वास्तविक दुनिया के डेटा के साथ काम करते समय अक्सर नमूना आकार छोटे होते हैं या जनसंख्या का विचरण अज्ञात होता है। ऐसे में सामान्य वितरण पर आधारित पारंपरिक सांख्यिकीय तकनीकें हमेशा कारगर नहीं रहतीं। यहीं t-वितरण, जिसे Student’s t-वितरण भी कहा जाता है, उपयोगी होता है। यह सीमित डेटा या अधिक अनिश्चितता की स्थिति में विश्वसनीय सांख्यिकीय निष्कर्ष निकालने का एक शक्तिशाली साधन है।
इस लेख में हम जानेंगे कि t-वितरण क्या है, यह समान वितरणों से कैसे तुलना करता है, इसके प्रमुख गणितीय गुण क्या हैं, और व्यवहार में, विशेषकर परिकल्पना परीक्षण और आत्मविश्वास अंतराल में, इसका उपयोग कैसे होता है। त्वरित संदर्भ के लिए अंत में मैंने t-वितरण की एक तालिका भी शामिल की है।
T-वितरण क्या है?
सामान्य वितरण की तरह t-वितरण भी सममित और घंटी-आकार का होता है। हालांकि, इसके पूंछ भाग भारी होते हैं, जो छोटे नमूना आकार के साथ आने वाली अधिक अनिश्चितता को दर्शाते हैं।
इसके अलावा, एक और प्रमुख कारक t-वितरण को अलग करता है: यह स्वतंत्रता की डिग्री (df) द्वारा परिभाषित होता है। यह मान df, नमूना आकार में से एक घटाकर (n − 1) निकाला जाता है और वितरण के आकार को प्रभावित करता है।
जैसे-जैसे स्वतंत्रता की डिग्री बढ़ती है, t-वितरण सामान्य वितरण जैसा होता जाता है। जब नमूना आकार बड़ा होता है (उदा., n > 30), तो अंतर इतना कम हो जाता है कि t-वितरण मानक सामान्य वक्र जैसा दिखने लगता है।
T-वितरण बनाम अन्य समान वितरण
t-वितरण की तुलना अन्य, समान वितरणों से करना उपयोगी होता है।
T-वितरण बनाम सामान्य वितरण
यद्यपि दोनों वितरण घंटी-आकार के हैं, t-वितरण की पूंछें भारी होती हैं और यह छोटे नमूनों तथा अज्ञात जनसंख्या विचरण के लिए अधिक उपयुक्त है, विशेष रूप से अपवाद मानों (outliers) के प्रति इसकी सहनशीलता को रेखांकित करना महत्वपूर्ण है.
|
विशेषता |
t-वितरण |
सामान्य वितरण |
|
आकार |
घंटी-आकार, भारी पूंछ |
घंटी-आकार, पतली पूंछ |
|
उपयोग परिदृश्य |
छोटे नमूने, σ अज्ञात |
बड़े नमूने, σ ज्ञात |
|
स्वतंत्रता की डिग्री |
आवश्यक |
लागू नहीं |
|
अपवाद मानों के प्रति संवेदनशीलता |
अधिक सहनशील |
कम सहनशील |
बड़े नमूनों के लिए, केन्द्रीय सीमा प्रमेय सामान्य वितरण के उपयोग को न्यायोचित ठहराता है, क्योंकि नमूना माध्य जनसंख्या के आकार की परवाह किए बिना सामान्य वितरण का अनुसरण करते हैं।
T-वितरण बनाम Z-वितरण
Z-वितरण से तात्पर्य मानक सामान्य वितरण से है, जिसका औसत 0 और मानक विचलन 1 होता है।
|
विशेषता |
t-वितरण |
Z-वितरण |
|
विचरण ज्ञात? |
नहीं |
हाँ |
|
पूंछ की मोटाई |
अधिक भारी |
अधिक पतली |
|
सामान्य परीक्षण |
t-परीक्षण |
z-परीक्षण |
|
छोटे नमूनों के लिए उपयोग |
हाँ |
नहीं |
आइए इसे एक Python कोड उदाहरण से समझते हैं:
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import t, norm

# X-axis range
x = np.linspace(-5, 5, 1000)

# Standard Normal (Z) Distribution
z_dist = norm.pdf(x)

# Plotting
plt.figure(figsize=(10, 6))
plt.plot(x, z_dist, label='Z-Distribution (Standard Normal)', color='black', linewidth=2)

# T-Distributions with different degrees of freedom
dfs = [1, 3, 5, 10, 30]
colors = ['red', 'orange', 'green', 'blue', 'purple']

for df, color in zip(dfs, colors):
    t_dist = t.pdf(x, df)
    plt.plot(x, t_dist, label=f'T-Distribution (df={df})', color=color, linestyle='--')

plt.title('T-Distribution vs Z-Distribution: Heavier Tails for Smaller Sample Sizes')
plt.xlabel('x')
plt.ylabel('Density')
plt.legend()
plt.grid(True)
plt.show()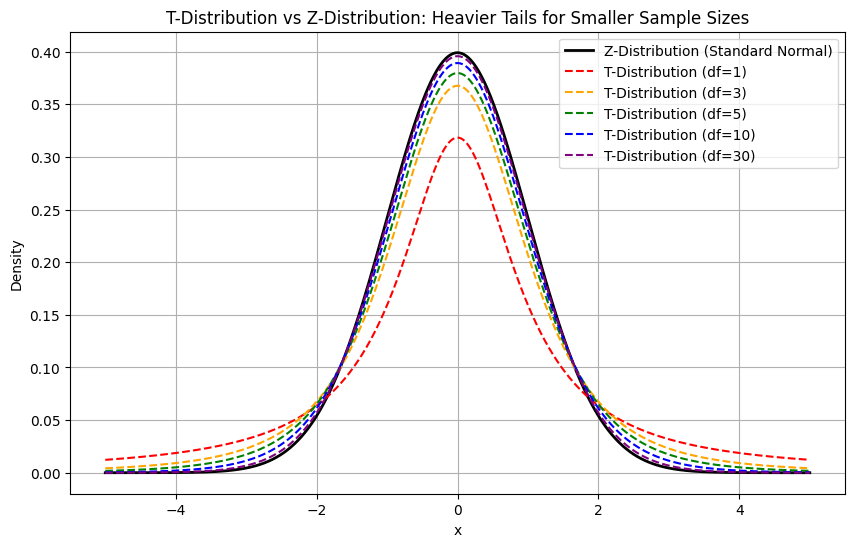
विशेष अवस्थाएँ और संबंधित वितरण
t-वितरण कई अन्य प्रायिकता वितरणों से निकटता से संबंधित है:
- मानक सामान्य वितरण (जैसे df → ∞): स्वतंत्रता की डिग्री बढ़ने पर t-वितरण सामान्य वितरण में अभिसरित होता है।
- Cauchy वितरण (df = 1): 1 स्वतंत्रता डिग्री वाला t-वितरण Cauchy वितरण के समकक्ष होता है, जिसका माध्य और विचरण अपरिभाषित होते हैं; व्यावहारिक रूप से 1 df वाला t-वितरण शायद ही इस्तेमाल होता है।
- F-वितरण: ν स्वतंत्रता डिग्री वाले t-चर का वर्ग (square) (1, ν) स्वतंत्रता डिग्री वाले F-वितरण का अनुसरण करता है।
- अकेंद्रीय (noncentral) t-वितरण: शक्ति विश्लेषण और उन्नत सांख्यिकीय अनुप्रयोगों में प्रयुक्त; इसमें गैर-केंद्रीयता पैरामीटर शामिल होता है, जो शून्य परिकल्पना गलत होने पर उत्पन्न होता है।
T-वितरण की सीमाएँ
t-वितरण यह मानता है कि अंतर्निहित डेटा लगभग सामान्य है। अत्यधिक तिरछे (skewed) या गैर-सामान्य डेटा के मामलों में यह उपयुक्त नहीं हो सकता। ऐसी स्थितियों में सुदृढ़ (robust) सांख्यिकीय तकनीकें या अ-पैरामीत्रिक विधियाँ अधिक उपयुक्त हो सकती हैं।
अब देखते हैं कि समान माध्य वाले सामान्य डेटा बनाम तिरछे डेटा पर t-परीक्षण का व्यवहार कैसे भिन्न होता है।
import numpy as np
import scipy.stats as stats
import matplotlib.pyplot as plt

np.random.seed(42)

# Generate data
normal_data = np.random.normal(loc=0, scale=1, size=30)
skewed_data = np.random.exponential(scale=1.0, size=30) - 1  # Shift to mean ≈ 0

# Perform one-sample t-tests (test if mean == 0)
t_stat_normal, p_normal = stats.ttest_1samp(normal_data, popmean=0)
t_stat_skewed, p_skewed = stats.ttest_1samp(skewed_data, popmean=0)

# Plot histograms
plt.figure(figsize=(12, 5))

plt.subplot(1, 2, 1)
plt.hist(normal_data, bins=15, color='skyblue', edgecolor='black')
plt.title(f'Normal Data\np-value = {p_normal:.3f}')
plt.axvline(0, color='red', linestyle='--')

plt.subplot(1, 2, 2)
plt.hist(skewed_data, bins=15, color='salmon', edgecolor='black')
plt.title(f'Skewed Data\np-value = {p_skewed:.3f}')
plt.axvline(0, color='red', linestyle='--')

plt.suptitle("Impact of Data Shape on t-test")
plt.tight_layout()
plt.show()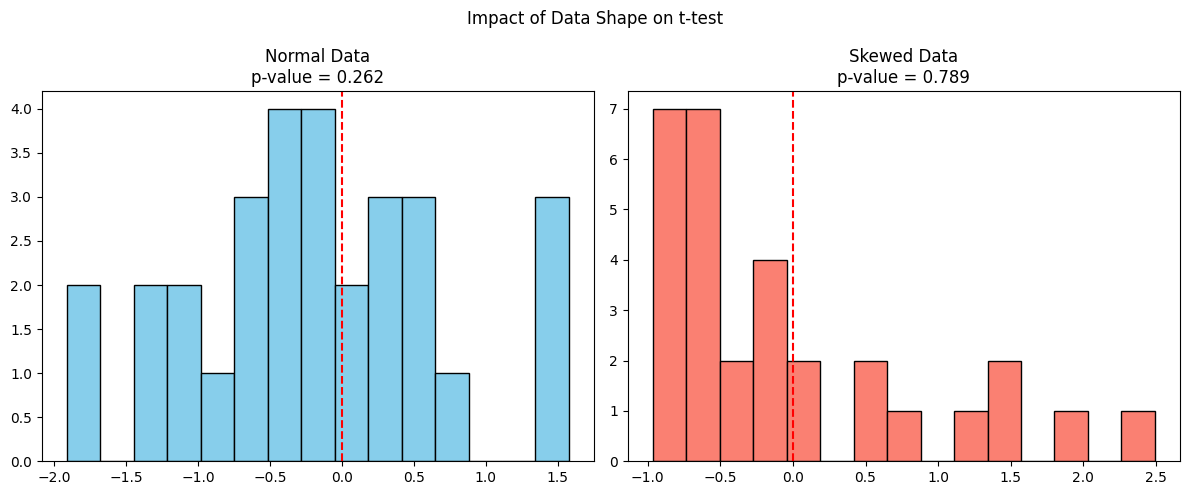
बाएँ ग्राफ सामान्य वितरण के डेटा को दिखाता है जहाँ t-परीक्षण वैध है और p-मूल्य भरोसेमंद है। वहीं दाएँ ग्राफ तिरछे डेटा को दर्शाता है जो घातीय वितरण से आया है; यद्यपि नमूना माध्य समान हो सकता है, t-परीक्षण सममिति मानकर चलता है और तिरछेपन का हिसाब नहीं रख पाता, जिससे p-मूल्य भ्रामक हो सकता है।
T-वितरण के गणितीय गुण
t-वितरण इस प्रकार परिभाषित है:
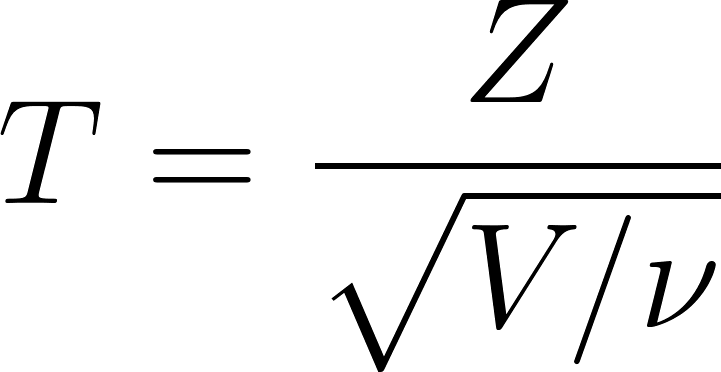
जहाँ:
- T परिणामी मान है जो Student’s t-वितरण का अनुसरण करता है, जिसकी स्वतंत्रता डिग्री ν है
- Z एक मानक सामान्य यादृच्छिक चर है, Z∼N(0,1)
- V एक काइ-स्क्वेयर (chi-square) वितरण वाला यादृच्छिक चर है जिसकी स्वतंत्रता डिग्री ν है, V∼χ2(ν)
- v स्वतंत्रता की डिग्री का पैरामीटर है, जो प्रायः n−1 के बराबर होता है, जहाँ नमूना आकार है।
प्रायिकता घनत्व फलन (PDF)
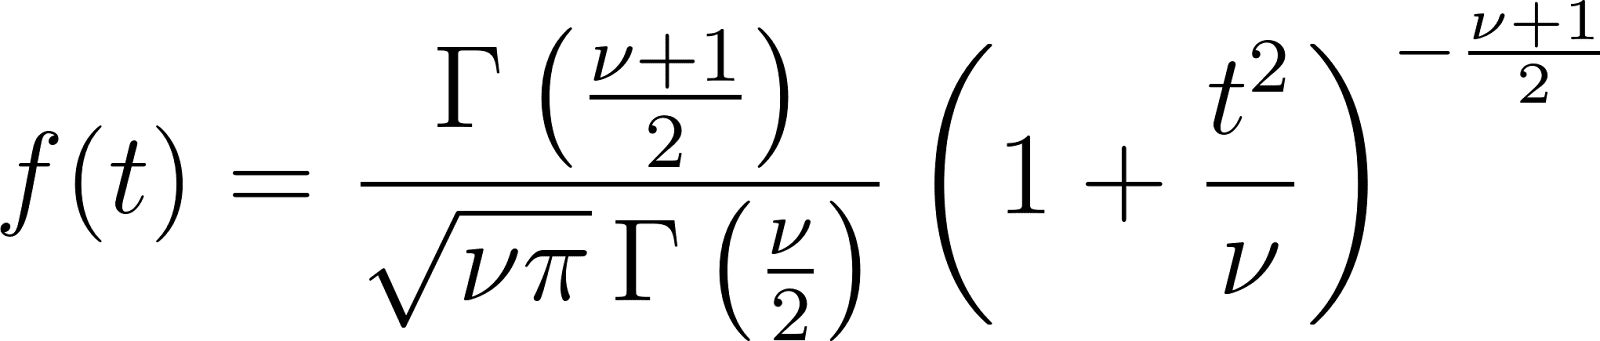
प्रमुख गुण
- माध्य: 0 (जब v > 1)
- विचरण: v / (v - 2) (जब v > 2)
- विकृति (Skewness): 0 (सममित वितरण)
- चौड़ाई (Kurtosis): सामान्य वितरण से अधिक (leptokurtic)
सिमुलेशन
Monte Carlo विधियाँ अक्सर t-वितरित यादृच्छिक चर का अनुकरण (simulate) करने में प्रयुक्त होती हैं, विशेषकर सांख्यिकीय महत्व को परखने या कृत्रिम डेटा बनाने में।
आइए इसे Python का उपयोग करके सिमुलेट करते हैं।
यहाँ हमारा लक्ष्य छोटे-नमूना (नमूना आकार = 10) प्रयोगों की बड़ी संख्या का सिमुलेशन करना, प्रत्येक के लिए t-सांख्यक निकालना, और परिणामी वितरण की सैद्धांतिक t-वितरण से तुलना करना है।
इसे करने के लिए हमें नीचे दिए गए तरीके का पालन करना होगा:
- सामान्य वितरण (माध्य = 0, मानक विचलन = 1) से अनेक नमूने बनाएँ।
- प्रत्येक नमूने के लिए t-सांख्यक की गणना करें: (नमूना माध्य xˉ से जनसंख्या माध्य μ घटाएँ, फिर परिणाम को माध्य के मानक त्रुटि से विभाजित करें, जो नमूना मानक विचलन को नमूना आकार के वर्गमूल n से भाग देकर मिलता है)
- सिमुलेटेड t-मूल्यों का हिस्टोग्राम बनाएं।
- तुलना हेतु सैद्धांतिक t-वितरण ओवरले करें।
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import t

# Simulation parameters
n = 10                      # sample size
mu = 0                      # population mean
sigma = 1                   # population std deviation (not used directly)
df = n - 1                  # degrees of freedom
num_simulations = 10000     # number of Monte Carlo simulations

# Monte Carlo simulation
t_stats = []
for _ in range(num_simulations):
    sample = np.random.normal(loc=mu, scale=sigma, size=n)
    sample_mean = np.mean(sample)
    sample_std = np.std(sample, ddof=1)  # sample std dev with Bessel's correction
    t_stat = (sample_mean - mu) / (sample_std / np.sqrt(n))
    t_stats.append(t_stat)

# Plot histogram of simulated t-statistics
x = np.linspace(-5, 5, 1000)
plt.figure(figsize=(10, 6))
plt.hist(t_stats, bins=50, density=True, alpha=0.6, label='Simulated t-Statistics')

# Overlay theoretical t-distribution
plt.plot(x, t.pdf(x, df), label=f'Theoretical t-Distribution (df={df})', color='red', linewidth=2)

plt.title('Monte Carlo Simulation of t-Distribution (n=10)')
plt.xlabel('t-value')
plt.ylabel('Density')
plt.legend()
plt.grid(True)
plt.show()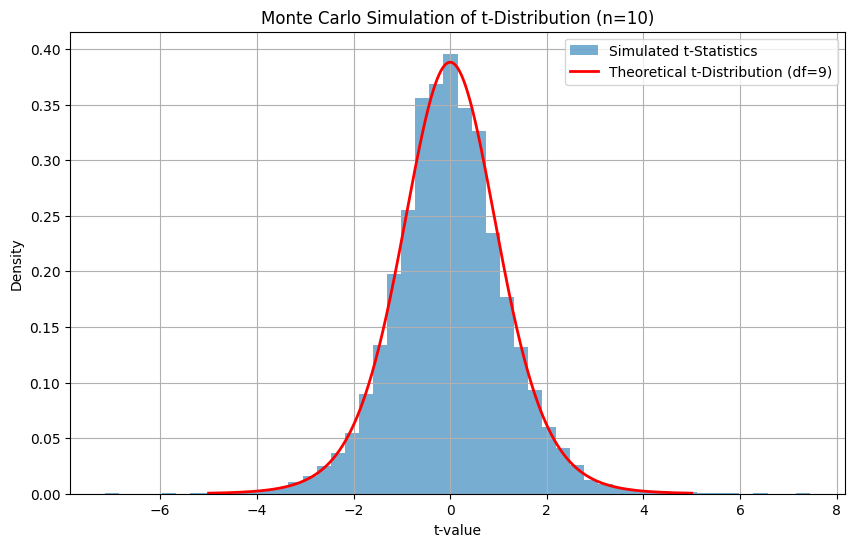
सिमुलेटेड t-मूल्य एक ऐसे वितरण का निर्माण करते हैं जो df = 9 वाले सैद्धांतिक t-वितरण से काफ़ी मेल खाता है। यादृच्छिक नमूनाकरण के ज़रिए t-वितरण को समझने और मान्य करने का यह व्यावहारिक तरीका है। यह बूटस्ट्रैपिंग और पुनर्नमूनाकरण-आधारित निष्कर्ष का भी मूलभूत सिद्धांत है।
t-वितरण का उपयोग कब करें
t-वितरण अनेक सांख्यिकीय अनुप्रयोगों में आधारभूत है:
- जब मानक विचलन अज्ञात हो, तब जनसंख्या माध्य का आकलन
- t-परीक्षण द्वारा परिकल्पना परीक्षण
- छोटे नमूनों के लिए आत्मविश्वास अंतराल
- प्रतिगमन विश्लेषण, जहाँ गुणांकों का t-वितरण होता है
- बेयज़ियन निष्कर्षण, विशेषकर जब विचरण पैरामीटर हाशिये पर कर दिए जाते हैं
t-वितरण के साथ आत्मविश्वास अंतराल
माध्य का आत्मविश्वास अंतराल इस प्रकार निकाला जाता है:
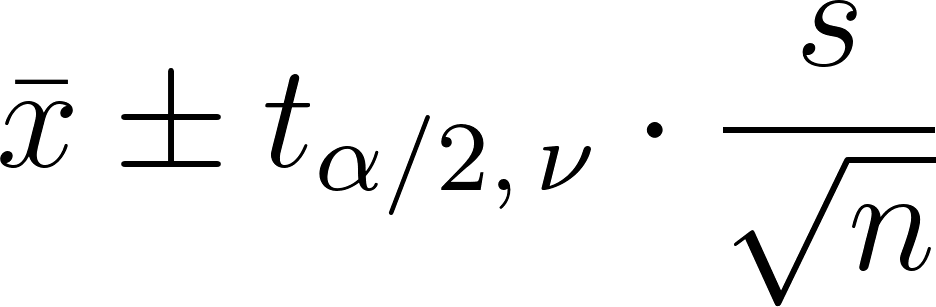
जहाँ:
- x नमूना माध्य है
- s नमूना मानक विचलन है
- n नमूना आकार है
- और मध्य भाग t-वितरण से निकला महत्वपूर्ण मान है। (alpha प्रासंगिकता स्तर है, और दो-पूंछ परीक्षण होने के कारण alpha को दो से विभाजित किया जाता है।)
महत्वपूर्ण मान खोजने के लिए t-वितरण तालिका या कैलकुलेटर का उपयोग करें।
t-वितरण के साथ परिकल्पना परीक्षण
t-परीक्षण में, परीक्षण-सांख्यक यह है:
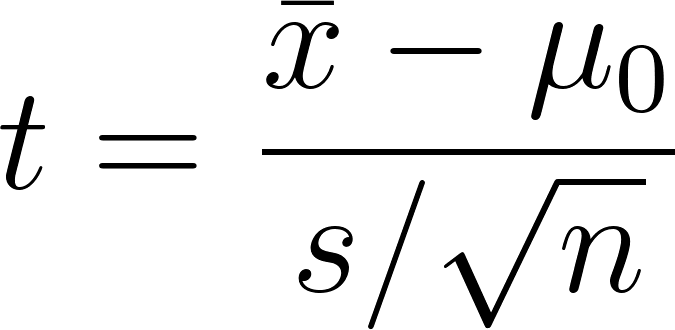
आप इसे एक महत्वपूर्ण t-मूल्य से तुलना करते हैं ताकि शून्य परिकल्पना को स्वीकार या अस्वीकार किया जा सके। t-परीक्षण ये हो सकते हैं:
- एक-नमूना
- दो-नमूना
- युग्मित-नमूना
ग्राफ़ीय चित्रण एक-पूंछ और दो-पूंछ परीक्षणों में महत्वपूर्ण क्षेत्रों को देखने में मदद करते हैं।
T-वितरण तालिका
t-वितरण तालिका विभिन्न आत्मविश्वास स्तरों और स्वतंत्रता डिग्रियों के लिए t-वितरण के महत्वपूर्ण मान सूचीबद्ध करती है। यह इन कार्यों के लिए आवश्यक है:
- आत्मविश्वास अंतराल निर्धारित करना
- t-परीक्षण करना
- प्रतिगमन में महत्व की जाँच
यदि यह उपयोगी हो, तो मैंने यहाँ आपके संदर्भ के लिए t-वितरण तालिका का एक संक्षिप्त संस्करण शामिल किया है:
| df | 80% (1-tailed) | 90% (2-tailed) | 95% (2-tailed) | 98% (2-tailed) | 99% (2-tailed) |
|---|---|---|---|---|---|
| 1 | 3.078 | 6.314 | 12.706 | 31.821 | 63.657 |
| 2 | 1.886 | 2.920 | 4.303 | 6.965 | 9.925 |
| 5 | 1.476 | 2.015 | 2.571 | 3.365 | 4.032 |
| 10 | 1.372 | 1.812 | 2.228 | 2.764 | 3.169 |
| 20 | 1.325 | 1.725 | 2.086 | 2.528 | 2.845 |
| 30 | 1.310 | 1.697 | 2.042 | 2.457 | 2.750 |
| 60 | 1.296 | 1.671 | 2.000 | 2.390 | 2.660 |
| ∞ | 1.282 | 1.645 | 1.960 | 2.326 | 2.576 |
निष्कर्ष
मुझे आशा है कि इस लेख ने आपको t-वितरण की ठोस समझ दी है और सिद्धांत तथा व्यवहार के बीच की खाई पाटने में मदद की है। यह सांख्यिकी में एक मूलभूत अवधारणा है जो अनिश्चितता से निपटती है, खासकर छोटे नमूना आकार या अज्ञात जनसंख्या मानकों के साथ।
आगे भी, जैसे-जैसे हम सुदृढ़ सांख्यिकी और बेयज़ियन विधियों जैसे उन्नत डेटा कार्यों पर बढ़ेंगे, t-वितरण बार-बार सामने आता रहेगा। मैं आपको हमारे Statistician in R करियर ट्रैक में नामांकन करने की सलाह देता/देती हूँ ताकि आप सच में विशेषज्ञ बन सकें।
