Distribusi Normal Standar: Apa Itu dan Mengapa Penting
Pelajari dasar-dasar distribusi normal standar dan signifikansinya dalam statistika, data science, dan machine learning. Ketahui cara menerapkan konsep ini pada analisis data dunia nyata.
Anda mungkin sering melihat kurva lonceng, yang memiliki banyak sebutan seperti distribusi normal atau distribusi Gaussian, di mana-mana, terutama jika Anda akrab dengan statistika atau data science. Ini terasa seperti, namun bukan, kebetulan alam: Ternyata banyak hal yang kita ukur merupakan hasil penjumlahan banyak faktor kecil, yang memberi petunjuk adanya model aditif yang mendasarinya.
Dengan mentransformasikan distribusi normal apa pun ke bentuk khusus yang disebut distribusi normal standar, kita dapat membuat distribusi yang sangat berguna dalam konteks tertentu, seperti menghitung probabilitas, melakukan inferensi statistik, dan menerapkan uji statistik. Pada akhir artikel ini, Anda akan memahami apa itu distribusi normal standar, mengapa kita mengambil langkah tambahan untuk menstandardisasinya, dan bagaimana semua ini berkaitan dengan variabilitas, probabilitas, dan pengujian hipotesis. Pada akhirnya, saya juga berharap Anda mendaftar ke kursus kami Introduction to Statistics in R atau jalur keterampilan Statistical Inference in R untuk terus membangun pemahaman dari artikel ini.
Apa itu Distribusi Normal Standar?
Distribusi normal standar adalah bentuk khusus dari distribusi normal dengan mean nol dan simpangan baku satu. Kita juga perlu mengatakan bahwa distribusi ini simetris dan probabilitas nilai-nilai tertentu menurun secara simetris saat Anda menjauh dari pusat.
Gambar "Distribusi Normal Standar" oleh Dall-E
Memahami Persamaan Distribusi Normal Standar
Mari kita melihat lebih dekat aspek matematis dari distribusi normal standar.
PDF dari distribusi normal standar
Jika Anda belum familiar dengan gagasan fungsi kerapatan peluang (probability density function/PDF), ketahuilah bahwa PDF menjelaskan bagaimana probabilitas didistribusikan pada nilai-nilai yang mungkin dari suatu peubah acak kontinu. Setiap distribusi probabilitas kontinu, seperti distribusi eksponensial, distribusi t, atau distribusi Cauchy, memiliki fungsi kerapatan peluangnya sendiri yang mendefinisikan kurvanya. PDF dari distribusi normal standar didefinisikan di sini:
Fungsi ini memastikan luas di bawah kurva berintegral 1. Jika Anda melihat persamaan dan memasukkan berbagai nilai x, Anda akan mendapatkan tinggi kurva pada titik-titik tersebut. Dalam persamaan:
x merepresentasikan sembarang bilangan real dan merupakan peubah masukan untuk fungsi. x muncul pada pangkat fungsi, yaitu −x2/2. Ini mengendalikan bentuk kurva.
Karena x2 selalu tidak negatif, dan ada tanda negatif di depannya, maka pangkatnya selalu negatif atau nol.
Dalam kasus khusus saat x=0, pangkatnya paling besar, sehingga f(x) mencapai puncaknya.
Jika x bergerak menjauh dari 0 baik ke arah positif maupun negatif, x2 meningkat, sehingga pangkatnya makin negatif. Pangkat yang lebih negatif menghasilkan nilai fungsi yang lebih kecil, yang berarti, bersama dengan hal-hal lain yang kita sebutkan, f(x) menurun secara simetris pada kedua sisi x=0.
Basis pangkatnya, yaitu bilangan Euler, memastikan peluruhan fungsi yang cepat saat x bergerak semakin jauh dari nol ke kedua arah.
Konstanta 1/√(2π) memastikan total luas di bawah kurva sama dengan 1.
CDF dari distribusi normal standar
Berbeda dengan PDF, yang memberikan kemungkinan relatif dari berbagai nilai, CDF memberi tahu Anda probabilitas bahwa suatu variabel kurang dari atau sama dengan nilai tertentu. Sama seperti PDF, setiap distribusi probabilitas kontinu memiliki CDF-nya masing-masing.
Persamaan ini sedikit lebih rumit, tetapi kita bisa menguraikannya:
Integral berarti bahwa alih-alih memberikan tinggi kurva pada x, CDF memberi tahu total probabilitas dari −∞ hingga x.
Saat x→−∞, CDF mendekati 0.
Saat x=0 CDF adalah 0,5, karena distribusinya simetris dan setengah probabilitas berada di kiri nol.
Saat x→∞, CDF mendekati 1.
Mengapa Kita Peduli pada Distribusi Normal Standar
Panduan kami tentang distribusi Gaussian memuat beberapa gagasan bagus tentang kapan Anda mungkin ingin menyesuaikan data menjadi distribusi normal. Namun terkadang, Anda mungkin ingin mengubah data menjadi normal standar secara khusus. Berikut beberapa alasan umum:
Normal standar digunakan dalam pengujian hipotesis
Distribusi normal standar membuat data kita lebih dapat dibandingkan dan dapat digunakan dengan metode statistik tertentu. Dengan mengonversi data menjadi skor-Z, kita dapat membandingkan pengamatan di berbagai distribusi normal. Khususnya, ini menjadi dasar uji Z, yang kita gunakan saat ingin menentukan apakah mean sampel berbeda secara signifikan dari mean populasi.
Uji t, di sisi lain, menggunakan simpangan baku sampel sebagai taksiran simpangan baku populasi, itulah mengapa uji ini bergantung pada distribusi t, yang memiliki ekor lebih berat daripada distribusi normal standar. Baca tutorial kami T-test vs. Z-test: Kapan Menggunakan Masing-Masing, yang membahas hal-hal seperti varians populasi dan sampel.
Normal standar membandingkan data pada skala umum
Karena dataset dan variabel yang berbeda dapat memiliki satuan dan skala yang berbeda, perbandingan langsung bisa sulit. Namun saat Anda mengonversinya ke skor-Z dengan mengurangkan mean dan membaginya dengan simpangan baku, perbandingan lintas distribusi menjadi mudah. Saat diterapkan pada dataset yang terdistribusi normal, hal ini menghasilkan distribusi normal standar. Misalnya, mengonversi skor SAT dan GRE—keduanya saya perkirakan terdistribusi normal—menjadi skor-Z memungkinkan kita membandingkan performa siswa relatif terhadap populasi uji masing-masing.
Normal standar digunakan dalam pengendalian mutu
Normal standar diketahui penting dalam memantau kualitas produk di manufaktur. Dengan menelaah probabilitas secara cermat, produsen dapat menentukan apakah fluktuasi kualitas disebabkan variasi acak atau isu mendasar lainnya. Ini terkait dengan pengujian hipotesis, yang telah kita sebutkan sebelumnya, dan juga tabel skor-Z, yang akan kita bahas di bawah.
Normal standar digunakan dalam pemodelan statistik
Distribusi normal standar berperan dalam menilai galat pada model seperti regresi linear dan peramalan deret waktu. Dalam model-model ini, kita berasumsi bahwa residual, yakni selisih antara nilai teramati dan nilai terprediksi, tidak hanya mengikuti distribusi normal tetapi juga dapat distandardisasi untuk mengikuti distribusi normal standar.
Dalam regresi linear, residual terstandardisasi adalah residual yang telah dikonversi menjadi nilai terstandardisasi, yang memungkinkan kita mengukur seberapa ekstrem suatu galat dalam satuan simpangan baku, sehingga memudahkan deteksi pencilan. Ini membantu karena heteroskedastisitas pada residual, yang bisa tidak tampak pada prediktor model, dapat mendistorsikan interpretasi residual.
Dalam analisis deret waktu, galat ramalan sering diasumsikan mengikuti distribusi normal standar ketika telah distandardisasi dengan benar. Ini penting untuk membangun interval prediksi. Banyak model deret waktu, seperti ARIMA, bergantung pada kuantil normal standar untuk menentukan batas kepercayaan di sekitar ramalan. Selain itu, dalam dekomposisi deret waktu, komponen sisa, yang menangkap fluktuasi tak teratur, sering kali berdistribusi normal. Jika Anda menstandardisasi komponen sisa ini, Anda dapat menemukan probabilitas nilai ekstrem dalam deret waktu yang Anda ketahui bukan hasil dari tren-siklus atau musiman. Kursus Forecasting in R kami akan mengajarkan teknik-teknik seperti ini.
Saya juga memikirkan principal component analysis, yang sering digunakan sebagai teknik prapemrosesan. Dalam PCA, kita menginginkan fitur masukan memiliki mean nol dan varians satu untuk membantu mencegah fitur dengan nilai besar mendominasi. Langkah prapemrosesan yang umum adalah menstandardisasi data dengan mengurangkan mean dan membaginya dengan simpangan baku. Ini memastikan setiap fitur memiliki mean nol dan varians satu, namun perlu ditegaskan bahwa ini tidak memaksakan kenormalan. Namun, dalam beberapa kasus, saya perkirakan data yang ditransformasikan akan mendekati normal jika distribusi aslinya sudah mendekati normal.
Normal standar digunakan untuk perhitungan probabilitas
Fungsi distribusi kumulatif dari distribusi normal standar, yang telah kita bahas sebelumnya, terdokumentasi dengan baik, maksudnya telah dihitung sebelumnya dan diorganisasi dalam tabel yang banyak tersedia, sehingga perhitungan probabilitas menjadi lebih mudah karena Anda hanya perlu menggunakan tabel untuk mencari nilai yang benar.
Misalnya, untuk mencari probabilitas bahwa tinggi badan yang dipilih secara acak berada di bawah 6 kaki, kita menstandardisasi tinggi tersebut menggunakan distribusi normal populasi dan mencari skor-Z di tabel normal standar. Saya menempatkan versi tabel normal standar di bagian bawah artikel ini jika Anda membutuhkannya.
Transformasi untuk Menyelaraskan Data dengan Distribusi Normal Standar
Transformasi dapat membantu membentuk ulang data menjadi distribusi normal standar. Secara garis besar, ini merupakan proses dua langkah. Pertama, kita membentuk ulang data agar menjadi normal, lalu kita melakukan standardisasi skor-Z.
Sebagai catatan, Anda biasanya tidak menerapkan standardisasi skor-Z sebagai langkah pertama karena nilai ekstrem dapat mendistorsi simpangan baku, sebab mean dan simpangan baku sensitif terhadap pencilan. Selain itu, beberapa transformasi memerlukan data positif. Jika Anda menerapkan standardisasi skor-Z terlebih dahulu, nilai yang dipusatkan ke mean dapat mencakup bilangan negatif, yang dapat menimbulkan masalah bagi transformasi yang hanya bekerja dengan nilai positif. Saya khususnya memikirkan logaritma. Jadi sebaiknya ikuti urutannya: langkah 1, lalu langkah 2.
Langkah 1: Transformasikan data agar menjadi normal
Beberapa ide transformasi yang bisa Anda gunakan antara lain:
Transformasi log untuk data miring
Saat data miring ke kanan (positif), transformasi log dapat membantu menormalkannya. Misalnya, menerapkan logaritma pada nilai mentah akan mengompresi nilai besar, mengurangi kemiringan, dan menciptakan distribusi yang lebih simetris.
Transformasi akar kuadrat untuk data cacah
Untuk data cacah atau dataset yang agak miring, kita dapat mencoba transformasi akar kuadrat. Metode ini mengurangi variabilitas sambil mempertahankan struktur yang lebih simetris, mendekatkan data ke bentuk kurva lonceng.
Transformasi Box-Cox untuk penyesuaian yang fleksibel
Transformasi Box-Cox melangkah lebih jauh dengan menyesuaikan transformasi terhadap data. Parameternya, λ, menentukan rumus tepat yang diterapkan, menjadikannya sangat serbaguna untuk menyelaraskan data dengan sifat-sifat distribusi normal standar. Feature Engineering in R akan menunjukkan Box-Cox, di antara banyak metode penting dan bermanfaat lainnya.
Langkah 2: Lakukan standardisasi skor-Z
Setelah transformasi diterapkan, data dapat distandardisasi agar sesuai dengan distribusi normal standar. Ini menyesuaikan data agar memiliki mean nol dan simpangan baku satu. Rumus skor-Z adalah:
di mana X adalah data yang telah ditransformasikan, μ adalah mean, dan σ adalah simpangan baku.
Sekarang, jika Anda memahami perbedaan antara skor-Z populasi dan skor-Z sampel, seperti yang kami bahas dalam jalur Statistical Inference in R, Anda mungkin mengenali persamaan di atas sebagai persamaan untuk skor-Z populasi. Jika Anda bekerja dengan sampel alih-alih seluruh populasi, kita akan menaksir mean dan simpangan baku sebagai gantinya:
Di sini, X-bar adalah mean sampel, dan s adalah simpangan baku sampel.
Hasilnya akan sama jika Anda menggunakan mean dan simpangan baku dari dataset baru yang telah dinormalisasi. Namun kadang-kadang peneliti mungkin tertarik untuk membandingkan data relatif terhadap populasi acuan yang lebih besar dengan menggunakan semacam mean dan simpangan baku tolok ukur sebagai gantinya.
Bayangkan melihat dataset pendapatan, yang akan miring ke kanan, lalu melakukan transformasi log untuk menormalkannya. Kemudian, bayangkan juga bahwa kita ingin membandingkan pendapatan relatif terhadap tolok ukur nasional, dalam hal ini kita akan menggunakan mean dan simpangan baku nasional alih-alih yang berasal dari sampel kita untuk menghitung skor-Z. Tujuannya di sini adalah memungkinkan perbandingan yang bermakna lintas dataset atau studi.
Jadi, pada dasarnya, jika Anda menggunakan sampel, secara teknis Anda mendapatkan pendekatan normal terstandardisasi daripada distribusi normal standar teoretis yang tepat. Saya pikir ini perbedaan yang layak diperjelas meskipun perbedaannya pasti kecil untuk dataset besar.
Memvisualisasikan Distribusi Normal Standar
Berikut salah satu cara membuat distribusi normal standar teoretis dalam bahasa pemrograman R. Pada kode ini, saya juga menambahkan garis vertikal untuk skor standar, alias skor-Z, yang merupakan cara untuk memberi tahu kita, untuk nilai tertentu, berapa banyak simpangan baku di atas atau di bawah mean populasi nilai kita berada.
install.packages("ggplot2")
library(ggplot2)
ggplot(data.frame(x = c(-4,4)), aes(x))+
stat_function(fun = dnorm, geom ="area", fill ='#ffe6b7', color ='black', alpha =0.5, args = list( mean =0, sd =1))+
labs(title ="Standard Normal Distribution", subtitle ="Standard Deviations and Z-Scores")+
theme(plot.title = element_text(hjust =0.5, face ="bold"))+
theme(plot.subtitle = element_text(hjust =0.5))+
geom_vline(xintercept =1, linetype ='dotdash', color ="black")+
geom_vline(xintercept =-1, linetype ='dotdash', color ="black")+
geom_vline(xintercept =2, linetype ='dotdash', color ="black")+
geom_vline(xintercept =-2, linetype ='dotdash', color ="black")+
geom_vline(xintercept =3, linetype ='dotdash', color ="black")+
geom_vline(xintercept =-3, linetype ='dotdash', color ="black")+
geom_text(aes(x=1, label="\n 1 σ", y=0.125), colour="#376795", angle=90, text=element_text(size=11))+
geom_text(aes(x=2, label="\n 2 σ", y=0.125), colour="#376795", angle=90, text=element_text(size=11))+
geom_text(aes(x=3, label="\n 3 σ", y=0.125), colour="#376795", angle=90, text=element_text(size=11))+
geom_text(aes(x=-1, label="\n-1 σ", y=0.125), colour="#376795", angle=90, text=element_text(size=11))+
geom_text(aes(x=-2, label="\n-2 σ", y=0.125), colour="#376795", angle=90, text=element_text(size=11))+
geom_text(aes(x=-3, label="\n-3 σ", y=0.125), colour="#376795", angle=90, text=element_text(size=11))Didukung oleh
Anda perlu tahu ada beberapa distribusi serupa yang dapat terlihat seperti normal standar tetapi bukan:
Distribusi
Mengapa Bukan Normal Standar
Distribusi t
Ekor sedikit lebih berat, bergantung pada derajat kebebasan
Distribusi Logistik
Ekor sedikit lebih berat daripada normal, bentuk berbeda
Distribusi Laplace
Puncak lebih tajam, ekor lebih berat, peluruhan eksponensial
Distribusi Normal Standar dan Tabel Normal Standar
Sekarang izinkan saya kembali ke sesuatu yang saya sebutkan sebelumnya: gagasan tentang tabel normal standar, juga disebut tabel skor-Z, atau tabel Z, yang digunakan untuk mencari probabilitas kumulatif bagi skor-Z, yang merepresentasikan jumlah simpangan baku suatu nilai dari mean dalam distribusi normal standar. Tabel ini umum digunakan dalam statistika untuk pengujian hipotesis, interval kepercayaan, dan perhitungan probabilitas. Gagasannya adalah, alih-alih menghitung probabilitas secara manual, Anda dapat merujuk tabel untuk dengan cepat menentukan proporsi nilai yang berada di bawah skor-Z tertentu.
Tabel ini memerlukan sedikit latihan untuk dibaca, dan tampilan tabel terkadang berbeda satu sama lain. Di sini, Anda melihatnya tersusun dalam format dua dimensi. Tujuannya adalah memudahkan pencarian probabilitas untuk skor-Z saat bekerja dengan tempat desimal. Dalam kasus ini, kolom paling kiri berisi bilangan bulat dan satu tempat desimal pertama dari skor-Z. Baris atas merepresentasikan tempat desimal kedua. Untuk menemukan probabilitas yang terkait dengan skor-Z tertentu, cari baris yang sesuai dengan bagian pertama skor-Z, lalu temukan kolom yang cocok dengan tempat desimal kedua. Nilai pada perpotongan baris dan kolom ini adalah probabilitas kumulatif, artinya proporsi titik data yang berada di bawah skor-Z tersebut.
Sebaiknya tunjukkan contoh: Misalnya, Anda menghitung skor-Z sebesar 0,32 untuk nilai ujian seorang siswa. Ini berarti nilai tersebut berada 0,32 simpangan baku di atas mean. Sekarang, mari gunakan tabel Z untuk mencari probabilitas bahwa nilai yang dipilih secara acak kurang dari skor-Z ini.
Langkah 1: Temukan baris untuk 0,3.
Langkah 2: Temukan kolom untuk 0,02.
Langkah 3: Lihat perpotongan antara baris 0,3 dan kolom 0,02. Nilai pada posisi ini adalah 0,6915.
Probabilitas kumulatif untuk Z = 0,32 adalah 0,6554, yang berarti 65,54% nilai dalam distribusi normal standar berada kurang dari 0,32 simpangan baku di atas mean. Jika Anda perlu menentukan probabilitas nilai yang lebih besar dari skor-Z tertentu, kurangkan nilai tabel dari 1 sebelum mencari baris dan kolom.
Saya penulis dan editor data science dengan kontribusi pada artikel riset di jurnal ilmiah. Saya sangat tertarik pada aljabar linear, statistika, R, dan sejenisnya. Saya juga cukup sering bermain catur!
FAQ Distribusi Normal Standar
Apa bedanya distribusi normal standar dengan distribusi normal?⌄
Distribusi normal standar adalah kasus khusus dari distribusi normal dengan mean 0 dan simpangan baku 1. Standardisasi ini memungkinkan perhitungan probabilitas dan perbandingan lintas dataset menjadi lebih mudah.
Apakah mengurangkan mean dan membaginya dengan simpangan baku menghasilkan distribusi normal standar⌄
Mengurangkan mean dan membaginya dengan simpangan baku mengubah suatu dataset menjadi bentuk terstandardisasi, tetapi tidak serta-merta menciptakan distribusi normal standar kecuali data aslinya berdistribusi normal.
Apa hubungan antara distribusi normal standar dan teorema limit pusat?⌄
Teorema limit pusat menyatakan bahwa jumlah dari banyak peubah acak yang saling bebas dan identik distribusinya cenderung mengikuti distribusi normal, yang dapat distandardisasi ke bentuk normal standar.
Apa yang direpresentasikan skor-Z dalam distribusi normal standar?⌄
Skor-Z memberi tahu kita berapa banyak simpangan baku suatu nilai dari mean. Skor-Z positif berarti nilainya di atas mean, sedangkan skor-Z negatif berarti nilainya di bawah mean.
Bagaimana kaitan distribusi normal standar dengan interval kepercayaan?⌄
Interval kepercayaan menggunakan skor-Z untuk menentukan rentang probabilitas dalam mengestimasi parameter populasi. Misalnya, interval kepercayaan 95% berkaitan dengan skor-Z sekitar ±1,96.
Temukan alasan mengapa Anda sebaiknya (tidak) menggunakan spaghetti plot untuk menyampaikan ketidakpastian jalur prediksi badai serta dampaknya terhadap interpretasi.
Kuasai pertanyaan wawancara basis data, dari konsep SQL dasar hingga skenario desain sistem tingkat lanjut. Panduan mendalam ini mencakup semua yang Anda perlukan untuk sukses di wawancara DBMS dan meraih peran berikutnya.




Anda mungkin sering melihat kurva lonceng, yang memiliki banyak sebutan seperti distribusi normal atau distribusi Gaussian, di mana-mana, terutama jika Anda akrab dengan statistika atau data science. Ini terasa seperti, namun bukan, kebetulan alam: Ternyata banyak hal yang kita ukur merupakan hasil penjumlahan banyak faktor kecil, yang memberi petunjuk adanya model aditif yang mendasarinya.
Dengan mentransformasikan distribusi normal apa pun ke bentuk khusus yang disebut distribusi normal standar, kita dapat membuat distribusi yang sangat berguna dalam konteks tertentu, seperti menghitung probabilitas, melakukan inferensi statistik, dan menerapkan uji statistik. Pada akhir artikel ini, Anda akan memahami apa itu distribusi normal standar, mengapa kita mengambil langkah tambahan untuk menstandardisasinya, dan bagaimana semua ini berkaitan dengan variabilitas, probabilitas, dan pengujian hipotesis. Pada akhirnya, saya juga berharap Anda mendaftar ke kursus kami Introduction to Statistics in R atau jalur keterampilan Statistical Inference in R untuk terus membangun pemahaman dari artikel ini.
Apa itu Distribusi Normal Standar?
Distribusi normal standar adalah bentuk khusus dari distribusi normal dengan mean nol dan simpangan baku satu. Kita juga perlu mengatakan bahwa distribusi ini simetris dan probabilitas nilai-nilai tertentu menurun secara simetris saat Anda menjauh dari pusat.
Gambar "Distribusi Normal Standar" oleh Dall-E
Memahami Persamaan Distribusi Normal Standar
Mari kita melihat lebih dekat aspek matematis dari distribusi normal standar.
PDF dari distribusi normal standar
Jika Anda belum familiar dengan gagasan fungsi kerapatan peluang (probability density function/PDF), ketahuilah bahwa PDF menjelaskan bagaimana probabilitas didistribusikan pada nilai-nilai yang mungkin dari suatu peubah acak kontinu. Setiap distribusi probabilitas kontinu, seperti distribusi eksponensial, distribusi t, atau distribusi Cauchy, memiliki fungsi kerapatan peluangnya sendiri yang mendefinisikan kurvanya. PDF dari distribusi normal standar didefinisikan di sini: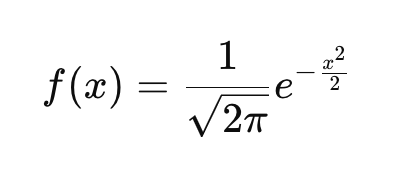
Fungsi ini memastikan luas di bawah kurva berintegral 1. Jika Anda melihat persamaan dan memasukkan berbagai nilai x, Anda akan mendapatkan tinggi kurva pada titik-titik tersebut. Dalam persamaan:
CDF dari distribusi normal standar
Berbeda dengan PDF, yang memberikan kemungkinan relatif dari berbagai nilai, CDF memberi tahu Anda probabilitas bahwa suatu variabel kurang dari atau sama dengan nilai tertentu. Sama seperti PDF, setiap distribusi probabilitas kontinu memiliki CDF-nya masing-masing.
Persamaan ini sedikit lebih rumit, tetapi kita bisa menguraikannya:
Mengapa Kita Peduli pada Distribusi Normal Standar
Panduan kami tentang distribusi Gaussian memuat beberapa gagasan bagus tentang kapan Anda mungkin ingin menyesuaikan data menjadi distribusi normal. Namun terkadang, Anda mungkin ingin mengubah data menjadi normal standar secara khusus. Berikut beberapa alasan umum:
Normal standar digunakan dalam pengujian hipotesis
Distribusi normal standar membuat data kita lebih dapat dibandingkan dan dapat digunakan dengan metode statistik tertentu. Dengan mengonversi data menjadi skor-Z, kita dapat membandingkan pengamatan di berbagai distribusi normal. Khususnya, ini menjadi dasar uji Z, yang kita gunakan saat ingin menentukan apakah mean sampel berbeda secara signifikan dari mean populasi.
Uji t, di sisi lain, menggunakan simpangan baku sampel sebagai taksiran simpangan baku populasi, itulah mengapa uji ini bergantung pada distribusi t, yang memiliki ekor lebih berat daripada distribusi normal standar. Baca tutorial kami T-test vs. Z-test: Kapan Menggunakan Masing-Masing, yang membahas hal-hal seperti varians populasi dan sampel.
Normal standar membandingkan data pada skala umum
Karena dataset dan variabel yang berbeda dapat memiliki satuan dan skala yang berbeda, perbandingan langsung bisa sulit. Namun saat Anda mengonversinya ke skor-Z dengan mengurangkan mean dan membaginya dengan simpangan baku, perbandingan lintas distribusi menjadi mudah. Saat diterapkan pada dataset yang terdistribusi normal, hal ini menghasilkan distribusi normal standar. Misalnya, mengonversi skor SAT dan GRE—keduanya saya perkirakan terdistribusi normal—menjadi skor-Z memungkinkan kita membandingkan performa siswa relatif terhadap populasi uji masing-masing.
Normal standar digunakan dalam pengendalian mutu
Normal standar diketahui penting dalam memantau kualitas produk di manufaktur. Dengan menelaah probabilitas secara cermat, produsen dapat menentukan apakah fluktuasi kualitas disebabkan variasi acak atau isu mendasar lainnya. Ini terkait dengan pengujian hipotesis, yang telah kita sebutkan sebelumnya, dan juga tabel skor-Z, yang akan kita bahas di bawah.
Normal standar digunakan dalam pemodelan statistik
Distribusi normal standar berperan dalam menilai galat pada model seperti regresi linear dan peramalan deret waktu. Dalam model-model ini, kita berasumsi bahwa residual, yakni selisih antara nilai teramati dan nilai terprediksi, tidak hanya mengikuti distribusi normal tetapi juga dapat distandardisasi untuk mengikuti distribusi normal standar.
Dalam regresi linear, residual terstandardisasi adalah residual yang telah dikonversi menjadi nilai terstandardisasi, yang memungkinkan kita mengukur seberapa ekstrem suatu galat dalam satuan simpangan baku, sehingga memudahkan deteksi pencilan. Ini membantu karena heteroskedastisitas pada residual, yang bisa tidak tampak pada prediktor model, dapat mendistorsikan interpretasi residual.
Dalam analisis deret waktu, galat ramalan sering diasumsikan mengikuti distribusi normal standar ketika telah distandardisasi dengan benar. Ini penting untuk membangun interval prediksi. Banyak model deret waktu, seperti ARIMA, bergantung pada kuantil normal standar untuk menentukan batas kepercayaan di sekitar ramalan. Selain itu, dalam dekomposisi deret waktu, komponen sisa, yang menangkap fluktuasi tak teratur, sering kali berdistribusi normal. Jika Anda menstandardisasi komponen sisa ini, Anda dapat menemukan probabilitas nilai ekstrem dalam deret waktu yang Anda ketahui bukan hasil dari tren-siklus atau musiman. Kursus Forecasting in R kami akan mengajarkan teknik-teknik seperti ini.
Normal standar digunakan dalam machine learning
Banyak algoritma machine learning bekerja paling baik saat data berada pada skala standar. Saya memikirkan regresi logistik, klastering k-means, dan jaringan saraf.
Saya juga memikirkan principal component analysis, yang sering digunakan sebagai teknik prapemrosesan. Dalam PCA, kita menginginkan fitur masukan memiliki mean nol dan varians satu untuk membantu mencegah fitur dengan nilai besar mendominasi. Langkah prapemrosesan yang umum adalah menstandardisasi data dengan mengurangkan mean dan membaginya dengan simpangan baku. Ini memastikan setiap fitur memiliki mean nol dan varians satu, namun perlu ditegaskan bahwa ini tidak memaksakan kenormalan. Namun, dalam beberapa kasus, saya perkirakan data yang ditransformasikan akan mendekati normal jika distribusi aslinya sudah mendekati normal.
Normal standar digunakan untuk perhitungan probabilitas
Fungsi distribusi kumulatif dari distribusi normal standar, yang telah kita bahas sebelumnya, terdokumentasi dengan baik, maksudnya telah dihitung sebelumnya dan diorganisasi dalam tabel yang banyak tersedia, sehingga perhitungan probabilitas menjadi lebih mudah karena Anda hanya perlu menggunakan tabel untuk mencari nilai yang benar.
Misalnya, untuk mencari probabilitas bahwa tinggi badan yang dipilih secara acak berada di bawah 6 kaki, kita menstandardisasi tinggi tersebut menggunakan distribusi normal populasi dan mencari skor-Z di tabel normal standar. Saya menempatkan versi tabel normal standar di bagian bawah artikel ini jika Anda membutuhkannya.
Transformasi untuk Menyelaraskan Data dengan Distribusi Normal Standar
Transformasi dapat membantu membentuk ulang data menjadi distribusi normal standar. Secara garis besar, ini merupakan proses dua langkah. Pertama, kita membentuk ulang data agar menjadi normal, lalu kita melakukan standardisasi skor-Z.
Sebagai catatan, Anda biasanya tidak menerapkan standardisasi skor-Z sebagai langkah pertama karena nilai ekstrem dapat mendistorsi simpangan baku, sebab mean dan simpangan baku sensitif terhadap pencilan. Selain itu, beberapa transformasi memerlukan data positif. Jika Anda menerapkan standardisasi skor-Z terlebih dahulu, nilai yang dipusatkan ke mean dapat mencakup bilangan negatif, yang dapat menimbulkan masalah bagi transformasi yang hanya bekerja dengan nilai positif. Saya khususnya memikirkan logaritma. Jadi sebaiknya ikuti urutannya: langkah 1, lalu langkah 2.
Langkah 1: Transformasikan data agar menjadi normal
Beberapa ide transformasi yang bisa Anda gunakan antara lain:
Transformasi log untuk data miring
Saat data miring ke kanan (positif), transformasi log dapat membantu menormalkannya. Misalnya, menerapkan logaritma pada nilai mentah akan mengompresi nilai besar, mengurangi kemiringan, dan menciptakan distribusi yang lebih simetris.
Transformasi akar kuadrat untuk data cacah
Untuk data cacah atau dataset yang agak miring, kita dapat mencoba transformasi akar kuadrat. Metode ini mengurangi variabilitas sambil mempertahankan struktur yang lebih simetris, mendekatkan data ke bentuk kurva lonceng.
Transformasi Box-Cox untuk penyesuaian yang fleksibel
Transformasi Box-Cox melangkah lebih jauh dengan menyesuaikan transformasi terhadap data. Parameternya, λ, menentukan rumus tepat yang diterapkan, menjadikannya sangat serbaguna untuk menyelaraskan data dengan sifat-sifat distribusi normal standar. Feature Engineering in R akan menunjukkan Box-Cox, di antara banyak metode penting dan bermanfaat lainnya.
Langkah 2: Lakukan standardisasi skor-Z
Setelah transformasi diterapkan, data dapat distandardisasi agar sesuai dengan distribusi normal standar. Ini menyesuaikan data agar memiliki mean nol dan simpangan baku satu. Rumus skor-Z adalah:
di mana X adalah data yang telah ditransformasikan, μ adalah mean, dan σ adalah simpangan baku.
Sekarang, jika Anda memahami perbedaan antara skor-Z populasi dan skor-Z sampel, seperti yang kami bahas dalam jalur Statistical Inference in R, Anda mungkin mengenali persamaan di atas sebagai persamaan untuk skor-Z populasi. Jika Anda bekerja dengan sampel alih-alih seluruh populasi, kita akan menaksir mean dan simpangan baku sebagai gantinya:
Di sini, X-bar adalah mean sampel, dan s adalah simpangan baku sampel.
Hasilnya akan sama jika Anda menggunakan mean dan simpangan baku dari dataset baru yang telah dinormalisasi. Namun kadang-kadang peneliti mungkin tertarik untuk membandingkan data relatif terhadap populasi acuan yang lebih besar dengan menggunakan semacam mean dan simpangan baku tolok ukur sebagai gantinya.
Bayangkan melihat dataset pendapatan, yang akan miring ke kanan, lalu melakukan transformasi log untuk menormalkannya. Kemudian, bayangkan juga bahwa kita ingin membandingkan pendapatan relatif terhadap tolok ukur nasional, dalam hal ini kita akan menggunakan mean dan simpangan baku nasional alih-alih yang berasal dari sampel kita untuk menghitung skor-Z. Tujuannya di sini adalah memungkinkan perbandingan yang bermakna lintas dataset atau studi.
Jadi, pada dasarnya, jika Anda menggunakan sampel, secara teknis Anda mendapatkan pendekatan normal terstandardisasi daripada distribusi normal standar teoretis yang tepat. Saya pikir ini perbedaan yang layak diperjelas meskipun perbedaannya pasti kecil untuk dataset besar.
Memvisualisasikan Distribusi Normal Standar
Berikut salah satu cara membuat distribusi normal standar teoretis dalam bahasa pemrograman R. Pada kode ini, saya juga menambahkan garis vertikal untuk skor standar, alias skor-Z, yang merupakan cara untuk memberi tahu kita, untuk nilai tertentu, berapa banyak simpangan baku di atas atau di bawah mean populasi nilai kita berada.
Anda perlu tahu ada beberapa distribusi serupa yang dapat terlihat seperti normal standar tetapi bukan:
Distribusi Normal Standar dan Tabel Normal Standar
Sekarang izinkan saya kembali ke sesuatu yang saya sebutkan sebelumnya: gagasan tentang tabel normal standar, juga disebut tabel skor-Z, atau tabel Z, yang digunakan untuk mencari probabilitas kumulatif bagi skor-Z, yang merepresentasikan jumlah simpangan baku suatu nilai dari mean dalam distribusi normal standar. Tabel ini umum digunakan dalam statistika untuk pengujian hipotesis, interval kepercayaan, dan perhitungan probabilitas. Gagasannya adalah, alih-alih menghitung probabilitas secara manual, Anda dapat merujuk tabel untuk dengan cepat menentukan proporsi nilai yang berada di bawah skor-Z tertentu.
Tabel ini memerlukan sedikit latihan untuk dibaca, dan tampilan tabel terkadang berbeda satu sama lain. Di sini, Anda melihatnya tersusun dalam format dua dimensi. Tujuannya adalah memudahkan pencarian probabilitas untuk skor-Z saat bekerja dengan tempat desimal. Dalam kasus ini, kolom paling kiri berisi bilangan bulat dan satu tempat desimal pertama dari skor-Z. Baris atas merepresentasikan tempat desimal kedua. Untuk menemukan probabilitas yang terkait dengan skor-Z tertentu, cari baris yang sesuai dengan bagian pertama skor-Z, lalu temukan kolom yang cocok dengan tempat desimal kedua. Nilai pada perpotongan baris dan kolom ini adalah probabilitas kumulatif, artinya proporsi titik data yang berada di bawah skor-Z tersebut.
Sebaiknya tunjukkan contoh: Misalnya, Anda menghitung skor-Z sebesar 0,32 untuk nilai ujian seorang siswa. Ini berarti nilai tersebut berada 0,32 simpangan baku di atas mean. Sekarang, mari gunakan tabel Z untuk mencari probabilitas bahwa nilai yang dipilih secara acak kurang dari skor-Z ini.
Probabilitas kumulatif untuk Z = 0,32 adalah 0,6554, yang berarti 65,54% nilai dalam distribusi normal standar berada kurang dari 0,32 simpangan baku di atas mean. Jika Anda perlu menentukan probabilitas nilai yang lebih besar dari skor-Z tertentu, kurangkan nilai tabel dari 1 sebelum mencari baris dan kolom.
Kesimpulan
Semoga Anda menikmati penjelajahan tentang distribusi normal standar ini. Teruslah belajar bersama kami di DataCamp. Saya telah menyebut kursus Introduction to Statistics in R dan jalur keterampilan Statistical Inference in R. Namun jika Anda lebih suka Python, kursus Statistical Thinking in Python dan Experimental Design in Python juga merupakan pilihan yang sangat baik.