Quando si lavora con dati reali, capita spesso che le dimensioni del campione siano ridotte o che la varianza della popolazione sia sconosciuta. In queste condizioni, le tecniche statistiche tradizionali basate sulla distribuzione normale possono non essere valide. È qui che la distribuzione t, nota anche come distribuzione t di Student, diventa utile. È uno strumento potente per trarre inferenze statistiche affidabili quando i dati sono limitati o l'incertezza è elevata.
In questo articolo vedremo cos'è la distribuzione t, come si confronta con distribuzioni simili, le sue proprietà matematiche fondamentali e come viene utilizzata nella pratica, in particolare nei test d'ipotesi e negli intervalli di confidenza. Ho anche incluso alla fine una tabella della distribuzione t per un rapido riferimento.
Che cos'è la distribuzione t?
Proprio come la distribuzione normale, anche la distribuzione t è simmetrica e a forma di campana. Tuttavia, ha code più pesanti che riflettono una maggiore incertezza, spesso associata a campioni di dimensioni ridotte.
C'è poi un altro fattore chiave che distingue la distribuzione t: è definita dai gradi di libertà (df). Questo valore, df, si calcola come la dimensione del campione meno uno (n − 1) e influisce sulla forma della distribuzione.
All'aumentare dei gradi di libertà, la distribuzione t diventa più simile alla distribuzione normale. Quando la dimensione del campione è grande (ad es., n > 30), la differenza diventa così piccola che la distribuzione t inizia ad assomigliare alla curva normale standard.
Distribuzione t vs. altre distribuzioni simili
È utile confrontare la distribuzione t con altre distribuzioni simili.
Distribuzione t vs. distribuzione normale
Sebbene entrambe le distribuzioni siano a forma di campana, con la distribuzione t che presenta code più pesanti ed è più adatta a piccoli campioni e varianza della popolazione sconosciuta, è particolarmente importante sottolinearne la tolleranza verso i valori anomali.
|
Caratteristica |
Distribuzione t |
Distribuzione normale |
|
Forma |
A campana, code più pesanti |
A campana, code più sottili |
|
Caso d'uso |
Campioni piccoli, σ sconosciuta |
Campioni grandi, σ nota |
|
Gradi di libertà |
Richiesti |
Non applicabile |
|
Sensibilità ai valori anomali |
Più tollerante |
Meno tollerante |
Per campioni più grandi, il teorema del limite centrale giustifica l'uso della distribuzione normale, poiché le medie campionarie tendono a seguire una distribuzione normale a prescindere dalla forma della popolazione.
Distribuzione t vs. distribuzione Z
La distribuzione Z si riferisce alla distribuzione normale standard, che ha media 0 e deviazione standard 1.
|
Caratteristica |
Distribuzione t |
Distribuzione Z |
|
Varianza nota? |
No |
Sì |
|
Spessore delle code |
Maggiore |
Minore |
|
Test comune |
t-test |
z-test |
|
Uso con campioni piccoli |
Sì |
No |
Capciamolo con un esempio di codice Python:
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import t, norm

# X-axis range
x = np.linspace(-5, 5, 1000)

# Standard Normal (Z) Distribution
z_dist = norm.pdf(x)

# Plotting
plt.figure(figsize=(10, 6))
plt.plot(x, z_dist, label='Z-Distribution (Standard Normal)', color='black', linewidth=2)

# T-Distributions with different degrees of freedom
dfs = [1, 3, 5, 10, 30]
colors = ['red', 'orange', 'green', 'blue', 'purple']

for df, color in zip(dfs, colors):
    t_dist = t.pdf(x, df)
    plt.plot(x, t_dist, label=f'T-Distribution (df={df})', color=color, linestyle='--')

plt.title('T-Distribution vs Z-Distribution: Heavier Tails for Smaller Sample Sizes')
plt.xlabel('x')
plt.ylabel('Density')
plt.legend()
plt.grid(True)
plt.show()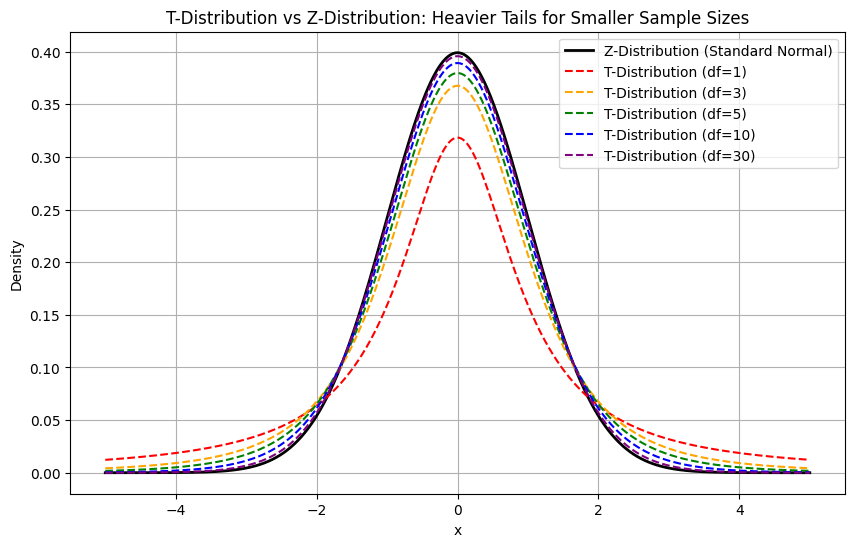
Casi speciali e distribuzioni correlate
La distribuzione t è strettamente correlata a diverse altre distribuzioni di probabilità:
- Distribuzione normale standard (al crescere di df → ∞): la distribuzione t converge alla distribuzione normale all'aumentare dei gradi di libertà.
- Distribuzione di Cauchy (df = 1): una distribuzione t con 1 grado di libertà è equivalente alla distribuzione di Cauchy, nota per avere media e varianza non definite, il che di fatto significa che una distribuzione t con un grado di libertà è raramente usata in pratica.
- Distribuzione F: il quadrato di una variabile t-distribuita con ν gradi di libertà segue una distribuzione F con gradi di libertà (1, ν).
- Distribuzione t non centrale: usata nell'analisi della potenza e in applicazioni statistiche avanzate, include un parametro di non centralità e nasce quando l'ipotesi nulla è falsa.
Limitazioni della distribuzione t
La distribuzione t assume che i dati sottostanti siano approssimativamente normali. In presenza di dati fortemente asimmetrici o non normali, potrebbe non essere appropriata. In tali casi, tecniche statistiche robuste o metodi non parametrici possono essere più adatti.
Confrontiamo ora come si comporta il t-test su dati normali rispetto a dati asimmetrici, entrambi con la stessa media.
import numpy as np
import scipy.stats as stats
import matplotlib.pyplot as plt

np.random.seed(42)

# Generate data
normal_data = np.random.normal(loc=0, scale=1, size=30)
skewed_data = np.random.exponential(scale=1.0, size=30) - 1  # Shift to mean ≈ 0

# Perform one-sample t-tests (test if mean == 0)
t_stat_normal, p_normal = stats.ttest_1samp(normal_data, popmean=0)
t_stat_skewed, p_skewed = stats.ttest_1samp(skewed_data, popmean=0)

# Plot histograms
plt.figure(figsize=(12, 5))

plt.subplot(1, 2, 1)
plt.hist(normal_data, bins=15, color='skyblue', edgecolor='black')
plt.title(f'Normal Data\np-value = {p_normal:.3f}')
plt.axvline(0, color='red', linestyle='--')

plt.subplot(1, 2, 2)
plt.hist(skewed_data, bins=15, color='salmon', edgecolor='black')
plt.title(f'Skewed Data\np-value = {p_skewed:.3f}')
plt.axvline(0, color='red', linestyle='--')

plt.suptitle("Impact of Data Shape on t-test")
plt.tight_layout()
plt.show()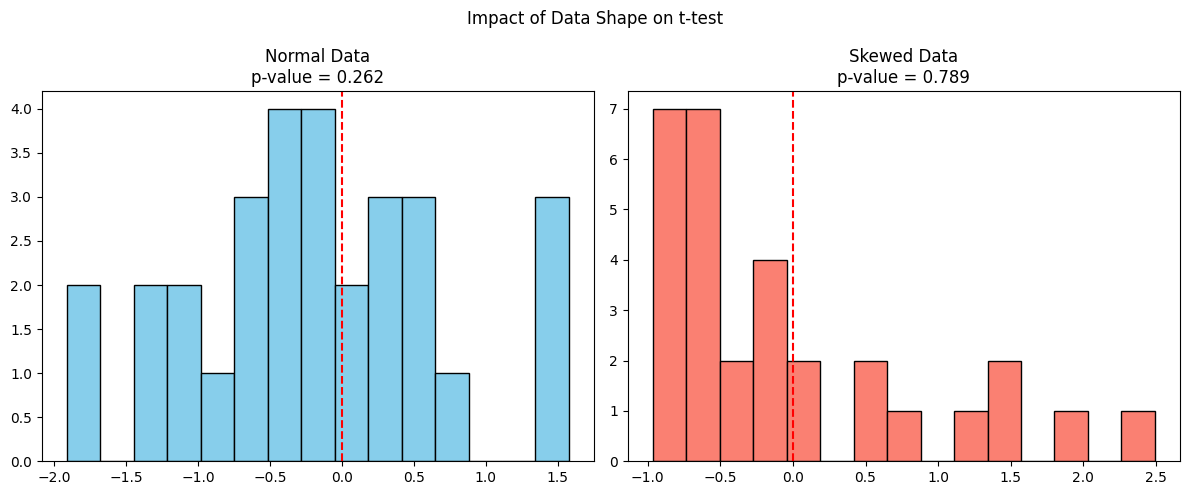
Il grafico a sinistra mostra dati da una distribuzione normale, per cui il t-test è valido e il p-value è affidabile. Il grafico a destra mostra invece dati asimmetrici da una distribuzione esponenziale: sebbene la media campionaria possa essere simile, il t-test assume simmetria e non tiene conto dell'asimmetria, potenzialmente restituendo un p-value impreciso.
Proprietà matematiche della distribuzione t
La distribuzione t è definita come:
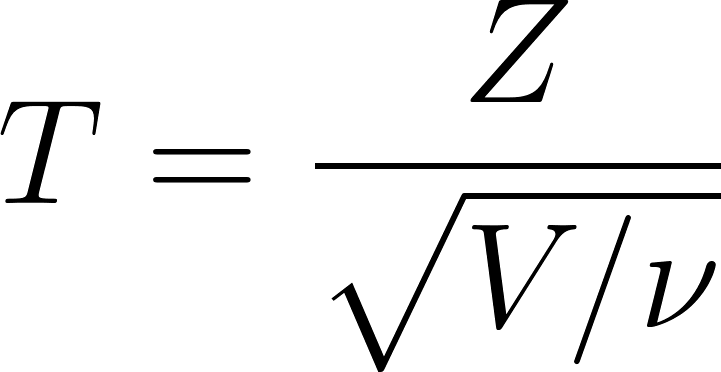
Dove:
- T è il valore risultante che segue una distribuzione t di Student con gradi di libertà ν
- Z è una variabile casuale normale standard Z∼N(0,1)
- V è una variabile casuale con distribuzione chi-quadrato con ν gradi di libertà, V∼χ2(ν)
- v è il parametro dei gradi di libertà, spesso uguale a n−1, dove è la dimensione del campione.
Funzione di densità di probabilità (PDF)
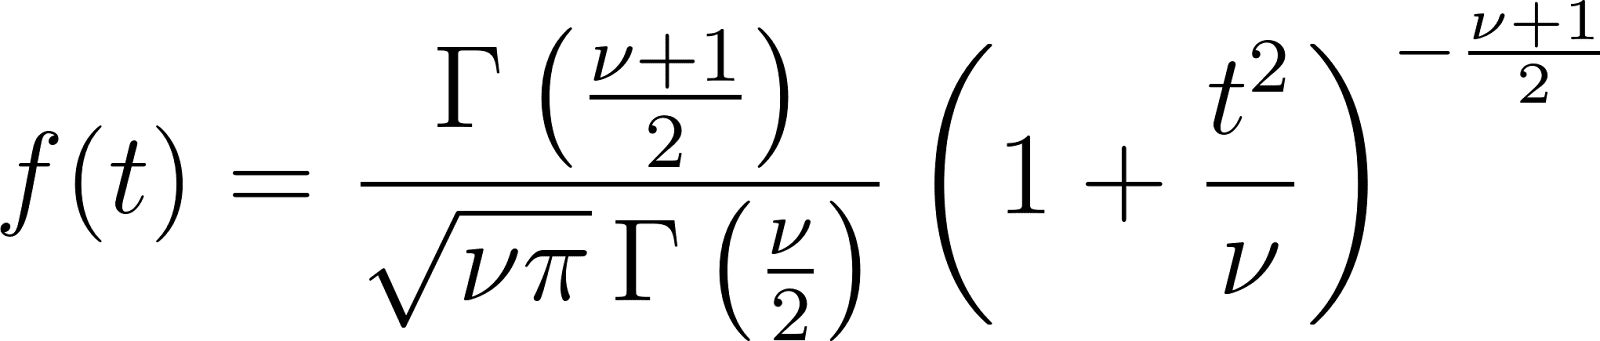
Proprietà chiave
- Media: 0 (per v > 1)
- Varianza: v / (v - 2) (per v > 2)
- Assimmetria: 0 (distribuzione simmetrica)
- Curtosi: superiore alla distribuzione normale (leptocurtica)
Simulazione
I metodi Monte Carlo sono spesso usati per simulare variabili casuali con distribuzione t, soprattutto per valutare la significatività statistica o creare dati sintetici.
Simuliamo il tutto con Python.
L'obiettivo è simulare un gran numero di esperimenti con piccoli campioni (dimensione campione = 10), calcolare il t-statistic per ciascuno e confrontare la distribuzione risultante con la distribuzione t teorica.
Per farlo, dobbiamo seguire l'approccio seguente:
- Generare molti campioni da una distribuzione normale (media = 0, dev. std = 1).
- Per ogni campione, calcolare il t-statistic: (Sottrai la media della popolazione μ dalla media campionaria xˉ, poi dividi il risultato per l'errore standard della media, ovvero la deviazione standard campionaria divisa per la radice quadrata della dimensione del campione n)
- Rappresentare l'istogramma dei valori t simulati.
- Sovrapporre la distribuzione t teorica per il confronto.
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import t

# Simulation parameters
n = 10                      # sample size
mu = 0                      # population mean
sigma = 1                   # population std deviation (not used directly)
df = n - 1                  # degrees of freedom
num_simulations = 10000     # number of Monte Carlo simulations

# Monte Carlo simulation
t_stats = []
for _ in range(num_simulations):
    sample = np.random.normal(loc=mu, scale=sigma, size=n)
    sample_mean = np.mean(sample)
    sample_std = np.std(sample, ddof=1)  # sample std dev with Bessel's correction
    t_stat = (sample_mean - mu) / (sample_std / np.sqrt(n))
    t_stats.append(t_stat)

# Plot histogram of simulated t-statistics
x = np.linspace(-5, 5, 1000)
plt.figure(figsize=(10, 6))
plt.hist(t_stats, bins=50, density=True, alpha=0.6, label='Simulated t-Statistics')

# Overlay theoretical t-distribution
plt.plot(x, t.pdf(x, df), label=f'Theoretical t-Distribution (df={df})', color='red', linewidth=2)

plt.title('Monte Carlo Simulation of t-Distribution (n=10)')
plt.xlabel('t-value')
plt.ylabel('Density')
plt.legend()
plt.grid(True)
plt.show()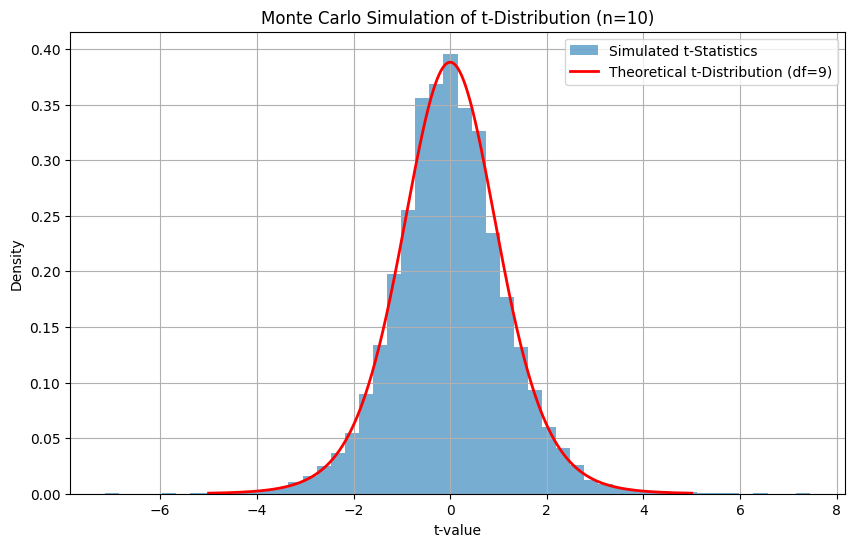
I valori t simulati formano una distribuzione che corrisponde strettamente alla distribuzione t teorica con df = 9. Questo è un modo pratico per comprendere e validare la distribuzione t tramite campionamento casuale. È anche un concetto alla base del bootstrapping e dell'inferenza basata sul ricampionamento.
Quando usare la distribuzione t
La distribuzione t è fondamentale in molte applicazioni statistiche:
- Stima della media di una popolazione quando la deviazione standard è sconosciuta
- Test d'ipotesi tramite t-test
- Intervalli di confidenza per campioni piccoli
- Analisi di regressione, dove i coefficienti seguono una distribuzione t
- Inferenza bayesiana, in particolare quando i parametri di varianza sono marginalizzati
Intervalli di confidenza con la distribuzione t
Un intervallo di confidenza per la media si calcola come:
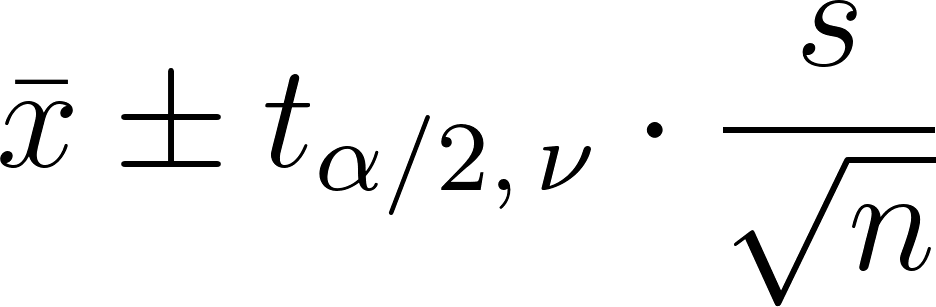
Dove:
- x è la media campionaria
- s è la deviazione standard campionaria
- n è la dimensione del campione
- E la parte centrale è il valore critico dalla distribuzione t. (alpha è il livello di significatività, e alpha diviso due perché il test è a due code.)
Usa una tabella della distribuzione t o una calcolatrice per trovare il valore critico.
Test d'ipotesi con la distribuzione t
Nei t-test, la statistica test è:
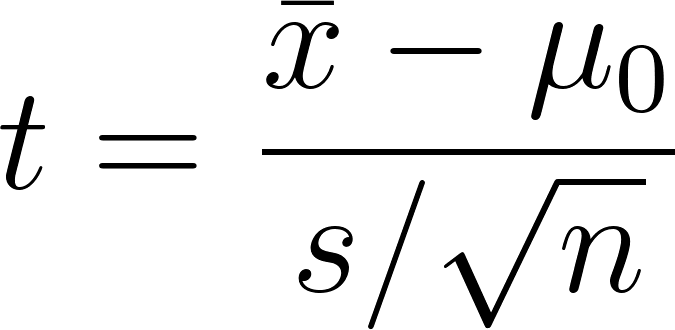
Confronti questo valore con un t-critico per accettare o rifiutare l'ipotesi nulla. I t-test possono essere:
- A un campione
- A due campioni
- Appaiati
Illustrazioni grafiche aiutano a visualizzare le regioni critiche nei test a una coda e a due code.
Tabella della distribuzione t
Una tabella della distribuzione t elenca i valori critici della distribuzione t per vari livelli di confidenza e gradi di libertà. È essenziale per:
- Determinare gli intervalli di confidenza
- Condurre t-test
- Verificare la significatività in regressione
Se ti è utile, ho incluso qui una versione condensata di una tabella della distribuzione t a cui puoi fare riferimento:
| df | 80% (1-coda) | 90% (2-code) | 95% (2-code) | 98% (2-code) | 99% (2-code) |
|---|---|---|---|---|---|
| 1 | 3.078 | 6.314 | 12.706 | 31.821 | 63.657 |
| 2 | 1.886 | 2.920 | 4.303 | 6.965 | 9.925 |
| 5 | 1.476 | 2.015 | 2.571 | 3.365 | 4.032 |
| 10 | 1.372 | 1.812 | 2.228 | 2.764 | 3.169 |
| 20 | 1.325 | 1.725 | 2.086 | 2.528 | 2.845 |
| 30 | 1.310 | 1.697 | 2.042 | 2.457 | 2.750 |
| 60 | 1.296 | 1.671 | 2.000 | 2.390 | 2.660 |
| ∞ | 1.282 | 1.645 | 1.960 | 2.326 | 2.576 |
Conclusione
Spero che questo articolo ti abbia fornito una solida comprensione della distribuzione t e ti abbia aiutato a colmare il divario tra teoria e pratica. È un concetto centrale della statistica che affronta l'incertezza, soprattutto con campioni piccoli o parametri della popolazione sconosciuti.
Inoltre, la distribuzione t continuerà a ricorrere man mano che affronteremo lavori di analisi più avanzati, ad esempio quelli che coinvolgono statistiche robuste e metodi bayesiani. Ti consiglio di iscriverti al nostro percorso di carriera Statistician in R per diventare davvero un esperto.




