
Kursus
Dasar-Dasar Probabilitas di Python
5 jam
16.3K
Jika kita mengambil banyak sampel acak dari hampir semua jenis distribusi data, sesuatu yang mengejutkan terjadi. Rata-rata dari sampel-sampel tersebut mulai terlihat seperti distribusi normal – kurva lonceng yang familier itu. Itulah teorema limit tengah (CLT) secara singkat.
Ini adalah hal besar dalam probabilitas dan statistika karena berarti kita dapat membuat prediksi yang akurat dan menarik kesimpulan tentang seluruh populasi, bahkan ketika hanya melihat sampel kecil.
Yang membuat CLT sangat berguna adalah ia tetap bekerja meskipun data asalnya tidak berdistribusi normal. Mari kita telusuri lebih jauh dan lihat cara menghitungnya.
Teorema limit tengah, atau CLT, adalah gagasan dalam statistika yang menyatakan bahwa jika kita mengambil banyak sampel acak dari populasi mana pun dan melihat rata-rata dari sampel-sampel tersebut, rata-rata itu akan mulai membentuk kurva normal berbentuk lonceng meskipun populasi asalnya sama sekali tidak tampak normal.
Ini berkaitan dengan hukum bilangan besar, yang memberi tahu kita bahwa saat kita mengumpulkan lebih banyak data, rata-rata sampel kita akan semakin mendekati rata-rata sebenarnya dari seluruh populasi. CLT melangkah lebih jauh — ia memberi tahu kita bahwa rata-rata sampel menjadi lebih akurat dan pola rata-rata tersebut menjadi dapat diprediksi. Kursus Intro to Statistics kami memiliki latihan untuk membiasakan Anda dengan hubungan dan perbedaan antara CLT dan hukum bilangan besar, jika Anda ingin mengeksplorasi bagian ini lebih jauh.
Cara yang bagus untuk melihat ini secara langsung adalah dengan melempar dadu. Jika kita melempar sekali, kita mendapatkan angka acak antara 1 dan 6. Namun setelah cukup banyak lemparan, rata-ratanya akan menetap di sekitar 3,5 (nilai rata-rata sebenarnya dari dadu adil). Lakukan ini berulang kali, dan distribusi rata-rata tersebut mulai terlihat seperti kurva normal.
Berikut rumus dasar teorema limit tengah:
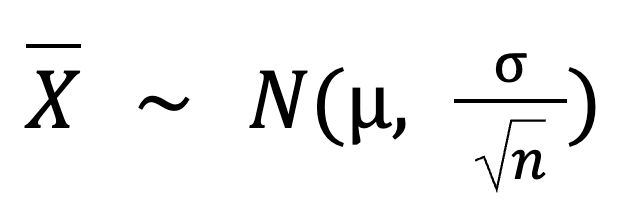
Dalam rumus ini:
X adalah distribusi penarikan sampel dari rata-rata sampel, yang mengikuti distribusi normal.
N adalah distribusi normal.
𝜇 adalah mean populasi.
σ adalah simpangan baku populasi.
n adalah ukuran sampel.
Saat ukuran sampel semakin besar, simpangan baku distribusi penarikan sampel menjadi lebih kecil. Semakin banyak data yang kita kumpulkan, semakin rapat rata-rata sampel kita berkumpul di sekitar mean populasi yang sebenarnya.
Agar teorema limit tengah bekerja seperti yang kita harapkan, ada beberapa kondisi yang perlu dipertimbangkan:
Misalkan kita ingin mengetahui berapa banyak cangkir kopi yang terjual per hari di sebuah kedai kopi lokal. Selama bertahun-tahun, jumlah cangkir yang terjual setiap hari mungkin mengikuti distribusi seperti yang saya sertakan di sini. Sebagian besar hari, mereka menjual antara 80 dan 120 cangkir. Namun pada hari-hari sibuk seperti liburan atau acara khusus, mereka menjual 150 atau bahkan 180 cangkir. Dalam kasus ini datanya agak condong (tidak merata).
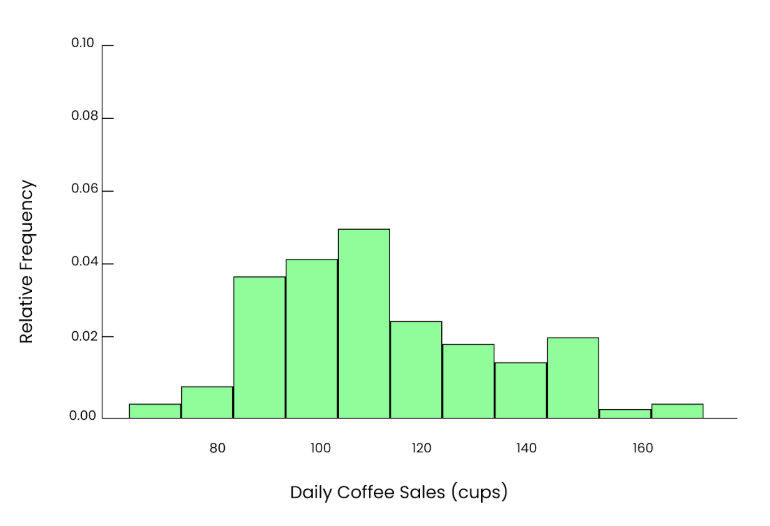
Grafik tidak merata. Gambar oleh Penulis.
Misalkan kita mengambil sampel kecil. Kita secara acak memilih 5 hari dari setahun dan melihat berapa banyak cangkir yang terjual pada hari-hari tersebut.
95, 102, 85, 110, 120Rata-rata yang kita peroleh dari sampel ini adalah:
Mean = 95+102+85+110+1205 = 102.4 cups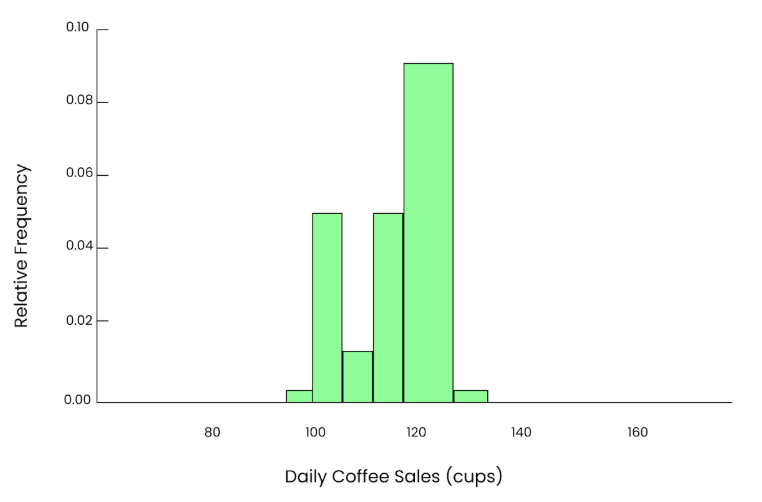
Grafik 5 cangkir. Gambar oleh Penulis.
Itu memberi kita satu perkiraan mean populasi, tetapi karena sampelnya kecil, mungkin tidak tepat. Jika kita mengulangi proses ini 10 kali, setiap kali secara acak memilih 5 hari, menghitung rata-rata, dan mencatat hasilnya. Sepuluh rata-rata sampel tersebut adalah:
97.6, 105.8, 93.4, 110.2, 99.0, 102.4, 101.2, 107.5, 96.3, 94.1Jika kita memplot nilai-nilai ini dalam histogram, kita akan melihat bentuk lonceng yang kasar, tetapi mungkin masih tampak tidak merata. Dan sebaran rata-rata ini lebih kecil daripada sebaran di populasi.
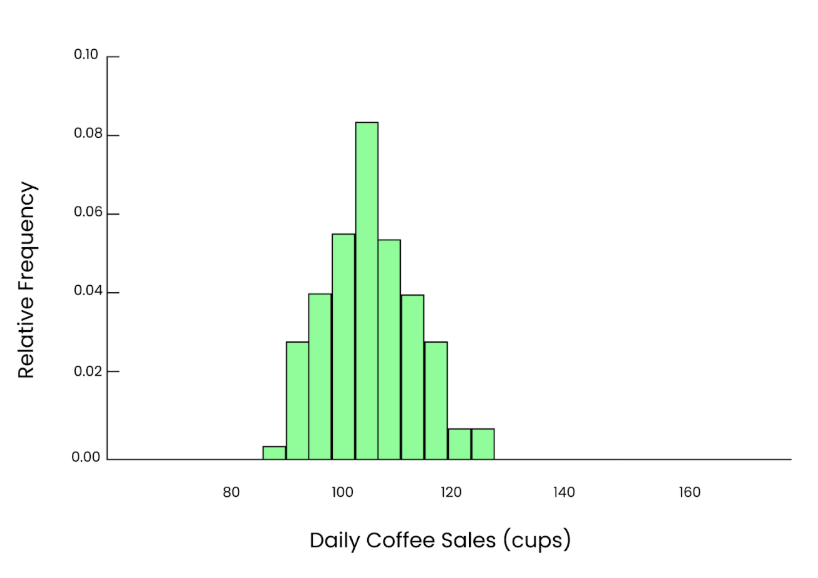
Grafik 10 cangkir. Gambar oleh Penulis.
Sekarang, mari ambil sampel yang lebih besar. Kali ini, kita secara acak memilih 50 hari dan menghitung rata-rata jumlah cangkir yang terjual:
98, 104, 87, 112, 105, 100, 108, 95, 102, 106,
92, 115, 97, 101, 109, 103, 96, 110, 104, 98,
100, 102, 89, 107, 94, 111, 108, 90, 100, 103,
106, 99, 96, 112, 105, 97, 100, 104, 93, 110,
107, 102, 95, 101, 99, 103, 109, 98, 94, 100
Saat kita menghitung rata-rata sampel ini, kita mendapatkan:
Mean = 101.2 cupsPerkiraan ini jauh lebih dekat dengan mean populasi 100, dan karena ukuran sampel kita lebih besar, ini adalah perkiraan yang lebih presisi.
Jika kita mengulangi proses ini berkali-kali, setiap kali secara acak memilih 50 hari, menghitung rata-ratanya, dan memplot rata-rata tersebut dalam histogram, meskipun data asalnya condong, kita akan melihat kurva lonceng yang halus dan jelas. Itulah kekuatan teorema limit tengah.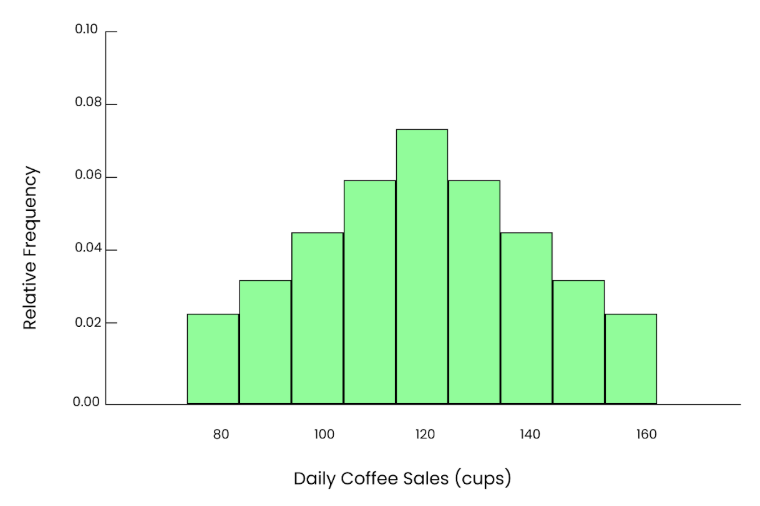
Grafik merata. Gambar oleh Penulis.
Kita bahkan dapat menghitung sebarannya menggunakan rumus ini:
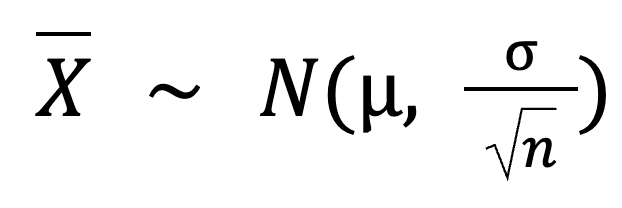 Berikut:
µ (mean populasi) = 100
σ (simpangan baku populasi) = 15
n (ukuran sampel) = 50
Jadi, simpangan baku rata-rata sampel kita adalah:
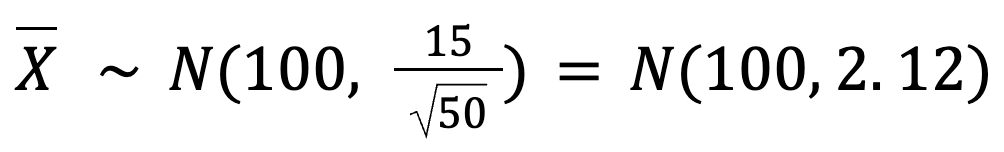
Ini memberi tahu kita bahwa rata-rata sampel akan sangat dekat dengan 100 cangkir dengan variasi kecil saja (sekitar 2,12 cangkir).
Kita tahu data di dunia nyata bisa aneh dan tidak dapat diprediksi. Namun teorema limit tengah memberi kita cara yang andal untuk memahami apa yang terjadi dan membuat keputusan yang lebih baik berdasarkan hal itu. Mari pahami pentingnya secara lebih rinci.
Dalam statistika, teorema limit tengah adalah alasan mengapa uji parametrik seperti uji t, ANOVA, dan regresi bekerja sebagaimana mestinya. Uji-uji ini didasarkan pada gagasan bahwa data sampel berasal dari populasi dengan karakteristik tetap.
Tanpa teorema limit tengah, kita tidak akan dapat mengandalkan uji-uji tersebut. Dan karena teorema ini, uji parametrik sering kali lebih kuat daripada uji nonparametrik, yang tidak membuat asumsi tentang distribusi data.
Teorema ini juga muncul di banyak situasi dunia nyata. Di bidang keuangan, analis menggunakannya untuk memperkirakan rerata imbal hasil saham berdasarkan kinerja masa lalu. Dalam jajak pendapat dan survei, teorema ini membuat prediksi tentang seluruh populasi dengan mengumpulkan sampel tanggapan. Dalam machine learning dan big data, kita menggunakannya ketika model dilatih pada sampel. Misalnya, aplikasi film dapat menggunakan sampel aktivitas pengguna untuk membangun sistem rekomendasinya.
Simpangan baku adalah angka yang memberi tahu kita seberapa menyebar nilai-nilai dari rata-rata. Saat kita melihat rata-rata sampel (rata-rata dari berbagai sampel), kita ingin tahu seberapa besar variasi rata-rata tersebut. Untuk itu, kita dapat menggunakan rumus ini:
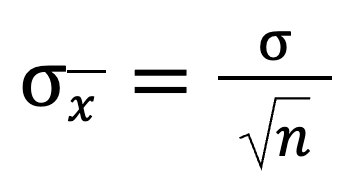
Ini memberi tahu kita bahwa ketika kita membagi simpangan baku populasi dengan akar kuadrat ukuran sampel, kita mendapatkan simpangan baku distribusi penarikan sampel. Saat ukuran sampel semakin besar, nilai keseluruhannya semakin kecil.
Mari lihat contoh singkat:
| Ukuran Sampel (n) | Rata-rata Sampel (μₓ̄) | Simp. Baku (σₓ̄) |
|---|---|---|
| 5 | 17 | 1.788854 |
| 10 | 17 | 1.264911 |
| 25 | 17 | 0.800000 |
| 50 | 17 | 0.565685 |
| 100 | 17 | 0.400000 |
Anda dapat melihat bahwa mean tetap sama, tetapi simpangan bakunya terus mengecil. Ini menunjukkan bahwa semakin besar sampel, semakin akurat dan konsisten hasilnya.
Dalam data science, kita biasanya berurusan dengan sampel, bukan seluruh populasi. CLT membantu kita memahami bagaimana hasil sampel tersebut berperilaku dan memberi tahu kita bahwa jika kita mengambil cukup banyak sampel, rata-ratanya akan mulai terlihat seperti distribusi normal, bahkan jika data asalnya sama sekali tidak demikian.
Ini juga memiliki manfaat besar di dunia nyata. Dalam machine learning, kita sering menggunakan teknik seperti bootstrapping untuk memperkirakan nilai. Berkat CLT, kita dapat yakin bahwa perkiraan tersebut akurat.
CLT juga berperan penting dalam A/B testing. Saat perusahaan mencoba dua versi laman web atau fitur, CLT membantu kita menentukan apakah hasilnya bermakna atau hanya derau acak.
Bahkan dalam reinforcement learning, di mana sistem belajar melalui coba-coba, CLT meredam kekacauan. Seiring semakin banyak data masuk, rata-rata menjadi lebih stabil, yang membantu sistem belajar lebih cepat dan lebih baik.
Terakhir, Anda juga akan menemukan CLT dalam pengujian hipotesis dan analisis deret waktu. CLT membantu data scientist menguji gagasan dan melacak tren dengan lebih percaya diri.
Teorema limit tengah mungkin terdengar teknis jika Anda baru dalam statistik, tetapi inilah alasan besar mengapa kita dapat melakukan hal-hal cerdas dengan data. Ia mengubah keacakan menjadi sesuatu yang dapat kita pahami dan percayai. Faktanya, ini adalah salah satu blok bangunan pemodelan statistik dan wajib diketahui bagi siapa pun yang bekerja dengan data.
Jika Anda ingin mengeksplorasi lebih jauh, bacalah tentang hukum bilangan besar dan distribusi probabilitas — semuanya saling terhubung.
Belajar bersama DataCamp
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



