Khi làm việc với dữ liệu thực tế, cỡ mẫu thường nhỏ hoặc phương sai tổng thể chưa biết. Đây là những điều kiện mà các kỹ thuật thống kê truyền thống dựa trên phân phối chuẩn có thể không còn phù hợp. Lúc này, phân phối t, còn gọi là phân phối t của Student, trở nên hữu ích. Đây là một công cụ mạnh để đưa ra suy luận thống kê đáng tin cậy khi dữ liệu hạn chế hoặc mức độ bất định cao.
Trong bài viết này, chúng ta sẽ tìm hiểu phân phối t là gì, cách so sánh với các phân phối tương tự, các tính chất toán học chính, và cách sử dụng trong thực tiễn, đặc biệt trong kiểm định giả thuyết và khoảng tin cậy. Tôi cũng đính kèm một bảng phân phối t ở cuối để bạn tham khảo nhanh.
Phân phối t là gì?
Tương tự phân phối chuẩn, phân phối t cũng đối xứng và có dạng hình chuông. Tuy nhiên, nó có phần đuôi dày hơn, phản ánh mức độ bất định lớn hơn thường đi kèm với cỡ mẫu nhỏ.
Ngoài ra, còn một yếu tố quan trọng khác tạo nên sự khác biệt của phân phối t: nó được xác định bởi số bậc tự do (df). Giá trị df này được tính bằng kích thước mẫu trừ đi một (n − 1) và ảnh hưởng đến hình dạng của phân phối.
Khi số bậc tự do tăng, phân phối t trở nên giống với phân phối chuẩn hơn. Khi cỡ mẫu lớn (ví dụ, n > 30), khác biệt trở nên rất nhỏ đến mức phân phối t bắt đầu giống đường cong chuẩn tắc.
Phân phối t so với các phân phối tương tự
So sánh phân phối t với các phân phối tương tự sẽ hữu ích.
Phân phối t so với phân phối chuẩn
Dù cả hai đều có dạng hình chuông, với phân phối t có phần đuôi dày hơn và phù hợp hơn cho mẫu nhỏ và phương sai tổng thể chưa biết, điều đặc biệt quan trọng là nhấn mạnh khả năng chịu ảnh hưởng ngoại lệ tốt hơn của nó.
|
Đặc điểm |
Phân phối t |
Phân phối chuẩn |
|
Hình dạng |
Hình chuông, đuôi dày hơn |
Hình chuông, đuôi mảnh hơn |
|
Trường hợp sử dụng |
Mẫu nhỏ, σ chưa biết |
Mẫu lớn, σ đã biết |
|
Bậc tự do |
Bắt buộc |
Không áp dụng |
|
Độ nhạy với ngoại lệ |
Khoan dung hơn |
Kém khoan dung hơn |
Với mẫu lớn, định lý giới hạn trung tâm biện minh cho việc dùng phân phối chuẩn, vì trung bình mẫu có xu hướng tuân theo phân phối chuẩn bất kể hình dạng phân phối của tổng thể.
Phân phối t so với phân phối Z
Phân phối Z là phân phối chuẩn tắc, có trung bình bằng 0 và độ lệch chuẩn bằng 1.
|
Đặc điểm |
Phân phối t |
Phân phối Z |
|
Phương sai đã biết? |
Không |
Có |
|
Độ dày đuôi |
Dày hơn |
Mảnh hơn |
|
Kiểm định phổ biến |
T-test |
Z-test |
|
Dùng cho mẫu nhỏ |
Có |
Không |
Hãy hiểu điều này qua một ví dụ mã Python:
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import t, norm

# X-axis range
x = np.linspace(-5, 5, 1000)

# Standard Normal (Z) Distribution
z_dist = norm.pdf(x)

# Plotting
plt.figure(figsize=(10, 6))
plt.plot(x, z_dist, label='Z-Distribution (Standard Normal)', color='black', linewidth=2)

# T-Distributions with different degrees of freedom
dfs = [1, 3, 5, 10, 30]
colors = ['red', 'orange', 'green', 'blue', 'purple']

for df, color in zip(dfs, colors):
    t_dist = t.pdf(x, df)
    plt.plot(x, t_dist, label=f'T-Distribution (df={df})', color=color, linestyle='--')

plt.title('T-Distribution vs Z-Distribution: Heavier Tails for Smaller Sample Sizes')
plt.xlabel('x')
plt.ylabel('Density')
plt.legend()
plt.grid(True)
plt.show()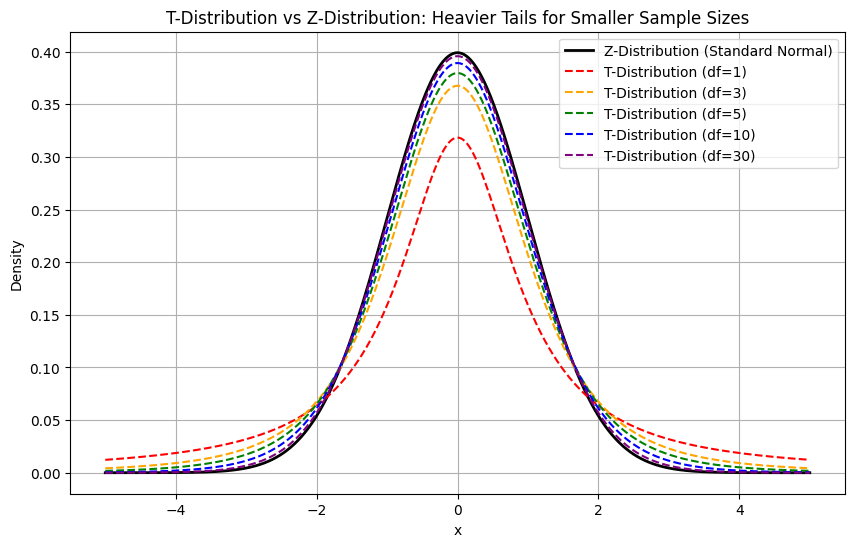
Trường hợp đặc biệt và các phân phối liên quan
Phân phối t có quan hệ chặt chẽ với một số phân phối xác suất khác:
- Phân phối chuẩn tắc (khi df → ∞): Phân phối t hội tụ về phân phối chuẩn khi số bậc tự do tăng.
- Phân phối Cauchy (df = 1): Phân phối t với 1 bậc tự do tương đương với phân phối Cauchy, nổi tiếng vì có trung bình và phương sai không xác định, đồng nghĩa phân phối t với một bậc tự do hiếm khi được dùng trong thực tế.
- Phân phối F: Bình phương của một biến tuân theo phân phối t với ν bậc tự do sẽ tuân theo phân phối F với (1, ν) bậc tự do.
- Phân phối t không tâm: Được dùng trong phân tích lực kiểm định và các ứng dụng thống kê nâng cao, phiên bản này có tham số không tâm, xuất hiện khi giả thuyết không sai.
Hạn chế của phân phối t
Phân phối t giả định dữ liệu nền xấp xỉ phân phối chuẩn. Trong các trường hợp dữ liệu lệch mạnh hoặc không chuẩn, nó có thể không phù hợp. Các kỹ thuật thống kê vững hoặc phương pháp phi tham số có thể thích hợp hơn.
Giờ hãy so sánh cách t-test hoạt động trên dữ liệu chuẩn so với dữ liệu lệch, cả hai có cùng trung bình.
import numpy as np
import scipy.stats as stats
import matplotlib.pyplot as plt

np.random.seed(42)

# Generate data
normal_data = np.random.normal(loc=0, scale=1, size=30)
skewed_data = np.random.exponential(scale=1.0, size=30) - 1  # Shift to mean ≈ 0

# Perform one-sample t-tests (test if mean == 0)
t_stat_normal, p_normal = stats.ttest_1samp(normal_data, popmean=0)
t_stat_skewed, p_skewed = stats.ttest_1samp(skewed_data, popmean=0)

# Plot histograms
plt.figure(figsize=(12, 5))

plt.subplot(1, 2, 1)
plt.hist(normal_data, bins=15, color='skyblue', edgecolor='black')
plt.title(f'Normal Data\np-value = {p_normal:.3f}')
plt.axvline(0, color='red', linestyle='--')

plt.subplot(1, 2, 2)
plt.hist(skewed_data, bins=15, color='salmon', edgecolor='black')
plt.title(f'Skewed Data\np-value = {p_skewed:.3f}')
plt.axvline(0, color='red', linestyle='--')

plt.suptitle("Impact of Data Shape on t-test")
plt.tight_layout()
plt.show()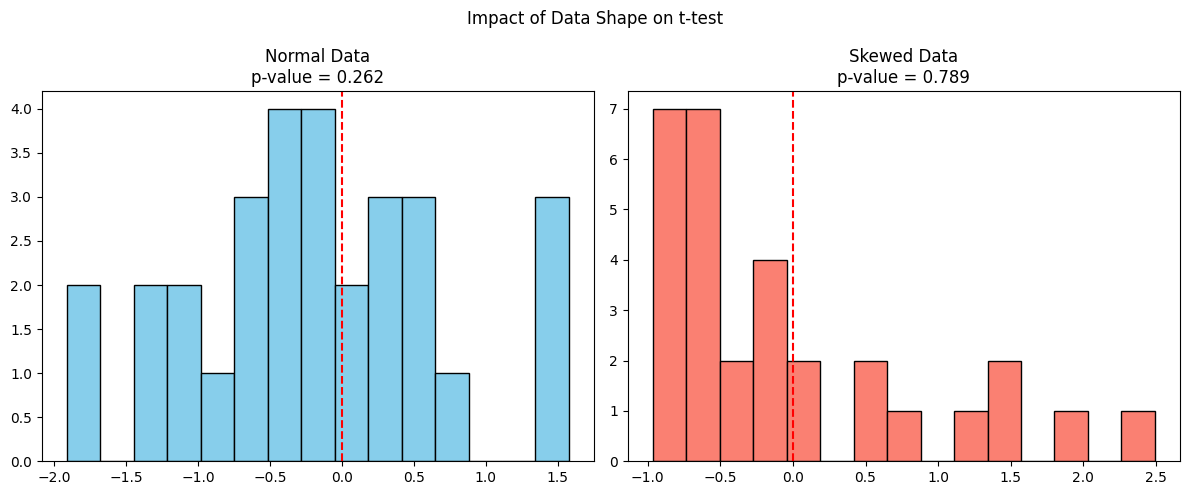
Biểu đồ bên trái thể hiện dữ liệu từ phân phối chuẩn, nơi t-test có hiệu lực và p-value đáng tin cậy. Trong khi biểu đồ bên phải thể hiện dữ liệu lệch từ phân phối mũ, dù trung bình mẫu có thể tương tự, t-test giả định tính đối xứng và không tính đến độ lệch, có thể dẫn đến p-value không chính xác.
Các tính chất toán học của phân phối t
Phân phối t được định nghĩa như sau:
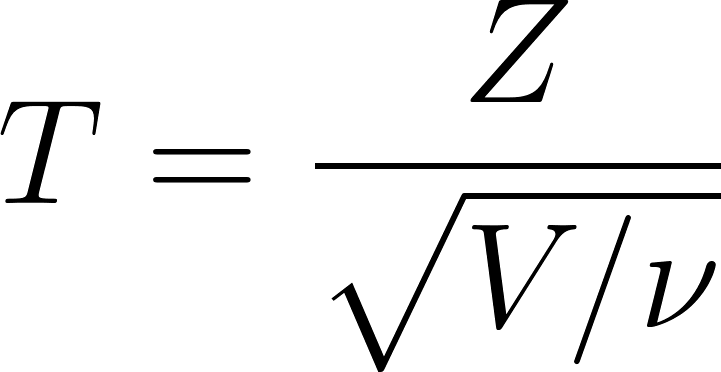
Trong đó:
- T là giá trị thu được tuân theo phân phối t của Student với ν bậc tự do
- Z là biến ngẫu nhiên chuẩn tắc Z∼N(0,1)
- V là biến ngẫu nhiên tuân theo phân phối chi-bình phương với ν bậc tự do, V∼χ2(ν)
- v là tham số bậc tự do, thường bằng n−1, trong đó là kích thước mẫu.
Hàm mật độ xác suất (PDF)
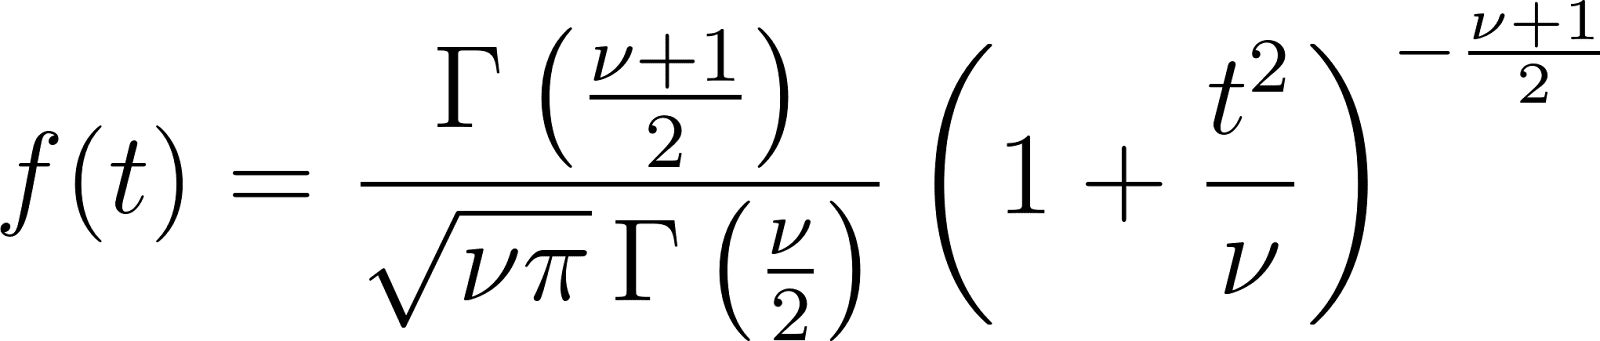
Các tính chất chính
- Trung bình: 0 (với v > 1)
- Phương sai: v / (v - 2) (với v > 2)
- Độ lệch: 0 (phân phối đối xứng)
- Độ nhọn: Cao hơn phân phối chuẩn (leptokurtic)
Mô phỏng
Các phương pháp Monte Carlo thường được dùng để mô phỏng các biến ngẫu nhiên tuân theo phân phối t, đặc biệt khi đánh giá ý nghĩa thống kê hoặc tạo dữ liệu tổng hợp.
Hãy mô phỏng điều này bằng Python.
Mục tiêu là mô phỏng số lượng lớn các thí nghiệm với mẫu nhỏ (kích thước mẫu = 10), tính thống kê t cho mỗi thí nghiệm, và so sánh phân phối thu được với phân phối t lý thuyết.
Để làm điều này, ta thực hiện theo hướng tiếp cận sau:
- Sinh nhiều mẫu từ phân phối chuẩn (trung bình = 0, độ lệch chuẩn = 1).
- Với mỗi mẫu, tính thống kê t: (Lấy trung bình mẫu xˉ trừ đi trung bình tổng thể μ, rồi chia cho sai số chuẩn của trung bình, tức là độ lệch chuẩn mẫu chia căn bậc hai kích thước mẫu n)
- Vẽ biểu đồ tần suất của các giá trị t mô phỏng.
- Chồng lên đường cong phân phối t lý thuyết để so sánh.
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import t

# Simulation parameters
n = 10                      # sample size
mu = 0                      # population mean
sigma = 1                   # population std deviation (not used directly)
df = n - 1                  # degrees of freedom
num_simulations = 10000     # number of Monte Carlo simulations

# Monte Carlo simulation
t_stats = []
for _ in range(num_simulations):
    sample = np.random.normal(loc=mu, scale=sigma, size=n)
    sample_mean = np.mean(sample)
    sample_std = np.std(sample, ddof=1)  # sample std dev with Bessel's correction
    t_stat = (sample_mean - mu) / (sample_std / np.sqrt(n))
    t_stats.append(t_stat)

# Plot histogram of simulated t-statistics
x = np.linspace(-5, 5, 1000)
plt.figure(figsize=(10, 6))
plt.hist(t_stats, bins=50, density=True, alpha=0.6, label='Simulated t-Statistics')

# Overlay theoretical t-distribution
plt.plot(x, t.pdf(x, df), label=f'Theoretical t-Distribution (df={df})', color='red', linewidth=2)

plt.title('Monte Carlo Simulation of t-Distribution (n=10)')
plt.xlabel('t-value')
plt.ylabel('Density')
plt.legend()
plt.grid(True)
plt.show()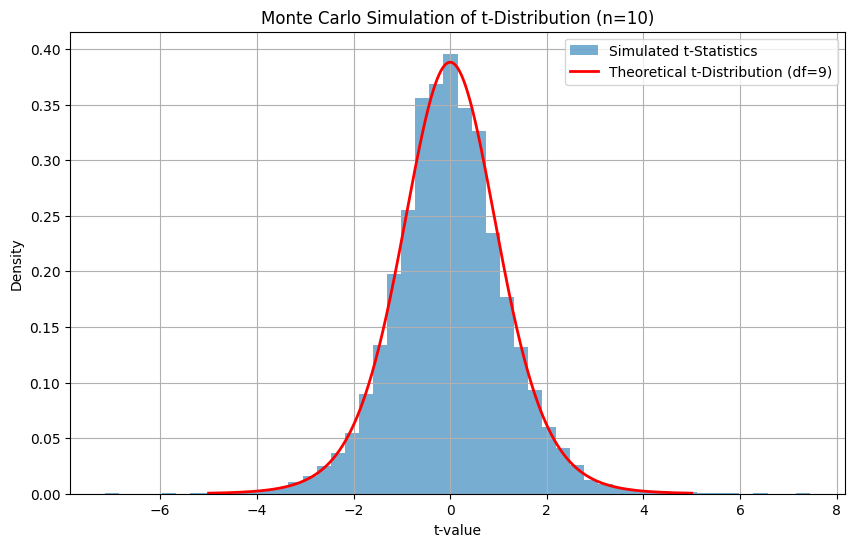
Các giá trị t mô phỏng tạo thành một phân phối khớp chặt chẽ với phân phối t lý thuyết với df = 9. Đây là cách thực tiễn để hiểu và kiểm chứng phân phối t thông qua lấy mẫu ngẫu nhiên. Nó cũng là nền tảng của bootstrapping và suy luận dựa trên tái lấy mẫu.
Khi nào nên dùng phân phối t
Phân phối t là nền tảng trong nhiều ứng dụng thống kê:
- Ước lượng trung bình tổng thể khi độ lệch chuẩn chưa biết
- Kiểm định giả thuyết bằng t-test
- Khoảng tin cậy cho mẫu nhỏ
- Phân tích hồi quy, nơi các hệ số tuân theo phân phối t
- Suy luận Bayes, đặc biệt khi tham số phương sai được tích phân biên
Khoảng tin cậy với phân phối t
Khoảng tin cậy cho trung bình được tính như sau:
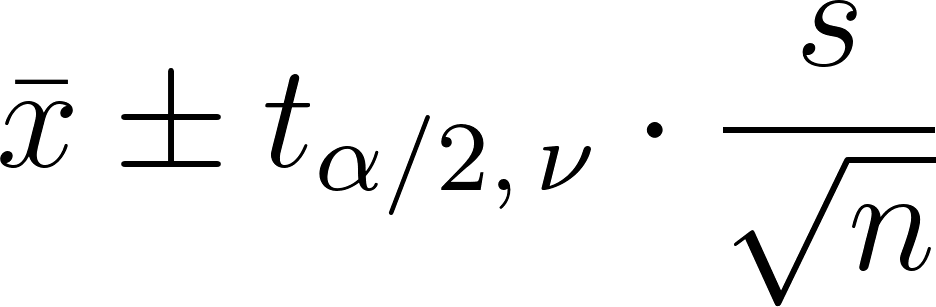
Trong đó:
- x là trung bình mẫu
- s là độ lệch chuẩn mẫu
- n là kích thước mẫu
- Và phần ở giữa là giá trị tới hạn từ phân phối t. (alpha là mức ý nghĩa, và chia alpha cho hai vì đây là bài toán hai đuôi.)
Hãy dùng bảng phân phối t hoặc máy tính để tìm giá trị tới hạn.
Kiểm định giả thuyết với phân phối t
Trong t-test, thống kê kiểm định là:
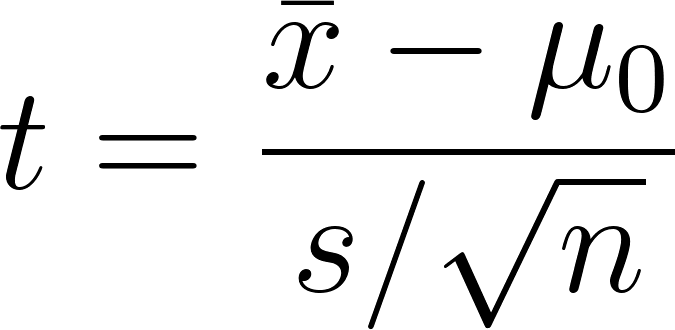
Bạn so sánh giá trị này với giá trị t tới hạn để chấp nhận hoặc bác bỏ giả thuyết không. T-test có thể là:
- Một mẫu
- Hai mẫu
- Cặp mẫu
Các minh họa đồ họa giúp hình dung vùng tới hạn trong kiểm định một đuôi và hai đuôi.
Bảng phân phối t
Bảng phân phối t liệt kê các giá trị tới hạn của phân phối t cho nhiều mức độ tin cậy và số bậc tự do khác nhau. Nó thiết yếu cho việc:
- Xác định khoảng tin cậy
- Thực hiện t-test
- Xác minh ý nghĩa trong hồi quy
Nếu hữu ích, tôi đã đính kèm một phiên bản rút gọn của bảng phân phối t để bạn tham khảo tại đây:
| df | 80% (1 đuôi) | 90% (2 đuôi) | 95% (2 đuôi) | 98% (2 đuôi) | 99% (2 đuôi) |
|---|---|---|---|---|---|
| 1 | 3.078 | 6.314 | 12.706 | 31.821 | 63.657 |
| 2 | 1.886 | 2.920 | 4.303 | 6.965 | 9.925 |
| 5 | 1.476 | 2.015 | 2.571 | 3.365 | 4.032 |
| 10 | 1.372 | 1.812 | 2.228 | 2.764 | 3.169 |
| 20 | 1.325 | 1.725 | 2.086 | 2.528 | 2.845 |
| 30 | 1.310 | 1.697 | 2.042 | 2.457 | 2.750 |
| 60 | 1.296 | 1.671 | 2.000 | 2.390 | 2.660 |
| ∞ | 1.282 | 1.645 | 1.960 | 2.326 | 2.576 |
Kết luận
Hy vọng bài viết này đã giúp bạn hiểu vững về phân phối t và thu hẹp khoảng cách giữa lý thuyết và thực tiễn. Đây là khái niệm cốt lõi trong thống kê để xử lý bất định, nhất là khi cỡ mẫu nhỏ hoặc tham số tổng thể chưa biết.
Hơn nữa, phân phối t sẽ còn xuất hiện khi chúng ta làm việc với các bài toán dữ liệu nâng cao hơn, như thống kê vững và phương pháp Bayes. Tôi khuyến nghị bạn đăng ký lộ trình nghề nghiệp Statistician in R của chúng tôi để thật sự trở thành chuyên gia.
