
Last chance! 50% off DataCamp Premium
Sale ends in

Tutorial ini akan memandu Anda cara menggunakan TensorBoard, sebuah utilitas luar biasa yang memungkinkan Anda memvisualisasikan data dan perilakunya. Anda akan melihat untuk tujuan apa saja Anda dapat menggunakannya saat melatih jaringan saraf.
Tip: lihat kursus Deep Learning DataCamp dengan Keras di sini.
Sebelum memulai, pastikan untuk mengimpor pustaka berikut agar kode berjalan dengan baik:
from pandas_datareader import data
import matplotlib.pyplot as plt
import pandas as pd
import datetime as dt
import urllib.request, json
import os
import numpy as np

# This code has been tested with TensorFlow 1.6
import tensorflow as tf
from tensorflow.examples.tutorials.mnist import input_data
Untuk memvisualisasikan melalui TensorBoard, Anda perlu memulai layanannya terlebih dahulu. Caranya,
python3, Anda akan mendapatkan prompt seperti >>>import tensorflow as tf>>>) dengan mengetik exit() dan ketik perintah berikut
tensorboard --logdir=summaries--logdir adalah direktori tempat Anda akan membuat data untuk divisualisasikan--port=<port_you_like> untuk mengubah port tempat TensorBoard berjalanTensorBoard 1.6.0 at <url>:6006 (Press CTRL+C to quit)Catatan: TensorBoard tidak menyukai banyak event file dalam direktori yang sama. Ini dapat membuat kurva yang sangat buruk pada tampilan. Jadi Anda sebaiknya membuat folder terpisah untuk setiap contoh yang berbeda (misalnya, summaries/first, summaries/second, ...) untuk menyimpan data. Hal lain yang perlu diingat adalah, jika Anda ingin menjalankan ulang sebuah eksperimen (yaitu menyimpan event file ke folder yang sudah berisi data), Anda harus memastikan untuk menghapus terlebih dahulu event file yang ada.
Tampilan yang berbeda menerima masukan dengan format yang berbeda dan menampilkannya dengan cara yang berbeda. Anda dapat mengubahnya pada bilah atas berwarna oranye.
Dalam tutorial ini, Anda akan membahas tampilan yang dicetak tebal.
Pada bagian ini, Anda akan terlebih dahulu memahami mengapa memvisualisasikan metrik tertentu (misalnya loss atau akurasi) itu bermanfaat. Saat melatih deep neural networks, salah satu masalah krusial yang sering dialami pemula adalah kurangnya pemahaman terhadap efek dari berbagai pilihan desain dan hiperparameter.
Misalnya, jika Anda secara ceroboh menginisialisasi bobot jaringan saraf dalam dengan varians yang sangat besar antar bobot, model Anda akan cepat menyimpang dan kolaps. Di sisi lain, hal-hal juga bisa salah bahkan saat Anda cukup mahir menjinakkan jaringan saraf untuk dimanfaatkan. Misalnya, tidak memperhatikan laju pembelajaran dapat menyebabkan model menyimpang atau terlalu cepat jenuh pada kinerja suboptimal.
Salah satu cara cepat mendeteksi masalah pada model Anda adalah memiliki visualisasi grafis tentang apa yang terjadi pada model secara real time (misalnya, setiap 100 iterasi). Jadi jika model Anda berperilaku aneh, itu akan terlihat jelas. Itulah yang disediakan TensorBoard. Anda dapat memutuskan nilai mana yang perlu ditampilkan dan TensorBoard akan mempertahankan visualisasi real time dari nilai-nilai tersebut selama pembelajaran.
Anda memulai dengan membuat jaringan saraf lima lapis yang akan digunakan untuk mengklasifikasikan gambar digit tulisan tangan. Untuk itu Anda akan menggunakan dataset MNIST yang terkenal. TensorFlow menyediakan API sederhana untuk memuat data MNIST, jadi Anda tidak perlu mengunduhnya secara manual. Sebelum itu Anda mendefinisikan metode sederhana (accuracy()) yang menghitung akurasi beberapa prediksi terhadap label sebenarnya.
def accuracy(predictions,labels):
    '''
    Accuracy of a given set of predictions of size (N x n_classes) and
    labels of size (N x n_classes)
    '''
    return np.sum(np.argmax(predictions,axis=1)==np.argmax(labels,axis=1))*100.0/labels.shape[0]
Pertama, definisikan batch_size yang menyatakan jumlah data yang Anda ambil pada satu langkah optimisasi/validasi atau pengujian. Lalu Anda mendefinisikan layer_ids, yang memberikan pengenal untuk setiap lapisan jaringan saraf yang akan Anda definisikan. Setelah itu Anda dapat mendefinisikan layer_sizes.
Perhatikan bahwa len(layer_sizes) harus len(layer_ids)+1, karena layer_sizes menyertakan ukuran input di awal.
MNIST memiliki gambar berukuran 28x28, yang akan menjadi 784 saat diratakan ke satu dimensi. Lalu Anda dapat mendefinisikan placeholder input dan label, yang nantinya akan digunakan untuk melatih model. Terakhir, Anda mendefinisikan dua variabel TensorFlow untuk setiap lapisan (weights dan bias).
Anda dapat menggunakan variable scoping (info lebih lanjut di sini) agar variabel diberi nama dengan rapi dan lebih mudah diakses nanti.
batch_size = 100
layer_ids = ['hidden1','hidden2','hidden3','hidden4','hidden5','out']
layer_sizes = [784, 500, 400, 300, 200, 100, 10]

tf.reset_default_graph()

# Inputs and Labels
train_inputs = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[0]], name='train_inputs')
train_labels = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[-1]], name='train_labels')

# Weight and Bias definitions
for idx, lid in enumerate(layer_ids):

    with tf.variable_scope(lid):
        w = tf.get_variable('weights',shape=[layer_sizes[idx], layer_sizes[idx+1]],
                            initializer=tf.truncated_normal_initializer(stddev=0.05))
        b = tf.get_variable('bias',shape= [layer_sizes[idx+1]],
                            initializer=tf.random_uniform_initializer(-0.1,0.1))
Dengan placeholder input/output, bobot, dan bias tiap lapisan telah didefinisikan, kini Anda dapat mendefinisikan perhitungan untuk menghitung logit dari jaringan saraf. Logit adalah nilai yang belum dinormalisasi yang dihasilkan di lapisan terakhir jaringan saraf. Setelah dinormalisasi, Anda menyebutnya prediksi. Ini melibatkan iterasi melalui tiap lapisan jaringan saraf dan menghitung tf.matmul(h,w) +b. Anda juga perlu menerapkan fungsi aktivasi seperti tf.nn.relu(tf.matmul(h,w) +b) untuk semua lapisan kecuali yang terakhir.
Selanjutnya, Anda mendefinisikan fungsi loss yang digunakan untuk mengoptimalkan jaringan saraf. Dalam contoh ini, Anda dapat menggunakan cross entropy loss, yang sering memberikan hasil lebih baik pada masalah klasifikasi dibandingkan mean squared error.
Terakhir, Anda perlu mendefinisikan optimizer yang menerima loss dan memperbarui bobot jaringan saraf ke arah yang meminimalkan loss.
# Calculating Logits
h = train_inputs
for lid in layer_ids:
    with tf.variable_scope(lid,reuse=True):
        w, b = tf.get_variable('weights'), tf.get_variable('bias')
        if lid != 'out':
          h = tf.nn.relu(tf.matmul(h,w)+b,name=lid+'_output')
        else:
          h = tf.nn.xw_plus_b(h,w,b,name=lid+'_output')

tf_predictions = tf.nn.softmax(h, name='predictions')
# Calculating Loss
tf_loss = tf.reduce_mean(tf.nn.softmax_cross_entropy_with_logits_v2(labels=train_labels, logits=h),name='loss')

# Optimizer
tf_learning_rate = tf.placeholder(tf.float32, shape=None, name='learning_rate')
optimizer = tf.train.MomentumOptimizer(tf_learning_rate,momentum=0.9)
grads_and_vars = optimizer.compute_gradients(tf_loss)
tf_loss_minimize = optimizer.minimize(tf_loss)
Di sini Anda dapat mendefinisikan objek tf.summary. Objek-objek ini adalah entitas yang dipahami oleh TensorBoard. Artinya, nilai apa pun yang ingin Anda tampilkan, sebaiknya dibungkus sebagai objek tf.summary.
Ada beberapa jenis summary. Di sini, karena Anda hanya memvisualisasikan skalar, Anda dapat mendefinisikan objek tf.summary.scalar. Selain itu, Anda dapat menggunakan tf.name_scope untuk mengelompokkan skalar pada papan. Artinya, skalar dengan name scope yang sama akan ditampilkan pada baris yang sama. Di sini Anda mendefinisikan tiga summary yang berbeda.
tf_loss_summary : Anda memberikan nilai melalui placeholder setiap kali Anda perlu menerbitkannya ke papantf_accuracy_summary : Anda memberikan nilai melalui placeholder setiap kali Anda perlu menerbitkannya ke papantf_gradnorm_summary : ini menghitung norma l2 dari gradien lapisan terakhir jaringan saraf Anda. Norma gradien adalah indikator yang baik apakah bobot jaringan saraf diperbarui dengan benar. Norma gradien yang terlalu kecil dapat mengindikasikan fenomena vanishing gradient atau gradien yang terlalu besar dapat menyiratkan fenomena exploding gradient.# Name scope allows you to group various summaries together
# Summaries having the same name_scope will be displayed on the same row
with tf.name_scope('performance'):
# Summaries need to be displayed
# Whenever you need to record the loss, feed the mean loss to this placeholder
tf_loss_ph = tf.placeholder(tf.float32,shape=None,name='loss_summary')
# Create a scalar summary object for the loss so it can be displayed
tf_loss_summary = tf.summary.scalar('loss', tf_loss_ph)
# Whenever you need to record the loss, feed the mean test accuracy to this placeholder
tf_accuracy_ph = tf.placeholder(tf.float32,shape=None, name='accuracy_summary')
# Create a scalar summary object for the accuracy so it can be displayed
tf_accuracy_summary = tf.summary.scalar('accuracy', tf_accuracy_ph)
# Gradient norm summary
for g,v in grads_and_vars:
if 'hidden5' in v.name and 'weights' in v.name:
with tf.name_scope('gradients'):
tf_last_grad_norm = tf.sqrt(tf.reduce_mean(g**2))
tf_gradnorm_summary = tf.summary.scalar('grad_norm', tf_last_grad_norm)
break
# Merge all summaries together
performance_summaries = tf.summary.merge([tf_loss_summary,tf_accuracy_summary])
Pada kode di bawah ini Anda melakukan hal-hal berikut. Pertama, Anda membuat sesi, tempat Anda mengeksekusi operasi yang didefinisikan di atas. Lalu, Anda membuat folder untuk menyimpan summary data. Selanjutnya, Anda membuat summary writer summ_writer. Anda sekarang dapat menginisialisasi semua variabel. Setelah itu dilanjutkan dengan memuat dataset MNIST.
Kemudian, untuk setiap epoch, dan setiap batch dalam data pelatihan (yaitu, setiap iterasi), eksekusi gradnorm_summary jika ini adalah iterasi pertama dan tulis gradnorm_summary ke event file dengan summary writer. Sekarang Anda mengeksekusi optimisasi model dan perhitungan loss. Setelah melalui seluruh dataset pelatihan untuk satu epoch, hitung rata-rata loss pelatihan.
Anda melakukan perlakuan serupa untuk dataset validasi. Secara khusus, untuk setiap batch dalam data validasi, Anda menghitung akurasi validasi. Setelah itu, hitung rata-rata akurasi validasi untuk seluruh set validasi.
Terakhir, fase pengujian dijalankan. Di sini, untuk setiap batch dalam data uji, Anda menghitung akurasi uji untuk setiap batch. Dengan itu, Anda menghitung rata-rata akurasi uji untuk seluruh set uji. Di bagian akhir Anda mengeksekusi performance_summaries dan menuliskannya ke event file dengan summary writer.
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25

config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure Tensorflow doesn't overflow the GPU

session = tf.InteractiveSession(config=config)

if not os.path.exists('summaries'):
    os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','first')):
    os.mkdir(os.path.join('summaries','first'))

summ_writer = tf.summary.FileWriter(os.path.join('summaries','first'), session.graph)

tf.global_variables_initializer().run()

accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)


for epoch in range(n_epochs):
    loss_per_epoch = []
    for i in range(n_train//batch_size):

        # =================================== Training for one step ========================================
        batch = mnist_data.train.next_batch(batch_size)    # Get one batch of training data
        if i == 0:
            # Only for the first epoch, get the summary data
            # Otherwise, it can clutter the visualization
            l,_,gn_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary],
                                      feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                                 train_labels: batch[1],
                                                tf_learning_rate: 0.0001})
            summ_writer.add_summary(gn_summ, epoch)
        else:
            # Optimize with training data
            l,_ = session.run([tf_loss,tf_loss_minimize],
                              feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                         train_labels: batch[1],
                                         tf_learning_rate: 0.0001})
        loss_per_epoch.append(l)

    print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
    avg_loss = np.mean(loss_per_epoch)

    # ====================== Calculate the Validation Accuracy ==========================
    valid_accuracy_per_epoch = []
    for i in range(n_valid//batch_size):
        valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
        valid_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
        valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))

    mean_v_acc = np.mean(valid_accuracy_per_epoch)
    print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))

    # ===================== Calculate the Test Accuracy ===============================
    accuracy_per_epoch = []
    for i in range(n_test//batch_size):
        test_images, test_labels = mnist_data.test.next_batch(batch_size)
        test_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: test_images.reshape(batch_size,image_size*image_size)}
        )
        accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))

    print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
    avg_test_accuracy = np.mean(accuracy_per_epoch)

    # Execute the summaries defined above
    summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})

    # Write the obtained summaries to the file, so it can be displayed in the TensorBoard
    summ_writer.add_summary(summ, epoch)

session.close()
Successfully downloaded train-images-idx3-ubyte.gz 9912422 bytes.
Extracting MNIST_data/train-images-idx3-ubyte.gz
Successfully downloaded train-labels-idx1-ubyte.gz 28881 bytes.
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Successfully downloaded t10k-images-idx3-ubyte.gz 1648877 bytes.
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Successfully downloaded t10k-labels-idx1-ubyte.gz 4542 bytes.
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 2.30252
    Average Valid Accuracy in epoch 0: 10.02000
    Average Test Accuracy in epoch 0: 9.76000

Average loss in epoch 1: 2.30016
    Average Valid Accuracy in epoch 1: 12.56000
    Average Test Accuracy in epoch 1: 12.64000

  ...
  ...
  ...

Average loss in epoch 24: 1.03386
    Average Valid Accuracy in epoch 24: 71.88000
    Average Test Accuracy in epoch 24: 71.23000
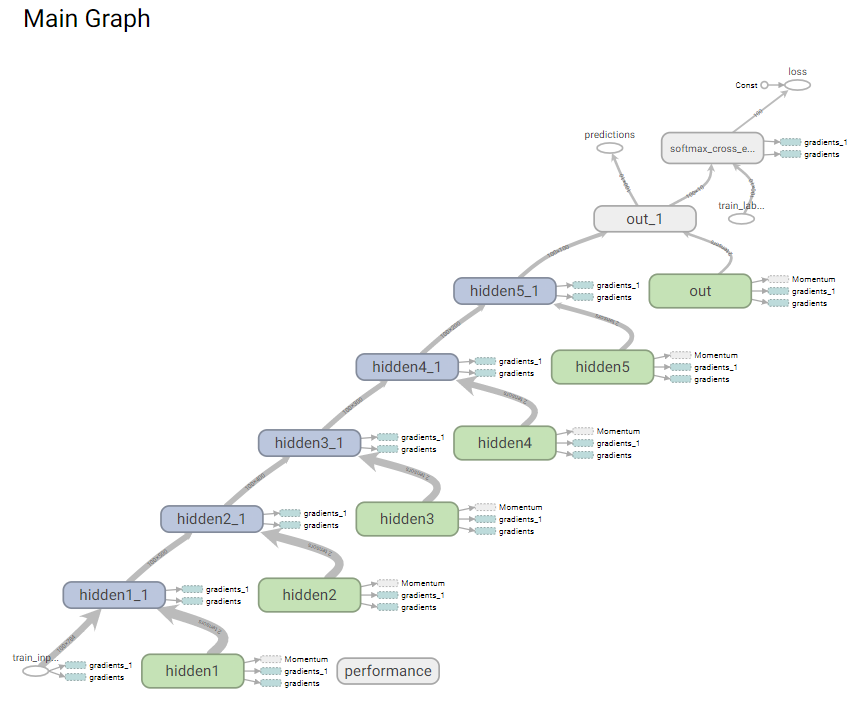
Pertama, Anda akan melihat seperti apa computational graph dari model Anda. Anda dapat mengakses tampilan ini dengan mengklik tampilan Graphs di TensorBoard. Tampilan ini seharusnya terlihat seperti gambar di bawah. Anda dapat melihat alur yang rapi dari train_inputs ke loss dan predictions melalui hidden layer 1 hingga 5.
Klasifikasi MNIST adalah salah satu contoh paling sederhana, dan ini pun masih tidak dapat diselesaikan dengan jaringan saraf 5 lapis. Untuk MNIST, tidak sulit mencapai akurasi lebih dari 90% dalam kurang dari 5 epoch.
Lalu apa yang terjadi di sini?
Mari melihat TensorBoard:
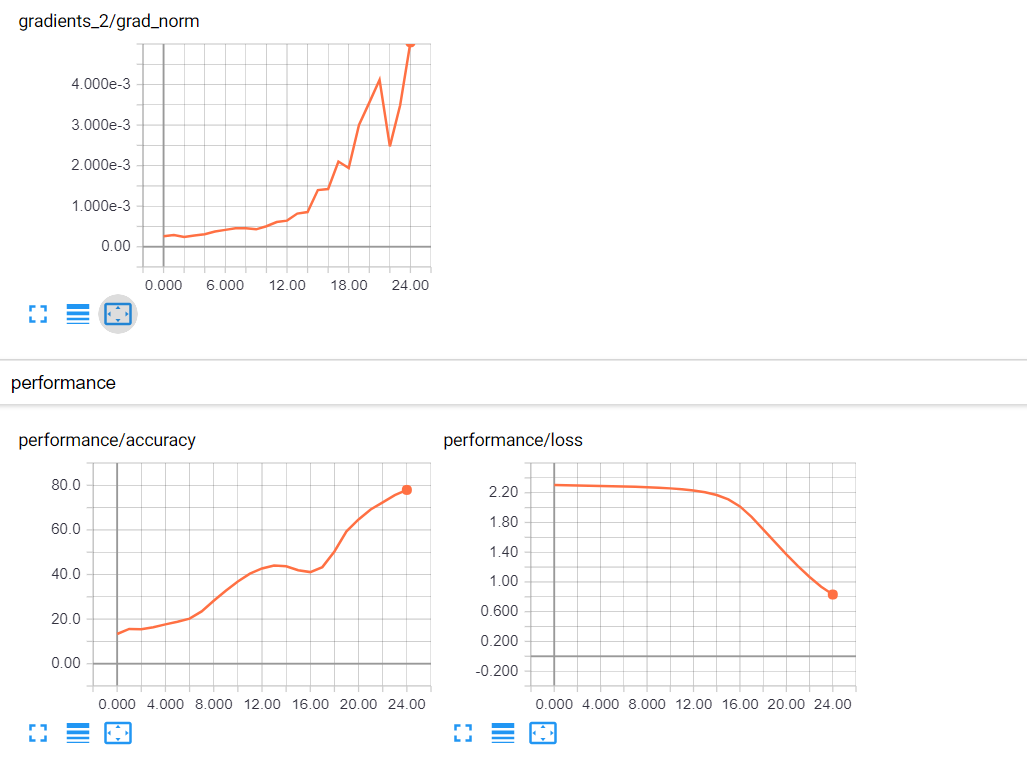
Anda dapat melihat bahwa akurasi meningkat, tetapi sangat lambat, dan pembaruan gradien meningkat seiring waktu. Ini perilaku yang aneh. Jika Anda mendekati konvergensi, Anda seharusnya melihat gradien mengecil (mendekati nol), bukan meningkat. Namun karena akurasi meningkat, Anda berada di jalur yang benar. Anda mungkin memerlukan laju pembelajaran yang lebih tinggi.
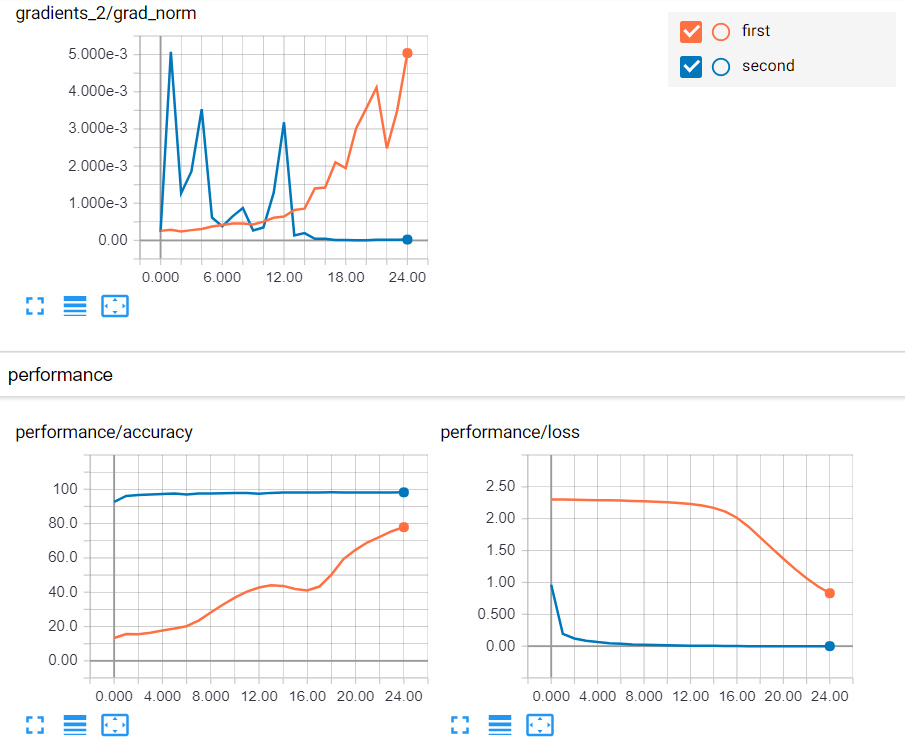
Sekarang Anda dapat mencoba laju pembelajaran 0.01. Ini hampir identik dengan eksekusi jaringan saraf sebelumnya, kecuali Anda akan menggunakan 0.01 alih-alih 0.0001. Alih-alih tf_learning_rate: 0.0001, gunakan tf_learning_rate: 0.01. Ingat ada dua tempat yang perlu Anda ganti argumennya.
Sekarang Anda dapat melihat bahwa akurasi mulai mendekati 100 dan terus meningkat. Dan Anda dapat melihat bahwa pembaruan gradien juga berkurang seiring waktu dan mendekati nol. Semuanya tampak jauh lebih baik dengan laju pembelajaran 0.01.
Berikutnya, mari melampaui skalar. Anda akan melihat bagaimana menganalisis vektor skalar dan kumpulan skalar.
Anda telah melihat manfaat memvisualisasikan skalar melalui TensorBoard, yang memungkinkan Anda melihat perilaku model dan memperbaiki potensi masalah pada model. Selain itu, memvisualisasikan graph memungkinkan Anda melihat bahwa ada tautan tanpa putus dari input ke prediksi, yang diperlukan untuk perhitungan gradien.
Sekarang, Anda akan melihat tampilan lain yang berguna di TensorBoard; histogram atau distribusi.
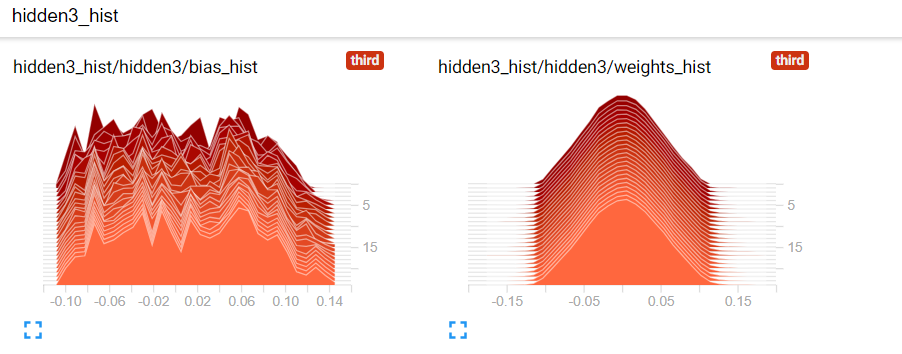
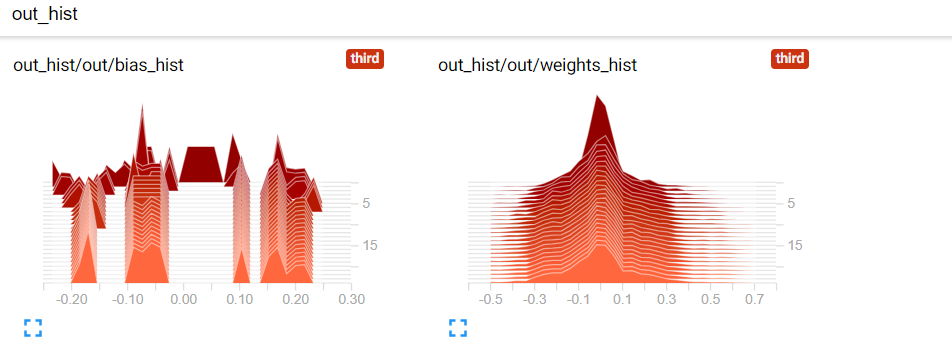
Ingat bahwa histogram adalah kumpulan nilai yang direpresentasikan oleh frekuensi/kepadatan yang dimiliki nilai tersebut dalam koleksi. Anda dapat menggunakan histogram untuk memvisualisasikan nilai bobot jaringan dari waktu ke waktu. Memvisualisasikan bobot jaringan itu penting, karena jika bobot melompat tidak menentu selama pembelajaran, ini menandakan ada yang salah dengan inisialisasi bobot atau laju pembelajaran.
Anda akan melihat bagaimana bobot berubah pada contoh ini. Jika Anda melihat kodenya, ia menggunakan truncated_normal_initializer() untuk menginisialisasi bobot.
Di sini Anda kembali mendefinisikan objek tf.summary. Namun, kini Anda memvisualisasikan vektor skalar sehingga Anda perlu mendefinisikan objek tf.summary.histogram.
Dalam kasus ini, Anda mendefinisikan dua objek histogram (tf_w_hist dan tf_b_hist) yang berisi bobot dan bias dari suatu lapisan. Anda akan mendefinisikan objek histogram seperti itu untuk semua lapisan dan setiap lapisan akan memiliki name scope sendiri.
Terakhir, Anda dapat menggunakan operasi tf.summary.merge untuk membuat operasi terkelompok yang mengeksekusi semua summary ini sekaligus.
# Summaries need to be displayed
# Create a summary for each weight bias in each layer
all_summaries = []
for lid in layer_ids:
    with tf.name_scope(lid+'_hist'):
        with tf.variable_scope(lid,reuse=True):
            w,b = tf.get_variable('weights'), tf.get_variable('bias')

            # Create a scalar summary object for the loss so it can be displayed
            tf_w_hist = tf.summary.histogram('weights_hist', tf.reshape(w,[-1]))
            tf_b_hist = tf.summary.histogram('bias_hist', b)
            all_summaries.extend([tf_w_hist, tf_b_hist])

# Merge all parameter histogram summaries together
tf_param_summaries = tf.summary.merge(all_summaries)
Langkah ini hampir sama seperti yang Anda lakukan sebelumnya, tetapi di sini Anda memiliki beberapa baris tambahan untuk menghitung histogram summary (tf_param_summaries).
Catatan bahwa laju pembelajaran juga berubah lagi.
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25

config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure Tensorflow doesn't overflow the GPU

session = tf.InteractiveSession(config=config)

if not os.path.exists('summaries'):
    os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','third')):
    os.mkdir(os.path.join('summaries','third'))

summ_writer_3 = tf.summary.FileWriter(os.path.join('summaries','third'), session.graph)

tf.global_variables_initializer().run()

accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)


for epoch in range(n_epochs):
    loss_per_epoch = []
    for i in range(n_train//batch_size):

        # =================================== Training for one step ========================================
        batch = mnist_data.train.next_batch(batch_size)    # Get one batch of training data
        if i == 0:
            # Only for the first epoch, get the summary data
            # Otherwise, it can clutter the visualization
            l,_,gn_summ, wb_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary, tf_param_summaries],
                                      feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                                 train_labels: batch[1],
                                                tf_learning_rate: 0.00001})
            summ_writer_3.add_summary(gn_summ, epoch)
            summ_writer_3.add_summary(wb_summ, epoch)
        else:
            # Optimize with training data
            l,_ = session.run([tf_loss,tf_loss_minimize],
                              feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                         train_labels: batch[1],
                                         tf_learning_rate: 0.01})
        loss_per_epoch.append(l)

    print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
    avg_loss = np.mean(loss_per_epoch)

    # ====================== Calculate the Validation Accuracy ==========================
    valid_accuracy_per_epoch = []
    for i in range(n_valid//batch_size):
        valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
        valid_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
        valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))

    mean_v_acc = np.mean(valid_accuracy_per_epoch)
    print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))

    # ===================== Calculate the Test Accuracy ===============================
    accuracy_per_epoch = []
    for i in range(n_test//batch_size):
        test_images, test_labels = mnist_data.test.next_batch(batch_size)
        test_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: test_images.reshape(batch_size,image_size*image_size)}
        )
        accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))

    print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
    avg_test_accuracy = np.mean(accuracy_per_epoch)

    # Execute the summaries defined above
    summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})

    # Write the obtained summaries to the file, so they can be displayed
    summ_writer_3.add_summary(summ, epoch)

session.close()
Extracting MNIST_data/train-images-idx3-ubyte.gz
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 1.02625
    Average Valid Accuracy in epoch 0: 92.76000
    Average Test Accuracy in epoch 0: 92.65000

Average loss in epoch 1: 0.19110
    Average Valid Accuracy in epoch 1: 95.80000
    Average Test Accuracy in epoch 1: 95.48000

  ...
  ...
  ...

Average loss in epoch 24: 0.00009
    Average Valid Accuracy in epoch 24: 98.28000
    Average Test Accuracy in epoch 24: 98.09000
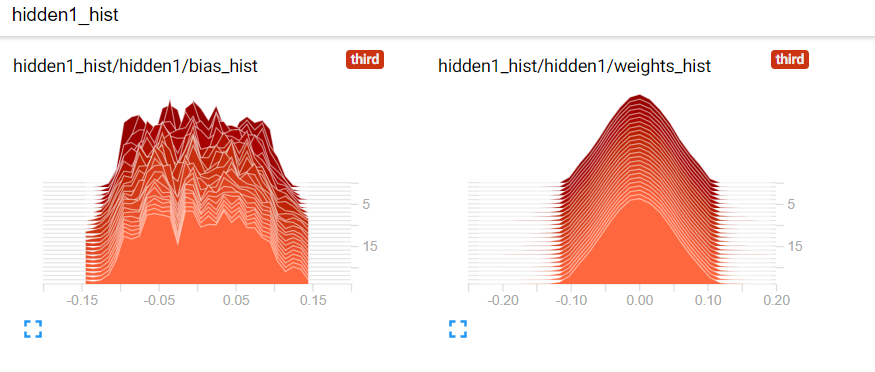
Berikut tampilan bobot dan bias Anda. Pertama, ada 3 sumbu; waktu (sumbu x), nilai (sumbu y) dan frekuensi/kepadatan nilai (sumbu z). Histogram yang lebih gelap merepresentasikan data yang lebih lama dan histogram yang lebih terang merepresentasikan data yang lebih baru. Nilai yang lebih tinggi pada sumbu z berarti vektor berisi lebih banyak nilai di sekitar nilai spesifik tersebut.
Catatan: Anda juga memiliki tampilan "overlay" dari histogram seiring waktu. Anda dapat mengubah jenis tampilan pada panel opsi di sisi kiri.
Sekarang, alih-alih menggunakan truncated_normal_initializer(), Anda akan menggunakan xavier_initializer() untuk menginisialisasi bobot. Inisialisasi Xavier adalah teknik inisialisasi yang jauh lebih baik, terutama untuk jaringan saraf dalam.
Ini karena alih-alih menggunakan simpangan baku yang ditentukan pengguna (seperti saat menggunakan truncated_normal_initializer()), inisialisasi Xavier secara otomatis menentukan simpangan baku berdasarkan jumlah koneksi input dan output ke suatu lapisan. Ini membantu aliran gradien dari atas ke bawah tanpa masalah seperti vanishing gradient. Setelah itu Anda mendefinisikan model lagi.
Pertama, Anda mendefinisikan batch_size yang menyatakan jumlah data yang Anda ambil pada satu langkah optimisasi/validasi atau pengujian. Lalu Anda dapat mendefinisikan layer_ids, yang memberikan pengenal untuk setiap lapisan jaringan saraf yang akan Anda definisikan.
Kemudian Anda dapat mendefinisikan layer_sizes. Perhatikan bahwa len(layer_sizes) harus len(layer_ids)+1, karena layer_sizes menyertakan ukuran input di awal. MNIST memiliki gambar berukuran 28x28, yang akan menjadi 784 saat diratakan ke satu dimensi.
Kemudian, Anda dapat mendefinisikan placeholder input dan label, yang nantinya akan digunakan untuk melatih model. Terakhir, Anda mendefinisikan dua variabel TensorFlow untuk setiap lapisan (weights dan bias).
Catatan: Ini identik dengan kode yang Anda gunakan pertama kali, kecuali teknik inisialisasi yang digunakan untuk bobot
batch_size = 100
layer_ids = ['hidden1','hidden2','hidden3','hidden4','hidden5','out']
layer_sizes = [784, 500, 400, 300, 200, 100, 10]

tf.reset_default_graph()

# Inputs and Labels
train_inputs = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[0]], name='train_inputs')
train_labels = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[-1]], name='train_labels')

# Weight and Bias definitions
for idx, lid in enumerate(layer_ids):

    with tf.variable_scope(lid):
        w = tf.get_variable('weights',shape=[layer_sizes[idx], layer_sizes[idx+1]],
                            initializer=tf.contrib.layers.xavier_initializer())
        b = tf.get_variable('bias',shape= [layer_sizes[idx+1]],
                            initializer=tf.random_uniform_initializer(-0.1,0.1))
Dengan placeholder input/output, bobot, dan bias tiap lapisan telah didefinisikan, kini Anda dapat kembali mendefinisikan perhitungan untuk menghitung logit dari jaringan saraf.
Catatan: Bagian ini identik dengan kode yang Anda gunakan saat pertama kali mendefinisikan operasi dan tensor ini.
Di sini Anda dapat kembali mendefinisikan objek tf.summary. Ini juga identik dengan kode yang Anda gunakan saat pertama kali mendefinisikan operasi dan tensor ini.
Di sini Anda kembali mendefinisikan objek tf.summary. Namun, kini Anda memvisualisasikan vektor skalar sehingga Anda perlu mendefinisikan objek tf.summary.histogram.
Catatan bahwa ini identik dengan kode yang Anda gunakan saat pertama kali mendefinisikan operasi dan tensor ini.
Catatan bahwa ini sama seperti yang Anda lakukan sebelumnya pada bagian sebelumnya!
Hanya ada beberapa potongan kode yang perlu Anda ubah: tiga kemunculan os.path.join('summaries','third') menjadi os.path.join('summaries','fourth'), summ_writer_3 menjadi summ_writer_4 (muncul 4 kali) dan tf_learning_rate dari 0.00001 harus diubah menjadi 0.01.
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25

config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure TensorFlow doesn't overflow the GPU

session = tf.InteractiveSession(config=config)

if not os.path.exists('summaries'):
    os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','fourth')):
    os.mkdir(os.path.join('summaries','fourth'))

summ_writer_4 = tf.summary.FileWriter(os.path.join('summaries','fourth'), session.graph)

tf.global_variables_initializer().run()

accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)


for epoch in range(n_epochs):
    loss_per_epoch = []
    for i in range(n_train//batch_size):

        # =================================== Training for one step ========================================
        batch = mnist_data.train.next_batch(batch_size)    # Get one batch of training data
        if i == 0:
            # Only for the first epoch, get the summary data
            # Otherwise, it can clutter the visualization
            l,_,gn_summ, wb_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary, tf_param_summaries],
                                      feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                                 train_labels: batch[1],
                                                tf_learning_rate: 0.01})
            summ_writer_4.add_summary(gn_summ, epoch)
            summ_writer_4.add_summary(wb_summ, epoch)
        else:
            # Optimize with training data
            l,_ = session.run([tf_loss,tf_loss_minimize],
                              feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                         train_labels: batch[1],
                                         tf_learning_rate: 0.01})
        loss_per_epoch.append(l)

    print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
    avg_loss = np.mean(loss_per_epoch)

    # ====================== Calculate the Validation Accuracy ==========================
    valid_accuracy_per_epoch = []
    for i in range(n_valid//batch_size):
        valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
        valid_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
        valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))

    mean_v_acc = np.mean(valid_accuracy_per_epoch)
    print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))

    # ===================== Calculate the Test Accuracy ===============================
    accuracy_per_epoch = []
    for i in range(n_test//batch_size):
        test_images, test_labels = mnist_data.test.next_batch(batch_size)
        test_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: test_images.reshape(batch_size,image_size*image_size)}
        )
        accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))

    print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
    avg_test_accuracy = np.mean(accuracy_per_epoch)

    # Execute the summaries defined above
    summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})

    # Write the obtained summaries to the file, so they can be displayed
    summ_writer_4.add_summary(summ, epoch)

session.close()
Extracting MNIST_data/train-images-idx3-ubyte.gz
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 0.43618
    Average Valid Accuracy in epoch 0: 95.70000
    Average Test Accuracy in epoch 0: 95.22000

Average loss in epoch 1: 0.12872
    Average Valid Accuracy in epoch 1: 96.86000
    Average Test Accuracy in epoch 1: 96.71000

  ...
  ...
  ...

Average loss in epoch 24: 0.00009
    Average Valid Accuracy in epoch 24: 98.42000
    Average Test Accuracy in epoch 24: 98.21000
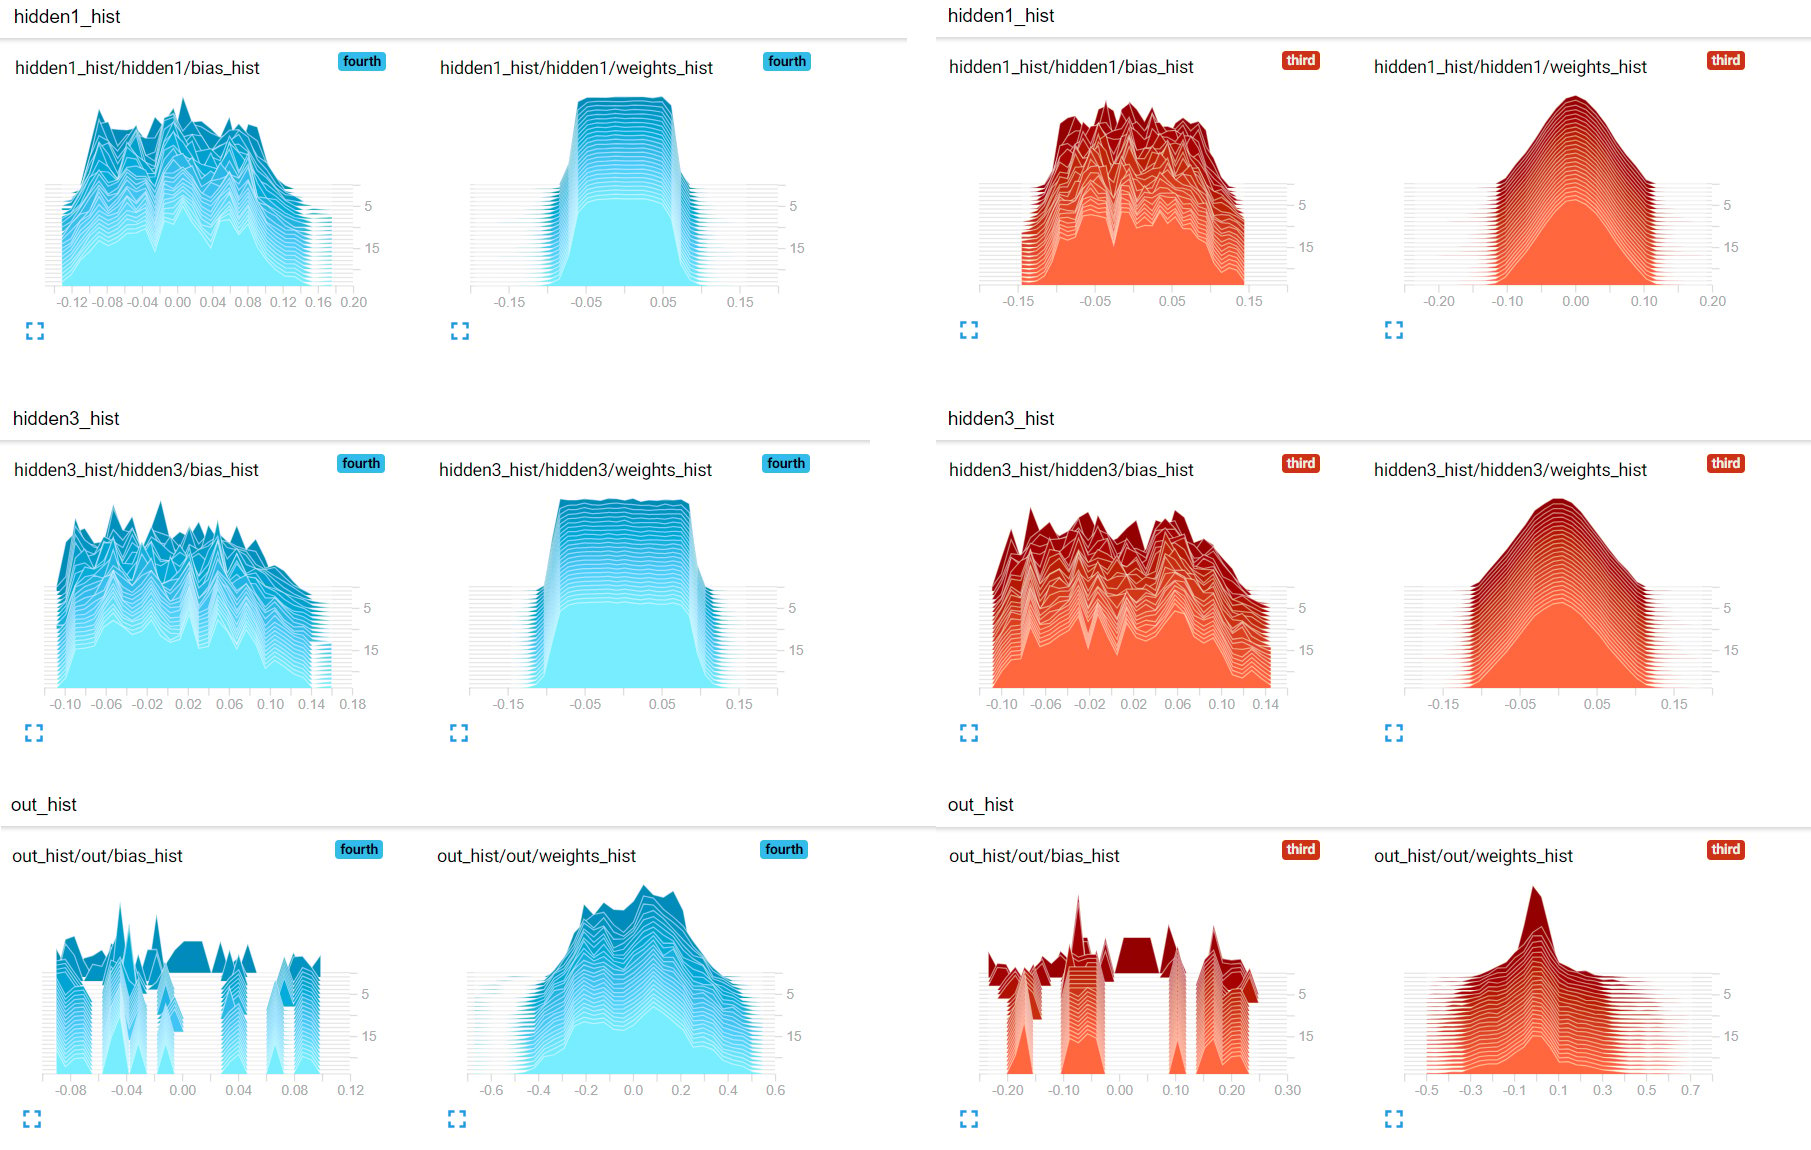
Di sini Anda dapat membandingkan bagaimana bobot berevolusi seiring waktu untuk dua inisialisasi yang berbeda; truncated_normal_initializer (merah) dan xavier_initializer (biru). Anda dapat melihat bahwa xavier_initializer menjaga lebih banyak bobot tetap menjauh dari nol dibandingkan inisialisasi normal, yang merupakan hal yang lebih baik. Ini berpotensi memungkinkan jaringan saraf yang diinisialisasi Xavier berkonvergensi lebih cepat, sebagaimana terlihat pada kurva loss/akurasi.
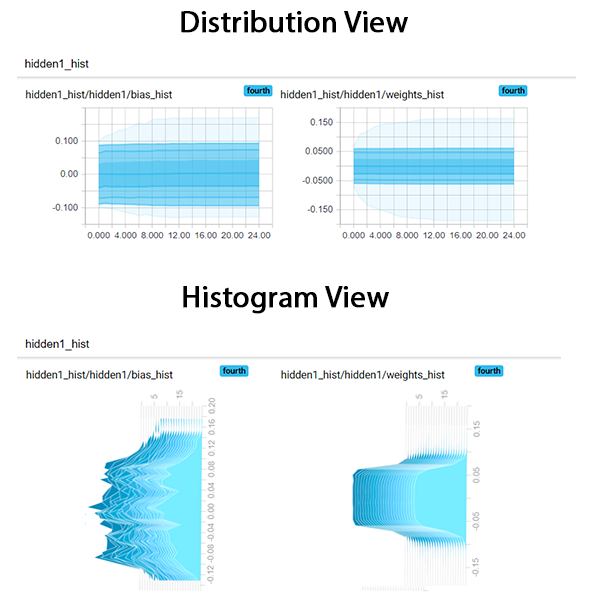
Sekarang Anda dapat membandingkan perbedaan antara dua tampilan; tampilan histogram dan tampilan distribusi. Tampilan distribusi pada dasarnya adalah cara lain untuk melihat histogram. Jika Anda melihat gambar di bawah, Anda dapat dengan mudah melihat bahwa tampilan distribusi adalah tampilan dari atas untuk tampilan histogram. Perhatikan bahwa grafik histogram diputar pada kasus ini untuk memudahkan melihat kemiripan.
Dalam tutorial ini, Anda melihat cara menggunakan TensorBoard. Pertama, Anda mempelajari cara memulai layanannya melalui command prompt (Windows) atau terminal (Ubuntu/Mac). Selanjutnya, Anda melihat berbagai tampilan data yang disediakan TensorBoard. Lalu Anda melihat kode yang memvisualisasikan nilai skalar (misalnya loss/akurasi) dan menggunakan model jaringan saraf feed-forward untuk memahami secara konkret penggunaan visualisasi nilai skalar.
Setelah itu, Anda menelusuri bagaimana memvisualisasikan kumpulan/vektor skalar menggunakan tampilan histogram. Ini diikuti dengan perbandingan yang menyoroti perbedaan antara teknik inisialisasi bobot jaringan saraf menggunakan tampilan histogram.
Terakhir, Anda membahas kesamaan antara tampilan distribusi dan tampilan histogram.
Jika Anda ingin mempelajari lebih lanjut tentang deep learning, pastikan untuk melihat kursus Deep Learning in Keras kami.
Lihat tutorial Optimasi Hiperparameter pada Model Machine Learning kami untuk mempelajari lebih lanjut tentang parameter dan hiperparameter.
Jika Anda ingin menghubungi saya, Anda dapat mengirim email ke thushv@gmail.com atau terhubung melalui LinkedIn.
Pelajari lebih lanjut tentang Machine Learning dan Deep Learning
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt




