
Last chance! 50% off DataCamp Premium
Sale ends in

Deze tutorial laat je zien hoe je TensorBoard gebruikt, een geweldige tool waarmee je data en het gedrag ervan kunt visualiseren. Je ziet voor welke doeleinden je het kunt inzetten tijdens het trainen van een neuraal netwerk.
Tip: bekijk DataCamp's Deep Learning-cursus met Keras hier.
Voordat je begint, importeer de volgende libraries om de code succesvol uit te voeren:
from pandas_datareader import data
import matplotlib.pyplot as plt
import pandas as pd
import datetime as dt
import urllib.request, json
import os
import numpy as np

# This code has been tested with TensorFlow 1.6
import tensorflow as tf
from tensorflow.examples.tutorials.mnist import input_data
Om dingen via TensorBoard te visualiseren, moet je eerst de service starten. Daarvoor:
python3, je krijgt dan een prompt die eruitziet als >>>import tensorflow as tf>>>) door exit() te typen en voer dan het volgende commando uit
tensorboard --logdir=summaries--logdir is de map waarin je data maakt om te visualiseren--port=<port_you_like> gebruiken om de poort te wijzigen waarop TensorBoard draaitTensorBoard 1.6.0 at <url>:6006 (Press CTRL+C to quit)Let op: TensorBoard ziet niet graag meerdere event files in dezelfde map. Dit kan leiden tot zeer grillige curves in de weergave. Maak daarom voor elk voorbeeld een aparte map (bijvoorbeeld summaries/first, summaries/second, …) om data op te slaan. Houd er ook rekening mee dat je, als je een experiment opnieuw wilt draaien (dus een event file opslaat in een al gevulde map), eerst de bestaande event files moet verwijderen.
Verschillende weergaven nemen input in verschillende formaten en tonen die op een andere manier. Je kunt ze wijzigen via de oranje balk bovenaan.
In deze tutorial behandel je de vetgedrukte weergaven.
In deze sectie begrijp je eerst waarom het visualiseren van bepaalde metrieke gegevens (bijvoorbeeld verlies of nauwkeurigheid) nuttig is. Bij het trainen van diepe neurale netwerken is een van de grootste struikelblokken voor beginners het gebrek aan inzicht in de effecten van diverse ontwerpkeuzes en hyperparameters.
Als je bijvoorbeeld onzorgvuldig de gewichten van een diep neuraal netwerk initialiseert met een zeer grote variantie tussen de gewichten, zal je model snel divergeren en instorten. Aan de andere kant kan er ook veel misgaan als je behoorlijk bedreven bent in het temmen van neurale netwerken. Zo kan onvoldoende aandacht voor de learning rate leiden tot óf divergeren van het model óf voortijdige verzadiging tot suboptimale prestaties.
Een manier om snel problemen in je model te detecteren is een grafische visualisatie van wat er in real time gebeurt (bijvoorbeeld elke 100 iteraties). Als je model zich vreemd gedraagt, zie je dat meteen. Precies dat is wat TensorBoard je biedt. Je kunt bepalen welke waarden getoond moeten worden en TensorBoard houdt daar tijdens het leren een realtime visualisatie van bij.
Je begint met het maken van een neuraal netwerk met vijf lagen waarmee je handgeschreven cijfers gaat classificeren. Daarvoor gebruik je de bekende MNIST-dataset. TensorFlow biedt een eenvoudige API om MNIST-data te laden, dus je hoeft die niet handmatig te downloaden. Vooraf definieer je een eenvoudige methode (accuracy()) die de nauwkeurigheid van voorspellingen ten opzichte van de ware labels berekent.
def accuracy(predictions,labels):
    '''
    Accuracy of a given set of predictions of size (N x n_classes) and
    labels of size (N x n_classes)
    '''
    return np.sum(np.argmax(predictions,axis=1)==np.argmax(labels,axis=1))*100.0/labels.shape[0]
Definieer eerst een batch_size die het aantal data aangeeft dat je in één optimalisatie-/validatie- of teststap sampelt. Definieer vervolgens de layer_ids, die een identificator geven voor elke laag van het neurale netwerk dat je gaat definiëren. Daarna kun je layer_sizes definiëren.
Let op dat len(layer_sizes) gelijk moet zijn aan len(layer_ids)+1, omdat layer_sizes ook de grootte van de input aan het begin bevat.
MNIST bevat afbeeldingen van 28x28, wat 784 is als je ze uitrolt naar één dimensie. Vervolgens kun je de placeholders voor input en labels definiëren, die je later gebruikt om het model te trainen. Tot slot definieer je twee TensorFlow-variabelen per laag (weights en bias).
Je kunt variabele scoping gebruiken (meer info hier) zodat de variabelen netjes benoemd zijn en later eenvoudiger toegankelijk.
batch_size = 100
layer_ids = ['hidden1','hidden2','hidden3','hidden4','hidden5','out']
layer_sizes = [784, 500, 400, 300, 200, 100, 10]

tf.reset_default_graph()

# Inputs and Labels
train_inputs = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[0]], name='train_inputs')
train_labels = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[-1]], name='train_labels')

# Weight and Bias definitions
for idx, lid in enumerate(layer_ids):

    with tf.variable_scope(lid):
        w = tf.get_variable('weights',shape=[layer_sizes[idx], layer_sizes[idx+1]],
                            initializer=tf.truncated_normal_initializer(stddev=0.05))
        b = tf.get_variable('bias',shape= [layer_sizes[idx+1]],
                            initializer=tf.random_uniform_initializer(-0.1,0.1))
Met de input-/output-placeholders en de gewichten en biases van elke laag gedefinieerd, kun je nu de berekeningen definiëren om de logits van het neurale netwerk te verkrijgen. Logits zijn de ongenormaliseerde waarden die in de laatste laag van het neurale netwerk worden geproduceerd. Na normalisatie noem je ze voorspellingen. Dit houdt in dat je door elke laag in het neurale netwerk itereert en tf.matmul(h,w) +b berekent. Je moet ook een activatiefunctie toepassen zoals tf.nn.relu(tf.matmul(h,w) +b) voor alle lagen behalve de laatste.
Vervolgens definieer je de verliesfunctie die wordt gebruikt om het neurale netwerk te optimaliseren. In dit voorbeeld kun je de cross-entropy-verliesfunctie gebruiken, die bij classificatieproblemen vaak betere resultaten geeft dan de mean squared error.
Tot slot definieer je een optimizer die het verlies inneemt en de gewichten van het neurale netwerk bijwerkt in de richting die het verlies minimaliseert.
# Calculating Logits
h = train_inputs
for lid in layer_ids:
    with tf.variable_scope(lid,reuse=True):
        w, b = tf.get_variable('weights'), tf.get_variable('bias')
        if lid != 'out':
          h = tf.nn.relu(tf.matmul(h,w)+b,name=lid+'_output')
        else:
          h = tf.nn.xw_plus_b(h,w,b,name=lid+'_output')

tf_predictions = tf.nn.softmax(h, name='predictions')
# Calculating Loss
tf_loss = tf.reduce_mean(tf.nn.softmax_cross_entropy_with_logits_v2(labels=train_labels, logits=h),name='loss')

# Optimizer
tf_learning_rate = tf.placeholder(tf.float32, shape=None, name='learning_rate')
optimizer = tf.train.MomentumOptimizer(tf_learning_rate,momentum=0.9)
grads_and_vars = optimizer.compute_gradients(tf_loss)
tf_loss_minimize = optimizer.minimize(tf_loss)
Hier kun je de tf.summary-objecten definiëren. Dit zijn de entiteiten die TensorBoard begrijpt. Dit betekent dat elke waarde die je wilt tonen, je als een tf.summary-object moet verpakken.
Er zijn verschillende soorten summaries. Omdat je hier alleen scalaire waarden visualiseert, kun je tf.summary.scalar-objecten definiëren. Daarnaast kun je tf.name_scope gebruiken om scalars op het bord te groeperen. Scalars met dezelfde name scope worden in dezelfde rij weergegeven. Hier definieer je drie verschillende summaries.
tf_loss_summary : je voert een waarde in via een placeholder, telkens wanneer je dit op het bord wilt publicerentf_accuracy_summary : je voert een waarde in via een placeholder, telkens wanneer je dit op het bord wilt publicerentf_gradnorm_summary : dit berekent de l2-norm van de gradiënten van de laatste laag van je neurale netwerk. De gradiëntnorm is een goede indicator of de gewichten van het neurale netwerk juist worden bijgewerkt. Een te kleine gradiëntnorm kan duiden op het vanishing gradient-fenomeen; een te grote op exploding gradients.# Name scope allows you to group various summaries together
# Summaries having the same name_scope will be displayed on the same row
with tf.name_scope('performance'):
# Summaries need to be displayed
# Whenever you need to record the loss, feed the mean loss to this placeholder
tf_loss_ph = tf.placeholder(tf.float32,shape=None,name='loss_summary')
# Create a scalar summary object for the loss so it can be displayed
tf_loss_summary = tf.summary.scalar('loss', tf_loss_ph)
# Whenever you need to record the loss, feed the mean test accuracy to this placeholder
tf_accuracy_ph = tf.placeholder(tf.float32,shape=None, name='accuracy_summary')
# Create a scalar summary object for the accuracy so it can be displayed
tf_accuracy_summary = tf.summary.scalar('accuracy', tf_accuracy_ph)
# Gradient norm summary
for g,v in grads_and_vars:
if 'hidden5' in v.name and 'weights' in v.name:
with tf.name_scope('gradients'):
tf_last_grad_norm = tf.sqrt(tf.reduce_mean(g**2))
tf_gradnorm_summary = tf.summary.scalar('grad_norm', tf_last_grad_norm)
break
# Merge all summaries together
performance_summaries = tf.summary.merge([tf_loss_summary,tf_accuracy_summary])
In de onderstaande code doe je het volgende. Eerst maak je een sessie waarin je de hierboven gedefinieerde operaties uitvoert. Vervolgens maak je een map om summary data op te slaan. Daarna maak je een summary-writer summ_writer. Nu kun je alle variabelen initialiseren. Daarna laad je de MNIST-dataset.
Voor elke epoch, en elke batch in de trainingsdata (dus elke iteratie), voer je gradnorm_summary uit als het de eerste iteratie is en schrijf je gradnorm_summary met de summary-writer naar het eventbestand. Vervolgens voer je de modeloptimalisatie en verliesberekening uit. Nadat je de volledige trainingsset voor één epoch hebt doorlopen, bereken je het gemiddelde trainingsverlies.
Voor de validatieset volg je een vergelijkbare aanpak. Voor elke batch in de validatiedata bereken je de validatienauwkeurigheid. Daarna bereken je de gemiddelde validatienauwkeurigheid voor de volledige validatieset.
Tot slot voer je de testfase uit. Voor elke batch in de testdata bereken je de testnauwkeurigheid per batch. Daarmee bereken je de gemiddelde testnauwkeurigheid voor de volledige testset. Helemaal aan het eind voer je performance_summaries uit en schrijf je die met de summary-writer naar het eventbestand.
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25

config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure Tensorflow doesn't overflow the GPU

session = tf.InteractiveSession(config=config)

if not os.path.exists('summaries'):
    os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','first')):
    os.mkdir(os.path.join('summaries','first'))

summ_writer = tf.summary.FileWriter(os.path.join('summaries','first'), session.graph)

tf.global_variables_initializer().run()

accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)


for epoch in range(n_epochs):
    loss_per_epoch = []
    for i in range(n_train//batch_size):

        # =================================== Training for one step ========================================
        batch = mnist_data.train.next_batch(batch_size)    # Get one batch of training data
        if i == 0:
            # Only for the first epoch, get the summary data
            # Otherwise, it can clutter the visualization
            l,_,gn_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary],
                                      feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                                 train_labels: batch[1],
                                                tf_learning_rate: 0.0001})
            summ_writer.add_summary(gn_summ, epoch)
        else:
            # Optimize with training data
            l,_ = session.run([tf_loss,tf_loss_minimize],
                              feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                         train_labels: batch[1],
                                         tf_learning_rate: 0.0001})
        loss_per_epoch.append(l)

    print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
    avg_loss = np.mean(loss_per_epoch)

    # ====================== Calculate the Validation Accuracy ==========================
    valid_accuracy_per_epoch = []
    for i in range(n_valid//batch_size):
        valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
        valid_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
        valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))

    mean_v_acc = np.mean(valid_accuracy_per_epoch)
    print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))

    # ===================== Calculate the Test Accuracy ===============================
    accuracy_per_epoch = []
    for i in range(n_test//batch_size):
        test_images, test_labels = mnist_data.test.next_batch(batch_size)
        test_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: test_images.reshape(batch_size,image_size*image_size)}
        )
        accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))

    print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
    avg_test_accuracy = np.mean(accuracy_per_epoch)

    # Execute the summaries defined above
    summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})

    # Write the obtained summaries to the file, so it can be displayed in the TensorBoard
    summ_writer.add_summary(summ, epoch)

session.close()
Successfully downloaded train-images-idx3-ubyte.gz 9912422 bytes.
Extracting MNIST_data/train-images-idx3-ubyte.gz
Successfully downloaded train-labels-idx1-ubyte.gz 28881 bytes.
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Successfully downloaded t10k-images-idx3-ubyte.gz 1648877 bytes.
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Successfully downloaded t10k-labels-idx1-ubyte.gz 4542 bytes.
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 2.30252
    Average Valid Accuracy in epoch 0: 10.02000
    Average Test Accuracy in epoch 0: 9.76000

Average loss in epoch 1: 2.30016
    Average Valid Accuracy in epoch 1: 12.56000
    Average Test Accuracy in epoch 1: 12.64000

  ...
  ...
  ...

Average loss in epoch 24: 1.03386
    Average Valid Accuracy in epoch 24: 71.88000
    Average Test Accuracy in epoch 24: 71.23000
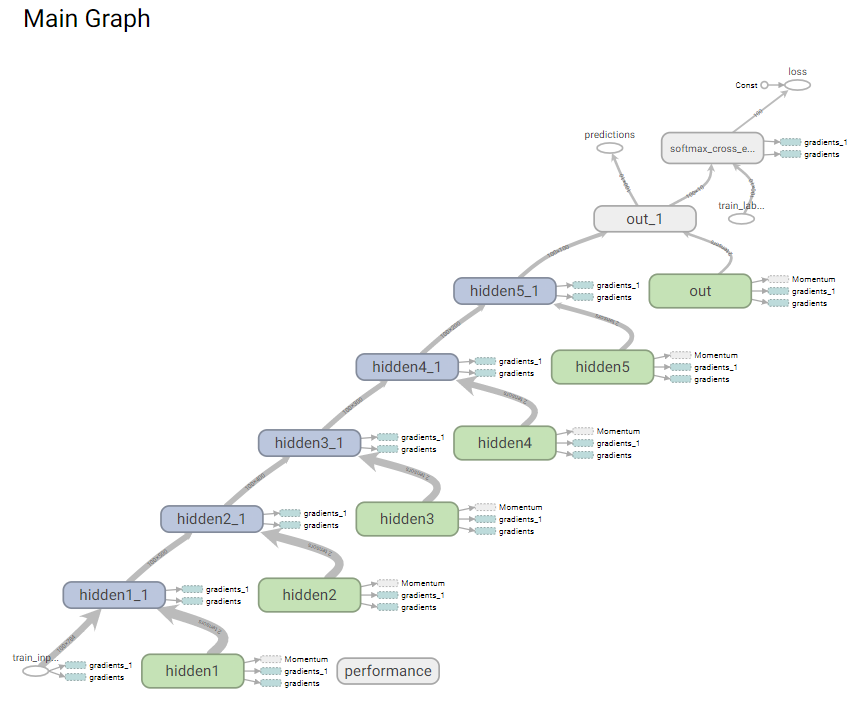
Eerst bekijk je hoe de computationele graaf van je model eruitziet. Je opent deze weergave door op de Graphs-weergave in TensorBoard te klikken. Het zou eruit moeten zien zoals op de afbeelding hieronder. Je ziet een nette stroom van train_inputs naar loss en predictions via de verborgen lagen 1 t/m 5.
MNIST-classificatie is een van de eenvoudigste voorbeelden, en toch lukt het hier niet met een neuraal netwerk van 5 lagen. Voor MNIST is het niet moeilijk om in minder dan 5 epochs meer dan 90% nauwkeurigheid te behalen.
Wat is hier dus aan de hand?
Laten we TensorBoard erbij pakken:
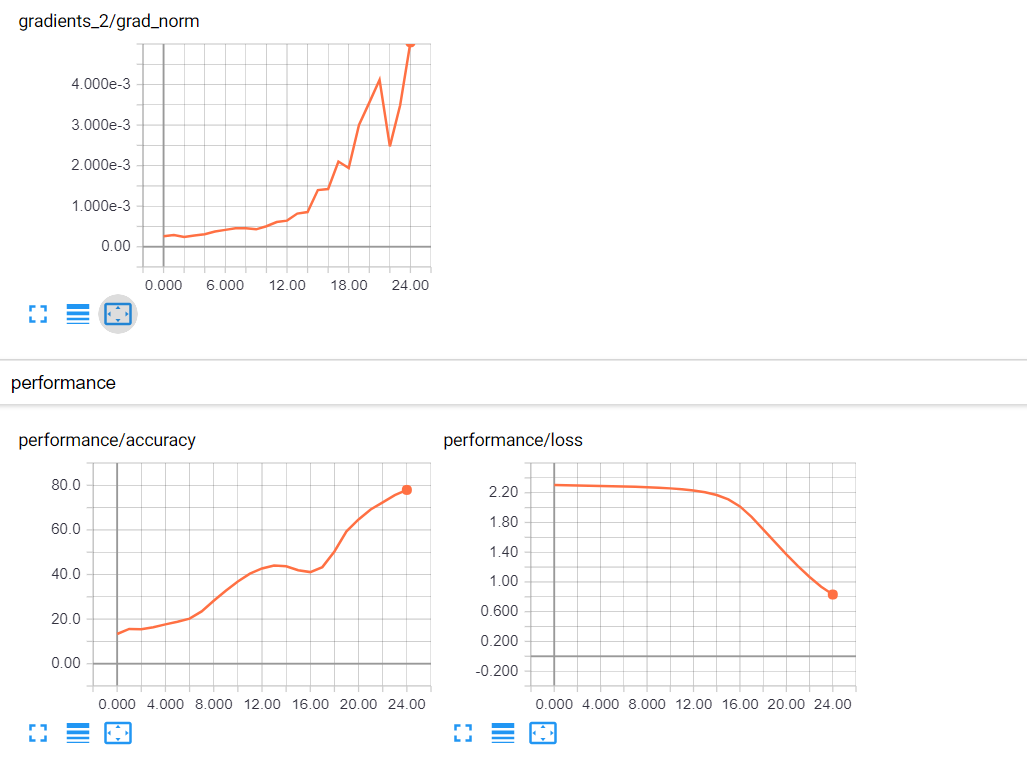
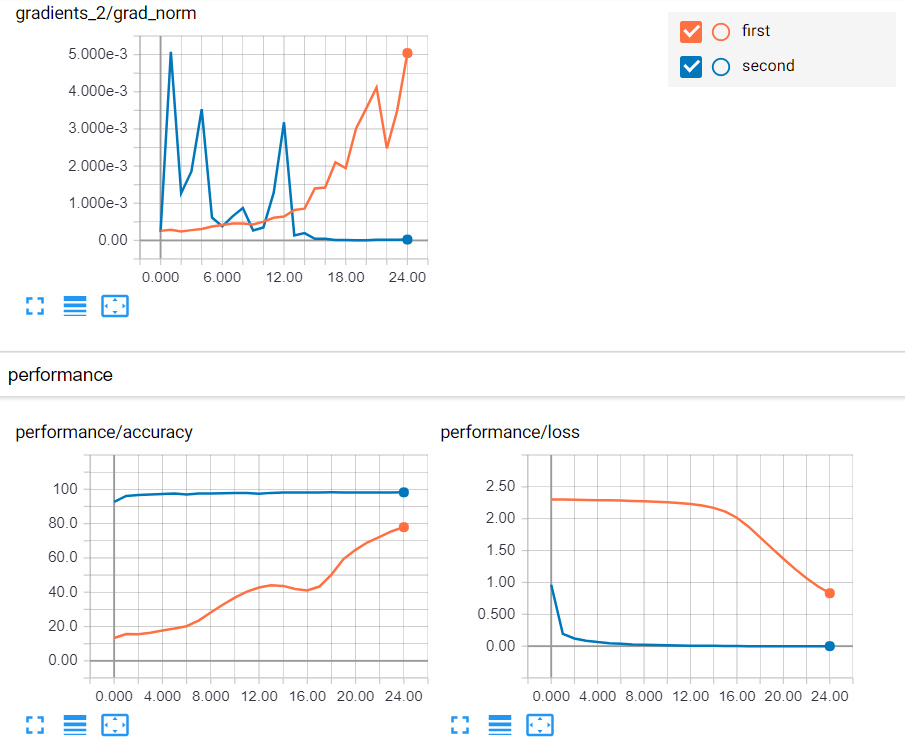
Je ziet dat de nauwkeurigheid stijgt, maar heel langzaam, en dat de gradiëntupdates in de tijd toenemen. Dat is vreemd gedrag. Als je richting convergentie gaat, zouden de gradiënten juist moeten afnemen (naar nul), niet toenemen. Maar omdat de nauwkeurigheid omhooggaat, zit je op de goede weg. Waarschijnlijk heb je een hogere learning rate nodig.
Je kunt nu een learning rate van 0.01 proberen. Dit is bijna identiek aan de vorige uitvoering van het neurale netwerk, behalve dat je 0.01 gebruikt in plaats van 0.0001. Gebruik dus tf_learning_rate: 0.01 in plaats van tf_learning_rate: 0.0001. Let op dat je dit op twee plekken moet aanpassen.
Je ziet nu dat de nauwkeurigheid dicht bij 100 begint en blijft stijgen. En je ziet dat de gradiëntupdates in de tijd afnemen en richting nul gaan. Met een learning rate van 0.01 ziet het er een stuk beter uit.
Dan gaan we verder dan alleen scalars. Je ziet hoe je vectoren en verzamelingen van scalars kunt analyseren.
Je zag het nut van het visualiseren van scalars met TensorBoard, waarmee je kon zien hoe het model zich gedraagt en eventuele problemen kon oplossen. Bovendien liet het visualiseren van de graaf zien dat er een ononderbroken verbinding is van input naar voorspellingen, wat nodig is voor gradiëntberekeningen.
Nu bekijk je een andere nuttige weergave in TensorBoard: histogrammen of verdelingen.
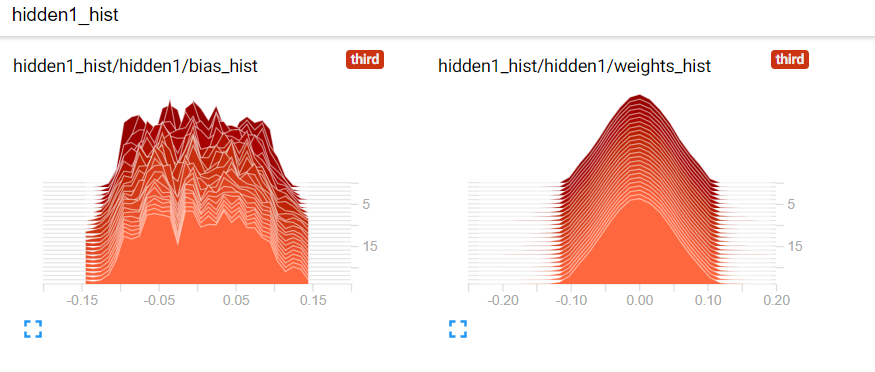
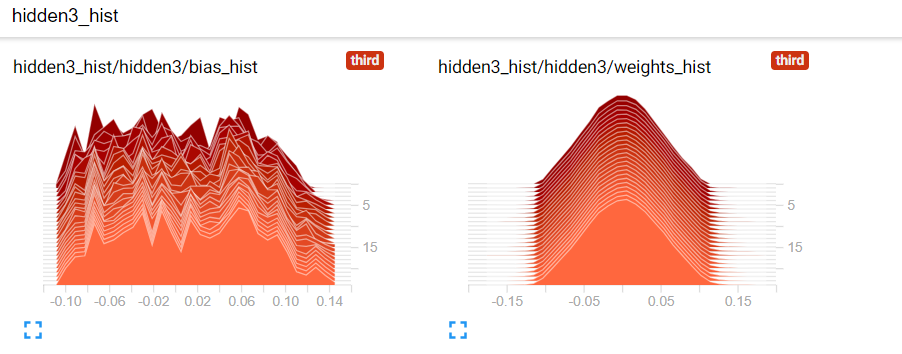
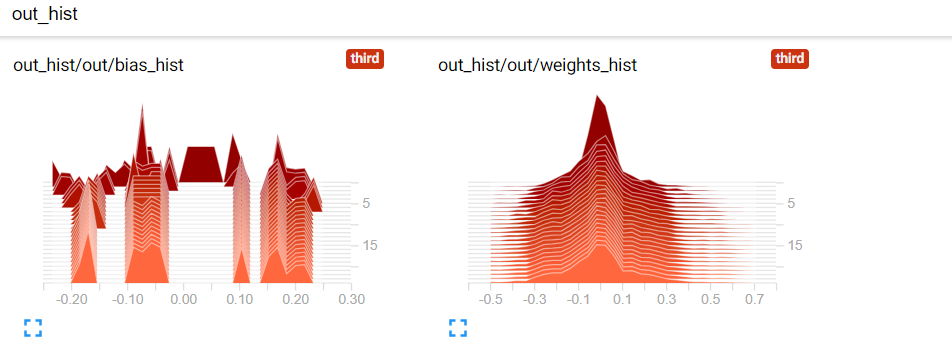
Onthoud dat een histogram een verzameling waarden is die wordt weergegeven via de frequentie/dichtheid waarmee de waarde in de verzameling voorkomt. Je kunt histogrammen gebruiken om de gewichtswaarden van het netwerk in de tijd te visualiseren. Het visualiseren van netwerkgewichten is belangrijk, want als de gewichten tijdens het leren wild heen en weer springen, wijst dat op problemen met de initiële gewichten of de learning rate.
Je ziet in het voorbeeld hoe gewichten veranderen. In de code wordt een truncated_normal_initializer() gebruikt om gewichten te initialiseren.
Hier definieer je opnieuw de tf.summary-objecten. Maar nu visualiseer je vectoren van scalars, dus moet je tf.summary.histogram-objecten definiëren.
In dit geval definieer je twee histogramobjecten (tf_w_hist en tf_b_hist) die de gewichten en biases van een bepaalde laag bevatten. Je definieert zulke histogramobjecten voor alle lagen en elke laag krijgt zijn eigen name scope.
Tot slot kun je de operatie tf.summary.merge gebruiken om een gegroepeerde operatie te maken die al deze summaries in één keer uitvoert.
# Summaries need to be displayed
# Create a summary for each weight bias in each layer
all_summaries = []
for lid in layer_ids:
    with tf.name_scope(lid+'_hist'):
        with tf.variable_scope(lid,reuse=True):
            w,b = tf.get_variable('weights'), tf.get_variable('bias')

            # Create a scalar summary object for the loss so it can be displayed
            tf_w_hist = tf.summary.histogram('weights_hist', tf.reshape(w,[-1]))
            tf_b_hist = tf.summary.histogram('bias_hist', b)
            all_summaries.extend([tf_w_hist, tf_b_hist])

# Merge all parameter histogram summaries together
tf_param_summaries = tf.summary.merge(all_summaries)
Deze stap is bijna hetzelfde als wat je eerder deed, maar hier heb je een paar extra regels om de histogram-samenvattingen te berekenen (tf_param_summaries).
Let op dat de learning rates ook opnieuw zijn aangepast.
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25

config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure Tensorflow doesn't overflow the GPU

session = tf.InteractiveSession(config=config)

if not os.path.exists('summaries'):
    os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','third')):
    os.mkdir(os.path.join('summaries','third'))

summ_writer_3 = tf.summary.FileWriter(os.path.join('summaries','third'), session.graph)

tf.global_variables_initializer().run()

accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)


for epoch in range(n_epochs):
    loss_per_epoch = []
    for i in range(n_train//batch_size):

        # =================================== Training for one step ========================================
        batch = mnist_data.train.next_batch(batch_size)    # Get one batch of training data
        if i == 0:
            # Only for the first epoch, get the summary data
            # Otherwise, it can clutter the visualization
            l,_,gn_summ, wb_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary, tf_param_summaries],
                                      feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                                 train_labels: batch[1],
                                                tf_learning_rate: 0.00001})
            summ_writer_3.add_summary(gn_summ, epoch)
            summ_writer_3.add_summary(wb_summ, epoch)
        else:
            # Optimize with training data
            l,_ = session.run([tf_loss,tf_loss_minimize],
                              feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                         train_labels: batch[1],
                                         tf_learning_rate: 0.01})
        loss_per_epoch.append(l)

    print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
    avg_loss = np.mean(loss_per_epoch)

    # ====================== Calculate the Validation Accuracy ==========================
    valid_accuracy_per_epoch = []
    for i in range(n_valid//batch_size):
        valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
        valid_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
        valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))

    mean_v_acc = np.mean(valid_accuracy_per_epoch)
    print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))

    # ===================== Calculate the Test Accuracy ===============================
    accuracy_per_epoch = []
    for i in range(n_test//batch_size):
        test_images, test_labels = mnist_data.test.next_batch(batch_size)
        test_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: test_images.reshape(batch_size,image_size*image_size)}
        )
        accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))

    print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
    avg_test_accuracy = np.mean(accuracy_per_epoch)

    # Execute the summaries defined above
    summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})

    # Write the obtained summaries to the file, so they can be displayed
    summ_writer_3.add_summary(summ, epoch)

session.close()
Extracting MNIST_data/train-images-idx3-ubyte.gz
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 1.02625
    Average Valid Accuracy in epoch 0: 92.76000
    Average Test Accuracy in epoch 0: 92.65000

Average loss in epoch 1: 0.19110
    Average Valid Accuracy in epoch 1: 95.80000
    Average Test Accuracy in epoch 1: 95.48000

  ...
  ...
  ...

Average loss in epoch 24: 0.00009
    Average Valid Accuracy in epoch 24: 98.28000
    Average Test Accuracy in epoch 24: 98.09000
Zo zien je gewichten en biases eruit. Eerst heb je 3 assen: tijd (x-as), waarde (y-as) en frequentie/dichtheid van waarden (z-as). Donkerdere histogrammen representeren oudere data en lichtere histogrammen nieuwere data. Een hogere waarde op de z-as betekent dat de vector meer waarden bevat in de buurt van die specifieke waarde.
Let op: er is ook een "overlay"-weergave van de histogrammen in de tijd. Je kunt het type weergave wijzigen in het optiepaneel links.
In plaats van truncated_normal_initializer() gebruik je nu xavier_initializer() om gewichten te initialiseren. Xavier-initialisatie is een veel betere techniek, vooral voor diepe neurale netwerken.
Dat komt omdat in plaats van een door de gebruiker gedefinieerde standaarddeviatie (zoals bij truncated_normal_initializer()), Xavier-initialisatie de standaarddeviatie automatisch bepaalt op basis van het aantal input- en outputverbindingen van een laag. Dit helpt om gradiënten probleemloos van boven naar beneden te laten doorstromen, zonder problemen zoals vanishing gradients. Vervolgens definieer je het model opnieuw.
Definieer eerst een batch_size die het aantal data aangeeft dat je in één optimalisatie-/validatie- of teststap sampelt. Vervolgens kun je de layer_ids definiëren, die een identificator geven voor elke laag van het neurale netwerk dat je definieert.
Daarna kun je layer_sizes definiëren. Let op dat len(layer_sizes) gelijk moet zijn aan len(layer_ids)+1, omdat layer_sizes ook de grootte van de input aan het begin bevat. MNIST heeft afbeeldingen van 28x28, wat 784 is na uitrollen.
Vervolgens definieer je de placeholders voor input en labels, die je later gebruikt om het model te trainen. Tot slot definieer je twee TensorFlow-variabelen per laag (weights en bias).
Let op: Dit is identiek aan de code die je de eerste keer gebruikte, behalve de gebruikte initialisatietechniek voor de gewichten
batch_size = 100
layer_ids = ['hidden1','hidden2','hidden3','hidden4','hidden5','out']
layer_sizes = [784, 500, 400, 300, 200, 100, 10]

tf.reset_default_graph()

# Inputs and Labels
train_inputs = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[0]], name='train_inputs')
train_labels = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[-1]], name='train_labels')

# Weight and Bias definitions
for idx, lid in enumerate(layer_ids):

    with tf.variable_scope(lid):
        w = tf.get_variable('weights',shape=[layer_sizes[idx], layer_sizes[idx+1]],
                            initializer=tf.contrib.layers.xavier_initializer())
        b = tf.get_variable('bias',shape= [layer_sizes[idx+1]],
                            initializer=tf.random_uniform_initializer(-0.1,0.1))
Met de input-/output-placeholders en de gewichten en biases van elke laag gedefinieerd, kun je nu opnieuw de berekeningen definiëren om de logits van het neurale netwerk te verkrijgen.
Let op: Dit deel is identiek aan de code die je de eerste keer gebruikte om deze operaties en tensors te definiëren.
Hier kun je opnieuw de tf.summary-objecten definiëren. Dit is ook identiek aan de code die je de eerste keer gebruikte om deze operaties en tensors te definiëren.
Hier definieer je opnieuw de tf.summary-objecten. Nu visualiseer je vectoren van scalars, dus moet je tf.summary.histogram-objecten definiëren.
Let op dat dit identiek is aan de code die je de eerste keer gebruikte om deze operaties en tensors te definiëren.
Let op dat dit hetzelfde is als wat je eerder deed in de vorige sectie!
Er zijn maar een paar stukjes code die je moet wijzigen: de drie voorkomens van os.path.join('summaries','third') naar os.path.join('summaries','fourth'), summ_writer_3 naar summ_writer_4 (dit komt 4 keer voor) en de tf_learning_rate van 0.00001 moet worden ingesteld op 0.01.
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25

config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure TensorFlow doesn't overflow the GPU

session = tf.InteractiveSession(config=config)

if not os.path.exists('summaries'):
    os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','fourth')):
    os.mkdir(os.path.join('summaries','fourth'))

summ_writer_4 = tf.summary.FileWriter(os.path.join('summaries','fourth'), session.graph)

tf.global_variables_initializer().run()

accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)


for epoch in range(n_epochs):
    loss_per_epoch = []
    for i in range(n_train//batch_size):

        # =================================== Training for one step ========================================
        batch = mnist_data.train.next_batch(batch_size)    # Get one batch of training data
        if i == 0:
            # Only for the first epoch, get the summary data
            # Otherwise, it can clutter the visualization
            l,_,gn_summ, wb_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary, tf_param_summaries],
                                      feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                                 train_labels: batch[1],
                                                tf_learning_rate: 0.01})
            summ_writer_4.add_summary(gn_summ, epoch)
            summ_writer_4.add_summary(wb_summ, epoch)
        else:
            # Optimize with training data
            l,_ = session.run([tf_loss,tf_loss_minimize],
                              feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                         train_labels: batch[1],
                                         tf_learning_rate: 0.01})
        loss_per_epoch.append(l)

    print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
    avg_loss = np.mean(loss_per_epoch)

    # ====================== Calculate the Validation Accuracy ==========================
    valid_accuracy_per_epoch = []
    for i in range(n_valid//batch_size):
        valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
        valid_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
        valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))

    mean_v_acc = np.mean(valid_accuracy_per_epoch)
    print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))

    # ===================== Calculate the Test Accuracy ===============================
    accuracy_per_epoch = []
    for i in range(n_test//batch_size):
        test_images, test_labels = mnist_data.test.next_batch(batch_size)
        test_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: test_images.reshape(batch_size,image_size*image_size)}
        )
        accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))

    print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
    avg_test_accuracy = np.mean(accuracy_per_epoch)

    # Execute the summaries defined above
    summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})

    # Write the obtained summaries to the file, so they can be displayed
    summ_writer_4.add_summary(summ, epoch)

session.close()
Extracting MNIST_data/train-images-idx3-ubyte.gz
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 0.43618
    Average Valid Accuracy in epoch 0: 95.70000
    Average Test Accuracy in epoch 0: 95.22000

Average loss in epoch 1: 0.12872
    Average Valid Accuracy in epoch 1: 96.86000
    Average Test Accuracy in epoch 1: 96.71000

  ...
  ...
  ...

Average loss in epoch 24: 0.00009
    Average Valid Accuracy in epoch 24: 98.42000
    Average Test Accuracy in epoch 24: 98.21000
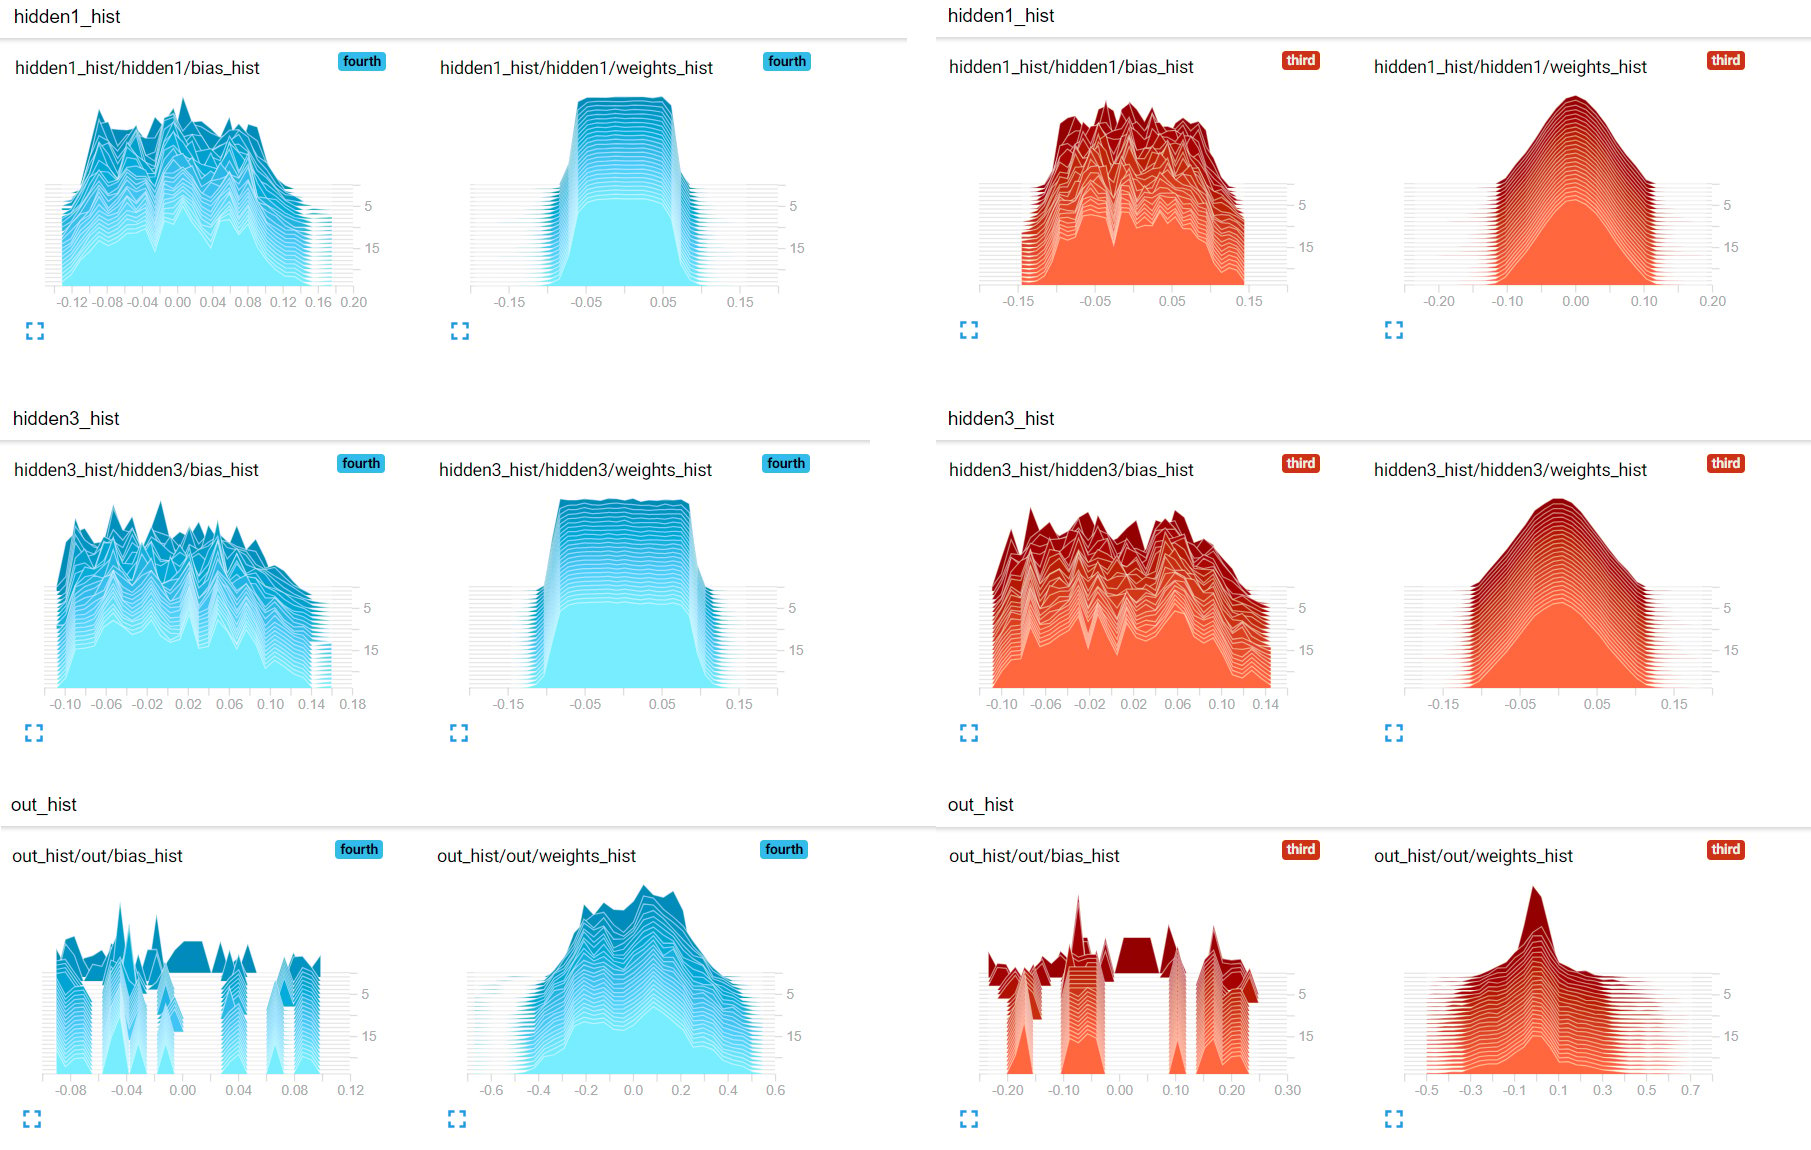
Hier kun je vergelijken hoe gewichten zich in de tijd ontwikkelen voor de twee verschillende initialisaties: truncated_normal_initializer (rood) en xavier_initializer (blauw). Je ziet dat xavier_initializer meer gewichten verder van nul houdt dan de normale initializer, wat beter is. Dit stelt Xavier-geïnitialiseerde neurale netwerken mogelijk in staat sneller te convergeren, zoals blijkt uit de verlies-/nauwkeurigheidscurves.
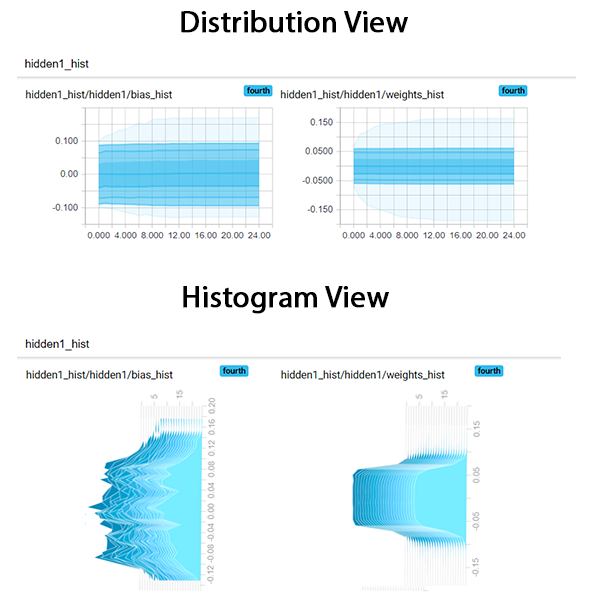
Je kunt nu het verschil vergelijken tussen de twee weergaven: histogramweergave en distributieweergave. De distributieweergave is in essentie een andere manier om naar histogrammen te kijken. Als je naar de onderstaande afbeelding kijkt, zie je eenvoudig dat de distributieweergave is een bovenaanzicht van de histogramweergave. Merk op dat de histogramgrafieken hier gedraaid zijn om de gelijkenis makkelijker te zien.
In deze tutorial zag je hoe je TensorBoard gebruikt. Eerst leerde je hoe je de service start via de opdrachtprompt (Windows) of terminal (Ubuntu/Mac). Vervolgens bekeek je verschillende dataviews die TensorBoard biedt. Daarna bekeek je code die scalaire waarden visualiseert (bijvoorbeeld verlies/nauwkeurigheid) en gebruikte je een feedforward-neuraal netwerk om het nut van de visualisatie van scalars concreet te begrijpen.
Daarna onderzocht je hoe je verzamelingen/vectoren van scalars kunt visualiseren met de histogramweergave. Dit werd gevolgd door een vergelijking die de verschillen tussen initialisatietechnieken voor netwerkgewichten met de histogramweergave benadrukte.
Tot slot besprak je de overeenkomsten tussen de distributieweergave en de histogramweergave.
Wil je meer leren over deep learning, bekijk dan onze cursus Deep Learning in Keras.
Bekijk onze tutorial Hyperparameteroptimalisatie in machine learning-modellen om meer te leren over parameters en hyperparameters.
Als je contact met me wilt opnemen, stuur me dan een e-mail op thushv@gmail.com of connect via LinkedIn.
Leer meer over Machine Learning en Deep Learning
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

