Curso
Entendendo Machine Learning
2 h
308.8K

Este tutorial vai mostrar como usar o TensorBoard, uma ferramenta incrível para visualizar dados e seu comportamento. Você verá para que tipos de finalidade pode usá-lo ao treinar uma rede neural.
Dica: confira o curso de Deep Learning com Keras da DataCamp aqui.
Antes de começar, garanta que você importou as bibliotecas abaixo para executar o código com sucesso:
from pandas_datareader import data
import matplotlib.pyplot as plt
import pandas as pd
import datetime as dt
import urllib.request, json
import os
import numpy as np

# This code has been tested with TensorFlow 1.6
import tensorflow as tf
from tensorflow.examples.tutorials.mnist import input_data
Para visualizar informações no TensorBoard, primeiro você precisa iniciar o serviço. Para isso,
python3 e você verá um prompt como >>>import tensorflow as tf>>>) digitando exit() e execute o comando abaixo
tensorboard --logdir=summaries--logdir é o diretório onde você vai criar os dados para visualização--port=<porta_que_você_preferir> para alterar a porta em que o TensorBoard rodaTensorBoard 1.6.0 at <url>:6006 (Press CTRL+C to quit)Observação: o TensorBoard não lida bem com múltiplos event files no mesmo diretório. Isso pode gerar curvas estranhas na tela. Por isso, crie uma pasta separada para cada exemplo diferente (por exemplo, summaries/first, summaries/second, ...) para salvar os dados. Outro ponto importante: se quiser rodar um experimento novamente (ou seja, salvar um event file em uma pasta que já tem arquivos), certifique-se de apagar primeiro os arquivos existentes.
Cada visualização aceita formatos de entrada diferentes e exibe os dados de maneiras distintas. Você pode alterná-las na barra superior laranja.
Neste tutorial, vamos cobrir as visualizações em negrito.
Nesta seção, você vai entender por que visualizar certas métricas (por exemplo, loss ou acurácia) ajuda tanto. Ao treinar redes neurais profundas, um dos grandes desafios para iniciantes é entender os efeitos de diferentes escolhas de arquitetura e hiperparâmetros.
Por exemplo, se você inicializar os pesos de forma descuidada, com variância muito alta, o modelo pode divergir rapidamente e colapsar. Por outro lado, mesmo com experiência em treinar redes neurais, é fácil errar na taxa de aprendizado: valores inadequados podem causar desde divergência até saturação precoce em um desempenho abaixo do ideal.
Uma forma de detectar problemas rapidamente é ter uma visualização gráfica, em tempo real (por exemplo, a cada 100 iterações), do que está acontecendo no modelo. Se algo estiver estranho, isso ficará evidente. É exatamente isso que o TensorBoard oferece. Você escolhe quais valores quer exibir, e ele mantém a visualização desses valores durante o treinamento.
Vamos começar criando uma rede neural de cinco camadas para classificar dígitos escritos à mão, usando o famoso dataset MNIST. O TensorFlow oferece uma API simples para carregar o MNIST, então você não precisa baixá-lo manualmente. Antes, definimos um método simples (accuracy()) que calcula a acurácia de previsões em relação aos rótulos verdadeiros.
def accuracy(predictions,labels):
    '''
    Accuracy of a given set of predictions of size (N x n_classes) and
    labels of size (N x n_classes)
    '''
    return np.sum(np.argmax(predictions,axis=1)==np.argmax(labels,axis=1))*100.0/labels.shape[0]
Primeiro, defina um batch_size que indica a quantidade de dados amostrados em um único passo de otimização/validação ou teste. Em seguida, defina os layer_ids, que dão um identificador a cada camada da rede neural. Depois, defina os layer_sizes.
Note que len(layer_sizes) deve ser len(layer_ids)+1, porque layer_sizes inclui o tamanho da entrada no início.
O MNIST tem imagens 28x28, que viram 784 quando achatadas em uma dimensão. Agora você pode definir os placeholders de entrada e rótulo, que serão usados para treinar o modelo. Por fim, defina duas variáveis do TensorFlow para cada camada (weights e bias).
Você pode usar escopos de variável (mais informações aqui) para que as variáveis tenham nomes organizados e fiquem mais fáceis de acessar depois.
batch_size = 100
layer_ids = ['hidden1','hidden2','hidden3','hidden4','hidden5','out']
layer_sizes = [784, 500, 400, 300, 200, 100, 10]

tf.reset_default_graph()

# Inputs and Labels
train_inputs = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[0]], name='train_inputs')
train_labels = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[-1]], name='train_labels')

# Weight and Bias definitions
for idx, lid in enumerate(layer_ids):

    with tf.variable_scope(lid):
        w = tf.get_variable('weights',shape=[layer_sizes[idx], layer_sizes[idx+1]],
                            initializer=tf.truncated_normal_initializer(stddev=0.05))
        b = tf.get_variable('bias',shape= [layer_sizes[idx+1]],
                            initializer=tf.random_uniform_initializer(-0.1,0.1))
Com os placeholders de entrada/saída, pesos e vieses definidos, podemos calcular os logits da rede neural. Logits são os valores não normalizados produzidos na última camada. Após normalização, temos as previsões. Isso envolve iterar por cada camada e computar tf.matmul(h,w) + b. Também é preciso aplicar uma função de ativação como tf.nn.relu(tf.matmul(h,w) + b) em todas as camadas, exceto na última.
Depois, definimos a função de loss usada para otimizar a rede. Neste exemplo, usamos a entropia cruzada, que costuma trazer melhores resultados em classificação do que o erro quadrático médio.
Por fim, definimos um otimizador que recebe o loss e atualiza os pesos na direção que minimiza esse loss.
# Calculating Logits
h = train_inputs
for lid in layer_ids:
    with tf.variable_scope(lid,reuse=True):
        w, b = tf.get_variable('weights'), tf.get_variable('bias')
        if lid != 'out':
          h = tf.nn.relu(tf.matmul(h,w)+b,name=lid+'_output')
        else:
          h = tf.nn.xw_plus_b(h,w,b,name=lid+'_output')

tf_predictions = tf.nn.softmax(h, name='predictions')
# Calculating Loss
tf_loss = tf.reduce_mean(tf.nn.softmax_cross_entropy_with_logits_v2(labels=train_labels, logits=h),name='loss')

# Optimizer
tf_learning_rate = tf.placeholder(tf.float32, shape=None, name='learning_rate')
optimizer = tf.train.MomentumOptimizer(tf_learning_rate,momentum=0.9)
grads_and_vars = optimizer.compute_gradients(tf_loss)
tf_loss_minimize = optimizer.minimize(tf_loss)
Aqui você define objetos tf.summary. Esses objetos são o tipo de entidade que o TensorBoard entende. Ou seja, qualquer valor que você queira exibir deve ser encapsulado como um objeto tf.summary.
Há vários tipos de summary. Como estamos visualizando apenas escalares, podemos definir objetos tf.summary.scalar. Além disso, dá para usar tf.name_scope para agrupar escalares no painel. Escalares com o mesmo name scope aparecem na mesma linha. Aqui definimos três summaries.
tf_loss_summary: você alimenta um valor via placeholder sempre que quiser publicar no paineltf_accuracy_summary: idem, para a acuráciatf_gradnorm_summary: calcula a norma L2 dos gradientes da última camada da rede. A norma do gradiente é um bom indicador se os pesos estão sendo atualizados corretamente. Norma muito pequena pode indicar vanishing gradient, e muito grande pode indicar exploding gradient.# Name scope allows you to group various summaries together
# Summaries having the same name_scope will be displayed on the same row
with tf.name_scope('performance'):
# Summaries need to be displayed
# Whenever you need to record the loss, feed the mean loss to this placeholder
tf_loss_ph = tf.placeholder(tf.float32,shape=None,name='loss_summary')
# Create a scalar summary object for the loss so it can be displayed
tf_loss_summary = tf.summary.scalar('loss', tf_loss_ph)
# Whenever you need to record the loss, feed the mean test accuracy to this placeholder
tf_accuracy_ph = tf.placeholder(tf.float32,shape=None, name='accuracy_summary')
# Create a scalar summary object for the accuracy so it can be displayed
tf_accuracy_summary = tf.summary.scalar('accuracy', tf_accuracy_ph)
# Gradient norm summary
for g,v in grads_and_vars:
if 'hidden5' in v.name and 'weights' in v.name:
with tf.name_scope('gradients'):
tf_last_grad_norm = tf.sqrt(tf.reduce_mean(g**2))
tf_gradnorm_summary = tf.summary.scalar('grad_norm', tf_last_grad_norm)
break
# Merge all summaries together
performance_summaries = tf.summary.merge([tf_loss_summary,tf_accuracy_summary])
No código abaixo fazemos o seguinte. Primeiro, criamos uma sessão, onde executamos as operações definidas acima. Depois, criamos uma pasta para salvar os summary data. Em seguida, criamos um writer de summaries, o summ_writer. Agora podemos inicializar todas as variáveis. Depois, carregamos o dataset MNIST.
Então, para cada época e para cada batch de treino (ou seja, cada iteração), executamos o gradnorm_summary se for a primeira iteração e gravamos esse summary no arquivo de eventos com o writer. Em seguida, executamos a otimização do modelo e calculamos o loss. Ao final de uma época completa, calculamos o loss médio de treino.
Fazemos um processo similar para a validação. Em cada batch de validação, calculamos a acurácia e, depois, a acurácia média do conjunto de validação.
Por fim, executamos a fase de teste. Para cada batch de teste, calculamos a acurácia e, ao final, a acurácia média do conjunto de teste. No encerramento, executamos os performance_summaries e gravamos tudo no arquivo de eventos com o writer.
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25

config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure Tensorflow doesn't overflow the GPU

session = tf.InteractiveSession(config=config)

if not os.path.exists('summaries'):
    os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','first')):
    os.mkdir(os.path.join('summaries','first'))

summ_writer = tf.summary.FileWriter(os.path.join('summaries','first'), session.graph)

tf.global_variables_initializer().run()

accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)


for epoch in range(n_epochs):
    loss_per_epoch = []
    for i in range(n_train//batch_size):

        # =================================== Training for one step ========================================
        batch = mnist_data.train.next_batch(batch_size)    # Get one batch of training data
        if i == 0:
            # Only for the first epoch, get the summary data
            # Otherwise, it can clutter the visualization
            l,_,gn_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary],
                                      feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                                 train_labels: batch[1],
                                                tf_learning_rate: 0.0001})
            summ_writer.add_summary(gn_summ, epoch)
        else:
            # Optimize with training data
            l,_ = session.run([tf_loss,tf_loss_minimize],
                              feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                         train_labels: batch[1],
                                         tf_learning_rate: 0.0001})
        loss_per_epoch.append(l)

    print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
    avg_loss = np.mean(loss_per_epoch)

    # ====================== Calculate the Validation Accuracy ==========================
    valid_accuracy_per_epoch = []
    for i in range(n_valid//batch_size):
        valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
        valid_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
        valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))

    mean_v_acc = np.mean(valid_accuracy_per_epoch)
    print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))

    # ===================== Calculate the Test Accuracy ===============================
    accuracy_per_epoch = []
    for i in range(n_test//batch_size):
        test_images, test_labels = mnist_data.test.next_batch(batch_size)
        test_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: test_images.reshape(batch_size,image_size*image_size)}
        )
        accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))

    print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
    avg_test_accuracy = np.mean(accuracy_per_epoch)

    # Execute the summaries defined above
    summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})

    # Write the obtained summaries to the file, so it can be displayed in the TensorBoard
    summ_writer.add_summary(summ, epoch)

session.close()
Successfully downloaded train-images-idx3-ubyte.gz 9912422 bytes.
Extracting MNIST_data/train-images-idx3-ubyte.gz
Successfully downloaded train-labels-idx1-ubyte.gz 28881 bytes.
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Successfully downloaded t10k-images-idx3-ubyte.gz 1648877 bytes.
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Successfully downloaded t10k-labels-idx1-ubyte.gz 4542 bytes.
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 2.30252
    Average Valid Accuracy in epoch 0: 10.02000
    Average Test Accuracy in epoch 0: 9.76000

Average loss in epoch 1: 2.30016
    Average Valid Accuracy in epoch 1: 12.56000
    Average Test Accuracy in epoch 1: 12.64000

  ...
  ...
  ...

Average loss in epoch 24: 1.03386
    Average Valid Accuracy in epoch 24: 71.88000
    Average Test Accuracy in epoch 24: 71.23000
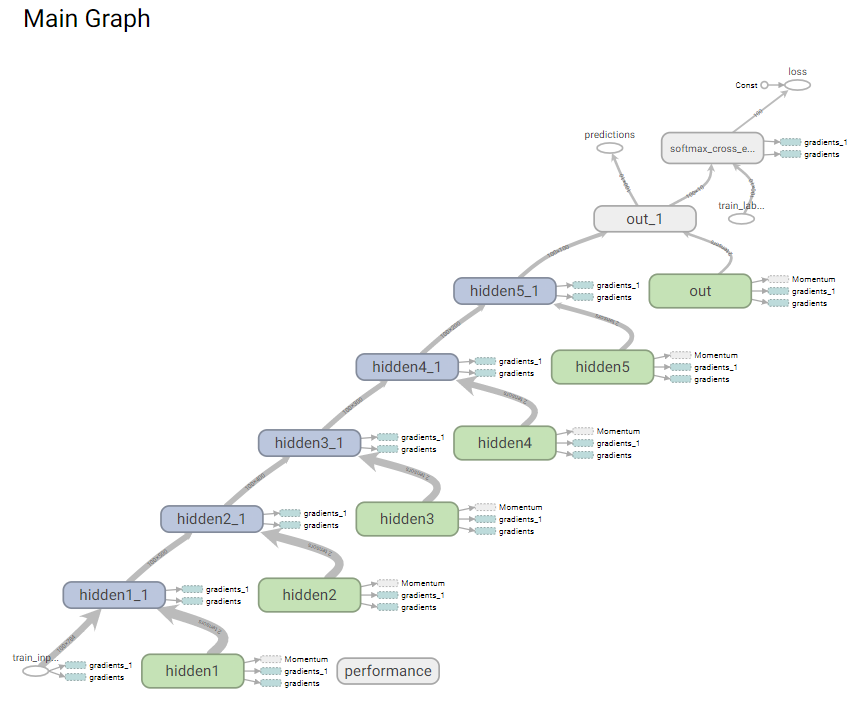
Primeiro, veja como é o grafo computacional do seu modelo. Acesse esse painel clicando em Graphs no TensorBoard. Deve ficar parecido com a imagem abaixo. Dá para ver um fluxo organizado de train_inputs até loss e predictions, passando pelas camadas ocultas de 1 a 5.
A classificação do MNIST é um dos exemplos mais simples — e ainda assim não foi resolvida com uma rede de 5 camadas aqui. No MNIST, não é difícil passar de 90% de acurácia em menos de 5 épocas.
Então, o que está acontecendo?
Vamos olhar no TensorBoard:
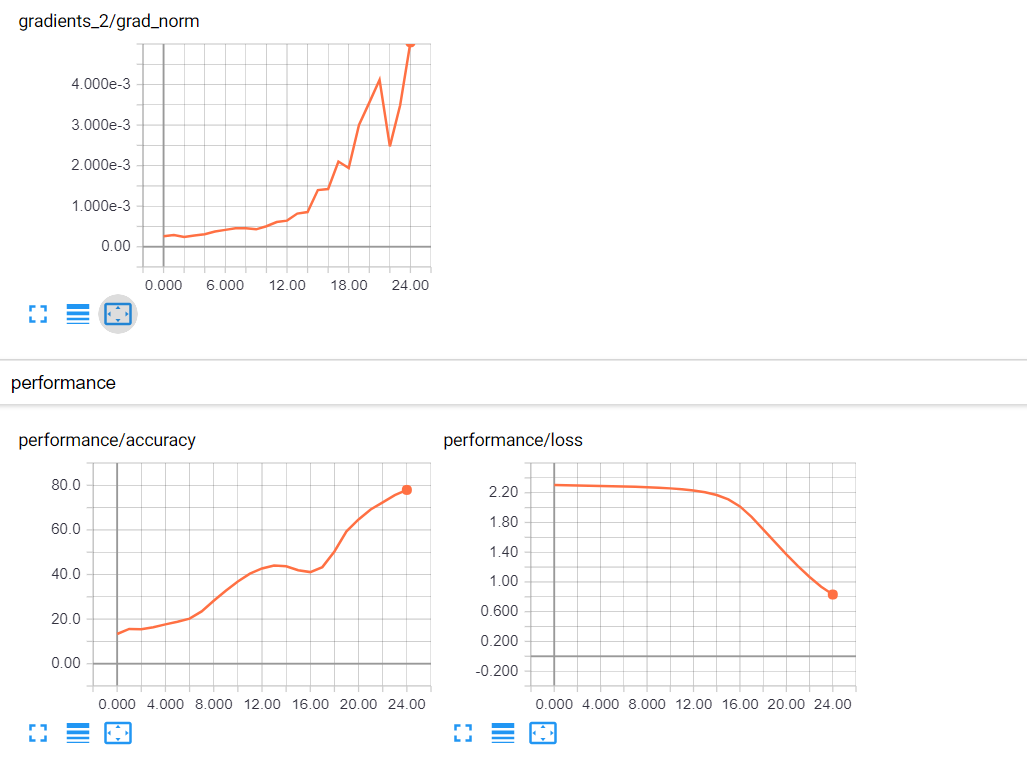
Você pode ver que a acurácia está subindo, mas muito lentamente, e que as atualizações de gradiente aumentam ao longo do tempo. Isso é estranho. Perto da convergência, o esperado é ver os gradientes diminuindo (indo a zero), não aumentando. Mas como a acurácia sobe, estamos na direção certa. Provavelmente falta uma taxa de aprendizado maior.
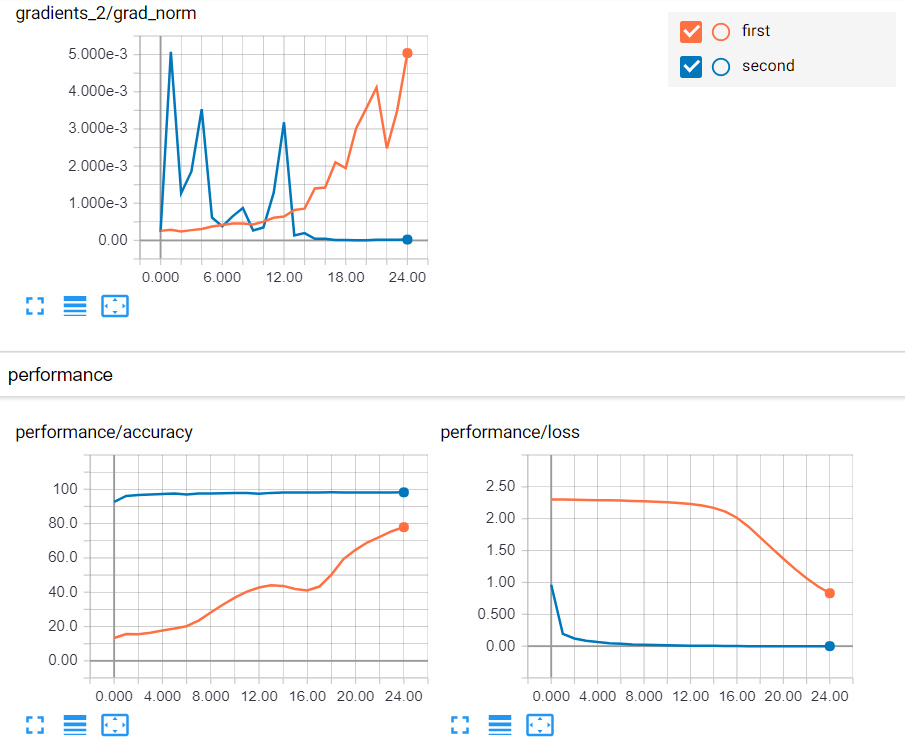
Agora, tente uma taxa de aprendizado de 0.01. É praticamente idêntico à execução anterior, exceto pelo uso de 0.01 em vez de 0.0001. Onde estiver tf_learning_rate: 0.0001, use tf_learning_rate: 0.01. Atenção: há duas ocorrências para trocar.
Agora dá para ver que a acurácia começa perto de 100 e continua subindo. E os gradientes vão diminuindo ao longo do tempo, aproximando-se de zero. Com a taxa de aprendizado 0.01, tudo parece bem mais estável.
Em seguida, vamos além dos escalares. Você verá como analisar vetores e coleções de escalares.
Você viu como a visualização de escalares no TensorBoard ajuda a entender o comportamento do modelo e a corrigir problemas. Além disso, visualizar o grafo confirma que há um caminho ininterrupto das entradas às previsões, necessário para o cálculo dos gradientes.
Agora, vamos a outra visualização útil do TensorBoard: histogramas ou distribuições.
Lembre que um histograma é uma coleção de valores representada pela frequência/densidade desses valores. Podemos usá-los para visualizar os pesos da rede ao longo do tempo. Isso é importante porque, se os pesos estiverem “pulando” demais durante o treino, pode indicar problema na inicialização ou na taxa de aprendizado.
No exemplo, vamos observar como os pesos mudam. No código, usamos truncated_normal_initializer() para inicializá-los.
Novamente, vamos definir objetos tf.summary. Mas, como agora visualizamos vetores de escalares, precisamos de tf.summary.histogram.
Neste caso, definimos dois histogramas (tf_w_hist e tf_b_hist) contendo, respectivamente, os pesos e vieses de uma camada. Faremos isso para todas as camadas, cada uma com seu próprio name scope.
Por fim, usamos tf.summary.merge para criar uma operação agrupada que executa todos os summaries de uma vez.
# Summaries need to be displayed
# Create a summary for each weight bias in each layer
all_summaries = []
for lid in layer_ids:
    with tf.name_scope(lid+'_hist'):
        with tf.variable_scope(lid,reuse=True):
            w,b = tf.get_variable('weights'), tf.get_variable('bias')

            # Create a scalar summary object for the loss so it can be displayed
            tf_w_hist = tf.summary.histogram('weights_hist', tf.reshape(w,[-1]))
            tf_b_hist = tf.summary.histogram('bias_hist', b)
            all_summaries.extend([tf_w_hist, tf_b_hist])

# Merge all parameter histogram summaries together
tf_param_summaries = tf.summary.merge(all_summaries)
Esta etapa é quase igual à anterior, mas agora temos algumas linhas extras para calcular os summaries de histograma (tf_param_summaries).
Note também que as taxas de aprendizado mudaram novamente.
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25

config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure Tensorflow doesn't overflow the GPU

session = tf.InteractiveSession(config=config)

if not os.path.exists('summaries'):
    os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','third')):
    os.mkdir(os.path.join('summaries','third'))

summ_writer_3 = tf.summary.FileWriter(os.path.join('summaries','third'), session.graph)

tf.global_variables_initializer().run()

accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)


for epoch in range(n_epochs):
    loss_per_epoch = []
    for i in range(n_train//batch_size):

        # =================================== Training for one step ========================================
        batch = mnist_data.train.next_batch(batch_size)    # Get one batch of training data
        if i == 0:
            # Only for the first epoch, get the summary data
            # Otherwise, it can clutter the visualization
            l,_,gn_summ, wb_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary, tf_param_summaries],
                                      feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                                 train_labels: batch[1],
                                                tf_learning_rate: 0.00001})
            summ_writer_3.add_summary(gn_summ, epoch)
            summ_writer_3.add_summary(wb_summ, epoch)
        else:
            # Optimize with training data
            l,_ = session.run([tf_loss,tf_loss_minimize],
                              feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                         train_labels: batch[1],
                                         tf_learning_rate: 0.01})
        loss_per_epoch.append(l)

    print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
    avg_loss = np.mean(loss_per_epoch)

    # ====================== Calculate the Validation Accuracy ==========================
    valid_accuracy_per_epoch = []
    for i in range(n_valid//batch_size):
        valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
        valid_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
        valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))

    mean_v_acc = np.mean(valid_accuracy_per_epoch)
    print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))

    # ===================== Calculate the Test Accuracy ===============================
    accuracy_per_epoch = []
    for i in range(n_test//batch_size):
        test_images, test_labels = mnist_data.test.next_batch(batch_size)
        test_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: test_images.reshape(batch_size,image_size*image_size)}
        )
        accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))

    print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
    avg_test_accuracy = np.mean(accuracy_per_epoch)

    # Execute the summaries defined above
    summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})

    # Write the obtained summaries to the file, so they can be displayed
    summ_writer_3.add_summary(summ, epoch)

session.close()
Extracting MNIST_data/train-images-idx3-ubyte.gz
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 1.02625
    Average Valid Accuracy in epoch 0: 92.76000
    Average Test Accuracy in epoch 0: 92.65000

Average loss in epoch 1: 0.19110
    Average Valid Accuracy in epoch 1: 95.80000
    Average Test Accuracy in epoch 1: 95.48000

  ...
  ...
  ...

Average loss in epoch 24: 0.00009
    Average Valid Accuracy in epoch 24: 98.28000
    Average Test Accuracy in epoch 24: 98.09000
Veja como ficam seus pesos e vieses. Primeiro, temos 3 eixos: tempo (x), valor (y) e frequência/densidade (z). Histogramas mais escuros representam dados mais antigos; mais claros, dados recentes. Um valor mais alto no eixo z indica que o vetor tem mais valores próximos daquele ponto.
Observação: também há uma visualização "overlay" dos histogramas ao longo do tempo. Você pode trocar o tipo de exibição no painel de opções à esquerda.
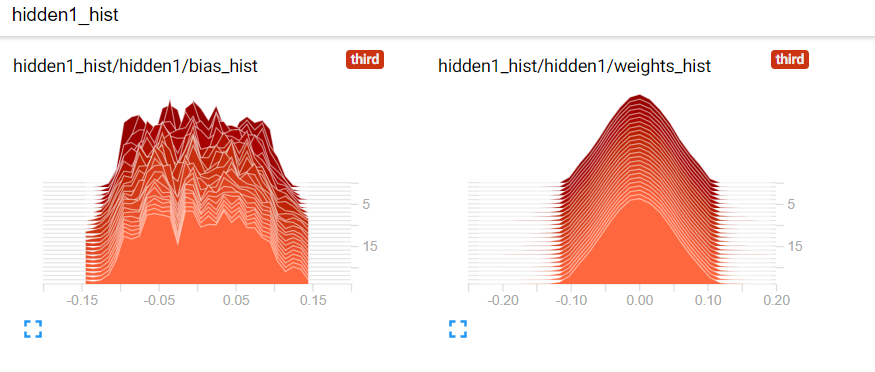
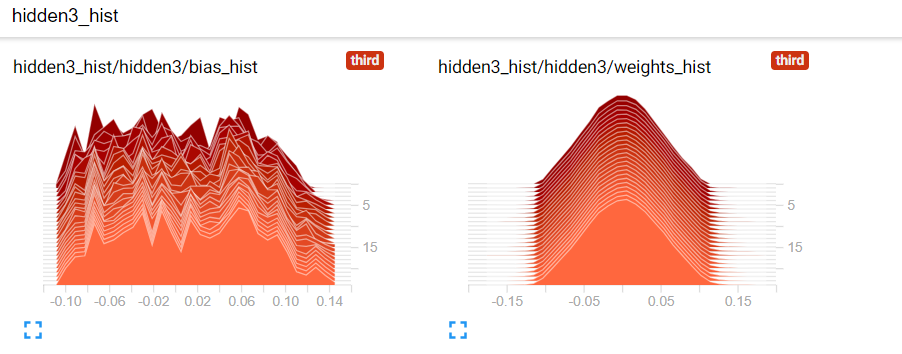
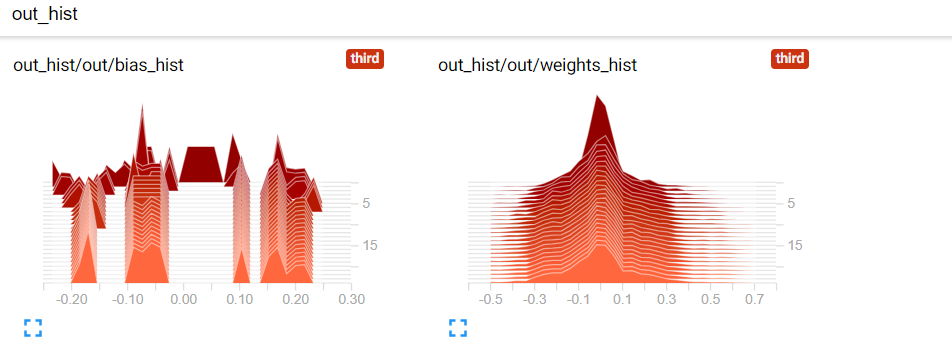
Agora, em vez de truncated_normal_initializer(), vamos usar xavier_initializer() para inicializar os pesos. A inicialização Xavier costuma ser bem melhor, especialmente em redes profundas.
Isso porque, em vez de usar um desvio-padrão fixo definido pelo usuário (como fizemos com truncated_normal_initializer()), a Xavier decide automaticamente o desvio-padrão com base no número de conexões de entrada e saída da camada. Isso ajuda os gradientes a fluírem de cima a baixo sem problemas como vanishing gradient. Em seguida, redefinimos o modelo.
Primeiro, defina um batch_size indicando quantos dados são amostrados em cada passo de otimização/validação ou teste. Depois defina os layer_ids, que identificam cada camada da rede.
Defina então os layer_sizes. Note que len(layer_sizes) deve ser len(layer_ids)+1, pois inclui o tamanho da entrada. O MNIST tem imagens 28x28, que viram 784 quando achatadas.
Depois, defina os placeholders de entrada e rótulo, usados no treino. Por fim, crie duas variáveis do TensorFlow para cada camada (weights e bias).
Observação: isto é idêntico ao primeiro código, mudando apenas a técnica de inicialização dos pesos.
batch_size = 100
layer_ids = ['hidden1','hidden2','hidden3','hidden4','hidden5','out']
layer_sizes = [784, 500, 400, 300, 200, 100, 10]

tf.reset_default_graph()

# Inputs and Labels
train_inputs = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[0]], name='train_inputs')
train_labels = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[-1]], name='train_labels')

# Weight and Bias definitions
for idx, lid in enumerate(layer_ids):

    with tf.variable_scope(lid):
        w = tf.get_variable('weights',shape=[layer_sizes[idx], layer_sizes[idx+1]],
                            initializer=tf.contrib.layers.xavier_initializer())
        b = tf.get_variable('bias',shape= [layer_sizes[idx+1]],
                            initializer=tf.random_uniform_initializer(-0.1,0.1))
Com os placeholders, pesos e vieses definidos, podemos novamente calcular os logits da rede neural.
Observação: esta parte é idêntica ao código usado na primeira vez em que definimos essas operações e tensores.
Aqui você define os objetos tf.summary novamente. Também é idêntico ao código da primeira definição dessas operações e tensores.
Mais uma vez, definimos objetos tf.summary. Agora, como visualizamos vetores de escalares, precisamos de tf.summary.histogram.
Observação: também é idêntico ao código da primeira vez.
Observação: é o mesmo procedimento da seção anterior!
Você só precisa alterar alguns trechos: as três ocorrências de os.path.join('summaries','third') para os.path.join('summaries','fourth'), summ_writer_3 para summ_writer_4 (4 vezes) e ajustar o tf_learning_rate de 0.00001 para 0.01.
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25

config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure TensorFlow doesn't overflow the GPU

session = tf.InteractiveSession(config=config)

if not os.path.exists('summaries'):
    os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','fourth')):
    os.mkdir(os.path.join('summaries','fourth'))

summ_writer_4 = tf.summary.FileWriter(os.path.join('summaries','fourth'), session.graph)

tf.global_variables_initializer().run()

accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)


for epoch in range(n_epochs):
    loss_per_epoch = []
    for i in range(n_train//batch_size):

        # =================================== Training for one step ========================================
        batch = mnist_data.train.next_batch(batch_size)    # Get one batch of training data
        if i == 0:
            # Only for the first epoch, get the summary data
            # Otherwise, it can clutter the visualization
            l,_,gn_summ, wb_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary, tf_param_summaries],
                                      feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                                 train_labels: batch[1],
                                                tf_learning_rate: 0.01})
            summ_writer_4.add_summary(gn_summ, epoch)
            summ_writer_4.add_summary(wb_summ, epoch)
        else:
            # Optimize with training data
            l,_ = session.run([tf_loss,tf_loss_minimize],
                              feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                         train_labels: batch[1],
                                         tf_learning_rate: 0.01})
        loss_per_epoch.append(l)

    print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
    avg_loss = np.mean(loss_per_epoch)

    # ====================== Calculate the Validation Accuracy ==========================
    valid_accuracy_per_epoch = []
    for i in range(n_valid//batch_size):
        valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
        valid_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
        valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))

    mean_v_acc = np.mean(valid_accuracy_per_epoch)
    print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))

    # ===================== Calculate the Test Accuracy ===============================
    accuracy_per_epoch = []
    for i in range(n_test//batch_size):
        test_images, test_labels = mnist_data.test.next_batch(batch_size)
        test_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: test_images.reshape(batch_size,image_size*image_size)}
        )
        accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))

    print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
    avg_test_accuracy = np.mean(accuracy_per_epoch)

    # Execute the summaries defined above
    summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})

    # Write the obtained summaries to the file, so they can be displayed
    summ_writer_4.add_summary(summ, epoch)

session.close()
Extracting MNIST_data/train-images-idx3-ubyte.gz
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 0.43618
    Average Valid Accuracy in epoch 0: 95.70000
    Average Test Accuracy in epoch 0: 95.22000

Average loss in epoch 1: 0.12872
    Average Valid Accuracy in epoch 1: 96.86000
    Average Test Accuracy in epoch 1: 96.71000

  ...
  ...
  ...

Average loss in epoch 24: 0.00009
    Average Valid Accuracy in epoch 24: 98.42000
    Average Test Accuracy in epoch 24: 98.21000
Aqui você pode comparar como os pesos evoluem ao longo do tempo para duas inicializações: truncated_normal_initializer (vermelho) e xavier_initializer (azul). Repare que xavier_initializer mantém mais pesos longe de zero do que o normal, o que é melhor. Isso pode permitir que redes inicializadas com Xavier convirjam mais rápido, como sugerem as curvas de loss/acurácia.
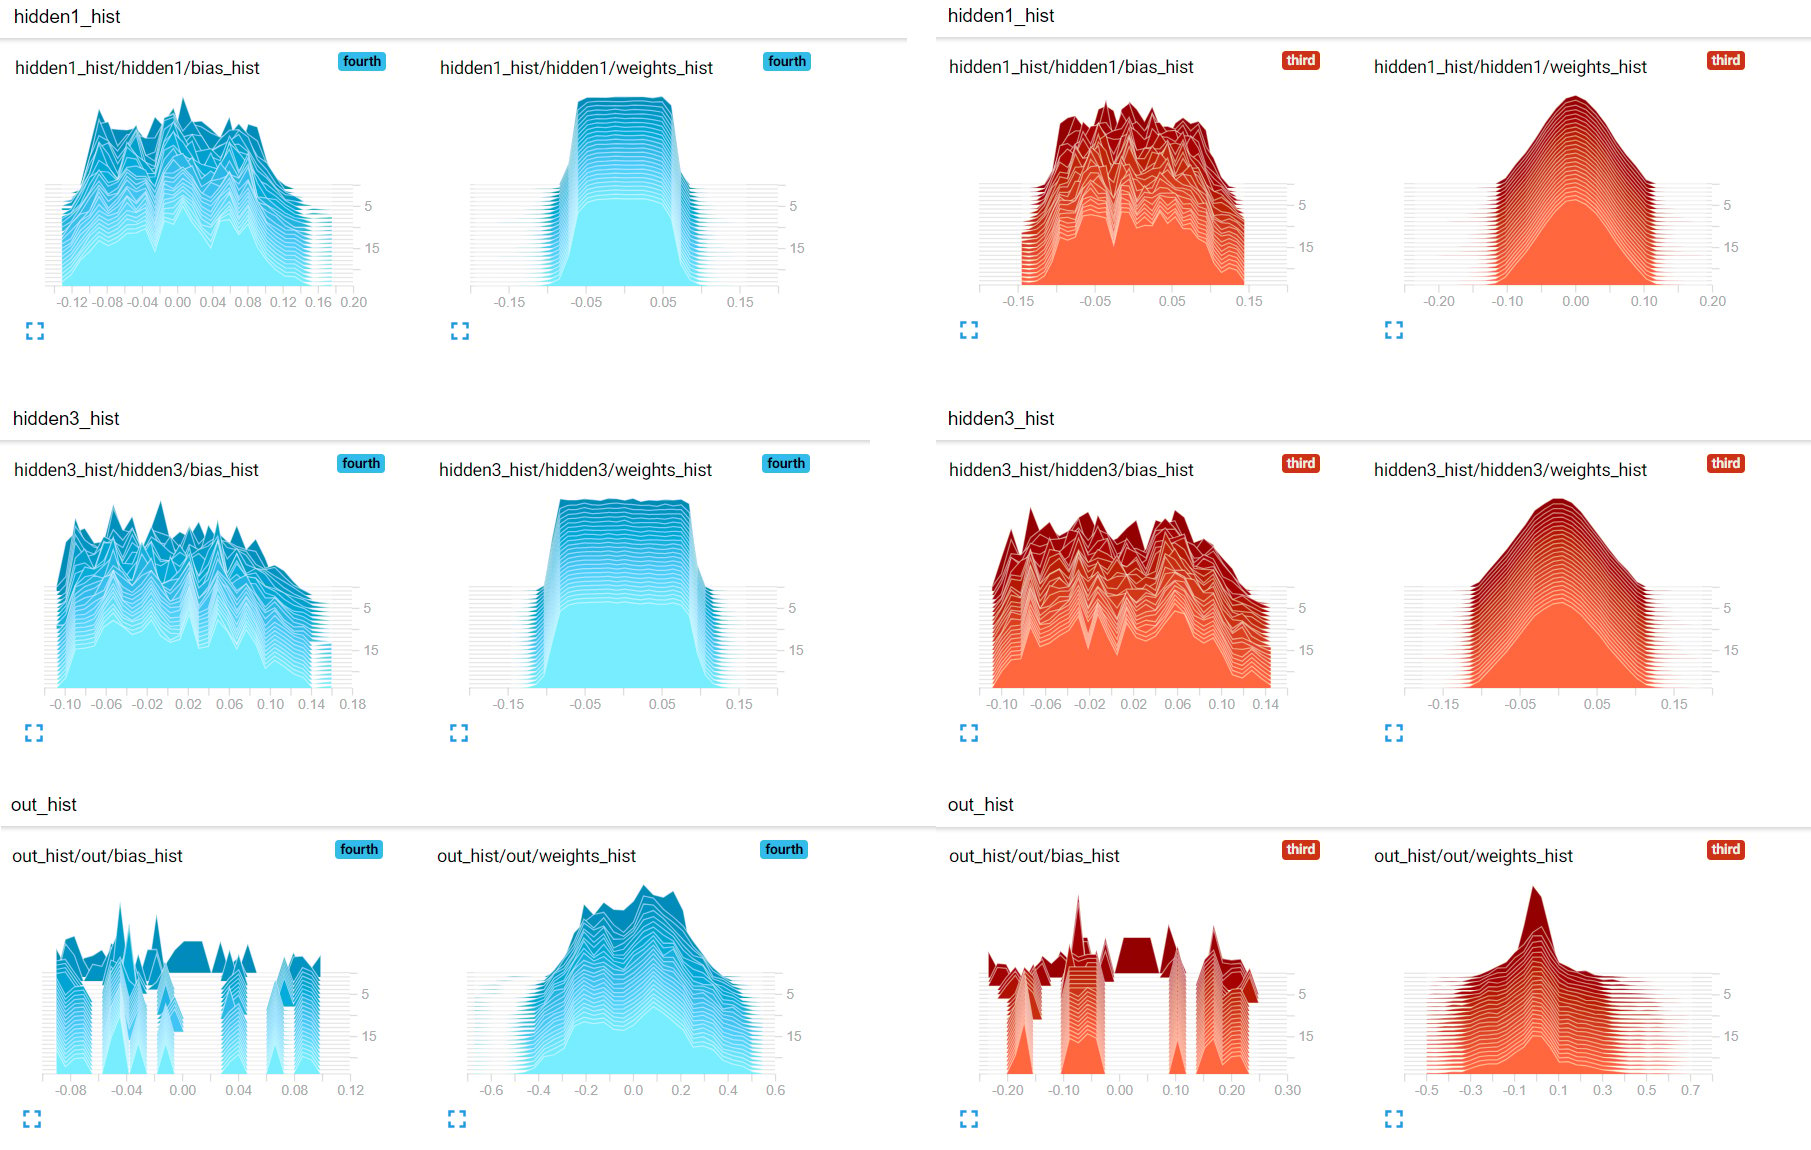
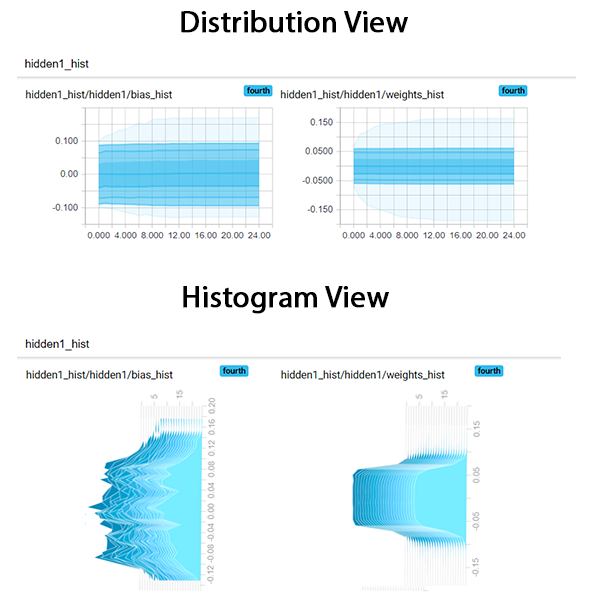
Agora podemos comparar duas visões: a de histograma e a de distribuição. A visualização de distribuição é, essencialmente, outra forma de olhar para os histogramas. Na imagem abaixo, dá para notar que a visão de distribuição é como uma “vista de cima” do histograma. Note que, neste caso, os gráficos de histograma foram rotacionados para facilitar a comparação.
Neste tutorial, você viu como usar o TensorBoard. Primeiro, aprendeu a iniciar o serviço pelo prompt (Windows) ou terminal (Ubuntu/Mac). Depois, explorou diferentes visualizações de dados oferecidas pelo TensorBoard. Em seguida, analisou código que visualiza valores escalares (por exemplo, loss/acurácia) usando uma rede neural feed-forward para entender na prática a utilidade dessa visualização.
Depois, vimos como visualizar coleções/vetores de escalares com histogramas e comparamos técnicas de inicialização de pesos usando essa visualização.
Por fim, discutimos as semelhanças entre as visões de distribuição e de histograma.
Se quiser aprender mais sobre deep learning, confira nosso curso Deep Learning in Keras.
Veja também nosso tutorial Otimização de hiperparâmetros em modelos de machine learning para aprender mais sobre parâmetros e hiperparâmetros.
Se quiser falar comigo, me envie um e-mail em thushv@gmail.com ou me adicione no LinkedIn.
Aprenda mais sobre machine learning e deep learning
Curso
Curso
Curso
Tutorial
Zoumana Keita
14 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Abid Ali Awan
10 min
Tutorial
Zoumana Keita
14 min
Tutorial
Bharath K
13 min
Tutorial
Arjun Sarkar
15 min