Cours
Comprendre le Machine Learning
2 h
308.6K

Ce tutoriel vous guide pas à pas pour utiliser TensorBoard, un formidable outil pour visualiser des données et leurs comportements. Vous verrez à quelles fins l’utiliser lors de l’entraînement d’un réseau de neurones.
Astuce : découvrez le cours Deep Learning avec Keras de DataCamp ici.
Avant de commencer, importez les bibliothèques suivantes pour exécuter correctement le code :
from pandas_datareader import data
import matplotlib.pyplot as plt
import pandas as pd
import datetime as dt
import urllib.request, json
import os
import numpy as np

# This code has been tested with TensorFlow 1.6
import tensorflow as tf
from tensorflow.examples.tutorials.mnist import input_data
Pour visualiser avec TensorBoard, vous devez d’abord lancer son service. Pour cela :
python3, vous devriez voir l’invite >>>import tensorflow as tf>>>) en tapant exit() et saisissez la commande suivante :
tensorboard --logdir=summaries--logdir indique le répertoire où vous créerez les données à visualiser--port= pour changer le port d’exécution de TensorBoardTensorBoard 1.6.0 at <url>:6006 (Press CTRL+C to quit)Remarque : TensorBoard n’apprécie pas la présence de plusieurs event files dans un même répertoire. Vous pourriez obtenir des courbes « bizarres » à l’écran. Créez donc un dossier distinct pour chaque exemple (par exemple : summaries/first, summaries/second, …) pour y enregistrer les données. Par ailleurs, si vous souhaitez relancer une expérience (c’est-à-dire écrire un event file dans un dossier déjà peuplé), pensez à supprimer d’abord les fichiers existants.
Chaque vue attend des formats d’entrée différents et les présente à sa façon. Vous pouvez les changer via la barre orange en haut.
Dans ce tutoriel, vous couvrirez les vues affichées en gras.
Dans cette section, vous verrez d’abord pourquoi visualiser certains indicateurs (par exemple la perte ou la précision) est utile. Lorsqu’on entraîne des réseaux de neurones profonds, l’un des écueils récurrents pour les débutants est de mal appréhender l’impact des choix d’architecture et des hyperparamètres.
Par exemple, si vous initialisez négligemment les poids avec une variance très élevée, votre modèle peut rapidement diverger et s’effondrer. À l’inverse, même en étant à l’aise avec les réseaux de neurones, ne pas surveiller le taux d’apprentissage peut conduire à la divergence du modèle ou à une saturation prématurée sur une performance sous-optimale.
Un moyen rapide de détecter des problèmes consiste à visualiser en temps réel ce qui se passe dans le modèle (par exemple toutes les 100 itérations). En cas de comportement anormal, cela saute aux yeux. C’est précisément ce que propose TensorBoard : vous décidez des valeurs à afficher et une visualisation en temps réel est maintenue pendant l’apprentissage.
Vous commencez par créer un réseau de neurones à cinq couches pour classer des images de chiffres manuscrits, en utilisant le célèbre jeu de données MNIST. TensorFlow fournit une API simple pour charger MNIST, vous n’avez donc pas à le télécharger manuellement. Avant cela, vous définissez une méthode simple (accuracy()) qui calcule la précision des prédictions par rapport aux étiquettes réelles.
def accuracy(predictions,labels):
    '''
    Accuracy of a given set of predictions of size (N x n_classes) and
    labels of size (N x n_classes)
    '''
    return np.sum(np.argmax(predictions,axis=1)==np.argmax(labels,axis=1))*100.0/labels.shape[0]
Commencez par définir un batch_size qui correspond au volume de données prélevé à chaque étape d’optimisation/validation ou de test. Puis définissez les layer_ids, identifiants de chaque couche du réseau de neurones que vous allez définir. Vous pouvez ensuite fixer les layer_sizes.
Notez que len(layer_sizes) doit être égal à len(layer_ids)+1, car layer_sizes inclut la taille d’entrée en début de liste.
MNIST contient des images 28x28, soit 784 une fois dépliées en 1 dimension. Définissez ensuite les placeholders des entrées et des étiquettes, qui serviront à entraîner le modèle. Enfin, déclarez deux variables TensorFlow par couche (weights et bias).
Vous pouvez utiliser le variable scoping (plus d’infos ici) afin de nommer proprement les variables et les retrouver facilement par la suite.
batch_size = 100
layer_ids = ['hidden1','hidden2','hidden3','hidden4','hidden5','out']
layer_sizes = [784, 500, 400, 300, 200, 100, 10]

tf.reset_default_graph()

# Inputs and Labels
train_inputs = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[0]], name='train_inputs')
train_labels = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[-1]], name='train_labels')

# Weight and Bias definitions
for idx, lid in enumerate(layer_ids):

    with tf.variable_scope(lid):
        w = tf.get_variable('weights',shape=[layer_sizes[idx], layer_sizes[idx+1]],
                            initializer=tf.truncated_normal_initializer(stddev=0.05))
        b = tf.get_variable('bias',shape= [layer_sizes[idx+1]],
                            initializer=tf.random_uniform_initializer(-0.1,0.1))
Avec les placeholders d’entrée/sortie et les poids/biais de chaque couche définis, vous pouvez maintenant décrire le calcul des logits du réseau. Les logits sont les valeurs non normalisées produites par la dernière couche. Une fois normalisées, ce sont les prédictions. Cela implique d’itérer sur chaque couche et de calculer tf.matmul(h,w) + b. Vous appliquerez également une fonction d’activation comme tf.nn.relu(tf.matmul(h,w) + b) pour toutes les couches sauf la dernière.
Définissez ensuite la fonction de perte utilisée pour optimiser le réseau. Dans cet exemple, la cross-entropie donne souvent de meilleurs résultats que l’erreur quadratique moyenne en classification.
Enfin, déclarez un optimiseur qui prend la perte en entrée et met à jour les poids dans la direction qui la minimise.
# Calculating Logits
h = train_inputs
for lid in layer_ids:
    with tf.variable_scope(lid,reuse=True):
        w, b = tf.get_variable('weights'), tf.get_variable('bias')
        if lid != 'out':
          h = tf.nn.relu(tf.matmul(h,w)+b,name=lid+'_output')
        else:
          h = tf.nn.xw_plus_b(h,w,b,name=lid+'_output')

tf_predictions = tf.nn.softmax(h, name='predictions')
# Calculating Loss
tf_loss = tf.reduce_mean(tf.nn.softmax_cross_entropy_with_logits_v2(labels=train_labels, logits=h),name='loss')

# Optimizer
tf_learning_rate = tf.placeholder(tf.float32, shape=None, name='learning_rate')
optimizer = tf.train.MomentumOptimizer(tf_learning_rate,momentum=0.9)
grads_and_vars = optimizer.compute_gradients(tf_loss)
tf_loss_minimize = optimizer.minimize(tf_loss)
Ici, vous allez définir des objets tf.summary. Ce sont les entités comprises par TensorBoard. Autrement dit, toute valeur à afficher doit être encapsulée dans un objet tf.summary.
Il existe plusieurs types de summaries. Comme vous visualisez uniquement des scalaires, définissez des objets tf.summary.scalar. Vous pouvez en outre utiliser tf.name_scope pour regrouper des scalaires : ceux qui partagent le même name scope s’affichent sur la même ligne. Vous définissez ici trois summaries.
tf_loss_summary : vous y fournissez une valeur via un placeholder quand vous voulez la publier dans le boardtf_accuracy_summary : même principe pour la précisiontf_gradnorm_summary : calcule la norme L2 des gradients de la dernière couche du réseau. La norme du gradient est un bon indicateur de la bonne mise à jour des poids. Une norme trop petite peut signaler un gradient qui s’annule, trop grande un gradient qui explose.# Name scope allows you to group various summaries together
# Summaries having the same name_scope will be displayed on the same row
with tf.name_scope('performance'):
# Summaries need to be displayed
# Whenever you need to record the loss, feed the mean loss to this placeholder
tf_loss_ph = tf.placeholder(tf.float32,shape=None,name='loss_summary')
# Create a scalar summary object for the loss so it can be displayed
tf_loss_summary = tf.summary.scalar('loss', tf_loss_ph)
# Whenever you need to record the loss, feed the mean test accuracy to this placeholder
tf_accuracy_ph = tf.placeholder(tf.float32,shape=None, name='accuracy_summary')
# Create a scalar summary object for the accuracy so it can be displayed
tf_accuracy_summary = tf.summary.scalar('accuracy', tf_accuracy_ph)
# Gradient norm summary
for g,v in grads_and_vars:
if 'hidden5' in v.name and 'weights' in v.name:
with tf.name_scope('gradients'):
tf_last_grad_norm = tf.sqrt(tf.reduce_mean(g**2))
tf_gradnorm_summary = tf.summary.scalar('grad_norm', tf_last_grad_norm)
break
# Merge all summaries together
performance_summaries = tf.summary.merge([tf_loss_summary,tf_accuracy_summary])
Dans le code ci-dessous : vous créez d’abord une session pour exécuter les opérations définies plus haut. Puis vous créez un dossier pour enregistrer les summaries. Ensuite, vous créez un writer de summaries summ_writer. Vous pouvez maintenant initialiser toutes les variables, puis charger MNIST.
Ensuite, pour chaque époque et chaque lot de données d’apprentissage, exécutez gradnorm_summary si c’est la première itération et écrivez-le dans l’event file avec le writer. Exécutez l’optimisation du modèle et le calcul de la perte. Après avoir parcouru tout l’ensemble d’apprentissage pour une époque, calculez la perte moyenne.
Procédez de manière similaire pour la validation : pour chaque lot, calculez la précision de validation, puis la précision moyenne sur tout l’ensemble de validation.
Enfin, étape de test : pour chaque lot de test, calculez la précision puis la précision moyenne sur tout l’ensemble de test. En toute fin, exécutez performance_summaries et écrivez-les dans l’event file via le writer.
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25

config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure Tensorflow doesn't overflow the GPU

session = tf.InteractiveSession(config=config)

if not os.path.exists('summaries'):
    os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','first')):
    os.mkdir(os.path.join('summaries','first'))

summ_writer = tf.summary.FileWriter(os.path.join('summaries','first'), session.graph)

tf.global_variables_initializer().run()

accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)


for epoch in range(n_epochs):
    loss_per_epoch = []
    for i in range(n_train//batch_size):

        # =================================== Training for one step ========================================
        batch = mnist_data.train.next_batch(batch_size)    # Get one batch of training data
        if i == 0:
            # Only for the first epoch, get the summary data
            # Otherwise, it can clutter the visualization
            l,_,gn_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary],
                                      feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                                 train_labels: batch[1],
                                                tf_learning_rate: 0.0001})
            summ_writer.add_summary(gn_summ, epoch)
        else:
            # Optimize with training data
            l,_ = session.run([tf_loss,tf_loss_minimize],
                              feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                         train_labels: batch[1],
                                         tf_learning_rate: 0.0001})
        loss_per_epoch.append(l)

    print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
    avg_loss = np.mean(loss_per_epoch)

    # ====================== Calculate the Validation Accuracy ==========================
    valid_accuracy_per_epoch = []
    for i in range(n_valid//batch_size):
        valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
        valid_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
        valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))

    mean_v_acc = np.mean(valid_accuracy_per_epoch)
    print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))

    # ===================== Calculate the Test Accuracy ===============================
    accuracy_per_epoch = []
    for i in range(n_test//batch_size):
        test_images, test_labels = mnist_data.test.next_batch(batch_size)
        test_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: test_images.reshape(batch_size,image_size*image_size)}
        )
        accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))

    print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
    avg_test_accuracy = np.mean(accuracy_per_epoch)

    # Execute the summaries defined above
    summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})

    # Write the obtained summaries to the file, so it can be displayed in the TensorBoard
    summ_writer.add_summary(summ, epoch)

session.close()
Successfully downloaded train-images-idx3-ubyte.gz 9912422 bytes.
Extracting MNIST_data/train-images-idx3-ubyte.gz
Successfully downloaded train-labels-idx1-ubyte.gz 28881 bytes.
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Successfully downloaded t10k-images-idx3-ubyte.gz 1648877 bytes.
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Successfully downloaded t10k-labels-idx1-ubyte.gz 4542 bytes.
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 2.30252
    Average Valid Accuracy in epoch 0: 10.02000
    Average Test Accuracy in epoch 0: 9.76000

Average loss in epoch 1: 2.30016
    Average Valid Accuracy in epoch 1: 12.56000
    Average Test Accuracy in epoch 1: 12.64000

  ...
  ...
  ...

Average loss in epoch 24: 1.03386
    Average Valid Accuracy in epoch 24: 71.88000
    Average Test Accuracy in epoch 24: 71.23000
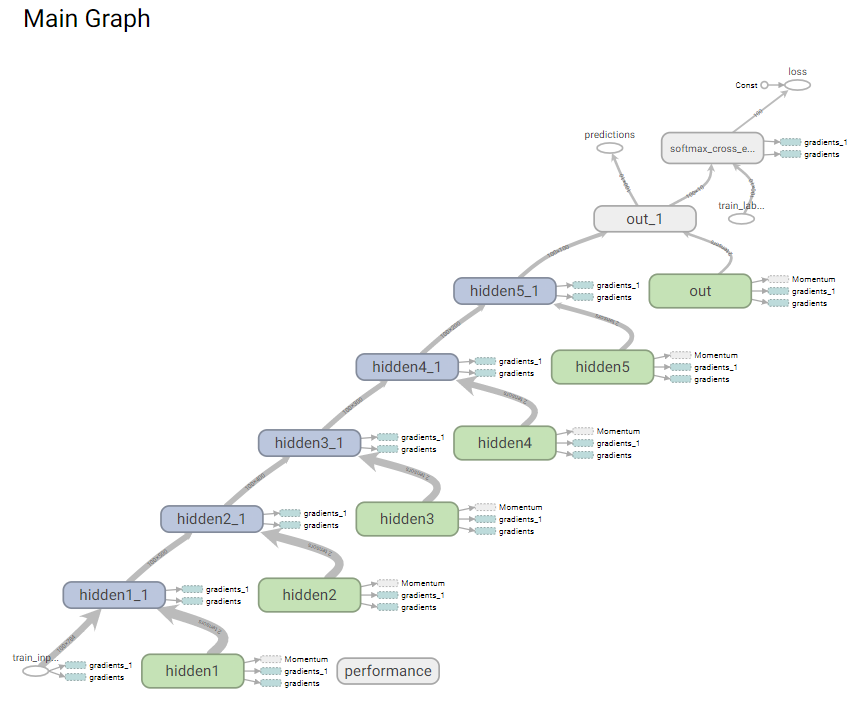
Commencez par regarder à quoi ressemble le graphe computationnel de votre modèle. Accédez à cette vue via Graphs dans TensorBoard. Vous devriez obtenir un résultat similaire à l’image ci-dessous. On y voit un enchaînement net de train_inputs vers loss et predictions via les couches cachées 1 à 5.
La classification MNIST est l’un des exemples les plus simples, et pourtant elle ne se résout pas correctement ici avec un réseau à 5 couches. Sur MNIST, dépasser 90 % de précision en moins de 5 époques n’est généralement pas difficile.
Que se passe-t-il donc ?
Regardons TensorBoard :
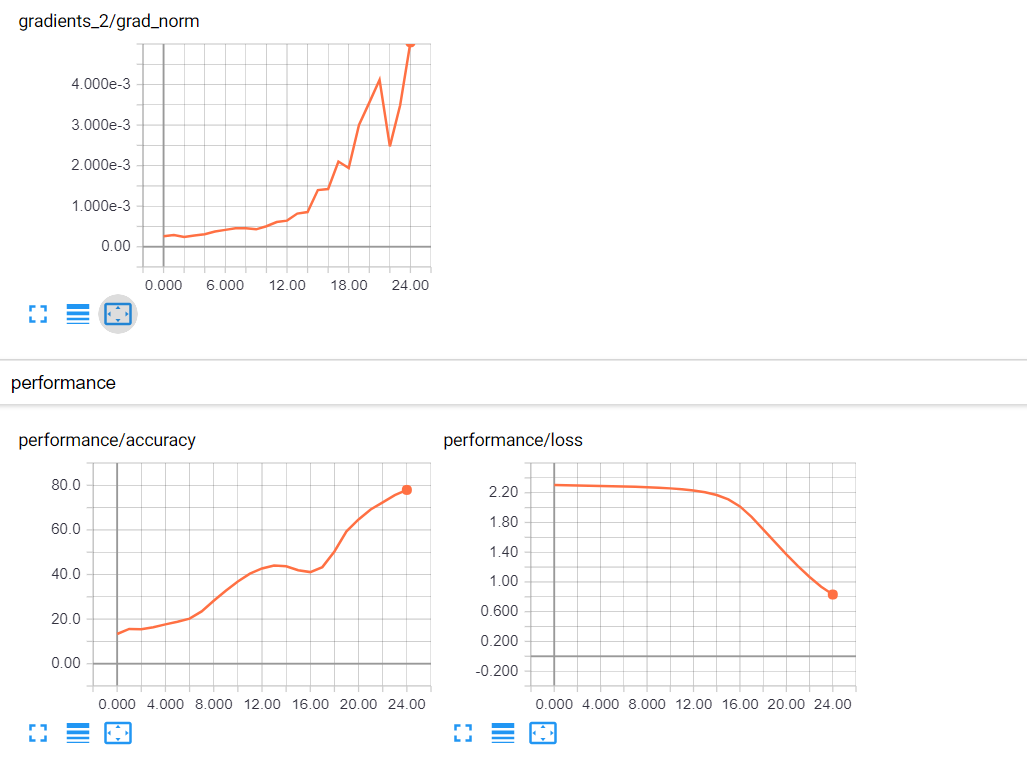
On voit que la précision augmente, mais très lentement, tandis que les mises à jour de gradient croissent dans le temps. C’est étrange : à l’approche de la convergence, les gradients devraient diminuer (tendre vers zéro), pas augmenter. Mais comme la précision progresse, la direction est la bonne. Il vous faut probablement un taux d’apprentissage plus élevé.
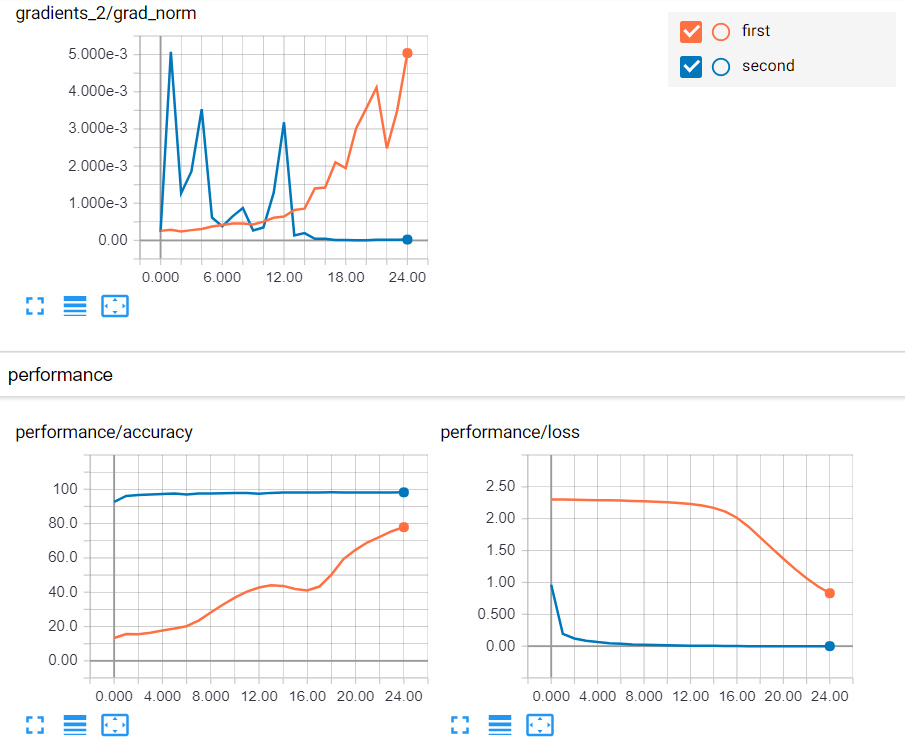
Essayez un taux d’apprentissage de 0.01. C’est quasi identique à l’exécution précédente, sauf que vous utilisez 0.01 au lieu de 0.0001. Remplacez tf_learning_rate: 0.0001 par tf_learning_rate: 0.01. Attention, il y a deux occurrences à modifier.
Vous constatez désormais que la précision démarre près de 100 et continue d’augmenter. Les mises à jour de gradient diminuent avec le temps et tendent vers zéro. Les choses vont nettement mieux avec un taux d’apprentissage de 0.01.
Passons maintenant au-delà des scalaires. Voyons comment analyser des vecteurs et des collections de scalaires.
Vous avez vu l’intérêt de visualiser des scalaires avec TensorBoard pour comprendre le comportement du modèle et corriger d’éventuels problèmes. La visualisation du graphe a aussi permis de vérifier la chaîne ininterrompue des entrées jusqu’aux prédictions, indispensable au calcul des gradients.
Voyons maintenant une autre vue utile de TensorBoard : les histogrammes ou distributions.
Rappel : un histogramme est une collection de valeurs représentées par leur fréquence/densité dans l’ensemble. Vous pouvez l’utiliser pour visualiser l’évolution des poids du réseau dans le temps. C’est important : si les poids « sautent » dans tous les sens pendant l’apprentissage, cela indique un problème d’initialisation des poids ou de taux d’apprentissage.
Vous allez observer l’évolution des poids dans l’exemple. Dans le code, les poids sont initialisés avec truncated_normal_initializer().
Vous définissez à nouveau des objets tf.summary, mais cette fois pour des vecteurs de scalaires : utilisez donc tf.summary.histogram.
Ici, vous déclarez deux objets histogrammes (tf_w_hist et tf_b_hist) qui contiennent les poids et biais d’une couche donnée. Vous les créez pour chaque couche, chacune avec son propre name scope.
Enfin, utilisez tf.summary.merge pour regrouper l’exécution de tous ces summaries en une seule opération.
# Summaries need to be displayed
# Create a summary for each weight bias in each layer
all_summaries = []
for lid in layer_ids:
    with tf.name_scope(lid+'_hist'):
        with tf.variable_scope(lid,reuse=True):
            w,b = tf.get_variable('weights'), tf.get_variable('bias')

            # Create a scalar summary object for the loss so it can be displayed
            tf_w_hist = tf.summary.histogram('weights_hist', tf.reshape(w,[-1]))
            tf_b_hist = tf.summary.histogram('bias_hist', b)
            all_summaries.extend([tf_w_hist, tf_b_hist])

# Merge all parameter histogram summaries together
tf_param_summaries = tf.summary.merge(all_summaries)
Cette étape est presque identique à la précédente, à ceci près que vous ajoutez le calcul des summaries d’histogrammes (tf_param_summaries).
Remarque : les taux d’apprentissage ont également changé.
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25

config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure Tensorflow doesn't overflow the GPU

session = tf.InteractiveSession(config=config)

if not os.path.exists('summaries'):
    os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','third')):
    os.mkdir(os.path.join('summaries','third'))

summ_writer_3 = tf.summary.FileWriter(os.path.join('summaries','third'), session.graph)

tf.global_variables_initializer().run()

accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)


for epoch in range(n_epochs):
    loss_per_epoch = []
    for i in range(n_train//batch_size):

        # =================================== Training for one step ========================================
        batch = mnist_data.train.next_batch(batch_size)    # Get one batch of training data
        if i == 0:
            # Only for the first epoch, get the summary data
            # Otherwise, it can clutter the visualization
            l,_,gn_summ, wb_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary, tf_param_summaries],
                                      feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                                 train_labels: batch[1],
                                                tf_learning_rate: 0.00001})
            summ_writer_3.add_summary(gn_summ, epoch)
            summ_writer_3.add_summary(wb_summ, epoch)
        else:
            # Optimize with training data
            l,_ = session.run([tf_loss,tf_loss_minimize],
                              feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                         train_labels: batch[1],
                                         tf_learning_rate: 0.01})
        loss_per_epoch.append(l)

    print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
    avg_loss = np.mean(loss_per_epoch)

    # ====================== Calculate the Validation Accuracy ==========================
    valid_accuracy_per_epoch = []
    for i in range(n_valid//batch_size):
        valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
        valid_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
        valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))

    mean_v_acc = np.mean(valid_accuracy_per_epoch)
    print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))

    # ===================== Calculate the Test Accuracy ===============================
    accuracy_per_epoch = []
    for i in range(n_test//batch_size):
        test_images, test_labels = mnist_data.test.next_batch(batch_size)
        test_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: test_images.reshape(batch_size,image_size*image_size)
        )
        accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))

    print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
    avg_test_accuracy = np.mean(accuracy_per_epoch)

    # Execute the summaries defined above
    summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})

    # Write the obtained summaries to the file, so they can be displayed
    summ_writer_3.add_summary(summ, epoch)

session.close()
Extracting MNIST_data/train-images-idx3-ubyte.gz
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 1.02625
    Average Valid Accuracy in epoch 0: 92.76000
    Average Test Accuracy in epoch 0: 92.65000

Average loss in epoch 1: 0.19110
    Average Valid Accuracy in epoch 1: 95.80000
    Average Test Accuracy in epoch 1: 95.48000

  ...
  ...
  ...

Average loss in epoch 24: 0.00009
    Average Valid Accuracy in epoch 24: 98.28000
    Average Test Accuracy in epoch 24: 98.09000
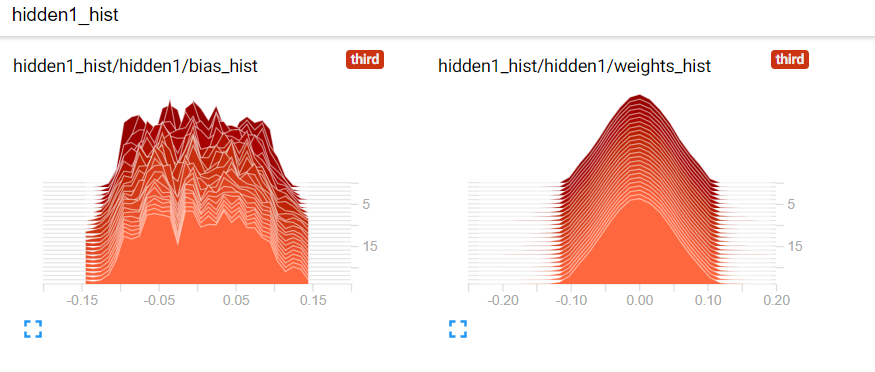
Voici à quoi ressemblent vos poids et biais. On dispose de 3 axes : le temps (axe x), la valeur (axe y) et la fréquence/densité des valeurs (axe z). Les histogrammes foncés représentent des données anciennes, les plus clairs des données récentes. Une valeur plus élevée sur l’axe z signifie que le vecteur contient davantage de valeurs proches de cette valeur spécifique.
Remarque : il existe aussi une vue « overlay » des histogrammes au fil du temps. Vous pouvez changer le type d’affichage dans le panneau latéral gauche.
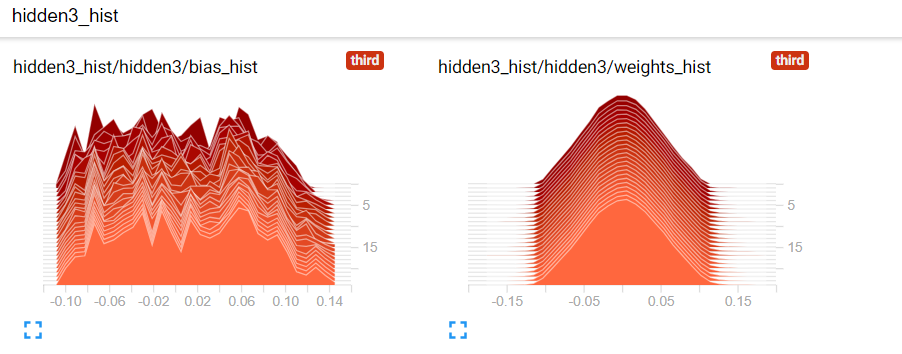
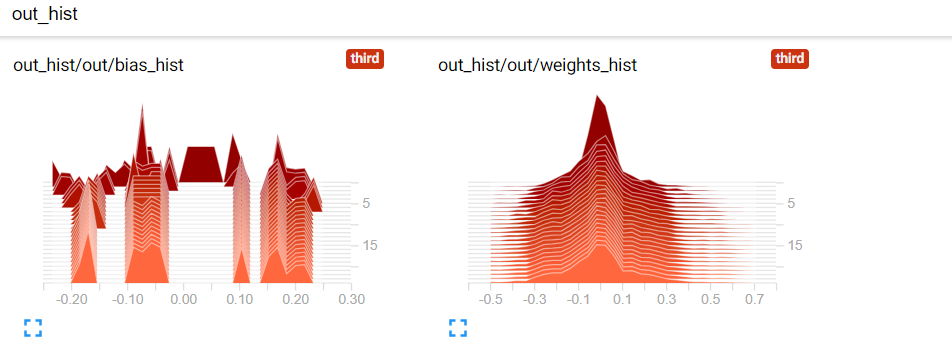
Maintenant, au lieu d’utiliser truncated_normal_initializer(), utilisez xavier_initializer() pour initialiser les poids. L’initialisation Xavier est souvent plus adaptée, notamment pour les réseaux profonds.
Plutôt que d’utiliser un écart type défini par l’utilisateur (comme avec truncated_normal_initializer()), Xavier décide automatiquement de l’écart type selon le nombre de connexions en entrée et en sortie d’une couche. Cela aide les gradients à se propager sans problèmes du haut vers le bas, évitant les vanishing gradients. Vous redéfinissez ensuite le modèle.
Définissez d’abord batch_size (taille de lot par étape d’optimisation/validation/test), puis layer_ids, identifiants des couches du réseau.
Définissez ensuite layer_sizes. Notez que len(layer_sizes) doit être égal à len(layer_ids)+1, car layer_sizes inclut la taille d’entrée. MNIST propose des images 28x28, soit 784 en 1D.
Vous pouvez alors définir les placeholders d’entrées et d’étiquettes, puis deux variables TensorFlow par couche (weights et bias).
Remarque : c’est identique au premier code, à l’exception de la technique d’initialisation des poids.
batch_size = 100
layer_ids = ['hidden1','hidden2','hidden3','hidden4','hidden5','out']
layer_sizes = [784, 500, 400, 300, 200, 100, 10]

tf.reset_default_graph()

# Inputs and Labels
train_inputs = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[0]], name='train_inputs')
train_labels = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[-1]], name='train_labels')

# Weight and Bias definitions
for idx, lid in enumerate(layer_ids):

    with tf.variable_scope(lid):
        w = tf.get_variable('weights',shape=[layer_sizes[idx], layer_sizes[idx+1]],
                            initializer=tf.contrib.layers.xavier_initializer())
        b = tf.get_variable('bias',shape= [layer_sizes[idx+1]],
                            initializer=tf.random_uniform_initializer(-0.1,0.1))
Avec les placeholders, poids et biais redéfinis, vous pouvez à nouveau décrire le calcul des logits du réseau de neurones.
Remarque : cette partie est identique à la première version des opérations et tenseurs.
Vous redéfinissez ici les objets tf.summary. C’est également identique à la première version.
Vous redéfinissez encore des objets tf.summary, mais pour des vecteurs de scalaires : utilisez tf.summary.histogram.
Remarque : c’est identique à la première définition.
Remarque : même procédure que dans la section précédente !
Il n’y a que quelques lignes à modifier : remplacez les trois occurrences de os.path.join('summaries','third') par os.path.join('summaries','fourth'), summ_writer_3 par summ_writer_4 (4 occurrences) et fixez tf_learning_rate à 0.01 au lieu de 0.00001.
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25

config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure TensorFlow doesn't overflow the GPU

session = tf.InteractiveSession(config=config)

if not os.path.exists('summaries'):
    os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','fourth')):
    os.mkdir(os.path.join('summaries','fourth'))

summ_writer_4 = tf.summary.FileWriter(os.path.join('summaries','fourth'), session.graph)

tf.global_variables_initializer().run()

accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)


for epoch in range(n_epochs):
    loss_per_epoch = []
    for i in range(n_train//batch_size):

        # =================================== Training for one step ========================================
        batch = mnist_data.train.next_batch(batch_size)    # Get one batch of training data
        if i == 0:
            # Only for the first epoch, get the summary data
            # Otherwise, it can clutter the visualization
            l,_,gn_summ, wb_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary, tf_param_summaries],
                                      feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                                 train_labels: batch[1],
                                                tf_learning_rate: 0.01})
            summ_writer_4.add_summary(gn_summ, epoch)
            summ_writer_4.add_summary(wb_summ, epoch)
        else:
            # Optimize with training data
            l,_ = session.run([tf_loss,tf_loss_minimize],
                              feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                         train_labels: batch[1],
                                         tf_learning_rate: 0.01})
        loss_per_epoch.append(l)

    print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
    avg_loss = np.mean(loss_per_epoch)

    # ====================== Calculate the Validation Accuracy ==========================
    valid_accuracy_per_epoch = []
    for i in range(n_valid//batch_size):
        valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
        valid_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
        valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))

    mean_v_acc = np.mean(valid_accuracy_per_epoch)
    print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))

    # ===================== Calculate the Test Accuracy ===============================
    accuracy_per_epoch = []
    for i in range(n_test//batch_size):
        test_images, test_labels = mnist_data.test.next_batch(batch_size)
        test_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: test_images.reshape(batch_size,image_size*image_size)
        )
        accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))

    print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
    avg_test_accuracy = np.mean(accuracy_per_epoch)

    # Execute the summaries defined above
    summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})

    # Write the obtained summaries to the file, so they can be displayed
    summ_writer_4.add_summary(summ, epoch)

session.close()
Extracting MNIST_data/train-images-idx3-ubyte.gz
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 0.43618
    Average Valid Accuracy in epoch 0: 95.70000
    Average Test Accuracy in epoch 0: 95.22000

Average loss in epoch 1: 0.12872
    Average Valid Accuracy in epoch 1: 96.86000
    Average Test Accuracy in epoch 1: 96.71000

  ...
  ...
  ...

Average loss in epoch 24: 0.00009
    Average Valid Accuracy in epoch 24: 98.42000
    Average Test Accuracy in epoch 24: 98.21000
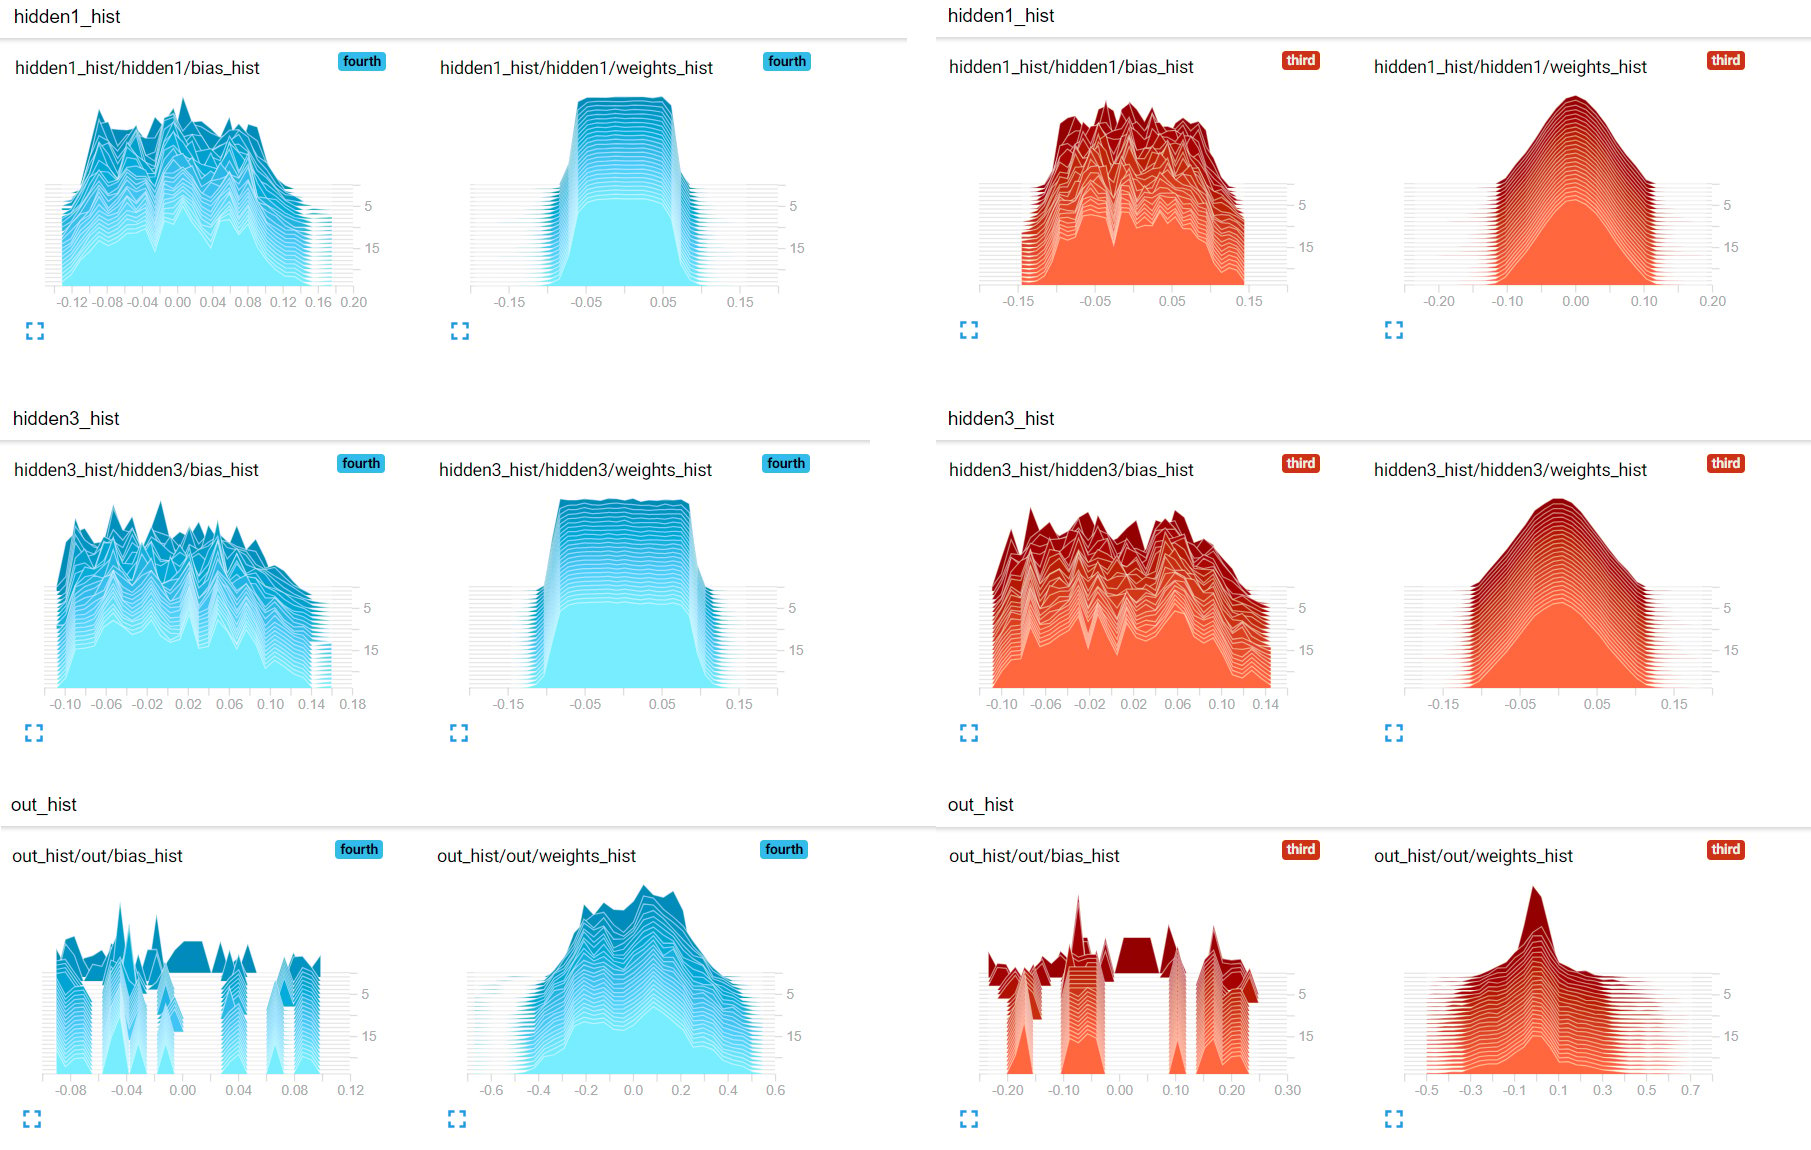
Vous pouvez maintenant comparer l’évolution des poids dans le temps pour deux initialisations : truncated_normal_initializer (rouge) et xavier_initializer (bleu). On voit que xavier_initializer maintient davantage de poids éloignés de zéro que l’initialiseur normal, ce qui est préférable. Cela permet potentiellement aux réseaux initialisés avec Xavier de converger plus vite, comme le suggèrent les courbes perte/précision.
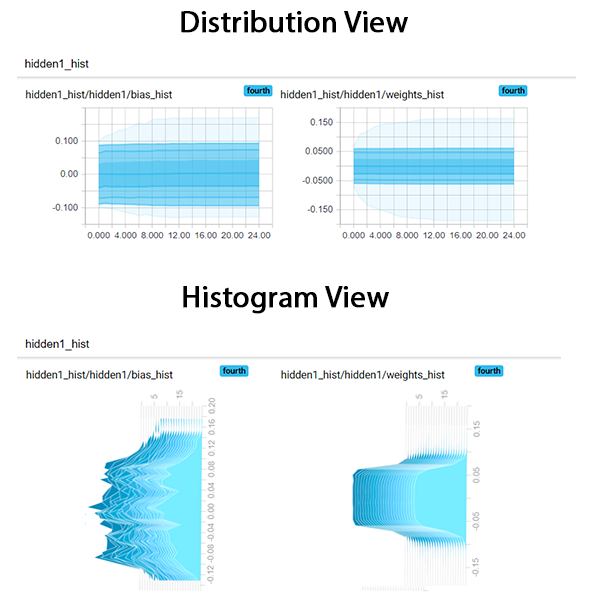
Vous pouvez comparer les deux vues : histogramme et distribution. La vue distribution est une autre façon de regarder les histogrammes. Sur l’image ci-dessous, on distingue bien que la vue distribution correspond à une vue de dessus de l’histogramme. Notez que, pour faciliter la comparaison, les histogrammes sont ici pivotés.
Dans ce tutoriel, vous avez appris à utiliser TensorBoard. D’abord, à lancer le service via l’invite de commandes (Windows) ou le terminal (Ubuntu/Mac). Puis vous avez exploré les différentes vues de données offertes par TensorBoard. Vous avez ensuite vu du code pour visualiser des scalaires (par exemple perte/précision) avec un réseau de neurones à propagation avant afin d’illustrer concrètement l’intérêt de ces visualisations.
Vous avez poursuivi avec la visualisation de collections/vecteurs de scalaires via la vue histogramme, puis comparé des techniques d’initialisation des poids grâce à cette même vue.
Enfin, vous avez évoqué les similitudes entre la vue distribution et la vue histogramme.
Pour aller plus loin en deep learning, consultez notre cours Deep Learning in Keras.
Découvrez aussi notre tutoriel Hyperparameter Optimization in Machine Learning Models pour en savoir plus sur les paramètres et hyperparamètres.
Pour me contacter, écrivez-moi à thushv@gmail.com ou retrouvez-moi sur LinkedIn.
Approfondir le machine learning et le deep learning
Cours
Cours
Cours