Corso
Capire il Machine Learning
2 ore
311.6K

Questo tutorial ti guiderà nell’uso di TensorBoard, un’utilissima utility che ti permette di visualizzare i dati e il loro comportamento. Vedrai per quali scopi puoi usarla durante l’addestramento di una rete neurale.
Consiglio: dai un’occhiata al corso di Deep Learning con Keras di DataCamp qui.
Prima di iniziare, assicurati di importare le seguenti librerie per eseguire correttamente il codice:
from pandas_datareader import data
import matplotlib.pyplot as plt
import pandas as pd
import datetime as dt
import urllib.request, json
import os
import numpy as np

# Questo codice è stato testato con TensorFlow 1.6
import tensorflow as tf
from tensorflow.examples.tutorials.mnist import input_data
Per visualizzare le cose con TensorBoard, prima devi avviare il suo servizio. Per farlo,
python3, otterrai un prompt simile a >>>import tensorflow as tf>>>) digitando exit() e inserisci il seguente comando
tensorboard --logdir=summaries--logdir è la directory in cui creerai i dati da visualizzare--port=<port_you_like> per cambiare la porta su cui gira TensorBoardTensorBoard 1.6.0 at <url>:6006 (Press CTRL+C to quit)Nota: a TensorBoard non piace trovare più event file nella stessa directory. Questo può portare a curve molto brutte a schermo. Quindi dovresti creare una cartella separata per ogni esempio diverso (per esempio, summaries/first, summaries/second, ...) per salvare i dati. Un’altra cosa da tenere a mente è che, se vuoi rieseguire un esperimento (cioè salvare un event file in una cartella già popolata), devi prima assicurarti di eliminare gli event file esistenti.
Viste diverse accettano input in formati differenti e li mostrano in modo diverso. Puoi cambiarle nella barra arancione in alto.
In questo tutorial, tratterai le viste in grassetto.
In questa sezione capirai innanzitutto perché visualizzare certe metriche (per esempio loss o accuracy) è utile. Quando si addestrano reti neurali profonde, uno dei problemi cruciali per i principianti è la scarsa comprensione degli effetti delle varie scelte di design e degli iperparametri.
Per esempio, se inizializzi con superficialità i pesi di una rete neurale profonda in modo che abbiano una varianza molto grande tra loro, il modello divergerà rapidamente e collasserà. D’altra parte, le cose possono andare storte anche quando sei piuttosto capace nel gestire le reti neurali. Per esempio, non prestare attenzione al learning rate può portare o alla divergenza del modello o a una saturazione prematura su prestazioni sub-ottimali.
Un modo per rilevare rapidamente i problemi del modello è avere una visualizzazione grafica in tempo reale di ciò che sta accadendo (per esempio, ogni 100 iterazioni). Se il modello si comporta in modo strano, sarà chiaramente visibile. Ed è esattamente ciò che ti offre TensorBoard. Puoi decidere quali valori visualizzare e lui manterrà una visualizzazione in tempo reale di quei valori durante l’apprendimento.
Inizi creando una rete neurale a cinque strati che userai per classificare immagini di cifre scritte a mano. Per questo userai il famoso dataset MNIST. TensorFlow fornisce una semplice API per caricare i dati di MNIST, quindi non devi scaricarli manualmente. Prima definisci un metodo semplice (cioè accuracy()), che calcola l’accuratezza di alcune predizioni rispetto alle etichette vere.
def accuracy(predictions,labels):
    '''
    Accuracy of a given set of predictions of size (N x n_classes) and
    labels of size (N x n_classes)
    '''
    return np.sum(np.argmax(predictions,axis=1)==np.argmax(labels,axis=1))*100.0/labels.shape[0]
Per prima cosa, definisci un batch_size che indica la quantità di dati che campioni in un singolo passo di ottimizzazione/validazione o test. Poi definisci i layer_ids, che forniscono un identificatore per ciascuno degli strati della rete neurale che stai definendo. Quindi puoi definire i layer_sizes.
Nota che len(layer_sizes) dovrebbe essere len(layer_ids)+1, perché layer_sizes include la dimensione dell’input all’inizio.
MNIST ha immagini di dimensione 28x28, che diventano 784 se “srotolate” in una singola dimensione. Poi puoi definire i placeholder di input e label, che userai in seguito per addestrare il modello. Infine, definisci due variabili TensorFlow per ogni strato (cioè weights e bias).
Puoi usare il variable scoping (maggiori informazioni qui) così che le variabili siano ben nominate e molto più facili da accedere in seguito.
batch_size = 100
layer_ids = ['hidden1','hidden2','hidden3','hidden4','hidden5','out']
layer_sizes = [784, 500, 400, 300, 200, 100, 10]

tf.reset_default_graph()

# Inputs and Labels
train_inputs = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[0]], name='train_inputs')
train_labels = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[-1]], name='train_labels')

# Weight and Bias definitions
for idx, lid in enumerate(layer_ids):

    with tf.variable_scope(lid):
        w = tf.get_variable('weights',shape=[layer_sizes[idx], layer_sizes[idx+1]],
                            initializer=tf.truncated_normal_initializer(stddev=0.05))
        b = tf.get_variable('bias',shape= [layer_sizes[idx+1]],
                            initializer=tf.random_uniform_initializer(-0.1,0.1))
Con i placeholder di input/output, i pesi e i bias di ogni strato definiti, ora puoi definire i calcoli per ottenere i logits della rete neurale. I logits sono i valori non normalizzati prodotti nell’ultimo strato della rete neurale. Una volta normalizzati, li chiami predizioni. Questo comporta iterare attraverso ogni strato della rete neurale e calcolare tf.matmul(h,w) +b. Devi anche applicare una funzione di attivazione come tf.nn.relu(tf.matmul(h,w) +b) per tutti gli strati tranne l’ultimo.
Poi definisci la funzione di loss usata per ottimizzare la rete neurale. In questo esempio, puoi usare la cross entropy, che spesso dà risultati migliori nei problemi di classificazione rispetto al mean squared error.
Infine, devi definire un ottimizzatore che prenda in ingresso la loss e aggiorni i pesi della rete neurale nella direzione che minimizza la loss.
# Calculating Logits
h = train_inputs
for lid in layer_ids:
    with tf.variable_scope(lid,reuse=True):
        w, b = tf.get_variable('weights'), tf.get_variable('bias')
        if lid != 'out':
          h = tf.nn.relu(tf.matmul(h,w)+b,name=lid+'_output')
        else:
          h = tf.nn.xw_plus_b(h,w,b,name=lid+'_output')

tf_predictions = tf.nn.softmax(h, name='predictions')
# Calculating Loss
tf_loss = tf.reduce_mean(tf.nn.softmax_cross_entropy_with_logits_v2(labels=train_labels, logits=h),name='loss')

# Optimizer
tf_learning_rate = tf.placeholder(tf.float32, shape=None, name='learning_rate')
optimizer = tf.train.MomentumOptimizer(tf_learning_rate,momentum=0.9)
grads_and_vars = optimizer.compute_gradients(tf_loss)
tf_loss_minimize = optimizer.minimize(tf_loss)
Qui puoi definire gli oggetti tf.summary. Questi oggetti sono le entità comprese da TensorBoard. Significa che qualunque valore tu voglia visualizzare, dovresti incapsularlo come oggetto tf.summary.
Esistono diversi tipi di summary. Qui, dato che stai visualizzando solo scalari, puoi definire oggetti tf.summary.scalar. Inoltre, puoi usare tf.name_scope per raggruppare gli scalari nella board. Cioè, gli scalari con lo stesso name scope verranno mostrati sulla stessa riga. Qui definisci tre summary diversi.
tf_loss_summary : passi un valore tramite un placeholder ogni volta che vuoi pubblicarlo sulla boardtf_accuracy_summary : passi un valore tramite un placeholder ogni volta che vuoi pubblicarlo sulla boardtf_gradnorm_summary : calcola la norma l2 dei gradienti dell’ultimo strato della tua rete neurale. La norma del gradiente è un buon indicatore del fatto che i pesi della rete neurale vengano aggiornati correttamente. Una norma del gradiente troppo piccola può indicare il fenomeno del vanishing gradient o, se troppo grande, dell’exploding gradient.# Name scope allows you to group various summaries together
# Summaries having the same name_scope will be displayed on the same row
with tf.name_scope('performance'):
# Summaries need to be displayed
# Whenever you need to record the loss, feed the mean loss to this placeholder
tf_loss_ph = tf.placeholder(tf.float32,shape=None,name='loss_summary')
# Create a scalar summary object for the loss so it can be displayed
tf_loss_summary = tf.summary.scalar('loss', tf_loss_ph)
# Whenever you need to record the loss, feed the mean test accuracy to this placeholder
tf_accuracy_ph = tf.placeholder(tf.float32,shape=None, name='accuracy_summary')
# Create a scalar summary object for the accuracy so it can be displayed
tf_accuracy_summary = tf.summary.scalar('accuracy', tf_accuracy_ph)
# Gradient norm summary
for g,v in grads_and_vars:
if 'hidden5' in v.name and 'weights' in v.name:
with tf.name_scope('gradients'):
tf_last_grad_norm = tf.sqrt(tf.reduce_mean(g**2))
tf_gradnorm_summary = tf.summary.scalar('grad_norm', tf_last_grad_norm)
break
# Merge all summaries together
performance_summaries = tf.summary.merge([tf_loss_summary,tf_accuracy_summary])
Nel codice seguente fai quanto segue. Per prima cosa, crei una sessione in cui esegui le operazioni definite sopra. Poi, crei una cartella per salvare i dati di summary. Quindi crei uno writer di summary, summ_writer. Ora puoi inizializzare tutte le variabili. A questo segue il caricamento del dataset MNIST.
Poi, per ogni epoca, e per ogni batch nei dati di training (cioè ogni iterazione), esegui gradnorm_summary se è la prima iterazione e scrivi gradnorm_summary nell’event file con il writer dei summary. Ora esegui l’ottimizzazione del modello e il calcolo della loss. Dopo aver attraversato l’intero dataset di training per una singola epoca, calcola la loss media di training.
Applichi un trattamento simile anche al dataset di validazione. Nello specifico, per ogni batch nei dati di validazione, calcoli l’accuratezza di validazione. Successivamente, calcoli l’accuratezza media di validazione per l’intero set di validazione.
Infine, esegui la fase di test. In questa, per ogni batch nei dati di test, calcoli l’accuratezza di test per ogni batch. Con questo, calcoli l’accuratezza media di test per l’intero set di test. Alla fine esegui performance_summaries e li scrivi nell’event file con il writer dei summary.
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25

config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure Tensorflow doesn't overflow the GPU

session = tf.InteractiveSession(config=config)

if not os.path.exists('summaries'):
    os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','first')):
    os.mkdir(os.path.join('summaries','first'))

summ_writer = tf.summary.FileWriter(os.path.join('summaries','first'), session.graph)

tf.global_variables_initializer().run()

accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)


for epoch in range(n_epochs):
    loss_per_epoch = []
    for i in range(n_train//batch_size):

        # =================================== Training for one step ========================================
        batch = mnist_data.train.next_batch(batch_size)    # Get one batch of training data
        if i == 0:
            # Only for the first epoch, get the summary data
            # Otherwise, it can clutter the visualization
            l,_,gn_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary],
                                      feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                                 train_labels: batch[1],
                                                tf_learning_rate: 0.0001})
            summ_writer.add_summary(gn_summ, epoch)
        else:
            # Optimize with training data
            l,_ = session.run([tf_loss,tf_loss_minimize],
                              feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                         train_labels: batch[1],
                                         tf_learning_rate: 0.0001})
        loss_per_epoch.append(l)

    print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
    avg_loss = np.mean(loss_per_epoch)

    # ====================== Calculate the Validation Accuracy ==========================
    valid_accuracy_per_epoch = []
    for i in range(n_valid//batch_size):
        valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
        valid_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
        valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))

    mean_v_acc = np.mean(valid_accuracy_per_epoch)
    print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))

    # ===================== Calculate the Test Accuracy ===============================
    accuracy_per_epoch = []
    for i in range(n_test//batch_size):
        test_images, test_labels = mnist_data.test.next_batch(batch_size)
        test_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: test_images.reshape(batch_size,image_size*image_size)}
        )
        accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))

    print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
    avg_test_accuracy = np.mean(accuracy_per_epoch)

    # Execute the summaries defined above
    summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})

    # Write the obtained summaries to the file, so it can be displayed in the TensorBoard
    summ_writer.add_summary(summ, epoch)

session.close()
Successfully downloaded train-images-idx3-ubyte.gz 9912422 bytes.
Extracting MNIST_data/train-images-idx3-ubyte.gz
Successfully downloaded train-labels-idx1-ubyte.gz 28881 bytes.
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Successfully downloaded t10k-images-idx3-ubyte.gz 1648877 bytes.
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Successfully downloaded t10k-labels-idx1-ubyte.gz 4542 bytes.
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 2.30252
    Average Valid Accuracy in epoch 0: 10.02000
    Average Test Accuracy in epoch 0: 9.76000

Average loss in epoch 1: 2.30016
    Average Valid Accuracy in epoch 1: 12.56000
    Average Test Accuracy in epoch 1: 12.64000

  ...
  ...
  ...

Average loss in epoch 24: 1.03386
    Average Valid Accuracy in epoch 24: 71.88000
    Average Test Accuracy in epoch 24: 71.23000
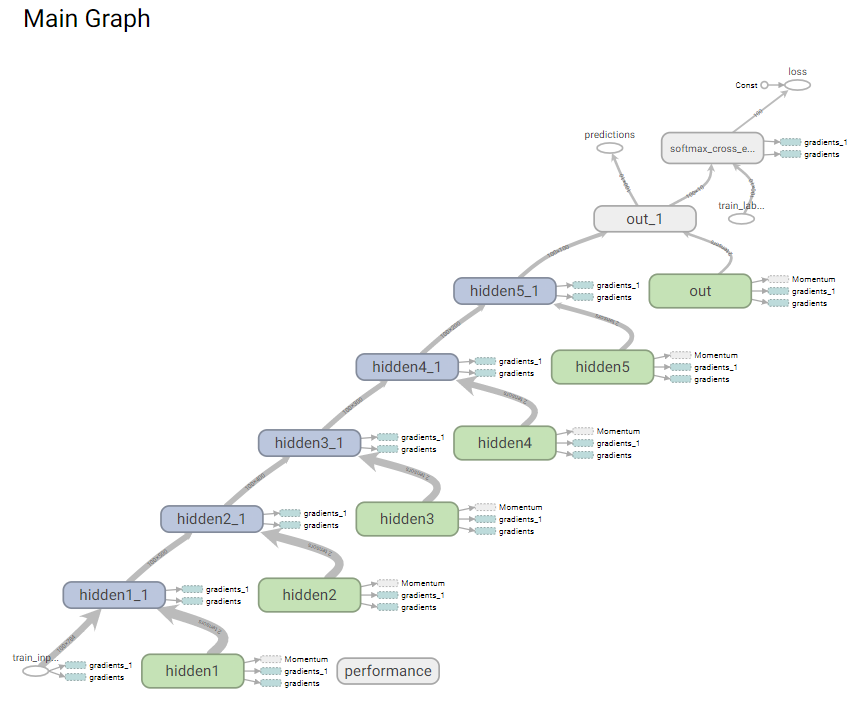
Per prima cosa vedrai com’è il grafo computazionale del tuo modello. Puoi accedere a questa vista cliccando sulla vista Graphs in TensorBoard. Dovrebbe apparire come nell’immagine qui sotto. Puoi vedere un bel flusso da train_inputs a loss e predictions che attraversa gli strati nascosti da 1 a 5.
La classificazione MNIST è uno degli esempi più semplici, e nonostante ciò non si riesce a risolverla con una rete a 5 strati. Per MNIST, non è difficile superare il 90% di accuratezza in meno di 5 epoche.
Quindi cosa sta succedendo qui?
Diamo un’occhiata a TensorBoard:
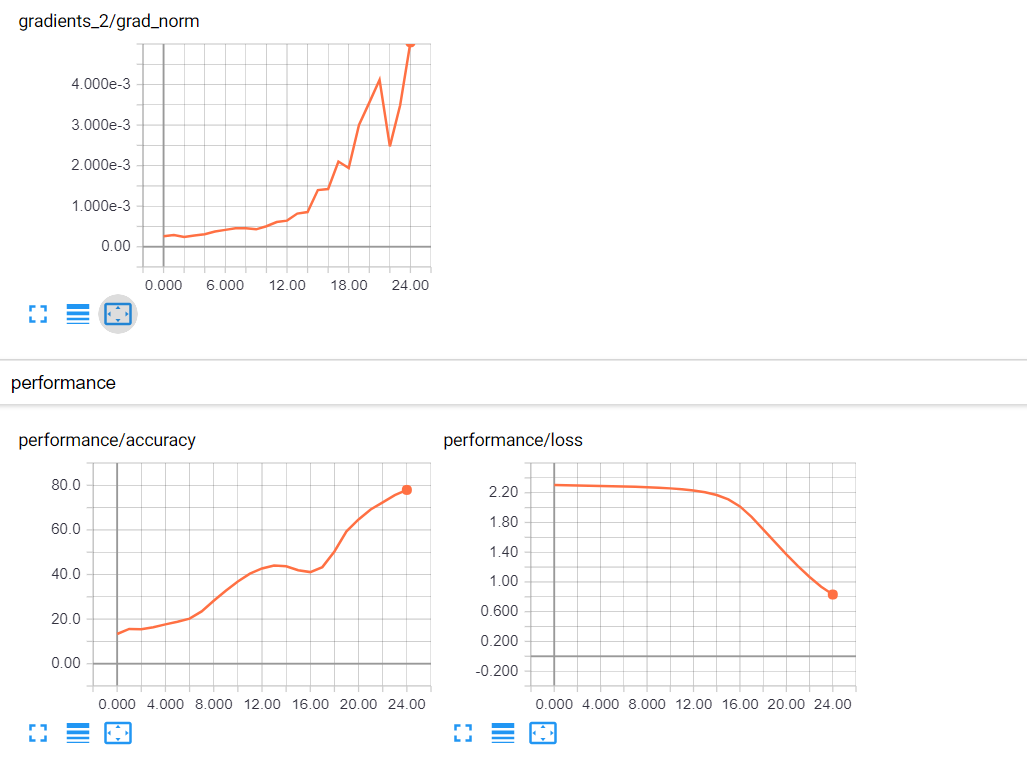
Puoi vedere che l’accuratezza sta salendo, ma molto lentamente, e che gli aggiornamenti del gradiente aumentano nel tempo. Questo è un comportamento strano. Se stai andando verso la convergenza, dovresti vedere i gradienti diminuire (avvicinandosi a zero), non aumentare. Ma poiché l’accuratezza sta salendo, sei sulla strada giusta. Probabilmente ti serve un learning rate più alto.
Ora puoi provare un learning rate di 0.01. Questo è quasi identico alla precedente esecuzione della rete neurale, tranne che userai 0.01 invece di 0.0001. Invece di tf_learning_rate: 0.0001, usa tf_learning_rate: 0.01. Attenzione: ci sono due punti in cui dovrai sostituire l’argomento.
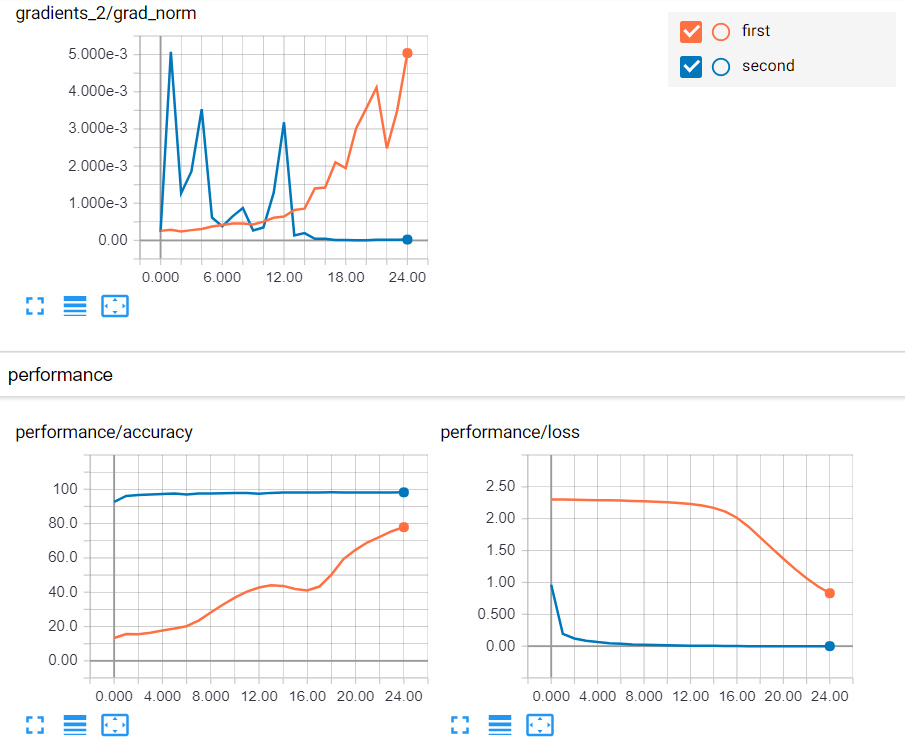
Ora puoi vedere che l’accuratezza parte vicino a 100 e continua a salire. E puoi vedere che anche gli aggiornamenti del gradiente diminuiscono nel tempo e si avvicinano a zero. Le cose sembrano molto meglio con un learning rate di 0.01.
Ora andiamo oltre gli scalari. Vedrai come analizzare vettori di scalari e collezioni di scalari.
Hai visto il vantaggio di visualizzare scalari con TensorBoard, che ti ha permesso di vedere come si comporta il modello e di correggere eventuali problemi. Inoltre, la visualizzazione del grafo ti ha permesso di verificare che esista un collegamento ininterrotto dagli input alle predizioni, necessario per il calcolo dei gradienti.
Ora vedrai un’altra vista utile in TensorBoard: istogrammi o distribuzioni.
Ricorda che un istogramma è una collezione di valori rappresentata dalla frequenza/densità che quel valore ha nella collezione. Puoi usare gli istogrammi per visualizzare i valori dei pesi della rete nel tempo. Visualizzare i pesi è importante, perché se i pesi saltano selvaggiamente qua e là durante l’apprendimento, indica che c’è qualcosa che non va con l’inizializzazione dei pesi o con il learning rate.
Vedrai come cambiano i pesi nell’esempio. Se guardi il codice, usa un truncated_normal_initializer() per inizializzare i pesi.
Qui definisci di nuovo gli oggetti tf.summary. Tuttavia, ora stai visualizzando vettori di scalari, quindi devi definire oggetti tf.summary.histogram.
In questo caso, definisci due oggetti istogramma (cioè tf_w_hist e tf_b_hist) che contengono pesi e bias di un dato strato. Definirai tali oggetti istogramma per tutti gli strati e ogni strato avrà il proprio name scope.
Infine, puoi usare l’operazione tf.summary.merge per creare un’operazione raggruppata che esegue tutti questi summary in una volta sola.
# Summaries need to be displayed
# Create a summary for each weight bias in each layer
all_summaries = []
for lid in layer_ids:
    with tf.name_scope(lid+'_hist'):
        with tf.variable_scope(lid,reuse=True):
            w,b = tf.get_variable('weights'), tf.get_variable('bias')

            # Create a scalar summary object for the loss so it can be displayed
            tf_w_hist = tf.summary.histogram('weights_hist', tf.reshape(w,[-1]))
            tf_b_hist = tf.summary.histogram('bias_hist', b)
            all_summaries.extend([tf_w_hist, tf_b_hist])

# Merge all parameter histogram summaries together
tf_param_summaries = tf.summary.merge(all_summaries)
Questo passaggio è quasi lo stesso di quanto fatto prima, ma qui hai alcune righe aggiuntive per calcolare i summary degli istogrammi (cioè tf_param_summaries).
Nota che anche i learning rate sono cambiati di nuovo.
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25

config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure Tensorflow doesn't overflow the GPU

session = tf.InteractiveSession(config=config)

if not os.path.exists('summaries'):
    os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','third')):
    os.mkdir(os.path.join('summaries','third'))

summ_writer_3 = tf.summary.FileWriter(os.path.join('summaries','third'), session.graph)

tf.global_variables_initializer().run()

accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)


for epoch in range(n_epochs):
    loss_per_epoch = []
    for i in range(n_train//batch_size):

        # =================================== Training for one step ========================================
        batch = mnist_data.train.next_batch(batch_size)    # Get one batch of training data
        if i == 0:
            # Only for the first epoch, get the summary data
            # Otherwise, it can clutter the visualization
            l,_,gn_summ, wb_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary, tf_param_summaries],
                                      feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                                 train_labels: batch[1],
                                                tf_learning_rate: 0.00001})
            summ_writer_3.add_summary(gn_summ, epoch)
            summ_writer_3.add_summary(wb_summ, epoch)
        else:
            # Optimize with training data
            l,_ = session.run([tf_loss,tf_loss_minimize],
                              feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                         train_labels: batch[1],
                                         tf_learning_rate: 0.01})
        loss_per_epoch.append(l)

    print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
    avg_loss = np.mean(loss_per_epoch)

    # ====================== Calculate the Validation Accuracy ==========================
    valid_accuracy_per_epoch = []
    for i in range(n_valid//batch_size):
        valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
        valid_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
        valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))

    mean_v_acc = np.mean(valid_accuracy_per_epoch)
    print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))

    # ===================== Calculate the Test Accuracy ===============================
    accuracy_per_epoch = []
    for i in range(n_test//batch_size):
        test_images, test_labels = mnist_data.test.next_batch(batch_size)
        test_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: test_images.reshape(batch_size,image_size*image_size)}
        )
        accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))

    print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
    avg_test_accuracy = np.mean(accuracy_per_epoch)

    # Execute the summaries defined above
    summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})

    # Write the obtained summaries to the file, so they can be displayed
    summ_writer_3.add_summary(summ, epoch)

session.close()
Extracting MNIST_data/train-images-idx3-ubyte.gz
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 1.02625
    Average Valid Accuracy in epoch 0: 92.76000
    Average Test Accuracy in epoch 0: 92.65000

Average loss in epoch 1: 0.19110
    Average Valid Accuracy in epoch 1: 95.80000
    Average Test Accuracy in epoch 1: 95.48000

  ...
  ...
  ...

Average loss in epoch 24: 0.00009
    Average Valid Accuracy in epoch 24: 98.28000
    Average Test Accuracy in epoch 24: 98.09000
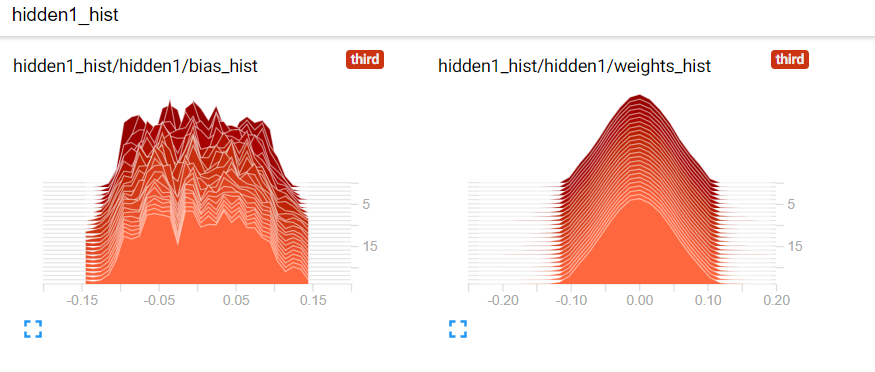
Ecco come appaiono i tuoi pesi e bias. Per prima cosa, hai 3 assi: tempo (asse x), valore (asse y) e frequenza/densità dei valori (asse z). Gli istogrammi più scuri rappresentano dati più vecchi e quelli più chiari dati più recenti. Un valore più alto sull’asse z significa che il vettore contiene più valori intorno a quel valore specifico.
Nota: hai anche una vista "overlay" degli istogrammi nel tempo. Puoi cambiare il tipo di visualizzazione nel pannello delle opzioni a sinistra.
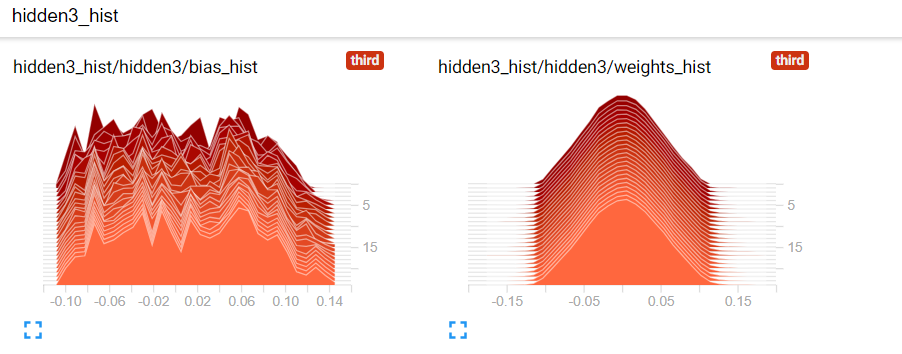
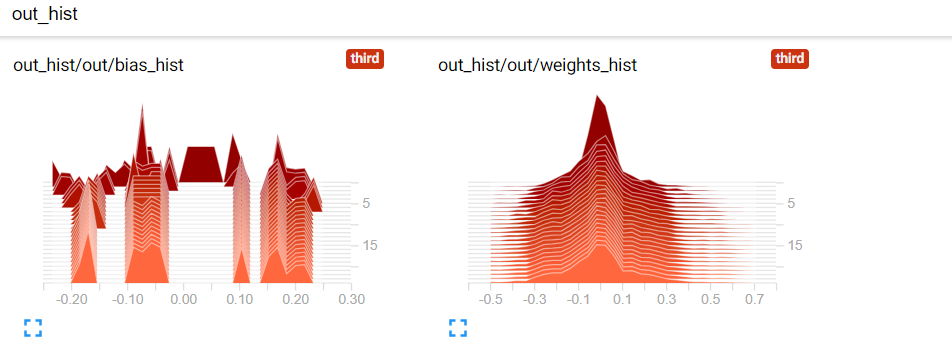
Ora, invece di usare truncated_normal_initializer(), userai xavier_initializer() per inizializzare i pesi. L’inizializzazione Xavier è una tecnica molto migliore, soprattutto per reti neurali profonde.
Questo perché, invece di usare una deviazione standard definita dall’utente (come fatto con truncated_normal_initializer()), l’inizializzazione Xavier decide automaticamente la deviazione standard in base al numero di connessioni in ingresso e in uscita di uno strato. Questo aiuta il flusso dei gradienti dall’alto verso il basso senza problemi come il vanishing gradient. Poi ridefinisci il modello.
Per prima cosa, definisci un batch_size che indica la quantità di dati che campioni in un singolo passo di ottimizzazione/validazione o test. Puoi quindi definire i layer_ids, che forniscono un identificatore per ciascuno degli strati della rete neurale che stai definendo.
Puoi poi definire i layer_sizes. Nota che len(layer_sizes) dovrebbe essere len(layer_ids)+1, perché layer_sizes include la dimensione dell’input all’inizio. MNIST ha immagini di dimensione 28x28, che diventano 784 se srotolate in una sola dimensione.
Quindi, puoi definire i placeholder di input e label, che userai in seguito per addestrare il modello. Infine, definisci due variabili TensorFlow per ogni strato (cioè weights e bias).
Nota: Questo è identico al codice usato la prima volta, tranne che per la tecnica di inizializzazione usata per i pesi
batch_size = 100
layer_ids = ['hidden1','hidden2','hidden3','hidden4','hidden5','out']
layer_sizes = [784, 500, 400, 300, 200, 100, 10]

tf.reset_default_graph()

# Inputs and Labels
train_inputs = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[0]], name='train_inputs')
train_labels = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[-1]], name='train_labels')

# Weight and Bias definitions
for idx, lid in enumerate(layer_ids):

    with tf.variable_scope(lid):
        w = tf.get_variable('weights',shape=[layer_sizes[idx], layer_sizes[idx+1]],
                            initializer=tf.contrib.layers.xavier_initializer())
        b = tf.get_variable('bias',shape= [layer_sizes[idx+1]],
                            initializer=tf.random_uniform_initializer(-0.1,0.1))
Con i placeholder di input/output, i pesi e i bias di ogni strato definiti, ora puoi di nuovo definire i calcoli per ottenere i logits della rete neurale.
Nota: Questa parte è identica al codice usato la prima volta che hai definito queste operazioni e tensori.
Qui puoi definire di nuovo gli oggetti tf.summary. Anche questo è identico al codice usato la prima volta che hai definito queste operazioni e tensori.
Qui definisci di nuovo gli oggetti tf.summary. Tuttavia, ora stai visualizzando vettori di scalari, quindi devi definire oggetti tf.summary.histogram.
Nota che questo è identico al codice usato la prima volta che hai definito queste operazioni e tensori.
Nota che è lo stesso di quanto fatto prima nella sezione precedente!
Ci sono solo pochi punti di codice da cambiare: le tre occorrenze di os.path.join('summaries','third') in os.path.join('summaries','fourth'), summ_writer_3 in summ_writer_4 (compare 4 volte) e il tf_learning_rate di 0.00001 va impostato a 0.01.
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25

config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure TensorFlow doesn't overflow the GPU

session = tf.InteractiveSession(config=config)

if not os.path.exists('summaries'):
    os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','fourth')):
    os.mkdir(os.path.join('summaries','fourth'))

summ_writer_4 = tf.summary.FileWriter(os.path.join('summaries','fourth'), session.graph)

tf.global_variables_initializer().run()

accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)


for epoch in range(n_epochs):
    loss_per_epoch = []
    for i in range(n_train//batch_size):

        # =================================== Training for one step ========================================
        batch = mnist_data.train.next_batch(batch_size)    # Get one batch of training data
        if i == 0:
            # Only for the first epoch, get the summary data
            # Otherwise, it can clutter the visualization
            l,_,gn_summ, wb_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary, tf_param_summaries],
                                      feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                                 train_labels: batch[1],
                                                tf_learning_rate: 0.01})
            summ_writer_4.add_summary(gn_summ, epoch)
            summ_writer_4.add_summary(wb_summ, epoch)
        else:
            # Optimize with training data
            l,_ = session.run([tf_loss,tf_loss_minimize],
                              feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                         train_labels: batch[1],
                                         tf_learning_rate: 0.01})
        loss_per_epoch.append(l)

    print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
    avg_loss = np.mean(loss_per_epoch)

    # ====================== Calculate the Validation Accuracy ==========================
    valid_accuracy_per_epoch = []
    for i in range(n_valid//batch_size):
        valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
        valid_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
        valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))

    mean_v_acc = np.mean(valid_accuracy_per_epoch)
    print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))

    # ===================== Calculate the Test Accuracy ===============================
    accuracy_per_epoch = []
    for i in range(n_test//batch_size):
        test_images, test_labels = mnist_data.test.next_batch(batch_size)
        test_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: test images.reshape(batch_size,image_size*image_size)}
        )
        accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))

    print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
    avg_test_accuracy = np.mean(accuracy_per_epoch)

    # Execute the summaries defined above
    summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})

    # Write the obtained summaries to the file, so they can be displayed
    summ_writer_4.add_summary(summ, epoch)

session.close()
Extracting MNIST_data/train-images-idx3-ubyte.gz
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 0.43618
    Average Valid Accuracy in epoch 0: 95.70000
    Average Test Accuracy in epoch 0: 95.22000

Average loss in epoch 1: 0.12872
    Average Valid Accuracy in epoch 1: 96.86000
    Average Test Accuracy in epoch 1: 96.71000

  ...
  ...
  ...

Average loss in epoch 24: 0.00009
    Average Valid Accuracy in epoch 24: 98.42000
    Average Test Accuracy in epoch 24: 98.21000
Qui puoi confrontare come evolvono i pesi nel tempo per le due diverse inizializzazioni: truncated_normal_initializer (rosso) e xavier_initializer (blu). Puoi vedere che xavier_initializer mantiene più pesi lontani da zero rispetto al normale inizializzatore, il che è meglio. Questo potenzialmente consente alle reti neurali inizializzate con Xavier di convergere più velocemente, come evidente dalle curve di loss/accuracy.
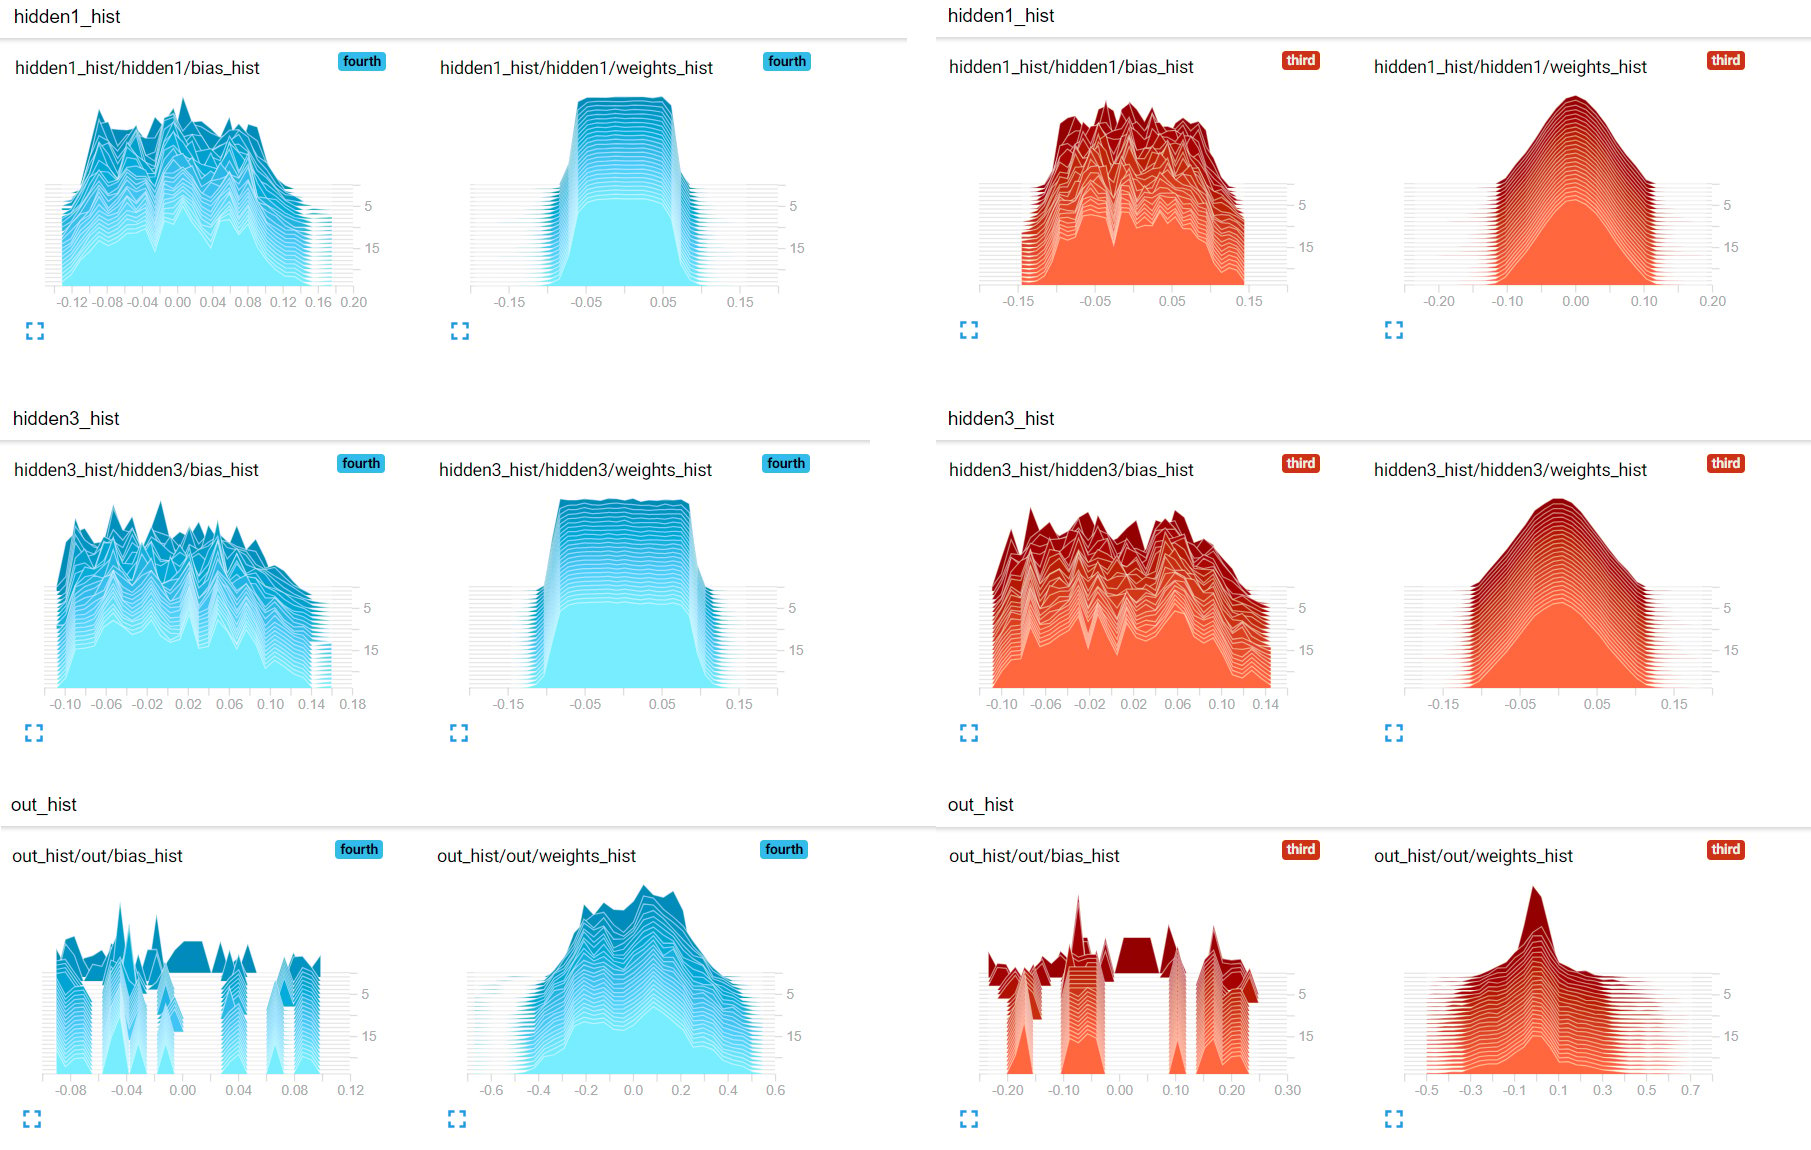
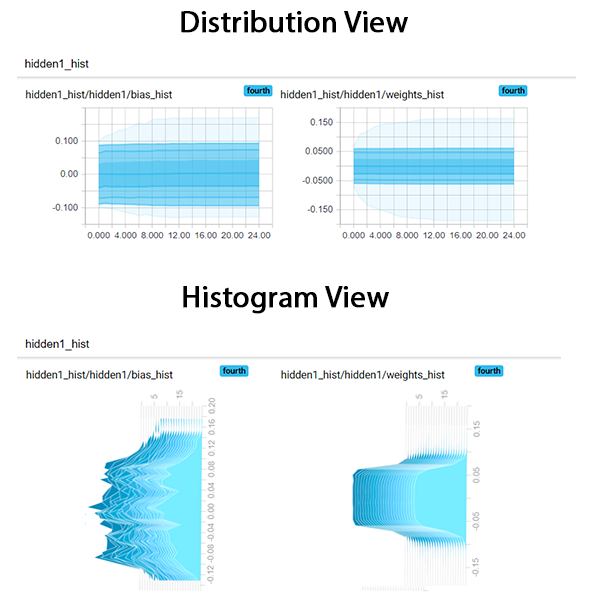
Ora puoi confrontare la differenza tra le due viste: vista istogramma e vista distribuzione. La vista distribuzione è essenzialmente un modo diverso di guardare gli istogrammi. Se guardi l’immagine qui sotto, puoi facilmente vedere che la vista distribuzione è una vista dall’alto della vista istogramma. Nota che i grafici a istogramma sono ruotati in questo caso per vedere più facilmente la somiglianza.
In questo tutorial, hai visto come usare TensorBoard. Per prima cosa, hai imparato come avviare il suo servizio tramite il prompt dei comandi (Windows) o il terminale (Ubuntu/Mac). Poi, hai esaminato le diverse viste dei dati fornite da TensorBoard. Hai quindi visto del codice che visualizza valori scalari (per esempio loss/accuracy) e hai usato un modello di rete neurale feed-forward per comprendere concretamente l’uso della visualizzazione di valori scalari.
Successivamente, hai esplorato come visualizzare collezioni/vettori di scalari usando la vista degli istogrammi. Questo è stato seguito da un confronto che evidenzia le differenze tra tecniche di inizializzazione dei pesi nelle reti neurali usando la vista degli istogrammi.
Infine, hai discusso le somiglianze tra la vista distribuzione e la vista istogramma.
Se vuoi saperne di più sul deep learning, assicurati di dare un’occhiata al nostro corso Deep Learning in Keras.
Dai un’occhiata anche al nostro tutorial Ottimizzazione degli iperparametri nei modelli di Machine Learning per saperne di più su parametri e iperparametri.
Se vuoi metterti in contatto con me, puoi scrivermi a thushv@gmail.com o connetterti con me su LinkedIn.
Approfondisci Machine Learning e Deep Learning
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



