Kurs
Machine Learning verstehen
2 Std.
308.6K

In diesem Tutorial erfährst du, wie du TensorBoard nutzt – ein starkes Tool, mit dem du Daten und ihr Verhalten visualisieren kannst. Du siehst, für welche Zwecke es sich beim Training eines neuronalen Netzes eignet.
Tipp: Schau dir den Deep-Learning-Kurs mit Keras von DataCamp hier an.
Bevor du loslegst, stelle sicher, dass du die folgenden Bibliotheken importierst, damit der Code korrekt läuft:
from pandas_datareader import data
import matplotlib.pyplot as plt
import pandas as pd
import datetime as dt
import urllib.request, json
import os
import numpy as np

# This code has been tested with TensorFlow 1.6
import tensorflow as tf
from tensorflow.examples.tutorials.mnist import input_data
Um Dinge mit TensorBoard zu visualisieren, musst du zuerst den Dienst starten. Gehe dafür so vor:
python3, dann erhältst du eine >>>-Eingabeaufforderung.import tensorflow as tf aus.>>>) mit exit() und gib folgenden Befehl ein:
tensorboard --logdir=summaries--logdir ist das Verzeichnis, in dem du die zu visualisierenden Daten erzeugst.--port=<port_you_like> den Port ändern, auf dem TensorBoard läuft.TensorBoard 1.6.0 at <url>:6006 (Press CTRL+C to quit)Hinweis: TensorBoard mag keine mehreren Event Files im selben Verzeichnis. Das kann zu sehr „zappeligen“ Kurven führen. Lege daher für jedes Beispiel einen eigenen Ordner an (zum Beispiel summaries/first, summaries/second, ...). Wenn du ein Experiment erneut ausführen willst (also wieder in einen bereits gefüllten Ordner schreibst), lösche vorher die bestehenden Event Files.
Unterschiedliche Ansichten erwarten unterschiedliche Eingabeformate und stellen sie jeweils anders dar. Du wechselst sie über die orangefarbene Top-Bar.
In diesem Tutorial behandeln wir die fett markierten Ansichten.
In diesem Abschnitt verstehst du, warum es sinnvoll ist, bestimmte Metriken (z. B. Loss oder Accuracy) zu visualisieren. Beim Training tiefer neuronaler Netze fehlt Einsteigern oft das Verständnis dafür, wie sich Designentscheidungen und Hyperparameter auswirken.
Setzt du Gewichte etwa unbedacht mit sehr großer Varianz an, divergiert dein Modell schnell und bricht zusammen. Aber auch mit Erfahrung kann einiges schiefgehen: Achtsamkeit bei der Lernrate ist entscheidend – sonst divergiert das Modell oder sättigt sich frühzeitig auf suboptimale Leistung.
Ein schneller Weg, Probleme zu erkennen, ist eine grafische Live-Visualisierung dessen, was im Modell passiert (z. B. alle 100 Iterationen). Verhält sich das Modell seltsam, siehst du das sofort. Genau das liefert dir TensorBoard: Du wählst die Werte aus, die angezeigt werden sollen, und TensorBoard hält während des Trainings eine Echtzeitvisualisierung bereit.
Wir starten mit einem fünf-lagigen neuronalen Netz zur Klassifikation handgeschriebener Ziffern auf dem bekannten MNIST-Datensatz. TensorFlow bietet eine einfache API zum Laden von MNIST, du musst es also nicht manuell herunterladen. Zuvor definieren wir eine einfache Methode (accuracy()), die die Genauigkeit von Vorhersagen gegenüber den True Labels berechnet.
def accuracy(predictions,labels):
    '''
    Accuracy of a given set of predictions of size (N x n_classes) and
    labels of size (N x n_classes)
    '''
    return np.sum(np.argmax(predictions,axis=1)==np.argmax(labels,axis=1))*100.0/labels.shape[0]
Definiere zunächst die batch_size, also wie viele Datenpunkte du pro Optimierungs‑/Validierungs‑ oder Testschritt ziehst. Danach legst du layer_ids als Bezeichner für die Schichten des Netzes fest und definierst dann layer_sizes.
Beachte: len(layer_sizes) sollte len(layer_ids)+1 entsprechen, da layer_sizes auch die Eingabegröße am Anfang enthält.
MNIST-Bilder haben 28×28 Pixel, also 784 Merkmale, wenn man sie „abflacht“. Dann definierst du Eingabe- und Label-Placeholders für das spätere Training. Abschließend legst du pro Schicht zwei TensorFlow-Variablen an (weights und bias).
Mit Variable Scopes (mehr Infos hier) erhalten Variablen saubere Namen und sind später leichter zugänglich.
batch_size = 100
layer_ids = ['hidden1','hidden2','hidden3','hidden4','hidden5','out']
layer_sizes = [784, 500, 400, 300, 200, 100, 10]

tf.reset_default_graph()

# Inputs and Labels
train_inputs = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[0]], name='train_inputs')
train_labels = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[-1]], name='train_labels')

# Weight and Bias definitions
for idx, lid in enumerate(layer_ids):

    with tf.variable_scope(lid):
        w = tf.get_variable('weights',shape=[layer_sizes[idx], layer_sizes[idx+1]],
                            initializer=tf.truncated_normal_initializer(stddev=0.05))
        b = tf.get_variable('bias',shape= [layer_sizes[idx+1]],
                            initializer=tf.random_uniform_initializer(-0.1,0.1))
Mit den definierten Placeholders, Gewichten und Biases legst du nun fest, wie die Logits des Netzes berechnet werden. Logits sind die unnormalisierten Werte der letzten Schicht. Nach der Normalisierung sprechen wir von Predictions. Dafür iterierst du über alle Schichten und berechnest tf.matmul(h,w) + b. Für alle Schichten außer der letzten wendest du eine Aktivierungsfunktion an, z. B. tf.nn.relu(tf.matmul(h,w) + b).
Anschließend definierst du die Verlustfunktion zur Optimierung des Netzes. Hier verwenden wir Kreuzentropie, die sich bei Klassifikationsaufgaben oft besser bewährt als der mittlere quadratische Fehler.
Zum Schluss brauchst du einen Optimierer, der den Loss minimiert und dazu die Gewichte in die richtige Richtung aktualisiert.
# Calculating Logits
h = train_inputs
for lid in layer_ids:
    with tf.variable_scope(lid,reuse=True):
        w, b = tf.get_variable('weights'), tf.get_variable('bias')
        if lid != 'out':
          h = tf.nn.relu(tf.matmul(h,w)+b,name=lid+'_output')
        else:
          h = tf.nn.xw_plus_b(h,w,b,name=lid+'_output')

tf_predictions = tf.nn.softmax(h, name='predictions')
# Calculating Loss
tf_loss = tf.reduce_mean(tf.nn.softmax_cross_entropy_with_logits_v2(labels=train_labels, logits=h),name='loss')

# Optimizer
tf_learning_rate = tf.placeholder(tf.float32, shape=None, name='learning_rate')
optimizer = tf.train.MomentumOptimizer(tf_learning_rate,momentum=0.9)
grads_and_vars = optimizer.compute_gradients(tf_loss)
tf_loss_minimize = optimizer.minimize(tf_loss)
Hier definierst du tf.summary-Objekte. Diese versteht TensorBoard. Alle Werte, die du anzeigen möchtest, kapselst du in ein tf.summary-Objekt.
Es gibt verschiedene Summary-Typen. Für Skalarwerte nutzt du tf.summary.scalar. Außerdem kannst du mit tf.name_scope Skalare gruppieren. Skalare mit demselben Name Scope erscheinen in einer Zeile. Wir definieren drei unterschiedliche Summaries:
tf_loss_summary: Du speist den Wert per Placeholder ein, wenn du ihn veröffentlichen willst.tf_accuracy_summary: Ebenfalls per Placeholder einspeisen, wenn du ihn veröffentlichen willst.tf_gradnorm_summary: Berechnet die L2‑Norm der Gradienten der letzten Schicht. Die Gradienten-Norm ist ein guter Indikator dafür, ob die Gewichte sinnvoll aktualisiert werden. Sehr kleine Werte deuten auf vanishing gradients, sehr große auf exploding gradients hin.# Name scope allows you to group various summaries together
# Summaries having the same name_scope will be displayed on the same row
with tf.name_scope('performance'):
# Summaries need to be displayed
# Whenever you need to record the loss, feed the mean loss to this placeholder
tf_loss_ph = tf.placeholder(tf.float32,shape=None,name='loss_summary')
# Create a scalar summary object for the loss so it can be displayed
tf_loss_summary = tf.summary.scalar('loss', tf_loss_ph)
# Whenever you need to record the loss, feed the mean test accuracy to this placeholder
tf_accuracy_ph = tf.placeholder(tf.float32,shape=None, name='accuracy_summary')
# Create a scalar summary object for the accuracy so it can be displayed
tf_accuracy_summary = tf.summary.scalar('accuracy', tf_accuracy_ph)
# Gradient norm summary
for g,v in grads_and_vars:
if 'hidden5' in v.name and 'weights' in v.name:
with tf.name_scope('gradients'):
tf_last_grad_norm = tf.sqrt(tf.reduce_mean(g**2))
tf_gradnorm_summary = tf.summary.scalar('grad_norm', tf_last_grad_norm)
break
# Merge all summaries together
performance_summaries = tf.summary.merge([tf_loss_summary,tf_accuracy_summary])
Im folgenden Code passiert Folgendes: Zunächst erstellst du eine Session, in der die oben definierten Operationen ausgeführt werden. Dann legst du einen Ordner zum Speichern der Summary-Daten an. Als Nächstes erzeugst du einen Summary Writer summ_writer. Jetzt initialisierst du alle Variablen und lädst den MNIST-Datensatz.
Für jede Epoche und jeden Batch der Trainingsdaten (also jede Iteration) führst du gradnorm_summary aus, falls es die erste Iteration ist, und schreibst gradnorm_summary per Summary Writer in die Event-Datei. Danach führst du die Modelloptimierung und die Loss-Berechnung aus. Nach einem kompletten Durchlauf des Trainingsdatensatzes berechnest du den durchschnittlichen Training Loss.
Analog verfährst du mit dem Validierungssatz: Für jeden Batch berechnest du die Validierungsgenauigkeit und im Anschluss den Durchschnitt über den gesamten Validierungssatz.
Zum Schluss folgt der Test: Für jeden Batch der Testdaten berechnest du die Testgenauigkeit und anschließend die durchschnittliche Testgenauigkeit über den gesamten Testsatz. Ganz am Ende führst du performance_summaries aus und schreibst sie mit dem Summary Writer in die Event-Datei.
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25

config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure Tensorflow doesn't overflow the GPU

session = tf.InteractiveSession(config=config)

if not os.path.exists('summaries'):
    os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','first')):
    os.mkdir(os.path.join('summaries','first'))

summ_writer = tf.summary.FileWriter(os.path.join('summaries','first'), session.graph)

tf.global_variables_initializer().run()

accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)


for epoch in range(n_epochs):
    loss_per_epoch = []
    for i in range(n_train//batch_size):

        # =================================== Training for one step ========================================
        batch = mnist_data.train.next_batch(batch_size)    # Get one batch of training data
        if i == 0:
            # Only for the first epoch, get the summary data
            # Otherwise, it can clutter the visualization
            l,_,gn_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary],
                                      feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                                 train_labels: batch[1],
                                                tf_learning_rate: 0.0001})
            summ_writer.add_summary(gn_summ, epoch)
        else:
            # Optimize with training data
            l,_ = session.run([tf_loss,tf_loss_minimize],
                              feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                         train_labels: batch[1],
                                         tf_learning_rate: 0.0001})
        loss_per_epoch.append(l)

    print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
    avg_loss = np.mean(loss_per_epoch)

    # ====================== Calculate the Validation Accuracy ==========================
    valid_accuracy_per_epoch = []
    for i in range(n_valid//batch_size):
        valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
        valid_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
        valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))

    mean_v_acc = np.mean(valid_accuracy_per_epoch)
    print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))

    # ===================== Calculate the Test Accuracy ===============================
    accuracy_per_epoch = []
    for i in range(n_test//batch_size):
        test_images, test_labels = mnist_data.test.next_batch(batch_size)
        test_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: test_images.reshape(batch_size,image_size*image_size)}
        )
        accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))

    print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
    avg_test_accuracy = np.mean(accuracy_per_epoch)

    # Execute the summaries defined above
    summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})

    # Write the obtained summaries to the file, so it can be displayed in the TensorBoard
    summ_writer.add_summary(summ, epoch)

session.close()
Successfully downloaded train-images-idx3-ubyte.gz 9912422 bytes.
Extracting MNIST_data/train-images-idx3-ubyte.gz
Successfully downloaded train-labels-idx1-ubyte.gz 28881 bytes.
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Successfully downloaded t10k-images-idx3-ubyte.gz 1648877 bytes.
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Successfully downloaded t10k-labels-idx1-ubyte.gz 4542 bytes.
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 2.30252
    Average Valid Accuracy in epoch 0: 10.02000
    Average Test Accuracy in epoch 0: 9.76000

Average loss in epoch 1: 2.30016
    Average Valid Accuracy in epoch 1: 12.56000
    Average Test Accuracy in epoch 1: 12.64000

  ...
  ...
  ...

Average loss in epoch 24: 1.03386
    Average Valid Accuracy in epoch 24: 71.88000
    Average Test Accuracy in epoch 24: 71.23000
Schau dir zuerst an, wie der Rechen-Graph deines Modells aussieht. Du erreichst diese Ansicht über Graphs in TensorBoard. Es sollte aussehen wie unten im Bild. Du siehst einen klaren Fluss von train_inputs zu loss und predictions durch die verdeckten Schichten 1 bis 5.
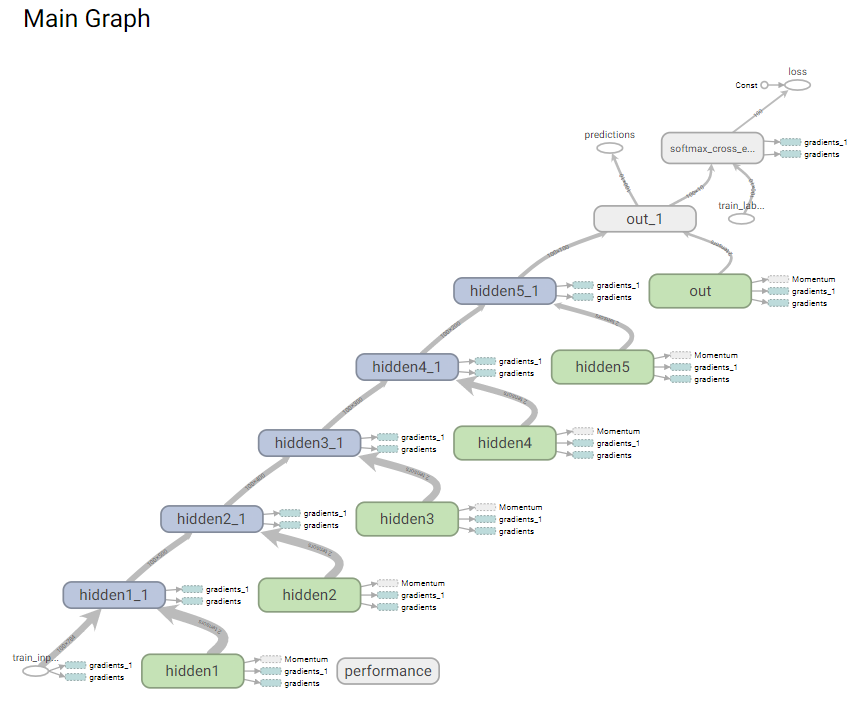
Die MNIST-Klassifikation ist eines der einfachsten Beispiele, und trotzdem schaffen wir hier mit einem 5‑Schicht-Netz keine überzeugenden Ergebnisse. Für MNIST sind Genauigkeiten von über 90% in weniger als 5 Epochen normalerweise kein Problem.
Was ist hier also los?
Werfen wir einen Blick in TensorBoard:
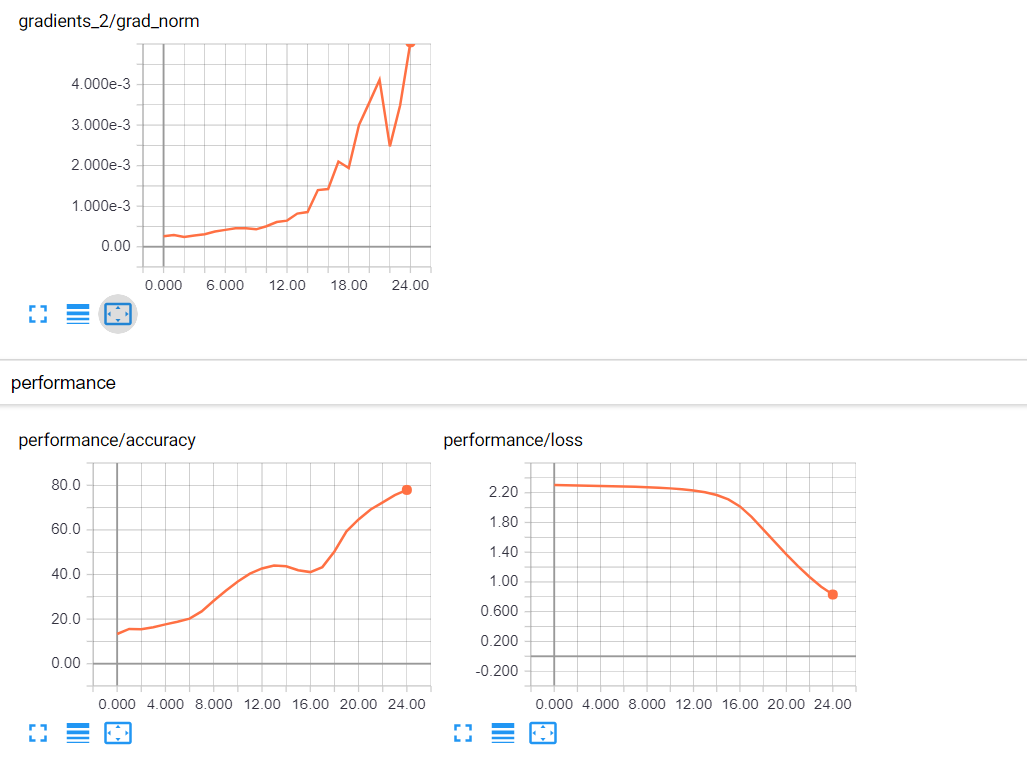
Du siehst, dass die Accuracy steigt, aber sehr langsam, während die Gradienten-Updates im Zeitverlauf zunehmen. Das ist ungewöhnlich. Auf dem Weg zur Konvergenz sollten die Gradienten kleiner werden (gegen null gehen), nicht größer. Weil die Accuracy dennoch steigt, bist du grundsätzlich auf Kurs. Vermutlich brauchst du eine höhere Lernrate.
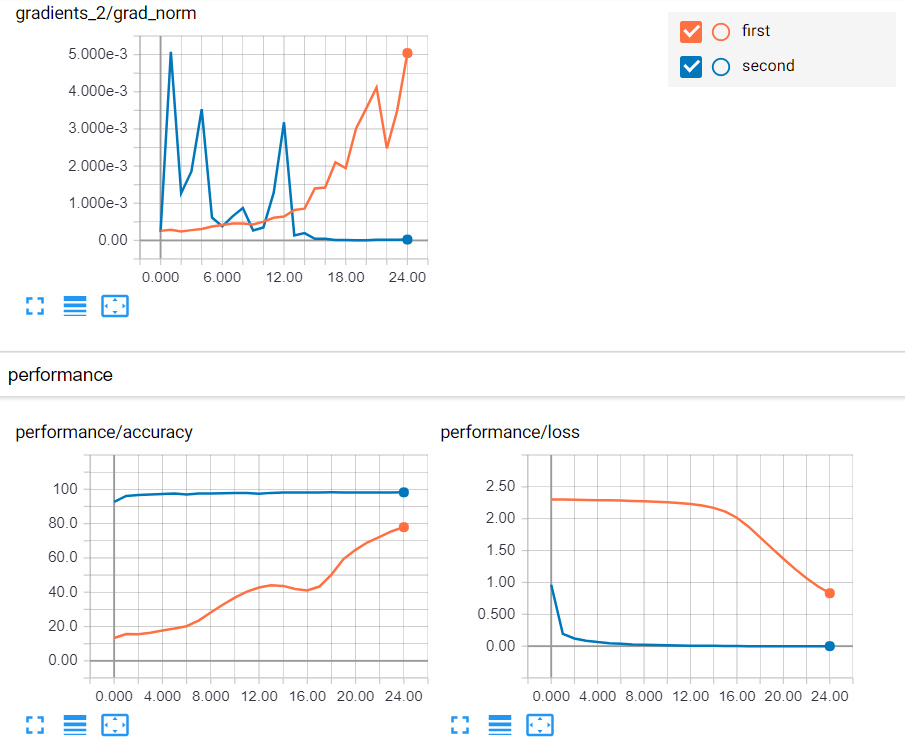
Probiere nun eine Lernrate von 0.01. Das ist fast identisch mit der vorherigen Ausführung – nur dass du 0.01 anstelle von 0.0001 verwendest. Ersetze also tf_learning_rate: 0.0001 durch tf_learning_rate: 0.01. Achtung: Das Argument musst du an zwei Stellen anpassen.
Jetzt startet die Accuracy nahe 100 und steigt weiter an. Gleichzeitig nehmen die Gradienten-Updates über die Zeit ab und nähern sich null. Mit der Lernrate 0.01 sieht es deutlich besser aus.
Als Nächstes gehen wir über Skalare hinaus. Du siehst, wie sich Vektoren aus Skalarwerten und Sammlungen analysieren lassen.
Du hast gesehen, wie hilfreich die Visualisierung von Skalaren in TensorBoard ist, um das Modellverhalten zu verstehen und Probleme zu beheben. Auch die Graph-Ansicht zeigte dir die durchgängige Verbindung von Input zu Predictions – Voraussetzung für Gradientenberechnungen.
Jetzt betrachten wir eine weitere nützliche Ansicht: Histogramme bzw. Verteilungen.
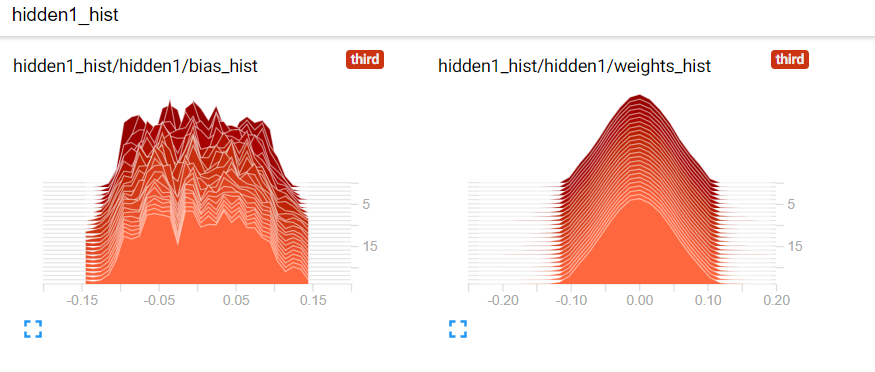
Erinnere dich: Ein Histogramm ist eine Sammlung von Werten, dargestellt über die Häufigkeit/Dichte, mit der ein Wert in der Sammlung vorkommt. Du kannst Histogramme nutzen, um die Gewichte des Netzes über die Zeit zu visualisieren. Das ist wichtig, denn stark springende Gewichte deuten auf Probleme bei der Initialisierung oder der Lernrate hin.
Im Beispiel siehst du, wie sich Gewichte verändern. Im Code wird truncated_normal_initializer() zur Initialisierung genutzt.
Auch hier definierst du tf.summary-Objekte. Da wir Vektoren von Skalarwerten visualisieren, verwenden wir tf.summary.histogram.
In diesem Fall definierst du zwei Histogramm-Objekte (tf_w_hist und tf_b_hist) für die Gewichte und Biases einer Schicht. Solche Objekte legst du für alle Schichten an – jede mit eigenem Name Scope.
Abschließend fasst du mit tf.summary.merge alle diese Summaries zu einer gruppierten Operation zusammen.
# Summaries need to be displayed
# Create a summary for each weight bias in each layer
all_summaries = []
for lid in layer_ids:
    with tf.name_scope(lid+'_hist'):
        with tf.variable_scope(lid,reuse=True):
            w,b = tf.get_variable('weights'), tf.get_variable('bias')

            # Create a scalar summary object for the loss so it can be displayed
            tf_w_hist = tf.summary.histogram('weights_hist', tf.reshape(w,[-1]))
            tf_b_hist = tf.summary.histogram('bias_hist', b)
            all_summaries.extend([tf_w_hist, tf_b_hist])

# Merge all parameter histogram summaries together
tf_param_summaries = tf.summary.merge(all_summaries)
Dieser Schritt ist fast identisch mit zuvor, nur dass wir zusätzliche Zeilen einfügen, um die Histogramm-Summaries zu berechnen (tf_param_summaries).
Hinweis: Die Lernraten wurden ebenfalls angepasst.
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25

config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure Tensorflow doesn't overflow the GPU

session = tf.InteractiveSession(config=config)

if not os.path.exists('summaries'):
    os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','third')):
    os.mkdir(os.path.join('summaries','third'))

summ_writer_3 = tf.summary.FileWriter(os.path.join('summaries','third'), session.graph)

tf.global_variables_initializer().run()

accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)


for epoch in range(n_epochs):
    loss_per_epoch = []
    for i in range(n_train//batch_size):

        # =================================== Training for one step ========================================
        batch = mnist_data.train.next_batch(batch_size)    # Get one batch of training data
        if i == 0:
            # Only for the first epoch, get the summary data
            # Otherwise, it can clutter the visualization
            l,_,gn_summ, wb_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary, tf_param_summaries],
                                      feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                                 train_labels: batch[1],
                                                tf_learning_rate: 0.00001})
            summ_writer_3.add_summary(gn_summ, epoch)
            summ_writer_3.add_summary(wb_summ, epoch)
        else:
            # Optimize with training data
            l,_ = session.run([tf_loss,tf_loss_minimize],
                              feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                         train_labels: batch[1],
                                         tf_learning_rate: 0.01})
        loss_per_epoch.append(l)

    print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
    avg_loss = np.mean(loss_per_epoch)

    # ====================== Calculate the Validation Accuracy ==========================
    valid_accuracy_per_epoch = []
    for i in range(n_valid//batch_size):
        valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
        valid_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
        valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))

    mean_v_acc = np.mean(valid_accuracy_per_epoch)
    print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))

    # ===================== Calculate the Test Accuracy ===============================
    accuracy_per_epoch = []
    for i in range(n_test//batch_size):
        test_images, test_labels = mnist_data.test.next_batch(batch_size)
        test_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: test_images.reshape(batch_size,image_size*image_size)}
        )
        accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))

    print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
    avg_test_accuracy = np.mean(accuracy_per_epoch)

    # Execute the summaries defined above
    summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})

    # Write the obtained summaries to the file, so they can be displayed
    summ_writer_3.add_summary(summ, epoch)

session.close()
Extracting MNIST_data/train-images-idx3-ubyte.gz
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 1.02625
    Average Valid Accuracy in epoch 0: 92.76000
    Average Test Accuracy in epoch 0: 92.65000

Average loss in epoch 1: 0.19110
    Average Valid Accuracy in epoch 1: 95.80000
    Average Test Accuracy in epoch 1: 95.48000

  ...
  ...
  ...

Average loss in epoch 24: 0.00009
    Average Valid Accuracy in epoch 24: 98.28000
    Average Test Accuracy in epoch 24: 98.09000
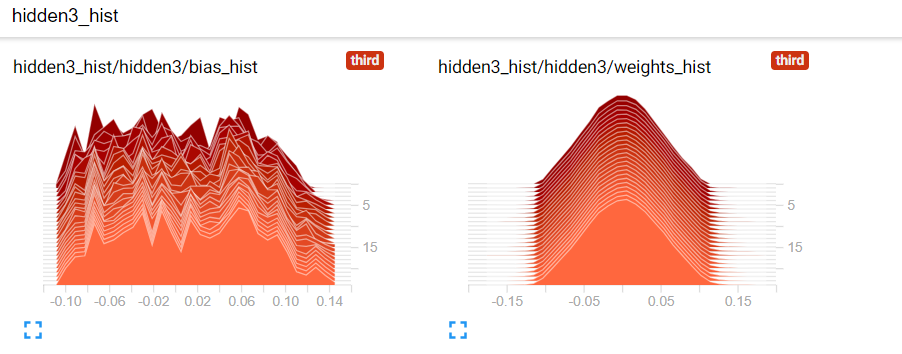
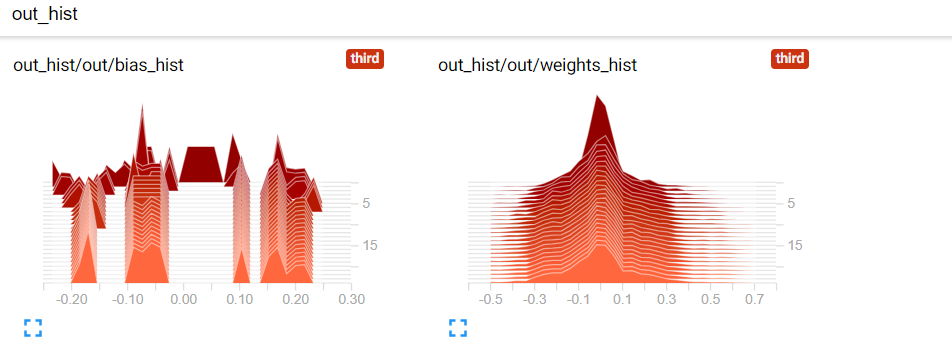
So sehen deine Gewichte und Biases aus: Wir haben drei Achsen – Zeit (x‑Achse), Wert (y‑Achse) und Häufigkeit/Dichte (z‑Achse). Dunklere Histogramme stehen für ältere Daten, hellere für neuere. Ein höherer Wert auf der z‑Achse bedeutet, dass der Vektor mehr Werte in der Nähe dieses spezifischen Werts enthält.
Hinweis: Es gibt auch eine „Overlay“-Ansicht der Histogramme über die Zeit. Du kannst die Anzeigeart in der linken Seitenleiste umschalten.
Anstelle von truncated_normal_initializer() verwenden wir nun den xavier_initializer() für die Gewichte. Xavier ist besonders für tiefe Netze eine bessere Initialisierungstechnik.
Statt einer frei gewählten Standardabweichung (wie bei truncated_normal_initializer()) bestimmt Xavier die Standardabweichung automatisch anhand der Anzahl der Eingangs- und Ausgangsverbindungen einer Schicht. So fließen Gradienten von oben nach unten besser, ohne Probleme wie vanishing gradients. Anschließend definierst du das Modell erneut.
Zuerst definierst du die batch_size. Dann legst du layer_ids als Bezeichner für die Schichten fest.
Dann definierst du layer_sizes. Beachte: len(layer_sizes) sollte len(layer_ids)+1 sein, da layer_sizes am Anfang die Eingabegröße enthält. MNIST-Bilder haben 28×28 Pixel, also 784 Merkmale.
Anschließend definierst du die Input- und Label-Placeholders für das Training. Schließlich legst du pro Schicht zwei TensorFlow-Variablen an (weights und bias).
Hinweis: Das ist identisch mit dem ersten Code – nur die Initialisierung der Gewichte ist anders.
batch_size = 100
layer_ids = ['hidden1','hidden2','hidden3','hidden4','hidden5','out']
layer_sizes = [784, 500, 400, 300, 200, 100, 10]

tf.reset_default_graph()

# Inputs and Labels
train_inputs = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[0]], name='train_inputs')
train_labels = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[-1]], name='train_labels')

# Weight and Bias definitions
for idx, lid in enumerate(layer_ids):

    with tf.variable_scope(lid):
        w = tf.get_variable('weights',shape=[layer_sizes[idx], layer_sizes[idx+1]],
                            initializer=tf.contrib.layers.xavier_initializer())
        b = tf.get_variable('bias',shape= [layer_sizes[idx+1]],
                            initializer=tf.random_uniform_initializer(-0.1,0.1))
Mit den definierten Placeholders, Gewichten und Biases legst du die Berechnungen für die Logits erneut fest.
Hinweis: Dieser Teil ist identisch mit der ersten Definition der Operationen und Tensoren.
Erneut definierst du tf.summary-Objekte. Auch das ist identisch mit dem ersten Mal.
Wieder definierst du tf.summary-Objekte. Da Vektoren aus Skalaren visualisiert werden, brauchst du tf.summary.histogram.
Hinweis: Auch das entspricht dem ersten Durchlauf.
Hinweis: Dies ist dasselbe Vorgehen wie im vorherigen Abschnitt.
Du änderst nur wenige Stellen: dreimal os.path.join('summaries','third') zu os.path.join('summaries','fourth'), summ_writer_3 zu summ_writer_4 (4 Vorkommen) und die tf_learning_rate von 0.00001 auf 0.01.
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25

config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure TensorFlow doesn't overflow the GPU

session = tf.InteractiveSession(config=config)

if not os.path.exists('summaries'):
    os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','fourth')):
    os.mkdir(os.path.join('summaries','fourth'))

summ_writer_4 = tf.summary.FileWriter(os.path.join('summaries','fourth'), session.graph)

tf.global_variables_initializer().run()

accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)


for epoch in range(n_epochs):
    loss_per_epoch = []
    for i in range(n_train//batch_size):

        # =================================== Training for one step ========================================
        batch = mnist_data.train.next_batch(batch_size)    # Get one batch of training data
        if i == 0:
            # Only for the first epoch, get the summary data
            # Otherwise, it can clutter the visualization
            l,_,gn_summ, wb_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary, tf_param_summaries],
                                      feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                                 train_labels: batch[1],
                                                tf_learning_rate: 0.01})
            summ_writer_4.add_summary(gn_summ, epoch)
            summ_writer_4.add_summary(wb_summ, epoch)
        else:
            # Optimize with training data
            l,_ = session.run([tf_loss,tf_loss_minimize],
                              feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                         train_labels: batch[1],
                                         tf_learning_rate: 0.01})
        loss_per_epoch.append(l)

    print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
    avg_loss = np.mean(loss_per_epoch)

    # ====================== Calculate the Validation Accuracy ==========================
    valid_accuracy_per_epoch = []
    for i in range(n_valid//batch_size):
        valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
        valid_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
        valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))

    mean_v_acc = np.mean(valid_accuracy_per_epoch)
    print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))

    # ===================== Calculate the Test Accuracy ===============================
    accuracy_per_epoch = []
    for i in range(n_test//batch_size):
        test_images, test_labels = mnist_data.test.next_batch(batch_size)
        test_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: test_images.reshape(batch_size,image_size*image_size)}
        )
        accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))

    print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
    avg_test_accuracy = np.mean(accuracy_per_epoch)

    # Execute the summaries defined above
    summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})

    # Write the obtained summaries to the file, so they can be displayed
    summ_writer_4.add_summary(summ, epoch)

session.close()
Extracting MNIST_data/train-images-idx3-ubyte.gz
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 0.43618
    Average Valid Accuracy in epoch 0: 95.70000
    Average Test Accuracy in epoch 0: 95.22000

Average loss in epoch 1: 0.12872
    Average Valid Accuracy in epoch 1: 96.86000
    Average Test Accuracy in epoch 1: 96.71000

  ...
  ...
  ...

Average loss in epoch 24: 0.00009
    Average Valid Accuracy in epoch 24: 98.42000
    Average Test Accuracy in epoch 24: 98.21000
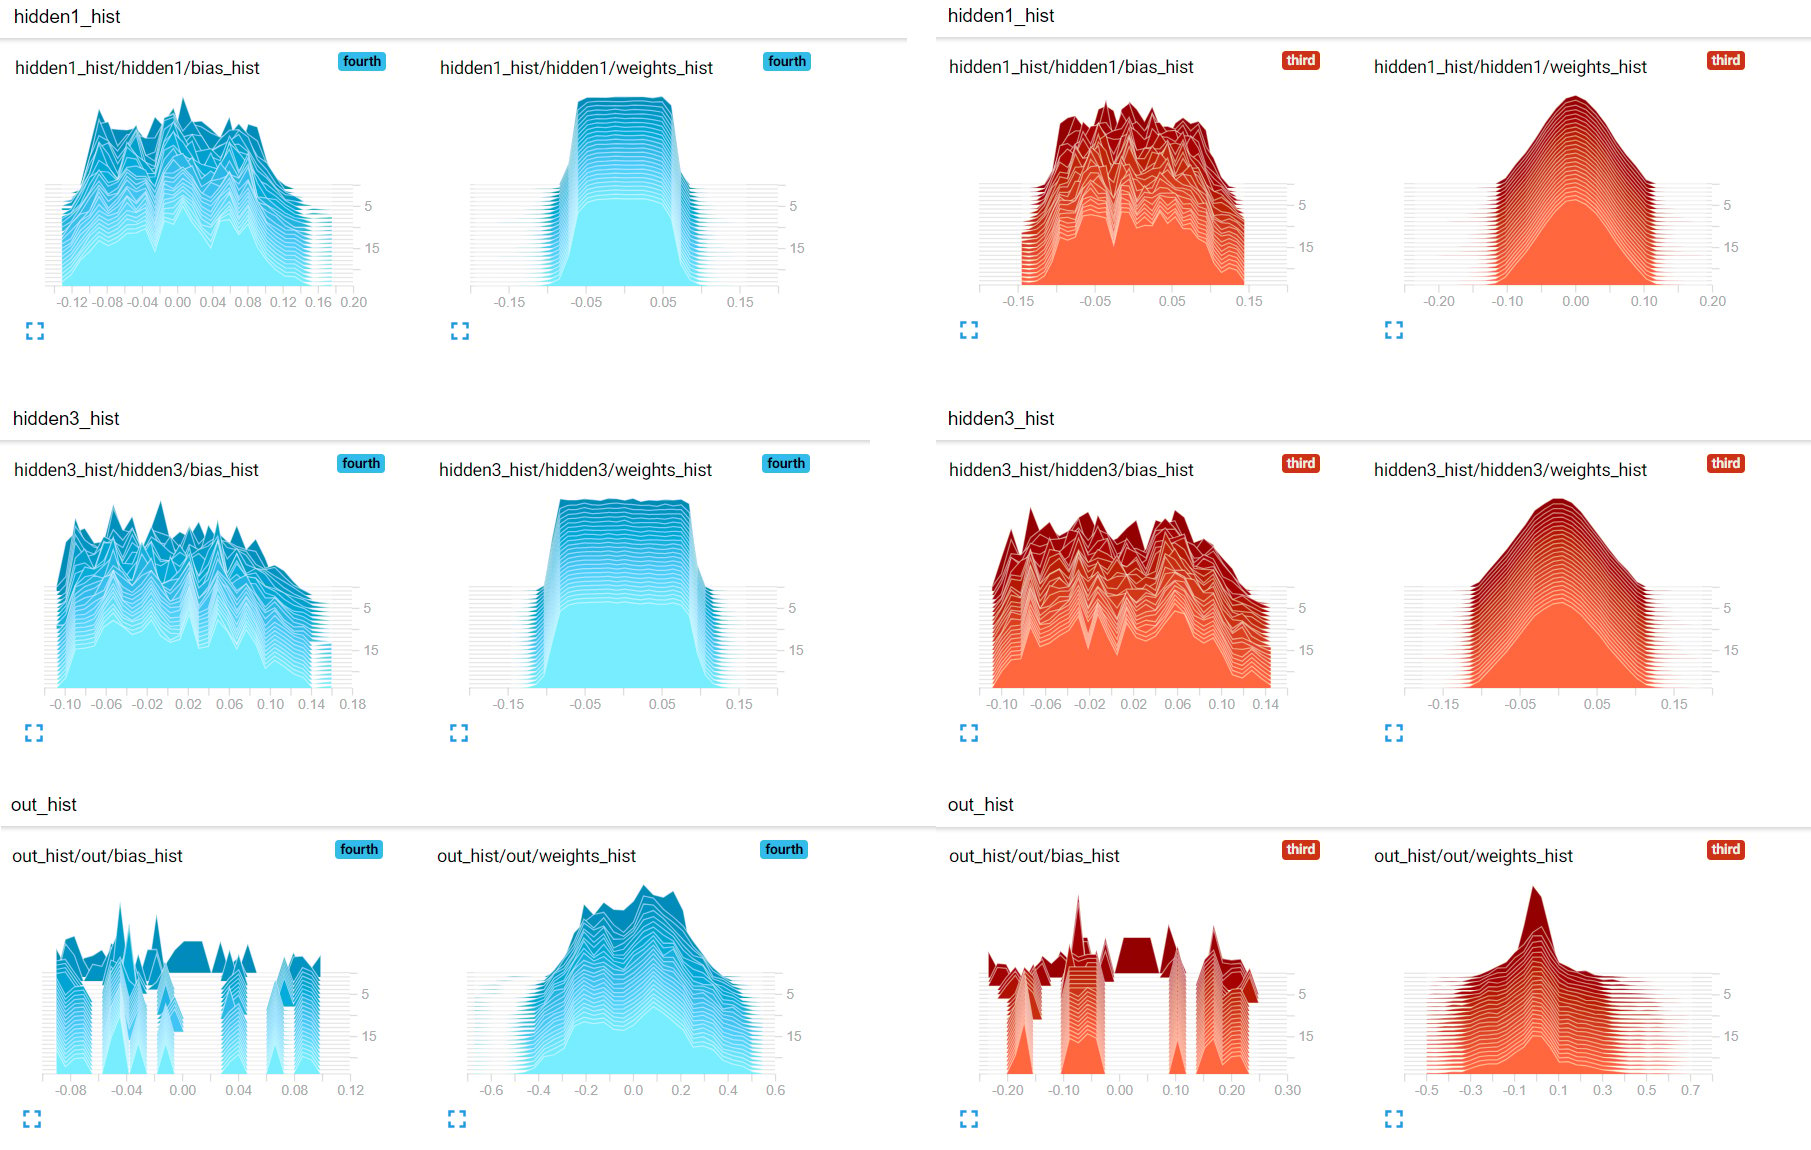
Hier vergleichst du, wie sich Gewichte über die Zeit bei zwei Initialisierungen entwickeln: truncated_normal_initializer (rot) und xavier_initializer (blau). Du siehst, dass xavier_initializer mehr Gewichte weiter weg von null hält als der normale Initialisierer – das ist vorteilhaft. Dadurch können Xavier-initialisierte Netze potenziell schneller konvergieren, was sich in den Loss-/Accuracy-Kurven widerspiegelt.
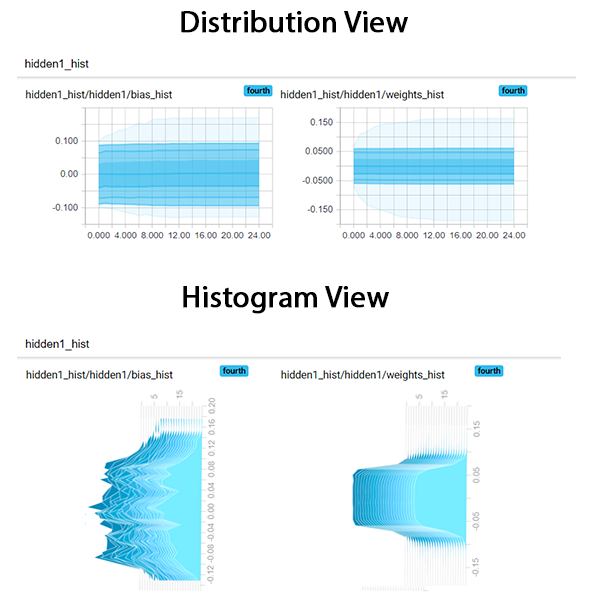
Nun kannst du die beiden Ansichten vergleichen: Histogramm- und Verteilungsansicht. Die Verteilungsansicht ist im Grunde eine andere Perspektive auf die Histogramme. Im Bild unten erkennst du leicht, dass die Verteilungsansicht eine Draufsicht auf die Histogramme ist. Beachte: Die Histogramm-Grafiken sind hier gedreht, um die Ähnlichkeit zu verdeutlichen.
In diesem Tutorial hast du gelernt, wie du TensorBoard verwendest. Zuerst hast du den Dienst über die Eingabeaufforderung (Windows) bzw. das Terminal (Ubuntu/Mac) gestartet. Dann hast du die verschiedenen Datenansichten in TensorBoard kennengelernt. Anschließend hast du Code gesehen, der Skalarwerte (z. B. Loss/Accuracy) visualisiert, und ein Feedforward-Netz genutzt, um den Nutzen dieser Visualisierung greifbar zu machen.
Danach hast du gesehen, wie man Sammlungen/Vektoren von Skalaren mit der Histogramm-Ansicht darstellt. Es folgte ein Vergleich der Initialisierungstechniken für Netzwerkgewichte mithilfe der Histogramm-Ansicht.
Zum Schluss hast du die Parallelen zwischen Verteilungs- und Histogramm-Ansicht diskutiert.
Wenn du mehr über Deep Learning lernen möchtest, wirf einen Blick auf unseren Kurs Deep Learning in Keras.
Sieh dir auch unser Tutorial Hyperparameter-Optimierung in Machine-Learning-Modellen an, um mehr über Parameter und Hyperparameter zu erfahren.
Wenn du mit mir in Kontakt treten möchtest, schreib mir gern eine E-Mail an thushv@gmail.com oder vernetze dich mit mir auf LinkedIn.
Erfahre mehr über Machine Learning und Deep Learning
Kurs
Kurs
Kurs
Blog
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
DataCamp Team
3 Min.
Tutorial
DataCamp Team
5 Min.
Tutorial
Sejal Jaiswal
9 Min.
Tutorial
Laiba Siddiqui
6 Min.



