

Hướng dẫn này sẽ giúp bạn sử dụng TensorBoard, một tiện ích tuyệt vời cho phép bạn trực quan hóa dữ liệu và cách dữ liệu thay đổi. Bạn sẽ thấy những mục đích có thể sử dụng nó khi huấn luyện mạng nơ-ron.
- Trước hết, bạn sẽ học cách khởi động TensorBoard, sau đó là tổng quan về các chế độ xem được cung cấp.
- Tiếp theo, bạn sẽ xem cách trực quan hóa các giá trị vô hướng (scalar) sinh ra trong quá trình tính toán. Bạn cũng sẽ học cách rút ra insight từ mô hình để khắc phục lỗi tiềm ẩn trong học.
- Sau đó, bạn sẽ tìm hiểu cách trực quan hóa vector hoặc tập hợp dữ liệu dưới dạng biểu đồ tần suất (histogram).
- Với chế độ xem này, bạn sẽ so sánh cách khởi tạo trọng số của mạng nơ-ron ảnh hưởng đến việc cập nhật trọng số trong quá trình học.
Mẹo: xem khóa học Deep Learning với Keras của DataCamp tại đây.
Trước khi bắt đầu, hãy chắc chắn bạn đã import các thư viện sau để chạy mã thành công:
from pandas_datareader import data
import matplotlib.pyplot as plt
import pandas as pd
import datetime as dt
import urllib.request, json
import os
import numpy as np
# This code has been tested with TensorFlow 1.6
import tensorflow as tf
from tensorflow.examples.tutorials.mnist import input_data
Khởi động TensorBoard
Để trực quan hóa bằng TensorBoard, trước tiên bạn cần khởi động dịch vụ của nó. Để làm vậy,
- Mở command prompt (Windows) hoặc terminal (Ubuntu/Mac)
- Đi vào thư mục gốc của dự án
- Nếu bạn dùng Python virtualenv, hãy kích hoạt môi trường ảo nơi bạn đã cài TensorFlow
- Đảm bảo bạn có thể thấy thư viện TensorFlow qua Python. Để làm vậy,
- Gõ
python3, bạn sẽ thấy dấu nhắc>>> - Thử
import tensorflow as tf - Nếu chạy thành công là ổn
- Gõ
- Thoát khỏi dấu nhắc Python (tức là
>>>) bằng cách gõexit()và nhập lệnh sautensorboard --logdir=summaries--logdirlà thư mục nơi bạn sẽ tạo dữ liệu để trực quan hóa- Các tệp mà TensorBoard lưu dữ liệu vào được gọi là event files
- Kiểu dữ liệu được lưu trong event files được gọi là summary data
- Bạn có thể dùng tùy chọn
--port=<port_you_like>để đổi cổng TensorBoard chạy
- Bạn sẽ thấy thông báo sau
TensorBoard 1.6.0 at <url>:6006 (Press CTRL+C to quit)
- Nhập <url>:6006 vào trình duyệt web
- Lúc này bạn sẽ thấy một bảng điều khiển màu cam. Bạn chưa có gì để hiển thị vì chưa sinh dữ liệu.
Lưu ý: TensorBoard không thích có nhiều event file trong cùng một thư mục. Điều này có thể khiến bạn nhận được các đường cong rất xấu trên màn hình. Vì vậy, bạn nên tạo thư mục riêng cho mỗi ví dụ khác nhau (ví dụ, summaries/first, summaries/second, ...) để lưu dữ liệu. Một điều nữa cần nhớ là nếu bạn muốn chạy lại một thí nghiệm (tức là lưu event file vào một thư mục đã có dữ liệu), bạn phải xóa các event file hiện có trước.
Các chế độ xem của TensorBoard
Các chế độ xem khác nhau nhận đầu vào với định dạng khác nhau và hiển thị theo cách khác nhau. Bạn có thể đổi chúng trên thanh trên cùng màu cam.
- Scalars - Trực quan hóa các giá trị vô hướng, như độ chính xác phân loại.
- Graph - Trực quan hóa đồ thị tính toán của mô hình, như mô hình mạng nơ-ron.
- Distributions - Trực quan hóa cách dữ liệu thay đổi theo thời gian, như trọng số của mạng nơ-ron.
- Histograms - Chế độ xem chi tiết hơn của phân phối, hiển thị phân phối theo phối cảnh 3 chiều
- Projector - Dùng để trực quan hóa word embeddings (tức là biểu diễn số của từ, nắm bắt quan hệ ngữ nghĩa)
- Image - Trực quan hóa dữ liệu ảnh
- Audio - Trực quan hóa dữ liệu âm thanh
- Text - Trực quan hóa dữ liệu văn bản (chuỗi)
Trong hướng dẫn này, bạn sẽ làm việc với các chế độ xem in đậm.
Hiểu lợi ích của việc trực quan hóa vô hướng
Trong phần này, trước tiên bạn sẽ hiểu vì sao trực quan hóa một số chỉ số (ví dụ loss hoặc accuracy) là hữu ích. Khi huấn luyện mạng nơ-ron sâu, một vấn đề quan trọng với người mới là thiếu hiểu biết về tác động của các lựa chọn thiết kế và siêu tham số khác nhau.
Ví dụ, nếu bất cẩn khởi tạo trọng số của mạng sâu với phương sai rất lớn giữa các trọng số, mô hình sẽ nhanh chóng phân kỳ và sụp đổ. Mặt khác, mọi thứ vẫn có thể sai ngay cả khi bạn khá thành thạo trong việc điều khiển mạng nơ-ron. Chẳng hạn, không chú ý đến learning rate có thể dẫn đến mô hình phân kỳ hoặc bão hòa quá sớm ở hiệu năng kém tối ưu.
Một cách để nhanh chóng phát hiện vấn đề với mô hình là có đồ thị trực quan thời gian thực về những gì đang diễn ra trong mô hình (ví dụ, mỗi 100 vòng lặp). Nếu mô hình hành xử kỳ lạ, điều đó sẽ hiện rõ. Đó chính là điều TensorBoard cung cấp. Bạn có thể quyết định những giá trị cần hiển thị và nó sẽ duy trì trực quan hóa thời gian thực các giá trị đó trong quá trình học.
Bạn bắt đầu bằng việc tạo một mạng nơ-ron năm lớp để phân loại ảnh chữ số viết tay. Bạn sẽ dùng bộ dữ liệu MNIST nổi tiếng. TensorFlow cung cấp API đơn giản để tải dữ liệu MNIST, nên bạn không cần tải thủ công. Trước đó, bạn định nghĩa một hàm đơn giản (accuracy()) để tính độ chính xác của các dự đoán so với nhãn thật.
def accuracy(predictions,labels):
'''
Accuracy of a given set of predictions of size (N x n_classes) and
labels of size (N x n_classes)
'''
return np.sum(np.argmax(predictions,axis=1)==np.argmax(labels,axis=1))*100.0/labels.shape[0]
Định nghĩa Input, Output, Trọng số và Độ lệch
Đầu tiên, xác định batch_size biểu thị lượng dữ liệu bạn lấy mẫu tại một bước tối ưu hóa/xác nhận hoặc kiểm thử. Sau đó bạn định nghĩa layer_ids, danh sách định danh cho mỗi lớp của mạng nơ-ron bạn sẽ xây dựng. Tiếp theo, bạn có thể định nghĩa layer_sizes.
Lưu ý len(layer_sizes) phải bằng len(layer_ids)+1, vì layer_sizes bao gồm kích thước đầu vào ở đầu.
MNIST có ảnh kích thước 28x28, sẽ là 784 khi trải phẳng về một chiều. Sau đó, bạn có thể định nghĩa các placeholder cho input và label, sẽ dùng để huấn luyện mô hình. Cuối cùng, bạn định nghĩa hai biến TensorFlow cho mỗi lớp (weights và bias).
Bạn có thể dùng variable scoping (thông tin thêm tại đây) để biến được đặt tên gọn gàng và dễ truy cập hơn về sau.
batch_size = 100
layer_ids = ['hidden1','hidden2','hidden3','hidden4','hidden5','out']
layer_sizes = [784, 500, 400, 300, 200, 100, 10]
tf.reset_default_graph()
# Inputs and Labels
train_inputs = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[0]], name='train_inputs')
train_labels = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[-1]], name='train_labels')
# Weight and Bias definitions
for idx, lid in enumerate(layer_ids):
with tf.variable_scope(lid):
w = tf.get_variable('weights',shape=[layer_sizes[idx], layer_sizes[idx+1]],
initializer=tf.truncated_normal_initializer(stddev=0.05))
b = tf.get_variable('bias',shape= [layer_sizes[idx+1]],
initializer=tf.random_uniform_initializer(-0.1,0.1))
Tính Logits, Dự đoán, Loss và Tối ưu
Với các placeholder input/output, trọng số và độ lệch cho mỗi lớp đã có, giờ bạn có thể định nghĩa phép tính để lấy logits của mạng nơ-ron. Logits là các giá trị chưa chuẩn hóa tạo ra ở lớp cuối. Khi chuẩn hóa, bạn gọi chúng là dự đoán. Việc này gồm lặp qua từng lớp trong mạng và tính tf.matmul(h,w) +b. Bạn cũng cần áp dụng hàm kích hoạt như tf.nn.relu(tf.matmul(h,w) +b) cho tất cả lớp trừ lớp cuối.
Tiếp theo, bạn định nghĩa hàm mất mát dùng để tối ưu mạng. Ở ví dụ này, bạn có thể dùng cross entropy, vốn thường cho kết quả tốt hơn mean squared error trong các bài toán phân loại.
Cuối cùng, bạn cần định nghĩa một bộ tối ưu nhận loss và cập nhật trọng số của mạng theo hướng giảm loss.
# Calculating Logits
h = train_inputs
for lid in layer_ids:
with tf.variable_scope(lid,reuse=True):
w, b = tf.get_variable('weights'), tf.get_variable('bias')
if lid != 'out':
h = tf.nn.relu(tf.matmul(h,w)+b,name=lid+'_output')
else:
h = tf.nn.xw_plus_b(h,w,b,name=lid+'_output')
tf_predictions = tf.nn.softmax(h, name='predictions')
# Calculating Loss
tf_loss = tf.reduce_mean(tf.nn.softmax_cross_entropy_with_logits_v2(labels=train_labels, logits=h),name='loss')
# Optimizer
tf_learning_rate = tf.placeholder(tf.float32, shape=None, name='learning_rate')
optimizer = tf.train.MomentumOptimizer(tf_learning_rate,momentum=0.9)
grads_and_vars = optimizer.compute_gradients(tf_loss)
tf_loss_minimize = optimizer.minimize(tf_loss)
Định nghĩa Summaries
Ở đây bạn có thể định nghĩa các đối tượng tf.summary. Đây là kiểu thực thể mà TensorBoard hiểu. Tức là bất cứ giá trị nào bạn muốn hiển thị, bạn nên đóng gói nó thành một đối tượng tf.summary.
Có nhiều loại summary khác nhau. Ở đây, vì bạn chỉ trực quan hóa vô hướng, bạn có thể định nghĩa các đối tượng tf.summary.scalar. Thêm nữa, bạn có thể dùng tf.name_scope để nhóm các scalar trên bảng. Tức là, các scalar có cùng name scope sẽ hiển thị trên cùng một hàng. Ở đây bạn định nghĩa ba summary khác nhau.
tf_loss_summary: bạn truyền giá trị qua placeholder bất cứ khi nào cần xuất lên bảngtf_accuracy_summary: bạn truyền giá trị qua placeholder bất cứ khi nào cần xuất lên bảngtf_gradnorm_summary: tính chuẩn l2 của gradient tại lớp cuối của mạng. Chuẩn gradient là chỉ báo tốt liệu trọng số được cập nhật đúng mực hay không. Gradient quá nhỏ có thể chỉ ra hiện tượng vanishing gradient hoặc gradient quá lớn có thể gợi ý hiện tượng exploding gradient.
# Name scope allows you to group various summaries together
# Summaries having the same name_scope will be displayed on the same row
with tf.name_scope('performance'):
# Summaries need to be displayed
# Whenever you need to record the loss, feed the mean loss to this placeholder
tf_loss_ph = tf.placeholder(tf.float32,shape=None,name='loss_summary')
# Create a scalar summary object for the loss so it can be displayed
tf_loss_summary = tf.summary.scalar('loss', tf_loss_ph)
# Whenever you need to record the loss, feed the mean test accuracy to this placeholder
tf_accuracy_ph = tf.placeholder(tf.float32,shape=None, name='accuracy_summary')
# Create a scalar summary object for the accuracy so it can be displayed
tf_accuracy_summary = tf.summary.scalar('accuracy', tf_accuracy_ph)
# Gradient norm summary
for g,v in grads_and_vars:
if 'hidden5' in v.name and 'weights' in v.name:
with tf.name_scope('gradients'):
tf_last_grad_norm = tf.sqrt(tf.reduce_mean(g**2))
tf_gradnorm_summary = tf.summary.scalar('grad_norm', tf_last_grad_norm)
break
# Merge all summaries together
performance_summaries = tf.summary.merge([tf_loss_summary,tf_accuracy_summary])
Thực thi mạng nơ-ron: Tải dữ liệu, Huấn luyện, Xác nhận và Kiểm thử
Trong đoạn mã dưới đây, bạn làm như sau. Đầu tiên, tạo một phiên làm việc (session), trong đó bạn thực thi các phép toán đã định nghĩa. Sau đó, tạo thư mục để lưu summary data. Tiếp theo, tạo một summary writer summ_writer. Bây giờ bạn có thể khởi tạo tất cả biến. Tiếp theo là tải bộ dữ liệu MNIST.
Rồi, với mỗi epoch và mỗi batch trong dữ liệu huấn luyện (tức là mỗi vòng lặp), thực thi gradnorm_summary nếu là vòng lặp đầu tiên và ghi gradnorm_summary vào event file bằng summary writer. Sau đó bạn thực thi tối ưu mô hình và tính loss. Sau khi đi hết tập huấn luyện cho một epoch, tính loss trung bình của epoch.
Bạn làm tương tự với tập xác nhận. Cụ thể, với mỗi batch trong dữ liệu xác nhận, bạn tính độ chính xác xác nhận. Sau đó tính độ chính xác trung bình cho toàn bộ tập xác nhận.
Cuối cùng, thực hiện giai đoạn kiểm thử. Trong đó, với mỗi batch trong dữ liệu kiểm thử, bạn tính độ chính xác kiểm thử cho từng batch. Từ đó, tính độ chính xác trung bình cho toàn bộ tập kiểm thử. Cuối cùng, bạn thực thi performance_summaries và ghi chúng vào event file bằng summary writer.
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25
config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure Tensorflow doesn't overflow the GPU
session = tf.InteractiveSession(config=config)
if not os.path.exists('summaries'):
os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','first')):
os.mkdir(os.path.join('summaries','first'))
summ_writer = tf.summary.FileWriter(os.path.join('summaries','first'), session.graph)
tf.global_variables_initializer().run()
accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)
for epoch in range(n_epochs):
loss_per_epoch = []
for i in range(n_train//batch_size):
# =================================== Training for one step ========================================
batch = mnist_data.train.next_batch(batch_size) # Get one batch of training data
if i == 0:
# Only for the first epoch, get the summary data
# Otherwise, it can clutter the visualization
l,_,gn_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary],
feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
train_labels: batch[1],
tf_learning_rate: 0.0001})
summ_writer.add_summary(gn_summ, epoch)
else:
# Optimize with training data
l,_ = session.run([tf_loss,tf_loss_minimize],
feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
train_labels: batch[1],
tf_learning_rate: 0.0001})
loss_per_epoch.append(l)
print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
avg_loss = np.mean(loss_per_epoch)
# ====================== Calculate the Validation Accuracy ==========================
valid_accuracy_per_epoch = []
for i in range(n_valid//batch_size):
valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
valid_batch_predictions = session.run(
tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))
mean_v_acc = np.mean(valid_accuracy_per_epoch)
print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))
# ===================== Calculate the Test Accuracy ===============================
accuracy_per_epoch = []
for i in range(n_test//batch_size):
test_images, test_labels = mnist_data.test.next_batch(batch_size)
test_batch_predictions = session.run(
tf_predictions,feed_dict={train_inputs: test_images.reshape(batch_size,image_size*image_size)}
)
accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))
print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
avg_test_accuracy = np.mean(accuracy_per_epoch)
# Execute the summaries defined above
summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})
# Write the obtained summaries to the file, so it can be displayed in the TensorBoard
summ_writer.add_summary(summ, epoch)
session.close()
Successfully downloaded train-images-idx3-ubyte.gz 9912422 bytes.
Extracting MNIST_data/train-images-idx3-ubyte.gz
Successfully downloaded train-labels-idx1-ubyte.gz 28881 bytes.
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Successfully downloaded t10k-images-idx3-ubyte.gz 1648877 bytes.
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Successfully downloaded t10k-labels-idx1-ubyte.gz 4542 bytes.
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 2.30252
Average Valid Accuracy in epoch 0: 10.02000
Average Test Accuracy in epoch 0: 9.76000
Average loss in epoch 1: 2.30016
Average Valid Accuracy in epoch 1: 12.56000
Average Test Accuracy in epoch 1: 12.64000
...
...
...
Average loss in epoch 24: 1.03386
Average Valid Accuracy in epoch 24: 71.88000
Average Test Accuracy in epoch 24: 71.23000
Trực quan hóa đồ thị tính toán
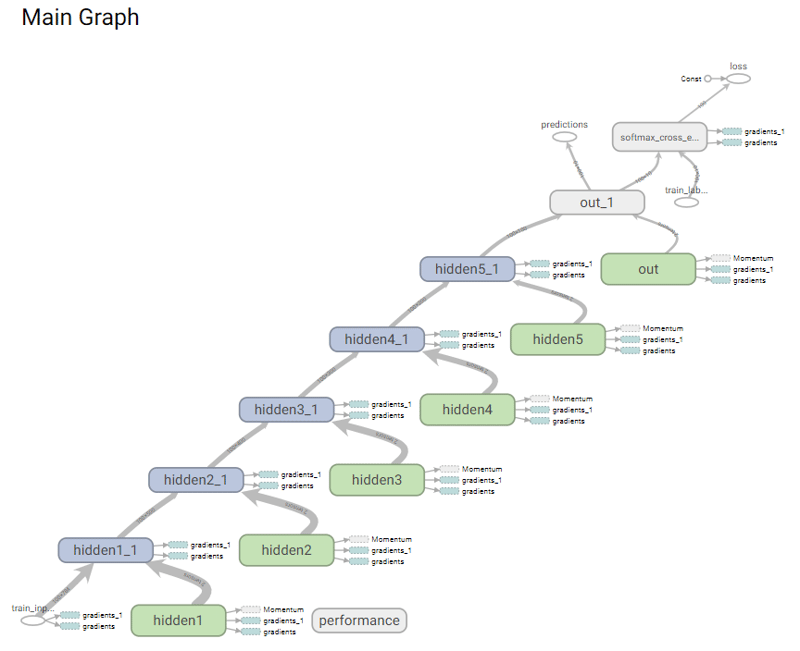
Trước tiên, bạn sẽ xem đồ thị tính toán của mô hình trông như thế nào. Bạn có thể truy cập chế độ xem này bằng cách nhấp vào Graphs trong TensorBoard. Nó sẽ giống hình dưới. Bạn có thể thấy luồng từ train_inputs tới loss và predictions đi qua các lớp ẩn 1 tới 5.
Trực quan hóa dữ liệu summary
Bài toán phân loại MNIST là một ví dụ đơn giản, và nó vẫn có thể được giải tốt mà không cần mạng 5 lớp. Với MNIST, không khó để đạt độ chính xác hơn 90% trong chưa đến 5 epoch.
Vậy chuyện gì đang xảy ra ở đây?
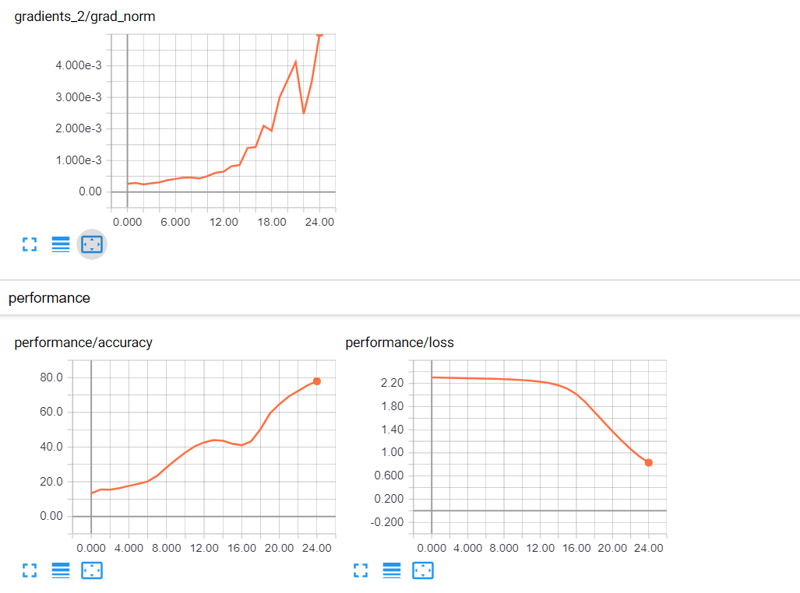
Hãy xem TensorBoard:
Quan sát và kết luận
Bạn có thể thấy độ chính xác đang tăng, nhưng rất chậm, và các cập nhật gradient đang tăng theo thời gian. Đây là hành vi kỳ lạ. Nếu đang tiến tới hội tụ, bạn nên thấy gradient giảm dần (tiến về 0), chứ không tăng. Nhưng vì độ chính xác vẫn tăng, bạn đang đi đúng hướng. Có lẽ bạn cần learning rate cao hơn.
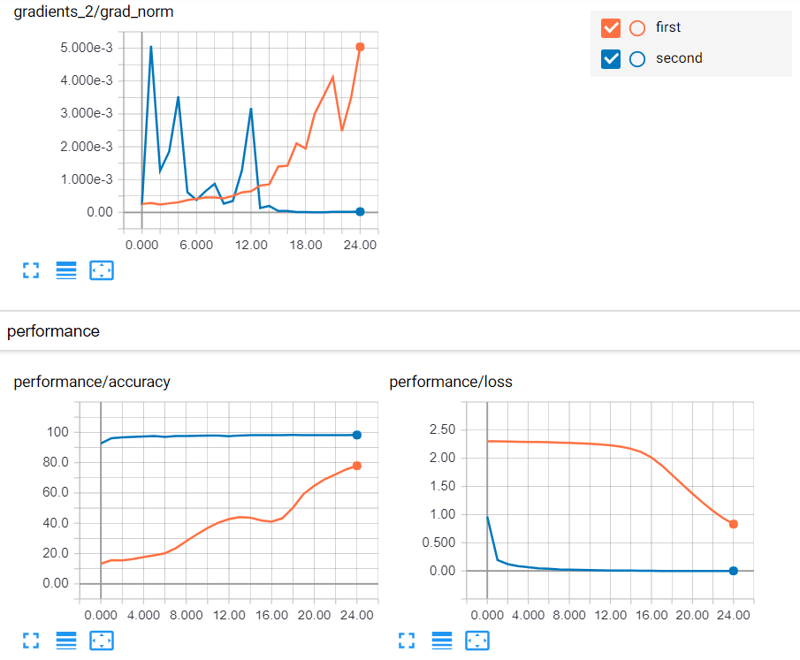
Giờ bạn có thể thử learning rate 0.01. Lần chạy này gần như giống hệt trước đó, ngoại trừ việc dùng 0.01 thay vì 0.0001. Thay tf_learning_rate: 0.0001 bằng tf_learning_rate: 0.01. Lưu ý có hai chỗ bạn cần thay tham số này.
Xem lại TensorBoard: Trông tốt hơn nhiều
Bây giờ bạn sẽ thấy độ chính xác bắt đầu gần 100 và tiếp tục tăng. Và bạn có thể thấy các cập nhật gradient cũng giảm dần theo thời gian và tiến về 0. Mọi thứ có vẻ ổn hơn nhiều với learning rate 0.01.
Tiếp theo, hãy đi xa hơn các vô hướng. Bạn sẽ xem cách phân tích các vector vô hướng và tập hợp vô hướng.
Vượt qua vô hướng: Trực quan hóa Histogram/Phân phối
Bạn đã thấy lợi ích của việc trực quan hóa các vô hướng bằng TensorBoard, cho phép bạn quan sát hành vi của mô hình và khắc phục các vấn đề tiềm ẩn. Hơn nữa, việc trực quan hóa đồ thị cho thấy có một liên kết liên tục từ input tới predictions, điều cần thiết cho tính toán gradient.
Bây giờ, bạn sẽ xem một chế độ xem hữu ích khác trong TensorBoard; histogram hoặc phân phối.
Hãy nhớ histogram là một tập các giá trị được biểu diễn bằng tần suất/mật độ mà giá trị đó xuất hiện trong tập. Bạn có thể dùng histogram để trực quan hóa giá trị trọng số mạng theo thời gian. Trực quan hóa trọng số mạng rất quan trọng, vì nếu trọng số nhảy loạn trong quá trình học, điều đó cho thấy có vấn đề với khởi tạo trọng số hoặc learning rate.
Bạn sẽ xem trọng số thay đổi trong ví dụ. Nếu nhìn vào mã, nó dùng truncated_normal_initializer() để khởi tạo trọng số.
Định nghĩa histogram summaries để trực quan hóa trọng số và độ lệch
Ở đây bạn lại định nghĩa các đối tượng tf.summary. Tuy nhiên, giờ bạn đang trực quan hóa các vector vô hướng nên cần định nghĩa các đối tượng tf.summary.histogram.
Trong trường hợp này, bạn định nghĩa hai đối tượng histogram (tf_w_hist và tf_b_hist) chứa trọng số và độ lệch của một lớp nhất định. Bạn sẽ định nghĩa các đối tượng histogram như vậy cho tất cả các lớp và mỗi lớp sẽ có name scope riêng.
Cuối cùng, bạn có thể dùng phép tf.summary.merge để tạo một phép gộp thực thi tất cả các summary này cùng lúc.
# Summaries need to be displayed
# Create a summary for each weight bias in each layer
all_summaries = []
for lid in layer_ids:
with tf.name_scope(lid+'_hist'):
with tf.variable_scope(lid,reuse=True):
w,b = tf.get_variable('weights'), tf.get_variable('bias')
# Create a scalar summary object for the loss so it can be displayed
tf_w_hist = tf.summary.histogram('weights_hist', tf.reshape(w,[-1]))
tf_b_hist = tf.summary.histogram('bias_hist', b)
all_summaries.extend([tf_w_hist, tf_b_hist])
# Merge all parameter histogram summaries together
tf_param_summaries = tf.summary.merge(all_summaries)
Thực thi mạng nơ-ron (với Histogram Summaries)
Bước này gần như giống hệt trước đó, nhưng tại đây bạn có vài dòng bổ sung để tính các histogram summaries (tf_param_summaries).
Lưu ý learning rate cũng đã thay đổi lần nữa.
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25
config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure Tensorflow doesn't overflow the GPU
session = tf.InteractiveSession(config=config)
if not os.path.exists('summaries'):
os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','third')):
os.mkdir(os.path.join('summaries','third'))
summ_writer_3 = tf.summary.FileWriter(os.path.join('summaries','third'), session.graph)
tf.global_variables_initializer().run()
accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)
for epoch in range(n_epochs):
loss_per_epoch = []
for i in range(n_train//batch_size):
# =================================== Training for one step ========================================
batch = mnist_data.train.next_batch(batch_size) # Get one batch of training data
if i == 0:
# Only for the first epoch, get the summary data
# Otherwise, it can clutter the visualization
l,_,gn_summ, wb_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary, tf_param_summaries],
feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
train_labels: batch[1],
tf_learning_rate: 0.00001})
summ_writer_3.add_summary(gn_summ, epoch)
summ_writer_3.add_summary(wb_summ, epoch)
else:
# Optimize with training data
l,_ = session.run([tf_loss,tf_loss_minimize],
feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
train_labels: batch[1],
tf_learning_rate: 0.01})
loss_per_epoch.append(l)
print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
avg_loss = np.mean(loss_per_epoch)
# ====================== Calculate the Validation Accuracy ==========================
valid_accuracy_per_epoch = []
for i in range(n_valid//batch_size):
valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
valid_batch_predictions = session.run(
tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))
mean_v_acc = np.mean(valid_accuracy_per_epoch)
print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))
# ===================== Calculate the Test Accuracy ===============================
accuracy_per_epoch = []
for i in range(n_test//batch_size):
test_images, test_labels = mnist_data.test.next_batch(batch_size)
test_batch_predictions = session.run(
tf_predictions,feed_dict={train_inputs: test_images.reshape(batch_size,image_size*image_size)}
)
accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))
print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
avg_test_accuracy = np.mean(accuracy_per_epoch)
# Execute the summaries defined above
summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})
# Write the obtained summaries to the file, so they can be displayed
summ_writer_3.add_summary(summ, epoch)
session.close()
Extracting MNIST_data/train-images-idx3-ubyte.gz
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 1.02625
Average Valid Accuracy in epoch 0: 92.76000
Average Test Accuracy in epoch 0: 92.65000
Average loss in epoch 1: 0.19110
Average Valid Accuracy in epoch 1: 95.80000
Average Test Accuracy in epoch 1: 95.48000
...
...
...
Average loss in epoch 24: 0.00009
Average Valid Accuracy in epoch 24: 98.28000
Average Test Accuracy in epoch 24: 98.09000
Trực quan hóa dữ liệu histogram của trọng số và độ lệch
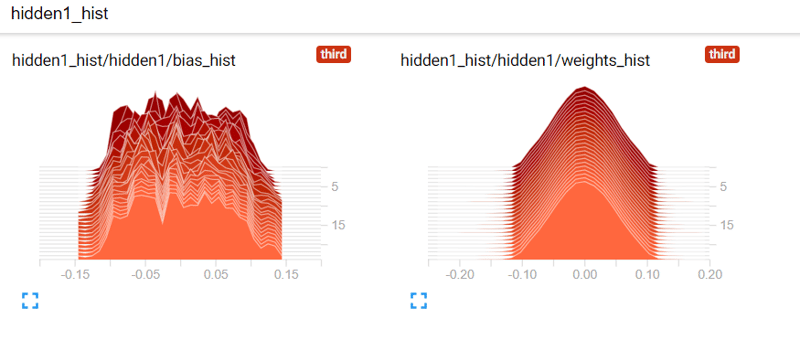
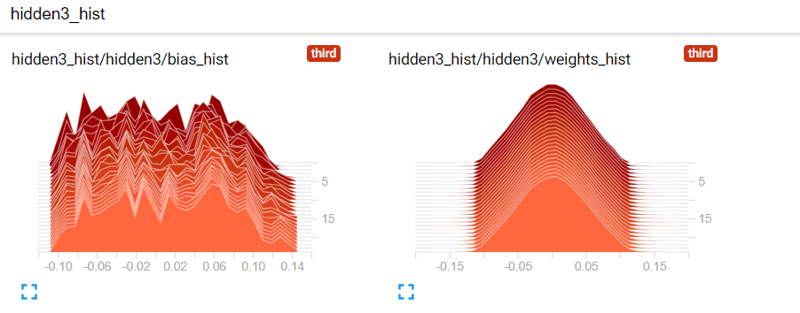
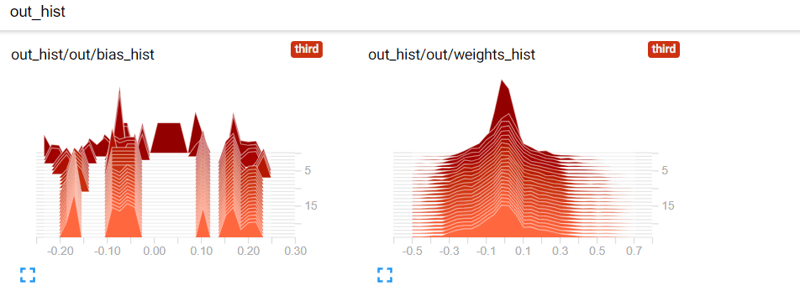
Đây là hình dạng trọng số và độ lệch của bạn. Trước hết, có 3 trục; thời gian (trục x), giá trị (trục y) và tần suất/mật độ giá trị (trục z). Histogram đậm hơn biểu thị dữ liệu cũ hơn và histogram nhạt hơn biểu thị dữ liệu mới hơn. Giá trị trục z cao hơn nghĩa là vector chứa nhiều giá trị gần giá trị cụ thể đó hơn.
Lưu ý: bạn cũng có chế độ xem "overlay" của các histogram theo thời gian. Bạn có thể đổi kiểu hiển thị ở bảng tùy chọn bên trái.
Ảnh hưởng của các phương pháp khởi tạo khác nhau
Giờ, thay vì dùng truncated_normal_initializer(), bạn sẽ dùng xavier_initializer() để khởi tạo trọng số. Khởi tạo Xavier là kỹ thuật tốt hơn nhiều, đặc biệt cho mạng sâu.
Bởi vì thay vì dùng độ lệch chuẩn do người dùng đặt (như khi dùng truncated_normal_initializer()), khởi tạo Xavier tự động quyết định độ lệch chuẩn dựa trên số kết nối vào/ra của một lớp. Điều này giúp gradient chảy từ trên xuống dưới mà không gặp vấn đề như vanishing gradient. Sau đó bạn định nghĩa lại mô hình.
Trước hết, bạn định nghĩa batch_size biểu thị lượng dữ liệu bạn lấy mẫu tại một bước tối ưu hóa/xác nhận hoặc kiểm thử. Sau đó bạn có thể định nghĩa layer_ids, danh sách định danh cho mỗi lớp của mạng nơ-ron bạn sẽ xây dựng.
Tiếp đó, bạn có thể định nghĩa layer_sizes. Lưu ý len(layer_sizes) phải bằng len(layer_ids)+1, vì layer_sizes bao gồm kích thước đầu vào ở đầu. MNIST có ảnh kích thước 28x28, sẽ là 784 khi trải phẳng về một chiều.
Tiếp theo, bạn định nghĩa placeholder cho input và label, sẽ dùng để huấn luyện mô hình. Cuối cùng, bạn định nghĩa hai biến TensorFlow cho mỗi lớp (weights và bias).
Lưu ý: Đoạn này giống hệt mã bạn dùng lần đầu, ngoại trừ kỹ thuật khởi tạo trọng số
batch_size = 100
layer_ids = ['hidden1','hidden2','hidden3','hidden4','hidden5','out']
layer_sizes = [784, 500, 400, 300, 200, 100, 10]
tf.reset_default_graph()
# Inputs and Labels
train_inputs = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[0]], name='train_inputs')
train_labels = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[-1]], name='train_labels')
# Weight and Bias definitions
for idx, lid in enumerate(layer_ids):
with tf.variable_scope(lid):
w = tf.get_variable('weights',shape=[layer_sizes[idx], layer_sizes[idx+1]],
initializer=tf.contrib.layers.xavier_initializer())
b = tf.get_variable('bias',shape= [layer_sizes[idx+1]],
initializer=tf.random_uniform_initializer(-0.1,0.1))
Tính Logits, Dự đoán, Loss và Tối ưu
Với các placeholder input/output, trọng số và độ lệch cho mỗi lớp đã có, giờ bạn có thể định nghĩa lại các phép tính để lấy logits của mạng nơ-ron.
Lưu ý: Phần này giống hệt mã bạn đã dùng lần đầu để định nghĩa các phép toán và tensor.
Định nghĩa Summaries
Ở đây bạn lại định nghĩa các đối tượng tf.summary. Phần này cũng giống hệt mã bạn dùng lần đầu để định nghĩa các phép toán và tensor.
Histogram Summaries: Trực quan hóa trọng số và độ lệch
Ở đây bạn lại định nghĩa các đối tượng tf.summary. Tuy nhiên, giờ bạn đang trực quan hóa các vector vô hướng nên cần định nghĩa các đối tượng tf.summary.histogram.
Lưu ý phần này giống hệt mã bạn đã dùng lần đầu để định nghĩa các phép toán và tensor.
Thực thi mạng nơ-ron
Lưu ý phần này giống với những gì bạn đã làm ở phần trước!
Chỉ có vài đoạn mã bạn cần thay đổi: ba chỗ os.path.join('summaries','third') thành os.path.join('summaries','fourth'), summ_writer_3 thành summ_writer_4 (xuất hiện 4 lần) và tf_learning_rate từ 0.00001 đổi thành 0.01.
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25
config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure TensorFlow doesn't overflow the GPU
session = tf.InteractiveSession(config=config)
if not os.path.exists('summaries'):
os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','fourth')):
os.mkdir(os.path.join('summaries','fourth'))
summ_writer_4 = tf.summary.FileWriter(os.path.join('summaries','fourth'), session.graph)
tf.global_variables_initializer().run()
accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)
for epoch in range(n_epochs):
loss_per_epoch = []
for i in range(n_train//batch_size):
# =================================== Training for one step ========================================
batch = mnist_data.train.next_batch(batch_size) # Get one batch of training data
if i == 0:
# Only for the first epoch, get the summary data
# Otherwise, it can clutter the visualization
l,_,gn_summ, wb_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary, tf_param_summaries],
feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
train_labels: batch[1],
tf_learning_rate: 0.01})
summ_writer_4.add_summary(gn_summ, epoch)
summ_writer_4.add_summary(wb_summ, epoch)
else:
# Optimize with training data
l,_ = session.run([tf_loss,tf_loss_minimize],
feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
train_labels: batch[1],
tf_learning_rate: 0.01})
loss_per_epoch.append(l)
print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
avg_loss = np.mean(loss_per_epoch)
# ====================== Calculate the Validation Accuracy ==========================
valid_accuracy_per_epoch = []
for i in range(n_valid//batch_size):
valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
valid_batch_predictions = session.run(
tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))
mean_v_acc = np.mean(valid_accuracy_per_epoch)
print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))
# ===================== Calculate the Test Accuracy ===============================
accuracy_per_epoch = []
for i in range(n_test//batch_size):
test_images, test_labels = mnist_data.test.next_batch(batch_size)
test_batch_predictions = session.run(
tf_predictions,feed_dict={train_inputs: test_images.reshape(batch_size,image_size*image_size)}
)
accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))
print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
avg_test_accuracy = np.mean(accuracy_per_epoch)
# Execute the summaries defined above
summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})
# Write the obtained summaries to the file, so they can be displayed
summ_writer_4.add_summary(summ, epoch)
session.close()
Extracting MNIST_data/train-images-idx3-ubyte.gz
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 0.43618
Average Valid Accuracy in epoch 0: 95.70000
Average Test Accuracy in epoch 0: 95.22000
Average loss in epoch 1: 0.12872
Average Valid Accuracy in epoch 1: 96.86000
Average Test Accuracy in epoch 1: 96.71000
...
...
...
Average loss in epoch 24: 0.00009
Average Valid Accuracy in epoch 24: 98.42000
Average Test Accuracy in epoch 24: 98.21000
Cách so sánh các kỹ thuật khởi tạo khác nhau
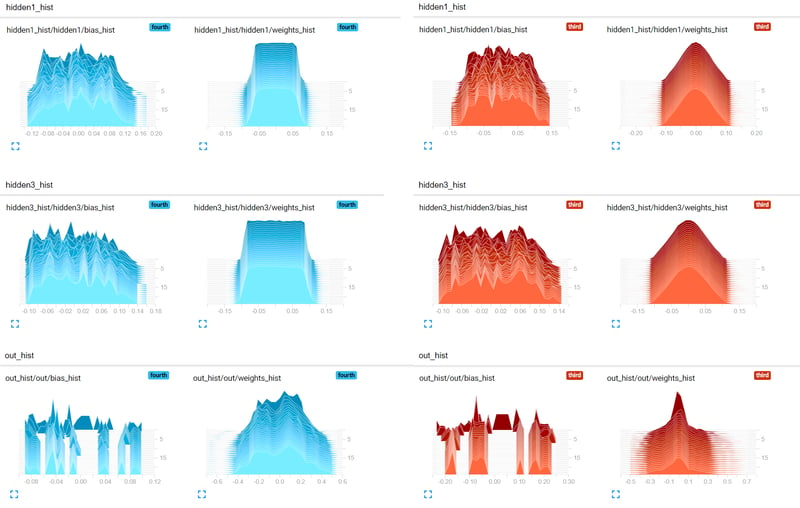
Ở đây bạn có thể so sánh cách trọng số tiến hóa theo thời gian với hai cách khởi tạo: truncated_normal_initializer (đỏ) và xavier_initializer (xanh). Bạn có thể thấy xavier_initializer giữ nhiều trọng số tránh xa 0 hơn so với khởi tạo thường, điều này tốt hơn. Điều này có thể giúp mạng được khởi tạo Xavier hội tụ nhanh hơn, thể hiện qua các đường cong loss/accuracy.
Chế độ xem phân phối của histogram
Bây giờ bạn có thể so sánh sự khác biệt giữa hai chế độ xem: histogram và distribution. Chế độ distribution về bản chất là một cách nhìn khác của histogram. Nếu nhìn hình dưới, bạn có thể thấy distribution là góc nhìn từ trên xuống của histogram. Lưu ý các đồ thị histogram được xoay để dễ thấy sự tương đồng.

Kết luận
Trong hướng dẫn này, bạn đã thấy cách dùng TensorBoard. Đầu tiên, bạn học cách khởi động dịch vụ qua command prompt (Windows) hoặc terminal (Ubuntu/Mac). Tiếp theo, bạn xem các chế độ xem dữ liệu khác nhau do TensorBoard cung cấp. Bạn sau đó xem mã để trực quan hóa các giá trị vô hướng (ví dụ loss/accuracy) và dùng mô hình mạng truyền thẳng để hiểu cụ thể việc trực quan hóa vô hướng.
Sau đó, bạn khám phá cách trực quan hóa tập hợp/vector các vô hướng bằng chế độ histogram. Tiếp theo là so sánh làm nổi bật khác biệt giữa các kỹ thuật khởi tạo trọng số của mạng bằng histogram.
Cuối cùng, bạn thảo luận sự tương đồng giữa chế độ distribution và histogram.
Nếu bạn muốn học thêm về deep learning, nhớ xem khóa học Deep Learning in Keras của chúng tôi.
Xem hướng dẫn Tối ưu siêu tham số trong các mô hình Machine Learning để tìm hiểu thêm về tham số và siêu tham số.
Nếu bạn muốn liên hệ với tôi, bạn có thể gửi email tới [email protected] hoặc kết nối qua LinkedIn.

