कोर्स
Understanding Machine Learning
2 घंटा
311.6K

यह ट्यूटोरियल आपको TensorBoard का उपयोग करना सिखाएगा, जो एक शानदार यूटिलिटी है जिससे आप डेटा और उसके व्यवहार को विज़ुअलाइज़ कर सकते हैं। आप देखेंगे कि न्यूरल नेटवर्क को ट्रेन करते समय आप इसे किन-किन उद्देश्यों के लिए इस्तेमाल कर सकते हैं।
टिप: DataCamp का Keras के साथ Deep Learning कोर्स यहाँ देखें।
शुरू करने से पहले, सुनिश्चित करें कि आप निम्नलिखित लाइब्रेरीज़ इम्पोर्ट कर लें ताकि कोड सफलतापूर्वक चले:
from pandas_datareader import data
import matplotlib.pyplot as plt
import pandas as pd
import datetime as dt
import urllib.request, json
import os
import numpy as np

# This code has been tested with TensorFlow 1.6
import tensorflow as tf
from tensorflow.examples.tutorials.mnist import input_data
TensorBoard के जरिए चीज़ों को विज़ुअलाइज़ करने के लिए, पहले उसकी सर्विस शुरू करनी होगी। इसके लिए,
python3 टाइप करें, आपको >>> जैसा प्रॉम्प्ट मिलेगाimport tensorflow as tf ट्राई करें>>>) से exit() टाइप कर बाहर आएँ और नीचे दिया कमांड टाइप करें
tensorboard --logdir=summaries--logdir वह डायरेक्टरी है जिसमें आप विज़ुअलाइज़ करने के लिए डेटा बनाएँगे--port=<port_you_like> का उपयोग कर सकते हैं ताकि TensorBoard जिस पोर्ट पर चलता है उसे बदला जा सकेTensorBoard 1.6.0 at <url>:6006 (Press CTRL+C to quit)नोट: TensorBoard एक ही डायरेक्टरी में कई इवेंट फ़ाइलें देखना पसंद नहीं करता। इससे डिस्प्ले पर बहुत बदसूरत कर्व्स मिल सकते हैं। इसलिए आपको प्रत्येक अलग उदाहरण के लिए अलग फ़ोल्डर बनाना चाहिए (उदाहरण के लिए, summaries/first, summaries/second, ...) ताकि डेटा सेव कर सकें। एक और बात ध्यान रखने की है कि यदि आप किसी प्रयोग को दोबारा चलाना चाहते हैं (यानी, पहले से भरे फ़ोल्डर में इवेंट फ़ाइल सेव करना), तो पहले मौजूदा इवेंट फ़ाइलों को हटा देना सुनिश्चित करें।
विभिन्न व्यू अलग-अलग प्रारूप के इनपुट लेते हैं और उन्हें अलग तरह से दिखाते हैं। आप इन्हें ऊपर नारंगी बार से बदल सकते हैं।
इस ट्यूटोरियल में, आप बोल्ड में दिखाए गए व्यूज़ को कवर करेंगे।
इस खंड में, आप पहले समझेंगे कि कुछ मेट्रिक्स (जैसे loss या accuracy) को विज़ुअलाइज़ करना क्यों लाभदायक है। डीप न्यूरल नेटवर्क को ट्रेन करते समय, शुरुआती लोगों के सामने एक महत्वपूर्ण समस्या यह होती है कि वे विभिन्न डिज़ाइन चॉइसेज़ और हाइपरपैरामीटर्स के प्रभावों को नहीं समझ पाते।
उदाहरण के लिए, यदि आप किसी डीप न्यूरल नेटवर्क के वेट्स को लापरवाही से इस तरह इनिशियलाइज़ कर देते हैं कि उनके बीच बहुत अधिक वैरिएंस हो, तो आपका मॉडल जल्दी ही डाइवर्ज होकर ध्वस्त हो सकता है। दूसरी ओर, जब आप न्यूरल नेटवर्क को काबू में रखने में सक्षम भी हों, तब भी चीज़ें गलत हो सकती हैं। उदाहरण के लिए, लर्निंग रेट पर ध्यान न देना मॉडल के डाइवर्ज होने या समय से पहले कमज़ोर प्रदर्शन पर सैचूरेट होने का कारण बन सकता है।
अपने मॉडल में समस्याओं का जल्दी पता लगाने का एक तरीका यह है कि आपके पास वास्तविक समय में (उदाहरण के लिए, हर 100 इटरेशन पर) मॉडल में क्या हो रहा है इसकी ग्राफिकल विज़ुअलाइज़ेशन हो। यदि आपका मॉडल अजीब तरह से व्यवहार कर रहा है, तो यह साफ़ दिखेगा। ठीक यही सुविधा TensorBoard देता है। आप तय कर सकते हैं कि किन मानों को दिखाया जाना है और यह सीखने के दौरान उन मानों का रियल-टाइम विज़ुअलाइज़ेशन बनाए रखेगा।
आप हाथ से लिखे अंकों की छवियों को वर्गीकृत करने के लिए पांच-लेयर वाला एक न्यूरल नेटवर्क बनाकर शुरू करेंगे। इसके लिए आप प्रसिद्ध MNIST डेटासेट का उपयोग करेंगे। TensorFlow MNIST डेटा लोड करने के लिए एक सरल API प्रदान करता है, इसलिए आपको इसे मैन्युअली डाउनलोड नहीं करना होगा। इससे पहले, आप एक सरल विधि (यानी, accuracy()) परिभाषित करेंगे, जो कुछ प्रेडिक्शंस की सटीकता को वास्तविक लेबल्स के सापेक्ष गणना करती है।
def accuracy(predictions,labels):
    '''
    Accuracy of a given set of predictions of size (N x n_classes) and
    labels of size (N x n_classes)
    '''
    return np.sum(np.argmax(predictions,axis=1)==np.argmax(labels,axis=1))*100.0/labels.shape[0]
सबसे पहले, batch_size परिभाषित करें जो किसी एक ऑप्टिमाइज़ेशन/वैलिडेशन या टेस्टिंग स्टेप पर सैंपल किए गए डेटा की मात्रा दर्शाता है। फिर आप layer_ids परिभाषित करते हैं, जो उस न्यूरल नेटवर्क की प्रत्येक लेयर के लिए एक आइडेंटिफ़ायर देता है जिसे आप परिभाषित करेंगे। इसके बाद आप layer_sizes परिभाषित कर सकते हैं।
ध्यान दें कि len(layer_sizes) को len(layer_ids)+1 होना चाहिए, क्योंकि layer_sizes की शुरुआत में इनपुट का आकार भी शामिल है।
MNIST में 28x28 आकार की छवियाँ होती हैं, जो एक-आयामी में अनरैप करने पर 784 हो जाती हैं। इसके बाद आप इनपुट और लेबल placeholders परिभाषित कर सकते हैं, जिन्हें आप बाद में मॉडल ट्रेन करने के लिए उपयोग करेंगे। अंत में, आप प्रत्येक लेयर के लिए दो TensorFlow वेरिएबल्स परिभाषित करते हैं (यानी, weights और bias)।
आप वेरिएबल स्कोपिंग का उपयोग कर सकते हैं (अधिक जानकारी यहाँ) ताकि वेरिएबल्स अच्छे से नामित हों और बाद में उन तक पहुँचना आसान हो।
batch_size = 100
layer_ids = ['hidden1','hidden2','hidden3','hidden4','hidden5','out']
layer_sizes = [784, 500, 400, 300, 200, 100, 10]

tf.reset_default_graph()

# Inputs and Labels
train_inputs = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[0]], name='train_inputs')
train_labels = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[-1]], name='train_labels')

# Weight and Bias definitions
for idx, lid in enumerate(layer_ids):

    with tf.variable_scope(lid):
        w = tf.get_variable('weights',shape=[layer_sizes[idx], layer_sizes[idx+1]],
                            initializer=tf.truncated_normal_initializer(stddev=0.05))
        b = tf.get_variable('bias',shape= [layer_sizes[idx+1]],
                            initializer=tf.random_uniform_initializer(-0.1,0.1))
इनपुट/आउटपुट placeholders, प्रत्येक लेयर के वेट्स और बायस परिभाषित होने के बाद, अब आप न्यूरल नेटवर्क के logits निकालने के लिए गणनाएँ परिभाषित कर सकते हैं। Logits न्यूरल नेटवर्क की आख़िरी लेयर में उत्पन्न अननॉर्मलाइज़्ड मान होते हैं। नॉर्मलाइज़ करने पर इन्हें predictions कहा जाता है। इसमें न्यूरल नेटवर्क की हर लेयर से गुजरते हुए tf.matmul(h,w) +b की गणना करनी होती है। आपको आख़िरी लेयर को छोड़कर सभी लेयर्स के लिए tf.nn.relu(tf.matmul(h,w) +b) जैसी एक activation फ़ंक्शन भी लगानी होगी।
अगले चरण में, आप वह loss फ़ंक्शन परिभाषित करते हैं जिसका उपयोग न्यूरल नेटवर्क को ऑप्टिमाइज़ करने के लिए किया जाता है। इस उदाहरण में, आप cross entropy loss का उपयोग कर सकते हैं, जो अक्सर वर्गीकरण समस्याओं में mean squared error से बेहतर परिणाम देता है।
अंत में, आपको एक optimizer परिभाषित करना होगा जो loss को लेता है और वेट्स को उस दिशा में अपडेट करता है जिससे loss कम से कम हो।
# Calculating Logits
h = train_inputs
for lid in layer_ids:
    with tf.variable_scope(lid,reuse=True):
        w, b = tf.get_variable('weights'), tf.get_variable('bias')
        if lid != 'out':
          h = tf.nn.relu(tf.matmul(h,w)+b,name=lid+'_output')
        else:
          h = tf.nn.xw_plus_b(h,w,b,name=lid+'_output')

tf_predictions = tf.nn.softmax(h, name='predictions')
# Calculating Loss
tf_loss = tf.reduce_mean(tf.nn.softmax_cross_entropy_with_logits_v2(labels=train_labels, logits=h),name='loss')

# Optimizer
tf_learning_rate = tf.placeholder(tf.float32, shape=None, name='learning_rate')
optimizer = tf.train.MomentumOptimizer(tf_learning_rate,momentum=0.9)
grads_and_vars = optimizer.compute_gradients(tf_loss)
tf_loss_minimize = optimizer.minimize(tf_loss)
यहाँ आप tf.summary ऑब्जेक्ट्स परिभाषित कर सकते हैं। ये ऑब्जेक्ट्स TensorBoard द्वारा समझे जाने वाले एंटिटीज़ हैं। यानी, जो भी मान आप दिखाना चाहते हैं, उन्हें tf.summary ऑब्जेक्ट के रूप में एनकैप्सुलेट करना चाहिए।
Summaries के कई प्रकार होते हैं। यहाँ, चूँकि आप केवल स्केलर्स को विज़ुअलाइज़ कर रहे हैं, आप tf.summary.scalar ऑब्जेक्ट्स परिभाषित कर सकते हैं। इसके अतिरिक्त, आप tf.name_scope का उपयोग करके बोर्ड पर स्केलर्स को समूहित कर सकते हैं। यानी, जिन स्केलर्स का नाम-स्कोप समान होगा, वे एक ही पंक्ति में दिखेंगे। यहाँ आप तीन अलग-अलग summaries परिभाषित करते हैं।
tf_loss_summary : जब भी आपको इसे बोर्ड पर प्रकाशित करना हो, आप placeholder के माध्यम से एक मान फ़ीड करते हैंtf_accuracy_summary : जब भी आपको इसे बोर्ड पर प्रकाशित करना हो, आप placeholder के माध्यम से एक मान फ़ीड करते हैंtf_gradnorm_summary : यह आपके न्यूरल नेटवर्क की आख़िरी लेयर के ग्रेडिएंट्स का l2 नॉर्म निकालता है। ग्रेडिएंट नॉर्म एक अच्छा संकेतक है कि न्यूरल नेटवर्क के वेट्स ठीक से अपडेट हो रहे हैं या नहीं। बहुत छोटा ग्रेडिएंट नॉर्म vanishing gradient का संकेत दे सकता है या बहुत बड़ा ग्रेडिएंट exploding gradient की ओर इशारा कर सकता है।# Name scope allows you to group various summaries together
# Summaries having the same name_scope will be displayed on the same row
with tf.name_scope('performance'):
# Summaries need to be displayed
# Whenever you need to record the loss, feed the mean loss to this placeholder
tf_loss_ph = tf.placeholder(tf.float32,shape=None,name='loss_summary')
# Create a scalar summary object for the loss so it can be displayed
tf_loss_summary = tf.summary.scalar('loss', tf_loss_ph)
# Whenever you need to record the loss, feed the mean test accuracy to this placeholder
tf_accuracy_ph = tf.placeholder(tf.float32,shape=None, name='accuracy_summary')
# Create a scalar summary object for the accuracy so it can be displayed
tf_accuracy_summary = tf.summary.scalar('accuracy', tf_accuracy_ph)
# Gradient norm summary
for g,v in grads_and_vars:
if 'hidden5' in v.name and 'weights' in v.name:
with tf.name_scope('gradients'):
tf_last_grad_norm = tf.sqrt(tf.reduce_mean(g**2))
tf_gradnorm_summary = tf.summary.scalar('grad_norm', tf_last_grad_norm)
break
# Merge all summaries together
performance_summaries = tf.summary.merge([tf_loss_summary,tf_accuracy_summary])
नीचे दिए गए कोड में आप यह सब करते हैं। पहले, आप एक सत्र (session) बनाते हैं, जिसमें आप ऊपर परिभाषित ऑपरेशंस चलाते हैं। फिर, आप summary डेटा सेव करने के लिए एक फ़ोल्डर बनाते हैं। इसके बाद, आप एक summary writer summ_writer बनाते हैं। अब आप सभी वेरिएबल्स इनिशियलाइज़ कर सकते हैं। इसके बाद MNIST डेटासेट लोड किया जाएगा।
फिर, प्रत्येक epoch और प्रशिक्षण डेटा के प्रत्येक बैच (यानी, प्रत्येक इटरेशन) के लिए, यदि यह पहला इटरेशन है तो gradnorm_summary चलाएँ और summary writer के साथ gradnorm_summary को इवेंट फ़ाइल में लिखें। अब आप मॉडल ऑप्टिमाइज़ेशन और loss की गणना करते हैं। एक सिंगल epoch के लिए पूरे प्रशिक्षण डेटासेट से गुजरने के बाद, औसत training loss निकालें।
आप validation डेटासेट के लिए भी इसी तरह की प्रक्रिया अपनाते हैं। विशेष रूप से, validation डेटा के प्रत्येक बैच के लिए, आप validation accuracy की गणना करते हैं। उसके बाद, पूरे validation सेट के लिए औसत validation accuracy निकालें।
अंत में, testing चरण चलता है। इसमें, टेस्ट डेटा के प्रत्येक बैच के लिए, आप उस बैच की test accuracy निकालते हैं। इसके साथ, पूरे टेस्ट सेट के लिए औसत test accuracy निकालें। बिलकुल अंत में आप performance_summaries चलाते हैं और summary writer के साथ उन्हें इवेंट फ़ाइल में लिखते हैं।
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25

config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure Tensorflow doesn't overflow the GPU

session = tf.InteractiveSession(config=config)

if not os.path.exists('summaries'):
    os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','first')):
    os.mkdir(os.path.join('summaries','first'))

summ_writer = tf.summary.FileWriter(os.path.join('summaries','first'), session.graph)

tf.global_variables_initializer().run()

accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)


for epoch in range(n_epochs):
    loss_per_epoch = []
    for i in range(n_train//batch_size):

        # =================================== Training for one step ========================================
        batch = mnist_data.train.next_batch(batch_size)    # Get one batch of training data
        if i == 0:
            # Only for the first epoch, get the summary data
            # Otherwise, it can clutter the visualization
            l,_,gn_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary],
                                      feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                                 train_labels: batch[1],
                                                tf_learning_rate: 0.0001})
            summ_writer.add_summary(gn_summ, epoch)
        else:
            # Optimize with training data
            l,_ = session.run([tf_loss,tf_loss_minimize],
                              feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                         train_labels: batch[1],
                                         tf_learning_rate: 0.0001})
        loss_per_epoch.append(l)

    print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
    avg_loss = np.mean(loss_per_epoch)

    # ====================== Calculate the Validation Accuracy ==========================
    valid_accuracy_per_epoch = []
    for i in range(n_valid//batch_size):
        valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
        valid_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
        valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))

    mean_v_acc = np.mean(valid_accuracy_per_epoch)
    print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))

    # ===================== Calculate the Test Accuracy ===============================
    accuracy_per_epoch = []
    for i in range(n_test//batch_size):
        test_images, test_labels = mnist_data.test.next_batch(batch_size)
        test_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: test_images.reshape(batch_size,image_size*image_size)}
        )
        accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))

    print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
    avg_test_accuracy = np.mean(accuracy_per_epoch)

    # Execute the summaries defined above
    summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})

    # Write the obtained summaries to the file, so it can be displayed in the TensorBoard
    summ_writer.add_summary(summ, epoch)

session.close()
Successfully downloaded train-images-idx3-ubyte.gz 9912422 bytes.
Extracting MNIST_data/train-images-idx3-ubyte.gz
Successfully downloaded train-labels-idx1-ubyte.gz 28881 bytes.
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Successfully downloaded t10k-images-idx3-ubyte.gz 1648877 bytes.
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Successfully downloaded t10k-labels-idx1-ubyte.gz 4542 bytes.
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 2.30252
    Average Valid Accuracy in epoch 0: 10.02000
    Average Test Accuracy in epoch 0: 9.76000

Average loss in epoch 1: 2.30016
    Average Valid Accuracy in epoch 1: 12.56000
    Average Test Accuracy in epoch 1: 12.64000

  ...
  ...
  ...

Average loss in epoch 24: 1.03386
    Average Valid Accuracy in epoch 24: 71.88000
    Average Test Accuracy in epoch 24: 71.23000
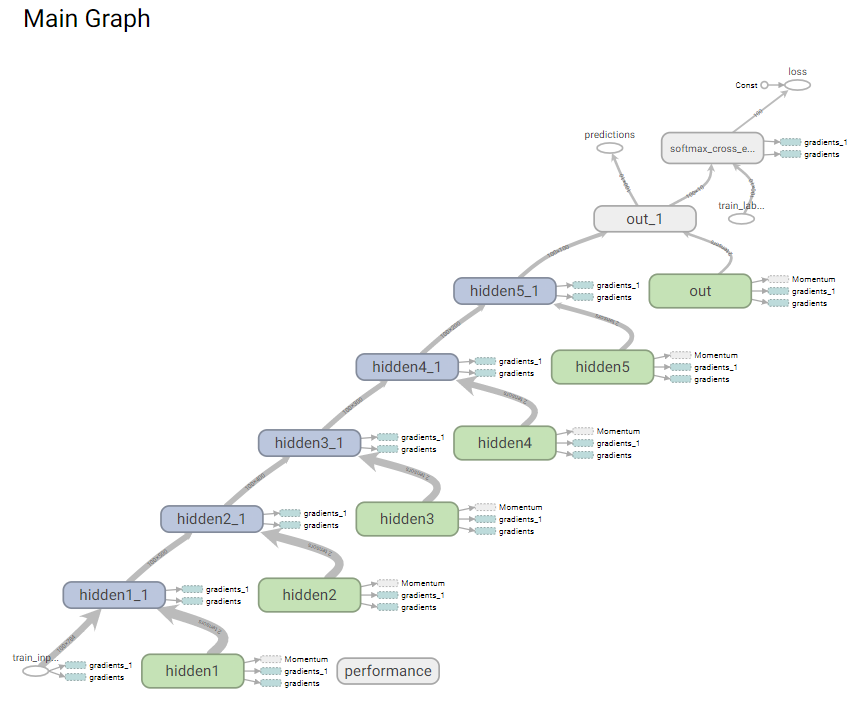
सबसे पहले, आप देखेंगे कि आपके मॉडल का कम्प्यूटेशनल ग्राफ़ कैसा दिखता है। आप TensorBoard में Graphs व्यू पर क्लिक करके इस व्यू तक पहुँच सकते हैं। यह नीचे दी गई छवि जैसा दिखना चाहिए। आप देख सकते हैं कि train_inputs से loss और predictions तक एक अच्छा फ्लो है, जो hidden layers 1 से 5 के माध्यम से जाता है।
MNIST वर्गीकरण सबसे सरल उदाहरणों में से एक है, और फिर भी इसे 5-लेयर वाले न्यूरल नेटवर्क से हल नहीं किया जा सका। MNIST के लिए, 5 से कम epochs में 90% से अधिक सटीकता पाना मुश्किल नहीं है।
तो यहाँ क्या हो रहा है?
आइए TensorBoard पर नज़र डालते हैं:
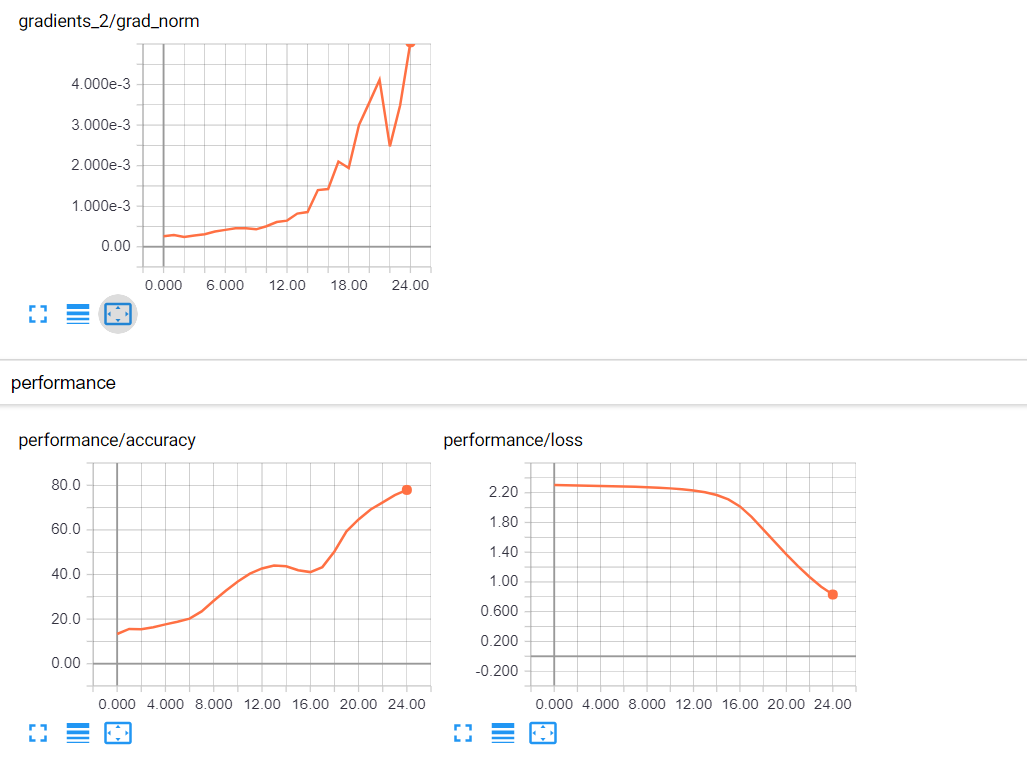
आप देख सकते हैं कि सटीकता बढ़ रही है, लेकिन बहुत धीरे-धीरे, और ग्रेडिएंट अपडेट्स समय के साथ बढ़ रहे हैं। यह एक अजीब व्यवहार है। यदि आप कन्वर्जेन्स की ओर बढ़ रहे हैं, तो आपको ग्रेडिएंट्स घटते हुए (शून्य की ओर जाते हुए) दिखने चाहिए, न कि बढ़ते हुए। लेकिन चूँकि सटीकता बढ़ रही है, आप सही दिशा में हैं। संभवतः आपको अधिक लर्निंग रेट की ज़रूरत है।
अब आप 0.01 का लर्निंग रेट आज़मा सकते हैं। यह न्यूरल नेटवर्क के पिछले रन के लगभग समान है, सिवाय इसके कि आप 0.0001 की जगह 0.01 का उपयोग करेंगे। tf_learning_rate: 0.0001 की जगह tf_learning_rate: 0.01 का उपयोग करें। ध्यान रखें कि आपको तर्क को दो स्थानों पर बदलना होगा।
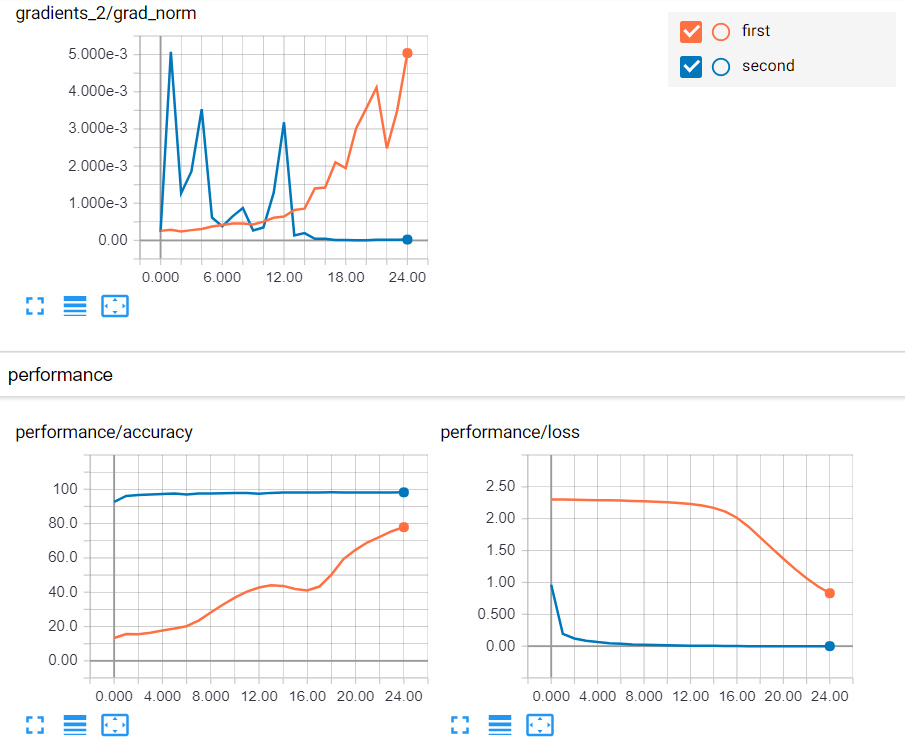
अब आप देख सकते हैं कि सटीकता 100 के क़रीब से शुरू होकर आगे बढ़ रही है। और आप देख सकते हैं कि ग्रेडिएंट अपडेट्स भी समय के साथ घट रहे हैं और शून्य के क़रीब जा रहे हैं। 0.01 के लर्निंग रेट के साथ चीज़ें काफी बेहतर लग रही हैं।
अगला, आइए स्केलर्स से आगे बढ़ते हैं। आप देखेंगे कि स्केलर्स के वेक्टर और स्केलर्स के संग्रह का विश्लेषण कैसे किया जा सकता है।
आपने TensorBoard के जरिए स्केलर्स को विज़ुअलाइज़ करने का लाभ देखा, जिससे आप मॉडल के व्यवहार को देख सके और किसी भी संभावित समस्या को ठीक कर सके। इसके अलावा, ग्राफ़ को विज़ुअलाइज़ करने से यह भी दिखा कि इनपुट से प्रेडिक्शंस तक एक बिना रुका हुआ लिंक है, जो ग्रेडिएंट गणनाओं के लिए आवश्यक है।
अब, आप TensorBoard में एक और उपयोगी व्यू देखने जा रहे हैं; हिस्टोग्राम या डिस्ट्रीब्यूशन्स।
याद रखें कि एक हिस्टोग्राम मानों का ऐसा संग्रह है जिसे उस फ़्रीक्वेंसी/डेंसिटी के माध्यम से दर्शाया जाता है जो किसी मान की उस संग्रह में होती है। आप समय के साथ नेटवर्क वेट मानों को विज़ुअलाइज़ करने के लिए हिस्टोग्राम का उपयोग कर सकते हैं। नेटवर्क वेट्स को विज़ुअलाइज़ करना महत्वपूर्ण है, क्योंकि यदि सीखने के दौरान वेट्स इधर-उधर बेतरतीब ढंग से उछल रहे हैं, तो यह दर्शाता है कि वेट इनिशियलाइज़ेशन या लर्निंग रेट में कुछ गड़बड़ी है।
आप उदाहरण में देखेंगे कि वेट्स कैसे बदलते हैं। यदि आप कोड देखें, तो यह वेट्स को इनिशियलाइज़ करने के लिए truncated_normal_initializer() का उपयोग करता है।
यहाँ आप फिर से tf.summary ऑब्जेक्ट्स परिभाषित करते हैं। हालाँकि, अब आप स्केलर्स के वेक्टर को विज़ुअलाइज़ कर रहे हैं, इसलिए आपको tf.summary.histogram ऑब्जेक्ट्स परिभाषित करने की आवश्यकता है।
इस मामले में, आप दो हिस्टोग्राम ऑब्जेक्ट्स परिभाषित करते हैं (यानी, tf_w_hist और tf_b_hist) जो दी गई लेयर के वेट्स और बायस को शामिल करते हैं। आप सभी लेयर्स के लिए ऐसे हिस्टोग्राम ऑब्जेक्ट्स परिभाषित करेंगे और प्रत्येक लेयर का अपना नाम-स्कोप होगा।
अंत में, आप tf.summary.merge ऑपरेशन का उपयोग करके एक ग्रुप्ड ऑपरेशन बना सकते हैं जो एक साथ ये सारी summaries चलाता है।
# Summaries need to be displayed
# Create a summary for each weight bias in each layer
all_summaries = []
for lid in layer_ids:
    with tf.name_scope(lid+'_hist'):
        with tf.variable_scope(lid,reuse=True):
            w,b = tf.get_variable('weights'), tf.get_variable('bias')

            # Create a scalar summary object for the loss so it can be displayed
            tf_w_hist = tf.summary.histogram('weights_hist', tf.reshape(w,[-1]))
            tf_b_hist = tf.summary.histogram('bias_hist', b)
            all_summaries.extend([tf_w_hist, tf_b_hist])

# Merge all parameter histogram summaries together
tf_param_summaries = tf.summary.merge(all_summaries)
यह चरण लगभग वैसा ही है जैसा आपने पहले किया था, लेकिन यहाँ आपके पास हिस्टोग्राम summaries (यानी, tf_param_summaries) को कंप्यूट करने के लिए कुछ अतिरिक्त पंक्तियाँ हैं।
नोट करें कि लर्निंग रेट्स भी फिर से बदले गए हैं।
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25

config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure Tensorflow doesn't overflow the GPU

session = tf.InteractiveSession(config=config)

if not os.path.exists('summaries'):
    os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','third')):
    os.mkdir(os.path.join('summaries','third'))

summ_writer_3 = tf.summary.FileWriter(os.path.join('summaries','third'), session.graph)

tf.global_variables_initializer().run()

accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)


for epoch in range(n_epochs):
    loss_per_epoch = []
    for i in range(n_train//batch_size):

        # =================================== Training for one step ========================================
        batch = mnist_data.train.next_batch(batch_size)    # Get one batch of training data
        if i == 0:
            # Only for the first epoch, get the summary data
            # Otherwise, it can clutter the visualization
            l,_,gn_summ, wb_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary, tf_param_summaries],
                                      feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                                 train_labels: batch[1],
                                                tf_learning_rate: 0.00001})
            summ_writer_3.add_summary(gn_summ, epoch)
            summ_writer_3.add_summary(wb_summ, epoch)
        else:
            # Optimize with training data
            l,_ = session.run([tf_loss,tf_loss_minimize],
                              feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                         train_labels: batch[1],
                                         tf_learning_rate: 0.01})
        loss_per_epoch.append(l)

    print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
    avg_loss = np.mean(loss_per_epoch)

    # ====================== Calculate the Validation Accuracy ==========================
    valid_accuracy_per_epoch = []
    for i in range(n_valid//batch_size):
        valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
        valid_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
        valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))

    mean_v_acc = np.mean(valid_accuracy_per_epoch)
    print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))

    # ===================== Calculate the Test Accuracy ===============================
    accuracy_per_epoch = []
    for i in range(n_test//batch_size):
        test_images, test_labels = mnist_data.test.next_batch(batch_size)
        test_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: test_images.reshape(batch_size,image_size*image_size)}
        )
        accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))

    print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
    avg_test_accuracy = np.mean(accuracy_per_epoch)

    # Execute the summaries defined above
    summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})

    # Write the obtained summaries to the file, so they can be displayed
    summ_writer_3.add_summary(summ, epoch)

session.close()
Extracting MNIST_data/train-images-idx3-ubyte.gz
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 1.02625
    Average Valid Accuracy in epoch 0: 92.76000
    Average Test Accuracy in epoch 0: 92.65000

Average loss in epoch 1: 0.19110
    Average Valid Accuracy in epoch 1: 95.80000
    Average Test Accuracy in epoch 1: 95.48000

  ...
  ...
  ...

Average loss in epoch 24: 0.00009
    Average Valid Accuracy in epoch 24: 98.28000
    Average Test Accuracy in epoch 24: 98.09000
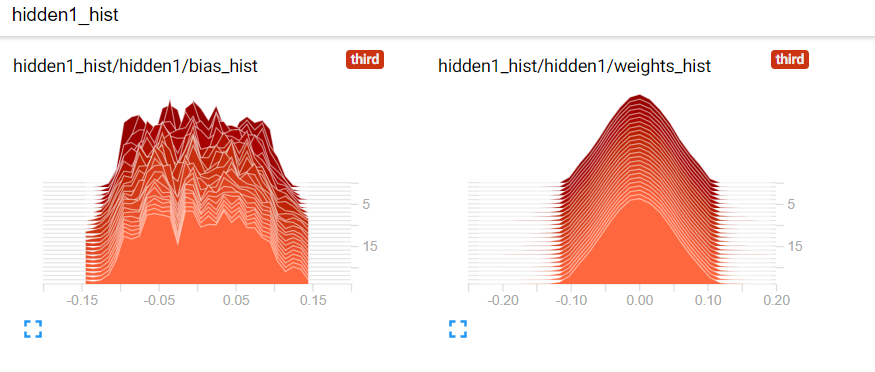
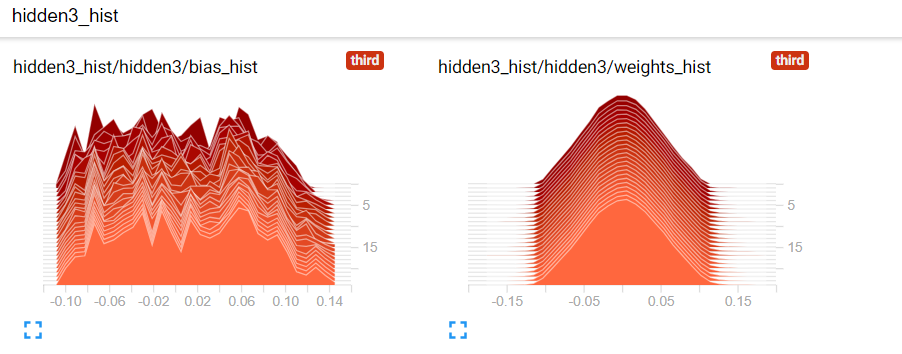
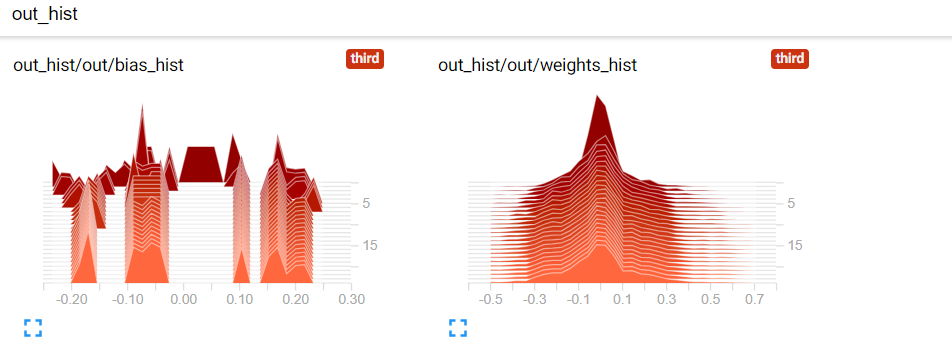
आपके वेट्स और बायसेज़ कुछ इस तरह दिखते हैं। सबसे पहले, आपके पास 3 अक्ष हैं; समय (x-अक्ष), मान (y-अक्ष) और मानों की आवृत्ति/घनत्व (z-अक्ष)। गहरे रंग के हिस्टोग्राम पुराने डेटा को दर्शाते हैं और हल्के रंग के हिस्टोग्राम नए डेटा को। z-अक्ष पर अधिक मान का मतलब है कि उस विशिष्ट मान के आसपास वेक्टर में अधिक मान मौजूद हैं।
टिप्पणी: आपके पास समय के साथ हिस्टोग्राम का एक "ओवरले" व्यू भी है। आप बाएँ तरफ के विकल्प पैनल में डिस्प्ले के प्रकार को बदल सकते हैं।
अब, truncated_normal_initializer() का उपयोग करने के बजाय, आप वेट्स को प्रारंभ करने के लिए xavier_initializer() का उपयोग करेंगे। Xavier इनिशियलाइज़ेशन एक कहीं बेहतर तकनीक है, खासकर डीप न्यूरल नेटवर्क्स के लिए।
ऐसा इसलिए क्योंकि उपयोगकर्ता-परिभाषित मानक विचलन का उपयोग करने के बजाय (जैसा कि आपने truncated_normal_initializer() के साथ किया था), Xavier इनिशियलाइज़ेशन किसी लेयर के इनपुट और आउटपुट कनेक्शनों की संख्या के आधार पर मानक विचलन स्वतः तय करता है। यह ग्रेडिएंट्स को ऊपर से नीचे तक बिना vanishing gradient जैसी समस्याओं के प्रवाहित होने में मदद करता है। इसके बाद, आप मॉडल को फिर से परिभाषित करेंगे।
सबसे पहले, आप एक batch_size परिभाषित करते हैं, जो एकल ऑप्टिमाइज़ेशन/वैलिडेशन या टेस्टिंग स्टेप पर सैंपल किए गए डेटा की मात्रा बताता है। इसके बाद, आप layer_ids परिभाषित कर सकते हैं, जो उस न्यूरल नेटवर्क की प्रत्येक लेयर के लिए पहचानकर्ता देता है जिसे आप परिभाषित करेंगे।
फिर, आप layer_sizes परिभाषित कर सकते हैं। ध्यान दें कि len(layer_sizes) को len(layer_ids)+1 होना चाहिए, क्योंकि layer_sizes की शुरुआत में इनपुट का आकार शामिल होता है। MNIST में 28x28 आकार की छवियाँ होती हैं, जो एकल आयाम में खोलने पर 784 हो जाएंगी।
इसके बाद, आप इनपुट और लेबल placeholders परिभाषित कर सकते हैं, जिन्हें आप बाद में मॉडल को ट्रेन करने के लिए उपयोग करेंगे। अंततः, आप प्रत्येक लेयर के लिए दो TensorFlow वेरिएबल्स परिभाषित करते हैं (weights और bias)।
टिप्पणी: यह उसी कोड के समान है जिसे आपने पहली बार उपयोग किया था, अंतर केवल वेट्स के लिए इस्तेमाल की गई इनिशियलाइज़ेशन तकनीक का है
batch_size = 100
layer_ids = ['hidden1','hidden2','hidden3','hidden4','hidden5','out']
layer_sizes = [784, 500, 400, 300, 200, 100, 10]

tf.reset_default_graph()

# Inputs and Labels
train_inputs = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[0]], name='train_inputs')
train_labels = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[-1]], name='train_labels')

# Weight and Bias definitions
for idx, lid in enumerate(layer_ids):

    with tf.variable_scope(lid):
        w = tf.get_variable('weights',shape=[layer_sizes[idx], layer_sizes[idx+1]],
                            initializer=tf.contrib.layers.xavier_initializer())
        b = tf.get_variable('bias',shape= [layer_sizes[idx+1]],
                            initializer=tf.random_uniform_initializer(-0.1,0.1))
इनपुट/आउटपुट placeholders, प्रत्येक लेयर के वेट्स और बायसेज़ परिभाषित होने के बाद, आप अब फिर से न्यूरल नेटवर्क के लॉजिट्स की गणना के लिए आवश्यक गणनाएँ परिभाषित कर सकते हैं।
टिप्पणी: यह हिस्सा उन कोड के समान है जिन्हें आपने पहली बार ये ऑपरेशंस और टेन्सर परिभाषित करते समय उपयोग किया था।
यहाँ आप tf.summary ऑब्जेक्ट्स फिर से परिभाषित कर सकते हैं। यह भी उन्हीं कोड के समान है जिन्हें आपने पहली बार ये ऑपरेशंस और टेन्सर परिभाषित करते समय उपयोग किया था।
यहाँ आप फिर से tf.summary ऑब्जेक्ट्स परिभाषित करते हैं। हालाँकि, अब आप स्कैलर्स के वेक्टर का विज़ुअलाइज़ेशन कर रहे हैं, इसलिए आपको tf.summary.histogram ऑब्जेक्ट्स परिभाषित करने की आवश्यकता है।
ध्यान दें कि यह उन्हीं कोड के समान है जिन्हें आपने पहली बार ये ऑपरेशंस और टेन्सर परिभाषित करते समय उपयोग किया था।
ध्यान दें कि यह वही है जो आपने पिछली अनुभाग में किया था!
सिर्फ कुछ कोड के हिस्से हैं जिन्हें आपको बदलना है: os.path.join('summaries','third') के तीन occurrences को os.path.join('summaries','fourth') में, summ_writer_3 को summ_writer_4 में (यह 4 बार आता है) और tf_learning_rate का 0.00001 मान 0.01 करना है।
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25

config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure TensorFlow doesn't overflow the GPU

session = tf.InteractiveSession(config=config)

if not os.path.exists('summaries'):
    os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','fourth')):
    os.mkdir(os.path.join('summaries','fourth'))

summ_writer_4 = tf.summary.FileWriter(os.path.join('summaries','fourth'), session.graph)

tf.global_variables_initializer().run()

accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)


for epoch in range(n_epochs):
    loss_per_epoch = []
    for i in range(n_train//batch_size):

        # =================================== Training for one step ========================================
        batch = mnist_data.train.next_batch(batch_size)    # Get one batch of training data
        if i == 0:
            # Only for the first epoch, get the summary data
            # Otherwise, it can clutter the visualization
            l,_,gn_summ, wb_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary, tf_param_summaries],
                                      feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                                 train_labels: batch[1],
                                                tf_learning_rate: 0.01})
            summ_writer_4.add_summary(gn_summ, epoch)
            summ_writer_4.add_summary(wb_summ, epoch)
        else:
            # Optimize with training data
            l,_ = session.run([tf_loss,tf_loss_minimize],
                              feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                         train_labels: batch[1],
                                         tf_learning_rate: 0.01})
        loss_per_epoch.append(l)

    print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
    avg_loss = np.mean(loss_per_epoch)

    # ====================== Calculate the Validation Accuracy ==========================
    valid_accuracy_per_epoch = []
    for i in range(n_valid//batch_size):
        valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
        valid_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
        valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))

    mean_v_acc = np.mean(valid_accuracy_per_epoch)
    print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))

    # ===================== Calculate the Test Accuracy ===============================
    accuracy_per_epoch = []
    for i in range(n_test//batch_size):
        test_images, test_labels = mnist_data.test.next_batch(batch_size)
        test_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: test_images.reshape(batch_size,image_size*image_size)}
        )
        accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))

    print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
    avg_test_accuracy = np.mean(accuracy_per_epoch)

    # Execute the summaries defined above
    summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})

    # Write the obtained summaries to the file, so they can be displayed
    summ_writer_4.add_summary(summ, epoch)

session.close()
Extracting MNIST_data/train-images-idx3-ubyte.gz
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 0.43618
    Average Valid Accuracy in epoch 0: 95.70000
    Average Test Accuracy in epoch 0: 95.22000

Average loss in epoch 1: 0.12872
    Average Valid Accuracy in epoch 1: 96.86000
    Average Test Accuracy in epoch 1: 96.71000

  ...
  ...
  ...

Average loss in epoch 24: 0.00009
    Average Valid Accuracy in epoch 24: 98.42000
    Average Test Accuracy in epoch 24: 98.21000
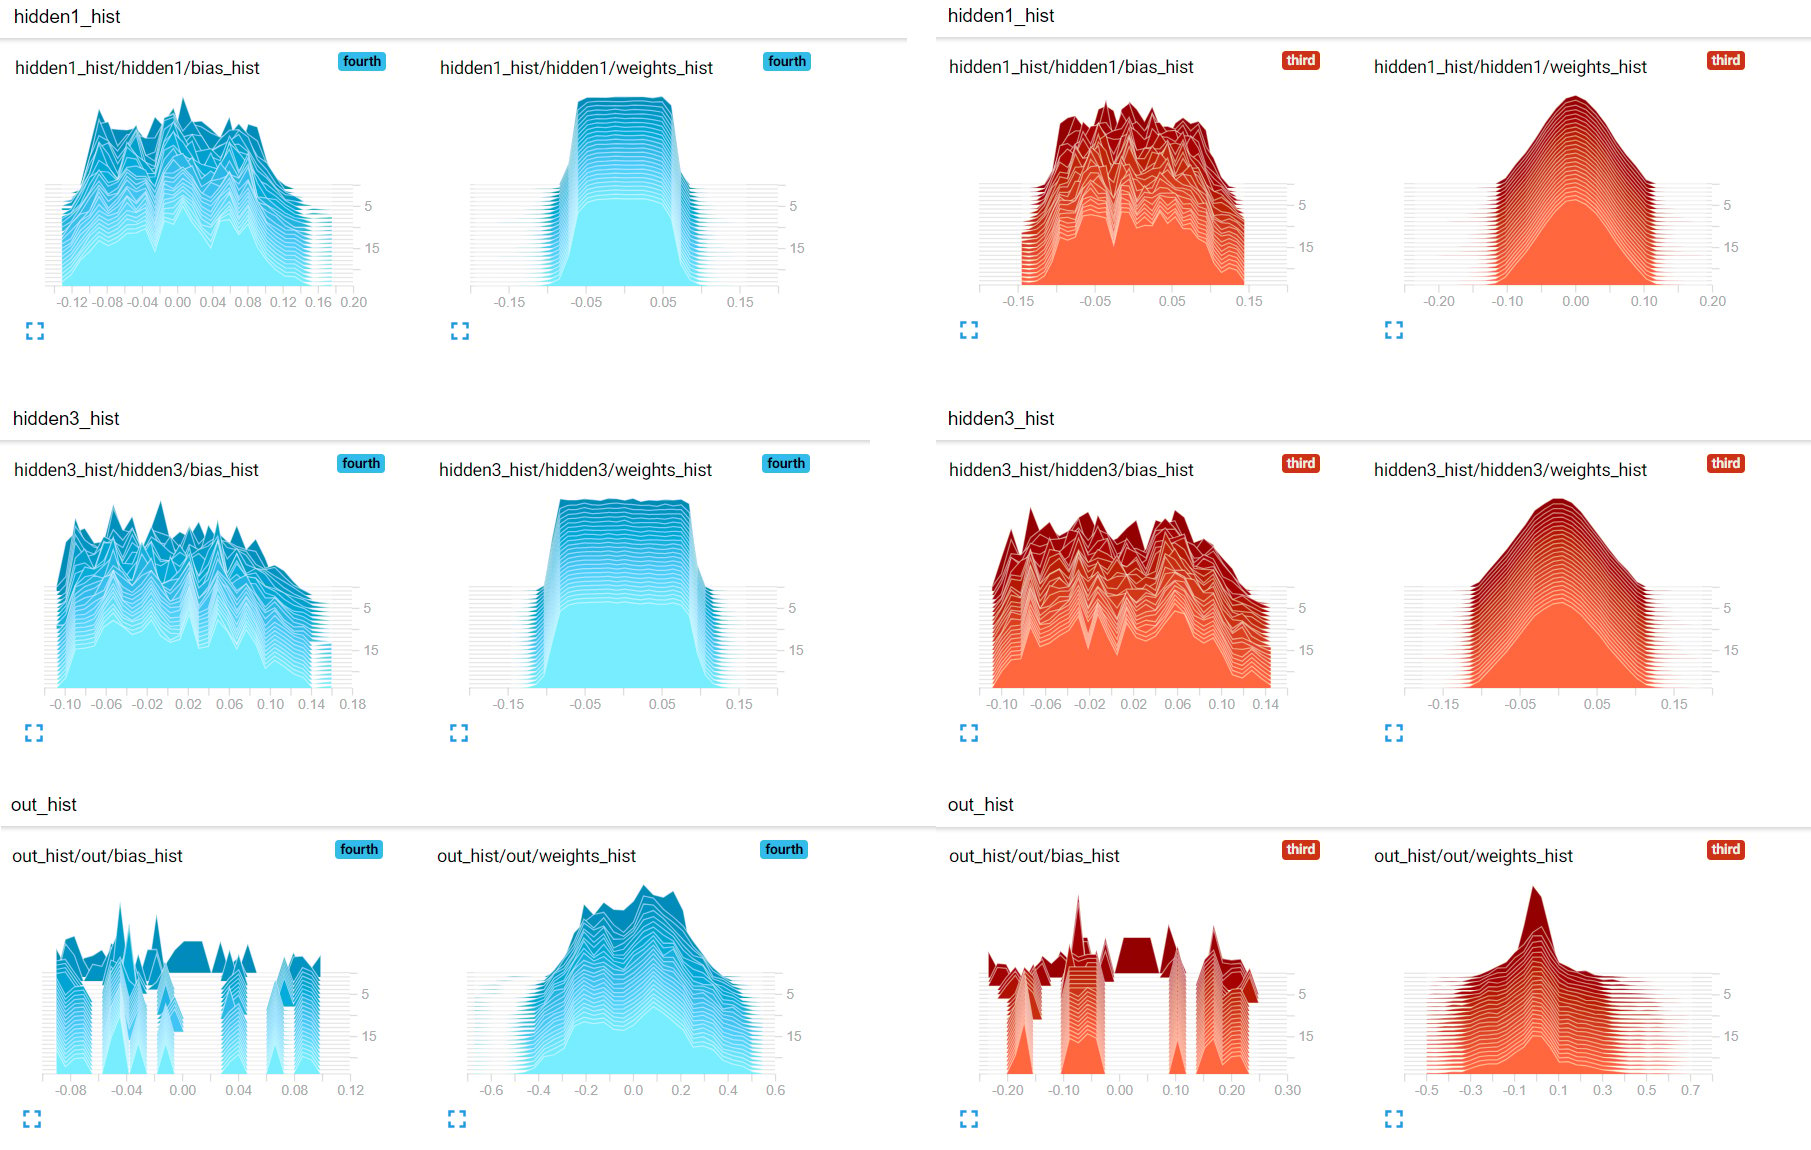
यहाँ आप दो अलग-अलग इनिशियलाइज़ेशन—truncated_normal_initializer (लाल) और xavier_initializer (नीला)—के लिए समय के साथ वेट्स के बदलने की तुलना कर सकते हैं। आप देख सकते हैं कि xavier_initializer सामान्य इनिशियलाइज़र की तुलना में अधिक वेट्स को शून्य से दूर रखता है, जो बेहतर है। इससे संभवतः Xavier-इनिशियलाइज़्ड न्यूरल नेटवर्क्स तेज़ी से कन्वर्ज होते हैं, जैसा कि लॉस/एक्यूरसी कर्व्स से स्पष्ट है।
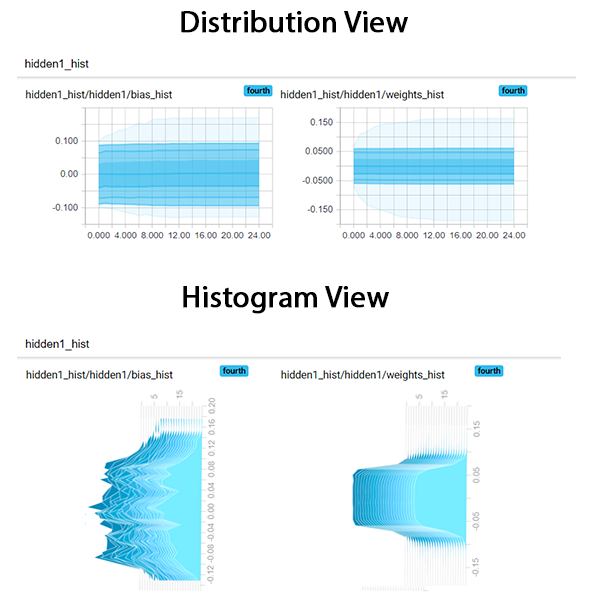
अब आप दो व्यू—हिस्टोग्राम व्यू और डिस्ट्रीब्यूशन व्यू—के बीच का अंतर तुलना कर सकते हैं। डिस्ट्रीब्यूशन व्यू मूलतः हिस्टोग्राम्स को देखने का एक अलग तरीका है। यदि आप नीचे दी गई छवि देखें, तो आसानी से समझ आएगा कि डिस्ट्रीब्यूशन व्यू हिस्टोग्राम व्यू का टॉप व्यू है। ध्यान दें कि समानता आसानी से दिखाने के लिए इस मामले में हिस्टोग्राम ग्राफ को घुमाया गया है।
इस ट्यूटोरियल में, आपने देखा कि TensorBoard का उपयोग कैसे करें। सबसे पहले, आपने कमांड प्रॉम्प्ट (Windows) या टर्मिनल (Ubuntu/Mac) के माध्यम से इसकी सेवा शुरू करना सीखा। अगला, आपने TensorBoard द्वारा उपलब्ध कराए गए डेटा के विभिन्न व्यू देखे। फिर, आपने वह कोड देखा जो स्कैलर मानों (उदाहरण के लिए लॉस/एक्यूरसी) का विज़ुअलाइज़ेशन करता है और स्कैलर मान विज़ुअलाइज़ेशन के उपयोग को ठोस रूप से समझने के लिए एक फीड-फॉरवर्ड न्यूरल नेटवर्क मॉडल का उपयोग किया।
इसके बाद, आपने यह खोजा कि हिस्टोग्राम व्यू का उपयोग करके स्कैलर्स के कलेक्शंस/वेक्टर कैसे विज़ुअलाइज़ किए जा सकते हैं। इसके बाद हिस्टोग्राम व्यू का उपयोग करके न्यूरल नेटवर्क वेट इनिशियलाइज़ेशन तकनीकों के बीच के अंतर को उजागर करती तुलना प्रस्तुत की गई।
अंत में, आपने डिस्ट्रीब्यूशन व्यू और हिस्टोग्राम व्यू के बीच समानताओं पर चर्चा की।
यदि आप डीप लर्निंग के बारे में और सीखना चाहते हैं, तो हमारे Deep Learning in Keras कोर्स को अवश्य देखें।
पैरामीटर्स और हाइपरपैरामीटर्स के बारे में अधिक जानने के लिए हमारा Hyperparameter Optimization in Machine Learning Models ट्यूटोरियल देखें।
यदि आप मुझसे संपर्क करना चाहें, तो मुझे thushv@gmail.com पर ई-मेल करें या LinkedIn के माध्यम से जुड़ें।
मशीन लर्निंग और डीप लर्निंग के बारे में और जानें
कोर्स
कोर्स
कोर्स