Curso
Comprender el machine learning
2 h
308.6K

Este tutorial te guía para usar TensorBoard, una herramienta fantástica que te permite visualizar datos y su comportamiento. Verás para qué puedes usarlo al entrenar una red neuronal.
Consejo: echa un vistazo al curso de Deep Learning con Keras de DataCamp aquí.
Antes de empezar, asegúrate de importar las siguientes librerías para ejecutar el código correctamente:
from pandas_datareader import data
import matplotlib.pyplot as plt
import pandas as pd
import datetime as dt
import urllib.request, json
import os
import numpy as np

# This code has been tested with TensorFlow 1.6
import tensorflow as tf
from tensorflow.examples.tutorials.mnist import input_data
Para visualizar con TensorBoard, primero tienes que iniciar su servicio. Para ello,
python3; verás un prompt con aspecto >>>import tensorflow as tf>>>) escribiendo exit() y teclea el siguiente comando
tensorboard --logdir=summaries--logdir es el directorio donde crearás los datos a visualizar--port=<puerto_que_prefieras> para cambiar el puerto en el que se ejecuta TensorBoardTensorBoard 1.6.0 at <url>:6006 (Press CTRL+C to quit)Nota: a TensorBoard no le gusta encontrar múltiples event files en el mismo directorio. Esto puede provocar curvas muy extrañas en pantalla. Por eso, crea una carpeta separada para cada ejemplo (por ejemplo, summaries/first, summaries/second, ...) para guardar los datos. Además, si quieres volver a ejecutar un experimento (es decir, guardar un event file en una carpeta ya poblada), asegúrate de borrar primero los event files existentes.
Cada vista admite formatos de entrada diferentes y las muestra de forma distinta. Puedes cambiar entre ellas en la barra superior naranja.
En este tutorial, cubrirás las vistas en negrita.
En esta sección, primero verás por qué es útil visualizar ciertas métricas (por ejemplo, pérdida o precisión). Al entrenar redes neuronales profundas, uno de los grandes problemas para principiantes es no comprender bien el efecto de distintas decisiones de diseño e hiperparámetros.
Por ejemplo, si inicializas los pesos de una red profunda con una varianza muy grande, el modelo puede divergir y colapsar rápidamente. Incluso si dominas bien las redes, las cosas pueden torcerse: no prestar atención a la tasa de aprendizaje puede provocar tanto la divergencia del modelo como una saturación prematura en un rendimiento subóptimo.
Una forma de detectar rápido problemas en tu modelo es tener una visualización gráfica en tiempo real de lo que está ocurriendo (por ejemplo, cada 100 iteraciones). Si el modelo se comporta de forma extraña, se verá claramente. Eso es justo lo que te ofrece TensorBoard. Tú decides qué valores quieres mostrar y TensorBoard mantiene una visualización en tiempo real de ellos durante el aprendizaje.
Empezarás creando una red neuronal de cinco capas para clasificar imágenes de dígitos escritos a mano. Usarás el famoso conjunto de datos MNIST. TensorFlow proporciona una API sencilla para cargar MNIST, así que no tendrás que descargarlo manualmente. Antes, define un método sencillo (accuracy()) que calcula la precisión de unas predicciones respecto a las etiquetas verdaderas.
def accuracy(predictions,labels):
    '''
    Accuracy of a given set of predictions of size (N x n_classes) and
    labels of size (N x n_classes)
    '''
    return np.sum(np.argmax(predictions,axis=1)==np.argmax(labels,axis=1))*100.0/labels.shape[0]
Primero, define un batch_size que indica la cantidad de datos que muestrearás en cada paso de optimización/validación o prueba. Luego define los layer_ids, que identifican cada capa de la red neuronal que vas a crear. Después puedes definir los layer_sizes.
Ten en cuenta que len(layer_sizes) debe ser len(layer_ids)+1, porque layer_sizes incluye el tamaño de la entrada al principio.
MNIST tiene imágenes de 28x28, que al aplanarlas a una dimensión quedan en 784. Después puedes definir los placeholders de entrada y etiquetas, que usarás más tarde para entrenar el modelo. Por último, define dos variables de TensorFlow por capa (weights y bias).
Puedes usar ámbitos de variables (más info aquí) para que las variables queden bien nombradas y sean más fáciles de acceder después.
batch_size = 100
layer_ids = ['hidden1','hidden2','hidden3','hidden4','hidden5','out']
layer_sizes = [784, 500, 400, 300, 200, 100, 10]

tf.reset_default_graph()

# Inputs and Labels
train_inputs = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[0]], name='train_inputs')
train_labels = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[-1]], name='train_labels')

# Weight and Bias definitions
for idx, lid in enumerate(layer_ids):

    with tf.variable_scope(lid):
        w = tf.get_variable('weights',shape=[layer_sizes[idx], layer_sizes[idx+1]],
                            initializer=tf.truncated_normal_initializer(stddev=0.05))
        b = tf.get_variable('bias',shape= [layer_sizes[idx+1]],
                            initializer=tf.random_uniform_initializer(-0.1,0.1))
Con los placeholders de entrada/salida y los pesos y sesgos de cada capa definidos, ya puedes establecer los cálculos para obtener los logits de la red neuronal. Los logits son los valores no normalizados producidos en la última capa. Al normalizarlos, obtienes las predicciones. Esto implica iterar por cada capa y calcular tf.matmul(h,w) + b. También necesitas aplicar una función de activación como tf.nn.relu(tf.matmul(h,w) + b) en todas las capas excepto la última.
Después, define la función de pérdida que se usará para optimizar la red. En este ejemplo, puedes usar la entropía cruzada, que suele dar mejores resultados en clasificación que el error cuadrático medio.
Por último, define un optimizador que tome la pérdida y actualice los pesos en la dirección que la minimiza.
# Calculating Logits
h = train_inputs
for lid in layer_ids:
    with tf.variable_scope(lid,reuse=True):
        w, b = tf.get_variable('weights'), tf.get_variable('bias')
        if lid != 'out':
          h = tf.nn.relu(tf.matmul(h,w)+b,name=lid+'_output')
        else:
          h = tf.nn.xw_plus_b(h,w,b,name=lid+'_output')

tf_predictions = tf.nn.softmax(h, name='predictions')
# Calculating Loss
tf_loss = tf.reduce_mean(tf.nn.softmax_cross_entropy_with_logits_v2(labels=train_labels, logits=h),name='loss')

# Optimizer
tf_learning_rate = tf.placeholder(tf.float32, shape=None, name='learning_rate')
optimizer = tf.train.MomentumOptimizer(tf_learning_rate,momentum=0.9)
grads_and_vars = optimizer.compute_gradients(tf_loss)
tf_loss_minimize = optimizer.minimize(tf_loss)
Aquí defines los objetos tf.summary. Estos objetos son los que entiende TensorBoard. Es decir, cualquier valor que quieras mostrar debes encapsularlo como un objeto tf.summary.
Hay varios tipos de resúmenes. Como aquí visualizas solo escalares, puedes definir objetos tf.summary.scalar. Además, puedes usar tf.name_scope para agrupar escalares en el panel. Es decir, los escalares con el mismo name scope se muestran en la misma fila. Aquí defines tres resúmenes.
tf_loss_summary: pasas un valor mediante un placeholder cuando quieras publicarlo en el paneltf_accuracy_summary: pasas un valor mediante un placeholder cuando quieras publicarlo en el paneltf_gradnorm_summary: calcula la norma L2 de los gradientes de la última capa. La norma del gradiente es un buen indicador de si los pesos se están actualizando correctamente. Un gradiente demasiado pequeño puede indicar vanishing gradient y uno demasiado grande, exploding gradient.# Name scope allows you to group various summaries together
# Summaries having the same name_scope will be displayed on the same row
with tf.name_scope('performance'):
# Summaries need to be displayed
# Whenever you need to record the loss, feed the mean loss to this placeholder
tf_loss_ph = tf.placeholder(tf.float32,shape=None,name='loss_summary')
# Create a scalar summary object for the loss so it can be displayed
tf_loss_summary = tf.summary.scalar('loss', tf_loss_ph)
# Whenever you need to record the loss, feed the mean test accuracy to this placeholder
tf_accuracy_ph = tf.placeholder(tf.float32,shape=None, name='accuracy_summary')
# Create a scalar summary object for the accuracy so it can be displayed
tf_accuracy_summary = tf.summary.scalar('accuracy', tf_accuracy_ph)
# Gradient norm summary
for g,v in grads_and_vars:
if 'hidden5' in v.name and 'weights' in v.name:
with tf.name_scope('gradients'):
tf_last_grad_norm = tf.sqrt(tf.reduce_mean(g**2))
tf_gradnorm_summary = tf.summary.scalar('grad_norm', tf_last_grad_norm)
break
# Merge all summaries together
performance_summaries = tf.summary.merge([tf_loss_summary,tf_accuracy_summary])
En el siguiente código haces lo siguiente. Primero, creas una sesión en la que ejecutarás las operaciones definidas. Luego, creas una carpeta para guardar los summary data. A continuación, creas un escritor de resúmenes summ_writer. Ya puedes inicializar todas las variables. Después cargas el conjunto de datos MNIST.
Luego, para cada época y cada lote del conjunto de entrenamiento (es decir, cada iteración), ejecuta gradnorm_summary si es la primera iteración y escribe gradnorm_summary en el event file con el summary writer. A continuación ejecutas la optimización del modelo y el cálculo de la pérdida. Tras recorrer todo el conjunto de entrenamiento en una época, calcula la pérdida media de entrenamiento.
Con el conjunto de validación haces algo similar. En concreto, para cada lote calculas la precisión de validación y, después, la precisión media de validación del conjunto completo.
Por último, ejecutas la fase de prueba. Para cada lote del conjunto de prueba calculas la precisión y, con ello, la precisión media del conjunto completo. Al final ejecutas performance_summaries y los escribes en el event file con el summary writer.
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25

config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure Tensorflow doesn't overflow the GPU

session = tf.InteractiveSession(config=config)

if not os.path.exists('summaries'):
    os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','first')):
    os.mkdir(os.path.join('summaries','first'))

summ_writer = tf.summary.FileWriter(os.path.join('summaries','first'), session.graph)

tf.global_variables_initializer().run()

accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)


for epoch in range(n_epochs):
    loss_per_epoch = []
    for i in range(n_train//batch_size):

        # =================================== Training for one step ========================================
        batch = mnist_data.train.next_batch(batch_size)    # Get one batch of training data
        if i == 0:
            # Only for the first epoch, get the summary data
            # Otherwise, it can clutter the visualization
            l,_,gn_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary],
                                      feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                                 train_labels: batch[1],
                                                tf_learning_rate: 0.0001})
            summ_writer.add_summary(gn_summ, epoch)
        else:
            # Optimize with training data
            l,_ = session.run([tf_loss,tf_loss_minimize],
                              feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                         train_labels: batch[1],
                                         tf_learning_rate: 0.0001})
        loss_per_epoch.append(l)

    print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
    avg_loss = np.mean(loss_per_epoch)

    # ====================== Calculate the Validation Accuracy ==========================
    valid_accuracy_per_epoch = []
    for i in range(n_valid//batch_size):
        valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
        valid_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
        valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))

    mean_v_acc = np.mean(valid_accuracy_per_epoch)
    print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))

    # ===================== Calculate the Test Accuracy ===============================
    accuracy_per_epoch = []
    for i in range(n_test//batch_size):
        test_images, test_labels = mnist_data.test.next_batch(batch_size)
        test_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: test_images.reshape(batch_size,image_size*image_size)}
        )
        accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))

    print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
    avg_test_accuracy = np.mean(accuracy_per_epoch)

    # Execute the summaries defined above
    summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})

    # Write the obtained summaries to the file, so it can be displayed in the TensorBoard
    summ_writer.add_summary(summ, epoch)

session.close()
Successfully downloaded train-images-idx3-ubyte.gz 9912422 bytes.
Extracting MNIST_data/train-images-idx3-ubyte.gz
Successfully downloaded train-labels-idx1-ubyte.gz 28881 bytes.
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Successfully downloaded t10k-images-idx3-ubyte.gz 1648877 bytes.
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Successfully downloaded t10k-labels-idx1-ubyte.gz 4542 bytes.
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 2.30252
    Average Valid Accuracy in epoch 0: 10.02000
    Average Test Accuracy in epoch 0: 9.76000

Average loss in epoch 1: 2.30016
    Average Valid Accuracy in epoch 1: 12.56000
    Average Test Accuracy in epoch 1: 12.64000

  ...
  ...
  ...

Average loss in epoch 24: 1.03386
    Average Valid Accuracy in epoch 24: 71.88000
    Average Test Accuracy in epoch 24: 71.23000
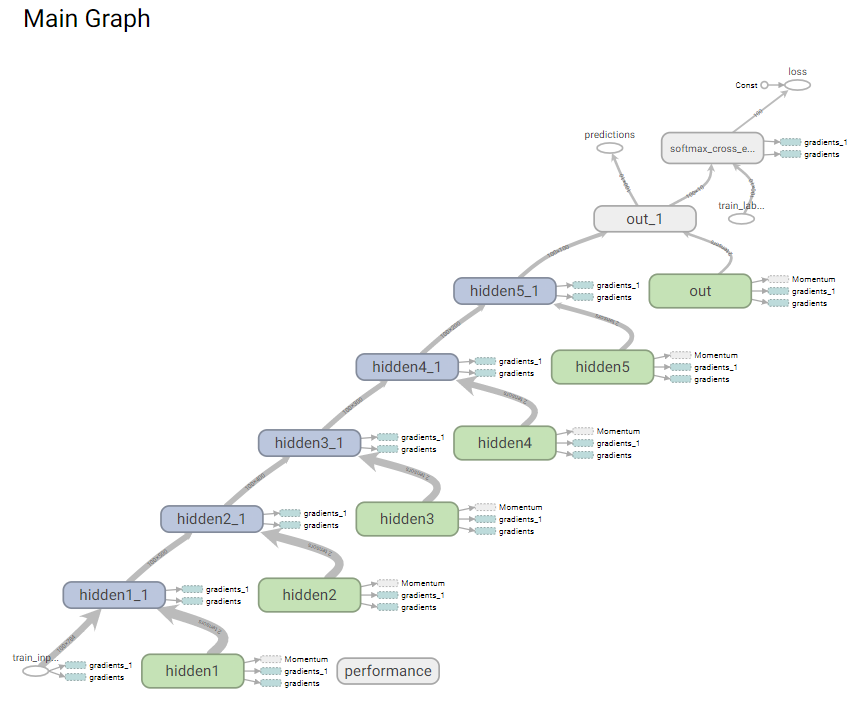
Primero, verás el grafo computacional de tu modelo. Accede a esta vista haciendo clic en Graphs en TensorBoard. Debería verse como en la imagen siguiente. Puedes ver un flujo claro desde train_inputs hasta loss y predictions pasando por las capas ocultas de la 1 a la 5.
La clasificación de MNIST es uno de los ejemplos más sencillos, y aun así aquí no se resuelve con una red de 5 capas. Para MNIST, no es difícil superar el 90% de precisión en menos de 5 épocas.
Entonces, ¿qué está pasando?
Veámoslo en TensorBoard:
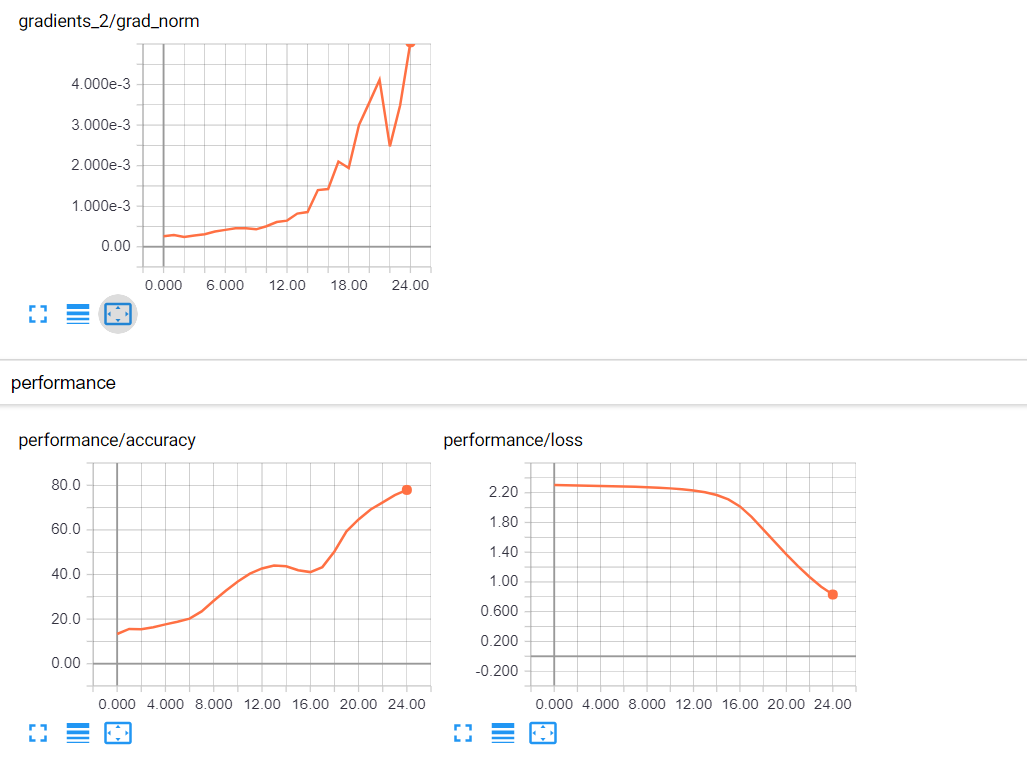
Se ve que la precisión sube, pero muy lentamente, y que las actualizaciones del gradiente aumentan con el tiempo. Es un comportamiento extraño. Si te acercas a la convergencia, deberías ver que los gradientes disminuyen (tienden a cero), no que aumentan. Pero como la precisión sube, vas por buen camino. Probablemente necesitas una tasa de aprendizaje mayor.
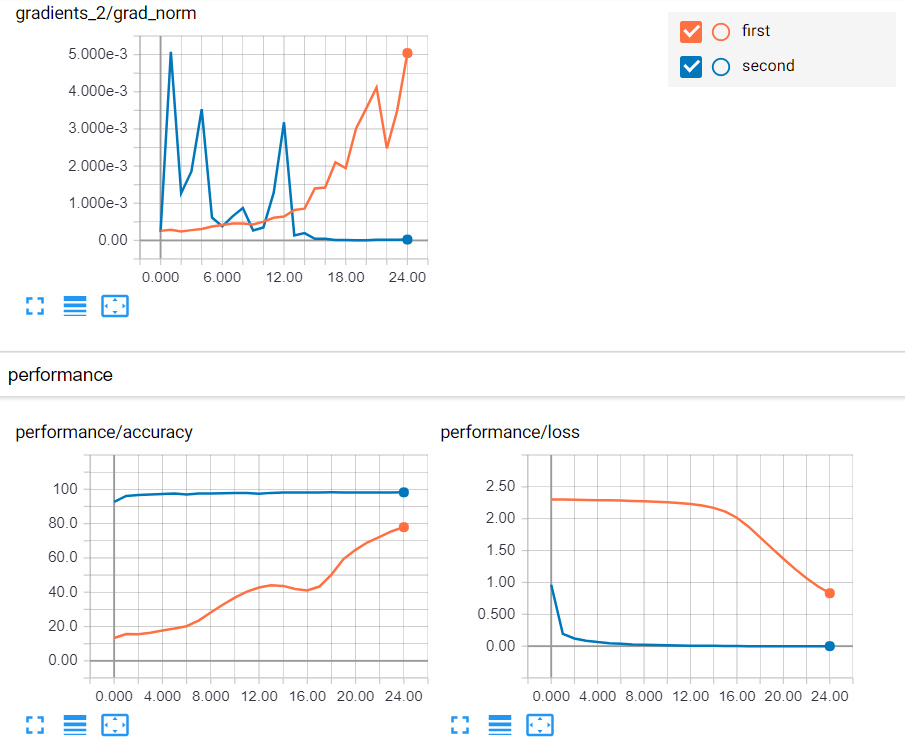
Prueba ahora con una tasa de aprendizaje de 0.01. Es casi idéntico a la ejecución anterior, salvo que usarás 0.01 en lugar de 0.0001. En vez de tf_learning_rate: 0.0001, usa tf_learning_rate: 0.01. Ojo: hay dos sitios donde debes cambiar este argumento.
Ahora verás que la precisión empieza cerca de 100 y sigue subiendo. Y también que las actualizaciones del gradiente disminuyen con el tiempo y se acercan a cero. Con una tasa de aprendizaje de 0.01 las cosas van mucho mejor.
Pasemos ahora más allá de los escalares. Verás cómo analizar vectores de escalares y colecciones de escalares.
Has visto las ventajas de visualizar escalares con TensorBoard, lo que te permitió entender el comportamiento del modelo y arreglar posibles problemas. Además, visualizar el grafo te permitió comprobar que hay un enlace continuo desde las entradas hasta las predicciones, necesario para calcular gradientes.
Ahora verás otra vista muy útil en TensorBoard: histogramas o distribuciones.
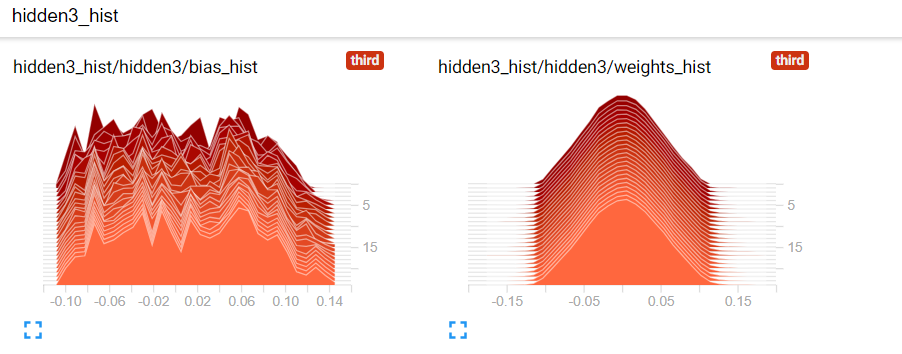
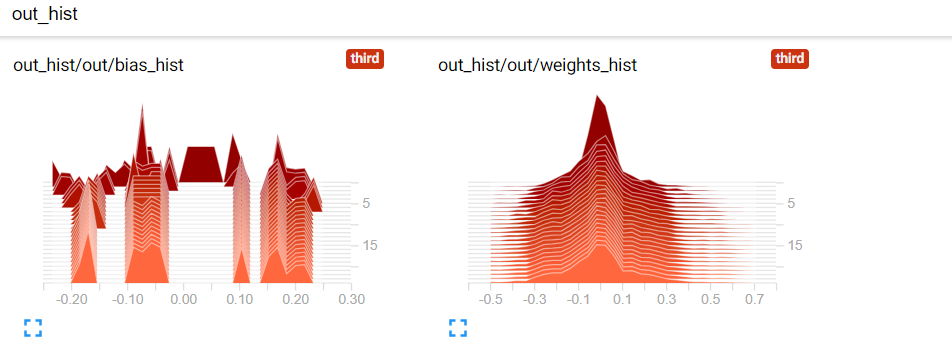
Recuerda que un histograma es una colección de valores representada por la frecuencia/densidad con la que aparecen en el conjunto. Puedes usar histogramas para visualizar los valores de los pesos de la red a lo largo del tiempo. Es importante, porque si los pesos saltan de un lado a otro durante el aprendizaje, indica que algo va mal con la inicialización o con la tasa de aprendizaje.
Verás cómo cambian los pesos en el ejemplo. Si miras el código, usa truncated_normal_initializer() para inicializar los pesos.
Aquí vuelves a definir objetos tf.summary. Pero ahora visualizas vectores de escalares, así que necesitas objetos tf.summary.histogram.
En este caso defines dos objetos de histograma (tf_w_hist y tf_b_hist) que contienen pesos y sesgos de una capa dada. Definirás estos histogramas para todas las capas, y cada capa tendrá su propio name scope.
Por último, puedes usar la operación tf.summary.merge para crear una operación agrupada que ejecute todos estos resúmenes a la vez.
# Summaries need to be displayed
# Create a summary for each weight bias in each layer
all_summaries = []
for lid in layer_ids:
    with tf.name_scope(lid+'_hist'):
        with tf.variable_scope(lid,reuse=True):
            w,b = tf.get_variable('weights'), tf.get_variable('bias')

            # Create a scalar summary object for the loss so it can be displayed
            tf_w_hist = tf.summary.histogram('weights_hist', tf.reshape(w,[-1]))
            tf_b_hist = tf.summary.histogram('bias_hist', b)
            all_summaries.extend([tf_w_hist, tf_b_hist])

# Merge all parameter histogram summaries together
tf_param_summaries = tf.summary.merge(all_summaries)
Este paso es casi igual que antes, pero aquí hay algunas líneas adicionales para calcular los resúmenes de histogramas (tf_param_summaries).
Nota: las tasas de aprendizaje también han cambiado de nuevo.
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25

config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure Tensorflow doesn't overflow the GPU

session = tf.InteractiveSession(config=config)

if not os.path.exists('summaries'):
    os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','third')):
    os.mkdir(os.path.join('summaries','third'))

summ_writer_3 = tf.summary.FileWriter(os.path.join('summaries','third'), session.graph)

tf.global_variables_initializer().run()

accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)


for epoch in range(n_epochs):
    loss_per_epoch = []
    for i in range(n_train//batch_size):

        # =================================== Training for one step ========================================
        batch = mnist_data.train.next_batch(batch_size)    # Get one batch of training data
        if i == 0:
            # Only for the first epoch, get the summary data
            # Otherwise, it can clutter the visualization
            l,_,gn_summ, wb_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary, tf_param_summaries],
                                      feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                                 train_labels: batch[1],
                                                tf_learning_rate: 0.00001})
            summ_writer_3.add_summary(gn_summ, epoch)
            summ_writer_3.add_summary(wb_summ, epoch)
        else:
            # Optimize with training data
            l,_ = session.run([tf_loss,tf_loss_minimize],
                              feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                         train_labels: batch[1],
                                         tf_learning_rate: 0.01})
        loss_per_epoch.append(l)

    print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
    avg_loss = np.mean(loss_per_epoch)

    # ====================== Calculate the Validation Accuracy ==========================
    valid_accuracy_per_epoch = []
    for i in range(n_valid//batch_size):
        valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
        valid_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
        valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))

    mean_v_acc = np.mean(valid_accuracy_per_epoch)
    print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))

    # ===================== Calculate the Test Accuracy ===============================
    accuracy_per_epoch = []
    for i in range(n_test//batch_size):
        test_images, test_labels = mnist_data.test.next_batch(batch_size)
        test_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: test_images.reshape(batch_size,image_size*image_size)}
        )
        accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))

    print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
    avg_test_accuracy = np.mean(accuracy_per_epoch)

    # Execute the summaries defined above
    summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})

    # Write the obtained summaries to the file, so they can be displayed
    summ_writer_3.add_summary(summ, epoch)

session.close()
Extracting MNIST_data/train-images-idx3-ubyte.gz
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 1.02625
    Average Valid Accuracy in epoch 0: 92.76000
    Average Test Accuracy in epoch 0: 92.65000

Average loss in epoch 1: 0.19110
    Average Valid Accuracy in epoch 1: 95.80000
    Average Test Accuracy in epoch 1: 95.48000

  ...
  ...
  ...

Average loss in epoch 24: 0.00009
    Average Valid Accuracy in epoch 24: 98.28000
    Average Test Accuracy in epoch 24: 98.09000
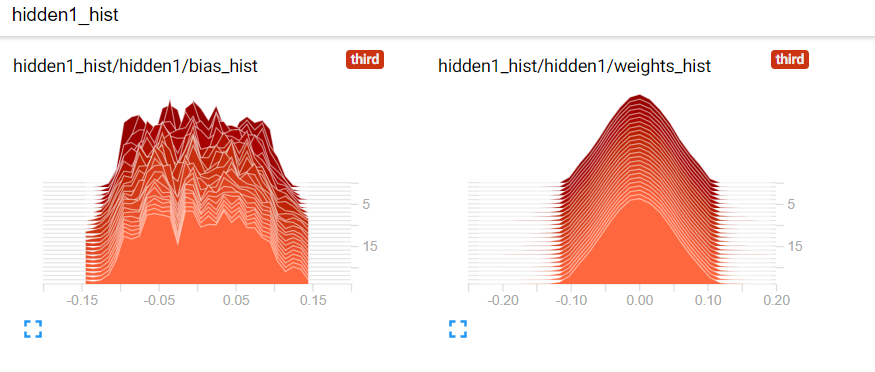
Así es como se ven tus pesos y sesgos. Primero, hay 3 ejes: tiempo (eje x), valor (eje y) y frecuencia/densidad (eje z). Los histogramas más oscuros representan datos más antiguos y los más claros, datos más recientes. Un valor más alto en el eje z indica que el vector contiene más valores cerca de ese valor concreto.
Nota: también tienes una vista "overlay" de los histogramas a lo largo del tiempo. Puedes cambiar el tipo de visualización en el panel de opciones de la izquierda.
Ahora, en lugar de usar truncated_normal_initializer(), usarás xavier_initializer() para inicializar los pesos. La inicialización de Xavier es una técnica mucho mejor, especialmente en redes profundas.
Esto se debe a que, en lugar de usar una desviación estándar definida por el usuario (como con truncated_normal_initializer()), Xavier decide automáticamente la desviación estándar en función del número de conexiones de entrada y salida de una capa. Esto ayuda a que los gradientes fluyan de arriba abajo sin problemas como el vanishing gradient. Después, defines de nuevo el modelo.
Primero defines el batch_size, que indica la cantidad de datos que muestrearás en cada paso de optimización/validación o prueba. Luego puedes definir los layer_ids, que identifican cada capa de la red que vas a definir.
Luego defines los layer_sizes. Recuerda que len(layer_sizes) debe ser len(layer_ids)+1, porque layer_sizes incluye el tamaño de la entrada al principio. MNIST tiene imágenes de 28x28, que al aplanarlas quedan en 784.
Después defines los placeholders de entrada y etiquetas, que usarás para entrenar el modelo. Por último, defines dos variables de TensorFlow por capa (weights y bias).
Nota: esto es idéntico al código que usaste la primera vez, salvo por la técnica de inicialización de los pesos.
batch_size = 100
layer_ids = ['hidden1','hidden2','hidden3','hidden4','hidden5','out']
layer_sizes = [784, 500, 400, 300, 200, 100, 10]

tf.reset_default_graph()

# Inputs and Labels
train_inputs = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[0]], name='train_inputs')
train_labels = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[-1]], name='train_labels')

# Weight and Bias definitions
for idx, lid in enumerate(layer_ids):

    with tf.variable_scope(lid):
        w = tf.get_variable('weights',shape=[layer_sizes[idx], layer_sizes[idx+1]],
                            initializer=tf.contrib.layers.xavier_initializer())
        b = tf.get_variable('bias',shape= [layer_sizes[idx+1]],
                            initializer=tf.random_uniform_initializer(-0.1,0.1))
Con los placeholders de entrada/salida y los pesos y sesgos de cada capa definidos, ya puedes volver a definir los cálculos para obtener los logits de la red.
Nota: esta parte es idéntica al código que usaste la primera vez.
Aquí vuelves a definir los objetos tf.summary. Esto también es idéntico al código de la primera vez.
Aquí de nuevo defines objetos tf.summary. Ahora visualizas vectores de escalares, así que necesitas objetos tf.summary.histogram.
Nota: esto es idéntico al código anterior.
Nota: es lo mismo que hiciste antes en la sección previa.
Solo debes cambiar unos pocos fragmentos: las tres apariciones de os.path.join('summaries','third') por os.path.join('summaries','fourth'), summ_writer_3 por summ_writer_4 (aparece 4 veces) y establecer tf_learning_rate de 0.00001 a 0.01.
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25

config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure TensorFlow doesn't overflow the GPU

session = tf.InteractiveSession(config=config)

if not os.path.exists('summaries'):
    os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','fourth')):
    os.mkdir(os.path.join('summaries','fourth'))

summ_writer_4 = tf.summary.FileWriter(os.path.join('summaries','fourth'), session.graph)

tf.global_variables_initializer().run()

accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)


for epoch in range(n_epochs):
    loss_per_epoch = []
    for i in range(n_train//batch_size):

        # =================================== Training for one step ========================================
        batch = mnist_data.train.next_batch(batch_size)    # Get one batch of training data
        if i == 0:
            # Only for the first epoch, get the summary data
            # Otherwise, it can clutter the visualization
            l,_,gn_summ, wb_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary, tf_param_summaries],
                                      feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                                 train_labels: batch[1],
                                                tf_learning_rate: 0.01})
            summ_writer_4.add_summary(gn_summ, epoch)
            summ_writer_4.add_summary(wb_summ, epoch)
        else:
            # Optimize with training data
            l,_ = session.run([tf_loss,tf_loss_minimize],
                              feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                         train_labels: batch[1],
                                         tf_learning_rate: 0.01})
        loss_per_epoch.append(l)

    print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
    avg_loss = np.mean(loss_per_epoch)

    # ====================== Calculate the Validation Accuracy ==========================
    valid_accuracy_per_epoch = []
    for i in range(n_valid//batch_size):
        valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
        valid_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
        valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))

    mean_v_acc = np.mean(valid_accuracy_per_epoch)
    print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))

    # ===================== Calculate the Test Accuracy ===============================
    accuracy_per_epoch = []
    for i in range(n_test//batch_size):
        test_images, test_labels = mnist_data.test.next_batch(batch_size)
        test_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: test_images.reshape(batch_size,image_size*image_size)}
        )
        accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))

    print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
    avg_test_accuracy = np.mean(accuracy_per_epoch)

    # Execute the summaries defined above
    summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})

    # Write the obtained summaries to the file, so they can be displayed
    summ_writer_4.add_summary(summ, epoch)

session.close()
Extracting MNIST_data/train-images-idx3-ubyte.gz
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 0.43618
    Average Valid Accuracy in epoch 0: 95.70000
    Average Test Accuracy in epoch 0: 95.22000

Average loss in epoch 1: 0.12872
    Average Valid Accuracy in epoch 1: 96.86000
    Average Test Accuracy in epoch 1: 96.71000

  ...
  ...
  ...

Average loss in epoch 24: 0.00009
    Average Valid Accuracy in epoch 24: 98.42000
    Average Test Accuracy in epoch 24: 98.21000
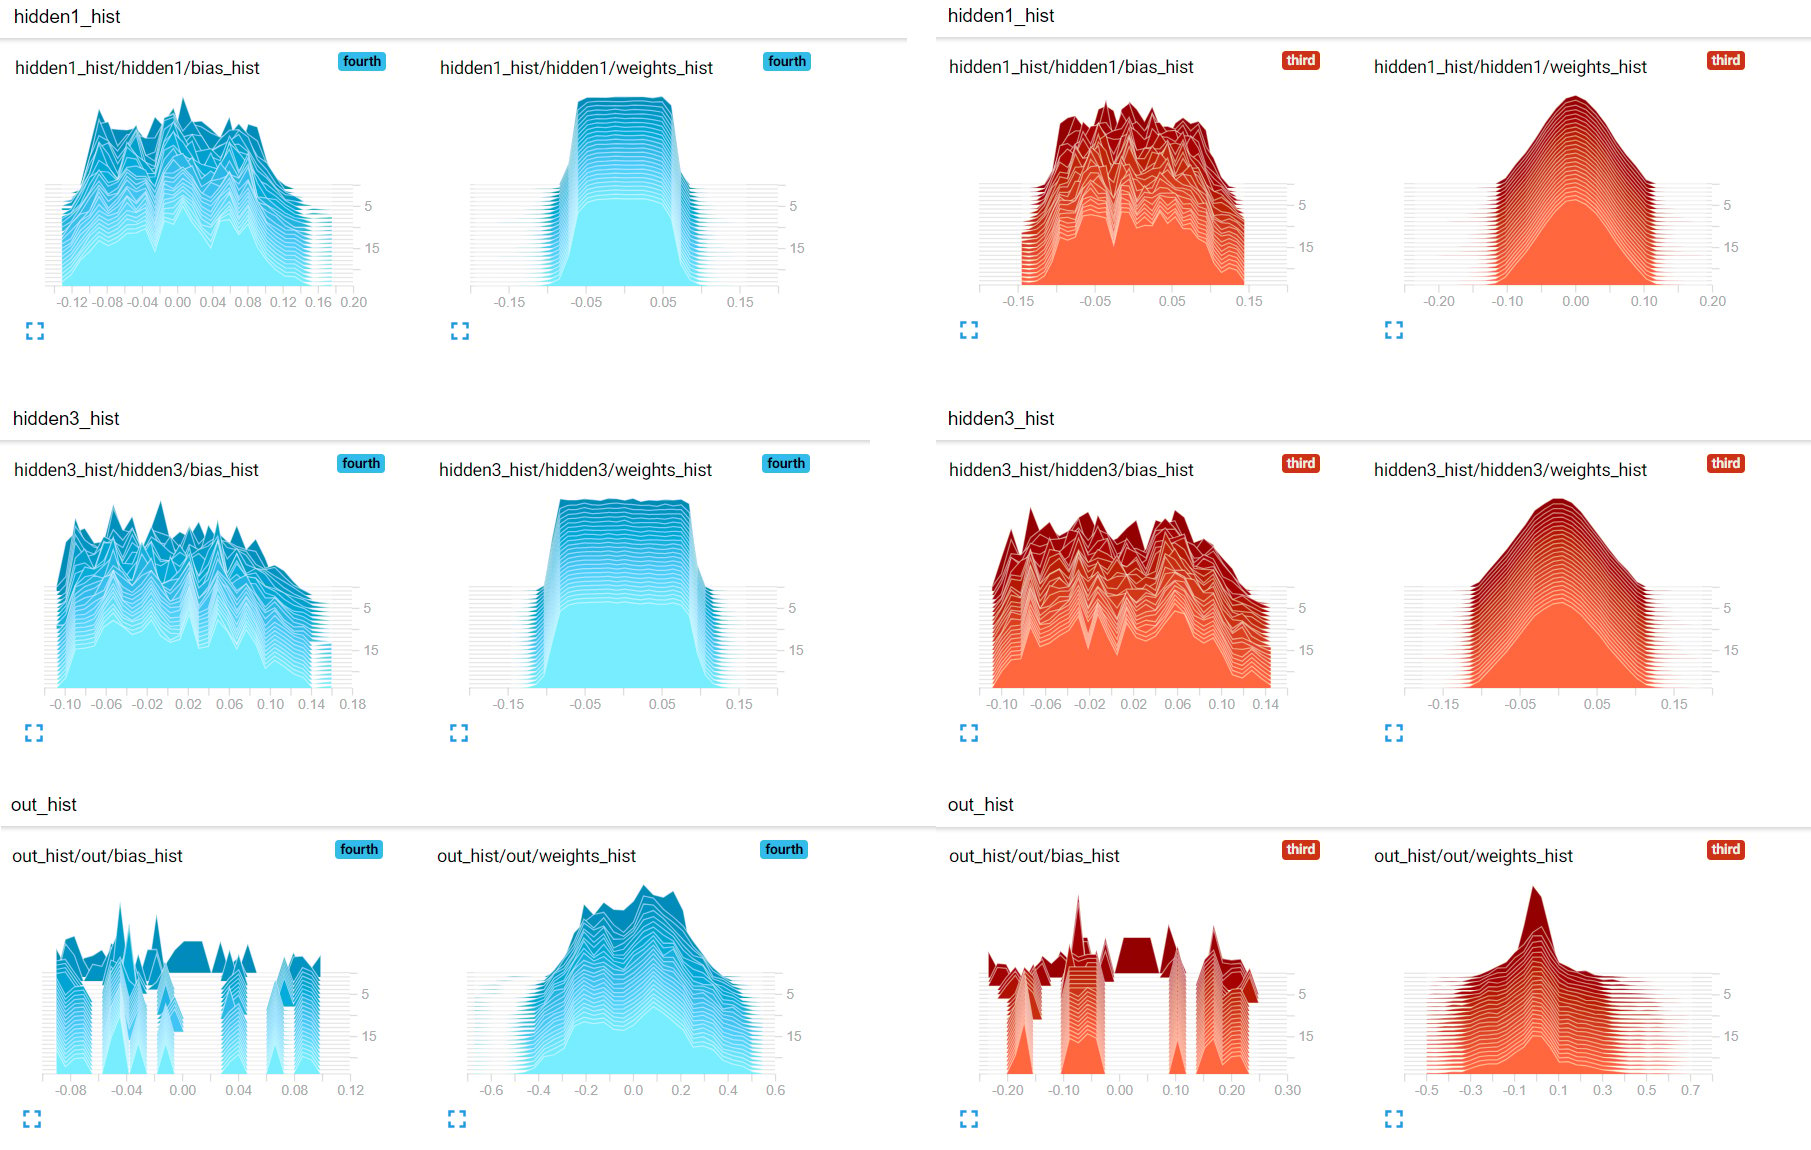
Aquí puedes comparar cómo evolucionan los pesos a lo largo del tiempo para dos inicializaciones: truncated_normal_initializer (rojo) y xavier_initializer (azul). Verás que xavier_initializer mantiene más pesos alejados de cero que el normal, lo cual es mejor. Esto puede permitir que las redes inicializadas con Xavier converjan más rápido, como muestran las curvas de pérdida/precisión.
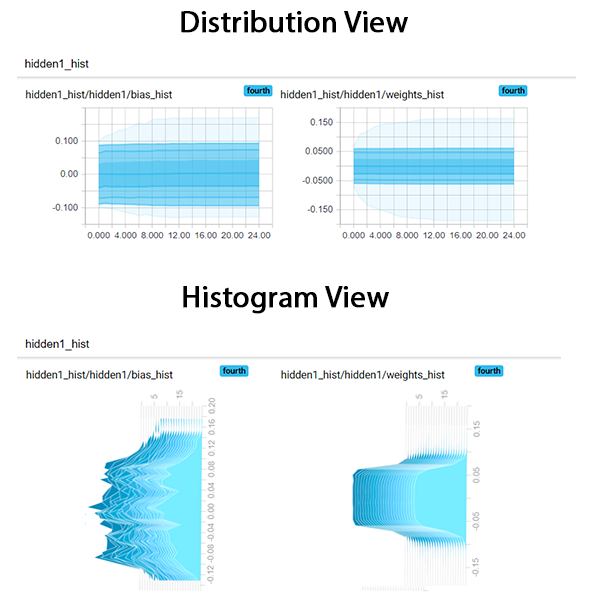
Ahora puedes comparar la diferencia entre las dos vistas: histograma y distribución. La vista de distribución es, esencialmente, otra forma de ver los histogramas. Si miras la imagen de abajo, verás que la vista de distribución es una vista superior del histograma. Observa que en este caso los gráficos de histograma están rotados para que se vea fácilmente la similitud.
En este tutorial has visto cómo usar TensorBoard. Primero, aprendiste a iniciar su servicio desde el símbolo del sistema (Windows) o la terminal (Ubuntu/Mac). Luego, exploraste distintas vistas de datos que ofrece TensorBoard. Después revisaste código que visualiza valores escalares (por ejemplo, pérdida/precisión) y usaste una red neuronal feed-forward para entender en concreto el uso de esta visualización.
A continuación, exploraste cómo visualizar colecciones/vectores de escalares con la vista de histogramas. Después comparaste distintas técnicas de inicialización de pesos usando esa vista.
Por último, comentamos las similitudes entre la vista de distribución y la de histogramas.
Si quieres aprender más sobre deep learning, no te pierdas nuestro curso Deep Learning in Keras.
Consulta nuestro tutorial Hyperparameter Optimization in Machine Learning Models para aprender más sobre parámetros e hiperparámetros.
Si quieres ponerte en contacto conmigo, puedes escribirme a thushv@gmail.com o conectar conmigo en LinkedIn.
Aprende más sobre machine learning y deep learning
Curso
Curso
Curso
Tutorial
Abid Ali Awan
15 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Bharath K
13 min
Tutorial
Zoumana Keita
14 min
Tutorial
Abid Ali Awan
10 min
Tutorial




