Kurs
Machine Learning'i Anlamak
2 sa
311.4K

Bu eğitim, verileri ve davranışlarını görselleştirmenizi sağlayan harika bir araç olan TensorBoard’u nasıl kullanacağınızı gösterecek. Bir sinir ağını eğitirken hangi amaçlarla kullanabileceğinizi göreceksiniz.
İpucu: DataCamp’in Keras ile Derin Öğrenme kursuna buradan göz atın.
Başlamadan önce, kodu başarıyla çalıştırmak için aşağıdaki kütüphaneleri içe aktardığınızdan emin olun:
from pandas_datareader import data
import matplotlib.pyplot as plt
import pandas as pd
import datetime as dt
import urllib.request, json
import os
import numpy as np

# This code has been tested with TensorFlow 1.6
import tensorflow as tf
from tensorflow.examples.tutorials.mnist import input_data
TensorBoard ile görselleştirme yapmak için önce servisini başlatmanız gerekir. Bunun için,
python3 yazın, >>> benzeri bir istem göreceksinizimport tensorflow as tf deneyin>>>) exit() yazarak çıkın ve aşağıdaki komutu girin
tensorboard --logdir=summaries--logdir, görselleştirmek üzere veri oluşturacağınız dizindir--port=<port_you_like> kullanabilirsinizTensorBoard 1.6.0 at <url>:6006 (Press CTRL+C to quit)Not: TensorBoard aynı dizinde birden fazla event dosyası görmeyi sevmez. Bu, ekranda çok tuhaf eğriler elde etmenize yol açabilir. Bu nedenle her farklı örnek için (örneğin, summaries/first, summaries/second, ...) veri kaydetmek üzere ayrı bir klasör oluşturmalısınız. Aklınızda tutmanız gereken bir diğer nokta da, bir deneyi yeniden çalıştırmak isterseniz (yani, event dosyasını halihazırda dolu bir klasöre kaydetmek), öncelikle mevcut event dosyalarını silmeniz gerektiğidir.
Farklı görünümler farklı biçimlerde girdi alır ve bunları farklı şekilde gösterir. Turuncu üst çubuktan bunlar arasında geçiş yapabilirsiniz.
Bu eğitimde kalın olarak gösterilen görünümleri ele alacaksınız.
Bu bölümde, önce belirli metrikleri (örneğin kayıp veya doğruluk) görselleştirmenin neden faydalı olduğunu anlayacaksınız. Derin sinir ağlarını eğitirken, yeni başlayanların karşılaştığı kritik sorunlardan biri, çeşitli tasarım seçimlerinin ve hiperparametrelerin etkilerini anlayamamaktır.
Örneğin, bir derin sinir ağının ağırlıklarını dikkatsizce çok büyük varyansa sahip olacak şekilde başlatırsanız, modeliniz hızla ıraksar ve çöker. Öte yandan, sinir ağlarını ustalıkla kullanmayı bilseniz bile işler ters gidebilir. Örneğin, öğrenme hızına dikkat etmemek modelin ıraksamasına ya da zamanından önce, optimumun altında bir performansta doygunluğa ulaşmasına neden olabilir.
Modelinizdeki sorunları hızla tespit etmenin bir yolu, modelinizde gerçek zamanlı olarak (örneğin her 100 iterasyonda) neler olup bittiğinin görsel bir temsilini elde etmektir. Böylece modeliniz garip davranıyorsa bu açıkça görülebilir. TensorBoard’un sunduğu şey tam olarak budur. Hangi değerlerin görüntüleneceğine siz karar verirsiniz ve TensorBoard bu değerlerin öğrenme süresince gerçek zamanlı görselleştirmesini sürdürür.
Önce el yazısı rakam görüntülerini sınıflandırmak için kullanacağınız beş katmanlı bir sinir ağı oluşturacaksınız. Bunun için ünlü MNIST veri kümesini kullanacaksınız. TensorFlow, MNIST verisini yüklemek için basit bir API sağlar, böylece veriyi manuel olarak indirmenize gerek kalmaz. Bundan önce, bazı tahminlerin gerçek etiketlere göre doğruluğunu hesaplayan basit bir yöntem (yani, accuracy()) tanımlarsınız.
def accuracy(predictions,labels):
    '''
    Accuracy of a given set of predictions of size (N x n_classes) and
    labels of size (N x n_classes)
    '''
    return np.sum(np.argmax(predictions,axis=1)==np.argmax(labels,axis=1))*100.0/labels.shape[0]
Önce, tek bir optimizasyon/doğrulama veya test adımında örneklediğiniz veri miktarını belirten bir batch_size tanımlayın. Ardından, tanımlayacağınız sinir ağının her bir katmanı için bir tanımlayıcı veren layer_ids’i tanımlarsınız. Sonrasında layer_sizes’ı tanımlayabilirsiniz.
len(layer_sizes) değerinin len(layer_ids)+1 olmasına dikkat edin; çünkü layer_sizes başta girdinin boyutunu da içerir.
MNIST, 28x28 boyutunda görüntülere sahiptir ve tek boyuta açıldığında 784 olur. Daha sonra, modeli eğitmek için kullanacağınız girdi ve etiket placeholder’larını tanımlayabilirsiniz. Son olarak, her katman için iki TensorFlow değişkeni tanımlarsınız (yani, weights ve bias).
Değişken kapsamını (daha fazla bilgi için buraya bakın) kullanabilirsiniz; böylece değişkenler düzgün isimlendirilir ve sonradan erişimleri çok daha kolay olur.
batch_size = 100
layer_ids = ['hidden1','hidden2','hidden3','hidden4','hidden5','out']
layer_sizes = [784, 500, 400, 300, 200, 100, 10]

tf.reset_default_graph()

# Inputs and Labels
train_inputs = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[0]], name='train_inputs')
train_labels = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[-1]], name='train_labels')

# Weight and Bias definitions
for idx, lid in enumerate(layer_ids):

    with tf.variable_scope(lid):
        w = tf.get_variable('weights',shape=[layer_sizes[idx], layer_sizes[idx+1]],
                            initializer=tf.truncated_normal_initializer(stddev=0.05))
        b = tf.get_variable('bias',shape= [layer_sizes[idx+1]],
                            initializer=tf.random_uniform_initializer(-0.1,0.1))
Girdi/çıkış placeholder’ları, her katmanın ağırlıkları ve sapmaları tanımlandığına göre, şimdi sinir ağının logit’lerini hesaplayacak işlemleri tanımlayabilirsiniz. Logit’ler, sinir ağının son katmanında üretilen normalize edilmemiş değerlerdir. Normalize edildiğinde bunlara tahmin denir. Bu, sinir ağındaki her katman boyunca yineleyip tf.matmul(h,w) +b hesaplamayı içerir. Ayrıca son katman hariç tüm katmanlar için tf.nn.relu(tf.matmul(h,w) +b) gibi bir aktivasyon fonksiyonu uygulamanız gerekir.
Sonrasında, sinir ağını optimize etmek için kullanılan kayıp fonksiyonunu tanımlarsınız. Bu örnekte, sınıflandırma problemlerinde ortalama karesel hatadan genellikle daha iyi sonuç veren çapraz entropi kaybını kullanabilirsiniz.
Son olarak, kaybı alan ve sinir ağının ağırlıklarını kaybı en aza indirecek yönde güncelleyen bir optimize edici tanımlamanız gerekir.
# Calculating Logits
h = train_inputs
for lid in layer_ids:
    with tf.variable_scope(lid,reuse=True):
        w, b = tf.get_variable('weights'), tf.get_variable('bias')
        if lid != 'out':
          h = tf.nn.relu(tf.matmul(h,w)+b,name=lid+'_output')
        else:
          h = tf.nn.xw_plus_b(h,w,b,name=lid+'_output')

tf_predictions = tf.nn.softmax(h, name='predictions')
# Calculating Loss
tf_loss = tf.reduce_mean(tf.nn.softmax_cross_entropy_with_logits_v2(labels=train_labels, logits=h),name='loss')

# Optimizer
tf_learning_rate = tf.placeholder(tf.float32, shape=None, name='learning_rate')
optimizer = tf.train.MomentumOptimizer(tf_learning_rate,momentum=0.9)
grads_and_vars = optimizer.compute_gradients(tf_loss)
tf_loss_minimize = optimizer.minimize(tf_loss)
Burada tf.summary nesnelerini tanımlayabilirsiniz. Bu nesneler, TensorBoard’un anladığı varlık türleridir. Yani, hangi değerin görüntülenmesini istiyorsanız onu bir tf.summary nesnesi olarak kapsüllemelisiniz.
Çeşitli özet türleri vardır. Burada yalnızca skalerleri görselleştirdiğiniz için tf.summary.scalar nesneleri tanımlayabilirsiniz. Ayrıca, panoda skalerleri gruplamak için tf.name_scope kullanabilirsiniz. Yani, aynı ad kapsamına sahip skalerler aynı satırda görüntülenecektir. Burada üç farklı özet tanımlarsınız.
tf_loss_summary : bunu panoya göndermeniz gerektiğinde, bir placeholder aracılığıyla bir değer beslersiniztf_accuracy_summary : bunu panoya göndermeniz gerektiğinde, bir placeholder aracılığıyla bir değer beslersiniztf_gradnorm_summary : bu, sinir ağınızın son katmanının gradyanlarının l2 normunu hesaplar. Gradyan normu, sinir ağının ağırlıklarının düzgün güncellenip güncellenmediğinin iyi bir göstergesidir. Çok küçük bir gradyan normu kaybolan gradyanı, çok büyük bir gradyan ise patlayan gradyan olgusunu işaret edebilir.# Name scope allows you to group various summaries together
# Summaries having the same name_scope will be displayed on the same row
with tf.name_scope('performance'):
# Summaries need to be displayed
# Whenever you need to record the loss, feed the mean loss to this placeholder
tf_loss_ph = tf.placeholder(tf.float32,shape=None,name='loss_summary')
# Create a scalar summary object for the loss so it can be displayed
tf_loss_summary = tf.summary.scalar('loss', tf_loss_ph)
# Whenever you need to record the loss, feed the mean test accuracy to this placeholder
tf_accuracy_ph = tf.placeholder(tf.float32,shape=None, name='accuracy_summary')
# Create a scalar summary object for the accuracy so it can be displayed
tf_accuracy_summary = tf.summary.scalar('accuracy', tf_accuracy_ph)
# Gradient norm summary
for g,v in grads_and_vars:
if 'hidden5' in v.name and 'weights' in v.name:
with tf.name_scope('gradients'):
tf_last_grad_norm = tf.sqrt(tf.reduce_mean(g**2))
tf_gradnorm_summary = tf.summary.scalar('grad_norm', tf_last_grad_norm)
break
# Merge all summaries together
performance_summaries = tf.summary.merge([tf_loss_summary,tf_accuracy_summary])
Aşağıdaki kodda şunları yapıyorsunuz. Önce, yukarıda tanımladığınız işlemleri yürüttüğünüz bir oturum oluşturuyorsunuz. Sonra, özet verilerini kaydetmek için bir klasör oluşturuyorsunuz. Ardından bir özet yazıcı summ_writer oluşturuyorsunuz. Artık tüm değişkenleri başlatabilirsiniz. Bunu MNIST veri kümesini yükleme izler.
Daha sonra, her dönem (epoch) ve eğitim verisindeki her yığın (yani her iterasyon) için, ilk iterasyonsa gradnorm_summary’i çalıştırın ve özet yazıcı ile gradnorm_summary’i event dosyasına yazın. Şimdi model optimizasyonunu ve kayıp hesaplamasını yürütürsünüz. Tek bir dönem için tüm eğitim verisinden geçtikten sonra ortalama eğitim kaybını hesaplayın.
Doğrulama veri kümesi için de benzer bir işlemi izlersiniz. Özellikle, doğrulama verisindeki her yığın için doğrulama doğruluğunu hesaplayın. Sonrasında, tam doğrulama kümesi için ortalama doğrulama doğruluğunu hesaplayın.
Son olarak, test aşaması yürütülür. Bu aşamada, test verisindeki her yığın için test doğruluğunu hesaplarsınız. Bununla birlikte, tam test kümesi için ortalama test doğruluğunu hesaplayın. En sonda performance_summaries’i çalıştırıp özet yazıcıyla event dosyasına yazarsınız.
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25

config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure Tensorflow doesn't overflow the GPU

session = tf.InteractiveSession(config=config)

if not os.path.exists('summaries'):
    os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','first')):
    os.mkdir(os.path.join('summaries','first'))

summ_writer = tf.summary.FileWriter(os.path.join('summaries','first'), session.graph)

tf.global_variables_initializer().run()

accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)


for epoch in range(n_epochs):
    loss_per_epoch = []
    for i in range(n_train//batch_size):

        # =================================== Training for one step ========================================
        batch = mnist_data.train.next_batch(batch_size)    # Get one batch of training data
        if i == 0:
            # Only for the first epoch, get the summary data
            # Otherwise, it can clutter the visualization
            l,_,gn_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary],
                                      feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                                 train_labels: batch[1],
                                                tf_learning_rate: 0.0001})
            summ_writer.add_summary(gn_summ, epoch)
        else:
            # Optimize with training data
            l,_ = session.run([tf_loss,tf_loss_minimize],
                              feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                         train_labels: batch[1],
                                         tf_learning_rate: 0.0001})
        loss_per_epoch.append(l)

    print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
    avg_loss = np.mean(loss_per_epoch)

    # ====================== Calculate the Validation Accuracy ==========================
    valid_accuracy_per_epoch = []
    for i in range(n_valid//batch_size):
        valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
        valid_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
        valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))

    mean_v_acc = np.mean(valid_accuracy_per_epoch)
    print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))

    # ===================== Calculate the Test Accuracy ===============================
    accuracy_per_epoch = []
    for i in range(n_test//batch_size):
        test_images, test_labels = mnist_data.test.next_batch(batch_size)
        test_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: test_images.reshape(batch_size,image_size*image_size)}
        )
        accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))

    print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
    avg_test_accuracy = np.mean(accuracy_per_epoch)

    # Execute the summaries defined above
    summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})

    # Write the obtained summaries to the file, so it can be displayed in the TensorBoard
    summ_writer.add_summary(summ, epoch)

session.close()
Successfully downloaded train-images-idx3-ubyte.gz 9912422 bytes.
Extracting MNIST_data/train-images-idx3-ubyte.gz
Successfully downloaded train-labels-idx1-ubyte.gz 28881 bytes.
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Successfully downloaded t10k-images-idx3-ubyte.gz 1648877 bytes.
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Successfully downloaded t10k-labels-idx1-ubyte.gz 4542 bytes.
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 2.30252
    Average Valid Accuracy in epoch 0: 10.02000
    Average Test Accuracy in epoch 0: 9.76000

Average loss in epoch 1: 2.30016
    Average Valid Accuracy in epoch 1: 12.56000
    Average Test Accuracy in epoch 1: 12.64000

  ...
  ...
  ...

Average loss in epoch 24: 1.03386
    Average Valid Accuracy in epoch 24: 71.88000
    Average Test Accuracy in epoch 24: 71.23000
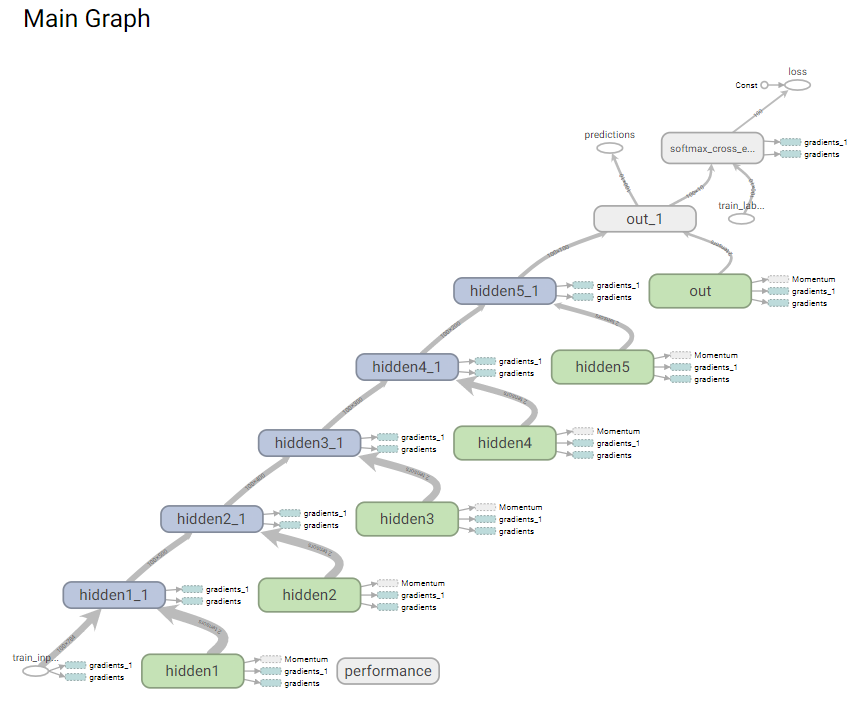
Önce, modelinizin hesaplama grafiğinin nasıl göründüğüne bakacaksınız. Bu görünüme TensorBoard’da Graphs görünümüne tıklayarak erişebilirsiniz. Aşağıdaki görsele benzemelidir. train_inputs’tan loss ve predictions’a, gizli katmanlar 1’den 5’e doğru güzel bir akış olduğunu görebilirsiniz.
MNIST sınıflandırması en basit örneklerden biridir ve yine de 5 katmanlı bir sinir ağı ile çözülememektedir. MNIST için 5 dönemden daha kısa sürede %90’ın üzerinde bir doğruluğa ulaşmak zor değildir.
Peki burada neler oluyor?
TensorBoard’a bir bakalım:
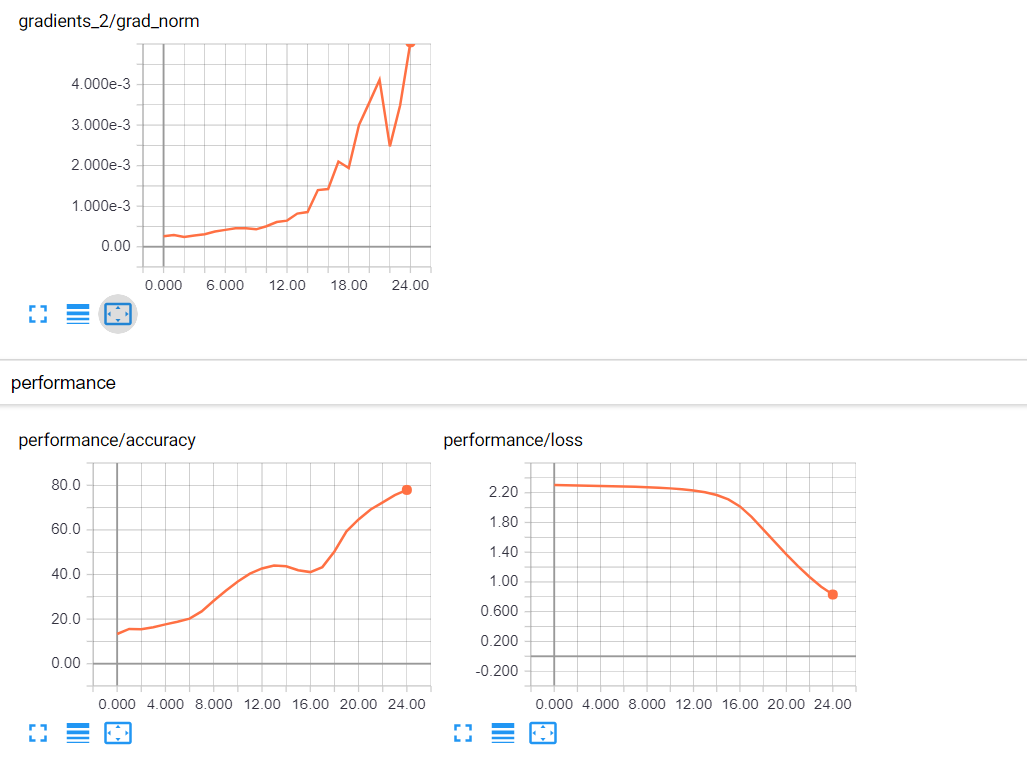
Doğruluğun arttığını, ancak çok yavaş arttığını ve gradyan güncellemelerinin zaman içinde yükseldiğini görebilirsiniz. Bu tuhaf bir davranıştır. Yakınsamaya yaklaşıyorsanız, gradyanların artması değil, azalması (sıfıra yaklaşması) gerekir. Ancak doğruluk yükseldiği için doğru yoldasınız. Muhtemelen daha yüksek bir öğrenme hızına ihtiyacınız var.
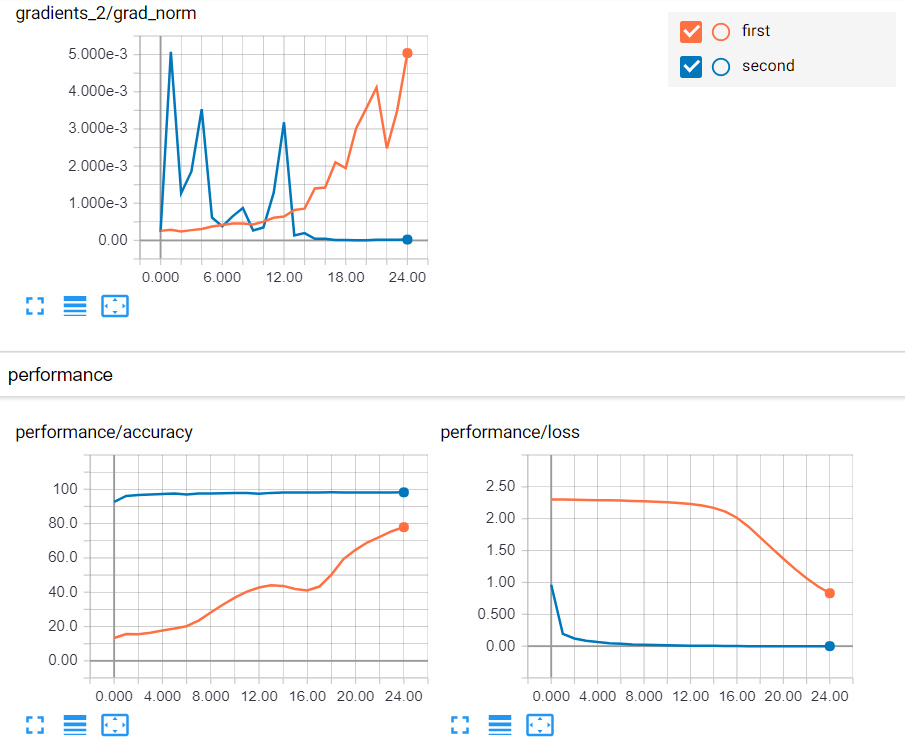
Şimdi 0.01 öğrenme hızını deneyebilirsiniz. Bu, sinir ağının önceki çalıştırmasına neredeyse aynıdır; tek fark 0.0001 yerine 0.01 kullanacak olmanızdır. tf_learning_rate: 0.0001 yerine tf_learning_rate: 0.01 kullanın. Değiştirmeniz gereken iki yer olduğuna dikkat edin.
Artık doğruluğun 100’e yakın başladığını ve yükselmeye devam ettiğini görebilirsiniz. Ayrıca gradyan güncellemelerinin zamanla azalarak sıfıra yaklaştığını da görüyorsunuz. 0.01 öğrenme hızıyla işler çok daha iyi görünüyor.
Sırada skalerlerin ötesine geçmek var. Skaler vektörlerini ve skaler koleksiyonlarını nasıl analiz edebileceğinizi göreceksiniz.
TensorBoard aracılığıyla skalerleri görselleştirmenin faydasını gördünüz; bu sayede modelin nasıl davrandığını görebildiniz ve modelle ilgili potansiyel sorunları düzeltebildiniz. Ayrıca, grafiği görselleştirmek, girdilerden tahminlere kesintisiz bir bağlantı olduğunu görmenizi sağladı; bu, gradyan hesaplamaları için gereklidir.
Şimdi, TensorBoard’daki bir başka kullanışlı görünümü göreceksiniz; histogramlar veya dağılımlar.
Unutmayın ki histogram, koleksiyondaki bir değerin sahip olduğu sıklık/yoğunluk ile temsil edilen değerler koleksiyonudur. Zaman içinde ağ ağırlık değerlerini görselleştirmek için histogramları kullanabilirsiniz. Ağ ağırlıklarını görselleştirmek önemlidir; çünkü öğrenme sırasında ağırlıklar oradan oraya vahşice sıçrıyorsa, bu ağırlık başlatmada veya öğrenme hızında bir sorun olduğuna işaret eder.
Örnekte ağırlıkların nasıl değiştiğini göreceksiniz. Koda bakarsanız, ağırlıkları başlatmak için truncated_normal_initializer() kullandığını görürsünüz.
Burada yine tf.summary nesnelerini tanımlarsınız. Ancak, şimdi skaler vektörlerini görselleştirdiğiniz için tf.summary.histogram nesneleri tanımlamanız gerekir.
Bu durumda, belirli bir katmanın ağırlıklarını ve sapmalarını içeren iki histogram nesnesi (tf_w_hist ve tf_b_hist) tanımlarsınız. Tüm katmanlar için bu tür histogram nesneleri tanımlayacak ve her katmanın kendi ad kapsamı olacaktır.
Son olarak, bu özetlerin tümünü tek seferde çalıştıran gruplandırılmış bir işlem oluşturmak için tf.summary.merge işlemini kullanabilirsiniz.
# Summaries need to be displayed
# Create a summary for each weight bias in each layer
all_summaries = []
for lid in layer_ids:
    with tf.name_scope(lid+'_hist'):
        with tf.variable_scope(lid,reuse=True):
            w,b = tf.get_variable('weights'), tf.get_variable('bias')

            # Create a scalar summary object for the loss so it can be displayed
            tf_w_hist = tf.summary.histogram('weights_hist', tf.reshape(w,[-1]))
            tf_b_hist = tf.summary.histogram('bias_hist', b)
            all_summaries.extend([tf_w_hist, tf_b_hist])

# Merge all parameter histogram summaries together
tf_param_summaries = tf.summary.merge(all_summaries)
Bu adım, daha önce yaptığınıza neredeyse aynıdır; ancak burada histogram özetlerini (yani, tf_param_summaries) hesaplamak için birkaç ek satırınız var.
Not öğrenme hızları da yine değişti.
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25

config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure Tensorflow doesn't overflow the GPU

session = tf.InteractiveSession(config=config)

if not os.path.exists('summaries'):
    os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','third')):
    os.mkdir(os.path.join('summaries','third'))

summ_writer_3 = tf.summary.FileWriter(os.path.join('summaries','third'), session.graph)

tf.global_variables_initializer().run()

accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)


for epoch in range(n_epochs):
    loss_per_epoch = []
    for i in range(n_train//batch_size):

        # =================================== Training for one step ========================================
        batch = mnist_data.train.next_batch(batch_size)    # Get one batch of training data
        if i == 0:
            # Only for the first epoch, get the summary data
            # Otherwise, it can clutter the visualization
            l,_,gn_summ, wb_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary, tf_param_summaries],
                                      feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                                 train_labels: batch[1],
                                                tf_learning_rate: 0.00001})
            summ_writer_3.add_summary(gn_summ, epoch)
            summ_writer_3.add_summary(wb_summ, epoch)
        else:
            # Optimize with training data
            l,_ = session.run([tf_loss,tf_loss_minimize],
                              feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                         train_labels: batch[1],
                                         tf_learning_rate: 0.01})
        loss_per_epoch.append(l)

    print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
    avg_loss = np.mean(loss_per_epoch)

    # ====================== Calculate the Validation Accuracy ==========================
    valid_accuracy_per_epoch = []
    for i in range(n_valid//batch_size):
        valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
        valid_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
        valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))

    mean_v_acc = np.mean(valid_accuracy_per_epoch)
    print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))

    # ===================== Calculate the Test Accuracy ===============================
    accuracy_per_epoch = []
    for i in range(n_test//batch_size):
        test_images, test_labels = mnist_data.test.next_batch(batch_size)
        test_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: test_images.reshape(batch_size,image_size*image_size)}
        )
        accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))

    print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
    avg_test_accuracy = np.mean(accuracy_per_epoch)

    # Execute the summaries defined above
    summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})

    # Write the obtained summaries to the file, so they can be displayed
    summ_writer_3.add_summary(summ, epoch)

session.close()
Extracting MNIST_data/train-images-idx3-ubyte.gz
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 1.02625
    Average Valid Accuracy in epoch 0: 92.76000
    Average Test Accuracy in epoch 0: 92.65000

Average loss in epoch 1: 0.19110
    Average Valid Accuracy in epoch 1: 95.80000
    Average Test Accuracy in epoch 1: 95.48000

  ...
  ...
  ...

Average loss in epoch 24: 0.00009
    Average Valid Accuracy in epoch 24: 98.28000
    Average Test Accuracy in epoch 24: 98.09000
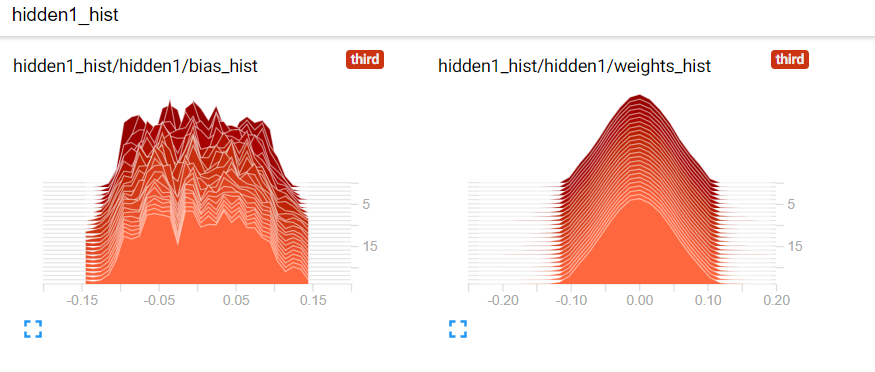
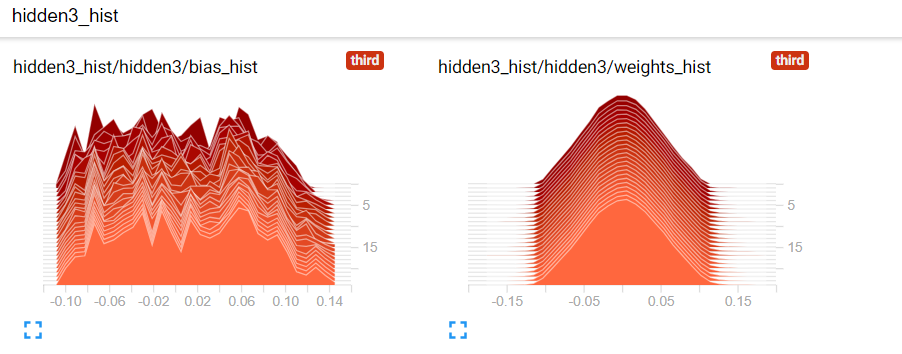
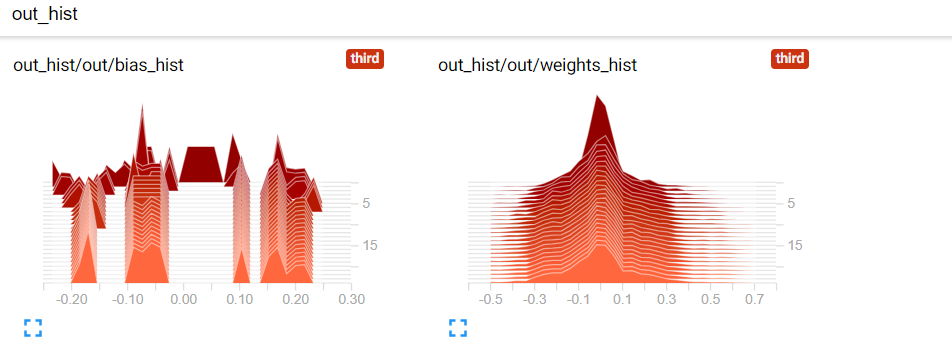
Ağırlıklarınızın ve sapmalarınızın nasıl göründüğü şöyledir. Önce 3 ekseniniz var; zaman (x ekseni), değer (y ekseni) ve değerlerin sıklığı/yoğunluğu (z ekseni). Daha koyu histogramlar daha eski verileri, daha açık histogramlar daha yeni verileri temsil eder. Z eksenindeki daha yüksek bir değer, vektörün belirli bir değerin yakınında daha fazla değer içerdiği anlamına gelir.
Not: Zaman içindeki histogramların bir "bindirme" görünümü de vardır. Sol taraftaki seçenek panelinden görüntüleme türünü değiştirebilirsiniz.
Şimdi truncated_normal_initializer() yerine ağırlıkları başlatmak için xavier_initializer() kullanacaksınız. Xavier başlatma, özellikle derin sinir ağları için çok daha iyi bir başlatma tekniğidir.
Bunun nedeni, kullanıcı tanımlı bir standart sapma kullanmak yerine (ki truncated_normal_initializer() kullanırken yaptığınız buydu), Xavier başlatmanın standart sapmayı bir katmana gelen ve giden bağlantı sayısına göre otomatik olarak belirlemesidir. Bu da kaybolan gradyan gibi sorunlar olmadan gradyanların üstten alta akmasına yardımcı olur. Ardından modeli tekrar tanımlarsınız.
Önce, tek bir optimizasyon/doğrulama veya test adımında örneklediğiniz veri miktarını belirten bir batch_size tanımlarsınız. Sonra, tanımlayacağınız sinir ağının her katmanı için tanımlayıcı veren layer_ids’i tanımlayabilirsiniz.
Sonrasında layer_sizes’ı tanımlayabilirsiniz. len(layer_sizes) değerinin len(layer_ids)+1 olması gerektiğine dikkat edin; çünkü layer_sizes başta girdinin boyutunu içerir. MNIST 28x28 boyutunda görüntülere sahiptir; tek boyuta açıldığında 784 olur.
Daha sonra, modeli eğitmek için kullanacağınız girdi ve etiket placeholder’larını tanımlayabilirsiniz. Son olarak, her katman için iki TensorFlow değişkeni tanımlarsınız (yani, weights ve bias).
Not: Bu, ilk seferde kullandığınız kodla aynıdır; yalnızca ağırlıklar için kullanılan başlatma tekniği farklıdır
batch_size = 100
layer_ids = ['hidden1','hidden2','hidden3','hidden4','hidden5','out']
layer_sizes = [784, 500, 400, 300, 200, 100, 10]

tf.reset_default_graph()

# Inputs and Labels
train_inputs = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[0]], name='train_inputs')
train_labels = tf.placeholder(tf.float32, shape=[batch_size, layer_sizes[-1]], name='train_labels')

# Weight and Bias definitions
for idx, lid in enumerate(layer_ids):

    with tf.variable_scope(lid):
        w = tf.get_variable('weights',shape=[layer_sizes[idx], layer_sizes[idx+1]],
                            initializer=tf.contrib.layers.xavier_initializer())
        b = tf.get_variable('bias',shape= [layer_sizes[idx+1]],
                            initializer=tf.random_uniform_initializer(-0.1,0.1))
Girdi/çıkış placeholder’ları, ağırlıklar ve her katmanın sapmaları tanımlandığına göre, şimdi sinir ağının logit’lerini yeniden hesaplayacak işlemleri tanımlayabilirsiniz.
Not: Bu kısım, bu işlemleri ve tensörleri ilk tanımladığınız zamanki kodla aynıdır.
Burada tf.summary nesnelerini yeniden tanımlayabilirsiniz. Bu da bu işlemleri ve tensörleri ilk kez tanımladığınız zamanki kodla aynıdır.
Burada yine tf.summary nesnelerini tanımlarsınız. Ancak, artık skaler vektörlerini görselleştirdiğiniz için tf.summary.histogram nesneleri tanımlamanız gerekir.
Not bu, bu işlemleri ve tensörleri ilk tanımladığınız zamanki kodla aynıdır.
Not bu, önceki bölümde yaptıklarınızla aynıdır!
Yalnızca birkaç satırı değiştirmeniz gerekir: os.path.join('summaries','third') ifadesinin geçtiği üç yeri os.path.join('summaries','fourth') ile, summ_writer_3’ü (4 kez geçer) summ_writer_4 ile ve 0.00001 olan tf_learning_rate’i 0.01 ile değiştirin.
image_size = 28
n_channels = 1
n_classes = 10
n_train = 55000
n_valid = 5000
n_test = 10000
n_epochs = 25

config = tf.ConfigProto(allow_soft_placement=True)
config.gpu_options.allow_growth = True
config.gpu_options.per_process_gpu_memory_fraction = 0.9 # making sure TensorFlow doesn't overflow the GPU

session = tf.InteractiveSession(config=config)

if not os.path.exists('summaries'):
    os.mkdir('summaries')
if not os.path.exists(os.path.join('summaries','fourth')):
    os.mkdir(os.path.join('summaries','fourth'))

summ_writer_4 = tf.summary.FileWriter(os.path.join('summaries','fourth'), session.graph)

tf.global_variables_initializer().run()

accuracy_per_epoch = []
mnist_data = input_data.read_data_sets('MNIST_data', one_hot=True)


for epoch in range(n_epochs):
    loss_per_epoch = []
    for i in range(n_train//batch_size):

        # =================================== Training for one step ========================================
        batch = mnist_data.train.next_batch(batch_size)    # Get one batch of training data
        if i == 0:
            # Only for the first epoch, get the summary data
            # Otherwise, it can clutter the visualization
            l,_,gn_summ, wb_summ = session.run([tf_loss,tf_loss_minimize,tf_gradnorm_summary, tf_param_summaries],
                                      feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                                 train_labels: batch[1],
                                                tf_learning_rate: 0.01})
            summ_writer_4.add_summary(gn_summ, epoch)
            summ_writer_4.add_summary(wb_summ, epoch)
        else:
            # Optimize with training data
            l,_ = session.run([tf_loss,tf_loss_minimize],
                              feed_dict={train_inputs: batch[0].reshape(batch_size,image_size*image_size),
                                         train_labels: batch[1],
                                         tf_learning_rate: 0.01})
        loss_per_epoch.append(l)

    print('Average loss in epoch %d: %.5f'%(epoch,np.mean(loss_per_epoch)))
    avg_loss = np.mean(loss_per_epoch)

    # ====================== Calculate the Validation Accuracy ==========================
    valid_accuracy_per_epoch = []
    for i in range(n_valid//batch_size):
        valid_images,valid_labels = mnist_data.validation.next_batch(batch_size)
        valid_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: valid_images.reshape(batch_size,image_size*image_size)})
        valid_accuracy_per_epoch.append(accuracy(valid_batch_predictions,valid_labels))

    mean_v_acc = np.mean(valid_accuracy_per_epoch)
    print('\tAverage Valid Accuracy in epoch %d: %.5f'%(epoch,np.mean(valid_accuracy_per_epoch)))

    # ===================== Calculate the Test Accuracy ===============================
    accuracy_per_epoch = []
    for i in range(n_test//batch_size):
        test_images, test_labels = mnist_data.test.next_batch(batch_size)
        test_batch_predictions = session.run(
            tf_predictions,feed_dict={train_inputs: test_images.reshape(batch_size,image_size*image_size)}
        )
        accuracy_per_epoch.append(accuracy(test_batch_predictions,test_labels))

    print('\tAverage Test Accuracy in epoch %d: %.5f\n'%(epoch,np.mean(accuracy_per_epoch)))
    avg_test_accuracy = np.mean(accuracy_per_epoch)

    # Execute the summaries defined above
    summ = session.run(performance_summaries, feed_dict={tf_loss_ph:avg_loss, tf_accuracy_ph:avg_test_accuracy})

    # Write the obtained summaries to the file, so they can be displayed
    summ_writer_4.add_summary(summ, epoch)

session.close()
Extracting MNIST_data/train-images-idx3-ubyte.gz
Extracting MNIST_data/train-labels-idx1-ubyte.gz
Extracting MNIST_data/t10k-images-idx3-ubyte.gz
Extracting MNIST_data/t10k-labels-idx1-ubyte.gz
Average loss in epoch 0: 0.43618
    Average Valid Accuracy in epoch 0: 95.70000
    Average Test Accuracy in epoch 0: 95.22000

Average loss in epoch 1: 0.12872
    Average Valid Accuracy in epoch 1: 96.86000
    Average Test Accuracy in epoch 1: 96.71000

  ...
  ...
  ...

Average loss in epoch 24: 0.00009
    Average Valid Accuracy in epoch 24: 98.42000
    Average Test Accuracy in epoch 24: 98.21000
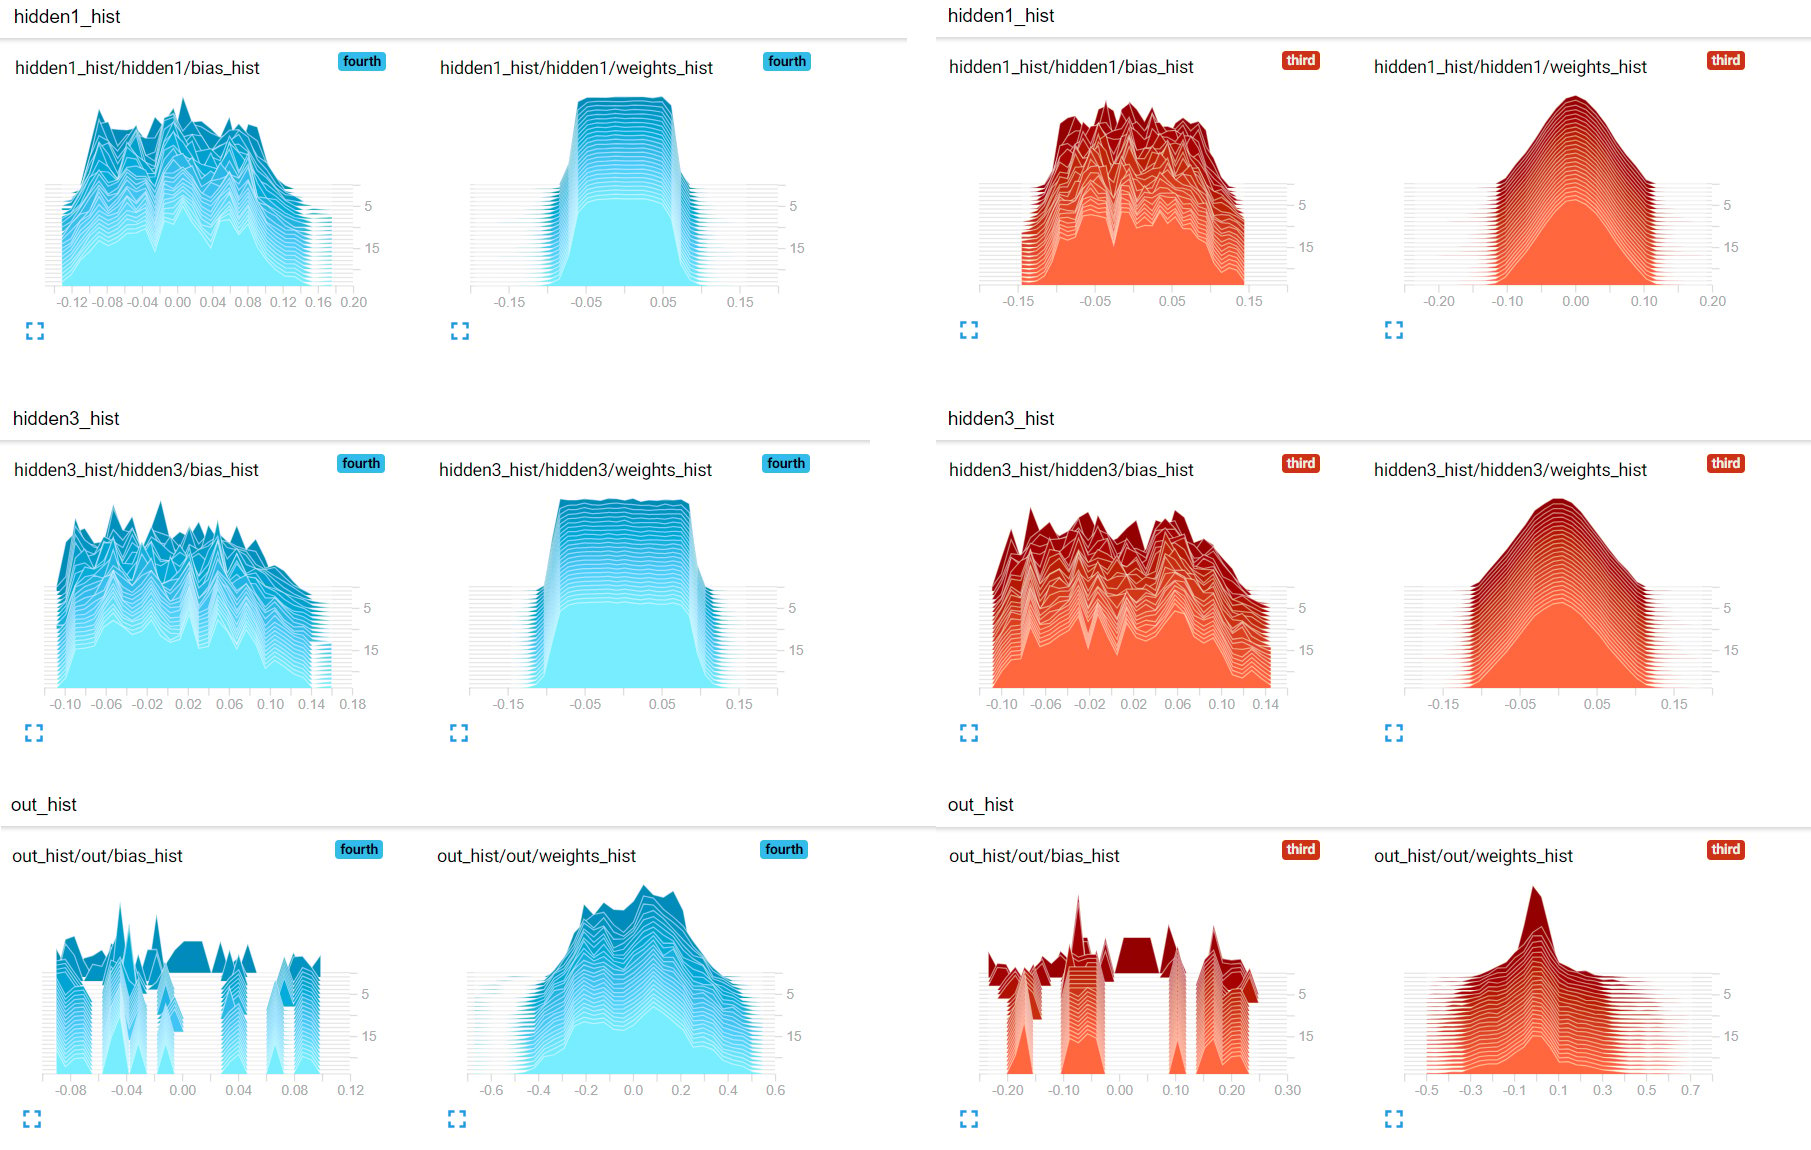
Burada, iki farklı başlatma için ağırlıkların zaman içindeki evrimini karşılaştırabilirsiniz; truncated_normal_initializer (kırmızı) ve xavier_initializer (mavi). xavier_initializer’ın, normal başlatıcıya kıyasla daha fazla ağırlığı sıfırdan uzakta tuttuğunu görebilirsiniz; bu daha iyi bir yaklaşımdır. Bu, kayıp/doğruluk eğrilerinin de gösterdiği üzere, Xavier ile başlatılan sinir ağlarının daha hızlı yakınsamasına olanak sağlayabilir.
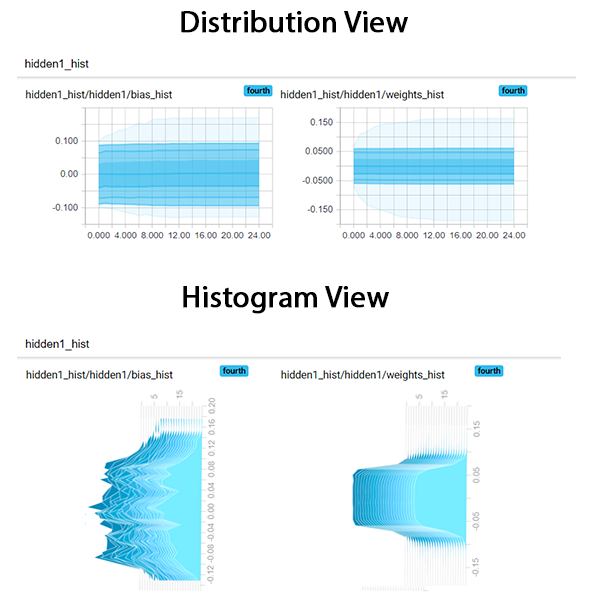
Şimdi iki görünüm arasındaki farkı karşılaştırabilirsiniz; histogram görünümü ve dağılım görünümü. Dağılım görünümü özünde histogramlara farklı bir bakış açısıdır. Aşağıdaki görsele bakarsanız, dağılım görünümünün histogram görünümünün üstten görünümü olduğunu kolayca görebilirsiniz. Benzerliği kolayca görebilmek için histogram grafiklerinin bu durumda döndürüldüğüne dikkat edin.
Bu eğitimde TensorBoard’un nasıl kullanılacağını gördünüz. Önce, komut istemi (Windows) veya terminal (Ubuntu/Mac) üzerinden servisini nasıl başlatacağınızı öğrendiniz. Ardından, TensorBoard’un sunduğu farklı veri görünümlerine baktınız. Daha sonra, skaler değerleri (örneğin kayıp/doğruluk) görselleştiren koda göz attınız ve skaler değer görselleştirmenin kullanımını somut olarak anlamak için ileri beslemeli bir sinir ağı modeli kullandınız.
Ardından, histogram görünümünü kullanarak skaler koleksiyonlarını/vektörlerini nasıl görselleştirebileceğinizi keşfettiniz. Bunu, histogram görünümünü kullanarak sinir ağı ağırlık başlatma teknikleri arasındaki farkları vurgulayan bir karşılaştırma izledi.
Son olarak, dağılım görünümü ile histogram görünümü arasındaki benzerlikleri tartıştınız.
Derin öğrenme hakkında daha fazla bilgi edinmek isterseniz, Keras ile Derin Öğrenme kursumuza mutlaka göz atın.
Parametreler ve hiperparametreler hakkında daha fazla bilgi edinmek için Makine Öğrenmesi Modellerinde Hiperparametre Optimizasyonu eğitimimize göz atın.
Benimle iletişime geçmek isterseniz, bana thushv@gmail.com adresinden e‑posta gönderebilir veya LinkedIn üzerinden bağlantı kurabilirsiniz.
Makine Öğrenmesi ve Derin Öğrenme hakkında daha fazlasını öğrenin
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




