Kurs
Machine Learning'i Anlamak
2 sa
310.7K
Bu blog yazısı, ‘transfer learning’ kavramını ve makine öğrenimi uygulamalarında nasıl kullanıldığını tanıtacak. Transfer learning bir makine öğrenimi modeli ya da tekniği değildir; daha ziyade makine öğrenimi içinde bir ‘tasarım metodolojisidir’. Başka bir ‘tasarım metodolojisi’ örneği de aktif öğrenmedir.
Bir sonraki blog yazısı, mevcut (ve yeni) verileri en iyi şekilde kullanmak için aktif öğrenmeyi transfer learning ile birlikte nasıl kullanabileceğinizi açıklayacak. Geniş anlamda, performansı veya genelleme yeteneklerini artırmak için harici bilgiden yararlanan makine öğrenimi uygulamaları transfer learning kullanır.
Transfer learning’in genel fikri, bol miktarda etiketli verinin bulunduğu görevlerden öğrenilen bilgiyi, yalnızca az miktarda etiketli verinin olduğu ortamlarda kullanmaktır. Etiketli veri oluşturmak maliyetlidir; bu yüzden mevcut veri kümelerinden en iyi şekilde yararlanmak kilittir.
Geleneksel bir makine öğrenimi modelinde birincil amaç, eğitim verilerinden öğrenilen örüntülere dayanarak görülmemiş veriye genelleme yapmaktır. Transfer learning ile bu genelleme sürecini, farklı bir görev için öğrenilmiş örüntülerden başlayarak hızlandırmaya çalışırsınız. Özünde, öğrenme sürecine (genellikle rastgele başlatılan) boş bir sayfadan başlamak yerine, başka bir görevi çözmek için öğrenilmiş örüntülerden başlarsınız.
Bilgi ve örüntülerin aktarımı çok çeşitli alanlarda mümkündür. Bugünkü yazı, bu farklı alanlardan birkaç örneğe bakarak transfer learning’i somutlaştıracak. Amaç, veri bilimcileri makine öğrenimi projelerinde transfer learning ile denemeler yapmaya teşvik etmek ve artılarını ile eksilerini fark etmelerini sağlamaktır.
Transfer learning’i iyi anlamanın bir veri bilimci olarak kritik bir beceri olduğuna inanmamın üç nedeni var:
 |
 |
Adının da belirttiği gibi, transfer learning bir alandan diğerine bilgi aktarabilme yeteneği gerektirir. Transfer learning üst düzeyde yorumlanabilir; örneğin birçok NLP problemi doğası gereği dizi tahmini problemine indirgenebildiğinden, NLP model mimarileri dizi tahmini problemlerinde yeniden kullanılabilir. Transfer learning düşük düzeyde de yorumlanabilir; burada bir modelin parametrelerini başka bir modelde gerçekten yeniden kullanırsınız (skip-gram, continuous bag-of-words, vb.). Transfer learning’in gereksinimleri bir yandan probleme, diğer yandan modele özeldir. Sonraki iki bölüm sırasıyla transfer learning’e üst düzey ve düşük düzey bir yaklaşımı ele alacaktır. Literatürde bu kavramları farklı isimlerle görseniz de transfer learning’in kapsayıcı konsepti değişmez.
Çok görevli öğrenmede bir modeli aynı anda farklı görevlerde eğitirsiniz. Genellikle esnek şekilde uyarlanabildikleri için derin öğrenme modelleri kullanılır.
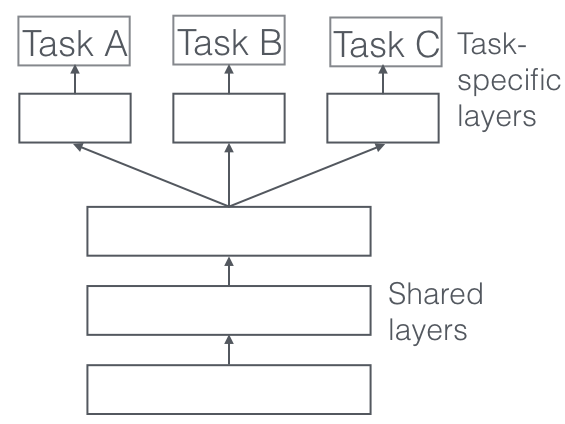
Ağ mimarisi, ilk katmanların farklı görevler arasında kullanıldığı, ardından farklı görevlere özel katmanlar ve çıktılarla devam edildiği şekilde uyarlanır. Genel fikir şudur: Bir ağı farklı görevlerde eğiterek, modelin benzer ‘bilgi’ ya da ‘işleme’ gerektiren görevlerde iyi performans göstermesi beklendiğinden, ağ daha iyi genelleyebilir.
Doğal Dil İşleme örneğinde, nihai hedefi varlık tanıma yapmak olan bir model düşünün. Modeli yalnızca varlık tanıma görevinde eğitmek yerine, onu aynı zamanda sözcük türü sınıflandırması, bir sonraki sözcüğü tahmin etme, ... gibi görevlerde de kullanırsınız. Böylece model bu görevlerden ve farklı veri kümelerinden öğrendiği yapıdan fayda sağlar. Sebastian Ruder’ın bu blogunu ve çok görevli öğrenmeyi ele alan şu blogu şiddetle öneririm.
Derin öğrenme modelinin büyük avantajlarından biri, özellik çıkarımının ‘otomatik’ olmasıdır. Etiketli veri ve geri yayılım sayesinde ağ, bir görev için yararlı özellikleri belirleyebilir. Ağ, örneğin bir görüntüyü sınıflandırmak için girdinin hangi kısmının önemli olduğunu ‘kendi kendine çözer’. Bu, özelliği elle tanımlama işinin soyutlandığı anlamına gelir. Derin öğrenme ağları diğer problemlerde yeniden kullanılabilir; çünkü çıkarılan özellik türleri çoğu zaman başka problemler için de kullanışlıdır. Özünde, bir özellik çıkarıcıda ağın ilk katmanlarını yararlı özellikleri belirlemek için kullanırsınız, ancak çıktı katmanı göreve fazla özgü olduğundan ağın çıktısını kullanmazsınız.
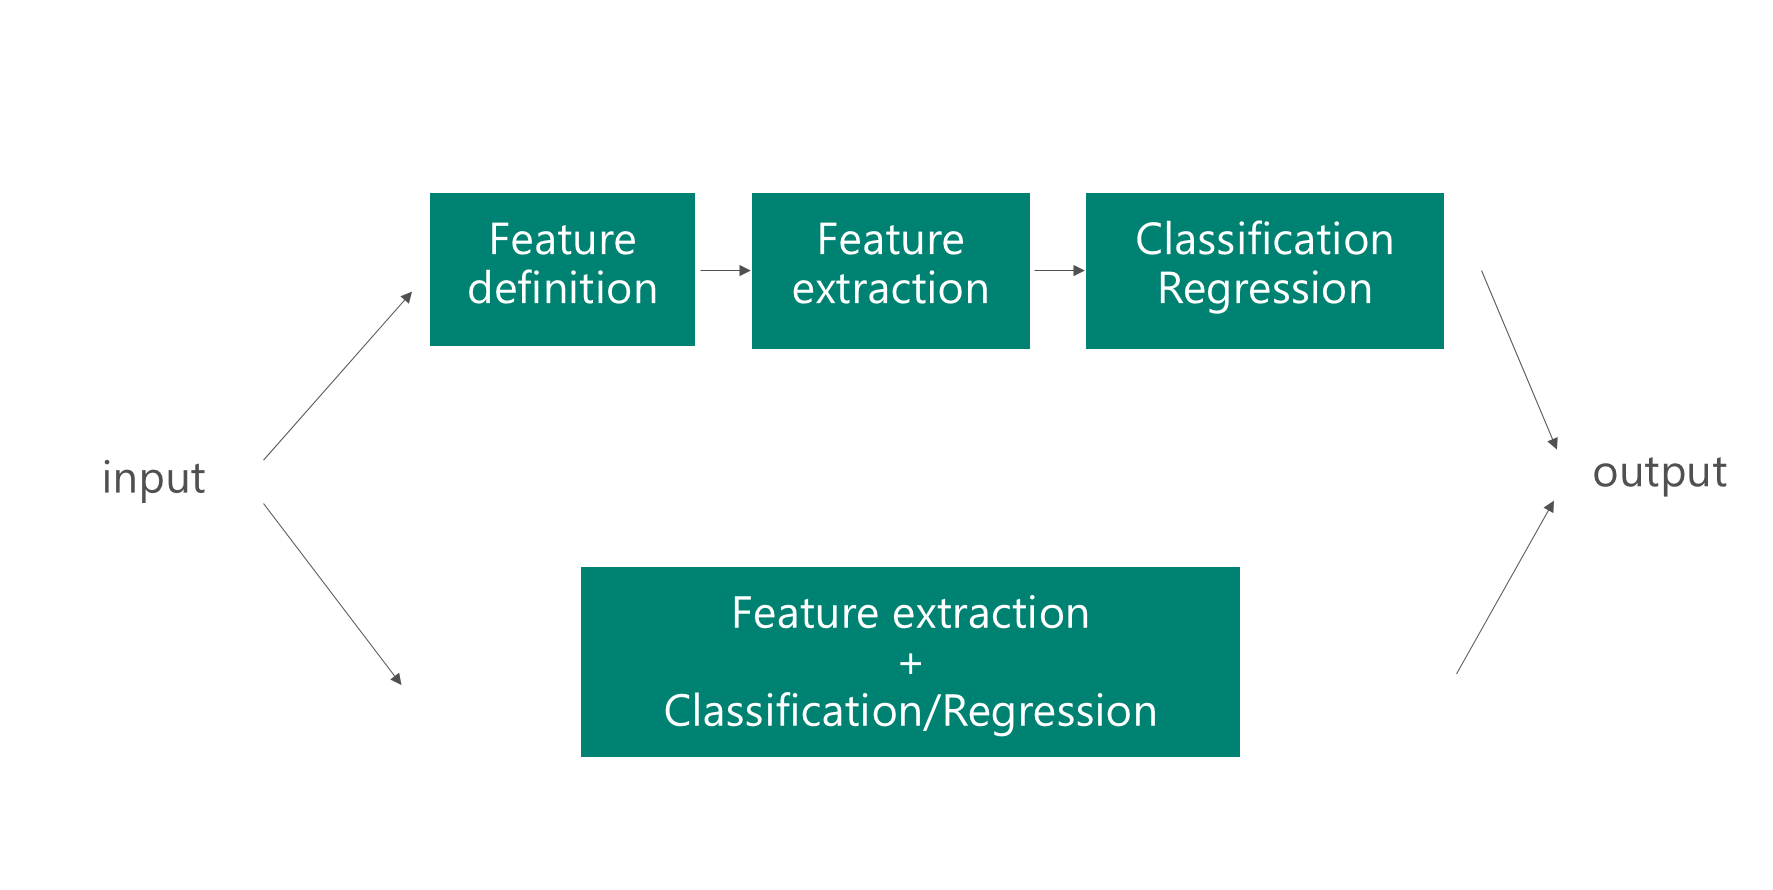
Derin öğrenme sistemleri özellik çıkarmada iyiyken, mevcut ağları diğer görevler için özellik çıkarımı yapmak üzere nasıl yeniden kullanabilirsiniz? Bir veri örneğini ağa beslemek ve ağdaki ara katmanlardan birini çıktı olarak almak mümkündür. Bu ara katman, ham verinin sabit uzunlukta, işlenmiş bir temsili olarak yorumlanabilir. Genellikle özellik çıkarıcı kavramı bilgisayarlı görü bağlamında kullanılır. Görüntüler, önceden eğitilmiş bir ağa (ör. VGG veya AlexNet) beslenir ve yeni veri temsilinde farklı bir makine öğrenimi yöntemi kullanılır. Bir görüntünün temsili olarak ara bir katmanı çıkarmak, orijinal veri boyutunu önemli ölçüde azaltır; bu da onları geleneksel makine öğrenimi teknikleri için daha elverişli hale getirir (örneğin, lojistik regresyon veya SVM’ler, 128 gibi küçük boyutlu bir görüntü temsilinde genellikle 128x128=16384 gibi orijinal boyuttan daha iyi çalışır).
Önceki blog yazılarımdan biri, günümüzde birçok NLP işlem hattının sözcük gömmelerini nasıl kullandığını ele almıştı. Bu sözcük gömmeleri, one-hot kodlamalara kıyasla sözcükleri temsil etmenin daha bilgilendirici bir yoludur. Yaygın olarak kullanılırlar ve farklı varyantları vardır. Genellikle bu varyantlar, geldikleri derleme (Vikipedi, haber makaleleri vb.) ve gömme modellerindeki farklılıklarla ayrışır. Sözcük gömmeleriyle transfer learning’in mantıklı olup olmadığını bilmek için bu modellerin ve derlemelerin arka planını anlamak önemlidir. İnsanlar genellikle sözcük gömmelerini kullanmayı transfer learning olarak adlandırmaz; ancak ben, bilgisayarlı görü ile transfer learning’e olan benzerlik nedeniyle aynı fikirde değilim. Özünde, sözcük gömmelerini kullanmak, sözcükleri vektöre dönüştürmek için bir özellik çıkarıcı ya da gömme ağını kullanmak demektir.
word2vec 4 yaşında olsa da hâlâ çok etkili bir sözcük gömme yaklaşımıdır. Öte yandan, FastText gibi yeni yaklaşımlar çok sayıda dilde sözcük gömmelerini erişilebilir kıldı. word2vec veya FastText’ten gelen gömmeler, kelime torbası yaklaşımlarına kıyasla önemli bir adımdır. Yine de, faydaları genellikle problem alanı tarafından belirlenir.
Satış temsilcileri için bir haber öneri servisi oluşturduğunuzu hayal edin. Satış ekipleri, sattıkları ürünle ilgilenebilecek şirketler hakkında haber almak istiyor. Haber makalelerinde kullanılan kelime dağarcığı genellikle oldukça genel olur; yani çoğu sözcük gömme modelinin (eğitildikleri derlemeye bağlı olarak) desteklediği bir söz varlığı kullanılır. Ayrıca, satış temsilcilerinin birkaç hafta boyunca okudukları haberleri toplamasını sağlarsanız, elinizde hızla büyük bir etiketli derlem olur. Sözcük gömmelerini yeniden kullanabilmek, öneri motorunun performansını önemli ölçüde artırabilir.
Öte yandan, hukuki sözleşmeler üzerinde konu sınıflandırması yapmanız gerektiğini düşünün. Sıradan hukuki sözleşmeler değil; rekabet hukuku bağlamında Fransızca sözleşmeler. Bu tür veri kümeleri genellikle etiketlenmemiştir ya da yalnızca sınırlı sayıda etiketli belge mevcuttur. Aşağıdaki bölüm, kutudan çıktığı hâliyle transfer learning’in bu durumda neden yalnızca bir yere kadar işe yarayacağını açıklar:
Sözcük gömmelerinin güncel durumu ile ilgili bu mükemmel blog yazısını okumanızı önemle tavsiye ederim. Bu yazıda belirtilen sorun ve çözümleri dikkate almak, sınırlı veri miktarıyla çalışırken sağlam NLP sistemleri ve sözcük gömmeleri oluşturmanın anahtarıdır.
Gensim, spacy ve FastText, makine öğrenimi uygulamanızda sözcük gömmelerini hızlıca kullanmanıza olanak sağlayan üç harika çerçevedir. Ayrıca özel sözcük gömmelerinin eğitimini de desteklerler. Daha fazlasını öğrenmek için şu gensim, şu spacy veya şu FastText eğitimine göz atın!
Derin öğrenme yöntemleri bilgisayarlı göründe önemli başarılara yol açtı. Probleme özgü özellikleri (örneğin, Yönelimli Gradyan Histogramı — HoG, histogram özellikleri vb.) elle tanımlamak yerine, derin öğrenme uygulayıcıların ham görüntüleri girdi olarak alan modeller eğitmesini sağlar. Özellik tanımlama konusundaki özgün karmaşıklık artık ağ tanımlamanın karmaşıklığına kaydı. Mimariiler sıklıkla yeniden kullanılsa da ağ mimarisini kurmada tek bir strateji yoktur. Genellikle derin öğrenme teknikleri, performansı artırmak amacıyla giderek daha derin ve karmaşık mimariler geliştiren araştırma ortamlarında devasa veri setlerinde (ör. Imagenet veya MS Coco) icat edilip uygulanmıştır. Bu mimariler, küçük görüntü veri kümeleri için (tipik olarak) ölçeklenebilir olmayan, milyonlarca parametreli modellere yol açar. 5.000’den az görüntü içeren bir veri kümesinde ResNet veya VGG gibi bir mimariyi eğitmek, belirgin aşırı öğrenmeye neden olacaktır. Son dönem derin öğrenme eğilimi önemli ilerlemeler sağladı; ancak küçük veri kümelerine sahip veri bilimciler adeta soğukta bırakılmış gibi görünüyor.
Görüldüğü üzere, derin öğrenme ağları hiyerarşik özellik temsilleri öğrenir (bkz. Distill’in şu blog yazısı). Bu, alt düzey katmanların kenar gibi düşük düzey özellikleri, üst düzey katmanların ise şekiller gibi daha yüksek düzey ancak yorumlanamaz kavramları öğrendiği anlamına gelir. Hiyerarşik temsil fikri, ağ farklı veri kümelerinde eğitildiğinde de ortaya çıkar; bu da farklı problem alanlarında yeniden kullanılabileceklerini gösterir.
Bilgisayarlı görü problemlerinde transfer learning kullanırken iki yaklaşım öne çıkar.
Keras’ın API’si, önceden eğitilmiş ağları yüklemenize ve eğitim sırasında birkaç katmanı sabit tutmanıza olanak tanır. Sonraki bölümde yine iki kullanım senaryosunu ele alacağım: Biri transfer learning’in yararlı olduğu, diğeri ise olmadığı bir durum.
Yaban hayatını korumada çalıştığınızı ve canlı kamera akışında görünen farklı hayvanları sınıflandırmak istediğinizi hayal edin. Özellikle nesli tükenme tehlikesi altındaki türleri izlemeye çalışıyorsanız, çok sayıda etiketli veri toplayamayabilirsiniz. Önceden eğitilmiş ağlar genellikle yiyeceklerden hayvanlara ve nesnelere kadar geniş bir kavram alanında eğitildiğinden, önceden eğitilmiş bir ağı özellik çıkarıcı veya başlatıcı olarak kullanmak kesinlikle bir seçenektir.
Öte yandan, onkologlar için radyografi görüntülerini analiz etmeniz gerektiğini düşünün. Bu görüntüler tipik kedi-köpek görselleri değildir; bir hastaya uygulanan taramanın çıktısıdır. Bu görüntüler RGB’ye dönüştürülse de, tarama sonuçlarını göstermek için tipik olarak gri tonlarındadır. Önceden eğitilmiş bir ağ RGB görüntülerdeki şekil ve kenarları tespit edebilse de, eğitim verilerinde yer almadıkları için radyografi görüntülerinde bunları tespit etmekte muhtemelen zorlanacaktır. Ayrıca tıbbi senaryolarda etiketli veri miktarı genellikle düşüktür. (Potansiyel olarak bol) etiketlenmemiş veriden yararlanmak için çeşitli teknikler mevcuttur, ancak genellikle daha fazla çalışma ve ince ayar gerektirirler. Tipik olarak bu teknikler, her katmanı sırasıyla görüntüleri yeniden kuracak şekilde (evrişimli ve ters evrişimli katmanlar kullanarak) eğiterek sınıflandırma ağının ağırlıklarını ön-eğitmeyi dener. Bu tekniklerle önceden eğitilmiş ağların birleşimi, yakınsama iyileştirmek için sıklıkla kullanılır.
Yukarıda bahsedilen her iki bilgisayarlı görü yöntemi de önemli bir varsayıma dayanır: Orijinal veri setinde çıkarılmış örüntüler, yeni veri setinin bağlamında kullanışlıdır. Bu kullanışlılığı nicelendirmek zordur; yine de dikkate alınması gereken önemli bir varsayımdır. Sismik, hiperspektral ya da tıbbi görüntüler, ImageNet’teki görüntülerle sınırlı benzerlik gösterir. Hangi trafik işaretinin yer aldığını belirlemek ise oldukça benzer örüntülere dayanır. Bilgisayarlı görü problem alanını anlamak, bilgisayarlı görüyü başarıyla uygulamak için kritik önemdedir. Transfer learning’de kullanılan modellerin (veri kümeleri, teknikler vb.) arka planını bilerek, denemeler sırasında zaman kaybını önleyebilir ve fark yaratabilecek modellerin ince ayarına odaklanabilirsiniz.
Makine Öğrenimi Kursları
Kurs
Kurs
Kurs