Cours
Comprendre le Machine Learning
2 h
308.2K
Ce billet présente le concept de « transfer learning » et son utilisation dans les applications de machine learning. Le transfer learning n’est pas un modèle ni une technique de machine learning ; c’est plutôt une « méthodologie de conception » en machine learning. Une autre « méthodologie de conception » est, par exemple, l’active learning.
Un prochain article expliquera comment combiner l’active learning avec le transfer learning pour exploiter au mieux les données existantes (et nouvelles). Au sens large, les applications d’apprentissage automatique qui tirent parti d’informations externes pour améliorer les performances ou les capacités de généralisation relèvent du transfer learning.
L’idée générale du transfer learning est de réutiliser des connaissances acquises sur des tâches pour lesquelles on dispose de beaucoup de données étiquetées, dans des contextes où l’on en a très peu. La création de données étiquetées coûte cher ; exploiter au mieux les jeux de données existants est donc essentiel.
Dans un modèle d’apprentissage automatique classique, l’objectif premier est de généraliser à des données inédites à partir de motifs appris sur les données d’entraînement. Avec le transfer learning, vous cherchez à amorcer ce processus de généralisation en partant de motifs appris pour une autre tâche. Concrètement, au lieu de démarrer l’apprentissage à partir d’une « page blanche » (souvent initialisée aléatoirement), vous partez de structures déjà apprises pour résoudre une autre tâche.
Le transfert de connaissances et de motifs est possible dans une grande variété de domaines. L’article d’aujourd’hui illustre le transfer learning au travers de plusieurs exemples issus de ces différents domaines. L’objectif est d’inciter les data scientists à expérimenter le transfer learning dans leurs projets de machine learning et de les sensibiliser à ses atouts comme à ses limites.
Voici trois raisons pour lesquelles une bonne compréhension du transfer learning est, selon moi, une compétence clé pour tout data scientist :
 |
 |
Comme son nom l’indique, le transfer learning suppose la capacité de transférer des connaissances d’un domaine à un autre. Il peut s’envisager à un niveau « haut » : des architectures de modèles NLP peuvent être réutilisées pour des problèmes de prédiction de séquences, de nombreux problèmes NLP pouvant être ramenés à de la prédiction séquentielle. Il peut aussi s’envisager à un niveau « bas », où l’on réutilise effectivement des paramètres d’un modèle dans un autre (skip-gram, continuous bag-of-words, etc.). Les prérequis du transfer learning sont à la fois spécifiques au problème et au modèle. Les deux sections suivantes décrivent respectivement une approche de haut niveau et une approche de bas niveau. Même si la littérature emploie parfois d’autres termes, l’idée directrice du transfer learning reste la même.
En apprentissage multi-tâches, vous entraînez un modèle sur plusieurs tâches simultanément. On utilise généralement des modèles de deep learning pour leur flexibilité d’adaptation.
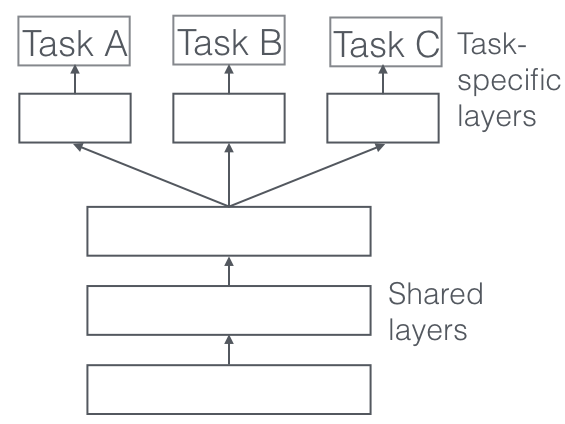
L’architecture du réseau est adaptée de sorte que les premières couches soient partagées entre différentes tâches, puis viennent des couches et des sorties spécifiques à chaque tâche. L’idée est qu’en entraînant un réseau sur plusieurs tâches, il généralisera mieux, car il doit bien performer sur des tâches qui requièrent des « connaissances » ou des traitements similaires.
Un exemple en traitement du langage naturel : un modèle dont l’objectif final est la reconnaissance d’entités nommées. Au lieu de l’entraîner uniquement sur cette tâche, vous l’utilisez aussi pour la classification morpho-syntaxique, la prédiction du mot suivant, etc. Le modèle bénéficie ainsi des structures apprises sur ces tâches et de leurs jeux de données. Je recommande vivement ce billet de Sebastian Ruder et cet article, tous deux consacrés à l’apprentissage multi-tâches.
L’un des grands atouts d’un modèle de deep learning est l’extraction « automatique » des caractéristiques. À partir des données étiquetées et de la rétropropagation, le réseau identifie les variables utiles à la tâche. Le réseau « détermine » quelles parties de l’entrée sont importantes pour, par exemple, classer une image. Cela évite un lourd travail manuel de définition des caractéristiques. Les réseaux de deep learning peuvent être réutilisés sur d’autres problèmes, car le type de caractéristiques extraites est souvent utile ailleurs. En featuriser, on réutilise essentiellement les premières couches du réseau pour déterminer les caractéristiques pertinentes, mais on n’utilise pas la sortie finale, trop spécifique à la tâche.
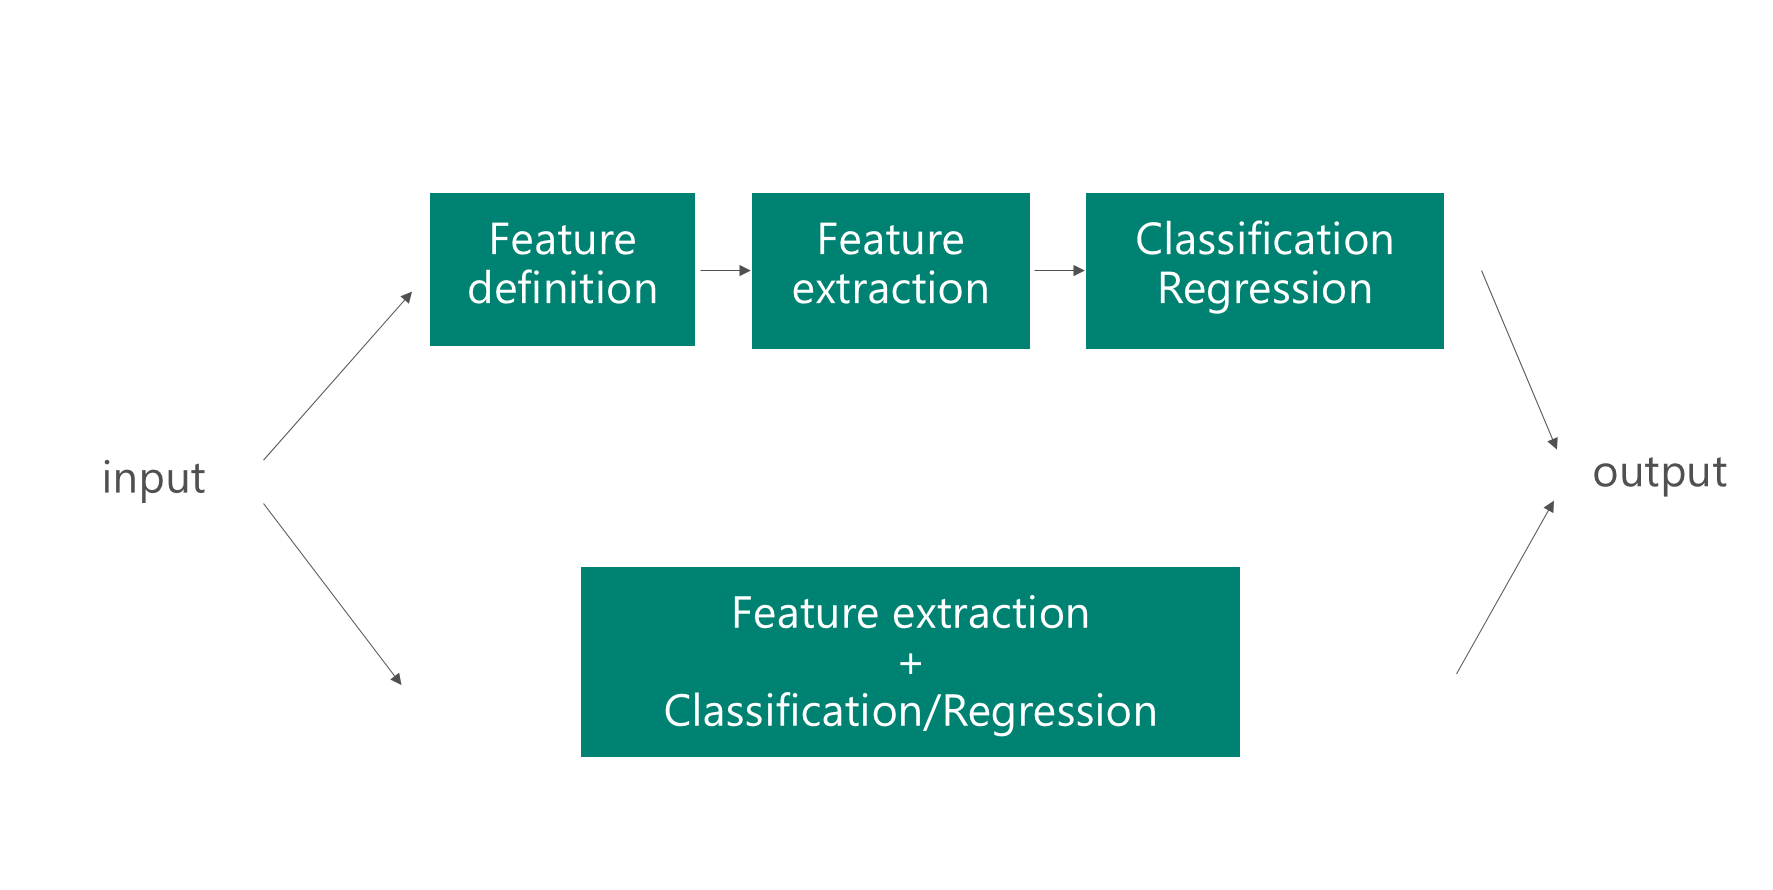
Puisque les systèmes de deep learning excellent dans l’extraction de caractéristiques, comment réutiliser des réseaux existants pour extraire des features sur d’autres tâches ? Il est possible d’injecter un échantillon dans le réseau et de récupérer la sortie d’une couche intermédiaire. Cette couche intermédiaire s’interprète comme une représentation traitée de longueur fixe des données brutes. Le concept de featuriser est souvent employé en vision par ordinateur : on alimente des images dans un réseau pré-entraîné (par exemple VGG ou AlexNet) et l’on applique une autre méthode de machine learning à cette nouvelle représentation. Extraire une couche intermédiaire comme représentation de l’image réduit fortement la taille des données d’origine, ce qui les rend plus adaptées aux techniques classiques (par exemple, la régression logistique ou les SVM fonctionnent mieux avec une représentation compacte de dimension 128 qu’avec l’originale, par exemple 128x128 = 16384 dimensions).
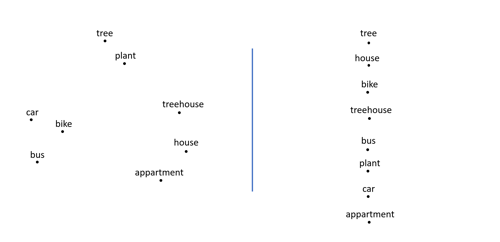
L’un de mes articles précédents expliquait comment de nombreuses chaînes de traitement NLP reposent aujourd’hui sur les word embeddings. Ces représentations vectorielles sont plus informatives que les encodages one-hot. Elles sont largement utilisées, avec de nombreuses variantes. Celles-ci diffèrent généralement par le corpus d’origine (Wikipedia, articles de presse, etc.) et par les modèles d’embedding. Il est important de comprendre l’origine de ces modèles et corpus pour savoir si le transfer learning avec des word embeddings est pertinent. On ne parle pas toujours de transfer learning pour les word embeddings ; je ne partage pas cet avis, compte tenu de la similarité avec la vision par ordinateur. Utiliser des word embeddings, c’est en substance utiliser un featuriser ou un réseau d’embedding pour convertir des mots en vecteurs.
Bien que word2vec ait déjà quelques années, il reste une approche d’embedding très influente. Des méthodes plus récentes, comme FastText, ont rendu les embeddings accessibles dans de nombreuses langues. Par rapport aux approches sac de mots, les embeddings issus de word2vec ou FastText constituent un net progrès. Néanmoins, leur utilité dépend fortement du domaine.
Imaginez que vous construisiez un service de recommandation d’actualités pour des commerciaux. Ils souhaitent recevoir des nouvelles sur des entreprises susceptibles d’être intéressées par leur offre. Le vocabulaire utilisé dans les articles est généralement assez courant, donc en grande partie couvert par la plupart des embeddings (selon le corpus d’entraînement). De plus, si vous demandez aux commerciaux de collecter les articles lus pendant quelques semaines, vous disposez rapidement d’un large corpus étiqueté. En réutilisant des embeddings, il est possible que le moteur de recommandation performe nettement mieux.
À l’inverse, imaginez devoir classifier des thèmes dans des contrats juridiques — pas n’importe lesquels, des contrats français en droit de la concurrence. Ces jeux de données sont rarement étiquetés, ou seulement de façon limitée. Voici pourquoi un transfer learning « clé en main » aura vite ses limites dans ce cas :
Je vous recommande vivement cet excellent billet sur l’état de l’art des word embeddings. Tenir compte des problèmes et solutions cités est essentiel pour bâtir des systèmes NLP et des embeddings robustes avec peu de données.
Gensim, spaCy et FastText sont trois excellents frameworks pour intégrer rapidement des embeddings dans vos applications de machine learning. Ils permettent aussi d’entraîner des embeddings personnalisés. Découvrez ce tutoriel gensim, cette page spaCy ou ce tutoriel FastText pour en savoir plus !
Les méthodes de deep learning ont permis des avancées majeures en vision par ordinateur. Plutôt que de définir manuellement des caractéristiques spécifiques au problème (Histogram of Oriented Gradients, histogrammes, etc.), on peut entraîner des modèles à partir d’images brutes. La complexité initiale de la définition des caractéristiques s’est déplacée vers la conception des réseaux. Si les architectures sont souvent réutilisées, il n’existe pas de stratégie unique pour les composer. Les techniques de deep learning ont été inventées et testées en recherche sur d’immenses jeux de données (comme ImageNet ou MS COCO). Pour gagner en performance, les chercheurs ont conçu des architectures de plus en plus profondes et complexes. Ces modèles, riches de millions de paramètres, ne sont (généralement) pas adaptés à de petits jeux d’images. Entraîner un ResNet ou un VGG sur un jeu de moins de 5 000 images conduit presque inévitablement au surapprentissage. La vague deep learning a apporté des progrès considérables, mais les data scientists avec de petits jeux de données ont parfois été laissés de côté.
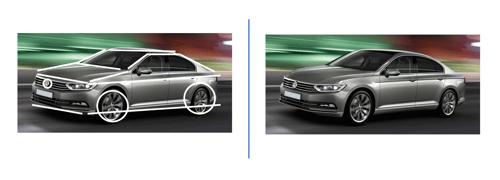
Il apparaît que les réseaux profonds apprennent des représentations hiérarchiques des caractéristiques (voir cet article de Distill). Les couches basses apprennent des motifs de bas niveau, comme des bords, tandis que les couches hautes apprennent des concepts plus élevés, souvent peu interprétables, comme des formes. Cette hiérarchie se retrouve même quand on entraîne le réseau sur des jeux de données différents, ce qui suggère leur réutilisation possible dans d’autres domaines.
Deux approches sont courantes pour appliquer le transfer learning en vision par ordinateur.
L’API de Keras permet de charger des réseaux pré-entraînés et de geler certaines couches pendant l’entraînement. Dans la section suivante, j’évoque deux cas d’usage : l’un où le transfer learning est pertinent, l’autre non.
Supposons que vous travailliez à la préservation de la faune et que vous vouliez classifier les animaux apparaissant sur un flux vidéo en direct. Si vous surveillez des espèces menacées, il est probable que vous n’obtiendrez pas beaucoup de données étiquetées. Étant donné que les réseaux pré-entraînés couvrent souvent un large spectre de concepts (alimentation, animaux, objets), les utiliser comme featuriser ou comme initialisation est clairement une option.
À l’inverse, imaginez devoir analyser des images de radiographie pour des oncologues. Il ne s’agit pas d’images « chat-chien », mais de résultats de scanners patients. Même converties en RGB, ces images sont souvent en niveaux de gris. Un réseau pré-entraîné sait détecter formes et bords sur des images RGB grand public, mais aura probablement du mal sur des radiographies, absentes de son entraînement. De plus, en contexte médical, les données étiquetées sont rares. Plusieurs techniques permettent d’exploiter des données non étiquetées (souvent abondantes), mais demandent plus de travail et de réglages fins. Typiquement, elles pré-entraînent les poids du réseau de classification en apprenant, couche par couche, à reconstruire les images (avec des couches convolutionnelles et déconvolutionnelles). Combiner ces techniques avec des réseaux pré-entraînés améliore souvent la convergence.
Ces deux méthodes en vision reposent sur une hypothèse clé : les motifs extraits dans le jeu de données d’origine sont utiles dans le nouveau contexte. Cette utilité est difficile à quantifier, mais cruciale. Des images sismiques, hyperspectrales ou médicales ont peu en commun avec celles d’ImageNet. En revanche, reconnaître un panneau de signalisation s’appuie sur des motifs assez similaires. Comprendre le domaine de vision par ordinateur visé est déterminant pour réussir. Connaître l’origine des modèles (jeux de données, techniques, etc.) utilisés en transfer learning vous évite de perdre du temps en expérimentations et vous permet de concentrer vos efforts de réglage sur les modèles à fort potentiel.
Cours de machine learning
Cours
Cours
Cours