

अगली ब्लॉग पोस्ट में समझाया जाएगा कि आप मौजूदा (और नए) डेटा का सर्वोत्तम उपयोग करने के लिए ट्रांसफ़र लर्निंग के साथ सक्रिय लर्निंग को कैसे साथ में उपयोग कर सकते हैं। व्यापक अर्थ में, वे मशीन लर्निंग अनुप्रयोग जो बाहरी जानकारी का उपयोग करके प्रदर्शन या सामान्यीकरण क्षमता में सुधार करते हैं, ट्रांसफ़र लर्निंग का उपयोग करते हैं।
ट्रांसफ़र लर्निंग: एक परिभाषा
ट्रांसफ़र लर्निंग का सामान्य विचार यह है कि जिन कार्यों के लिए बहुत अधिक लेबल किए हुए डेटा उपलब्ध हैं, उनसे सीखे गए ज्ञान को उन परिदृश्यों में उपयोग किया जाए जहाँ बहुत कम लेबल डेटा उपलब्ध है। लेबल्ड डेटा बनाना महंगा होता है, इसलिए मौजूदा डेटासेट्स का सर्वोत्तम उपयोग करना महत्वपूर्ण है।
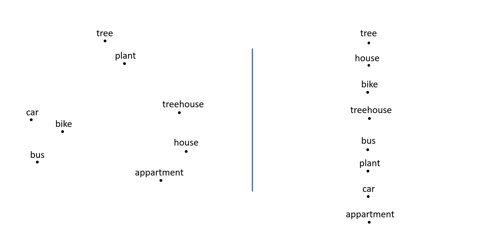
पारंपरिक मशीन लर्निंग मॉडल में प्राथमिक लक्ष्य प्रशिक्षण डेटा से सीखे गए पैटर्न के आधार पर अनदेखे डेटा पर सामान्यीकरण करना होता है। ट्रांसफ़र लर्निंग में, आप किसी दूसरे कार्य के लिए सीखे गए पैटर्न से शुरुआत करके इस सामान्यीकरण प्रक्रिया को गति देने का प्रयास करते हैं। मूलतः, सीखने की प्रक्रिया को (अक्सर यादृच्छिक रूप से इनिशियलाइज़) खाली पृष्ठ से शुरू करने के बजाय, आप किसी अन्य कार्य को हल करने के लिए सीखे गए पैटर्न से शुरू करते हैं।
ज्ञान और पैटर्न का ट्रांसफ़र अनेक डोमेन में संभव है। आज की पोस्ट इन विभिन्न डोमेन के कई उदाहरणों के माध्यम से ट्रांसफ़र लर्निंग को स्पष्ट करेगी। लक्ष्य डेटा वैज्ञानिकों को अपने मशीन लर्निंग प्रोजेक्ट्स में ट्रांसफ़र लर्निंग के साथ प्रयोग करने के लिए प्रेरित करना और इसके फायदे व कमियों के प्रति जागरूक करना है।
ऐसे तीन कारण हैं जिनकी वजह से मेरा मानना है कि ट्रांसफ़र लर्निंग की अच्छी समझ एक डेटा वैज्ञानिक के लिए अत्यावश्यक कौशल है:
- किसी भी प्रकार की सीखने की प्रक्रिया में ट्रांसफ़र लर्निंग अनिवार्य है। मनुष्यों को हर कार्य या समस्या अलग से नहीं सिखाई जाती, फिर भी वे अनदेखी परिस्थितियों में भी तात्कालिक रूप से समस्याएँ सुलझा लेते हैं। अनेक अनुभवों से सीखकर 'ज्ञान' को नए परिवेशों में लागू करने की क्षमता ही ट्रांसफ़र लर्निंग का सार है। इस दृष्टि से, अवधारणात्मक स्तर पर ट्रांसफ़र लर्निंग और सामान्यीकरण बहुत समान हैं। मुख्य अंतर यह है कि ट्रांसफ़र लर्निंग प्रायः 'कार्यों के बीच ज्ञान का हस्तांतरण' करने के लिए उपयोग होती है, जबकि सामान्यीकरण किसी विशिष्ट कार्य के भीतर होता है। इस प्रकार ट्रांसफ़र लर्निंग मूलतः उस सामान्यीकरण की धारणा से जुड़ी है जो सभी मशीन लर्निंग मॉडलों में आवश्यक है।
- छोटे-डेटा वाले अनेक परिदृश्यों में डीप लर्निंग तकनीकों की सफलता सुनिश्चित करने के लिए ट्रांसफ़र लर्निंग महत्वपूर्ण है। शोध में डीप लर्निंग लगभग सर्वत्र है, पर वास्तविक जीवन के कई परिदृश्यों में प्रायः मॉडल प्रशिक्षण के लिए लाखों लेबल्ड डेटा पॉइंट्स नहीं होते। न्यूरल नेटवर्क में मौजूद लाखों पैरामीटर्स को ट्यून करने के लिए डीप लर्निंग तकनीकों को विशाल डेटा चाहिए। खासकर सुपरवाइज़्ड लर्निंग में, इसका अर्थ है कि आपको बहुत (और महंगा) लेबल्ड डेटा चाहिए। छवियों को लेबल करना सहज लगता है, पर उदाहरण के लिए Natural Language Processing (NLP) में बड़े लेबल्ड डेटासेट बनाने के लिए विशेषज्ञ ज्ञान आवश्यक है। जैसे Penn Treebank, जो Part-of-Speech टैगिंग कॉर्पस है, बनाने में 7 वर्ष लगे और प्रशिक्षित भाषाविदों का निकट सहयोग लगा। ट्रांसफ़र लर्निंग, आवश्यक डेटासेट आकार घटाकर, न्यूरल नेटवर्क्स को व्यावहारिक विकल्प बनाने का एक तरीका है। अन्य विकल्प अधिक प्रायिकतामूलक मॉडल्स की ओर बढ़ना है, जो सीमित डेटा सेट्स के साथ अक्सर बेहतर काम करते हैं।
- ट्रांसफ़र लर्निंग के महत्वपूर्ण फायदे हैं तो कमियाँ भी हैं। इन कमियों को समझना सफल मशीन लर्निंग अनुप्रयोगों के लिए आवश्यक है। ज्ञान का ट्रांसफ़र तभी संभव है जब वह 'उचित' हो। इस संदर्भ में 'उचित' का सटीक अर्थ परिभाषित करना सरल नहीं है और आम तौर पर प्रयोग करना पड़ता है। आप खिलौना कार चलाने वाले एक नन्हे बच्चे पर Ferrari चलाने का भरोसा नहीं कर सकते। यही सिद्धांत ट्रांसफ़र लर्निंग पर भी लागू होता है: यद्यपि इसे मात्रात्मक रूप से आँकना कठिन है, पर इसकी एक ऊपरी सीमा है। यह हर समस्या का एक समान हल नहीं है।
 |  |
ट्रांसफ़र लर्निंग में सामान्य अवधारणाएँ
ट्रांसफ़र लर्निंग की आवश्यकताएँ
ट्रांसफ़र लर्निंग, जैसा कि नाम से स्पष्ट है, एक डोमेन से दूसरे में ज्ञान को स्थानांतरित करने की क्षमता पर निर्भर करती है। ट्रांसफ़र लर्निंग को उच्च स्तर पर भी समझा जा सकता है, अर्थात कई NLP समस्याएँ अंतर्निहित रूप से क्रम-पूर्वानुमान समस्याओं में बदली जा सकती हैं, इसलिए NLP मॉडल आर्किटेक्चर क्रम-पूर्वानुमान समस्याओं में पुन: उपयोग किए जा सकते हैं। इसे निम्न स्तर पर भी समझा जा सकता है, जहाँ आप सचमुच एक मॉडल के पैरामीटर्स को दूसरे मॉडल में पुन: उपयोग करते हैं (skip-gram, continuous bag-of-words, आदि)। ट्रांसफ़र लर्निंग की आवश्यकताएँ एक ओर समस्या-विशिष्ट और दूसरी ओर मॉडल-विशिष्ट होती हैं। अगली दो धाराएँ क्रमशः ट्रांसफ़र लर्निंग के उच्च-स्तरीय और निम्न-स्तरीय दृष्टिकोण पर चर्चा करेंगी। यद्यपि साहित्य में आपको ये अवधारणाएँ भिन्न नामों से मिलेंगी, पर ट्रांसफ़र लर्निंग की व्यापक धारणा विद्यमान रहती है।
मल्टी-टास्क लर्निंग
मल्टी-टास्क लर्निंग में, आप एक ही समय में अलग-अलग कार्यों पर एक मॉडल को प्रशिक्षित करते हैं। आमतौर पर डीप लर्निंग मॉडल्स का उपयोग किया जाता है क्योंकि वे लचीले ढंग से अनुकूलित किए जा सकते हैं।
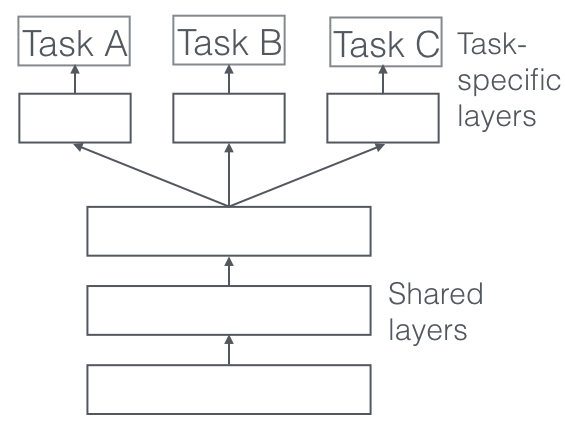
नेटवर्क आर्किटेक्चर को इस तरह बदला जाता है कि शुरुआती लेयर्स विभिन्न कार्यों में साझा की जाती हैं, और फिर अलग-अलग कार्यों के लिए अलग कार्य-विशिष्ट लेयर्स और आउटपुट जोड़े जाते हैं। सामान्य विचार यह है कि अलग-अलग कार्यों पर नेटवर्क को प्रशिक्षित करने से नेटवर्क बेहतर सामान्यीकरण करेगा, क्योंकि मॉडल को उन कार्यों पर अच्छा प्रदर्शन करना होगा जिनके लिए समान 'ज्ञान' या 'प्रक्रिया' की आवश्यकता होती है।
Natural Language Processing के मामले में एक उदाहरण वह मॉडल है जिसका अंतिम लक्ष्य एंटिटी रिकग्निशन करना है। मॉडल को केवल एंटिटी रिकग्निशन कार्य पर प्रशिक्षित करने के बजाय, आप इसे पार्ट-ऑफ-स्पीच वर्गीकरण, अगले शब्द की भविष्यवाणी, ... के लिए भी उपयोग करते हैं। इस प्रकार, मॉडल उन कार्यों और विभिन्न डेटासेट्स से सीखी गई संरचना का लाभ उठाएगा। मैं Sebastian Ruder की इस ब्लॉग पोस्ट और इस ब्लॉग की अत्यधिक अनुशंसा करता/करती हूँ, जो मल्टी-टास्क लर्निंग को विस्तार से समझाते हैं।
फीचराइज़र
डीप लर्निंग मॉडल का एक बड़ा लाभ यह है कि फीचर निष्कर्षण 'स्वचालित' होता है। लेबल्ड डेटा और बैकप्रोपेगेशन के आधार पर, नेटवर्क किसी कार्य के लिए उपयोगी फीचर्स निर्धारित कर पाता है। नेटवर्क 'समझ लेता है' कि, उदाहरण के लिए, किसी छवि को वर्गीकृत करने के लिए इनपुट का कौन सा हिस्सा महत्वपूर्ण है। इसका अर्थ है कि फीचर परिभाषा का मैन्युअल कार्य अमूर्त हो जाता है। डीप लर्निंग नेटवर्क्स को अन्य समस्याओं में पुन: उपयोग किया जा सकता है, क्योंकि जो प्रकार के फीचर्स निकाले जाते हैं वे अक्सर अन्य समस्याओं में भी उपयोगी होते हैं। मूलतः, एक फीचराइज़र में आप नेटवर्क की शुरुआती लेयर्स का उपयोग उपयोगी फीचर्स निर्धारित करने के लिए करते हैं, लेकिन नेटवर्क के आउटपुट का उपयोग नहीं करते, क्योंकि वह बहुत कार्य-विशिष्ट होता है।
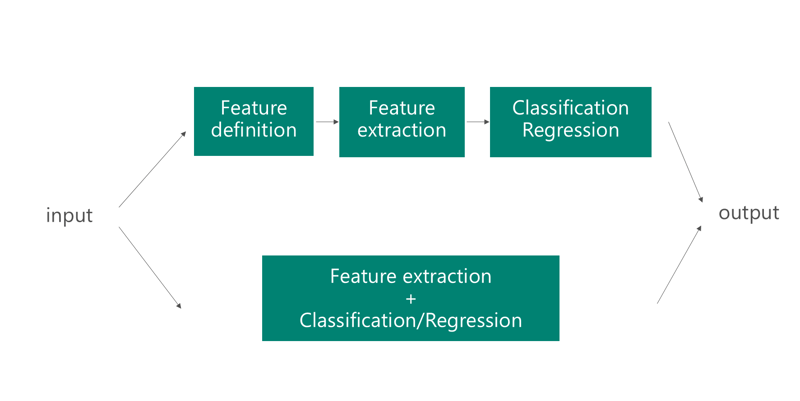
चूँकि डीप लर्निंग सिस्टम फीचर निष्कर्षण में अच्छे हैं, आप अन्य कार्यों के लिए फीचर निष्कर्षण करने हेतु मौजूदा नेटवर्क्स को कैसे पुन: उपयोग कर सकते हैं? यह संभव है कि आप डेटा सैंपल को नेटवर्क में फीड करें और नेटवर्क की किसी मध्यवर्ती लेयर का आउटपुट के रूप में उपयोग लें। इस मध्यवर्ती लेयर को कच्चे डेटा का एक नियत-लंबाई, संसाधित निरूपण माना जा सकता है। सामान्यतः, फीचराइज़र की अवधारणा कंप्यूटर विज़न के संदर्भ में उपयोग होती है। तब छवियों को किसी प्री-ट्रेंड नेटवर्क (उदाहरण के लिए, VGG या AlexNet) में फीड किया जाता है और नई डेटा अभिव्यक्ति पर भिन्न मशीन लर्निंग विधि का उपयोग किया जाता है। किसी मध्यवर्ती लेयर को छवि के निरूपण के रूप में निकालना मूल डेटा आकार को काफी घटा देता है, जिससे वे पारंपरिक मशीन लर्निंग तकनीकों के लिए अधिक अनुकूल हो जाती हैं (उदाहरण के लिए, लॉजिस्टिक रिग्रेशन या SVMs किसी छवि के छोटे निरूपण, जैसे 128 आयाम, पर, मूल 128x128=16384 आयाम की तुलना में, बेहतर काम करते हैं)।
ट्रांसफ़र लर्निंग के उपयोग
NLP
मेरी पिछली ब्लॉग पोस्टों में से एक में चर्चा की गई थी कि आजकल कई NLP पाइपलाइंस वर्ड एम्बेडिंग्स का उपयोग करती हैं। वर्ड एम्बेडिंग्स, वन-हॉट एनकोडिंग की तुलना में शब्दों को दर्शाने का अधिक सूचनात्मक तरीका हैं। ये व्यापक रूप से उपयोग होती हैं और विभिन्न प्रकार उपलब्ध हैं। आमतौर पर ये भिन्नताएँ उस कॉर्पस में होती हैं जिनसे वे आई हैं, जैसे Wikipedia, समाचार लेख आदि, और एम्बेडिंग मॉडलों के अंतरों में। यह समझना महत्वपूर्ण है कि इन मॉडलों और कॉर्पस का पृष्ठभूमि क्या है ताकि यह जाना जा सके कि वर्ड एम्बेडिंग्स के साथ ट्रांसफ़र लर्निंग तर्कसंगत है या नहीं। लोग प्रायः वर्ड एम्बेडिंग्स के उपयोग को ट्रांसफ़र लर्निंग नहीं कहेंगे, फिर भी मैं असहमत हूँ, क्योंकि यह कंप्यूटर विज़न में ट्रांसफ़र लर्निंग के बहुत समान है। मूलतः, वर्ड एम्बेडिंग्स का उपयोग करने का मतलब है कि आप फीचराइज़र या एम्बेडिंग नेटवर्क का उपयोग करके शब्दों को वेक्टर में बदल रहे हैं।
हालाँकि word2vec चार साल पुराना है, यह अब भी एक अत्यंत प्रभावशाली वर्ड एम्बेडिंग दृष्टिकोण है। दूसरी ओर, हालिया दृष्टिकोण जैसे FastText ने अनेक भाषाओं में वर्ड एम्बेडिंग्स उपलब्ध करा दी हैं। word2vec या FastText से प्राप्त एम्बेडिंग्स, बैग-ऑफ-वर्ड्स तरीकों की तुलना में एक महत्वपूर्ण प्रगति हैं। फिर भी, उनकी उपयोगिता प्रायः समस्या-डोमेन द्वारा निर्धारित होती है।
कल्पना कीजिए कि आप सेल्स लोगों के लिए एक न्यूज़ रिकमेंडेशन सेवा बना रहे हैं। सेल्स लोग उन कंपनियों से संबंधित समाचार पाना चाहते हैं जो उनके बेचे जाने वाले उत्पाद में रुचि रख सकती हैं। समाचार लेखों में प्रयुक्त शब्दावली आमतौर पर काफी सामान्य होती है, अर्थात अधिकांश वर्ड एम्बेडिंग्स (उनके प्रशिक्षण कॉर्पस पर निर्भर) द्वारा समर्थित शब्दावली का उपयोग होता है। साथ ही, यदि आप सेल्स लोगों से कुछ सप्ताह तक वे जो समाचार पढ़ते हैं उन्हें एकत्रित करवाएँ, तो आपके पास तुरंत एक बड़ा लेबल्ड कॉर्पस होगा। वर्ड एम्बेडिंग्स का पुन: उपयोग करके यह संभव है कि रिकमेंडेशन इंजन का प्रदर्शन काफी बेहतर हो।
दूसरी ओर, मान लीजिए आपको कानूनी अनुबंधों पर विषय-वर्गीकरण करना है। न सिर्फ कोई भी कानूनी अनुबंध, बल्कि प्रतिस्पर्धा क़ानून के संदर्भ में फ्रेंच कानूनी अनुबंध। ऐसे प्रकार के डेटासेट्स प्रायः लेबल्ड नहीं होते, या केवल सीमित मात्रा में लेबल्ड दस्तावेज़ उपलब्ध होते हैं। अगला खंड बताएगा कि इस स्थिति में रेडीमेड ट्रांसफ़र लर्निंग आपको केवल एक हद तक ही मदद क्यों करेगी:
- आउट-ऑफ-वोकैबुलरी (OOV) शब्द वे होते हैं जो प्रशिक्षण के दौरान नहीं देखे गए। जबकि word2vec और FastText, उदाहरण के लिए, Wikipedia या अन्य कॉर्पस पर प्रशिक्षित होते हैं, प्रयुक्त शब्दावली सीमित होती है। प्रशिक्षण के दौरान, जो शब्द बार-बार नहीं आए, उन्हें अक्सर हटा दिया जाता है। इसका मतलब है कि प्रतिस्पर्धा क़ानून के कानूनी अनुबंधों के डोमेन-विशिष्ट शब्द समर्थित न हों। प्री-ट्रेंड वर्ड एम्बेडिंग्स का उपयोग करते समय, आप प्रायः OOV शब्दों की जाँच करके उन्हें UNK टोकन (UNKnown word token) से बदलते हैं और इन सभी शब्दों को समान वेक्टर दिया जाता है। यदि कॉर्पस डोमेन-विशिष्ट है, तो यह अत्यंत अप्रभावी है, क्योंकि डोमेन-विशिष्ट शब्द प्रायः बहुत अर्थ वहन करते हैं। यदि अधिकांश (अर्थ-वहन करने वाले) शब्द UNK टोकन्स से बदल दिए गए, तो मॉडल बहुत कुछ नहीं सीख पाएगा।
- मानक प्री-ट्रेंड वर्ड एम्बेडिंग्स का एक विकल्प यह है कि आप एक बड़े अनसुपरवाइज़्ड दस्तावेज़ सेट पर एम्बेडिंग्स को फाइन-ट्यून करें। ध्यान दें कि यह तभी विकल्प है जब बड़े दस्तावेज़ सेट उपलब्ध हों। इसका अर्थ है कि यदि आपके पास प्रतिस्पर्धा क़ानून पर बड़ा कॉर्पस है, तो आप डोमेन-विशिष्ट शब्दों के लिए एम्बेडिंग्स प्रशिक्षित कर सकते हैं, जबकि अन्य अधिक सामान्य शब्दों के लिए प्री-ट्रेंड वर्ड एम्बेडिंग्स से शुरुआत करें। सामान्यतः, प्री-ट्रेंड वर्ड एम्बेडिंग्स से शुरुआत करने पर पूरा प्रोसेस तेज़ होता है और अपनी एम्बेडिंग्स का प्रशिक्षण आसान हो जाता है। ध्यान दें कि यह फिर भी आउट-ऑफ-द-बॉक्स एम्बेडिंग्स उपयोग करने से कठिन है और कॉर्पस को एम्बेडिंग प्रशिक्षण के लिए कैसे तैयार किया जाए, इस पर कुछ ज्ञान चाहिए।
मैं आपको वर्ड एम्बेडिंग्स की मौजूदा स्थिति पर यह उत्कृष्ट ब्लॉग पोस्ट पढ़ने की कड़ी सलाह देता/देती हूँ। इस ब्लॉग पोस्ट में बताए गए समस्याओं और समाधानों को ध्यान में रखना, सीमित डेटा के साथ काम करते समय मजबूत NLP सिस्टम्स और वर्ड एम्बेडिंग्स बनाने की कुंजी है।
Gensim, spacy और FastText तीन बेहतरीन फ़्रेमवर्क हैं जो आपको अपनी मशीन लर्निंग एप्लिकेशन में वर्ड एम्बेडिंग्स का तेज़ी से उपयोग करने देते हैं। साथ ही, ये कस्टम वर्ड एम्बेडिंग्स का प्रशिक्षण भी समर्थित करते हैं। अधिक जानने के लिए यह gensim, यह spacy या यह FastText ट्यूटोरियल देखें!
कंप्यूटर विज़न में ट्रांसफ़र लर्निंग
डीप लर्निंग विधियों ने कंप्यूटर विज़न में उल्लेखनीय सफलताएँ दिलाई हैं। समस्या-विशिष्ट फीचर्स (जैसे Histogram of Oriented Gradients (HoG) फीचर्स, हिस्टोग्राम फीचर्स, आदि) को मैन्युअल रूप से परिभाषित करने के बजाय, डीप लर्निंग प्रैक्टिशनर्स को ऐसे मॉडल प्रशिक्षित करने देती है जो कच्ची छवियों को इनपुट के रूप में लेते हैं। फीचर परिभाषा की मूल जटिलता अब नेटवर्क परिभाषा की जटिलता की ओर शिफ्ट हो गई है। यद्यपि आर्किटेक्चर अक्सर पुन: उपयोग होते हैं, नेटवर्क आर्किटेक्चर बनाने की कोई एकल रणनीति नहीं है। सामान्यतः, डीप लर्निंग तकनीकों का आविष्कार और विशाल डेटासेट्स (जैसे Imagenet या MS Coco) पर शोध सेटिंग्स में अनुप्रयोग हुआ है। इन बड़े डेटासेट्स पर प्रदर्शन बढ़ाने के लिए, शोधकर्ताओं ने बढ़ती गहराई और जटिलता वाले आर्किटेक्चर बनाए हैं। ये आर्किटेक्चर ऐसे मॉडलों का परिणाम देते हैं जिनमें लाखों पैरामीटर्स होते हैं और (आमतौर पर) छोटे इमेज डेटासेट्स के लिए स्केलेबल नहीं होते। 5,000 से कम छवियों वाले डेटासेट पर ResNet या VGG जैसे आर्किटेक्चर को प्रशिक्षित करना स्पष्ट ओवरफिटिंग की ओर ले जाएगा। हालिया डीप लर्निंग प्रवृत्ति ने उल्लेखनीय प्रगति की है, फिर भी ऐसा प्रतीत होता है कि केवल छोटे डेटासेट्स वाले डेटा वैज्ञानिक पीछे रह गए हैं।
जैसा कि सामने आया है, डीप लर्निंग नेटवर्क्स पदानुक्रमिक फीचर अभिव्यक्तियाँ सीखते हैं (देखें Distill का यह ब्लॉग पोस्ट)। इसका अर्थ है कि निम्न-स्तरीय लेयर्स किनारों जैसे निम्न-स्तरीय फीचर्स सीखती हैं, जबकि उच्च-स्तरीय लेयर्स आकार जैसे उच्च-स्तरीय, यद्यपि अव्याख्येय, संकल्पनाएँ सीखती हैं। यह पदानुक्रमिक फीचर अभिव्यक्ति का विचार तब भी दिखाई देता है जब नेटवर्क अलग-अलग डेटासेट्स पर प्रशिक्षित होता है, जो इंगित करता है कि उन्हें अलग-अलग समस्या डोमेनों में पुन: उपयोग किया जा सकता है।
कंप्यूटर विज़न समस्याओं पर ट्रांसफ़र लर्निंग का उपयोग करते समय दो दृष्टिकोण अपनाए जाते हैं।
- पहला, यदि पर्याप्त मात्रा में तस्वीरें (>1,000 प्रति क्लास) उपलब्ध हैं, तो आप किसी अन्य डेटासेट पर प्रशिक्षित मॉडल के वेट्स से एक नए मॉडल को इनिशियलाइज़ कर सकते हैं। प्रशिक्षण के दौरान, आप कुछ लेयर्स (आमतौर पर शुरुआती कन्वोल्यूशनल लेयर्स) को स्थिर रखते हैं और उच्च-स्तरीय लेयर्स के पैरामीटर्स को ऑप्टिमाइज़ करते हैं। लक्ष्य उन पैरामीटर्स की संख्या घटाना है जिन्हें ऑप्टिमाइज़ करना है, जबकि निम्न-स्तरीय लेयर्स का पुन: उपयोग करना है। निम्न-स्तरीय लेयर्स प्रायः समस्या-डोमेन की परवाह किए बिना समान होती हैं, और मॉडल को उच्च-स्तरीय लेयर्स को समस्या-विशिष्ट रूप से संयोजित करने की स्वतंत्रता मिलती है।
- दूसरा, यदि केवल बहुत कम संख्या में तस्वीरें उपलब्ध हैं (<1,000), तो मौजूदा मॉडल को फिर से प्रशिक्षित करना अधिकांश मामलों में फिर भी ओवरफिटिंग की ओर ले जाएगा। अनुकूलित किए जाने वाले पैरामीटर्स की संख्या छवियों की संख्या की तुलना में बहुत अधिक होगी। फिर भी, जब तक डेटा बड़े डेटासेट की छवियों से दृश्य रूप से समान है, तब तक किसी बड़े प्री-ट्रेंड नेटवर्क (जो उस बड़े डेटासेट पर प्रशिक्षित है) को फीचराइज़र के रूप में उपयोग किया जा सकता है। विशेष रूप से, आप किसी बड़े नेटवर्क की अंतिम N लेयर्स (आमतौर पर N=1 या N=2) हटा देते हैं, और बड़े प्री-ट्रेंड नेटवर्क के आउटपुट को छवियों के फीचर निरूपण के रूप में उपयोग करते हैं। यह फिर से इस धारणा पर आधारित है कि प्री-ट्रेंड नेटवर्क की शुरुआती लेयर्स समस्या-स्वतंत्र फीचर्स सीखती हैं। इन फीचर्स का बाद में, उदाहरण के लिए, SVM या लॉजिस्टिक रिग्रेशन के साथ उपयोग किया जा सकता है, पारंपरिक कंप्यूटर विज़न दृष्टिकोण की तरह। हालाँकि, फीचर्स को मैन्युअली परिभाषित करने के बजाय, प्री-ट्रेंड नेटवर्क को फीचराइज़र के रूप में उपयोग किया जाता है।
Keras का API आपको प्री-ट्रेंड नेटवर्क्स लोड करने और प्रशिक्षण के दौरान कई लेयर्स को स्थिर रखने की अनुमति देता है। अगले खंड में मैं दो उपयोग मामलों पर फिर चर्चा करूँगा/करूँगी—एक जहाँ ट्रांसफ़र लर्निंग उपयोगी है, और दूसरा जहाँ यह उपयोगी नहीं है।
कल्पना कीजिए कि आप वन्यजीव संरक्षण में काम कर रहे हैं और लाइव कैमरा फ़ीड पर दिखने वाले विभिन्न पशुओं का वर्गीकरण करना चाहते हैं। विशेषकर यदि आप विलुप्ति के कगार पर खड़ी प्रजातियों की निगरानी करना चाह रहे हैं, तो संभव है कि आप बहुत अधिक लेबल्ड डेटा एकत्रित न कर सकें। चूँकि प्री-ट्रेंड नेटवर्क्स प्रायः व्यापक डोमेन के कॉन्सेप्ट्स (खाद्य पदार्थों से लेकर जानवरों और वस्तुओं तक) पर प्रशिक्षित होते हैं, इसलिए प्री-ट्रेंड नेटवर्क को फीचराइज़र या इनिशियलाइज़र के रूप में उपयोग करना निश्चित रूप से विकल्प है।
दूसरी ओर, कल्पना कीजिए कि आपको ऑन्कोलॉजिस्ट्स के लिए रेडियोग्राफी छवियों का विश्लेषण करना है। ये छवियाँ आपकी सामान्य बिल्ली-कुत्ता छवियाँ नहीं हैं, क्योंकि ये किसी रोगी पर किए गए स्कैन का आउटपुट हैं। ये छवियाँ, भले ही RGB में बदली गई हों, प्रायः स्कैन के परिणाम दिखाने हेतु ग्रे-शेड्स में होती हैं। यद्यपि कोई प्री-ट्रेंड नेटवर्क RGB छवियों से आकार और किनारे पहचानने में सक्षम होता है, उन्हें रेडियोग्राफी छवियों पर ऐसा करने में कठिनाई होगी क्योंकि वे प्री-ट्रेंड मॉडल के प्रशिक्षण डेटा में शामिल नहीं हैं। साथ ही, चिकित्सकीय परिदृश्यों में लेबल्ड डेटा की मात्रा आमतौर पर कम होती है। (संभावित रूप से प्रचुर) अनलेबल्ड डेटा का लाभ उठाने की कई तकनीकें मौजूद हैं, पर वे सामान्यतः अधिक कार्य और फाइन-ट्यूनिंग माँगती हैं। प्रायः, ये तकनीकें वर्गीकरण नेटवर्क के वेट्स को प्री-ट्रेन करने का प्रयास करती हैं, प्रत्येक लेयर को क्रमिक रूप से छवियों का पुनर्निर्माण करना सिखाकर (कन्वोल्यूशनल और डीकन्वोल्यूशनल लेयर्स का उपयोग करते हुए)। अभिसरण सुधारने के लिए अक्सर इन तकनीकों और प्री-ट्रेंड नेटवर्क का संयोजन उपयोग होता है।
ऊपर उल्लिखित दोनों तरीक़े एक महत्वपूर्ण धारणा पर निर्भर हैं: मूल डेटासेट में निकाले गए पैटर्न नए डेटासेट के संदर्भ में उपयोगी हैं। इस उपयोगिता को मात्रात्मक रूप से आँकना कठिन है, फिर भी यह ध्यान में रखने योग्य महत्वपूर्ण धारणा है। सिस्मिक, हाइपरस्पेक्ट्रल या चिकित्सकीय इमेजरी, ImageNet की छवियों से सीमित समानता दिखाती हैं। परंतु किसी ट्रैफ़िक साइन का निर्धारण अपेक्षाकृत समान पैटर्न्स पर निर्भर करता है। कंप्यूटर विज़न के समस्या-डोमेन को समझना कंप्यूटर विज़न को सफलतापूर्वक लागू करने के लिए अत्यंत महत्वपूर्ण है। ट्रांसफ़र लर्निंग में उपयोग होने वाले मॉडलों (डेटासेट्स, तकनीकें, आदि) की पृष्ठभूमि जानकर, आप प्रयोग के दौरान समय बर्बाद करने से बच सकते हैं और उन मॉडलों के फाइन-ट्यूनिंग पर ध्यान केंद्रित कर सकते हैं जो वास्तविक अंतर ला सकते हैं।
यह ब्लॉग पोस्ट 'ट्रांसफ़र लर्निंग' की अवधारणा और इसे मशीन लर्निंग अनुप्रयोगों में कैसे उपयोग किया जाता है, का परिचय देगी। ट्रांसफ़र लर्निंग कोई मशीन लर्निंग मॉडल या तकनीक नहीं है; बल्कि यह मशीन लर्निंग के भीतर एक 'डिज़ाइन कार्यप्रणाली' है। एक अन्य 'डिज़ाइन कार्यप्रणाली' का उदाहरण सक्रिय लर्निंग है।