Curso
Entendendo Machine Learning
2 h
308K
Este post apresenta o conceito de "transfer learning" e como ele é usado em aplicações de machine learning. Transfer learning não é um modelo ou técnica em si; é uma "metodologia de design" dentro de machine learning. Outro exemplo de "metodologia de design" é o active learning.
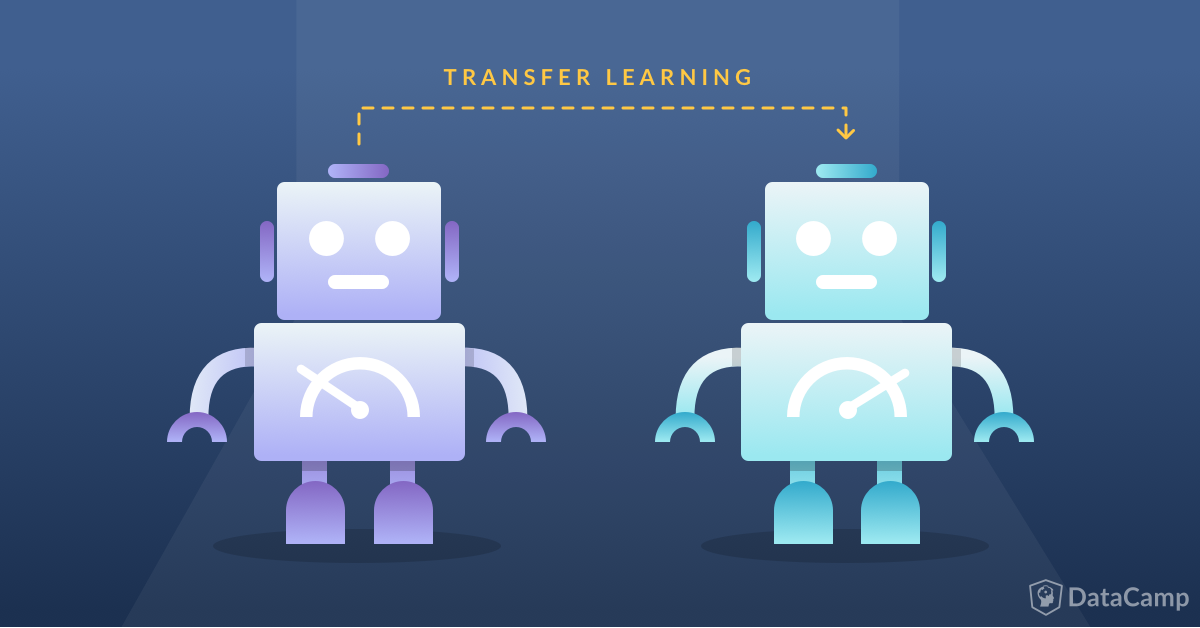
Um próximo post do blog vai explicar como você pode usar active learning em conjunto com transfer learning para aproveitar ao máximo dados existentes (e novos). Em termos gerais, aplicações de machine learning que aproveitam informações externas para melhorar o desempenho ou a capacidade de generalização usam transfer learning.
A ideia central do transfer learning é utilizar conhecimento aprendido em tarefas com muitos dados rotulados em cenários onde há poucos dados rotulados. Criar dados rotulados é caro, então tirar o máximo dos conjuntos já existentes é fundamental.
No modelo tradicional de machine learning, o objetivo principal é generalizar para dados inéditos com base em padrões aprendidos no treinamento. Com transfer learning, você tenta impulsionar esse processo de generalização partindo de padrões já aprendidos em outra tarefa. Em vez de começar o aprendizado de uma folha em branco (geralmente inicializada aleatoriamente), você parte de padrões aprendidos para resolver um problema diferente.
A transferência de conhecimento e de padrões é possível em várias áreas. O post de hoje ilustra transfer learning com exemplos de diferentes domínios. O objetivo é incentivar cientistas de dados a experimentar transfer learning em seus projetos de machine learning e mostrar seus prós e contras.
Há três motivos pelos quais eu considero entender bem transfer learning uma habilidade crítica para qualquer cientista de dados:
 |
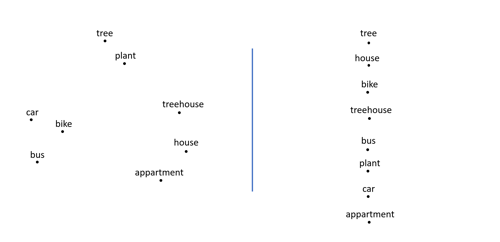 |
Transfer learning, como o nome indica, exige a capacidade de transferir conhecimento de um domínio para outro. Ele pode ser interpretado em alto nível, por exemplo, quando arquiteturas de NLP são reutilizadas em problemas de previsão de sequência, já que muitos problemas de NLP podem ser reduzidos a isso. Também pode ser interpretado em baixo nível, quando você efetivamente reutiliza parâmetros de um modelo em outro (skip-gram, continuous bag-of-words etc.). Os requisitos de transfer learning são, ao mesmo tempo, específicos do problema e do modelo. As próximas duas seções discutem, respectivamente, uma abordagem de alto nível e outra de baixo nível. Embora você encontre nomes diferentes na literatura, a ideia principal de transfer learning continua valendo.
No aprendizado multitarefa, você treina um modelo em diferentes tarefas ao mesmo tempo. Normalmente, usam-se modelos de deep learning por sua flexibilidade de adaptação.
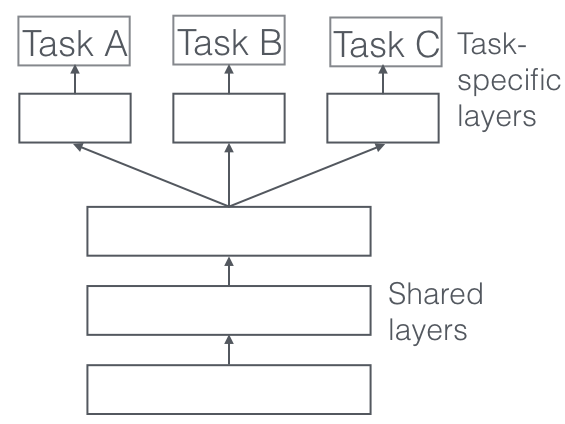
A arquitetura da rede é ajustada de forma que as primeiras camadas sejam compartilhadas entre tarefas, seguidas por camadas e saídas específicas de cada uma. A ideia é que, ao treinar uma rede em várias tarefas, ela generalize melhor, já que precisa ir bem em tarefas que exigem "conhecimentos" ou "processamentos" semelhantes.
Um exemplo em NLP: suponha que o objetivo final seja reconhecer entidades. Em vez de treinar o modelo apenas para esse fim, você também o usa para etiquetagem morfossintática, previsão da próxima palavra etc. Assim, o modelo se beneficia da estrutura aprendida nessas tarefas e nos diferentes datasets. Recomendo muito este blog do Sebastian Ruder e este outro post, ambos sobre aprendizado multitarefa.
Uma das grandes vantagens do deep learning é que a extração de atributos é "automática". Com base nos dados rotulados e no backpropagation, a rede consegue determinar quais atributos são úteis para a tarefa. A rede "descobre" que parte da entrada importa para, por exemplo, classificar uma imagem. Isso abstrai o trabalho manual de definir features. Redes de deep learning podem ser reutilizadas em outros problemas, pois o tipo de atributo extraído costuma ser útil em diferentes contextos. Em um featuriser, essencialmente você usa as primeiras camadas da rede para obter os atributos úteis, mas não aproveita a saída final, que é específica demais da tarefa.
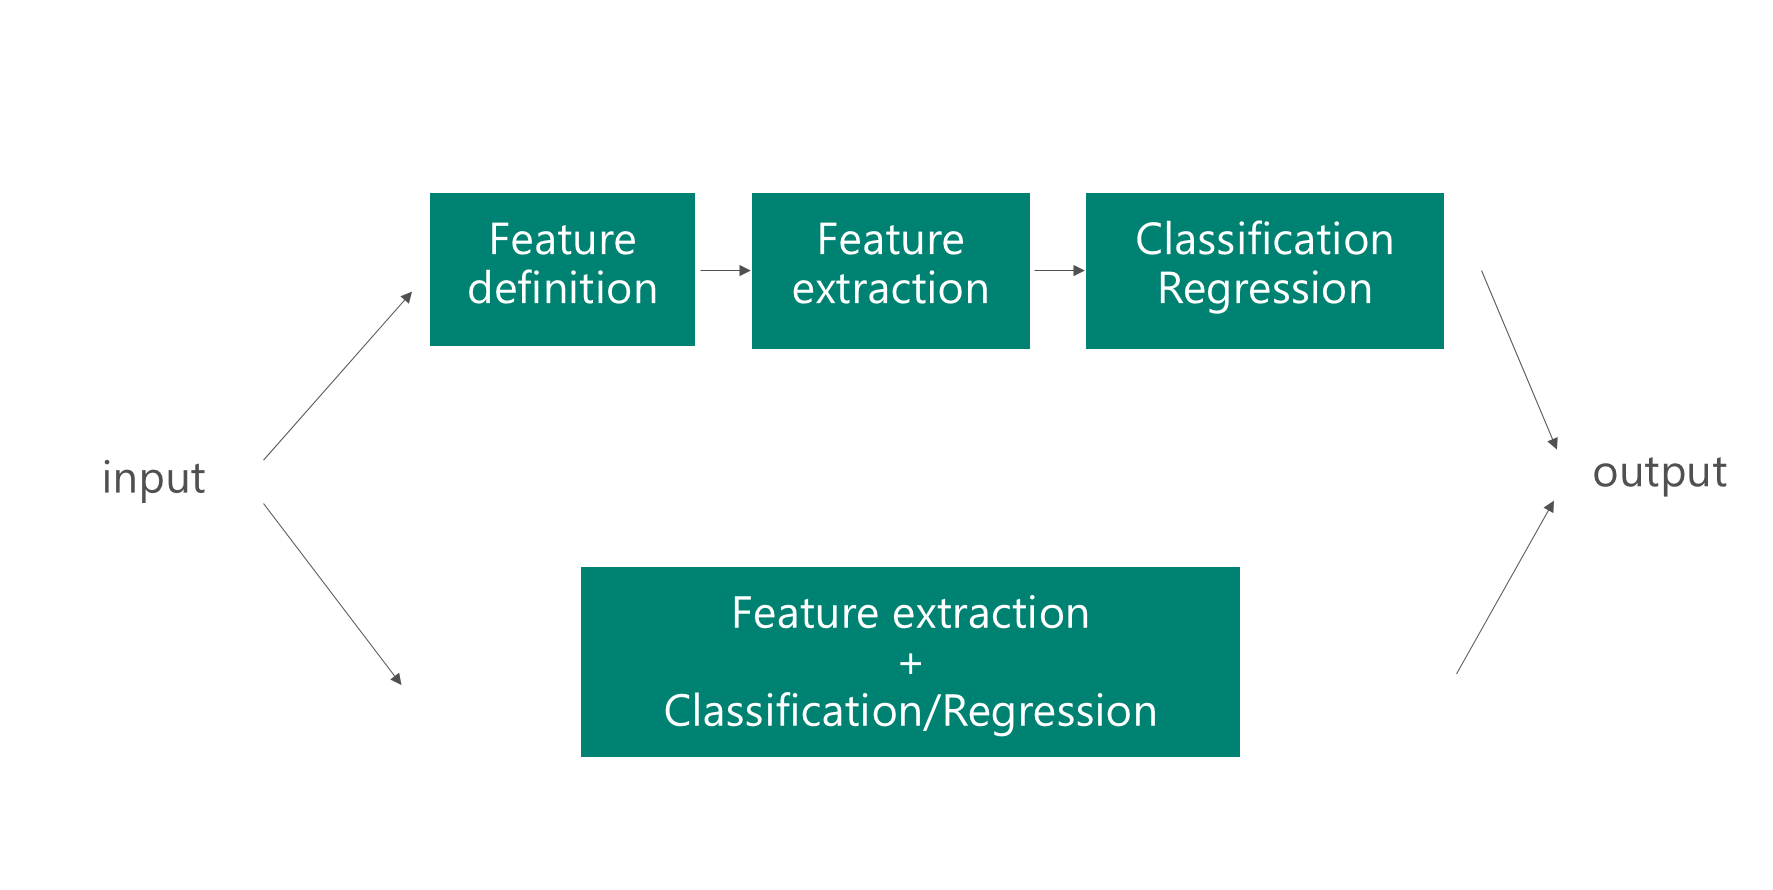
Sabendo que sistemas de deep learning são bons em extrair atributos, como reutilizar redes existentes para essa extração em outras tarefas? Dá para enviar uma amostra de dado pela rede e capturar uma das camadas intermediárias como saída. Essa camada intermediária pode ser interpretada como uma representação processada e de comprimento fixo dos dados brutos. Normalmente, o conceito de featuriser é usado em visão computacional. As imagens são passadas por uma rede pré-treinada (por exemplo, VGG ou AlexNet) e um outro método de machine learning é aplicado sobre a nova representação. Extrair uma camada intermediária como representação reduz drasticamente o tamanho original dos dados, tornando-os mais adequados a técnicas tradicionais (por exemplo, regressão logística ou SVM tendem a funcionar melhor com uma representação pequena, como dimensão 128, do que com a original, por exemplo, 128x128=16384 dimensões).
Um dos meus posts anteriores mostrou como muitas pipelines de NLP hoje usam word embeddings. Eles representam palavras de forma mais informativa que one-hot encodings. São amplamente utilizados e existem diferentes variantes. Em geral, variam pelo corpus de origem (Wikipedia, notícias etc.) e pelo tipo de modelo de embedding. Entender a origem desses modelos e corpora é importante para saber quando faz sentido aplicar transfer learning com embeddings. Muita gente não chamaria o uso de embeddings de transfer learning, mas eu discordo, pela semelhança com a visão computacional: ao usar embeddings, você utiliza um featuriser ou a rede de embedding para converter palavras em vetores.
Mesmo com seus anos de estrada, o word2vec ainda é uma abordagem muito influente. Métodos mais recentes, como o FastText, disponibilizaram embeddings em muitos idiomas. Embeddings como word2vec ou FastText são um salto em relação a bag-of-words. Ainda assim, sua utilidade depende muito do domínio do problema.
Imagine que você está construindo um serviço de recomendação de notícias para times de vendas. Essas pessoas querem receber notícias sobre empresas que podem se interessar pelo produto que vendem. O vocabulário de notícias tende a ser razoavelmente geral, o que costuma ser bem coberto pela maioria dos embeddings (dependendo do corpus de treinamento). Além disso, se os vendedores coletarem por algumas semanas as notícias que leem, você rapidamente terá um grande corpus rotulado. Reaproveitando embeddings, é possível que o motor de recomendação tenha um desempenho bem melhor.
Agora imagine classificar tópicos em contratos jurídicos — e não qualquer contrato, mas contratos franceses no contexto de direito da concorrência. Normalmente, esses datasets não são rotulados, ou há pouquíssimos documentos rotulados. A seguir, veja por que o transfer learning "pronto para uso" pode não ir muito longe nesse caso:
Recomendo muito este excelente post sobre o estado atual dos word embeddings. Considerar os problemas e soluções apresentados ali é essencial para criar sistemas de NLP e embeddings robustos quando se trabalha com poucos dados.
Gensim, spaCy e FastText são três ótimos frameworks para usar embeddings rapidamente em aplicações de machine learning. Além disso, permitem treinar embeddings personalizados. Confira este tutorial de gensim, este do spaCy e este do FastText para saber mais!
Métodos de deep learning geraram avanços enormes em visão computacional. Em vez de definir manualmente atributos específicos do problema — como Histogram of Oriented Gradients (HoG), histogramas etc. —, o deep learning permite treinar modelos que recebem imagens brutas como entrada. A complexidade da definição de atributos migrou para a de projetar a rede. Embora arquiteturas sejam frequentemente reutilizadas, não há uma fórmula única. Normalmente, as técnicas surgem e são aplicadas na pesquisa em datasets gigantes (como o ImageNet ou o MS COCO). Para ganhar desempenho nesses conjuntos, pesquisadores criaram arquiteturas cada vez mais profundas e complexas, com milhões de parâmetros — o que (geralmente) não escala para datasets pequenos. Treinar um ResNet ou VGG em menos de 5.000 imagens leva a overfitting significativo. A onda do deep learning trouxe grandes avanços, mas quem tem poucos dados muitas vezes ficou de fora.
Ao que tudo indica, redes profundas aprendem representações hierárquicas de atributos (veja este post da Distill). As camadas inferiores capturam padrões de baixo nível, como bordas; as superiores aprendem conceitos mais altos, muitas vezes pouco interpretáveis, como formas. Essa hierarquia também aparece quando a rede é treinada em datasets diferentes, sugerindo que pode ser reutilizada em domínios distintos.
Há duas abordagens comuns para usar transfer learning em visão computacional.
A API do Keras permite carregar redes pré-treinadas e manter várias camadas fixas durante o treinamento. A seguir, trago dois casos: um em que transfer learning ajuda e outro em que não ajuda tanto.
Imagine que você trabalha com preservação da vida selvagem e quer classificar animais que aparecem em uma câmera ao vivo. Se você estiver monitorando espécies ameaçadas, pode ser difícil reunir muitos dados rotulados. Como as redes pré-treinadas geralmente são treinadas em um domínio amplo (comida, animais, objetos), usar uma rede pré-treinada como featuriser ou inicializador faz todo sentido.
Por outro lado, pense em analisar radiografias para oncologistas. Essas imagens não são o clássico conjunto de gatos e cachorros — são resultados de exames em pacientes. Embora convertidas para RGB, normalmente aparecem em tons de cinza para destacar o exame. Uma rede pré-treinada pode detectar formas e bordas em imagens RGB, mas provavelmente terá dificuldade nessas radiografias, que não fazem parte do treinamento original. Além disso, em cenários médicos, a quantidade de dados rotulados costuma ser baixa. Existem técnicas para aproveitar dados não rotulados (muitas vezes abundantes), mas elas exigem mais trabalho e ajuste fino. Em geral, buscam pré-treinar os pesos da rede de classificação ao treinar cada camada, iterativamente, para reconstruir as imagens (usando camadas convolucionais e deconvolucionais). Combinar essas técnicas com redes pré-treinadas costuma melhorar a convergência.
As duas abordagens acima dependem de uma suposição importante: os padrões extraídos no dataset original são úteis no novo dataset. Medir essa utilidade é difícil, mas é uma hipótese crucial. Imagens sísmicas, hiperespectrais ou médicas têm pouca semelhança com as do ImageNet. Já identificar qual sinal de trânsito aparece em uma imagem depende de padrões bem parecidos. Entender o domínio do problema é essencial para aplicar visão computacional com sucesso. Conhecendo o histórico dos modelos (datasets, técnicas etc.) usados no transfer learning, você evita perder tempo na experimentação e foca em ajustar o que realmente faz diferença.
Cursos de machine learning
Curso
Curso
Curso
blog
Matt Crabtree
14 min
blog
Kurtis Pykes
8 min
blog
Yolanda Ferreiro
7 min
blog
Natassha Selvaraj
15 min
blog
Abid Ali Awan
11 min
Tutorial
Moez Ali
14 min