Khóa học
Tìm hiểu Machine Learning
2 giờ
313.8K
Bài viết này sẽ giới thiệu khái niệm "học chuyển giao" và cách nó được sử dụng trong các ứng dụng machine learning. Học chuyển giao không phải là một mô hình hay kỹ thuật machine learning; đúng hơn, nó là một "phương pháp thiết kế" trong machine learning. Một loại "phương pháp thiết kế" khác, chẳng hạn, là học chủ động.
Bài viết tiếp theo sẽ giải thích cách bạn có thể sử dụng học chủ động kết hợp với học chuyển giao để tận dụng tối ưu dữ liệu hiện có (và dữ liệu mới). Theo nghĩa rộng, các ứng dụng machine learning tận dụng thông tin bên ngoài để cải thiện hiệu năng hoặc khả năng khái quát hóa đều đang dùng học chuyển giao.
Ý tưởng chung của học chuyển giao là sử dụng kiến thức học được từ các tác vụ có nhiều dữ liệu gán nhãn trong bối cảnh chỉ có rất ít dữ liệu gán nhãn. Việc tạo dữ liệu gán nhãn rất tốn kém, nên tận dụng tối đa các bộ dữ liệu sẵn có là then chốt.
Trong một mô hình machine learning truyền thống, mục tiêu chính là khái quát hóa sang dữ liệu chưa thấy dựa trên các mẫu được học từ dữ liệu huấn luyện. Với học chuyển giao, bạn cố gắng kích hoạt quá trình khái quát hóa này bằng cách bắt đầu từ các mẫu đã học cho một tác vụ khác. Về bản chất, thay vì khởi động quá trình học từ con số 0 (thường được khởi tạo ngẫu nhiên), bạn bắt đầu từ những mẫu đã được học để giải một tác vụ khác.
Việc chuyển giao kiến thức và mẫu có thể thực hiện trong rất nhiều miền khác nhau. Bài viết hôm nay sẽ minh họa học chuyển giao bằng cách xem xét một số ví dụ ở các miền này. Mục tiêu là khuyến khích các nhà khoa học dữ liệu thử nghiệm học chuyển giao trong các dự án machine learning của mình và giúp họ nhận diện ưu điểm và nhược điểm.
Có ba lý do vì sao tôi cho rằng hiểu biết vững vàng về học chuyển giao là kỹ năng thiết yếu đối với nhà khoa học dữ liệu:
 |
 |
Đúng như tên gọi, học chuyển giao đòi hỏi khả năng chuyển kiến thức từ miền này sang miền khác. Học chuyển giao có thể được hiểu ở mức độ cao, tức là kiến trúc mô hình NLP có thể tái sử dụng cho các bài toán dự đoán chuỗi, vì nhiều bài toán NLP về bản chất có thể quy về dự đoán chuỗi. Học chuyển giao cũng có thể được hiểu ở mức độ thấp, nơi bạn thực sự tái sử dụng tham số từ một mô hình trong một mô hình khác (skip-gram, continuous bag-of-words, v.v.). Yêu cầu của học chuyển giao vừa phụ thuộc vào bài toán vừa phụ thuộc vào mô hình. Hai phần tiếp theo sẽ lần lượt bàn về cách tiếp cận mức cao và mức thấp đối với học chuyển giao. Dù trong tài liệu bạn sẽ gặp các khái niệm này với những tên gọi khác nhau, ý tưởng bao trùm của học chuyển giao vẫn hiện diện.
Trong học đa nhiệm, bạn huấn luyện một mô hình trên các tác vụ khác nhau cùng lúc. Thông thường, các mô hình học sâu được dùng vì chúng có thể điều chỉnh linh hoạt.
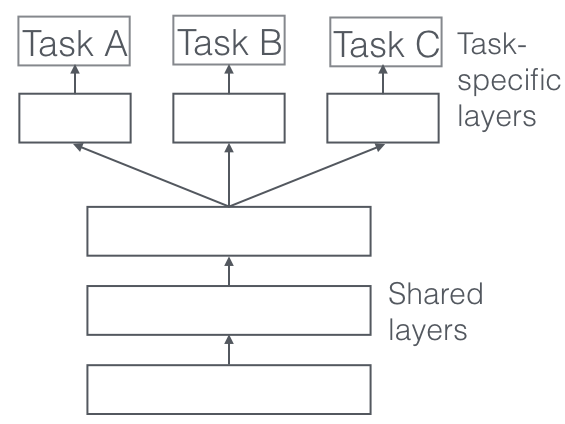
Kiến trúc mạng được điều chỉnh sao cho các lớp đầu dùng chung cho các tác vụ khác nhau, theo sau là các lớp và đầu ra riêng cho từng tác vụ. Ý tưởng chung là bằng cách huấn luyện mạng trên nhiều tác vụ, mạng sẽ khái quát hóa tốt hơn, vì mô hình buộc phải hoạt động tốt trên các tác vụ đòi hỏi loại "kiến thức" hoặc "xử lý" tương tự.
Một ví dụ trong NLP là mô hình có mục tiêu cuối cùng là nhận dạng thực thể. Thay vì chỉ huấn luyện mô hình cho tác vụ nhận dạng thực thể, bạn còn dùng nó để phân loại loại từ (POS), dự đoán từ tiếp theo, ... Nhờ đó, mô hình sẽ hưởng lợi từ cấu trúc học được từ các tác vụ và bộ dữ liệu khác nhau. Tôi rất khuyến nghị bài blog này của Sebastian Rude và bài viết này, cả hai đều bàn về học đa nhiệm để bạn tìm hiểu thêm.
Một trong những lợi thế lớn của mô hình học sâu là trích xuất đặc trưng mang tính "tự động". Dựa trên dữ liệu gán nhãn và lan truyền ngược, mạng có thể xác định đặc trưng hữu ích cho một tác vụ. Mạng "tự tìm" phần nào của đầu vào là quan trọng để, chẳng hạn, phân loại ảnh. Điều này có nghĩa công việc thủ công là định nghĩa đặc trưng đã được trừu tượng hóa. Mạng học sâu có thể tái sử dụng cho các bài toán khác, vì loại đặc trưng được trích xuất thường hữu ích cho những bài toán khác. Về cơ bản, trong một bộ trích đặc trưng, bạn dùng các lớp đầu của mạng để xác định đặc trưng hữu ích, nhưng bạn không dùng đầu ra cuối của mạng vì nó quá đặc thù theo tác vụ.
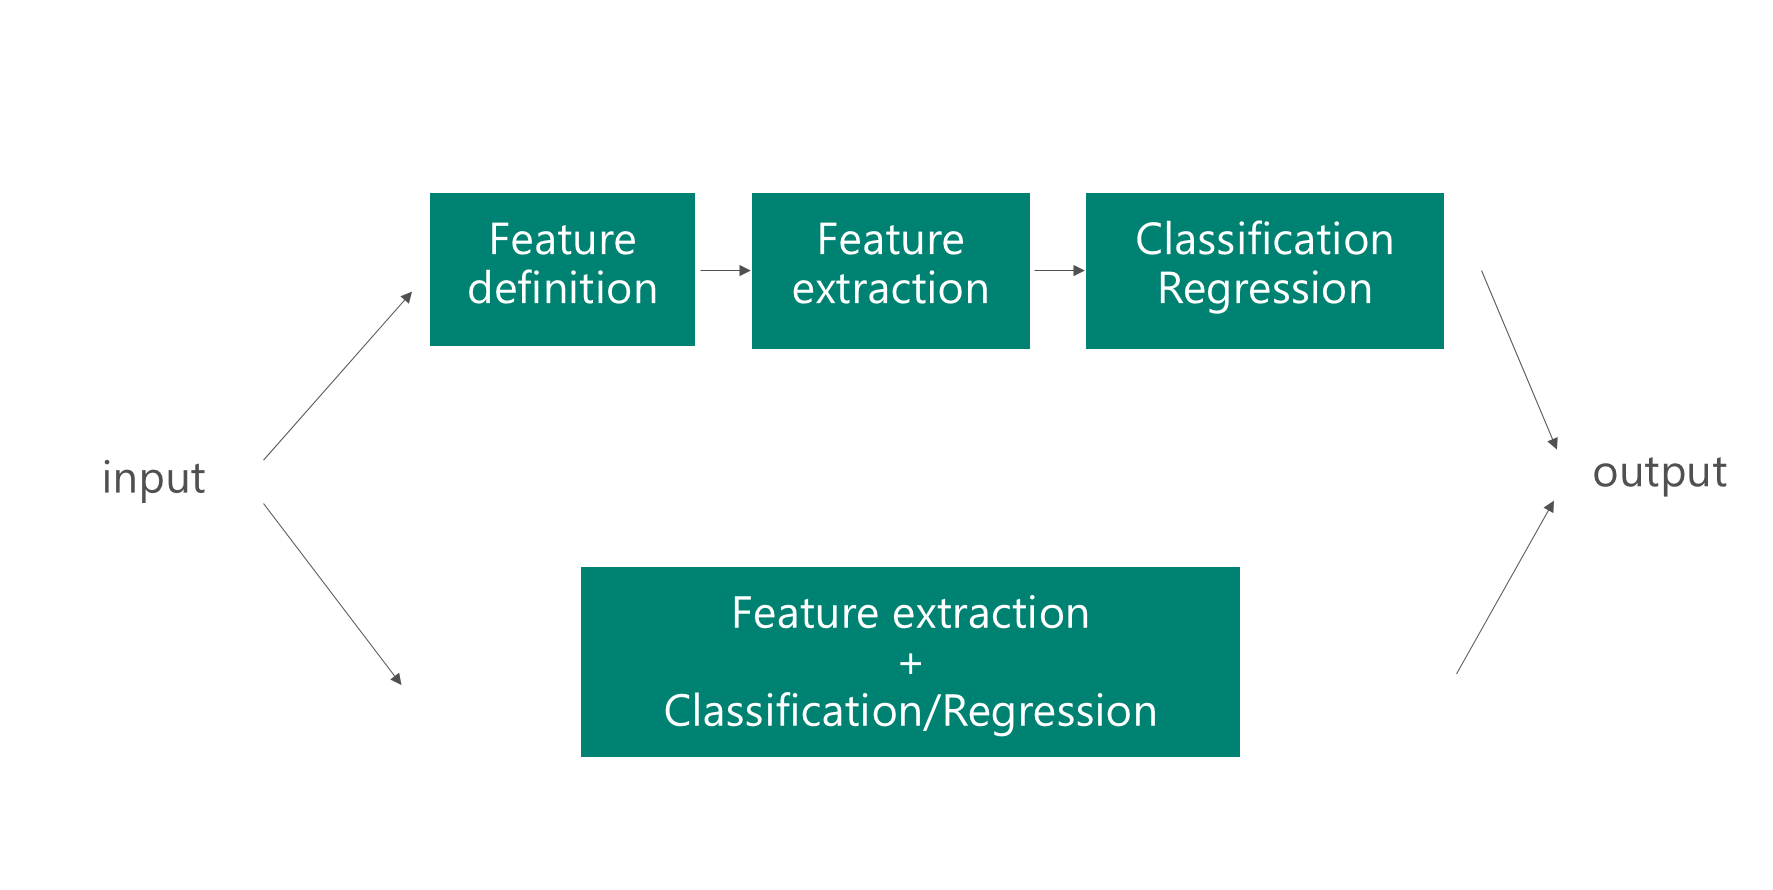
Nếu hệ thống học sâu giỏi trích xuất đặc trưng, vậy làm sao bạn có thể tái sử dụng các mạng hiện có để trích đặc trưng cho tác vụ khác? Có thể đưa một mẫu dữ liệu vào mạng và lấy một trong các lớp trung gian trong mạng làm đầu ra. Lớp trung gian này có thể được hiểu là một biểu diễn đã xử lý, có độ dài cố định của dữ liệu thô. Thông thường, khái niệm bộ trích đặc trưng được dùng trong bối cảnh thị giác máy tính. Ảnh sẽ được đưa vào một mạng đã huấn luyện sẵn (ví dụ, VGG hoặc AlexNet) và một phương pháp machine learning khác được dùng trên biểu diễn dữ liệu mới. Trích xuất một lớp trung gian làm biểu diễn của ảnh giúp giảm đáng kể kích thước dữ liệu gốc, khiến chúng phù hợp hơn với các kỹ thuật machine learning truyền thống (ví dụ, hồi quy logistic hoặc SVM hoạt động tốt hơn với biểu diễn ảnh có kích thước nhỏ, như 128 chiều, so với ảnh gốc, chẳng hạn 128x128=16384 chiều).
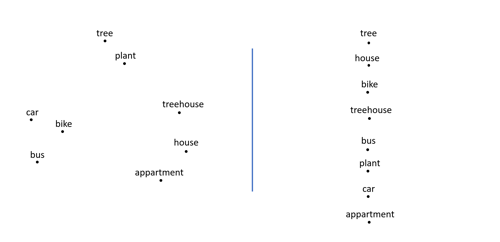
Một bài viết trước đây của tôi đã bàn về việc nhiều pipeline NLP hiện nay sử dụng word embedding. Các word embedding là cách biểu diễn từ thông tin hơn so với one-hot encoding. Chúng được dùng rộng rãi và có nhiều biến thể. Thông thường, các biến thể này khác nhau ở kho ngữ liệu nguồn, như Wikipedia, bài báo, v.v., và khác nhau ở mô hình embedding. Việc hiểu bối cảnh của các mô hình và kho ngữ liệu này rất quan trọng để biết liệu dùng học chuyển giao với word embedding có hợp lý hay không. Mọi người thường không gọi việc dùng word embedding là học chuyển giao, nhưng tôi không đồng ý, xét tới sự tương đồng với học chuyển giao trong thị giác máy tính. Thực chất, dùng word embedding nghĩa là bạn đang dùng một bộ trích đặc trưng hoặc mạng embedding để chuyển từ thành vector.
Dù word2vec đã ra đời 4 năm, đây vẫn là một phương pháp embedding từ có ảnh hưởng lớn. Ngược lại, các phương pháp gần đây như FastText đã đưa word embedding tới nhiều ngôn ngữ. Embedding từ word2vec hoặc FastText là một bước tiến lớn so với phương pháp bag-of-words. Tuy nhiên, tính hữu ích của chúng thường được quyết định bởi miền bài toán.
Hãy tưởng tượng bạn đang xây dựng dịch vụ gợi ý tin tức cho nhân viên bán hàng. Họ muốn nhận tin về các công ty có thể quan tâm đến sản phẩm họ đang bán. Từ vựng dùng trong bài báo thường khá chung, nghĩa là vốn từ được dùng thường được hỗ trợ bởi hầu hết các word embedding (tùy vào kho ngữ liệu chúng được huấn luyện). Thêm vào đó, nếu bạn nhờ đội bán hàng thu thập bài báo họ đọc trong vài tuần, bạn sẽ có ngay một kho ngữ liệu gán nhãn lớn trong tay. Nhờ tái sử dụng word embedding, có thể bộ máy gợi ý sẽ hoạt động tốt hơn đáng kể.
Mặt khác, giả sử bạn phải phân loại chủ đề cho các hợp đồng pháp lý. Không chỉ là hợp đồng pháp lý bất kỳ, mà là hợp đồng pháp lý tiếng Pháp trong bối cảnh luật cạnh tranh. Các bộ dữ liệu kiểu này thường không được gán nhãn, hoặc chỉ có một tập tài liệu gán nhãn hạn chế. Phần tiếp theo sẽ giải thích vì sao học chuyển giao dạng "mặc định" chỉ giúp bạn đến một mức nhất định trong trường hợp này:
Tôi rất khuyến khích bạn đọc bài viết xuất sắc này về tình hình hiện tại của word embedding. Việc cân nhắc các vấn đề và giải pháp nêu trong bài viết là chìa khóa để tạo ra hệ thống NLP và word embedding vững vàng khi làm việc với lượng dữ liệu hạn chế.
Gensim, spacy và FastText là ba framework tuyệt vời cho phép bạn nhanh chóng sử dụng word embedding trong ứng dụng machine learning của mình. Ngoài ra, chúng cũng hỗ trợ huấn luyện embedding tùy chỉnh. Xem gensim, spacy hoặc hướng dẫn FastText để tìm hiểu thêm!
Các phương pháp học sâu đã mang lại những thành công đáng kể trong thị giác máy tính. Thay vì phải định nghĩa thủ công các đặc trưng đặc thù cho bài toán, ví dụ đặc trưng Histogram of Oriented Gradients (HoG), đặc trưng histogram, v.v., học sâu cho phép người làm thực hành huấn luyện mô hình nhận ảnh thô làm đầu vào. Độ phức tạp vốn có của việc định nghĩa đặc trưng giờ đã chuyển sang độ phức tạp của việc định nghĩa kiến trúc mạng. Dù kiến trúc thường được tái sử dụng, không có một chiến lược duy nhất để xây dựng kiến trúc mạng. Thông thường, kỹ thuật học sâu được phát minh và áp dụng trong bối cảnh nghiên cứu trên những bộ dữ liệu khổng lồ (như Imagenet hoặc MS Coco). Để nâng cao hiệu năng trên các bộ dữ liệu lớn này, các nhà nghiên cứu đã đề xuất những kiến trúc mạng ngày càng sâu và phức tạp. Các kiến trúc này tạo ra mô hình với hàng triệu tham số và (thường) không thể mở rộng cho các bộ dữ liệu ảnh nhỏ. Huấn luyện một kiến trúc như ResNet hoặc VGG trên một bộ dữ liệu có dưới 5.000 ảnh sẽ dẫn đến quá khớp đáng kể. Xu hướng học sâu gần đây đã mang lại tiến bộ lớn, nhưng có vẻ các nhà khoa học dữ liệu chỉ có bộ dữ liệu nhỏ đã bị "bỏ lạnh".
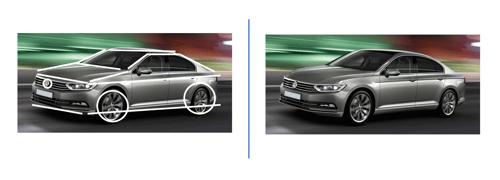
Hóa ra, mạng học sâu học các biểu diễn đặc trưng có tính phân cấp (xem bài viết này của Distill). Điều này có nghĩa các lớp thấp học các đặc trưng mức thấp, như cạnh, trong khi các lớp cao học các khái niệm mức cao hơn nhưng khó diễn giải, như hình dạng. Ý tưởng về biểu diễn đặc trưng phân cấp này cũng xuất hiện khi mạng được huấn luyện trên các bộ dữ liệu khác nhau, cho thấy chúng có thể tái sử dụng trong các miền bài toán khác.
Có hai cách tiếp cận khi dùng học chuyển giao cho bài toán thị giác máy tính.
API của Keras cho phép bạn tải các mạng đã huấn luyện và giữ cố định một số lớp trong quá trình huấn luyện. Ở phần tiếp theo tôi sẽ lại bàn về hai tình huống sử dụng, một trong đó học chuyển giao hữu ích, và một tình huống thì không.
Hãy tưởng tượng bạn làm trong lĩnh vực bảo tồn động vật hoang dã và muốn phân loại các loài động vật xuất hiện trên luồng camera trực tiếp. Đặc biệt nếu bạn cố gắng theo dõi các loài có nguy cơ tuyệt chủng, có khả năng bạn sẽ không thể thu thập được nhiều dữ liệu gán nhãn. Vì các mạng đã huấn luyện thường được huấn luyện trên miền khái niệm rất rộng (từ đồ ăn, động vật đến đồ vật), dùng một mạng đã huấn luyện làm bộ trích đặc trưng hoặc bộ khởi tạo chắc chắn là một lựa chọn.
Mặt khác, hãy tưởng tượng bạn cần phân tích ảnh X-quang cho bác sĩ ung bướu. Những ảnh này không phải dạng ảnh mèo-chó điển hình, vì chúng là kết quả của một lần quét chụp bệnh nhân. Dù có thể chuyển về ảnh RGB, chúng thường ở dạng thang xám để thể hiện kết quả quét. Dù một mạng đã huấn luyện có thể phát hiện hình dạng và cạnh từ ảnh RGB, nhiều khả năng nó sẽ gặp khó khăn khi phát hiện những yếu tố này trên ảnh X-quang vì chúng không nằm trong dữ liệu huấn luyện của mô hình đã huấn luyện. Thêm vào đó, trong bối cảnh y tế, lượng dữ liệu gán nhãn thường thấp. Có một số kỹ thuật tận dụng dữ liệu không gán nhãn (có thể dồi dào), nhưng chúng thường đòi hỏi nhiều công sức và tinh chỉnh. Thông thường, các kỹ thuật này cố gắng tiền huấn luyện trọng số của mạng phân loại bằng cách huấn luyện lặp mỗi lớp để tái tạo ảnh (dùng các lớp tích chập và giải tích chập). Kết hợp các kỹ thuật này với mạng đã huấn luyện thường được dùng để cải thiện hội tụ.
Cả hai phương pháp thị giác máy tính nêu trên đều dựa vào một giả định quan trọng: các mẫu trích xuất trong bộ dữ liệu gốc hữu ích trong ngữ cảnh của bộ dữ liệu mới. Tính hữu ích này khó định lượng, nhưng là giả định quan trọng cần cân nhắc. Ảnh địa chấn, siêu phổ hoặc thậm chí ảnh y khoa có mức độ tương đồng hạn chế với các ảnh trong ImageNet. Ngược lại, xác định ảnh chứa biển báo giao thông nào lại phụ thuộc vào các mẫu khá tương tự. Hiểu rõ miền bài toán thị giác máy tính là yếu tố then chốt để áp dụng thành công. Bằng cách nắm được bối cảnh của các mô hình (bộ dữ liệu, kỹ thuật, v.v.) dùng trong học chuyển giao, bạn có thể tránh lãng phí thời gian khi thử nghiệm và tập trung tinh chỉnh những mô hình có khả năng tạo khác biệt.
Khóa học Machine Learning
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
