Kurs
Machine Learning verstehen
2 Std.
308K
Dieser Blogpost führt in das Konzept des „Transfer Learning“ ein und zeigt, wie es in Machine-Learning-Anwendungen eingesetzt wird. Transfer Learning ist kein einzelnes ML-Modell oder -Verfahren, sondern eher eine „Designmethodik“ innerhalb des Machine Learnings. Eine weitere „Designmethodik“ ist zum Beispiel Active Learning.
Ein nächster Blogpost zeigt dir, wie du Active Learning in Kombination mit Transfer Learning einsetzen kannst, um vorhandene (und neue) Daten optimal zu nutzen. Ganz allgemein gilt: Machine-Learning-Anwendungen, die externe Informationen heranziehen, um Leistung oder Generalisierungsfähigkeit zu verbessern, nutzen Transfer Learning.
Die Grundidee von Transfer Learning ist, Wissen aus Aufgaben zu nutzen, für die viele gelabelte Daten vorliegen, und es auf Settings zu übertragen, in denen nur wenige gelabelte Daten verfügbar sind. Gelabelte Daten zu erstellen ist teuer, daher ist die optimale Nutzung bestehender Datensätze entscheidend.
In einem traditionellen Machine-Learning-Modell besteht das Hauptziel darin, auf Basis der aus Trainingsdaten gelernten Muster auf unbekannte Daten zu generalisieren. Mit Transfer Learning beschleunigst du diesen Generalisierungsprozess, indem du mit Mustern startest, die für eine andere Aufgabe gelernt wurden. Anstatt also auf einem (oft zufällig initialisierten) leeren Blatt zu beginnen, startest du mit Mustern, die bereits zur Lösung einer anderen Aufgabe gelernt wurden.
Wissens- und Mustertransfer ist in vielen Domänen möglich. Der heutige Beitrag veranschaulicht Transfer Learning anhand mehrerer Beispiele aus unterschiedlichen Bereichen. Ziel ist es, Data Scientists zum Experimentieren mit Transfer Learning in ihren Projekten zu ermutigen und sie für Vor- und Nachteile zu sensibilisieren.
Aus drei Gründen ist ein gutes Verständnis von Transfer Learning aus meiner Sicht eine Schlüsselkompetenz für Data Scientists:
 |
 |
Transfer Learning erfordert – wie der Name sagt – die Fähigkeit, Wissen von einer Domäne in eine andere zu übertragen. Das lässt sich auf hoher Ebene interpretieren: NLP-Architekturen können für Sequenzvorhersagen wiederverwendet werden, weil viele NLP-Probleme letztlich auf Sequenzvorhersage hinauslaufen. Auf niedriger Ebene bedeutet es, dass du tatsächlich Parameter eines Modells in einem anderen wiederverwendest (Skip-gram, Continuous Bag-of-Words etc.). Die Anforderungen an Transfer Learning sind teils problem-, teils modellspezifisch. Die nächsten beiden Abschnitte beleuchten einen High-Level- und einen Low-Level-Ansatz. Auch wenn in der Literatur andere Begriffe kursieren, bleibt das übergeordnete Konzept gleich.
Beim Multi-Task-Learning trainierst du ein Modell gleichzeitig auf mehreren Aufgaben. Häufig kommen Deep-Learning-Modelle zum Einsatz, weil sie sich flexibel anpassen lassen.
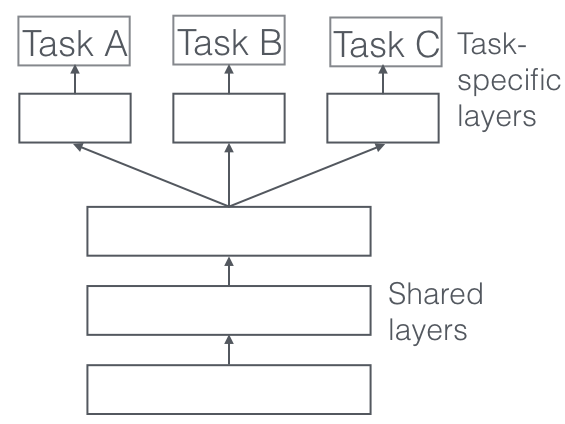
Die Netzwerkarchitektur wird so angepasst, dass die ersten Schichten für verschiedene Aufgaben gemeinsam genutzt werden. Darauf folgen aufgabenspezifische Schichten und Ausgaben. Die Idee: Durch das gemeinsame Training auf mehreren Aufgaben generalisiert das Netzwerk besser, weil es bei Aufgaben gut performen muss, die ähnliches „Wissen“ oder ähnliche „Verarbeitungsschritte“ erfordern.
Ein Beispiel in der NLP: Das Endziel ist die Erkennung von Entitäten. Anstatt das Modell nur darauf zu trainieren, lässt du es zusätzlich Wortarten klassifizieren, das nächste Wort vorhersagen, ... So profitiert das Modell von der dabei gelernten Struktur und den unterschiedlichen Datensätzen. Sehr empfehlenswert sind dieser Blog von Sebastian Ruder und dieser Beitrag, die Multi-Task-Learning ausführlich behandeln.
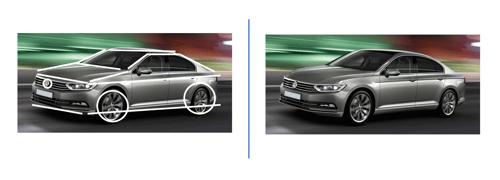
Ein großer Vorteil von Deep Learning ist die „automatische“ Merkmalsextraktion. Über gelabelte Daten und Backpropagation lernt das Netz, welche Features für eine Aufgabe nützlich sind. Das Netzwerk „findet heraus“, welche Teile des Inputs wichtig sind, um etwa ein Bild zu klassifizieren. Die manuelle Feature-Definition entfällt also. Deep-Learning-Netze lassen sich für andere Probleme wiederverwenden, weil die extrahierten Merkmalstypen oft auch dort hilfreich sind. Im Featurizer nutzt du im Kern die ersten Schichten des Netzes zur Merkmalsextraktion, verwendest aber nicht die Ausgabe des Netzes, da sie zu aufgabenspezifisch ist.
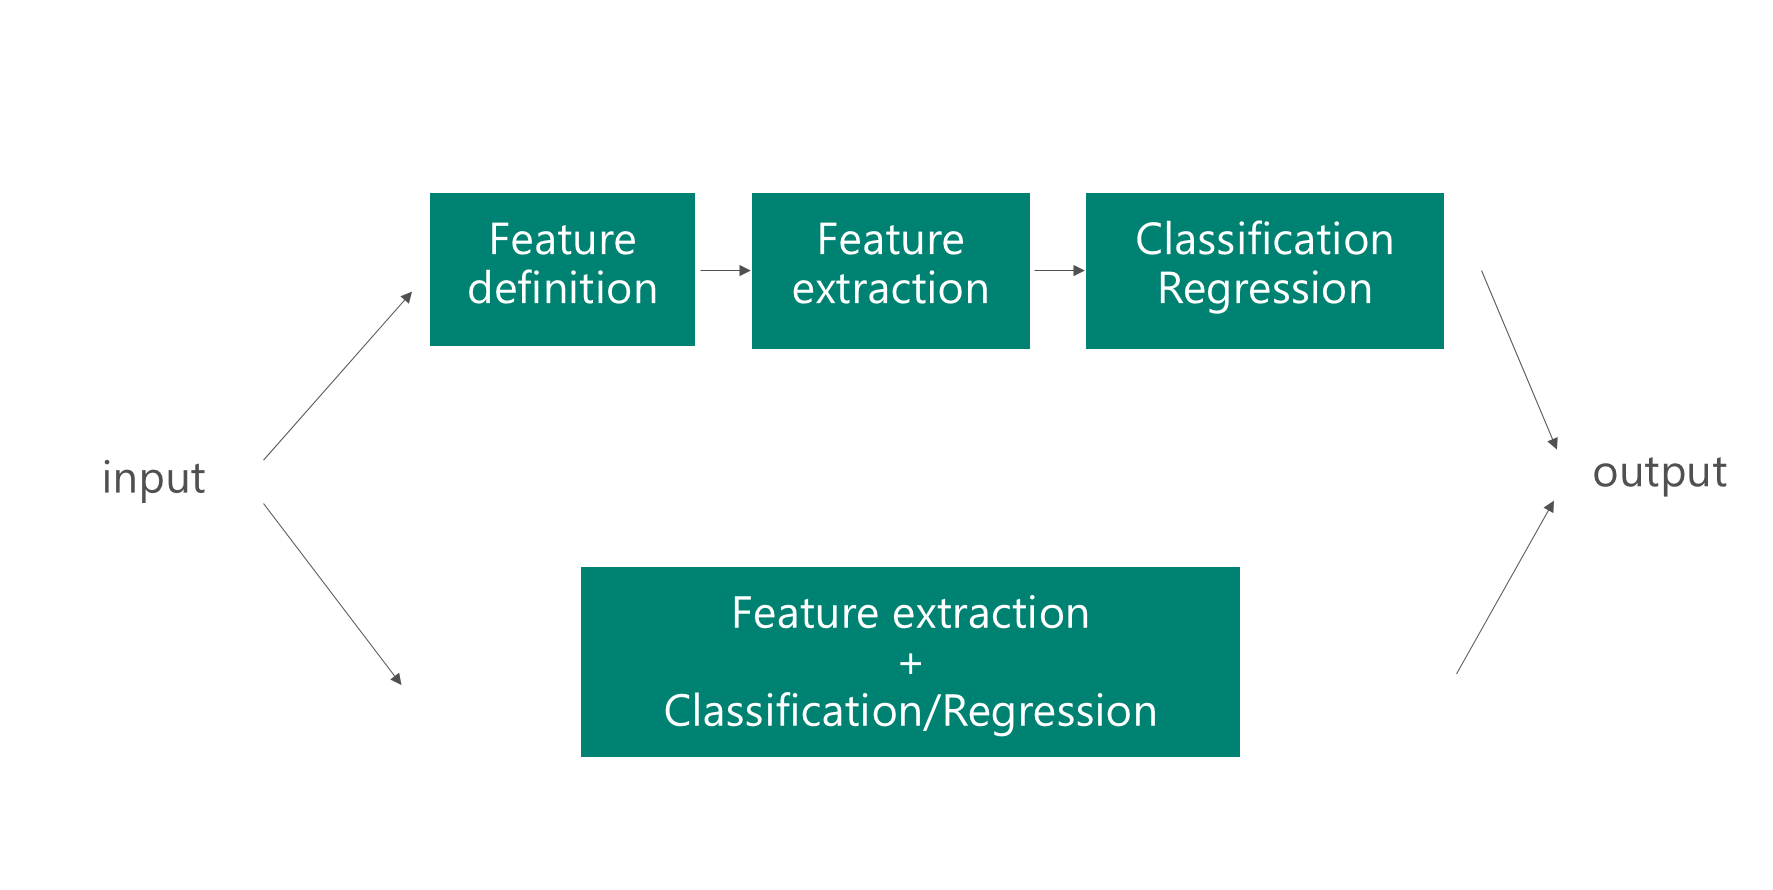
Wenn Deep-Learning-Systeme gut in der Merkmalsextraktion sind, wie kannst du bestehende Netze für andere Aufgaben wiederverwenden? Du kannst eine Datenprobe durchs Netz laufen lassen und eine der Zwischenschichten als Output entnehmen. Diese Zwischenschicht lässt sich als komprimierte, verarbeitete Repräsentation der Rohdaten interpretieren. Das Featurizer-Konzept wird häufig in der Bildverarbeitung genutzt: Bilder laufen durch ein vortrainiertes Netz (z. B. VGG oder AlexNet), und auf der neuen Datenrepräsentation setzt du eine andere ML-Methode ein. Eine Zwischenschicht als Bildrepräsentation zu verwenden, reduziert die ursprüngliche Datenmenge deutlich und macht sie für klassische ML-Techniken handlicher (z. B. funktionieren logistische Regression oder SVMs mit einer 128-dimensionalen Repräsentation oft besser als mit den ursprünglichen 128x128=16384 Dimensionen).
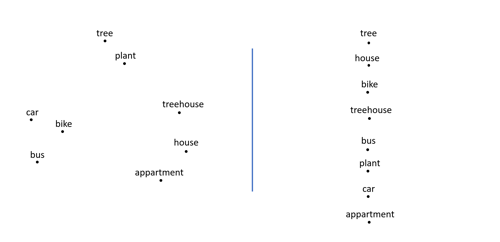
Einer meiner früheren Beiträge zeigt, wie viele NLP-Pipelines heute Word Embeddings nutzen. Diese sind eine informativere Wortrepräsentation als One-Hot-Codierungen. Sie sind weit verbreitet, und es gibt viele Varianten – sie unterscheiden sich typischerweise im zugrunde liegenden Korpus (Wikipedia, Nachrichtenartikel etc.) und im Embedding-Modell. Um einschätzen zu können, ob Transfer Learning mit Word Embeddings sinnvoll ist, musst du den Hintergrund von Modellen und Korpora kennen. Viele würden die Nutzung von Word Embeddings nicht als Transfer Learning bezeichnen; ich widerspreche, weil die Parallelen zur Bildverarbeitung offensichtlich sind. Im Kern nutzt du mit Embeddings einen Featurizer bzw. ein Embedding-Netz, um Wörter in Vektoren zu überführen.
Auch wenn word2vec schon älter ist, bleibt es ein einflussreicher Ansatz. Neuere Methoden wie FastText stellen Embeddings in vielen Sprachen bereit. Embeddings aus word2vec oder FastText sind ein großer Fortschritt gegenüber Bag-of-Words. Ihre Nützlichkeit hängt jedoch stark von der Domäne ab.
Stell dir vor, du baust einen News-Empfehlungsdienst für Vertriebsteams. Sie wollen Nachrichten zu Unternehmen erhalten, die sich für ihr Produkt interessieren könnten. Die Sprache in News-Artikeln ist meist relativ allgemein und wird von den meisten Embeddings gut abgedeckt (abhängig vom Trainingskorpus). Wenn du zusätzlich die gelesenen Artikel über ein paar Wochen sammelst, entsteht schnell ein großer gelabelter Korpus. Durch die Wiederverwendung von Word Embeddings kann die Empfehlung deutlich besser werden.
Andererseits sollst du Themenklassifikation für juristische Verträge durchführen. Nicht irgendwelche, sondern französische Verträge aus dem Wettbewerbsrecht. Solche Datensätze sind meist unlabelt oder nur in kleiner Zahl vorhanden. Warum dich Out-of-the-Box-Transfer hier nur begrenzt weiterbringt:
Sehr lesenswert ist dieser Überblick zum aktuellen Stand der Word Embeddings. Die dort genannten Herausforderungen und Lösungen sind zentral, um robuste NLP-Systeme mit wenig Daten aufzubauen.
Gensim, spaCy und FastText sind drei hervorragende Frameworks, mit denen du schnell Embeddings in deine ML-Anwendung bringst. Außerdem unterstützen sie das Training eigener Embeddings. Schau dir dieses gensim-, dieses spaCy- oder dieses FastText-Tutorial an, um mehr zu erfahren!
Deep Learning hat in der Computer Vision enorme Fortschritte ermöglicht. Statt Features wie Histogram of Oriented Gradients (HoG) oder Farb-Histogramme manuell zu definieren, können Modelle direkt mit Rohbildern trainiert werden. Die frühere Komplexität der Feature-Definition ist zur Komplexität des Netzwerk-Designs geworden. Architekturen werden häufig wiederverwendet, aber es gibt keinen Einheitsweg. Viele Verfahren wurden auf riesigen Datensätzen (z. B. ImageNet oder MS COCO) entwickelt. Um dort die Performance zu steigern, entstanden immer tiefere und komplexere Netze mit Millionen Parametern – auf kleinen Bilddatensätzen kaum skalierbar. Ein ResNet oder VGG mit weniger als 5.000 Bildern zu trainieren, führt schnell zu starkem Overfitting. Die Deep-Learning-Welle brachte große Fortschritte, ließ Data Scientists mit kleinen Datensätzen aber oft außen vor.
Wie sich zeigt, lernen Deep-Learning-Netze hierarchische Merkmalsrepräsentationen (siehe diesen Beitrag von Distill). Untere Schichten lernen Kanten u. Ä., höhere Schichten komplexere, oft schwer interpretierbare Formen. Dieses Prinzip zeigt sich auch bei Training auf unterschiedlichen Datensätzen – ein Hinweis auf Wiederverwendbarkeit in anderen Domänen.
Beim Transfer Learning in der Bildverarbeitung gibt es zwei gängige Ansätze.
Die API von Keras erlaubt es, vortrainierte Netze zu laden und ausgewählte Schichten während des Trainings eingefroren zu lassen. Im nächsten Abschnitt folgen zwei Use Cases – einer, in dem Transfer Learning hilft, und einer, in dem es weniger geeignet ist.
Angenommen, du arbeitest im Artenschutz und möchtest Tiere auf einem Live-Kamerastream klassifizieren. Gerade bei bedrohten Arten ist es schwer, viele gelabelte Daten zu sammeln. Da vortrainierte Netze oft auf einem breiten Spektrum an Konzepten (von Lebensmitteln über Tiere bis zu Gegenständen) trainiert sind, ist ein vortrainiertes Netz als Featurizer oder Initialisierung hier sehr sinnvoll.
Anders bei der Analyse von Radiologieaufnahmen für Onkologen. Diese Bilder sind keine typischen „Katze-Hund“-Fotos, sondern Ergebnisse eines medizinischen Scans. Obwohl sie zu RGB konvertiert werden, sind sie oft in Graustufen. Ein vortrainiertes Netz erkennt Kanten und Formen in RGB-Bildern gut, hat damit auf Radiologieaufnahmen jedoch eher Schwierigkeiten, weil solche Bilder im Training kaum vorkamen. Zudem sind gelabelte Daten im Medizinbereich knapp. Es gibt Verfahren, unlabelte Daten zu nutzen, die jedoch mehr Aufwand und Feintuning erfordern. Häufig werden die Gewichte des Klassifikationsnetzes vortrainiert, indem jede Schicht iterativ lernt, das Bild zu rekonstruieren (mit Convolutional und Deconvolutional Layers). Eine Kombination solcher Techniken mit vortrainierten Netzen verbessert oft die Konvergenz.
Beide oben beschriebenen Methoden beruhen auf einer wichtigen Annahme: Die im Originaldatensatz extrahierten Muster sind auch für den neuen Datensatz nützlich. Das ist schwer zu quantifizieren, aber entscheidend. Seismische, hyperspektrale oder medizinische Bilder ähneln ImageNet-Bildern nur wenig. Das Erkennen von Verkehrsschildern hingegen basiert auf recht ähnlichen Mustern. Wer das Problemfeld in der Bildverarbeitung versteht, setzt Transfer Learning erfolgreicher ein. Mit Wissen über die genutzten Modelle (Datensätze, Techniken etc.) sparst du Zeit bei Experimenten und konzentrierst dich auf das Finetuning der Modelle, die wirklich den Unterschied machen.
Machine-Learning-Kurse
Kurs
Kurs
Kurs