
Kursus
Pengurangan Dimensi dengan Python
4 jam
37.2K
Kita sering menemui dataset dengan ratusan bahkan ribuan fitur dalam permasalahan machine learning, dan skala ini kerap menimbulkan tantangan dalam visualisasi dan analisis data yang bermakna. Metode plot tradisional hanya dapat menampilkan dua atau tiga dimensi sekaligus, sehingga hampir mustahil untuk memahami struktur data berdimensi tinggi. Di sinilah teknik reduksi dimensi seperti UMAP (Uniform Manifold Approximation and Projection) berperan.
Seiring waktu, UMAP telah menjadi metode andalan untuk memvisualisasikan dataset kompleks di berbagai bidang. Tutorial ini akan memandu Anda melalui semua hal yang perlu diketahui tentang UMAP, mulai dari dasarnya hingga implementasi praktis dan tantangan umum, sehingga Anda dapat mulai menggunakan teknik ini dalam proyek Anda mulai sekarang.
UMAP adalah algoritma reduksi dimensi nonlinier yang memproyeksikan data berdimensi tinggi ke ruang berdimensi lebih rendah (biasanya 2D atau 3D) sambil mempertahankan struktur esensial data. UMAP merupakan singkatan dari Uniform Manifold Approximation and Projection, dan berlandaskan pembelajaran manifold serta analisis data topologis.
Metode reduksi dimensi lain, seperti t-SNE, bagus dalam mempertahankan lingkungan lokal namun akhirnya mendistorsi hubungan global. Manfaat utama UMAP adalah kemampuannya menyeimbangkan lingkungan lokal dan hubungan global. UMAP mengasumsikan bahwa data berada pada sebuah manifold Riemannian dan manifold ini dapat dimodelkan secara lokal dengan struktur topologis fuzzy. Fondasi matematis ini memungkinkan UMAP menciptakan visualisasi yang lebih bermakna, di mana titik data serupa berkumpul bersama sambil tetap mempertahankan topologi keseluruhan dataset.
Algoritma bekerja dengan membangun representasi graf berdimensi tinggi dari data, lalu mengoptimalkan graf berdimensi rendah agar semirip mungkin secara struktural. Selain untuk visualisasi, UMAP berguna sebagai langkah prapemrosesan untuk algoritma klasterisasi atau bahkan sebagai teknik reduksi dimensi nonlinier umum dalam pipeline machine learning.
Kita akan menguraikan prosesnya menjadi beberapa langkah kunci untuk memahami cara kerja UMAP. Teori matematis lengkapnya melibatkan konsep tingkat lanjut dari topologi dan analisis data topologis, jadi untuk tutorial ini, kita akan mengambil pendekatan intuitif terhadap algoritma inti.
UMAP memulai dengan membangun graf berbobot yang merepresentasikan hubungan dalam ruang berdimensi tinggi. Untuk setiap titik data, ia mengidentifikasi k tetangga terdekatnya (di mana k adalah parameter yang dapat kita atur). Namun, berbeda dengan graf k-NN sederhana, UMAP menggunakan pendekatan probabilistik. Ia menghitung probabilitas bahwa dua titik terhubung berdasarkan jaraknya, menggunakan pendekatan halus yang bergantung pada kerapatan lokal di sekitar setiap titik.
Wawasan kuncinya adalah UMAP beradaptasi dengan struktur lokal data kita. Di wilayah padat, titik-titik harus sangat dekat untuk dianggap sebagai tetangga, sementara di wilayah jarang, algoritme memperluas radius pencariannya.
Perilaku adaptif ini dikendalikan oleh rumus:
p(i,j) = exp(-(d(xi, xj) - ρi) / σi)Di mana d(xi, xj) adalah jarak antar titik, ρi adalah jarak ke tetangga terdekat, dan σi adalah faktor skala yang dihitung untuk setiap titik.
UMAP kemudian mengonversi distribusi probabilitas lokal ini menjadi struktur topologis fuzzy dari analisis data topologis. Ia mensimetriskan graf dengan menggabungkan probabilitas dari kedua arah:
p(i,j) = p(i|j) + p(j|i) - p(i|j) * p(j|i)Ini menciptakan apa yang disebut himpunan sederhana fuzzy (fuzzy simplicial set), yang menangkap struktur manifold dari data berdimensi tinggi.
Langkah terakhir melibatkan pencarian representasi berdimensi rendah yang mempertahankan struktur topologis fuzzy. UMAP menginisialisasi titik-titik dalam ruang berdimensi rendah (menggunakan embedding spektral) lalu menggunakan gradient descent untuk meminimalkan cross-entropy antara representasi topologis fuzzy berdimensi tinggi dan berdimensi rendah.
Optimasi menggunakan gaya tarik untuk mendekatkan titik-titik yang seharusnya berdekatan (berdasarkan struktur berdimensi tinggi) dan gaya tolak untuk menjauhkan titik-titik yang seharusnya berjauhan. Dinamika tarik-dorong ini menghasilkan visualisasi khas di mana klaster terpisah dengan baik sambil mempertahankan struktur internalnya.
UMAP memiliki aplikasi di banyak bidang di mana pemahaman data berdimensi tinggi bermanfaat.
Beberapa aplikasi dunia nyata tersebut meliputi:
Sekarang setelah kita memahami konsep, landasan matematika, dan aplikasi praktis UMAP, mari lanjut ke implementasinya.
Mari implementasikan UMAP pada dataset dunia nyata untuk melihat bagaimana cara kerjanya dalam praktik. Kita akan menggunakan dataset Olivetti Faces, yang berisi citra wajah grayscale dari 40 orang berbeda. Dataset Olivetti dapat diunduh dari Kaggle atau melalui pustaka Python scikit-learn.
Dataset Olivetti Faces berisi:
Ini sangat cocok untuk UMAP karena kita berharap citra dari orang yang sama akan berkelompok, meskipun ada variasi ekspresi dan pencahayaan.
Pertama, mari impor pustaka yang diperlukan dan muat dataset kita:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import matplotlib.cm as cm
from sklearn.datasets import fetch_olivetti_faces
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
import umap
import warnings
warnings.filterwarnings('ignore')

# Load the Olivetti faces dataset
faces = fetch_olivetti_faces(shuffle=True, random_state=42)
X = faces.data
y = faces.target

print(f"Dataset shape: {X.shape}")
print(f"Number of individuals: {len(np.unique(y))}")
print(f"Number of images per individual: {X.shape[0] // len(np.unique(y))}")

# Display sample faces
fig, axes = plt.subplots(2, 5, figsize=(12, 6))
for i, ax in enumerate(axes.flat):
   ax.imshow(X[i].reshape(64, 64), cmap='gray')
   ax.set_title(f'Person {y[i]}')
   ax.axis('off')
plt.suptitle('Sample Faces from the Dataset')
plt.tight_layout()
plt.show()
Dari kode di atas, kita dapat memvisualisasikan dataset sebagai berikut:
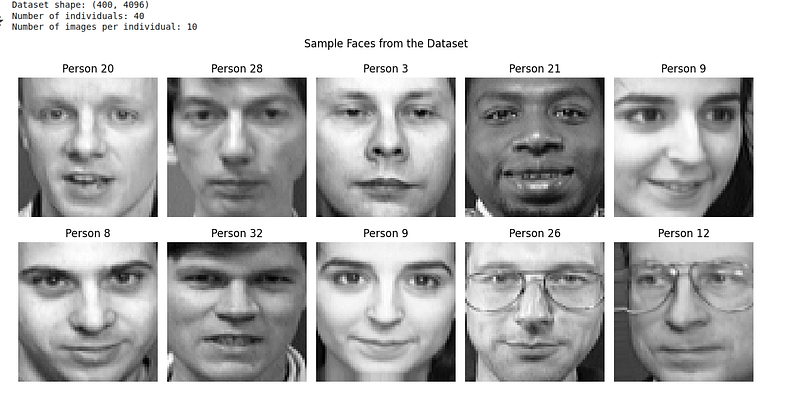
Dataset Olivetti faces sudah dinormalisasi sebelumnya dengan nilai piksel antara 0 dan 1, sehingga kita dapat langsung menerapkan UMAP:
# Create UMAP instance with default parameters
reducer = umap.UMAP(random_state=42)

# Fit and transform the data
embedding = reducer.fit_transform(X)

# Create a custom colormap for 40 distinct classes
colors = cm.get_cmap('hsv', 40)

# Create visualization
plt.figure(figsize=(12, 10))
scatter = plt.scatter(embedding[:, 0], embedding[:, 1], c=y,
                    cmap=colors, s=50, alpha=0.8, edgecolors='black', linewidth=0.5)
plt.colorbar(scatter, label='Person ID', ticks=np.arange(0, 40, 5))
plt.title('UMAP Projection of Olivetti Faces (Default Parameters)')
plt.xlabel('UMAP 1')
plt.ylabel('UMAP 2')
plt.grid(True, alpha=0.3)
plt.show()
Kita disajikan plot sebar berwarna sebagai visualisasi UMAP:
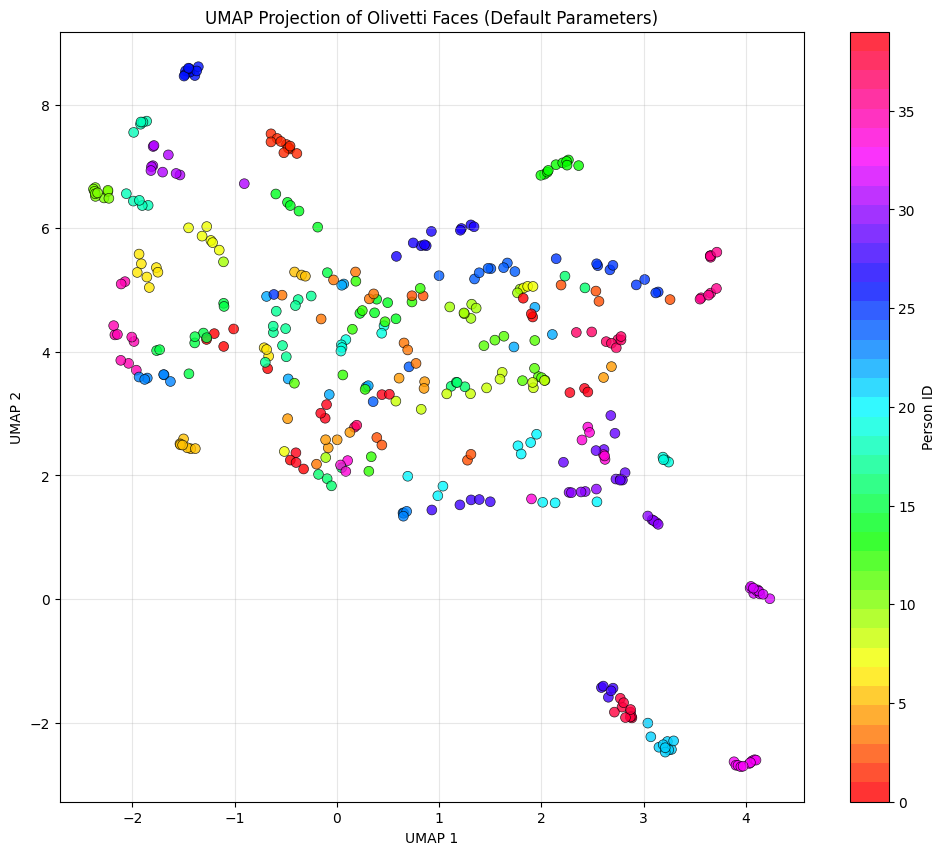
Berikut beberapa hal yang perlu dicatat untuk memahami diagram dengan lebih baik:
Meskipun ini jarang terjadi di skenario dunia nyata, idealnya kita berharap semua 10 citra dari orang yang sama (warna sama) berkelompok bersama. Pada gambar, kita melihat sebagian warna serupa berkelompok ketika kita membangun UMAP menggunakan parameter default.
UMAP memiliki beberapa parameter penting yang mengendalikan perilakunya. Mari kita jelajahi bagaimana pengaruhnya terhadap hasil:
# Create subplots for different parameter settings
fig, axes = plt.subplots(2, 3, figsize=(18, 12))
axes = axes.ravel()

# Different parameter configurations
param_configs = [
   {'n_neighbors': 5, 'min_dist': 0.1},
   {'n_neighbors': 15, 'min_dist': 0.1},
   {'n_neighbors': 50, 'min_dist': 0.1},
   {'n_neighbors': 15, 'min_dist': 0.0},
   {'n_neighbors': 15, 'min_dist': 0.5},
   {'n_neighbors': 15, 'min_dist': 0.99}
]

# Apply UMAP with different parameters
for idx, params in enumerate(param_configs):
   reducer = umap.UMAP(random_state=42, **params)
   embedding = reducer.fit_transform(X_scaled)

   ax = axes[idx]
   scatter = ax.scatter(embedding[:, 0], embedding[:, 1], c=y,
                       cmap='tab20', s=30, alpha=0.8)
   ax.set_title(f"n_neighbors={params['n_neighbors']}, "
                f"min_dist={params['min_dist']}")
   ax.set_xlabel('UMAP 1')
   ax.set_ylabel('UMAP 2')
   ax.grid(True, alpha=0.3)

plt.tight_layout()
plt.show()
Output visualisasinya adalah sebagai berikut:
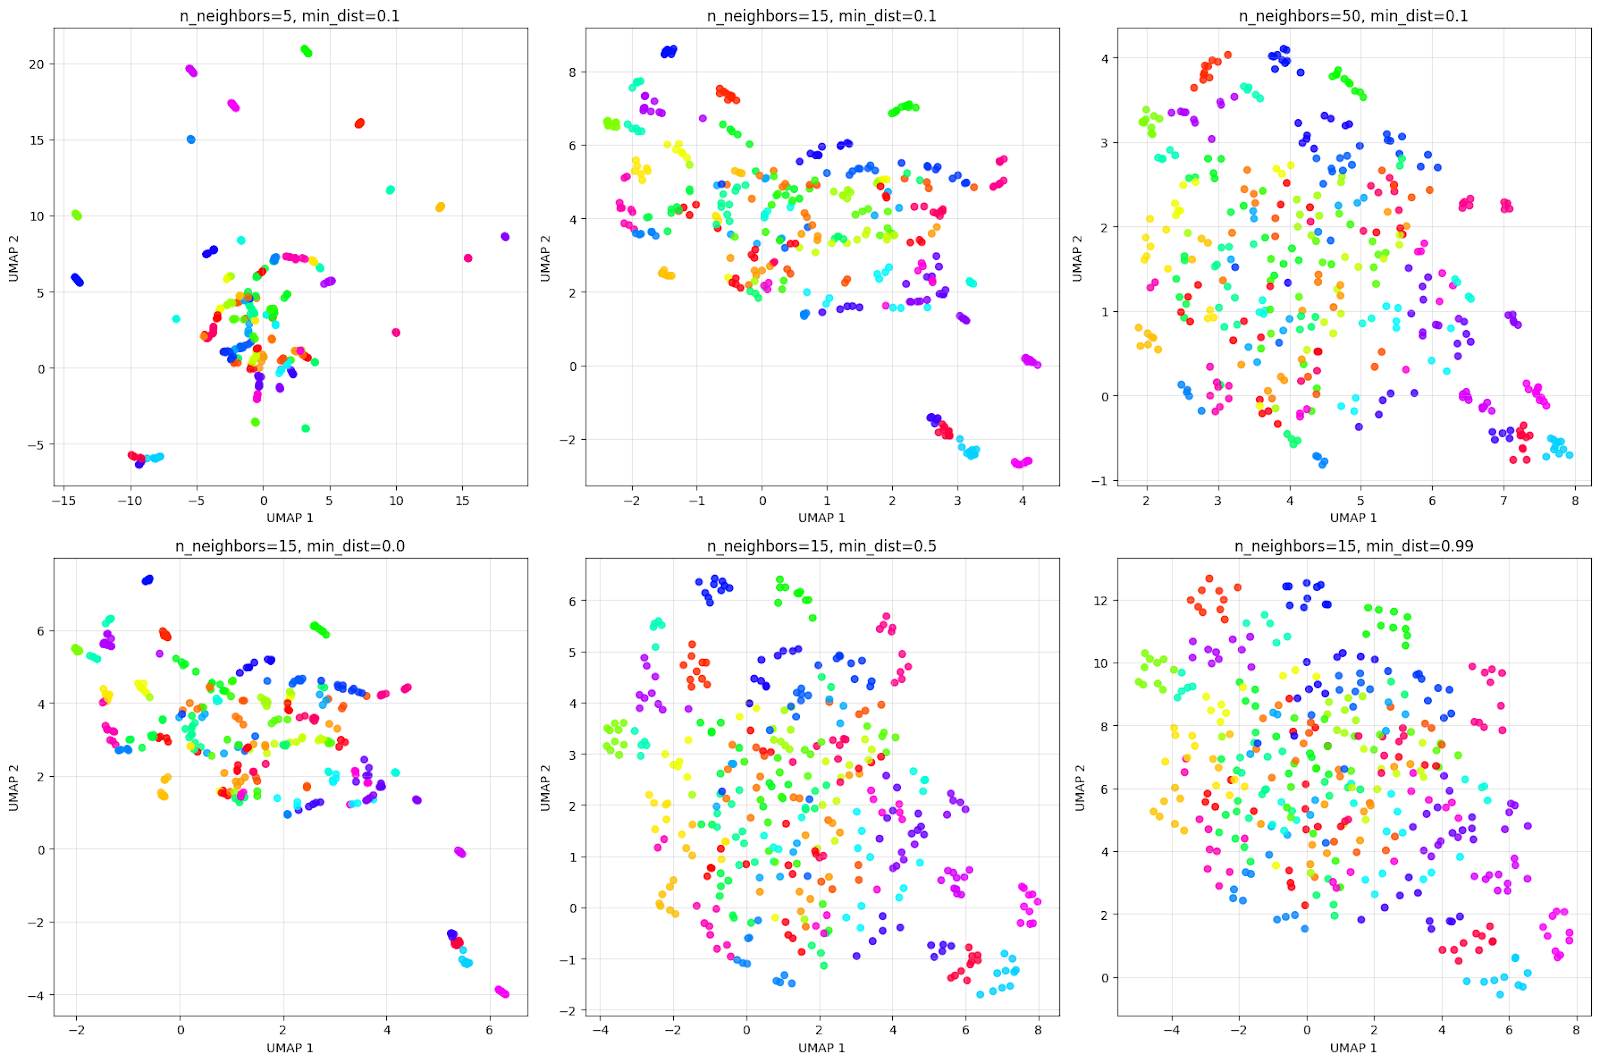
Grid di atas menggambarkan bagaimana parameter memengaruhi visualisasi. Menimbang baris atas untuk pengaruh n_neighbors:
Menimbang baris bawah untuk pengaruh min_dist:
Sebaiknya selalu bereksperimen dengan parameter-parameter ini untuk mendapatkan hasil pengelompokan terbaik bagi masalah yang dihadapi.
Mari lanjutkan contoh kita dengan dataset Olivetti untuk membandingkan UMAP dengan PCA dan t-SNE serta memahami perbedaannya:
from sklearn.decomposition import PCA
from sklearn.manifold import TSNE

# Create figure with subplots
fig, axes = plt.subplots(1, 3, figsize=(18, 6))

colors = cm.get_cmap('hsv', 40)

# PCA
pca = PCA(n_components=2, random_state=42)
pca_result = pca.fit_transform(X)
axes[0].scatter(pca_result[:, 0], pca_result[:, 1], c=y,
               cmap=colors, s=50, alpha=0.8)
axes[0].set_title('PCA Projection')
axes[0].set_xlabel('PC 1')
axes[0].set_ylabel('PC 2')
axes[0].grid(True, alpha=0.3)

# t-SNE
tsne = TSNE(n_components=2, random_state=42, perplexity=30)
tsne_result = tsne.fit_transform(X)
axes[1].scatter(tsne_result[:, 0], tsne_result[:, 1], c=y,
               cmap=colors, s=50, alpha=0.8)
axes[1].set_title('t-SNE Projection')
axes[1].set_xlabel('t-SNE 1')
axes[1].set_ylabel('t-SNE 2')
axes[1].grid(True, alpha=0.3)

# UMAP
umap_reducer = umap.UMAP(n_neighbors=15, min_dist=0.1, random_state=42)
umap_result = umap_reducer.fit_transform(X)
scatter = axes[2].scatter(umap_result[:, 0], umap_result[:, 1], c=y,
                        cmap=colors, s=50, alpha=0.8)
axes[2].set_title('UMAP Projection')
axes[2].set_xlabel('UMAP 1')
axes[2].set_ylabel('UMAP 2')
axes[2].grid(True, alpha=0.3)

plt.tight_layout()
plt.show()
Kita akan melihat plot perbandingan seperti di bawah ini:
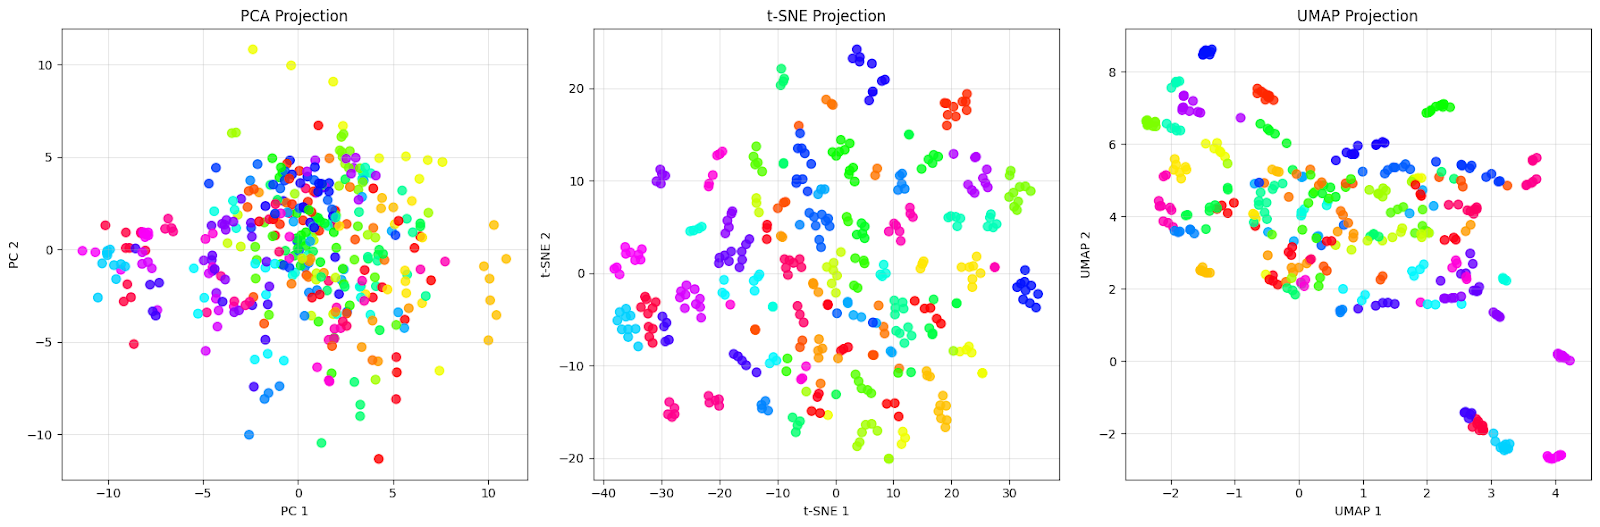
Proyeksi PCA (kiri) menunjukkan awan titik padat yang berpusat di sekitar origin dengan tumpang tindih ekstensif antar titik berwarna berbeda. Inilah yang kita harapkan dari PCA — ia menangkap arah varian maksimum dalam data, tetapi gagal memisahkan orang yang berbeda secara efektif. Kita dapat melihat bahwa wajah dari individu berbeda (warna berbeda) sepenuhnya tercampur, sehingga hampir mustahil mengidentifikasi kelompok yang jelas.
Proyeksi t-SNE (tengah) menunjukkan peningkatan dengan klaster yang terpisah jelas. Setiap warna (merepresentasikan orang berbeda) membentuk kelompok kompak yang berbeda dengan batas yang jelas antar individu. Perhatikan bagaimana t-SNE menciptakan pengelompokan lokal yang hampir sempurna di mana wajah dari orang yang sama ditarik sangat dekat satu sama lain sambil didorong menjauh dari kelompok lain. Ini adalah kekuatan t-SNE: unggul dalam mempertahankan lingkungan lokal dan menciptakan klaster yang terlihat jelas.
Proyeksi UMAP (kanan) mengambil pendekatan berbeda. Meskipun klasternya lebih menyebar dibanding t-SNE, ini mencerminkan upaya UMAP untuk mempertahankan struktur lokal dan global sekaligus. Kita dapat melihat bahwa setiap orang tetap membentuk kelompok yang dapat dikenali, tetapi dengan variasi internal yang lebih besar. Beberapa klaster menunjukkan sedikit tumpang tindih atau diposisikan lebih berdekatan, yang mungkin menunjukkan kemiripan nyata antar individu tersebut.
Perbandingan ini mengilustrasikan poin penting: “lebih baik” bergantung pada tujuan kita. Jika kita memerlukan pemisahan visual sejelas mungkin untuk presentasi atau eksplorasi awal, klaster rapat milik t-SNE sangat baik untuk dataset ini. Namun, jika kita ingin memahami struktur keseluruhan data dan bagaimana kelompok berbeda saling berhubungan, pelestarian hubungan global oleh UMAP membuatnya lebih cocok untuk dataset ini.
Seperti halnya semua algoritma dan teknik, kita menghadapi beberapa tantangan saat menerapkan UMAP pada data dunia nyata.
Berdasarkan pengalaman luas, berikut beberapa tantangan yang sering muncul:
Tantangan paling umum adalah memilih nilai yang sesuai untuk n_neighbors dan min_dist. Parameter-parameter ini sangat memengaruhi visualisasi, dan tidak ada satu solusi untuk semua kasus.
Parameter n_neighbors menyeimbangkan pelestarian struktur lokal versus global. Nilai kecil (5–15) berfokus pada pelestarian lingkungan yang sangat lokal, menangkap struktur detail namun berpotensi memecah pola yang lebih besar. Nilai besar (30–100) menekankan pola keterhubungan yang lebih luas, mengungkap struktur global namun berpotensi mengaburkan detail lokal.
Parameter min_dist mengendalikan seberapa rapat titik-titik dikemas dalam tata letak berdimensi rendah, tetapi tidak memengaruhi konstruksi graf berdimensi tinggi. Nilai mendekati 0 memungkinkan titik dikemas rapat, menciptakan klaster yang tampak rapat, sementara nilai mendekati 1 menyebarkan titik lebih merata di ruang proyeksi.
Pendekatan terbaik adalah mulai dari nilai default (n_neighbors=15, min_dist=0.1) dan sesuaikan berdasarkan karakteristik data Anda:
UMAP bisa lambat pada dataset yang sangat besar (jutaan titik), sehingga eksplorasi interaktif menjadi sulit. Kita dapat mencoba beberapa teknik berikut untuk meningkatkan kinerja:
Tidak seperti PCA, jarak pada proyeksi UMAP tidak memiliki interpretasi langsung. Titik yang tampak berdekatan mungkin tidak serupa dalam ruang asli. Untuk mengatasi keterbatasan ini, penting untuk:
UMAP menggunakan inisialisasi acak, yang dapat menghasilkan hasil berbeda antar run, sehingga sulit mereproduksi visualisasi persis sama. Kita dapat memastikan reprodusibilitas dengan praktik berikut:
random_state: umap.UMAP(random_state=42)init untuk menentukan posisi awal jika diperlukan reprodusibilitas yang tepatMetrik jarak default UMAP mengasumsikan data numerik kontinu, yang bisa bermasalah untuk dataset dengan fitur kategorikal atau campuran. Saat bekerja dengan tipe data campuran, kita dapat mempertimbangkan pendekatan berikut:
metric dengan opsi seperti 'hamming' untuk data binerPencilan ekstrem dapat mengompresi distribusi data utama, sehingga sulit melihat struktur pada mayoritas titik. Beberapa teknik yang dapat kita gunakan untuk mengatasinya adalah:
local_connectivity agar lebih tangguh terhadap pencilanMeskipun daftar ini tidak lengkap, ini mencakup isu paling umum saat bekerja dengan UMAP. Memahami isu-isu tersebut dan solusinya akan membantu kita memaksimalkan UMAP.
Melalui tutorial ini, kita telah mengeksplorasi cara kerja UMAP pada tingkat konseptual dan praktis, mengimplementasikannya pada data nyata, membandingkannya dengan metode alternatif, dan membahas tantangan umum. Pokoknya adalah kemampuan UMAP menyeimbangkan pelestarian struktur lokal dan global membuatnya berguna untuk analisis data eksploratif saat berhadapan dengan dataset kompleks dan berdimensi tinggi.
Untuk memperdalam keahlian Anda dalam teknik reduksi dimensi, pertimbangkan untuk mengeksplorasi kursus Dimensionality Reduction in Python kami, di mana Anda akan mendapatkan pengalaman langsung dengan UMAP bersama teknik lain seperti PCA dan t-SNE. Untuk perspektif yang lebih luas tentang bagaimana reduksi dimensi cocok dalam alur kerja machine learning, jalur Machine Learning Scientist with Python mengajarkan teknik pembelajaran terawasi dan tak terawasi, membantu Anda membangun solusi end-to-end untuk tantangan data dunia nyata.
Kursus Teratas di DataCamp
Kursus
Program
Kursus
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



