
Corso
Riduzione della dimensionalità in Python
4 ore
37.2K
Nei problemi di machine learning capita spesso di incontrare dataset con centinaia o addirittura migliaia di feature, e questa scala pone spesso sfide alla visualizzazione e all'analisi significative dei dati. I metodi di plotting tradizionali possono mostrare solo due o tre dimensioni alla volta, rendendo quasi impossibile comprendere la struttura dei dati ad alta dimensionalità. È qui che tecniche di riduzione della dimensionalità come UMAP (Uniform Manifold Approximation and Projection) vengono in soccorso.
Col tempo, UMAP è diventato un metodo di riferimento per visualizzare dataset complessi in vari campi. Questo tutorial ti guiderà in tutto ciò che devi sapere su UMAP, dalle basi all'implementazione pratica e alle sfide comuni, aiutandoti a iniziare a usare questa tecnica nei tuoi progetti fin da subito.
UMAP è un algoritmo non lineare di riduzione della dimensionalità che proietta dati ad alta dimensionalità in uno spazio a dimensionalità inferiore (tipicamente 2D o 3D) preservando la struttura essenziale dei dati. UMAP sta per Uniform Manifold Approximation and Projection ed è basato sul manifold learning e sulla topological data analysis.
Altri metodi di riduzione della dimensionalità, come t-SNE, sono bravi a preservare i vicinati locali ma finiscono per distorcere le relazioni globali. Il vantaggio chiave di UMAP è che trova un equilibrio tra i vicinati locali e le relazioni globali. Assume che i dati giacciano su un varietà riemanniana e che questa varietà possa essere modellata localmente con una struttura topologica fuzzy. Questo fondamento matematico consente a UMAP di creare visualizzazioni più significative, in cui punti dati simili si raggruppano mantenendo al contempo la topologia complessiva del dataset.
L'algoritmo funziona costruendo una rappresentazione a grafo ad alta dimensionalità dei dati, quindi ottimizzando un grafo a bassa dimensionalità affinché sia il più simile possibile strutturalmente. Oltre alla visualizzazione, UMAP è utile come fase di pre-processing per algoritmi di clustering o persino come tecnica generale di riduzione della dimensionalità non lineare per pipeline di machine learning.
Scomporremo il processo in alcuni passaggi chiave per capire come funziona UMAP. La teoria matematica completa coinvolge concetti avanzati di topologia e topological data analysis, quindi in questo tutorial adotteremo un approccio intuitivo all'algoritmo di base.
UMAP inizia costruendo un grafo pesato che rappresenta le relazioni nello spazio ad alta dimensionalità. Per ogni punto dati, identifica i suoi k vicini più prossimi (dove k è un parametro che possiamo regolare). Tuttavia, a differenza dei semplici grafi k-NN, UMAP usa un approccio probabilistico. Calcola la probabilità che due punti siano connessi in base alla loro distanza, usando un'approssimazione continua che dipende dalla densità locale attorno a ciascun punto.
L'intuizione chiave qui è che UMAP si adatta alla struttura locale dei nostri dati. Nelle regioni dense, i punti devono essere molto vicini per essere considerati vicini, mentre nelle regioni sparse l'algoritmo estende il raggio di ricerca.
Questo comportamento adattivo è controllato dalla formula:
p(i,j) = exp(-(d(xi, xj) - ρi) / σi)Dove d(xi, xj) è la distanza tra i punti, ρi è la distanza dal vicino più prossimo e σi è un fattore di scala calcolato per ciascun punto.
UMAP quindi converte queste distribuzioni di probabilità locali in una struttura topologica fuzzy dalla topological data analysis. Simmetrizza il grafo combinando le probabilità in entrambe le direzioni:
p(i,j) = p(i|j) + p(j|i) - p(i|j) * p(j|i)Questo crea quello che viene chiamato un fuzzy simplicial set, che cattura la struttura del manifold dei dati ad alta dimensionalità.
Il passaggio finale consiste nel trovare una rappresentazione a bassa dimensionalità che preservi la struttura topologica fuzzy. UMAP inizializza i punti nello spazio a bassa dimensionalità (usando uno spectral embedding) e poi usa il gradient descent per minimizzare l'entropia incrociata tra le rappresentazioni topologiche fuzzy ad alta e bassa dimensionalità.
L'ottimizzazione usa forze attrattive per avvicinare i punti che dovrebbero essere vicini (in base alla struttura ad alta dimensionalità) e forze repulsive per allontanare i punti che dovrebbero essere distanti. Questa dinamica di spinta-tiro crea le visualizzazioni caratteristiche in cui i cluster sono ben separati pur mantenendo la loro struttura interna.
UMAP ha applicazioni in numerosi campi in cui è utile comprendere i dati ad alta dimensionalità.
Alcune di queste applicazioni reali includono:
Ora che abbiamo compreso il concetto, le basi matematiche e le applicazioni pratiche di UMAP, passiamo all'implementazione.
Implementiamo UMAP su un dataset reale per vedere come funziona in pratica. Useremo il dataset Olivetti Faces, che contiene immagini in scala di grigi di volti di 40 persone diverse. Il dataset Olivetti può essere scaricato da Kaggle o tramite la libreria Python scikit-learn.
Il dataset Olivetti Faces contiene:
È perfetto per UMAP perché ci aspettiamo che le immagini della stessa persona si raggruppino, nonostante le variazioni di espressione e illuminazione.
Per prima cosa, importiamo le librerie necessarie e carichiamo il nostro dataset:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import matplotlib.cm as cm
from sklearn.datasets import fetch_olivetti_faces
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
import umap
import warnings
warnings.filterwarnings('ignore')

# Load the Olivetti faces dataset
faces = fetch_olivetti_faces(shuffle=True, random_state=42)
X = faces.data
y = faces.target

print(f"Dataset shape: {X.shape}")
print(f"Number of individuals: {len(np.unique(y))}")
print(f"Number of images per individual: {X.shape[0] // len(np.unique(y))}")

# Display sample faces
fig, axes = plt.subplots(2, 5, figsize=(12, 6))
for i, ax in enumerate(axes.flat):
   ax.imshow(X[i].reshape(64, 64), cmap='gray')
   ax.set_title(f'Person {y[i]}')
   ax.axis('off')
plt.suptitle('Sample Faces from the Dataset')
plt.tight_layout()
plt.show()
Dal codice sopra, possiamo visualizzare il dataset come segue:
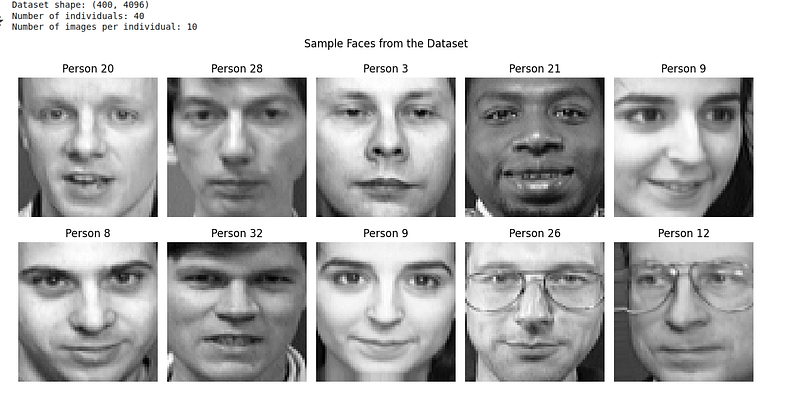
Il dataset Olivetti faces è pre-normalizzato con valori di pixel tra 0 e 1, quindi possiamo applicare UMAP direttamente:
# Create UMAP instance with default parameters
reducer = umap.UMAP(random_state=42)

# Fit and transform the data
embedding = reducer.fit_transform(X)

# Create a custom colormap for 40 distinct classes
colors = cm.get_cmap('hsv', 40)

# Create visualization
plt.figure(figsize=(12, 10))
scatter = plt.scatter(embedding[:, 0], embedding[:, 1], c=y,
                    cmap=colors, s=50, alpha=0.8, edgecolors='black', linewidth=0.5)
plt.colorbar(scatter, label='Person ID', ticks=np.arange(0, 40, 5))
plt.title('UMAP Projection of Olivetti Faces (Default Parameters)')
plt.xlabel('UMAP 1')
plt.ylabel('UMAP 2')
plt.grid(True, alpha=0.3)
plt.show()
Otteniamo un grafico a dispersione colorato come visualizzazione UMAP:
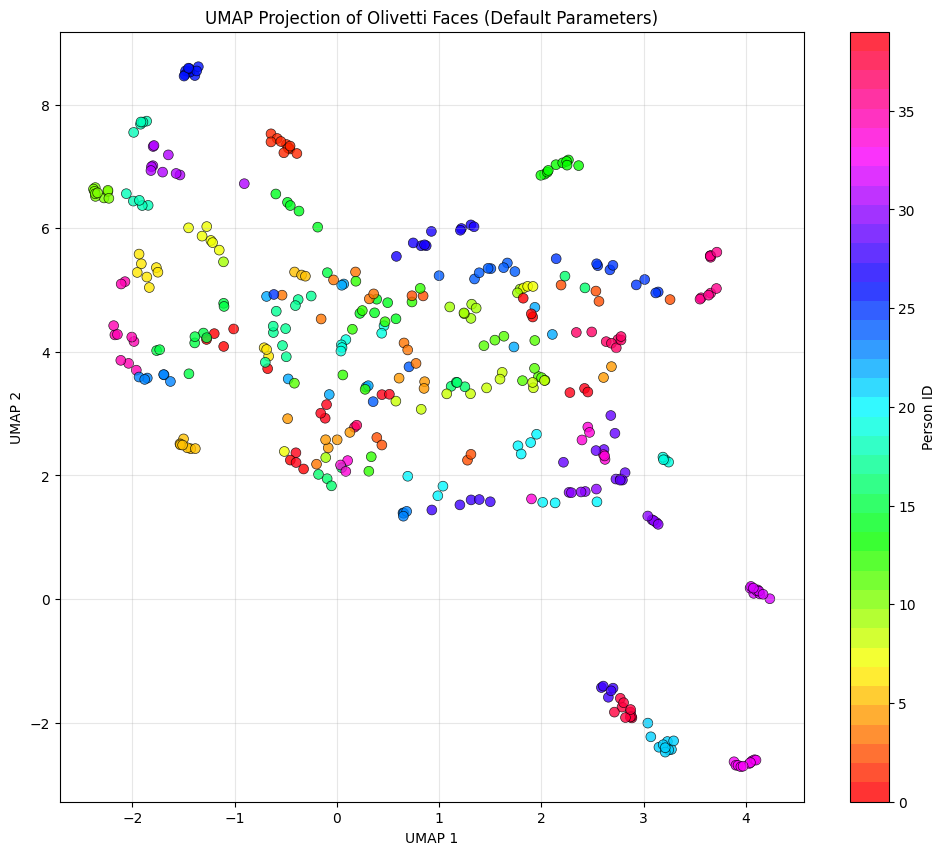
Ecco alcuni aspetti da notare per capire meglio il diagramma:
Anche se non accade spesso nel mondo reale, idealmente ci aspetteremmo che tutte le 10 immagini della stessa persona (stesso colore) si raggruppino. Nell'immagine vediamo alcuni colori simili raggruppati quando abbiamo costruito UMAP usando i parametri predefiniti.
UMAP ha diversi parametri importanti che ne controllano il comportamento. Vediamo come influenzano i risultati:
# Create subplots for different parameter settings
fig, axes = plt.subplots(2, 3, figsize=(18, 12))
axes = axes.ravel()

# Different parameter configurations
param_configs = [
   {'n_neighbors': 5, 'min_dist': 0.1},
   {'n_neighbors': 15, 'min_dist': 0.1},
   {'n_neighbors': 50, 'min_dist': 0.1},
   {'n_neighbors': 15, 'min_dist': 0.0},
   {'n_neighbors': 15, 'min_dist': 0.5},
   {'n_neighbors': 15, 'min_dist': 0.99}
]

# Apply UMAP with different parameters
for idx, params in enumerate(param_configs):
   reducer = umap.UMAP(random_state=42, **params)
   embedding = reducer.fit_transform(X_scaled)

   ax = axes[idx]
   scatter = ax.scatter(embedding[:, 0], embedding[:, 1], c=y,
                       cmap='tab20', s=30, alpha=0.8)
   ax.set_title(f"n_neighbors={params['n_neighbors']}, "
                f"min_dist={params['min_dist']}")
   ax.set_xlabel('UMAP 1')
   ax.set_ylabel('UMAP 2')
   ax.grid(True, alpha=0.3)

plt.tight_layout()
plt.show()
La visualizzazione risultante è la seguente:
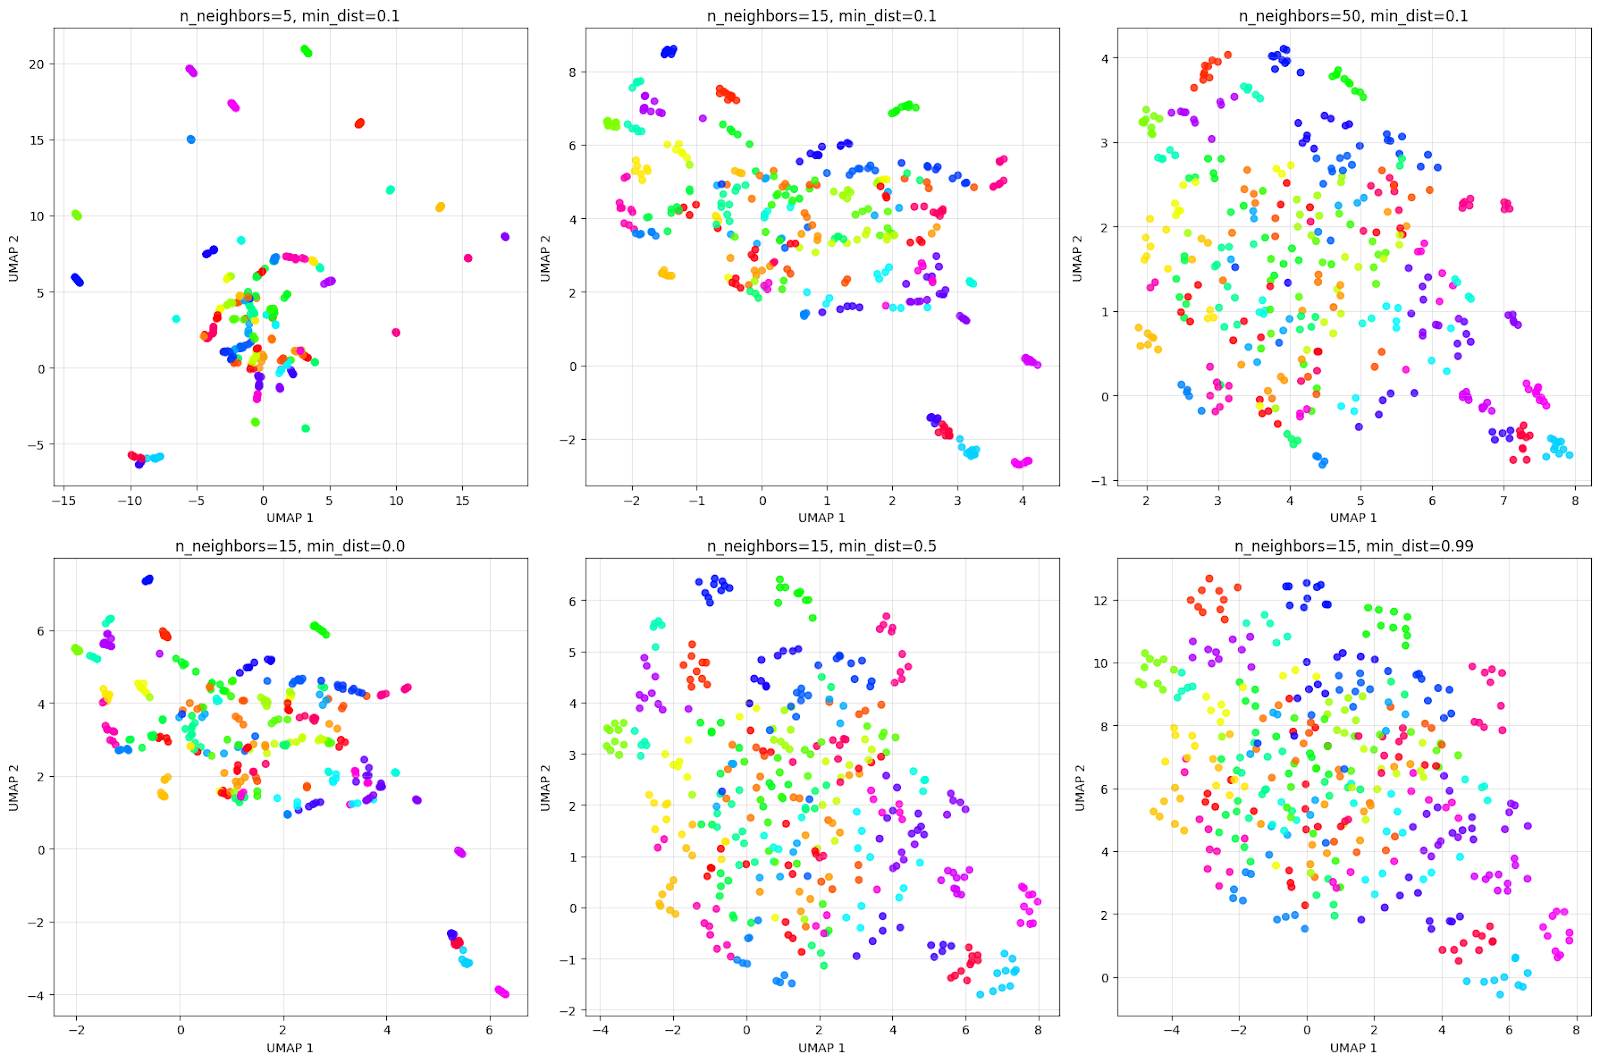
La griglia sopra illustra come i parametri impattano la visualizzazione. Considerando la riga superiore sull'effetto di n_neighbors:
Considerando la riga inferiore sull'effetto di min_dist:
È sempre consigliabile sperimentare con questi parametri per ottenere il miglior risultato di clustering per il problema in questione.
Continuiamo il nostro esempio con il dataset Olivetti per confrontare UMAP con PCA e t-SNE e comprenderne le differenze:
from sklearn.decomposition import PCA
from sklearn.manifold import TSNE

# Create figure with subplots
fig, axes = plt.subplots(1, 3, figsize=(18, 6))

colors = cm.get_cmap('hsv', 40)

# PCA
pca = PCA(n_components=2, random_state=42)
pca_result = pca.fit_transform(X)
axes[0].scatter(pca_result[:, 0], pca_result[:, 1], c=y,
               cmap=colors, s=50, alpha=0.8)
axes[0].set_title('PCA Projection')
axes[0].set_xlabel('PC 1')
axes[0].set_ylabel('PC 2')
axes[0].grid(True, alpha=0.3)

# t-SNE
tsne = TSNE(n_components=2, random_state=42, perplexity=30)
tsne_result = tsne.fit_transform(X)
axes[1].scatter(tsne_result[:, 0], tsne_result[:, 1], c=y,
               cmap=colors, s=50, alpha=0.8)
axes[1].set_title('t-SNE Projection')
axes[1].set_xlabel('t-SNE 1')
axes[1].set_ylabel('t-SNE 2')
axes[1].grid(True, alpha=0.3)

# UMAP
umap_reducer = umap.UMAP(n_neighbors=15, min_dist=0.1, random_state=42)
umap_result = umap_reducer.fit_transform(X)
scatter = axes[2].scatter(umap_result[:, 0], umap_result[:, 1], c=y,
                        cmap=colors, s=50, alpha=0.8)
axes[2].set_title('UMAP Projection')
axes[2].set_xlabel('UMAP 1')
axes[2].set_ylabel('UMAP 2')
axes[2].grid(True, alpha=0.3)

plt.tight_layout()
plt.show()
Vedremo il grafico di confronto come di seguito:
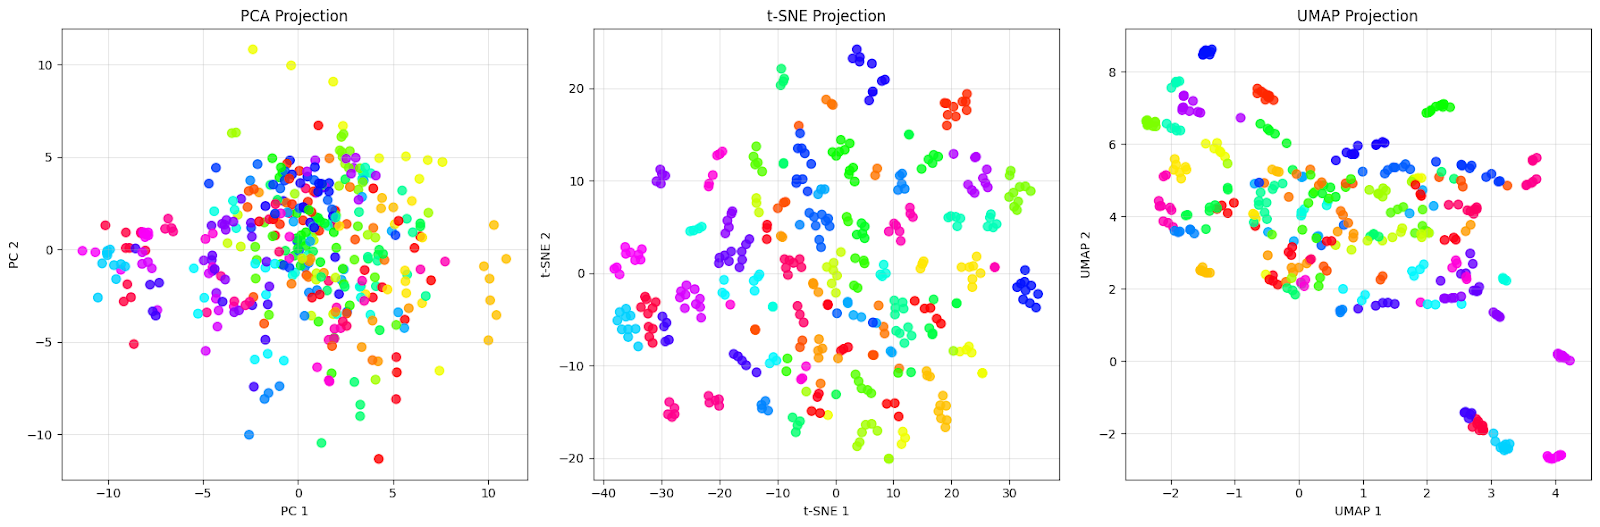
La proiezione PCA (a sinistra) mostra una nube densa di punti centrata attorno all'origine con un'ampia sovrapposizione tra punti di colori diversi. È esattamente ciò che ci aspettiamo dalla PCA: cattura le direzioni di massima varianza nei dati, ma non riesce a separare efficacemente le persone diverse. Si vede che i volti di individui diversi (colori differenti) sono completamente mescolati, rendendo quasi impossibile identificare gruppi distinti.
La proiezione t-SNE (al centro) mostra un miglioramento con cluster ben separati. Ogni colore (che rappresenta una persona diversa) forma un gruppo distinto e compatto con confini chiari tra gli individui. Nota come t-SNE crea raggruppamenti locali quasi perfetti, in cui i volti della stessa persona sono avvicinati molto tra loro mentre sono allontanati da altri gruppi. Questa è la forza di t-SNE: eccelle nel preservare i vicinati locali e nel creare cluster visivamente distinti.
La proiezione UMAP (a destra) adotta un approccio diverso. Sebbene i cluster siano più sparsi rispetto a t-SNE, ciò riflette il tentativo di UMAP di preservare sia la struttura locale sia quella globale. Si vede che ogni persona forma comunque gruppi riconoscibili, ma con maggiore variazione interna. Alcuni cluster mostrano una leggera sovrapposizione o sono posizionati più vicini, il che potrebbe indicare effettive somiglianze tra quegli individui.
Questo confronto illustra un punto importante: "migliore" dipende dal nostro obiettivo. Se ci serve la separazione visiva più chiara possibile per presentazioni o esplorazioni iniziali, i cluster compatti di t-SNE sono eccellenti per questo dataset. Tuttavia, se vogliamo comprendere la struttura complessiva dei dati e come i diversi gruppi si relazionano tra loro, la preservazione delle relazioni globali di UMAP lo rende più adatto per questo dataset.
Come per tutti gli algoritmi e le tecniche, incontriamo diverse sfide quando applichiamo UMAP a dati reali.
Avendo lavorato a fondo su questo, ecco alcune sfide che ho notato ricorrere spesso:
La sfida più comune è selezionare valori appropriati per n_neighbors e min_dist. Questi parametri influenzano significativamente la visualizzazione e non esiste una soluzione valida per tutti.
Il parametro n_neighbors bilancia la preservazione della struttura locale rispetto a quella globale. Valori più piccoli (5-15) si concentrano sul preservare vicinati molto locali, catturando strutture fini ma potenzialmente frammentando pattern più ampi. Valori più grandi (30-100) enfatizzano pattern di connettività più ampi, rivelando la struttura globale ma potenzialmente oscurando i dettagli locali.
Il parametro min_dist controlla quanto strettamente i punti sono impacchettati nel layout a bassa dimensionalità, ma non influisce sulla costruzione del grafo ad alta dimensionalità. Valori vicini a 0 permettono di impacchettare densamente i punti, creando cluster visivamente compatti, mentre valori che si avvicinano a 1 distribuiscono i punti in modo più uniforme nello spazio di proiezione.
L'approccio migliore è partire dai valori predefiniti (n_neighbors=15, min_dist=0.1) e regolare in base alle caratteristiche dei tuoi dati:
UMAP può essere lento su dataset molto grandi (milioni di punti), rendendo difficile l'esplorazione interattiva. Possiamo provare alcune di queste tecniche per migliorare le prestazioni:
A differenza della PCA, le distanze nelle proiezioni UMAP non hanno un'interpretazione diretta. Punti che sembrano vicini potrebbero non essere simili nello spazio originale. Per affrontare questo limite, è importante:
UMAP usa un'inizializzazione casuale, che può portare a risultati diversi tra le esecuzioni, rendendo difficile riprodurre esattamente le visualizzazioni. Possiamo garantire la riproducibilità seguendo queste pratiche:
random_state: umap.UMAP(random_state=42)init per specificare le posizioni iniziali se è richiesta una riproducibilità esattaLa metrica di distanza predefinita di UMAP presuppone dati numerici continui, il che può essere problematico per dataset con feature categoriche o miste. Quando si lavora con tipi di dati misti, possiamo considerare questi approcci:
metric con opzioni come 'hamming' per dati binariOutlier estremi possono comprimere la distribuzione principale dei dati, rendendo difficile vedere la struttura della maggioranza dei punti. Alcune tecniche che possiamo usare per superare questo problema sono:
local_connectivity per essere più robusti agli outlierAnche se questa lista non è esaustiva, copre i problemi più comuni affrontati quando si lavora con UMAP. Comprendere questi problemi e le relative soluzioni ci aiuterà a ottenere il massimo da UMAP.
In questo tutorial abbiamo esplorato come funziona UMAP sia a livello concettuale che pratico, lo abbiamo implementato su dati reali, confrontato con metodi alternativi e affrontato le sfide comuni. L'idea chiave è che la capacità di UMAP di bilanciare la preservazione della struttura locale e globale lo rende utile per l'analisi esplorativa quando si lavora con dataset complessi e ad alta dimensionalità.
Per approfondire le tecniche di riduzione della dimensionalità, valuta di esplorare il nostro corso Dimensionality Reduction in Python, dove farai pratica con UMAP insieme ad altre tecniche come PCA e t-SNE. Per una visione più ampia di come la riduzione della dimensionalità si inserisce nei workflow di machine learning, il percorso Machine Learning Scientist with Python ti insegna tecniche di apprendimento supervisionato e non supervisionato, aiutandoti a costruire soluzioni end-to-end per sfide di dati reali.
I migliori corsi DataCamp
Corso
Programma
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



