
Cursus
Dimensionality Reduction in Python
4 uur
37.2K
Bij machinelearning-problemen kom je vaak datasets tegen met honderden of zelfs duizenden features, en deze schaal maakt het lastig om data zinvol te visualiseren en te analyseren. Traditionele plotmethoden kunnen maar twee of drie dimensies tegelijk tonen, waardoor het bijna onmogelijk is om de structuur van hoog-dimensionale data te begrijpen. Hier komen technieken voor dimensionaliteitsreductie zoals UMAP (Uniform Manifold Approximation and Projection) van pas.
UMAP is in de loop der tijd dé methode geworden om complexe datasets te visualiseren in uiteenlopende domeinen. Deze tutorial leidt je door alles wat je over UMAP moet weten, van de basis tot praktische implementatie en veelvoorkomende uitdagingen, zodat je deze techniek meteen in je projecten kunt toepassen.
UMAP is een niet-lineair algoritme voor dimensionaliteitsreductie dat hoog-dimensionale data projecteert naar een lager-dimensionale ruimte (meestal 2D of 3D), terwijl het de essentiële structuur van de data bewaart. UMAP staat voor Uniform Manifold Approximation and Projection en is gebaseerd op manifold learning en topologische data-analyse.
Andere methoden voor dimensionaliteitsreductie, zoals t-SNE, behouden lokale buurtschappen goed maar vervormen globale relaties. Het belangrijkste voordeel van UMAP is dat het een balans vindt tussen zowel lokale buurten als globale relaties. Het veronderstelt dat de data op een Riemann-manifold ligt en dat deze manifold lokaal gemodelleerd kan worden met een vage topologische structuur. Deze wiskundige basis stelt UMAP in staat betekenisvollere visualisaties te maken, waarin vergelijkbare datapunten clusteren terwijl de algehele topologie van de dataset behouden blijft.
Het algoritme werkt door een hoog-dimensionale graafrepresentatie van de data te construeren en vervolgens een laag-dimensionale graaf te optimaliseren die structureel zo veel mogelijk overeenkomt. Naast visualisatie is UMAP nuttig als preprocessing-stap voor clusteralgoritmen of zelfs als algemene niet-lineaire dimensionaliteitsreductietechniek binnen machinelearning-pijplijnen.
We splitsen het proces op in een aantal kernstappen om te begrijpen hoe UMAP werkt. De volledige wiskundige theorie omvat geavanceerde concepten uit de topologie en topologische data-analyse, dus in deze tutorial kiezen we voor een intuïtieve benadering van het kernalgoritme.
UMAP begint met het bouwen van een gewogen graaf die relaties in de hoog-dimensionale ruimte weergeeft. Voor elk datapunt identificeert het de k naaste buren (waarbij k een instelbare parameter is). In tegenstelling tot eenvoudige k-NN-grafen gebruikt UMAP echter een probabilistische benadering. Het berekent de kans dat twee punten verbonden zijn op basis van hun afstand, met een soepele benadering die afhangt van de lokale dichtheid rond elk punt.
Het cruciale inzicht hier is dat UMAP zich aanpast aan de lokale structuur van je data. In dichte regio’s moeten punten zeer dicht bij elkaar liggen om als buren te gelden, terwijl het algoritme in ijle regio’s de zoekradius vergroot.
Dit adaptieve gedrag wordt gestuurd door de formule:
p(i,j) = exp(-(d(xi, xj) - ρi) / σi)Waarbij d(xi, xj) de afstand tussen punten is, ρi de afstand tot de naaste buur is, en σi een schaalfactor is die voor elk punt wordt berekend.
UMAP zet deze lokale kansverdelingen vervolgens om in een vage topologische structuur uit de topologische data-analyse. Het symmetriseert de graaf door de kansen uit beide richtingen te combineren:
p(i,j) = p(i|j) + p(j|i) - p(i|j) * p(j|i)Dit creëert wat een fuzzy simplicial set wordt genoemd, die de manifold-structuur van de hoog-dimensionale data vastlegt.
De laatste stap is het vinden van een laag-dimensionale representatie die de vage topologische structuur behoudt. UMAP initialiseert punten in de laag-dimensionale ruimte (met een spectrale embedding) en gebruikt vervolgens gradient descent om de cross-entropy tussen de hoog- en laag-dimensionale vage topologische representaties te minimaliseren.
De optimalisatie gebruikt aantrekkende krachten om punten die dicht bij elkaar horen samen te trekken (gebaseerd op de hoog-dimensionale structuur) en afstotende krachten om punten die ver uit elkaar horen te liggen uit elkaar te duwen. Deze duw-trek-dynamiek zorgt voor de karakteristieke visualisaties waarin clusters duidelijk gescheiden zijn, terwijl hun interne structuur behouden blijft.
UMAP heeft toepassingen in talloze domeinen waarin het begrijpen van hoog-dimensionale data nuttig is.
Enkele praktische toepassingen zijn:
Nu we het concept, de wiskundige basis en de praktische toepassingen van UMAP hebben besproken, gaan we door naar de implementatie.
Laten we UMAP toepassen op een real-world dataset om te zien hoe het in de praktijk werkt. We gebruiken de Olivetti Faces-dataset, met grijswaardenafbeeldingen van gezichten van 40 verschillende personen. De Olivetti-dataset kun je downloaden via Kaggle of via de scikit-learn Python-bibliotheek.
De Olivetti Faces-dataset bevat:
Dit is perfect voor UMAP, omdat we verwachten dat afbeeldingen van dezelfde persoon bij elkaar clusteren, ondanks variaties in expressie en belichting.
Laten we eerst de benodigde libraries importeren en onze dataset laden:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import matplotlib.cm as cm
from sklearn.datasets import fetch_olivetti_faces
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
import umap
import warnings
warnings.filterwarnings('ignore')

# Load the Olivetti faces dataset
faces = fetch_olivetti_faces(shuffle=True, random_state=42)
X = faces.data
y = faces.target

print(f"Dataset shape: {X.shape}")
print(f"Number of individuals: {len(np.unique(y))}")
print(f"Number of images per individual: {X.shape[0] // len(np.unique(y))}")

# Display sample faces
fig, axes = plt.subplots(2, 5, figsize=(12, 6))
for i, ax in enumerate(axes.flat):
   ax.imshow(X[i].reshape(64, 64), cmap='gray')
   ax.set_title(f'Person {y[i]}')
   ax.axis('off')
plt.suptitle('Sample Faces from the Dataset')
plt.tight_layout()
plt.show()
Met de bovenstaande code kunnen we de dataset als volgt visualiseren:
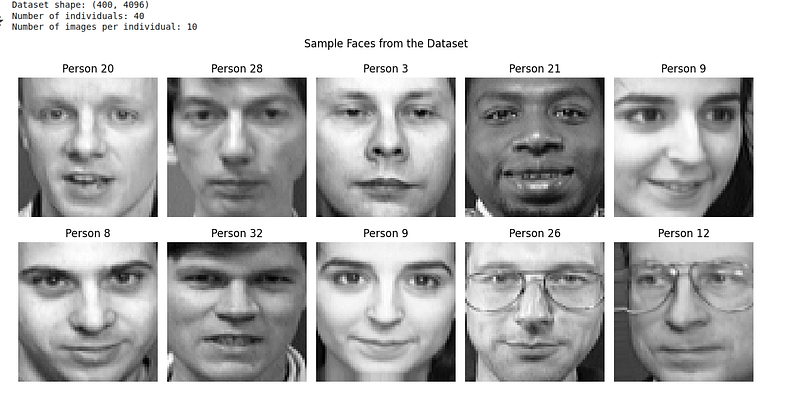
De Olivetti Faces-dataset is vooraf genormaliseerd met pixelwaarden tussen 0 en 1, dus we kunnen UMAP direct toepassen:
# Create UMAP instance with default parameters
reducer = umap.UMAP(random_state=42)

# Fit and transform the data
embedding = reducer.fit_transform(X)

# Create a custom colormap for 40 distinct classes
colors = cm.get_cmap('hsv', 40)

# Create visualization
plt.figure(figsize=(12, 10))
scatter = plt.scatter(embedding[:, 0], embedding[:, 1], c=y,
                    cmap=colors, s=50, alpha=0.8, edgecolors='black', linewidth=0.5)
plt.colorbar(scatter, label='Person ID', ticks=np.arange(0, 40, 5))
plt.title('UMAP Projection of Olivetti Faces (Default Parameters)')
plt.xlabel('UMAP 1')
plt.ylabel('UMAP 2')
plt.grid(True, alpha=0.3)
plt.show()
We krijgen een gekleurde scatterplot als UMAP-visualisatie:
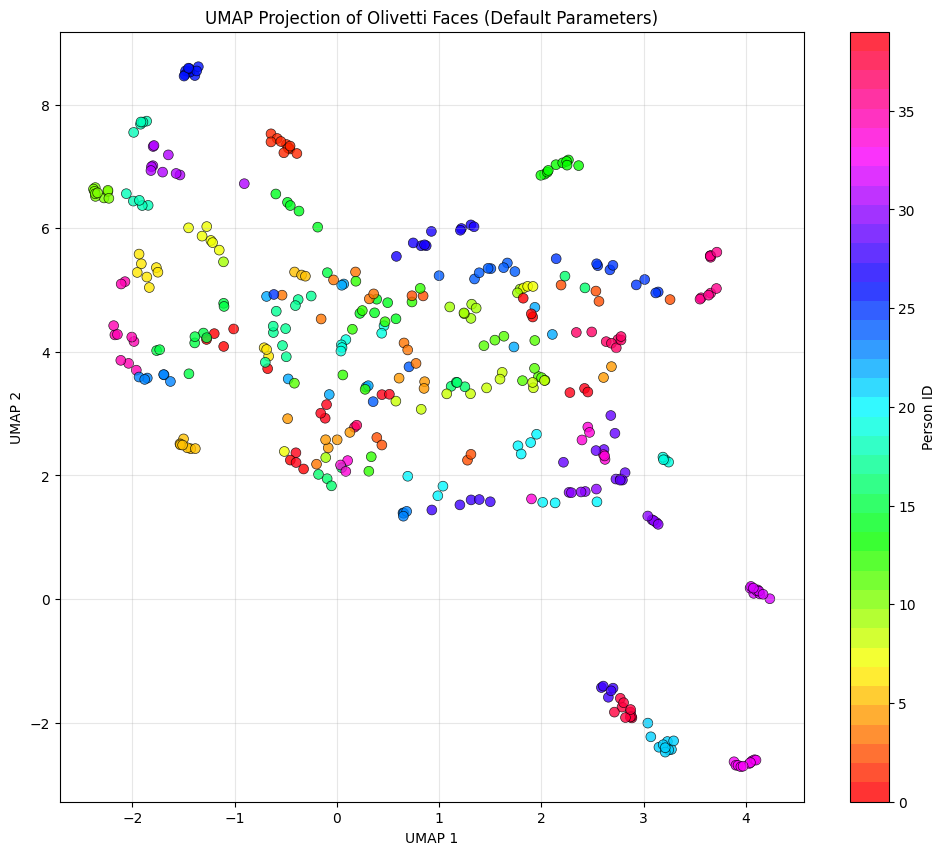
Hier zijn een paar aandachtspunten om het diagram beter te begrijpen:
Hoewel het in de praktijk niet perfect gebeurt, zouden we idealiter verwachten dat alle 10 afbeeldingen van dezelfde persoon (dezelfde kleur) bij elkaar clusteren. In het beeld zien we dat sommige gelijke kleuren bij elkaar clusteren wanneer we UMAP met de standaardparameters bouwen.
UMAP heeft verschillende belangrijke parameters die het gedrag sturen. Laten we bekijken hoe ze de resultaten beïnvloeden:
# Create subplots for different parameter settings
fig, axes = plt.subplots(2, 3, figsize=(18, 12))
axes = axes.ravel()

# Different parameter configurations
param_configs = [
   {'n_neighbors': 5, 'min_dist': 0.1},
   {'n_neighbors': 15, 'min_dist': 0.1},
   {'n_neighbors': 50, 'min_dist': 0.1},
   {'n_neighbors': 15, 'min_dist': 0.0},
   {'n_neighbors': 15, 'min_dist': 0.5},
   {'n_neighbors': 15, 'min_dist': 0.99}
]

# Apply UMAP with different parameters
for idx, params in enumerate(param_configs):
   reducer = umap.UMAP(random_state=42, **params)
   embedding = reducer.fit_transform(X_scaled)

   ax = axes[idx]
   scatter = ax.scatter(embedding[:, 0], embedding[:, 1], c=y,
                       cmap='tab20', s=30, alpha=0.8)
   ax.set_title(f"n_neighbors={params['n_neighbors']}, "
                f"min_dist={params['min_dist']}")
   ax.set_xlabel('UMAP 1')
   ax.set_ylabel('UMAP 2')
   ax.grid(True, alpha=0.3)

plt.tight_layout()
plt.show()
De resulterende visualisatie ziet er als volgt uit:
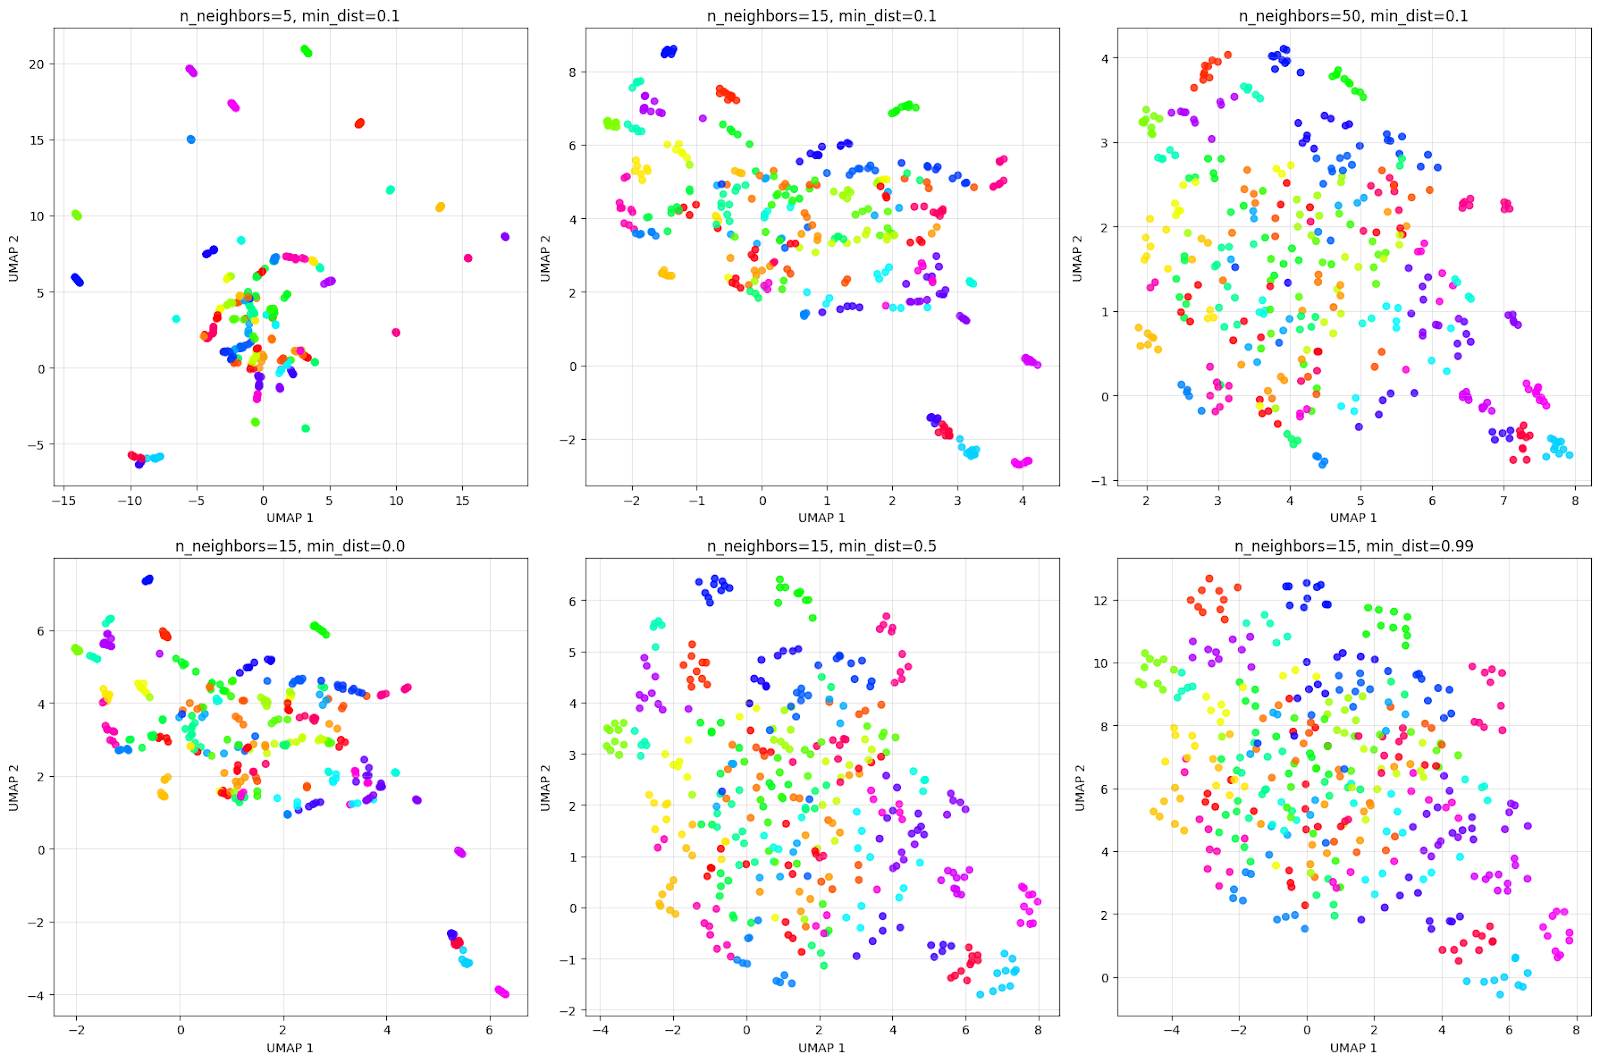
Het raster hierboven laat zien hoe parameters de visualisatie beïnvloeden. Kijkend naar de bovenste rij met het effect van n_neighbors:
Kijkend naar de onderste rij met het effect van min_dist:
Het is altijd aan te raden om met deze parameters te experimenteren om de beste clusteringen te krijgen voor het probleem dat je wilt oplossen.
Laten we ons voorbeeld met de Olivetti-dataset vervolgen om UMAP te vergelijken met PCA en t-SNE en hun verschillen te begrijpen:
from sklearn.decomposition import PCA
from sklearn.manifold import TSNE

# Create figure with subplots
fig, axes = plt.subplots(1, 3, figsize=(18, 6))

colors = cm.get_cmap('hsv', 40)

# PCA
pca = PCA(n_components=2, random_state=42)
pca_result = pca.fit_transform(X)
axes[0].scatter(pca_result[:, 0], pca_result[:, 1], c=y,
               cmap=colors, s=50, alpha=0.8)
axes[0].set_title('PCA Projection')
axes[0].set_xlabel('PC 1')
axes[0].set_ylabel('PC 2')
axes[0].grid(True, alpha=0.3)

# t-SNE
tsne = TSNE(n_components=2, random_state=42, perplexity=30)
tsne_result = tsne.fit_transform(X)
axes[1].scatter(tsne_result[:, 0], tsne_result[:, 1], c=y,
               cmap=colors, s=50, alpha=0.8)
axes[1].set_title('t-SNE Projection')
axes[1].set_xlabel('t-SNE 1')
axes[1].set_ylabel('t-SNE 2')
axes[1].grid(True, alpha=0.3)

# UMAP
umap_reducer = umap.UMAP(n_neighbors=15, min_dist=0.1, random_state=42)
umap_result = umap_reducer.fit_transform(X)
scatter = axes[2].scatter(umap_result[:, 0], umap_result[:, 1], c=y,
                        cmap=colors, s=50, alpha=0.8)
axes[2].set_title('UMAP Projection')
axes[2].set_xlabel('UMAP 1')
axes[2].set_ylabel('UMAP 2')
axes[2].grid(True, alpha=0.3)

plt.tight_layout()
plt.show()
We zien de vergelijkingsplot als hieronder:
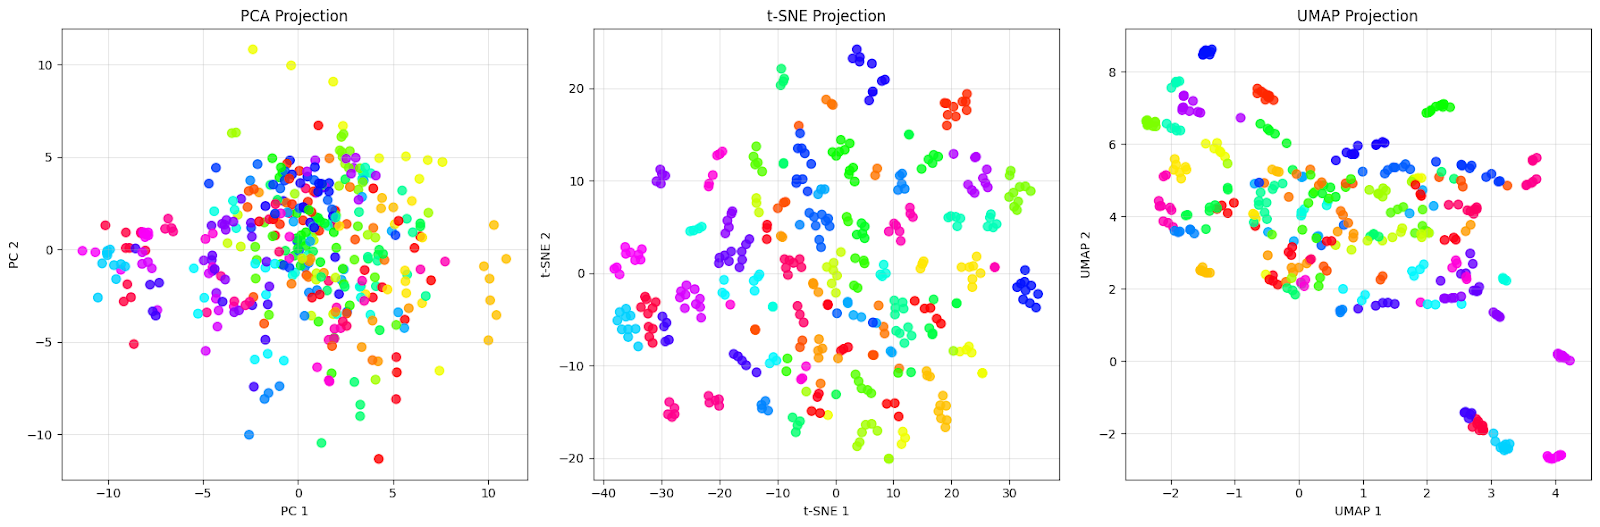
De PCA-projectie (links) toont een dichte wolk punten rond de oorsprong met veel overlap tussen verschillend gekleurde stippen. Dit is precies wat we van PCA verwachten — het legt de richtingen met maximale variantie in de data vast, maar slaagt er niet in de verschillende personen effectief te scheiden. Je ziet dat gezichten van verschillende individuen (verschillende kleuren) volledig door elkaar lopen, waardoor het vrijwel onmogelijk is om duidelijke groepen te identificeren.
De t-SNE-projectie (midden) toont verbetering met duidelijk gescheiden clusters. Elke kleur (die een andere persoon vertegenwoordigt) vormt een afzonderlijke, compacte groep met duidelijke grenzen tussen individuen. Merk op hoe t-SNE bijna perfecte lokale groeperingen creëert, waarbij gezichten van dezelfde persoon heel dicht bij elkaar worden getrokken en ver van andere groepen worden weggeduwd. Dit is t-SNE’s kracht: het blinkt uit in het behouden van lokale buurtschappen en het creëren van visueel onderscheidende clusters.
De UMAP-projectie (rechts) kiest een andere aanpak. Hoewel de clusters meer verspreid zijn dan bij t-SNE, weerspiegelt dit UMAP’s poging om zowel lokale als globale structuur te behouden. Je ziet dat elke persoon nog steeds herkenbare groepen vormt, maar met meer interne variatie. Sommige clusters overlappen licht of liggen dichter bij elkaar, wat kan duiden op daadwerkelijke gelijkenissen tussen die individuen.
Deze vergelijking illustreert een belangrijk punt: “beter” hangt af van je doel. Heb je de meest duidelijke visuele scheiding nodig voor presentatie of eerste verkenning, dan zijn t-SNE’s strakke clusters uitstekend voor deze dataset. Wil je echter de algehele structuur van de data en de onderlinge relaties tussen groepen begrijpen, dan is UMAP’s behoud van globale relaties geschikter voor deze dataset.
Zoals bij alle algoritmen en technieken kom je diverse uitdagingen tegen wanneer je UMAP toepast op real-world data.
Op basis van uitgebreide ervaring zijn dit enkele terugkerende knelpunten die ik vaak zie:
De meest voorkomende uitdaging is het selecteren van geschikte waarden voor n_neighbors en min_dist. Deze parameters beïnvloeden de visualisatie aanzienlijk, en er is geen one-size-fits-all-oplossing.
De n_neighbors-parameter balanceert het behoud van lokale versus globale structuur. Kleinere waarden (5–15) richten zich op zeer lokale buurten en leggen fijne structuur vast, maar kunnen grotere patronen versnipperen. Grotere waarden (30–100) benadrukken bredere connectiviteitspatronen, onthullen globale structuur maar kunnen lokale details verdoezelen.
De min_dist-parameter bepaalt hoe compact punten in de laag-dimensionale lay-out worden gepositioneerd, maar beïnvloedt de constructie van de hoog-dimensionale graaf niet. Waarden dicht bij 0 staan toe dat punten dicht op elkaar worden gepakt, wat visueel strakke clusters oplevert, terwijl waarden richting 1 punten gelijkmatiger over de projectieruimte verspreiden.
De beste aanpak is om te beginnen met de standaardwaarden (n_neighbors=15, min_dist=0.1) en te finetunen op basis van de kenmerken van je data:
UMAP kan traag zijn op zeer grote datasets (miljoenen punten), waardoor interactieve verkenning lastig wordt. We kunnen onderstaande technieken proberen om de performance te verbeteren:
In tegenstelling tot PCA hebben afstanden in UMAP-projecties geen directe interpretatie. Punten die dicht bij elkaar lijken te liggen, hoeven in de oorspronkelijke ruimte niet per se vergelijkbaar te zijn. Om deze beperking te adresseren is het belangrijk om:
UMAP gebruikt willekeurige initialisatie, wat tot verschillende resultaten per run kan leiden, waardoor exacte visualisaties lastig te reproduceren zijn. We kunnen reproduceerbaarheid waarborgen door het volgende te doen:
random_state te zetten: umap.UMAP(random_state=42)init te gebruiken om initiële posities te specificeren als exacte reproduceerbaarheid vereist isUMAP’s standaardafstandsmeter gaat uit van continue numerieke data, wat problematisch kan zijn voor datasets met categorische of gemengde features. Bij gemengde datatypen kun je het volgende overwegen:
metric-parameter gebruiken met opties zoals 'hamming' voor binaire dataExtreme outliers kunnen de hoofdmassa van de data samenpersen, waardoor de structuur van het merendeel van de punten lastig zichtbaar wordt. Enkele technieken om dit te ondervangen zijn:
local_connectivity aanpassen om robuuster te zijn tegen outliersHoewel deze lijst niet uitputtend is, dekt ze de meest voorkomende issues bij het werken met UMAP. Door deze problemen en hun oplossingen te begrijpen, haal je meer uit UMAP.
In deze tutorial hebben we onderzocht hoe UMAP werkt op zowel conceptueel als praktisch niveau, het geïmplementeerd op echte data, vergeleken met alternatieve methoden en veelvoorkomende uitdagingen besproken. De belangrijkste conclusie is dat UMAP’s vermogen om lokale en globale structuur in balans te houden het erg nuttig maakt voor exploratieve data-analyse bij complexe, hoog-dimensionale datasets.
Wil je je expertise in technieken voor dimensionaliteitsreductie verdiepen, bekijk dan onze Dimensionality Reduction in Python-cursus, waar je hands-on ervaring opdoet met UMAP naast andere technieken zoals PCA en t-SNE. Voor een breder perspectief op hoe dimensionaliteitsreductie past binnen machinelearning-workflows, behandelt het Machine Learning Scientist with Python-track zowel supervised als unsupervised learning, zodat je end-to-end oplossingen kunt bouwen voor real-world data-uitdagingen.
Topcursussen bij DataCamp
Cursus
Leerpad
Cursus
blog
Adel Nehme
15 min

