
Khóa học
Giảm Chiều Dữ Liệu với Python
4 giờ
37.2K
Trong các bài toán học máy, chúng ta thường gặp những tập dữ liệu có hàng trăm thậm chí hàng nghìn đặc trưng, và quy mô này thường gây khó khăn cho việc trực quan hóa và phân tích dữ liệu một cách có ý nghĩa. Các phương pháp vẽ truyền thống chỉ có thể hiển thị hai hoặc ba chiều cùng lúc, khiến việc hiểu cấu trúc của dữ liệu nhiều chiều gần như bất khả thi. Đây chính là lúc các kỹ thuật giảm chiều như UMAP (Uniform Manifold Approximation and Projection) phát huy tác dụng.
Theo thời gian, UMAP đã trở thành phương pháp ưa thích để trực quan hóa các tập dữ liệu phức tạp trong nhiều lĩnh vực. Hướng dẫn này sẽ đưa bạn đi từ nền tảng đến triển khai thực tế và các thách thức thường gặp, giúp bạn bắt đầu áp dụng kỹ thuật này vào dự án của mình ngay từ bây giờ.
UMAP là một thuật toán giảm chiều phi tuyến, dùng để chiếu dữ liệu có số chiều lớn xuống không gian có số chiều thấp hơn (thường là 2D hoặc 3D) trong khi vẫn giữ lại cấu trúc cốt lõi của dữ liệu. UMAP viết tắt của Uniform Manifold Approximation and Projection, dựa trên học đa tạp (manifold learning) và phân tích dữ liệu tô pô.
Các phương pháp giảm chiều khác như t-SNE giỏi trong việc bảo toàn lân cận cục bộ nhưng lại làm méo mó các mối quan hệ toàn cục. Lợi ích chính của UMAP là cân bằng được cả hai: vừa giữ lân cận cục bộ vừa duy trì mối quan hệ toàn cục. Thuật toán giả định dữ liệu nằm trên một đa tạp Riemann và đa tạp này có thể được mô hình hóa cục bộ bằng một cấu trúc tô pô mờ. Nền tảng toán học này cho phép UMAP tạo ra các trực quan hóa có ý nghĩa hơn, trong đó các điểm dữ liệu tương tự nhau tụ lại thành cụm, đồng thời vẫn duy trì được tô pô tổng thể của tập dữ liệu.
Thuật toán hoạt động bằng cách xây dựng một biểu diễn đồ thị ở không gian nhiều chiều của dữ liệu, sau đó tối ưu một đồ thị ở không gian thấp sao cho tương đồng về mặt cấu trúc nhất có thể. Ngoài trực quan hóa, UMAP hữu ích như một bước tiền xử lý cho các thuật toán phân cụm hoặc như một kỹ thuật giảm chiều phi tuyến tổng quát trong các pipeline học máy.
Chúng ta sẽ chia quy trình thành vài bước chính để hiểu cách UMAP hoạt động. Lý thuyết đầy đủ liên quan đến các khái niệm nâng cao từ tô pô và phân tích dữ liệu tô pô, nên trong hướng dẫn này, chúng ta sẽ tiếp cận trực quan vào lõi thuật toán.
UMAP bắt đầu bằng việc xây dựng một đồ thị có trọng số biểu diễn các mối quan hệ trong không gian nhiều chiều. Với mỗi điểm dữ liệu, thuật toán xác định k láng giềng gần nhất (k là tham số có thể điều chỉnh). Tuy nhiên, khác với đồ thị k-NN đơn giản, UMAP sử dụng cách tiếp cận xác suất. Thuật toán tính xác suất hai điểm được nối với nhau dựa trên khoảng cách của chúng, sử dụng một xấp xỉ trơn phụ thuộc vào mật độ cục bộ quanh mỗi điểm.
Điểm mấu chốt là UMAP thích ứng với cấu trúc cục bộ của dữ liệu. Ở vùng dày đặc, các điểm phải rất gần nhau mới được coi là láng giềng, trong khi ở vùng thưa, thuật toán mở rộng bán kính tìm kiếm.
Hành vi thích ứng này được điều khiển bởi công thức:
p(i,j) = exp(-(d(xi, xj) - ρi) / σi)Trong đó d(xi, xj) là khoảng cách giữa các điểm, ρi là khoảng cách tới láng giềng gần nhất, và σi là hệ số tỉ lệ được tính cho mỗi điểm.
Sau đó UMAP chuyển các phân phối xác suất cục bộ này thành một cấu trúc tô pô mờ từ phân tích dữ liệu tô pô. Thuật toán đối xứng hóa đồ thị bằng cách kết hợp xác suất theo cả hai hướng:
p(i,j) = p(i|j) + p(j|i) - p(i|j) * p(j|i)Điều này tạo ra cái gọi là tập đơn hình mờ (fuzzy simplicial set), nắm bắt cấu trúc đa tạp của dữ liệu nhiều chiều.
Bước cuối cùng là tìm một biểu diễn ở không gian chiều thấp bảo toàn cấu trúc tô pô mờ. UMAP khởi tạo các điểm trong không gian thấp (bằng nhúng phổ) rồi dùng gradient descent để tối thiểu hóa cross-entropy giữa các biểu diễn tô pô mờ ở không gian cao và thấp.
Quá trình tối ưu sử dụng lực hút để kéo các điểm cần gần nhau (dựa trên cấu trúc ở không gian cao) và lực đẩy để tách các điểm nên ở xa. Cơ chế kéo-đẩy này tạo nên các trực quan hóa đặc trưng, nơi các cụm được tách biệt tốt đồng thời vẫn giữ cấu trúc bên trong.
UMAP có ứng dụng trong nhiều lĩnh vực nơi việc thấu hiểu dữ liệu nhiều chiều là hữu ích.
Một số ứng dụng thực tế gồm:
Sau khi đã hiểu khái niệm, nền tảng toán học và ứng dụng thực tế của UMAP, hãy chuyển sang phần triển khai.
Hãy triển khai UMAP trên một tập dữ liệu thực để xem nó hoạt động ra sao trong thực tế. Chúng ta sẽ dùng tập dữ liệu Olivetti Faces, gồm các ảnh thang xám của khuôn mặt từ 40 người khác nhau. Tập Olivetti có thể tải từ Kaggle hoặc qua thư viện Python scikit-learn.
Tập dữ liệu Olivetti Faces gồm:
Đây là trường hợp hoàn hảo cho UMAP vì chúng ta kỳ vọng ảnh của cùng một người sẽ cụm lại với nhau, dù có biến thiên về biểu cảm và ánh sáng.
Trước tiên, hãy import các thư viện cần thiết và nạp tập dữ liệu:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import matplotlib.cm as cm
from sklearn.datasets import fetch_olivetti_faces
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
import umap
import warnings
warnings.filterwarnings('ignore')

# Load the Olivetti faces dataset
faces = fetch_olivetti_faces(shuffle=True, random_state=42)
X = faces.data
y = faces.target

print(f"Dataset shape: {X.shape}")
print(f"Number of individuals: {len(np.unique(y))}")
print(f"Number of images per individual: {X.shape[0] // len(np.unique(y))}")

# Display sample faces
fig, axes = plt.subplots(2, 5, figsize=(12, 6))
for i, ax in enumerate(axes.flat):
   ax.imshow(X[i].reshape(64, 64), cmap='gray')
   ax.set_title(f'Person {y[i]}')
   ax.axis('off')
plt.suptitle('Sample Faces from the Dataset')
plt.tight_layout()
plt.show()
Từ đoạn mã trên, chúng ta có thể trực quan hóa tập dữ liệu như sau:
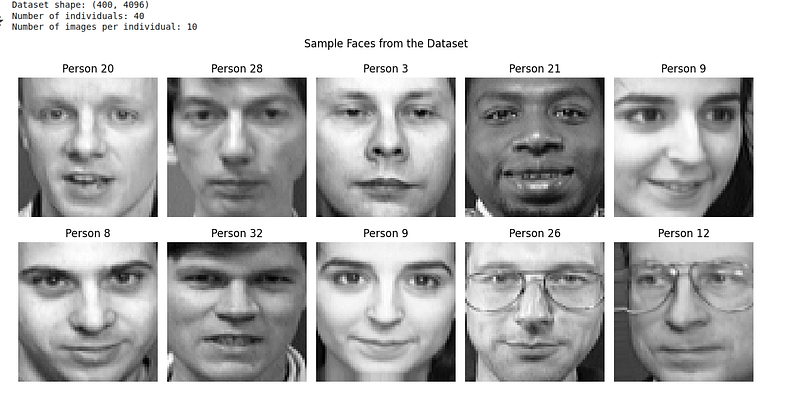
Tập Olivetti Faces đã được chuẩn hóa sẵn với giá trị pixel trong khoảng 0 đến 1, nên chúng ta có thể áp dụng UMAP trực tiếp:
# Create UMAP instance with default parameters
reducer = umap.UMAP(random_state=42)

# Fit and transform the data
embedding = reducer.fit_transform(X)

# Create a custom colormap for 40 distinct classes
colors = cm.get_cmap('hsv', 40)

# Create visualization
plt.figure(figsize=(12, 10))
scatter = plt.scatter(embedding[:, 0], embedding[:, 1], c=y,
                    cmap=colors, s=50, alpha=0.8, edgecolors='black', linewidth=0.5)
plt.colorbar(scatter, label='Person ID', ticks=np.arange(0, 40, 5))
plt.title('UMAP Projection of Olivetti Faces (Default Parameters)')
plt.xlabel('UMAP 1')
plt.ylabel('UMAP 2')
plt.grid(True, alpha=0.3)
plt.show()
Chúng ta sẽ thấy một biểu đồ phân tán có màu sắc như một trực quan hóa UMAP:
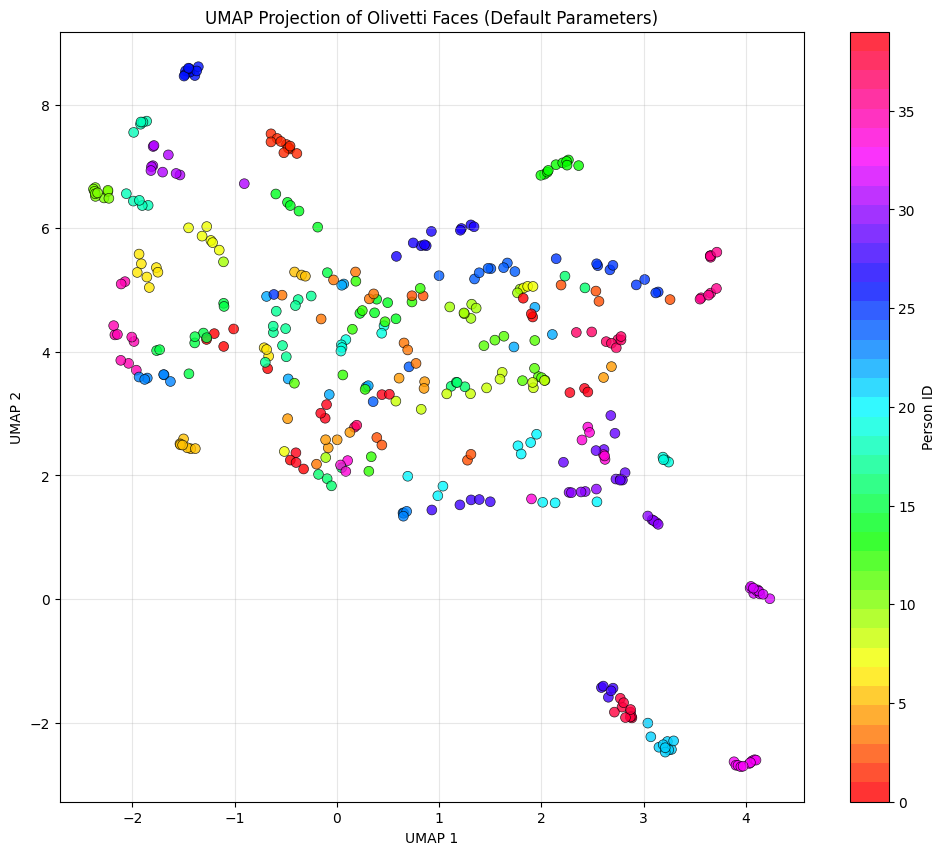
Một vài điểm cần lưu ý để hiểu sơ đồ tốt hơn:
Dù hiếm khi xảy ra trong thực tế, lý tưởng nhất là 10 ảnh của cùng một người (cùng màu) sẽ cụm lại với nhau. Trên hình, ta thấy một số màu tương tự cụm lại khi chúng ta xây dựng UMAP với tham số mặc định.
UMAP có một số tham số quan trọng điều khiển hành vi của nó. Hãy khám phá cách chúng ảnh hưởng đến kết quả:
# Create subplots for different parameter settings
fig, axes = plt.subplots(2, 3, figsize=(18, 12))
axes = axes.ravel()

# Different parameter configurations
param_configs = [
   {'n_neighbors': 5, 'min_dist': 0.1},
   {'n_neighbors': 15, 'min_dist': 0.1},
   {'n_neighbors': 50, 'min_dist': 0.1},
   {'n_neighbors': 15, 'min_dist': 0.0},
   {'n_neighbors': 15, 'min_dist': 0.5},
   {'n_neighbors': 15, 'min_dist': 0.99}
]

# Apply UMAP with different parameters
for idx, params in enumerate(param_configs):
   reducer = umap.UMAP(random_state=42, **params)
   embedding = reducer.fit_transform(X_scaled)

   ax = axes[idx]
   scatter = ax.scatter(embedding[:, 0], embedding[:, 1], c=y,
                       cmap='tab20', s=30, alpha=0.8)
   ax.set_title(f"n_neighbors={params['n_neighbors']}, "
                f"min_dist={params['min_dist']}")
   ax.set_xlabel('UMAP 1')
   ax.set_ylabel('UMAP 2')
   ax.grid(True, alpha=0.3)

plt.tight_layout()
plt.show()
Trực quan hóa đầu ra như sau:
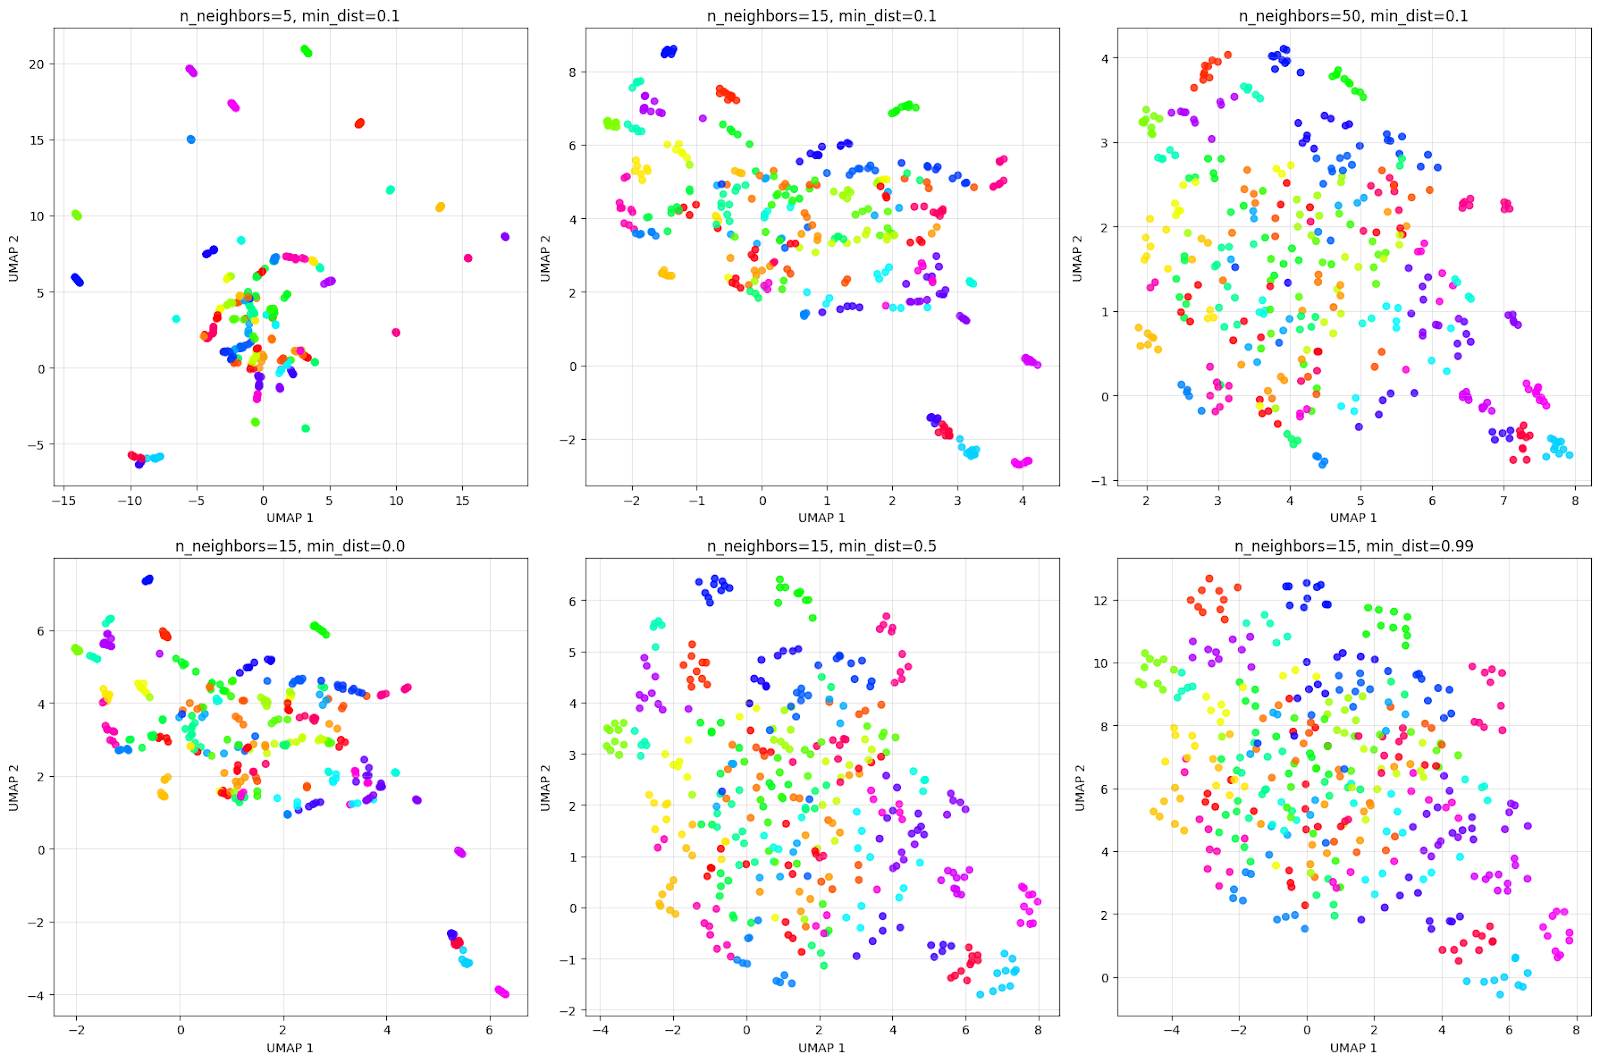
Lưới trên minh họa cách các tham số tác động đến trực quan hóa. Xét hàng trên về ảnh hưởng của n_neighbors:
Xét hàng dưới về ảnh hưởng của min_dist:
Luôn nên thử nghiệm các tham số này để đạt kết quả phân cụm tốt nhất cho bài toán cụ thể.
Hãy tiếp tục ví dụ với tập Olivetti để so sánh UMAP với PCA và t-SNE, từ đó hiểu sự khác biệt:
from sklearn.decomposition import PCA
from sklearn.manifold import TSNE

# Create figure with subplots
fig, axes = plt.subplots(1, 3, figsize=(18, 6))

colors = cm.get_cmap('hsv', 40)

# PCA
pca = PCA(n_components=2, random_state=42)
pca_result = pca.fit_transform(X)
axes[0].scatter(pca_result[:, 0], pca_result[:, 1], c=y,
               cmap=colors, s=50, alpha=0.8)
axes[0].set_title('PCA Projection')
axes[0].set_xlabel('PC 1')
axes[0].set_ylabel('PC 2')
axes[0].grid(True, alpha=0.3)

# t-SNE
tsne = TSNE(n_components=2, random_state=42, perplexity=30)
tsne_result = tsne.fit_transform(X)
axes[1].scatter(tsne_result[:, 0], tsne_result[:, 1], c=y,
               cmap=colors, s=50, alpha=0.8)
axes[1].set_title('t-SNE Projection')
axes[1].set_xlabel('t-SNE 1')
axes[1].set_ylabel('t-SNE 2')
axes[1].grid(True, alpha=0.3)

# UMAP
umap_reducer = umap.UMAP(n_neighbors=15, min_dist=0.1, random_state=42)
umap_result = umap_reducer.fit_transform(X)
scatter = axes[2].scatter(umap_result[:, 0], umap_result[:, 1], c=y,
                        cmap=colors, s=50, alpha=0.8)
axes[2].set_title('UMAP Projection')
axes[2].set_xlabel('UMAP 1')
axes[2].set_ylabel('UMAP 2')
axes[2].grid(True, alpha=0.3)

plt.tight_layout()
plt.show()
Chúng ta sẽ thấy biểu đồ so sánh như bên dưới:
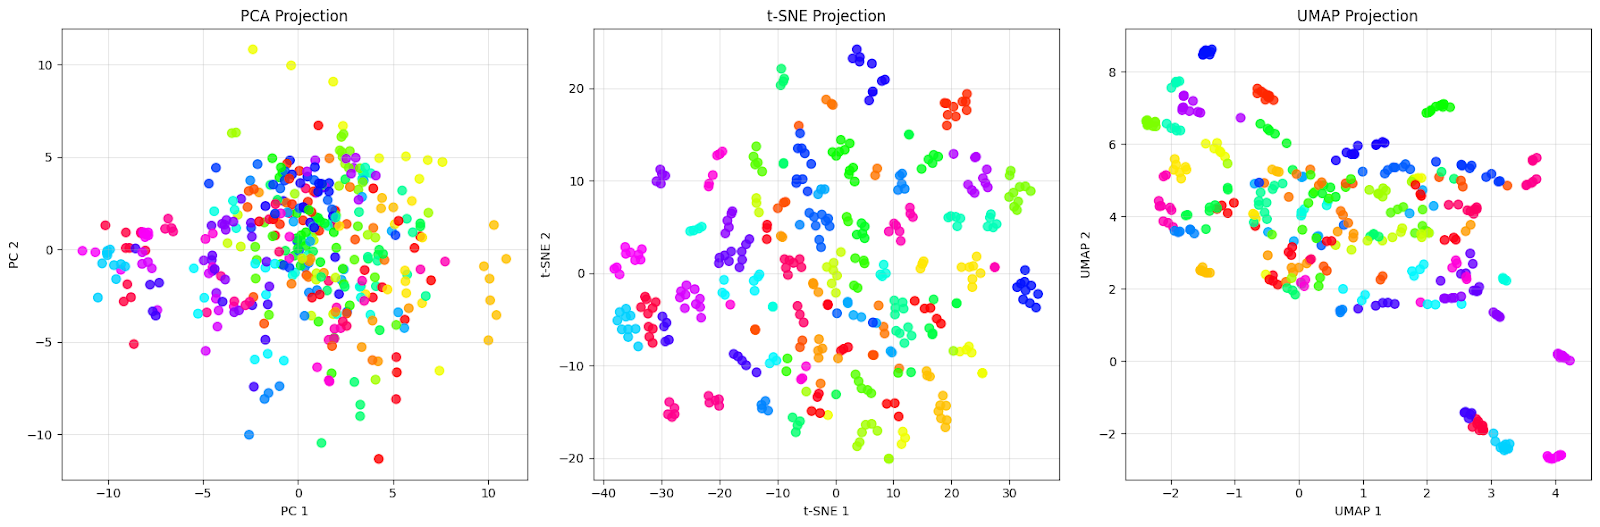
Phép chiếu PCA (bên trái) cho thấy một đám mây điểm dày đặc quanh gốc tọa độ với sự chồng lấn lớn giữa các chấm màu khác nhau. Đây chính xác là điều kỳ vọng từ PCA — nó nắm bắt các hướng phương sai lớn nhất trong dữ liệu nhưng không tách biệt hiệu quả các cá nhân khác nhau. Ta thấy khuôn mặt của các cá nhân khác nhau (màu khác nhau) trộn lẫn hoàn toàn, khiến gần như không thể nhận diện các nhóm riêng biệt.
Phép chiếu t-SNE (ở giữa) cho thấy cải thiện với các cụm tách biệt tốt. Mỗi màu (đại diện cho một người) tạo thành một nhóm riêng, chặt chẽ với ranh giới rõ ràng giữa các cá nhân. Lưu ý cách t-SNE tạo nên các nhóm cục bộ gần như hoàn hảo, nơi các khuôn mặt của cùng một người được kéo lại rất gần nhau trong khi đẩy ra xa các nhóm khác. Đây là thế mạnh của t-SNE: xuất sắc trong việc bảo toàn lân cận cục bộ và tạo các cụm trực quan khác biệt.
Phép chiếu UMAP (bên phải) tiếp cận theo cách khác. Dù các cụm tản rộng hơn so với t-SNE, điều này phản ánh nỗ lực của UMAP nhằm bảo toàn cả cấu trúc cục bộ lẫn toàn cục. Ta thấy mỗi người vẫn tạo thành những nhóm có thể nhận biết, nhưng với biến thiên nội bộ nhiều hơn. Một số cụm có chồng lấn nhẹ hoặc nằm gần nhau hơn, có thể cho thấy sự tương đồng thực sự giữa các cá nhân đó.
So sánh này minh họa một điểm quan trọng: “tốt hơn” phụ thuộc vào mục tiêu của bạn. Nếu cần sự tách biệt trực quan rõ ràng nhất để thuyết trình hoặc khám phá ban đầu, các cụm chặt của t-SNE là rất phù hợp cho tập dữ liệu này. Tuy nhiên, nếu muốn hiểu cấu trúc tổng thể của dữ liệu và quan hệ giữa các nhóm, khả năng bảo toàn mối quan hệ toàn cục của UMAP khiến nó phù hợp hơn cho tập dữ liệu này.
Như mọi thuật toán và kỹ thuật, chúng ta sẽ gặp một số thách thức khi áp dụng UMAP cho dữ liệu thực.
Từ kinh nghiệm làm việc nhiều với UMAP, dưới đây là một số thách thức tôi thường xuyên gặp:
Thách thức phổ biến nhất là chọn giá trị thích hợp cho n_neighbors và min_dist. Các tham số này ảnh hưởng đáng kể đến trực quan hóa và không có một cấu hình “chuẩn” cho mọi trường hợp.
Tham số n_neighbors cân bằng giữa việc bảo toàn cấu trúc cục bộ và toàn cục. Giá trị nhỏ (5–15) tập trung bảo toàn lân cận rất cục bộ, nắm bắt cấu trúc tinh nhưng có thể làm vỡ các mẫu lớn hơn. Giá trị lớn (30–100) nhấn mạnh các mẫu kết nối rộng, bộc lộ cấu trúc toàn cục nhưng có thể che mờ chi tiết cục bộ.
Tham số min_dist kiểm soát mức độ “nén” của các điểm trong bố cục không gian thấp, nhưng không ảnh hưởng đến quá trình xây dựng đồ thị ở không gian cao. Giá trị gần 0 cho phép các điểm dồn sát, tạo các cụm chặt về mặt thị giác, trong khi giá trị tiến gần 1 sẽ trải các điểm đồng đều hơn trên không gian chiếu.
Cách tốt nhất là bắt đầu với giá trị mặc định (n_neighbors=15, min_dist=0.1) rồi điều chỉnh theo đặc điểm dữ liệu:
UMAP có thể chậm trên các tập dữ liệu rất lớn (hàng triệu điểm), khiến việc khám phá tương tác trở nên khó khăn. Chúng ta có thể thử một số kỹ thuật dưới đây để cải thiện hiệu năng:
Không giống PCA, khoảng cách trong các phép chiếu UMAP không có cách diễn giải trực tiếp. Các điểm trông có vẻ gần nhau có thể không giống nhau trong không gian gốc. Để khắc phục hạn chế này, điều quan trọng là:
UMAP sử dụng khởi tạo ngẫu nhiên, có thể dẫn đến kết quả khác nhau giữa các lần chạy, gây khó khăn cho việc tái tạo trực quan hóa chính xác. Chúng ta có thể đảm bảo khả năng tái lập bằng cách thực hiện các thực hành sau:
random_state: umap.UMAP(random_state=42)init để chỉ định vị trí khởi tạo nếu cần tái lập chính xácThước đo khoảng cách mặc định của UMAP giả định dữ liệu số liên tục, điều này có thể gây vấn đề với các tập dữ liệu có đặc trưng phân loại hoặc hỗn hợp. Khi làm việc với dữ liệu kiểu hỗn hợp, chúng ta có thể cân nhắc các cách tiếp cận sau:
metric với các tùy chọn như 'hamming' cho dữ liệu nhị phânCác điểm ngoại lai cực đoan có thể nén phân bố dữ liệu chính, khiến khó thấy cấu trúc của đa số điểm. Một số kỹ thuật có thể dùng để khắc phục gồm:
local_connectivity để tăng khả năng chống chịu với ngoại laiDù danh sách này chưa đầy đủ, nó bao quát các vấn đề phổ biến nhất khi làm việc với UMAP. Hiểu các vấn đề và cách giải quyết sẽ giúp chúng ta khai thác tối đa UMAP.
Qua hướng dẫn này, chúng ta đã tìm hiểu cách UMAP hoạt động ở cả cấp độ khái niệm và thực tiễn, triển khai trên dữ liệu thực, so sánh với các phương pháp thay thế, và giải quyết các thách thức thường gặp. Điều cốt lõi là khả năng cân bằng giữa việc bảo toàn cấu trúc cục bộ và toàn cục của UMAP khiến nó hữu ích cho phân tích dữ liệu thăm dò khi xử lý các tập dữ liệu phức tạp, nhiều chiều.
Để đào sâu chuyên môn về các kỹ thuật giảm chiều dữ liệu, hãy khám phá khóa học Dimensionality Reduction in Python, nơi bạn sẽ thực hành UMAP cùng các kỹ thuật khác như PCA và t-SNE. Để có góc nhìn rộng hơn về cách giảm chiều dữ liệu hòa vào quy trình học máy, lộ trình Machine Learning Scientist with Python dạy bạn cả học có giám sát và không giám sát, giúp bạn xây dựng giải pháp đầu-cuối cho các bài toán dữ liệu thực tế.
Khóa học hàng đầu trên DataCamp
Khóa học
Lộ trình
Khóa học
blog
Matt Crabtree
10 phút
