Last chance! 50% off DataCamp Premium
Sale ends in
Dit jaar stond in het teken van innovatie binnen data science, met kunstmatige intelligentie en machine learning die de krantenkoppen domineerden. Hoewel de vooruitgang in 2023 onmiskenbaar is, is het belangrijk te erkennen dat veel van deze ML-doorbraken alleen mogelijk waren dankzij de juiste evaluatieprocessen die de modellen doorlopen. Data-professionals hebben de taak om te zorgen voor nauwkeurige evaluaties en processen om de prestaties van een machinelearningmodel te meten. Dat is niet alleen nuttig – het is essentieel.
Wil je de kunst van data science in de vingers krijgen, dan gidst dit artikel je door de cruciale stappen van modelevaluatie met de confusion matrix: een relatief eenvoudige maar krachtige tool die veel wordt gebruikt bij modelbeoordeling.
Laten we erin duiken en meer leren over de confusion matrix.
De confusion matrix is een hulpmiddel om de prestaties van een model te evalueren en wordt visueel weergegeven als een tabel. Het geeft data-professionals meer inzicht in de prestaties, fouten en zwakke plekken van het model. Zo kunnen ze het model gerichter analyseren en fine-tunen.
Laten we de basisstructuur van een confusion matrix leren kennen aan de hand van het voorbeeld waarin je een e-mail als spam of geen spam classificeert.
Om het concept van een confusion matrix echt te begrijpen, bekijk je de visualisatie hieronder:
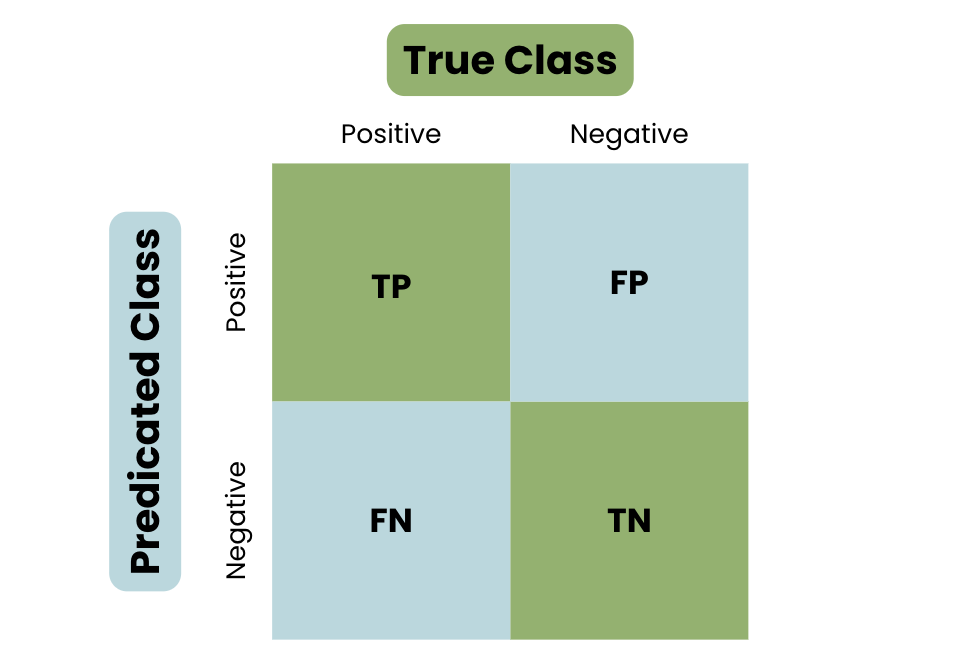
De basisstructuur van een confusion matrix
Om de confusion matrix goed te begrijpen, is het essentieel de belangrijkste maatstaven te kennen waarmee je de prestaties van een model beoordeelt.
Laten we de belangrijkste metrics definiëren:
Accuracy meet het totaal aantal correcte classificaties gedeeld door het totaal aantal gevallen.
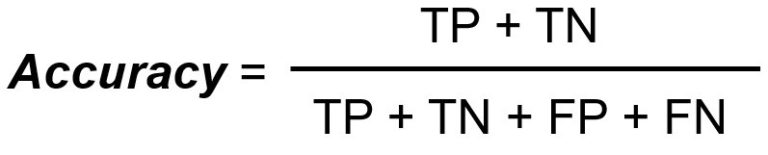
Recall/Sensitiviteit meet het totaal aantal true positives gedeeld door het totaal aantal werkelijke positieven.
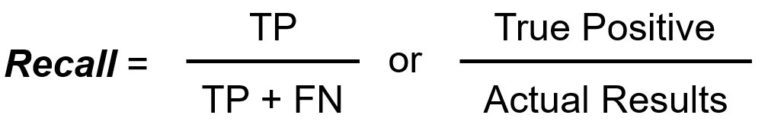
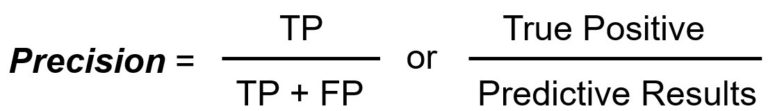
Precisie meet het totaal aantal true positives gedeeld door het totaal aantal voorspelde positieven.
Specificiteit meet het totaal aantal true negatives gedeeld door het totaal aantal werkelijke negatieven.
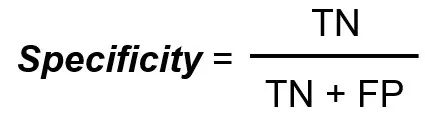
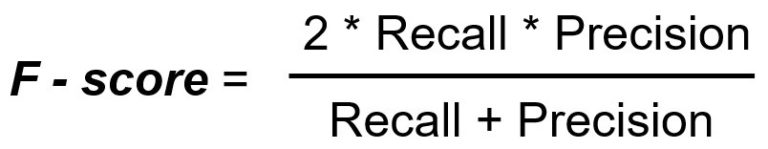
De F1-score is één metric die het harmonisch gemiddelde van precisie en recall neemt.
Om de confusion matrix beter te begrijpen, moet je het doel en het brede gebruik ervan snappen.
Bij het meten van de prestaties van een model – of van wat dan ook – focussen mensen vaak op accuracy. Maar zwaar leunen op alleen de accuracymetric kan tot verkeerde beslissingen leiden. Om dat te begrijpen, bekijken we de beperkingen van accuracy als opzichzelfstaande metric.
Zoals hierboven gedefinieerd meet accuracy het totaal aantal correcte classificaties gedeeld door het totaal aantal gevallen. Als je deze metric echter geïsoleerd gebruikt, zijn er beperkingen, zoals:
Met deze beperkingen in het achterhoofd biedt de confusion matrix, samen met diverse metrics, gedetailleerder inzicht in hoe je de prestaties van een model kunt verbeteren.
Zoals te zien is in de basisstructuur van een confusion matrix, worden voorspellingen opgesplitst in vier categorieën: True Positive, True Negative, False Positive en False Negative.
Deze gedetailleerde uitsplitsing biedt waardevolle inzichten en aanknopingspunten om de prestaties van een model te verbeteren:
Nu we een goed begrip hebben van de basisconfusionmatrix, de terminologie en het gebruik, gaan we verder met het handmatig berekenen van een confusion matrix, gevolgd door een praktisch voorbeeld.
Hier volgt een stapsgewijze handleiding voor het handmatig berekenen van een confusion matrix.
De eerste stap is het identificeren van de twee mogelijke uitkomsten van je taak: Positief of Negatief.
Zodra je de mogelijke uitkomsten hebt gedefinieerd, verzamel je alle voorspellingen van het model, inclusief hoe vaak het model elke klasse voorspelde en hoe vaak dat voorkwam.
Als alle voorspellingen verzameld zijn, classificeer je de uitkomsten in de vier categorieën:
Zodra de uitkomsten zijn geclassificeerd, presenteer je ze in een matrix/tabel, om ze vervolgens met diverse metrics verder te analyseren.
Laten we een praktisch voorbeeld doornemen om dit proces te illustreren.
We blijven bij het voorbeeld van het identificeren van een e-mail als spam of geen spam. We maken een hypothetische dataset waarbij spam Positief is en geen spam Negatief. We hebben de volgende gegevens:
We hebben nu de uitkomst gedefinieerd en de gegevens verzameld; de volgende stap is om de uitkomsten in de vier categorieën te classificeren:
De volgende stap is dit om te zetten in een confusion matrix:
|
Werkelijk / Voorspeld |
Spam (Positief) |
Geen spam (Negatief) |
|
Spam (Positief) |
60 (TP) |
20 (FN) |
|
Geen spam (Negatief) |
20 (FP) |
100 (TN) |
Wat vertelt de confusion matrix ons?
Met deze confusion matrix kunnen we de verschillende metrics berekenen: Accuracy, Recall/Sensitiviteit, Precisie, Specificiteit en de F1-score.
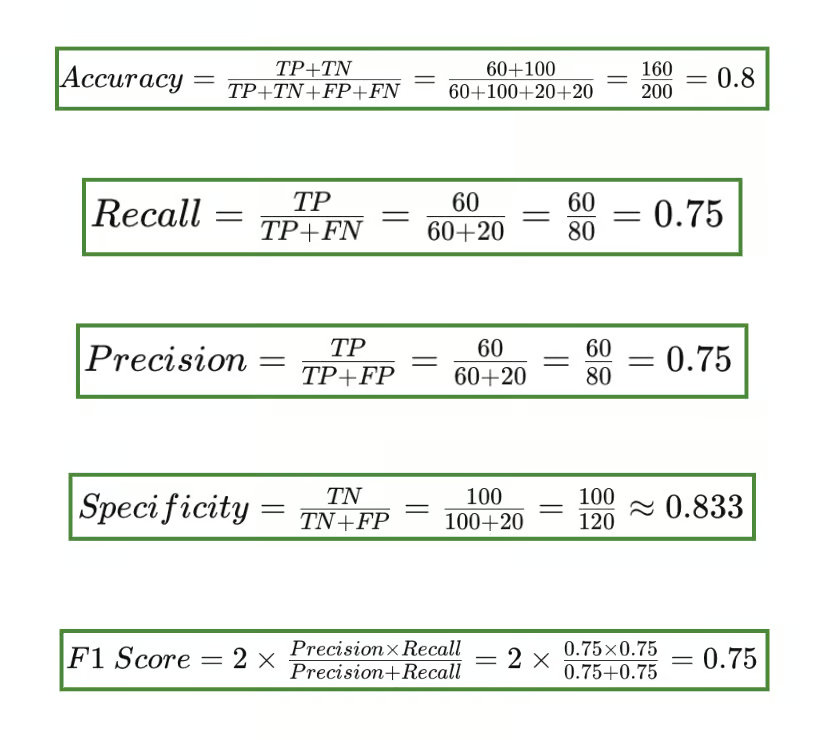
Output van confusion-matrixmetrics
Je vraagt je misschien af waarom de F1-score precisie en recall in de formule opneemt. De F1-score is cruciaal bij scheve data of wanneer je de trade-off tussen precisie en recall wilt balanceren.
Precisie meet de nauwkeurigheid van positieve voorspellingen. Het beantwoordt de vraag: ‘als het model TRUE voorspelde, hoe vaak had het gelijk?’. Precisie is vooral belangrijk wanneer de kosten van een false positive hoog zijn.
Recall of sensitiviteit meet hoeveel werkelijke positieven door het model correct zijn geïdentificeerd. Het beantwoordt de vraag: ‘wanneer de klasse daadwerkelijk TRUE was, hoe vaak zat de classifier dan goed?’.
Recall is belangrijk wanneer het missen van een positieve instantie (FN) aanzienlijk erger is dan het onterecht labelen van negatieve instanties als positief.
Om dit concreet te maken, maken we een confusion matrix met Scikit-learn in Python, met een Random Forest-classifier.
De eerste stap is het importeren van de vereiste libraries en het bouwen van je synthetische dataset.
# Import Libraries
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import confusion_matrix
import matplotlib.pyplot as plt
import seaborn as sns

# Synthetic Dataset
X, y = make_classification(n_samples=1000, n_features=20,
                           n_classes=2, random_state=42)

# Split into Training and Test Sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
De volgende stap is het model trainen met een eenvoudige random forest-classifier
# Train the Model
model = RandomForestClassifier(random_state=42)
model.fit(X_train, y_train)
Net als bij het praktische voorbeeld moeten we de uitkomsten classificeren en omzetten in een confusion matrix. Dat doen we door eerst te voorspellen op de testdata en vervolgens een confusion matrix te genereren:
# Predict on the Test Data
y_pred = model.predict(X_test)

# Generate the confusion matrix
cm = confusion_matrix(y_test, y_pred)
Nu willen we een visuele weergave van de confusion matrix genereren:
# Create a Confusion Matrix
plt.figure(figsize=(8, 8))
sns.heatmap(cm, annot=True, fmt='d', cmap='Greens')
plt.title('Confusion Matrix')
plt.ylabel('True label')
plt.xlabel('Predicted label')
plt.show()
Dit is de output:
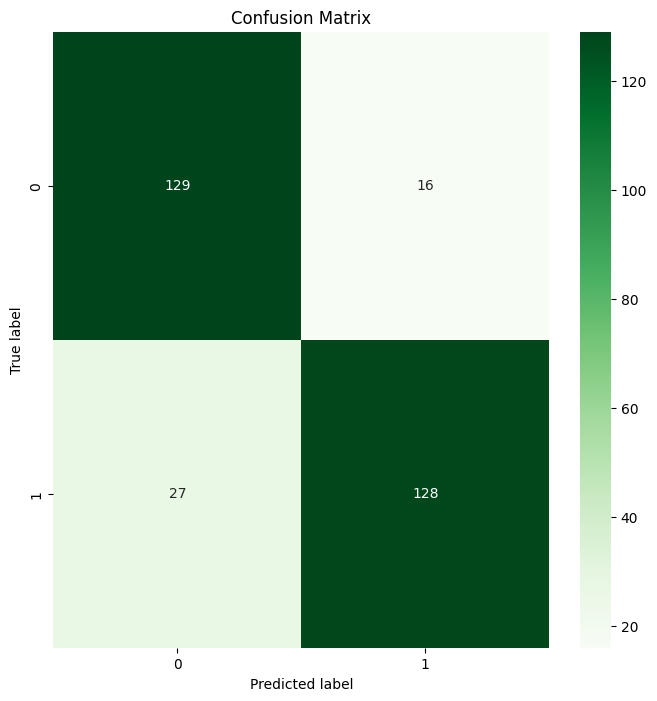
Random Forest-confusionmatrixoutput
Tada 🎉 Je hebt succesvol je eerste confusion matrix met Scikit-learn gemaakt!
In dit artikel hebben we de definitie van een confusion matrix verkend, de belangrijkste terminologie rond deze evaluatietool, en de beperkingen en het belang van de verschillende metrics. Handmatig een confusion matrix kunnen berekenen is belangrijk voor je data science-kennisbasis, net als het kunnen toepassen met libraries zoals Scikit-learn.
Wil je verder de diepte in met de confusion matrix, oefen dan confusion matrices in R met Understanding Confusion Matrix in R. Duik nog wat dieper met onze cursus Model Validation in Python, waarin je de basis van modevalidatie, validatietechnieken en het bouwen van gevalideerde, hoog presterende modellen leert.
Meer leren over de confusion matrix
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min