Corso
Validazione dei modelli in Python
4 ore
31.3K
Quest'anno è stato all'insegna dell'innovazione nel campo della data science, con intelligenza artificiale e machine learning a dominare le notizie. Pur essendo innegabili i progressi compiuti nel 2023, è importante riconoscere che molti di questi avanzamenti nel machine learning sono stati possibili solo grazie ai corretti processi di valutazione cui i modelli sono sottoposti. A chi lavora con i dati spetta il compito di garantire valutazioni accurate e processi adeguati per misurare le prestazioni di un modello di machine learning. Non è solo utile: è essenziale.
Se vuoi padroneggiare l'arte della data science, questo articolo ti guiderà nei passaggi cruciali della valutazione dei modelli usando la confusion matrix, uno strumento relativamente semplice ma potente, ampiamente utilizzato nella valutazione.
Quindi tuffiamoci e scopriamo di più sulla confusion matrix.
La confusion matrix è uno strumento utilizzato per valutare le prestazioni di un modello ed è rappresentata visivamente come una tabella. Fornisce agli specialisti dei dati un livello più profondo di insight sulle prestazioni del modello, sugli errori e sulle sue debolezze. Questo permette di analizzare ulteriormente il modello attraverso il fine tuning.
Vediamo la struttura di base di una confusion matrix, usando l'esempio dell'identificazione di un'email come spam o non spam.
Per comprendere davvero il concetto di confusion matrix, dai un'occhiata alla visualizzazione qui sotto:
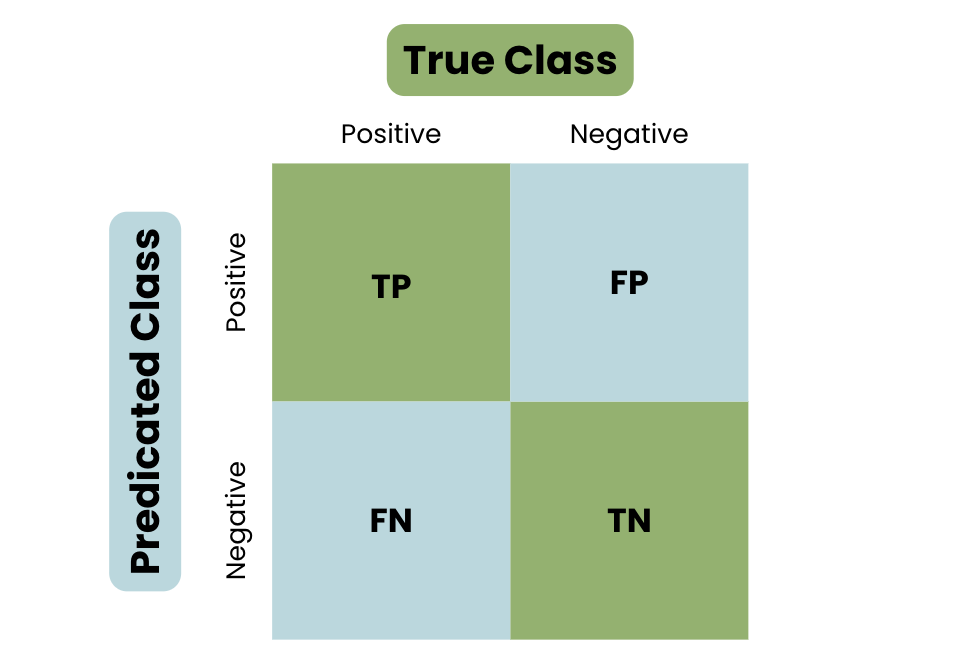
La struttura base di una Confusion Matrix
Per comprendere a fondo la Confusion Matrix, è essenziale conoscere le metriche importanti utilizzate per misurare le prestazioni di un modello.
Definiamo le metriche principali:
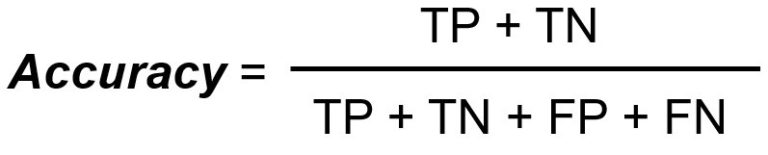
L'accuracy misura il numero totale di classificazioni corrette diviso per il numero totale di casi.
Il recall/sensitivity misura il numero totale di veri positivi diviso per il numero totale di positivi reali.
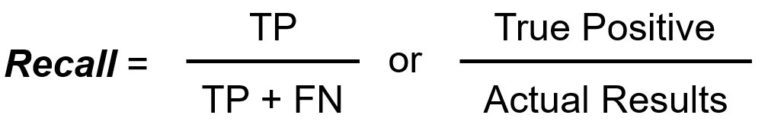
La precision misura il numero totale di veri positivi diviso per il numero totale di positivi previsti.
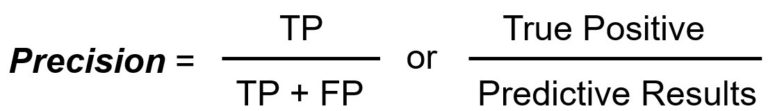
La specificity misura il numero totale di veri negativi diviso per il numero totale di negativi reali.
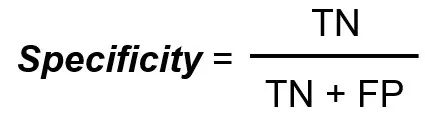
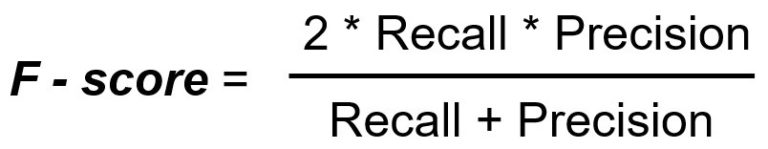
L'F1 Score è una metrica unica che rappresenta la media armonica di precision e recall.
Per comprendere meglio la confusion matrix, devi capirne l'obiettivo e perché è così diffusa.
Quando si tratta di misurare le prestazioni di un modello, o qualsiasi altra cosa in generale, ci si concentra sull'accuracy. Tuttavia, affidarsi pesantemente a questa metrica può portare a decisioni errate. Per capirlo, esamineremo i limiti dell'uso dell'accuracy come metrica a sé stante.
Come definito sopra, l'accuracy misura il numero totale di classificazioni corrette diviso per il numero totale di casi. Tuttavia, usare questa metrica da sola comporta limiti, come ad esempio:
Alla luce di questi limiti, la confusion matrix, insieme alle varie metriche, offre insight più dettagliati su come migliorare le prestazioni di un modello.
Come visto nella struttura base di una confusion matrix, le previsioni sono suddivise in quattro categorie: True Positive, True Negative, False Positive e False Negative.
Questa scomposizione dettagliata offre insight preziosi e soluzioni per migliorare le prestazioni di un modello:
Ora che abbiamo una buona comprensione di una confusion matrix di base, della sua terminologia e del suo utilizzo, passiamo al calcolo manuale di una confusion matrix, seguito da un esempio pratico.
Ecco una guida passo passo su come calcolare manualmente una Confusion Matrix.
Il primo passo è identificare i due possibili esiti del tuo task: Positivo o Negativo.
Una volta definiti i possibili esiti, il passo successivo è raccogliere tutte le previsioni del modello, inclusa la frequenza con cui il modello ha previsto ciascuna classe e la sua occorrenza.
Una volta raccolte tutte le previsioni, il passo successivo è classificare gli esiti nelle quattro categorie:
Una volta classificati gli esiti, il passo successivo è presentarli in una tabella a matrice, da analizzare ulteriormente usando varie metriche.
Vediamo un esempio pratico per illustrare questo processo.
Continuando con lo stesso esempio di identificare un'email come spam o non spam, creiamo un dataset ipotetico in cui spam è Positivo e non spam è Negativo. Abbiamo i seguenti dati:
A questo punto abbiamo definito l'esito e raccolto i dati; il passo successivo è classificare gli esiti nelle quattro categorie:
Il passo successivo è trasformare questo in una Confusion Matrix:
|
Reale / Predetto |
Spam (Positivo) |
Non spam (Negativo) |
|
Spam (Positivo) |
60 (TP) |
20 (FN) |
|
Non spam (Negativo) |
20 (FP) |
100 (TN) |
Quindi, cosa ci dice la Confusion Matrix?
Usando questa confusion matrix, possiamo calcolare diverse metriche: Accuracy, Recall/Sensitivity, Precision, Specificity e F1 Score.
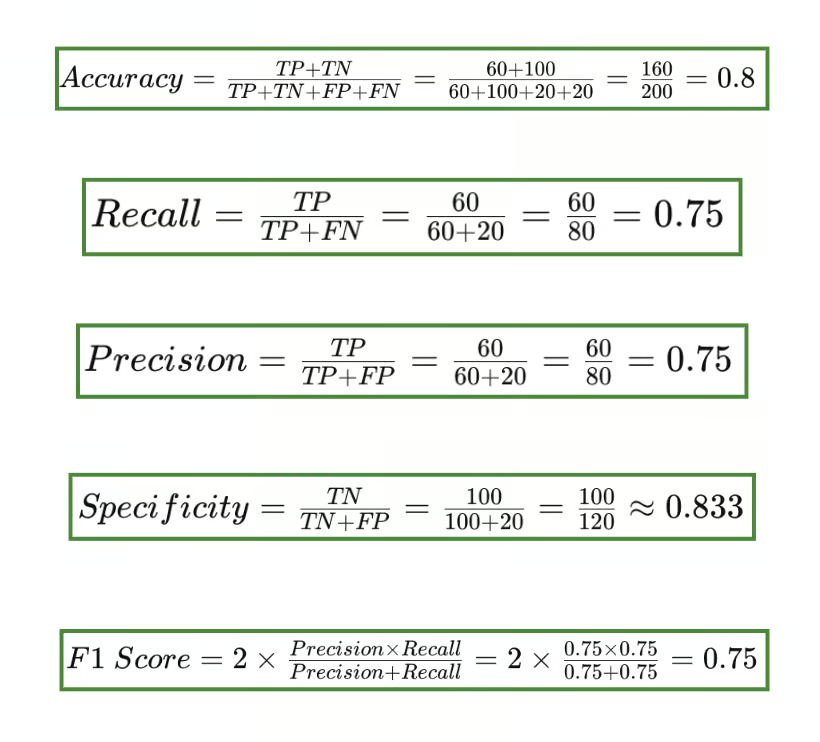
Output delle metriche della confusion matrix
Potresti chiederti perché l'F1 score includa precision e recall nella sua formula. L'F1 score è una metrica cruciale quando si lavora con dati sbilanciati o quando vuoi bilanciare il trade-off tra precision e recall.
La precision misura l'accuratezza delle previsioni positive. Risponde alla domanda: "quando il modello ha previsto TRUE, quanto spesso aveva ragione?". La precision, in particolare, è importante quando il costo di un falso positivo è elevato.
Il recall, o sensitivity, misura il numero di positivi reali identificati correttamente dal modello. Risponde alla domanda: "quando la classe era effettivamente TRUE, quanto spesso il classificatore l'ha azzeccata?".
Il recall è importante quando mancare un'istanza positiva (FN) è significativamente peggio che etichettare in modo errato istanze negative come positive.
Per contestualizzare, creiamo una confusion matrix con Scikit-learn in Python, usando un classificatore Random Forest.
Il primo passo è importare le librerie necessarie e costruire il tuo dataset sintetico.
# Import Libraries
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import confusion_matrix
import matplotlib.pyplot as plt
import seaborn as sns

# Synthetic Dataset
X, y = make_classification(n_samples=1000, n_features=20,
                           n_classes=2, random_state=42)

# Split into Training and Test Sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
Il passo successivo è addestrare il modello usando un semplice classificatore random forest
# Train the Model
model = RandomForestClassifier(random_state=42)
model.fit(X_train, y_train)
Come abbiamo fatto nell'esempio pratico, dobbiamo classificare gli esiti e trasformarli in una confusion matrix. Lo facciamo prima prevedendo sui dati di test e poi generando una Confusion Matrix:
# Predict on the Test Data
y_pred = model.predict(X_test)

# Generate the confusion matrix
cm = confusion_matrix(y_test, y_pred)
Ora vogliamo generare una rappresentazione visiva della confusion matrix:
# Create a Confusion Matrix
plt.figure(figsize=(8, 8))
sns.heatmap(cm, annot=True, fmt='d', cmap='Greens')
plt.title('Confusion Matrix')
plt.ylabel('True label')
plt.xlabel('Predicted label')
plt.show()
Questo è l'output:
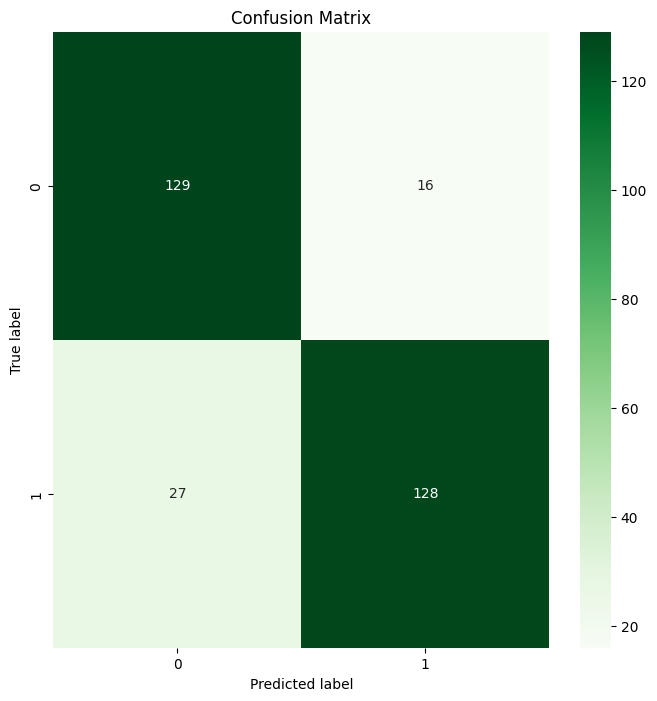
Output della Confusion Matrix con Random Forest
Tada 🎉 Hai creato con successo la tua prima Confusion Matrix usando Scikit-learn!
In questo articolo abbiamo esplorato la definizione di una Confusion Matrix, la terminologia importante che circonda lo strumento di valutazione e i limiti e l'importanza delle diverse metriche. Saper calcolare manualmente una Confusion Matrix è importante per la tua base di conoscenze in data science, così come saperla implementare usando librerie come Scikit-learn.
Se vuoi approfondire ulteriormente la Confusion Matrix, esercitati con le confusion matrix in R con Understanding Confusion Matrix in R. Vai un po' più a fondo con il nostro corso Model Validation in Python, dove imparerai le basi della validazione dei modelli, le tecniche di validazione e inizierai a creare modelli validati e ad alte prestazioni.
Scopri di più sulla Confusion Matrix
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



