Khóa học
Xác thực Mô hình trong Python
4 giờ
31.1K
Năm nay ghi dấu nhiều đổi mới trong khoa học dữ liệu, với trí tuệ nhân tạo và machine learning chiếm sóng tiêu đề. Dù không thể phủ nhận những tiến bộ đạt được trong năm 2023, điều quan trọng là nhận ra rằng nhiều đột phá trong machine learning chỉ khả thi nhờ các quy trình đánh giá đúng đắn mà mô hình trải qua. Các chuyên gia dữ liệu có nhiệm vụ đảm bảo thực hiện các đánh giá và quy trình chính xác để đo lường hiệu suất của mô hình machine learning. Đây không chỉ là hữu ích - mà là bắt buộc.
Nếu bạn muốn nắm vững nghệ thuật khoa học dữ liệu, bài viết này sẽ hướng dẫn bạn qua các bước then chốt của đánh giá mô hình bằng confusion matrix, một công cụ tương đối đơn giản nhưng mạnh mẽ, được sử dụng rộng rãi trong đánh giá mô hình.
Hãy cùng bắt đầu và tìm hiểu sâu hơn về confusion matrix.
Confusion matrix là một công cụ dùng để đánh giá hiệu suất của mô hình và được biểu diễn trực quan dưới dạng bảng. Nó đem lại lớp hiểu biết sâu hơn cho người làm dữ liệu về hiệu suất, lỗi và điểm yếu của mô hình. Nhờ đó, họ có thể tiếp tục phân tích và tinh chỉnh mô hình.
Hãy tìm hiểu cấu trúc cơ bản của một confusion matrix, sử dụng ví dụ phân loại email là spam hay không spam.
Để thực sự nắm bắt khái niệm confusion matrix, hãy xem hình minh họa dưới đây:
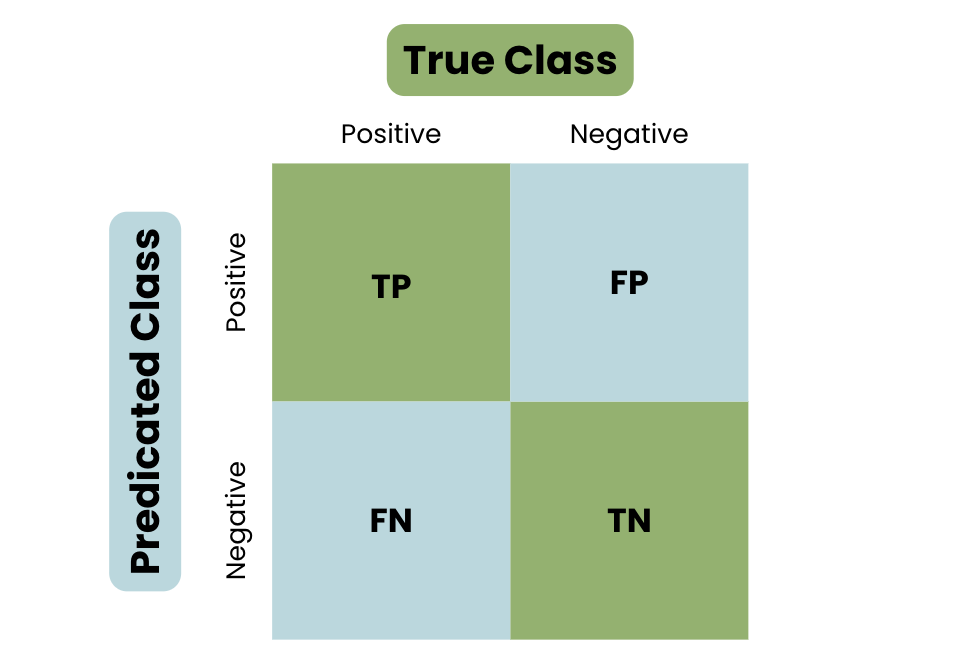
Cấu trúc cơ bản của Confusion Matrix
Để hiểu sâu về Confusion Matrix, bạn cần nắm các chỉ số quan trọng dùng để đo lường hiệu suất mô hình.
Hãy định nghĩa các chỉ số quan trọng:
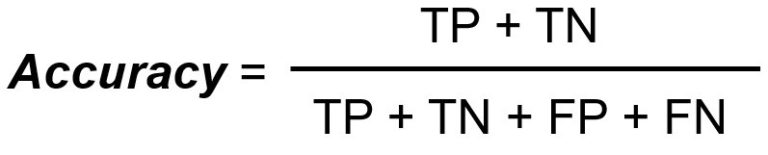
Accuracy đo tổng số phân loại đúng chia cho tổng số trường hợp.
Recall/Sensitivity đo tổng số dương tính thật chia cho tổng số dương tính thực tế.
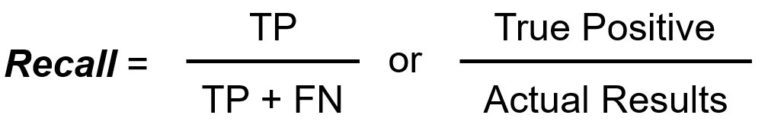
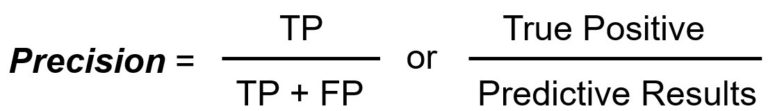
Precision đo tổng số dương tính thật chia cho tổng số dương tính được dự đoán.
Specificity đo tổng số âm tính thật chia cho tổng số âm tính thực tế.
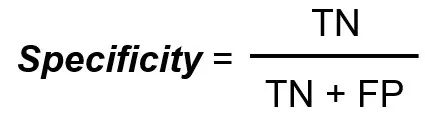
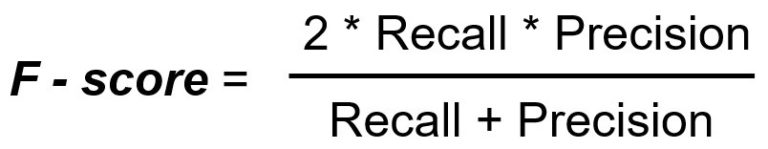
F1 là một chỉ số đơn lẻ là trung bình điều hòa của precision và recall.
Để hiểu rõ hơn về confusion matrix, bạn cần nắm mục tiêu và lý do nó được dùng rộng rãi.
Khi đo lường hiệu suất mô hình hay bất cứ thứ gì nói chung, mọi người thường tập trung vào độ chính xác. Tuy nhiên, phụ thuộc nặng vào chỉ số accuracy có thể dẫn đến quyết định sai. Để hiểu điều này, chúng ta sẽ xem qua những hạn chế của việc dùng accuracy như một chỉ số độc lập.
Như đã định nghĩa ở trên, accuracy đo tổng số phân loại đúng chia cho tổng số trường hợp. Tuy nhiên, dùng chỉ số này một cách độc lập có các hạn chế như:
Trước những hạn chế này, confusion matrix cùng nhiều chỉ số đi kèm mang lại cái nhìn chi tiết hơn về cách cải thiện hiệu suất mô hình.
Như thấy trong cấu trúc cơ bản của confusion matrix, các dự đoán được chia thành bốn nhóm: Dương tính thật, Âm tính thật, Dương tính giả và Âm tính giả.
Phân rã chi tiết này mang lại những hiểu biết và giải pháp giá trị để cải thiện hiệu suất mô hình:
Giờ đây khi đã hiểu tốt về confusion matrix cơ bản, thuật ngữ và cách dùng của nó, hãy chuyển sang tính toán thủ công confusion matrix, sau đó là một ví dụ thực tế.
Dưới đây là hướng dẫn từng bước để tính thủ công một Confusion Matrix.
Bước đầu tiên là xác định hai kết quả có thể của tác vụ: Dương tính hoặc Âm tính.
Sau khi xác định các kết quả có thể, bước tiếp theo là thu thập tất cả dự đoán của mô hình, bao gồm số lần mô hình dự đoán mỗi lớp và tần suất xảy ra.
Sau khi đã tổng hợp tất cả dự đoán, bước tiếp theo là phân loại kết quả vào bốn nhóm:
Khi đã phân loại kết quả, bước kế là trình bày chúng trong một bảng ma trận để tiếp tục phân tích bằng nhiều chỉ số.
Hãy đi qua một ví dụ thực tế để minh họa quy trình này.
Tiếp tục với ví dụ phân loại email là spam hay không spam, hãy tạo một bộ dữ liệu giả định trong đó spam là Dương tính và không spam là Âm tính. Chúng ta có dữ liệu sau:
Tại thời điểm này, chúng ta đã xác định kết quả và thu thập dữ liệu; bước tiếp theo là phân loại kết quả vào bốn nhóm:
Bước tiếp theo là chuyển điều này thành một Confusion Matrix:
|
Thực tế / Dự đoán |
Spam (Dương tính) |
Không spam (Âm tính) |
|
Spam (Dương tính) |
60 (TP) |
20 (FN) |
|
Không spam (Âm tính) |
20 (FP) |
100 (TN) |
Vậy Confusion Matrix cho chúng ta biết điều gì?
Dựa trên confusion matrix này, chúng ta có thể tính các chỉ số khác nhau: Accuracy, Recall/Sensitivity, Precision, Specificity và F1.
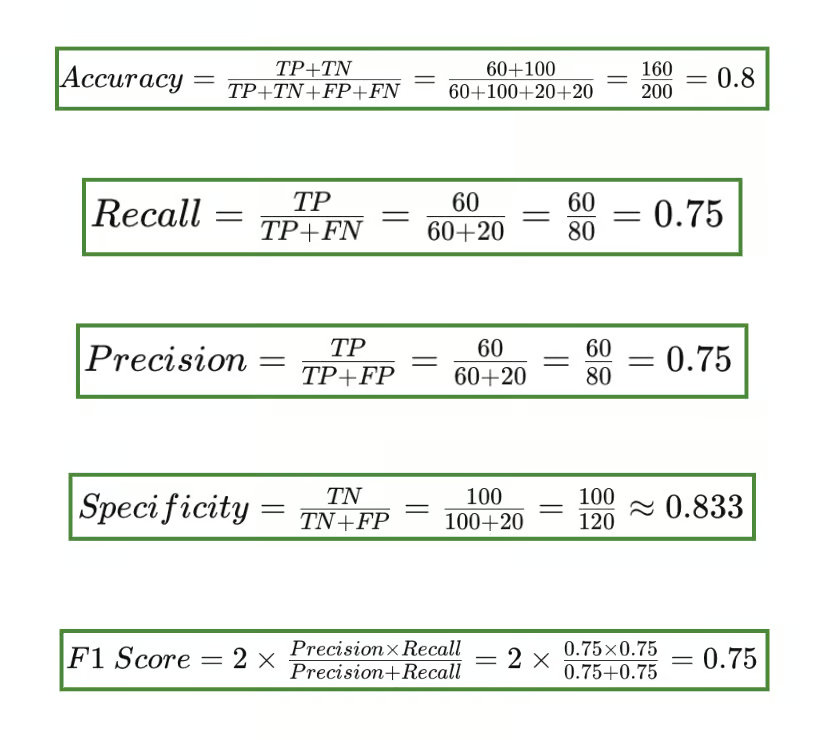
Đầu ra các chỉ số của confusion matrix
Bạn có thể thắc mắc tại sao điểm F1 lại bao gồm precision và recall trong công thức. Chỉ số F1 rất quan trọng khi xử lý dữ liệu lệch lớp hoặc khi bạn muốn cân bằng đánh đổi giữa precision và recall.
Precision đo độ chính xác của dự đoán dương tính. Nó trả lời câu hỏi: ‘khi mô hình dự đoán TRUE, nó đúng bao nhiêu lần?’. Precision đặc biệt quan trọng khi chi phí của dương tính giả cao.
Recall hay độ nhạy đo số dương tính thực tế được mô hình nhận diện đúng. Nó trả lời câu hỏi: ‘Khi lớp thực sự TRUE, bộ phân loại đúng bao nhiêu lần?’.
Recall quan trọng khi bỏ sót một trường hợp dương tính (FN) tệ hơn đáng kể so với gán nhầm trường hợp âm tính thành dương tính.
Để cụ thể hóa, hãy tạo một confusion matrix bằng Scikit-learn trong Python, sử dụng bộ phân loại Random Forest.
Bước đầu tiên là import các thư viện cần thiết và xây dựng bộ dữ liệu tổng hợp.
# Import Libraries
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import confusion_matrix
import matplotlib.pyplot as plt
import seaborn as sns

# Synthetic Dataset
X, y = make_classification(n_samples=1000, n_features=20,
                           n_classes=2, random_state=42)

# Split into Training and Test Sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
Bước tiếp theo là huấn luyện mô hình bằng một bộ phân loại random forest đơn giản
# Train the Model
model = RandomForestClassifier(random_state=42)
model.fit(X_train, y_train)
Như trong ví dụ thực tế, chúng ta sẽ cần phân loại các kết quả và chuyển chúng thành confusion matrix. Ta làm điều này bằng cách dự đoán trên dữ liệu kiểm tra trước rồi tạo Confusion Matrix:
# Predict on the Test Data
y_pred = model.predict(X_test)

# Generate the confusion matrix
cm = confusion_matrix(y_test, y_pred)
Giờ chúng ta muốn tạo biểu diễn trực quan của confusion matrix:
# Create a Confusion Matrix
plt.figure(figsize=(8, 8))
sns.heatmap(cm, annot=True, fmt='d', cmap='Greens')
plt.title('Confusion Matrix')
plt.ylabel('True label')
plt.xlabel('Predicted label')
plt.show()
Đây là đầu ra:
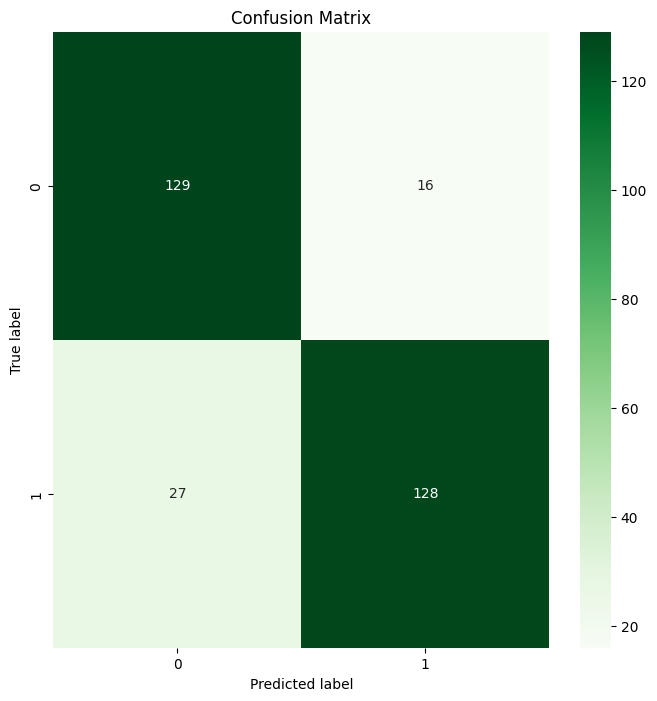
Đầu ra Confusion Matrix của Random Forest
Tada 🎉 Bạn đã tạo thành công Confusion Matrix đầu tiên bằng Scikit-learn!
Trong bài viết này, chúng ta đã tìm hiểu định nghĩa về Confusion Matrix, các thuật ngữ quan trọng xung quanh công cụ đánh giá này, cùng các hạn chế và tầm quan trọng của các chỉ số khác nhau. Khả năng tự tính toán Confusion Matrix là quan trọng cho nền tảng kiến thức khoa học dữ liệu của bạn, cũng như khả năng triển khai bằng các thư viện như Scikit-learn.
Nếu bạn muốn đi sâu hơn vào Confusion Matrix, hãy luyện tập confusion matrices trong R với Hiểu về Confusion Matrix trong R. Khám phá sâu hơn với khóa học Model Validation in Python, nơi bạn sẽ học các kiến thức cơ bản về xác thực mô hình, các kỹ thuật xác thực và bắt đầu tạo ra các mô hình đã được xác thực và có hiệu suất cao.
Tìm hiểu thêm về Confusion Matrix
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
