Kurs
Python'da Model Doğrulama
4 sa
31.3K
Bu yıl, yapay zekâ ve makine öğreniminin manşetlere damga vurduğu veri bilimi alanında yeniliklerle geçti. 2023’te kaydedilen ilerlemeden şüphe yokken, bu makine öğrenimi atılımlarının çoğunun, modellerin tabi tutulduğu doğru değerlendirme süreçleri sayesinde mümkün olduğunu kabul etmek önemlidir. Veri uzmanlarının görevi, bir makine öğrenimi modelinin performansını ölçmek için doğru değerlendirmelerin ve süreçlerin yürütülmesini sağlamaktır. Bu sadece faydalı değil — zorunludur.
Veri biliminin inceliklerini kavramak istiyorsanız, bu makale sizi, model değerlendirmesinde yaygın olarak kullanılan, nispeten basit ama güçlü bir araç olan karışıklık matrisiyle model değerlendirmesinin kritik adımlarında yönlendirecek.
Öyleyse konuya dalalım ve karışıklık matrisi hakkında daha fazlasını öğrenelim.
Karışıklık matrisi, bir modelin performansını değerlendirmek için kullanılan ve görsel olarak bir tabloyla temsil edilen bir araçtır. Modelin performansı, hataları ve zayıflıkları hakkında veri uzmanlarına daha derin bir içgörü sağlar. Bu da, modelin ince ayarla daha ileri analizine olanak tanır.
Bir e-postayı spam ya da spam değil olarak tanımlama örneğini kullanarak, karışıklık matrisinin temel yapısını öğrenelim.
Karışıklık matrisinin mantığını gerçekten kavramak için aşağıdaki görselleştirmeye bakın:
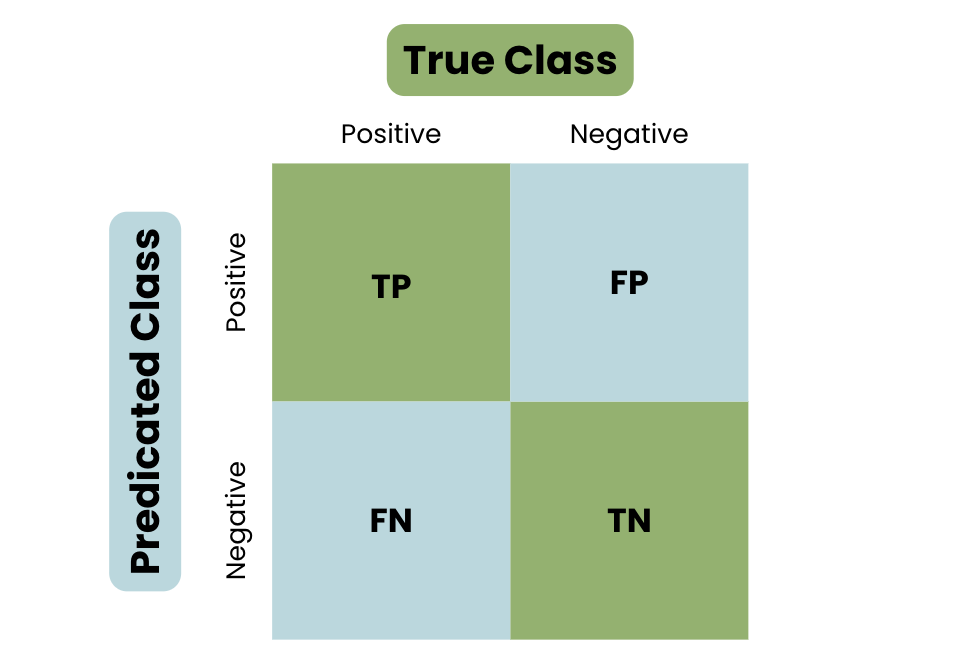
Karışıklık Matrisinin Temel Yapısı
Karışıklık Matrisini derinlemesine anlamak için, bir modelin performansını ölçmekte kullanılan önemli metrikleri bilmek gerekir.
Önemli metrikleri tanımlayalım:
Doğruluk, toplam doğru sınıflandırma sayısının toplam vaka sayısına oranıdır.
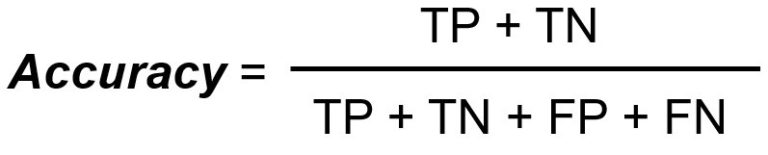
Duyarlılık/Hatırlama, doğru pozitiflerin toplamının, gerçek pozitiflerin toplamına oranıdır.
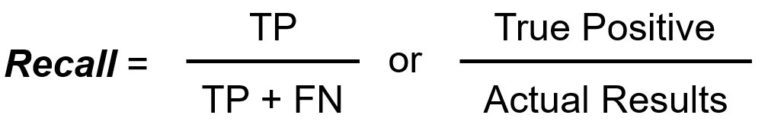
Kesinlik, doğru pozitiflerin toplamının, tahmin edilen pozitiflerin toplamına oranıdır.
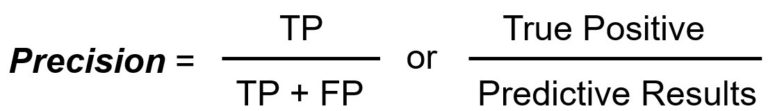
Özgüllük, doğru negatiflerin toplamının, gerçek negatiflerin toplamına oranıdır.
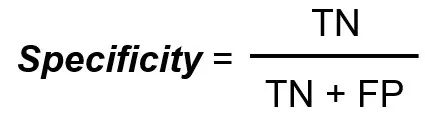
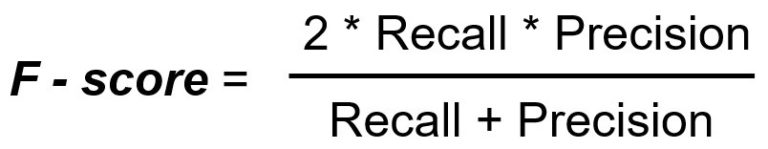
F1 Skoru, kesinlik ve duyarlılığın harmonik ortalamasını alan tek bir metriktir.
Karışıklık matrisini daha iyi kavramak için, amacını ve neden yaygın olarak kullanıldığını anlamalısınız.
Bir modelin performansını ya da genel olarak herhangi bir şeyi ölçerken insanlar çoğunlukla doğruluğa odaklanır. Ancak doğruluk metriğine aşırı derecede bel bağlamak yanlış kararlara yol açabilir. Bunu anlamak için, doğruluğu tek başına bir metrik olarak kullanmanın sınırlamalarını ele alacağız.
Yukarıda tanımlandığı gibi, doğruluk toplam doğru sınıflandırma sayısının toplam vaka sayısına oranıdır. Ancak bu metriği tek başına kullanmanın aşağıdakiler gibi sınırlamaları vardır:
Bu sınırlamalar karşısında, karışıklık matrisi ve çeşitli metrikler, bir modelin performansını nasıl iyileştireceğinize dair daha ayrıntılı içgörüler sunar.
Bir karışıklık matrisinin temel yapısında görüldüğü gibi, tahminler dört kategoriye ayrılır: True Positive, True Negative, False Positive ve False Negative.
Bu ayrıntılı döküm, bir modelin performansını iyileştirmek için değerli içgörüler ve çözümler sunar:
Artık temel bir karışıklık matrisini, terminolojisini ve kullanımını iyi anladığımıza göre, bir karışıklık matrisini elle hesaplamaya ve ardından pratik bir örneğe geçelim.
İşte bir Karışıklık Matrisi’nin nasıl elle hesaplanacağına dair adım adım bir kılavuz.
İlk adım, görevinizin iki olası sonucunu belirlemek olacaktır: Pozitif veya Negatif.
Olası sonuçlar tanımlandıktan sonra, bir sonraki adım modelin tüm tahminlerini toplamak, modelin her sınıfı kaç kez tahmin ettiği ve gerçekleşme sayılarını kaydetmektir.
Tüm tahminler bir araya getirildikten sonra, sonraki adım sonuçları dört kategoriye ayırmaktır:
Sonuçlar sınıflandırıldıktan sonra, bir dizi metrik kullanılarak daha fazla analiz etmek üzere bunları bir matris tablosunda sunmak bir sonraki adımdır.
Bu süreci göstermek için pratik bir örnekten geçelim.
E-postayı spam veya spam değil olarak tanımlama örneğiyle devam ederek, spam’in Pozitif, spam değilin Negatif olduğu varsayımsal bir veri kümesi oluşturalım. Aşağıdaki verilere sahibiz:
Bu noktada, sonucu tanımladık ve verileri topladık; sonraki adım sonuçları dört kategoriye ayırmaktır:
Sıradaki adım bunu bir Karışıklık Matrisi’ne dönüştürmektir:
|
Gerçek / Tahmin |
Spam (Pozitif) |
Spam Değil (Negatif) |
|
Spam (Pozitif) |
60 (TP) |
20 (FN) |
|
Spam Değil (Negatif) |
20 (FP) |
100 (TN) |
Peki Karışıklık Matrisi bize ne söylüyor?
Bu karışıklık matrisini kullanarak Doğruluk, Duyarlılık, Kesinlik, Özgüllük ve F1 Skoru gibi farklı metrikleri hesaplayabiliriz.
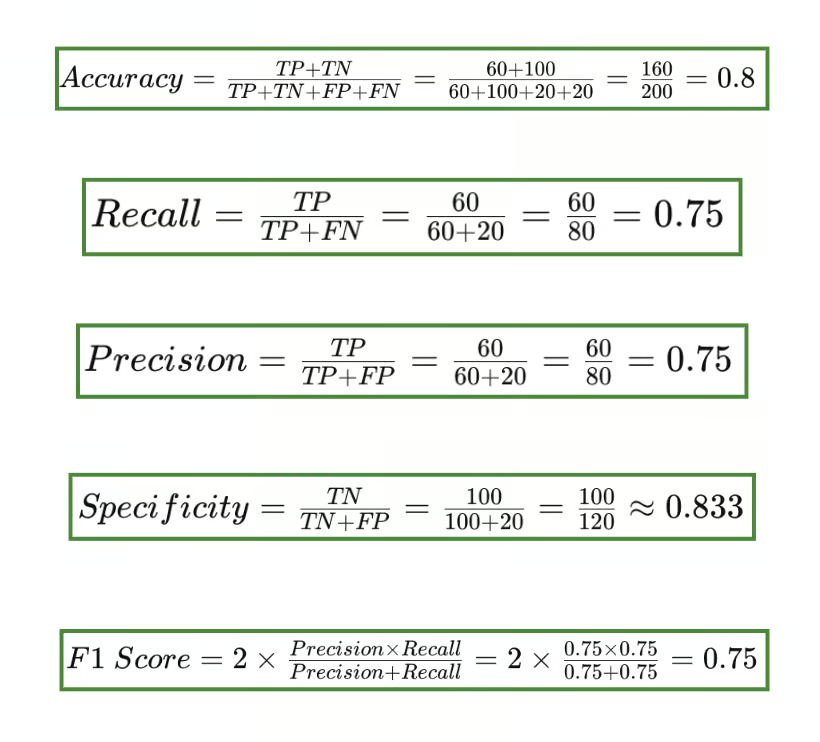
Karışıklık matrisi metrik çıktısı
F1 skorunun formülünde neden kesinlik ve duyarlılığın yer aldığını merak ediyor olabilirsiniz. F1 skoru, dengesiz verilerle çalışırken veya kesinlik ile duyarlılık arasındaki ödünleşimi dengelemek istediğinizde kritik öneme sahiptir.
Kesinlik, pozitif tahminlerin isabetini ölçer. ‘Model TRUE tahmin ettiğinde, ne sıklıkla doğruydu?’ sorusunu yanıtlar. Kesinlik özellikle, yanlış pozitifin maliyetinin yüksek olduğu durumlarda önemlidir.
Duyarlılık ya da hassasiyet, model tarafından doğru tanımlanan gerçek pozitiflerin sayısını ölçer. ‘Sınıf gerçekte TRUE olduğunda, sınıflandırıcı bunu ne sıklıkla doğru bildi?’ sorusunu yanıtlar.
Duyarlılık, pozitif bir örneği kaçırmanın (FN) negatif örnekleri hatalı şekilde pozitif etiketlemekten daha kötü olduğu durumlarda önemlidir.
Bunu somutlaştırmak için, Python'da Scikit-learn kullanarak bir Rastgele Orman (Random Forest) sınıflandırıcı ile bir karışıklık matrisi oluşturalım.
İlk adım, gerekli kütüphaneleri içe aktarmak ve sentetik veri kümenizi oluşturmaktır.
# Import Libraries
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import confusion_matrix
import matplotlib.pyplot as plt
import seaborn as sns

# Synthetic Dataset
X, y = make_classification(n_samples=1000, n_features=20,
                           n_classes=2, random_state=42)

# Split into Training and Test Sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
Bir sonraki adım, basit bir random forest sınıflandırıcı kullanarak modeli eğitmektir
# Train the Model
model = RandomForestClassifier(random_state=42)
model.fit(X_train, y_train)
Pratik örnekte yaptığımız gibi, sonuçları sınıflandırmamız ve bunu bir karışıklık matrisine dönüştürmemiz gerekecek. Bunu önce test verileri üzerinde tahmin yaparak ve ardından bir Karışıklık Matrisi üreterek yapıyoruz:
# Predict on the Test Data
y_pred = model.predict(X_test)

# Generate the confusion matrix
cm = confusion_matrix(y_test, y_pred)
Şimdi karışıklık matrisinin görsel bir temsilini üretmek istiyoruz:
# Create a Confusion Matrix
plt.figure(figsize=(8, 8))
sns.heatmap(cm, annot=True, fmt='d', cmap='Greens')
plt.title('Confusion Matrix')
plt.ylabel('True label')
plt.xlabel('Predicted label')
plt.show()
Çıktı şu şekilde:
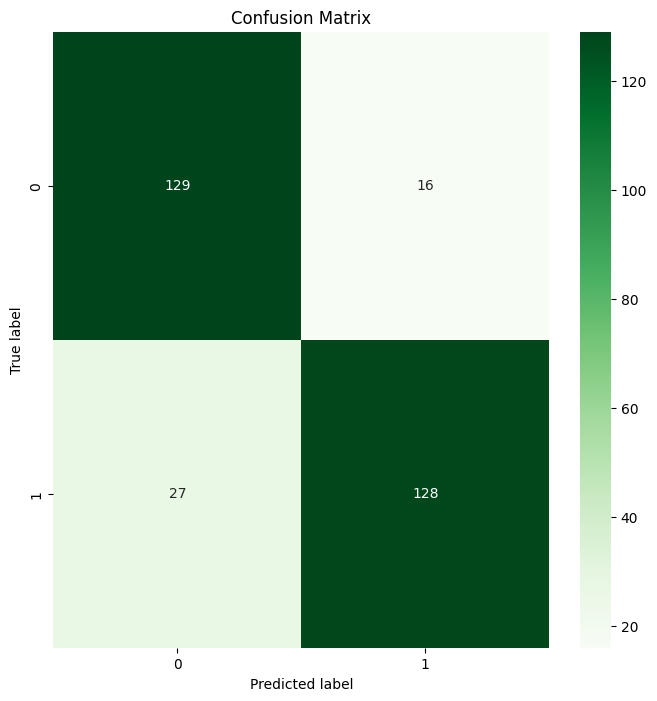
Random Forest Karışıklık Matrisi Çıktısı
Tadaa 🎉 Scikit-learn kullanarak ilk Karışıklık Matrisi'nizi başarıyla oluşturdunuz!
Bu makalede, bir Karışıklık Matrisinin tanımını, değerlendirme aracı etrafındaki önemli terminolojiyi ve farklı metriklerin sınırlamalarını ve önemini ele aldık. Bir Karışıklık Matrisi’ni elle hesaplayabilmek, veri bilimi bilgi birikiminiz için olduğu kadar, Scikit-learn gibi kütüphanelerle uygulayabilmek açısından da önemlidir.
Karışıklık Matrisine daha derinlemesine dalmak isterseniz, R ile karışıklık matrislerini R'de Karışıklık Matrisini Anlamak yazımızla pratik edin. Python'da Model Doğrulama kursumuzla biraz daha derine inin; burada model doğrulamanın temellerini, doğrulama tekniklerini öğrenecek ve doğrulanmış, yüksek performanslı modeller oluşturmaya başlayacaksınız.
Karışıklık Matrisi Hakkında Daha Fazla Bilgi Edinin
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



