
Programma
Elaborazione del linguaggio naturale in Python
20 ore
Nel mondo tech in rapida evoluzione di oggi, l'Intelligenza Artificiale spicca come un ambito cruciale e onnipresente, che si intreccia senza sforzo con le nostre esperienze quotidiane. Al centro di quest’ondata AI c'è il Natural Language Processing, un settore sofisticato che alimenta strumenti conversazionali popolari come ChatGPT e Bard.
E se la maggior parte dei modelli che rendono possibili questi strumenti fosse aperta a tutti e raccolta in un unico posto?
Entra in scena Hugging Face: un game-changer nel machine learning e nel natural language processing, oltre che un attore chiave nella democratizzazione dell'AI. Grazie al transfer learning, sta svolgendo un ruolo cruciale nel rendere l'AI più accessibile.
Ad oggi, vanta la libreria NLP più popolare in Python, con oltre 115k stelle su GitHub, ed è emersa come una delle piattaforme fondamentali per appassionati e professionisti dell'AI per sperimentare, distribuire e scalare i propri modelli.
Che tu sia un professionista dei dati o un principiante curioso, Hugging Face ha gli strumenti e le risorse per dare vita ai tuoi progetti di AI, spingendo sempre più in là i confini di ciò che è possibile con il machine learning.
Quindi, scopriamo cosa ha da offrire Hugging Face!
Puoi anche approfondire l'uso di modelli AI open source con Hugging Face seguendo il nostro code-along.
Per la maggior parte delle persone, Hugging Face potrebbe essere solo un'altra emoji disponibile sulla tastiera del telefono (🤗)
Tuttavia, nella scena tech è il GitHub del mondo ML — una piattaforma collaborativa ricca di strumenti che permettono a chiunque di creare, addestrare e distribuire modelli NLP e ML usando codice open source.
La svolta rivoluzionaria?
Questi modelli arrivano già pre-addestrati, il che semplifica ulteriormente l’ingresso nell’NLP. In poche parole, gli sviluppatori non partono più da zero: ora caricano semplicemente un modello pre-addestrato dall’hub di Hugging Face, lo perfezionano per i propri task specifici e ripartono da lì.
Questa facilità d’uso semplifica notevolmente il processo di sviluppo.
Così Hugging Face diventa un hub in cui data scientist, ricercatori e ML engineer convergono per scambiarsi idee, cercare supporto e contribuire a iniziative open source.
Loro stessi si descrivono così:
“La community di AI che costruisce il futuro.”
Questa visione è proprio uno degli ingredienti segreti del successo di Hugging Face: un approccio guidato dalla community.
Un altro motivo della sua forte crescita è l'intuitività della piattaforma. Un'interfaccia semplice facilita l'avvio — sia per i nuovi arrivati sia per i più esperti.
Con l'obiettivo di ospitare la più grande collezione di risorse NLP e ML, Hugging Face è impegnata a democratizzare l'AI e renderla accessibile a una community globale.
Fondata nel 2016, Hugging Face era un'azienda americano-francese con l'obiettivo di sviluppare un chatbot AI interattivo rivolto agli adolescenti. Tuttavia, dopo aver reso open source il modello che alimentava questo chatbot, ha rapidamente cambiato rotta verso una visione più ampia: fornire all'industria dell'AI strumenti potenti e accessibili.
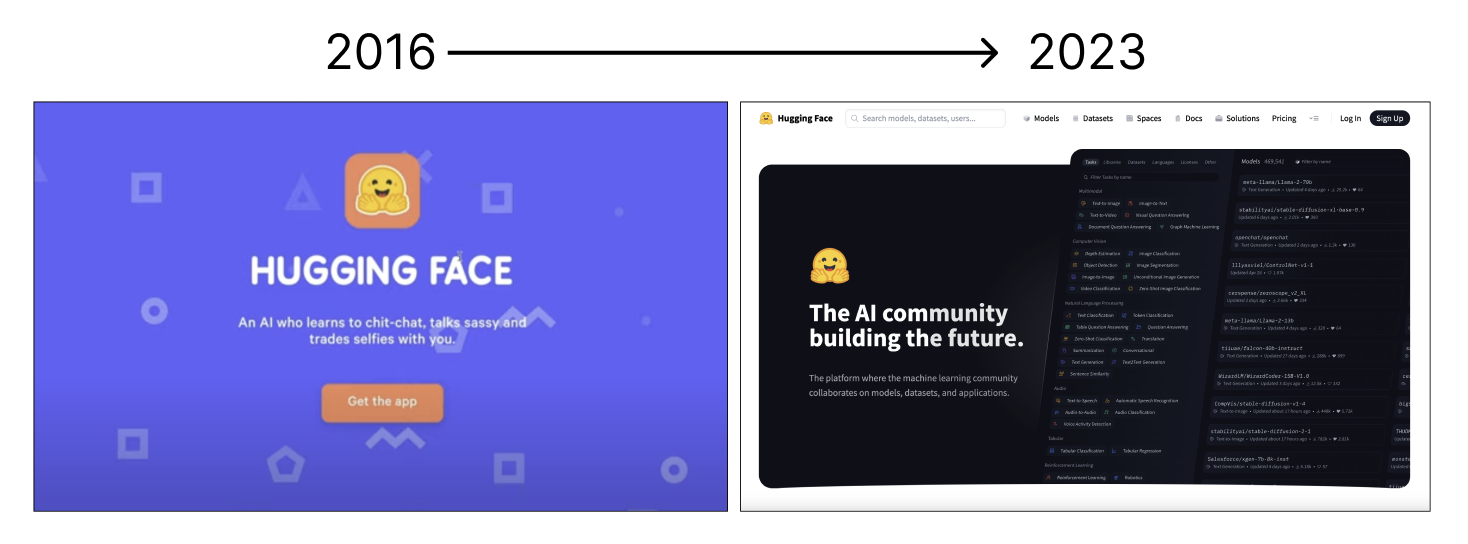
Immagine dell'autore.
Il lancio nel 2018 della libreria Transformers, di natura trasformativa, ha segnato uno dei contributi più grandi e noti alla community AI, offrendo modelli pre-addestrati come BERT e GPT, diventati capisaldi nei task NLP.
Oggi, HuggingFace ha completamente trasformato l'ecosistema ML. Il suo impegno per la collaborazione open source ha catalizzato l'innovazione nell'NLP, consentendo una crescita e uno sviluppo condivisi della tecnologia.
La piattaforma è diventata un punto nevralgico per la condivisione di modelli e dataset, spingendo la ricerca e le applicazioni pratiche nell'AI.
Il loro mantra?
“Democratizzare il buon Machine Learning, un commit alla volta.”
Attraverso partnership strategiche e una dedizione a rendere ampiamente disponibili strumenti NLP avanzati, Hugging Face è diventata parte integrante della community, spingendo continuamente i confini dell'AI e democratizzando l'accesso alle tecnologie più all'avanguardia.
Hugging Face è diventata una pietra miliare dell’NLP moderno grazie alla sua gamma di componenti e funzionalità di base che coprono un’ampia varietà di esigenze di elaborazione del linguaggio.
Vediamoli uno per uno.
La libreria Transformers è una suite completa di modelli di machine learning all'avanguardia, progettati appositamente per l'NLP. Comprende un'ampia raccolta di modelli pre-addestrati ottimizzati per task come classificazione del testo, generazione del linguaggio, traduzione e sintesi, tra gli altri.
Hugging Face ha astratto i task NLP più comuni in un metodo `pipeline()` semplice da usare, un'API intuitiva per eseguire un'ampia varietà di compiti. Queste pipeline consentono di applicare facilmente modelli complessi a problemi reali. Se vuoi scoprire di più su cosa c'è dietro questa libreria, ti consiglio vivamente l'articolo An Introduction to Using Transformers and Hugging Face.
Questi modelli sono facilmente accessibili e personalizzabili, il che è stato rivoluzionario per sviluppatori e ricercatori e ha avuto un ruolo chiave nel rendere più accessibili modelli NLP sofisticati.
La sua importanza risiede nella capacità di astrarre le complessità legate all'addestramento e alla distribuzione di modelli NLP, facilitando l'implementazione di funzionalità avanzate con poco codice.
La libreria consente di sfruttare modelli pre-addestrati senza approfondire gli algoritmi sottostanti.
La libreria Transformers semplifica l'implementazione di modelli NLP in diversi modi chiave:
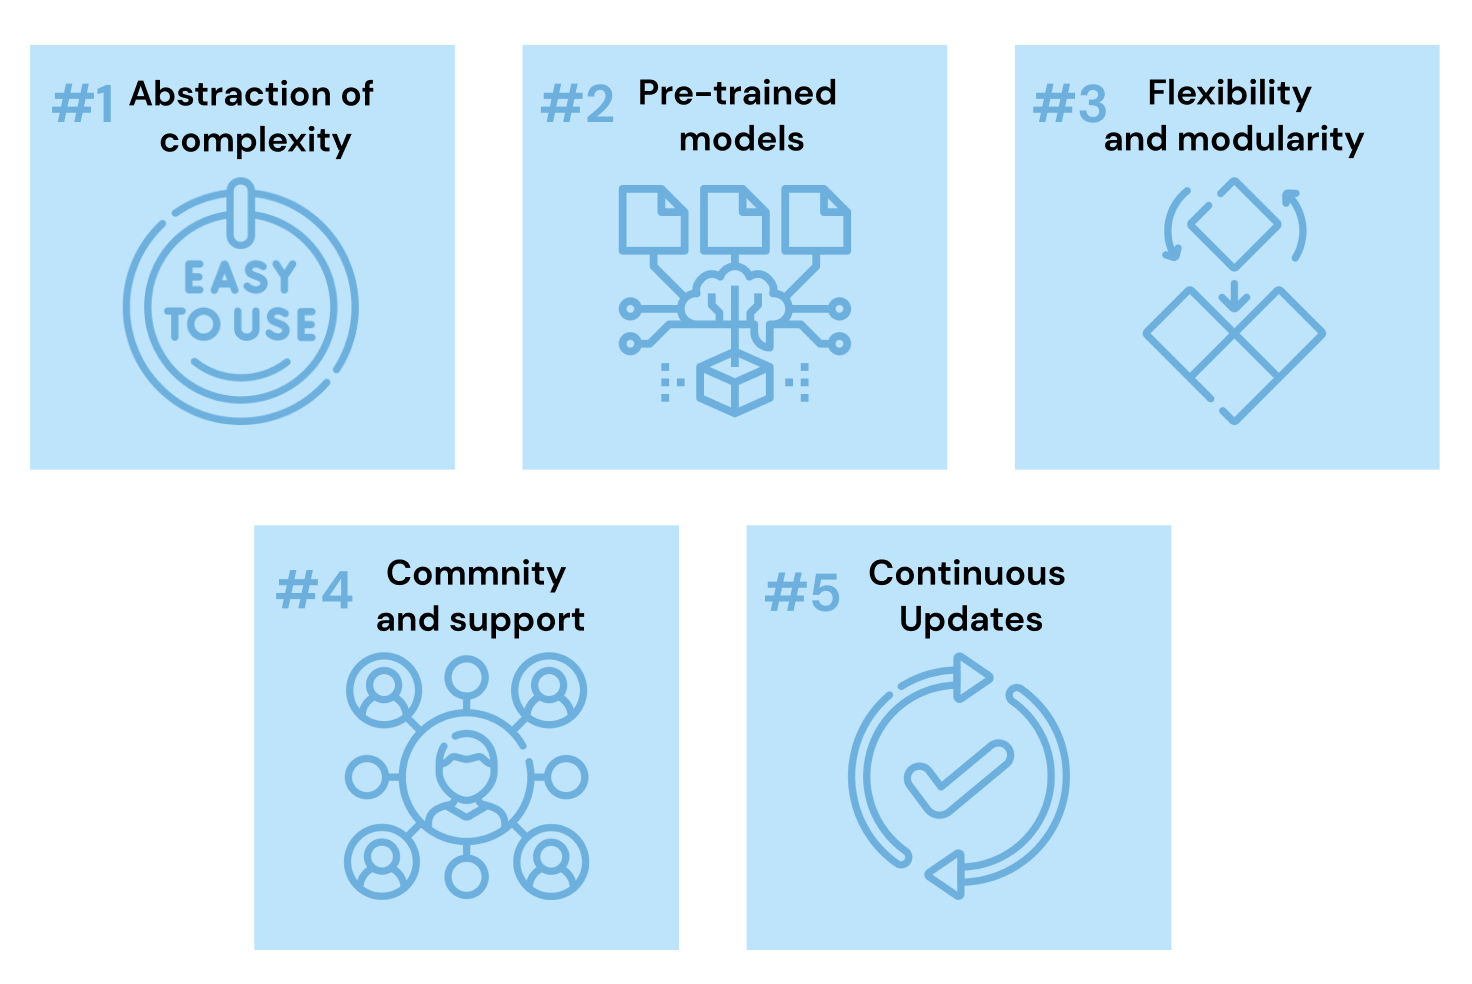
Se vuoi toccare con mano tutto il lavoro che la libreria transformers ci evita, scopri come distribuire un modello NLP con Building a Transformer with PyTorch.
Il Model Hub è il volto della community, una piattaforma in cui migliaia di modelli e dataset sono a portata di mano. È una funzionalità innovativa che consente di condividere e scoprire modelli contribuiti dalla community, promuovendo un approccio collaborativo allo sviluppo NLP.
Puoi dargli un'occhiata sul sito ufficiale. Lì puoi selezionare facilmente il Model Hub cliccando sul pulsante Models nel navigatore, e ti apparirà una vista come la seguente:
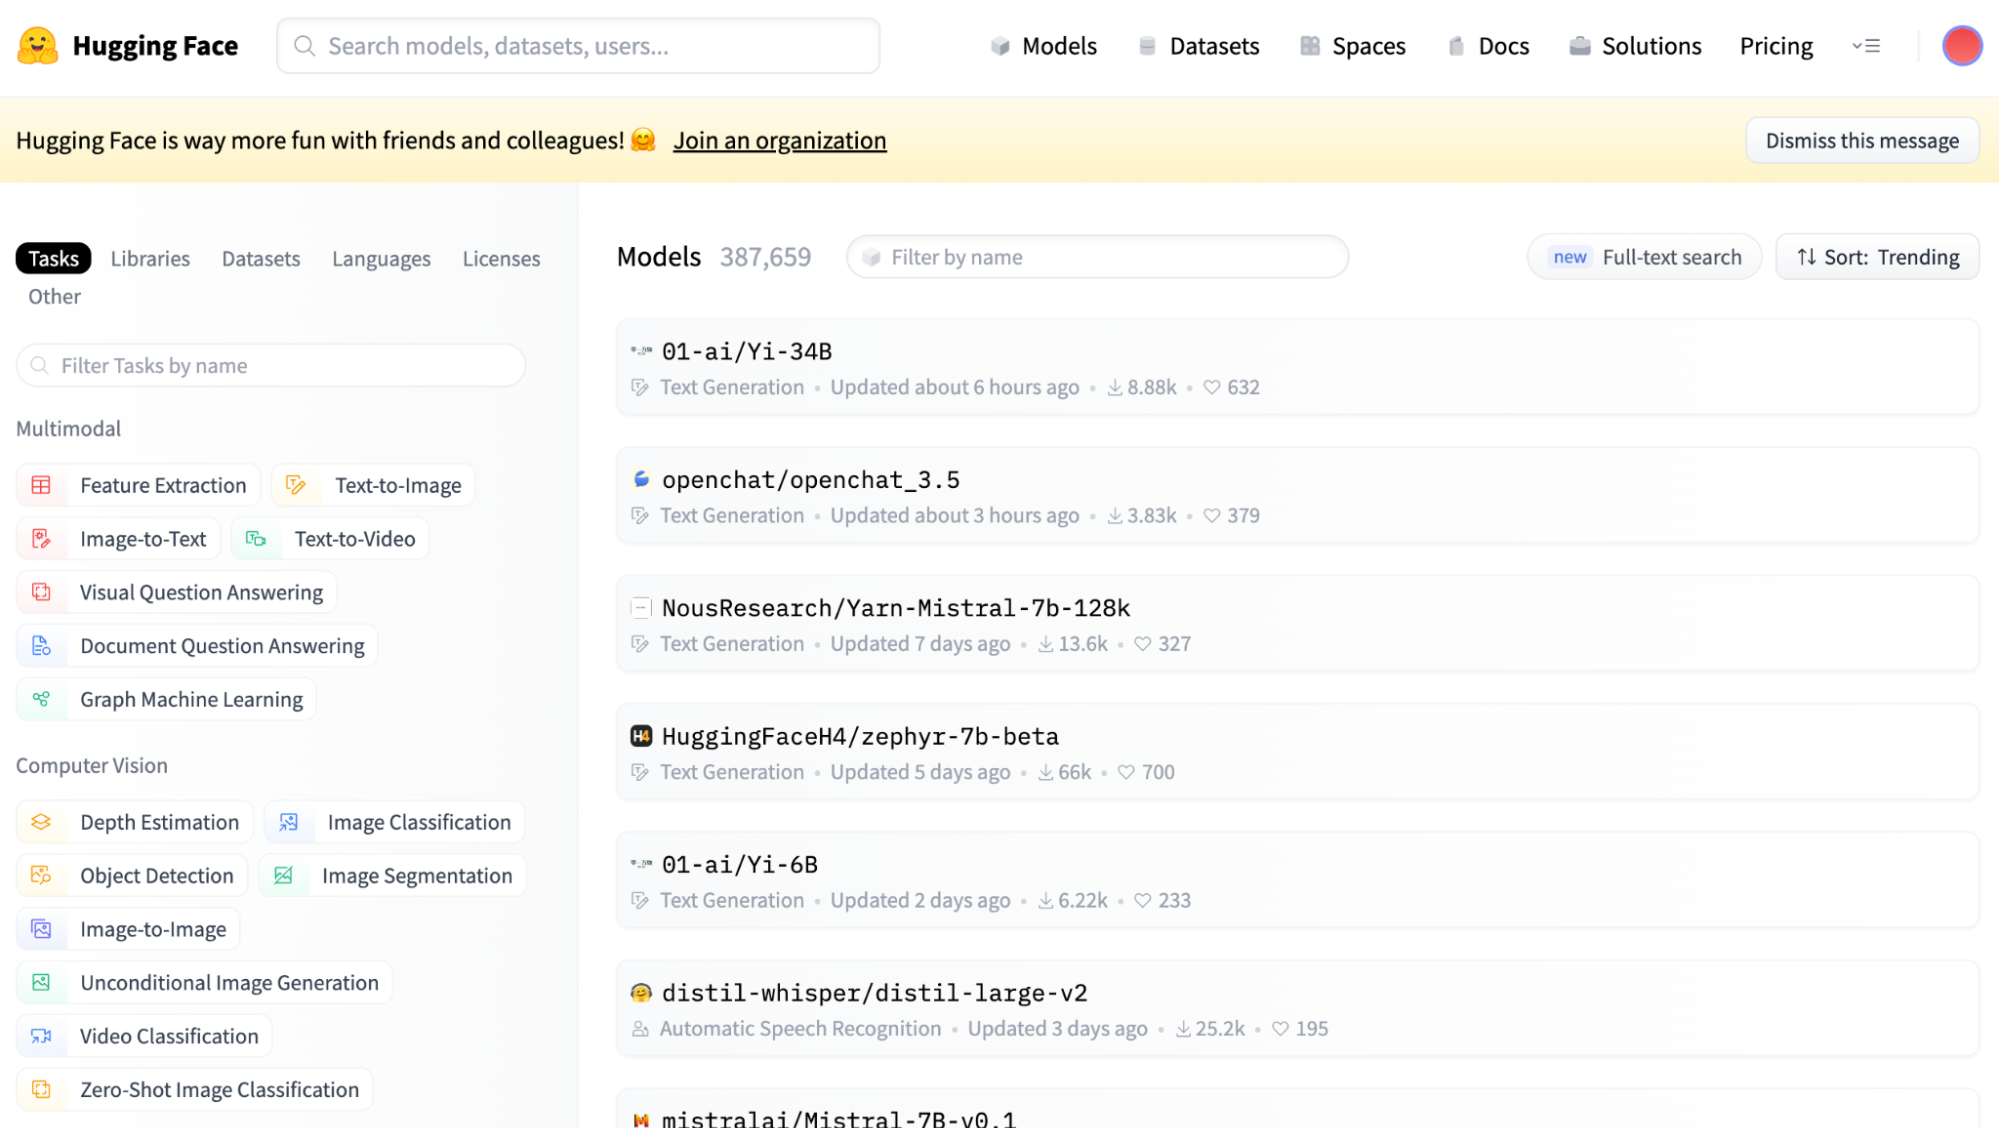
Screenshot della vista principale di Hugging Face Model Hub.
Come puoi vedere, nella sidebar di sinistra ci sono diversi filtri relativi al task principale da eseguire.
Contribuire al Model Hub è reso semplice dagli strumenti di Hugging Face, che guidano l'utente nel processo di caricamento dei modelli. Una volta pubblicati, questi modelli sono disponibili per tutta la community, sia direttamente tramite l'hub sia tramite l'integrazione con la libreria Transformers di Hugging Face.
Questa facilità di accesso e contribuzione alimenta un ecosistema dinamico in cui i modelli all'avanguardia vengono continuamente perfezionati ed estesi, fornendo una base ricca e collaborativa per l'avanzamento dell'NLP.
I tokenizer sono cruciali nell'NLP, perché sono responsabili di convertire il testo in un formato comprensibile dai modelli di machine learning, aspetto essenziale per elaborare lingue e strutture testuali diverse.
Si occupano di suddividere il testo in token — unità di base come parole, subword o caratteri — preparando così i dati per l'elaborazione da parte dei modelli di machine learning. Questi token sono i mattoni che consentono ai modelli di capire e generare linguaggio umano.
Facilitano anche la trasformazione dei token in rappresentazioni vettoriali per l'input del modello e gestiscono padding e troncamento per lunghezze di sequenza uniformi.
Hugging Face fornisce una gamma di tokenizer user-friendly, ottimizzati per la libreria Transformers, fondamentali per un pre-processing del testo senza intoppi. Puoi leggere di più sulla tokenizzazione in un articolo dedicato.
Un altro componente chiave è la libreria Hugging Face Datasets, un vasto repository di dataset NLP che supportano l'addestramento e il benchmarking di modelli ML.
Questa libreria è uno strumento cruciale per gli sviluppatori del settore, poiché offre una collezione diversificata di dataset che possono essere usati per addestrare, testare e valutare modelli NLP in un’ampia gamma di task.
Uno dei principali vantaggi è l'interfaccia semplice e intuitiva. Mentre puoi sfogliare ed esplorare tutti i dataset nell'Hub di Hugging Face, per usarli nel codice c'è una libreria dedicata che consente di scaricare qualsiasi dataset senza sforzo.
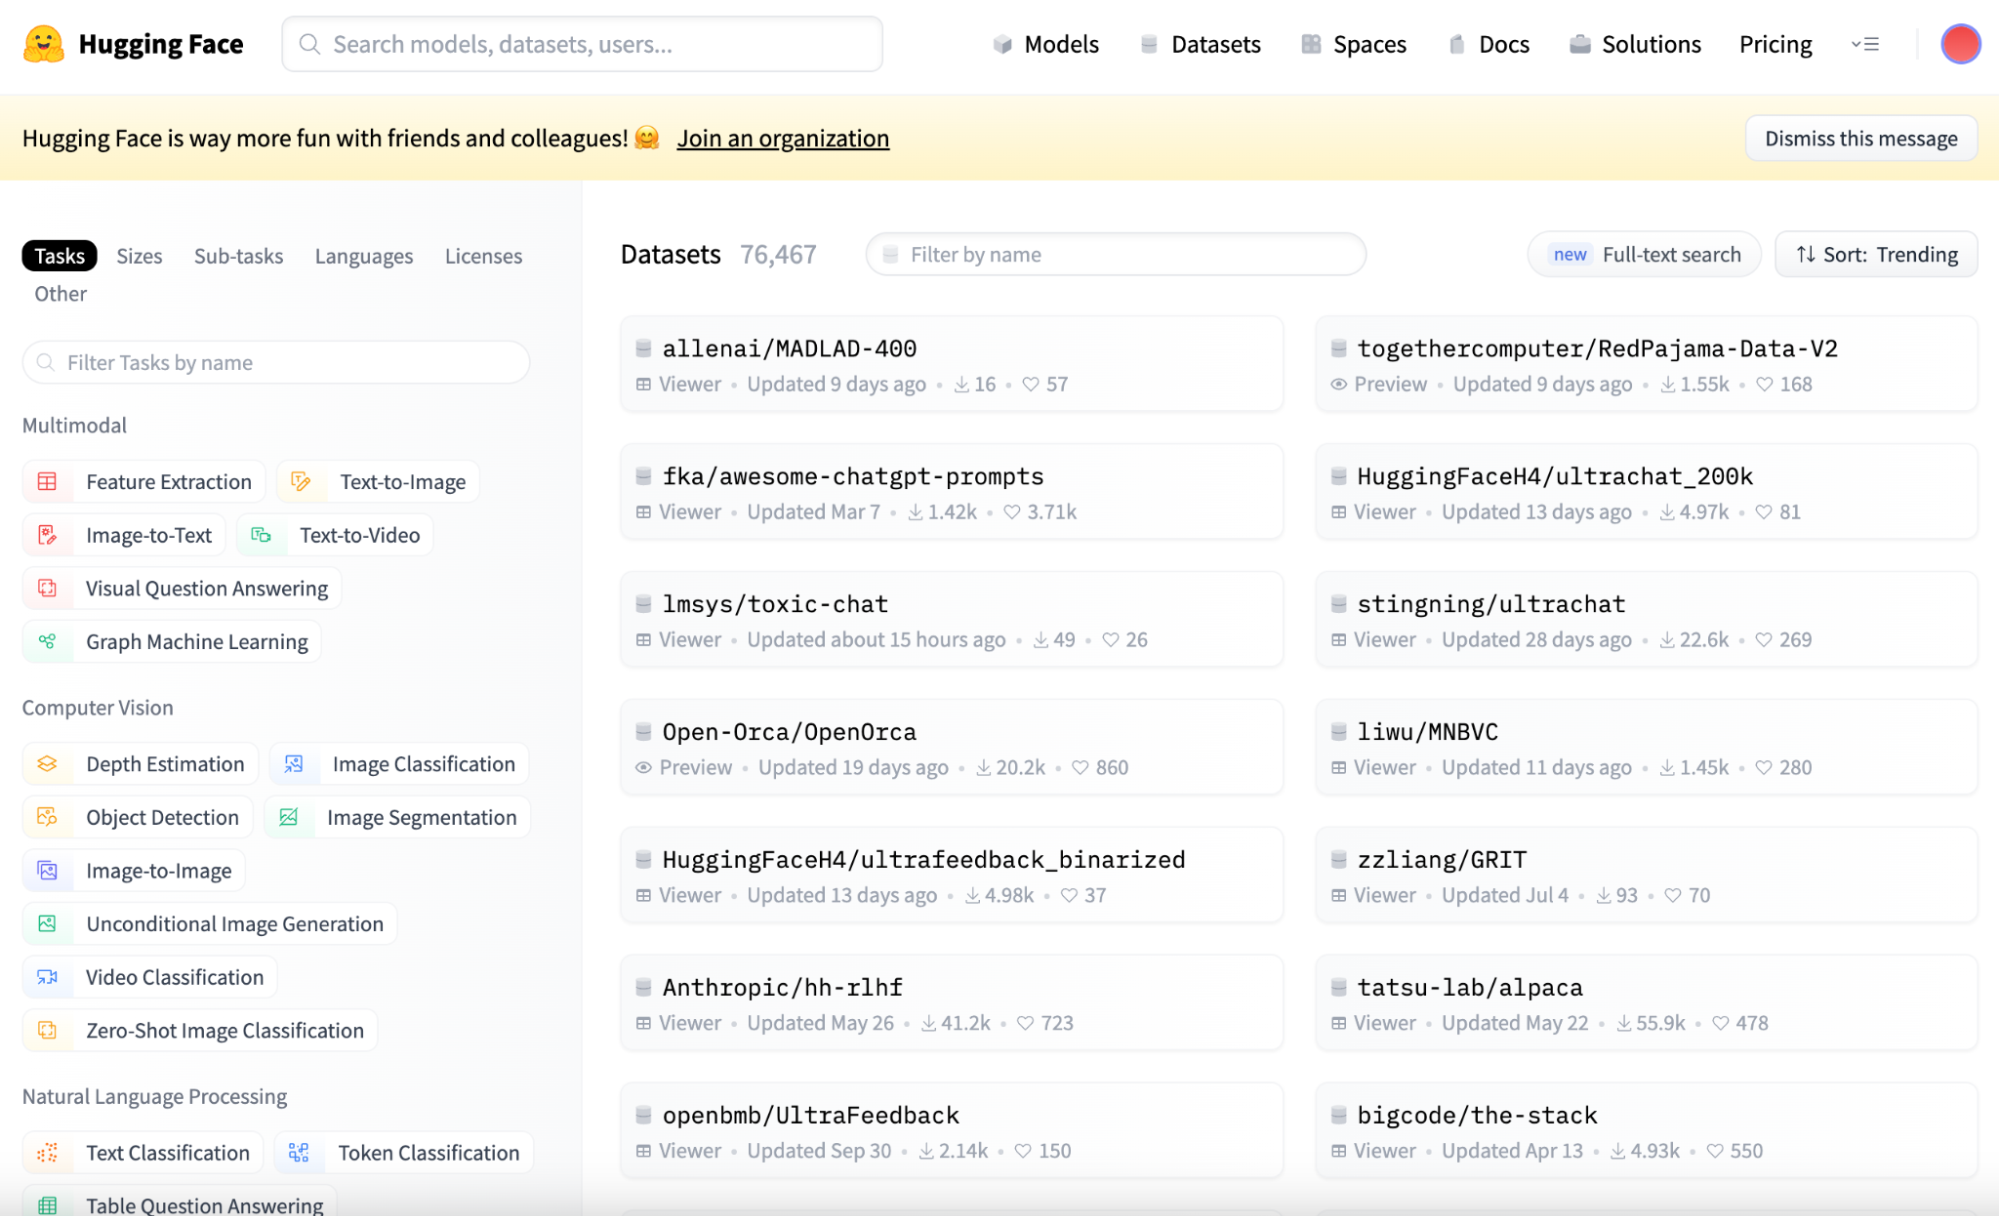
Screenshot della vista principale di Hugging Face Datasets.
Include dataset per task comuni come classificazione del testo, traduzione e question answering, nonché dataset più specializzati per sfide specifiche nel campo.
Ora che siamo allineati e conosciamo i concetti alla base di Hugging Face, proviamo a capire come usare questo piccolo gioiello tecnologico.
Questa guida ti accompagnerà brevemente attraverso le basi per iniziare con Hugging Face, tra cui installazione, uso di modelli pre-addestrati, fine-tuning e condivisione dei tuoi modelli con la community.
Per prima cosa, dovresti combinare la libreria transformers con la tua libreria di deep learning preferita, TensorFlow o PyTorch.
La libreria transformers si installa facilmente con pip, il gestore pacchetti di Python.
pip install transformers
Per avere la piena capacità, dovresti installare anche le librerie datasets e tokenizers.
pip install tokenizers, datasets
Il model hub di Hugging Face offre una vasta collezione di modelli pre-addestrati che puoi usare per un’ampia gamma di task NLP. Scopriamo come usare il nostro primo modello pre-addestrato.
1. Seleziona un modello pre-addestrato: Per prima cosa, devi selezionare un modello pre-addestrato. Per farlo, andiamo al Model Hub.
Immagina di voler inferire il sentiment corrispondente a una stringa di testo. Possiamo filtrare facilmente solo i modelli che eseguono task di `Text Classification` selezionando il pulsante Text Classification nella sidebar sinistra.
I modelli di Hugging Face vengono mostrati in ordine di Trending. Di solito, i risultati più in alto sono i più usati. Quindi, selezioniamo il secondo risultato, che è il modello di sentiment analysis più utilizzato.
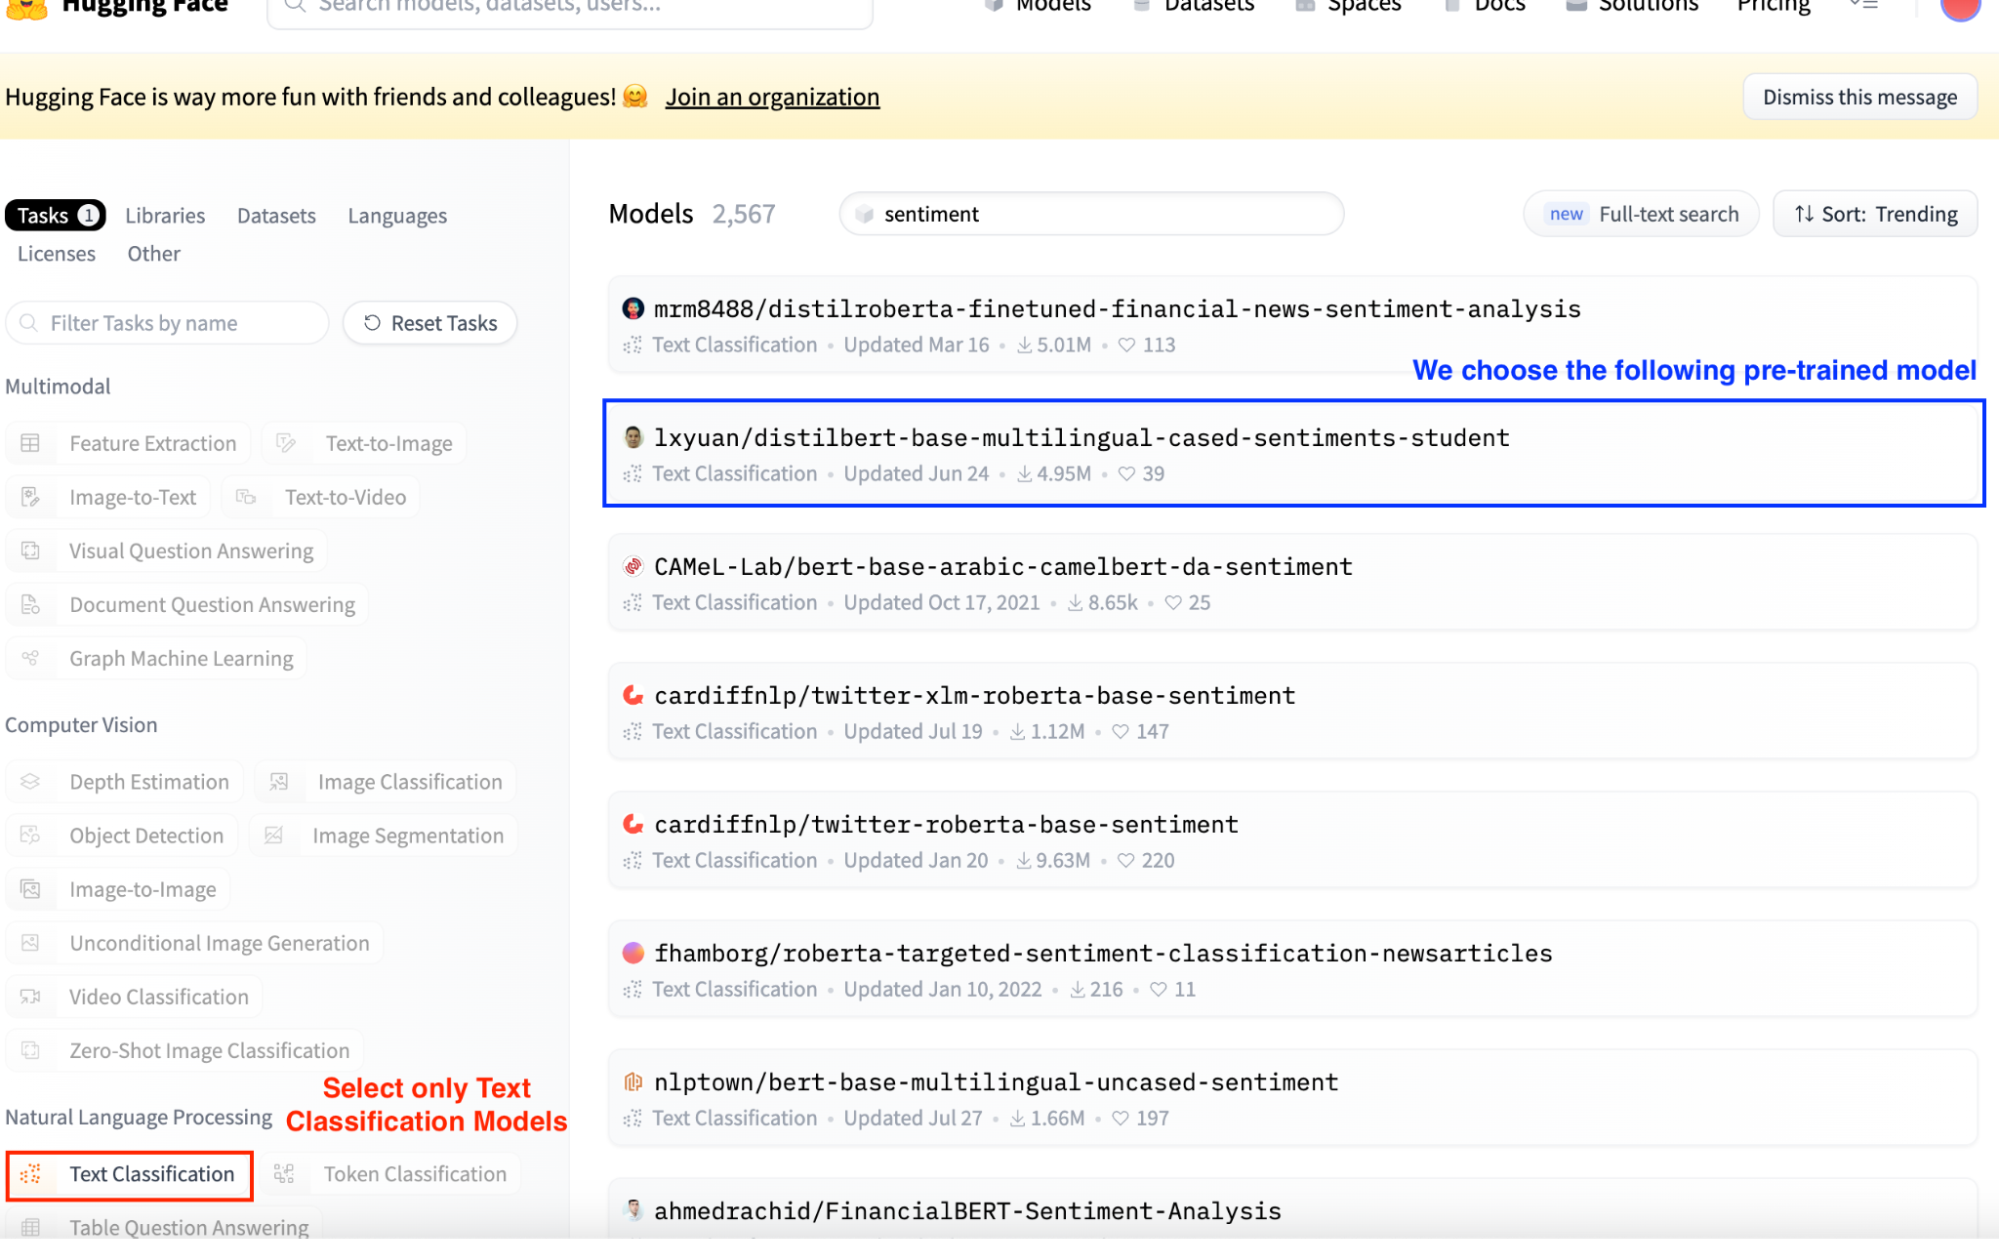
Screenshot della vista principale di Hugging Face Model Hub. Selezione dei modelli di Text Classification.
Per usarlo, dobbiamo copiare il nome corrispondente del modello. Lo trovi nella parte superiore della sua pagina specifica.
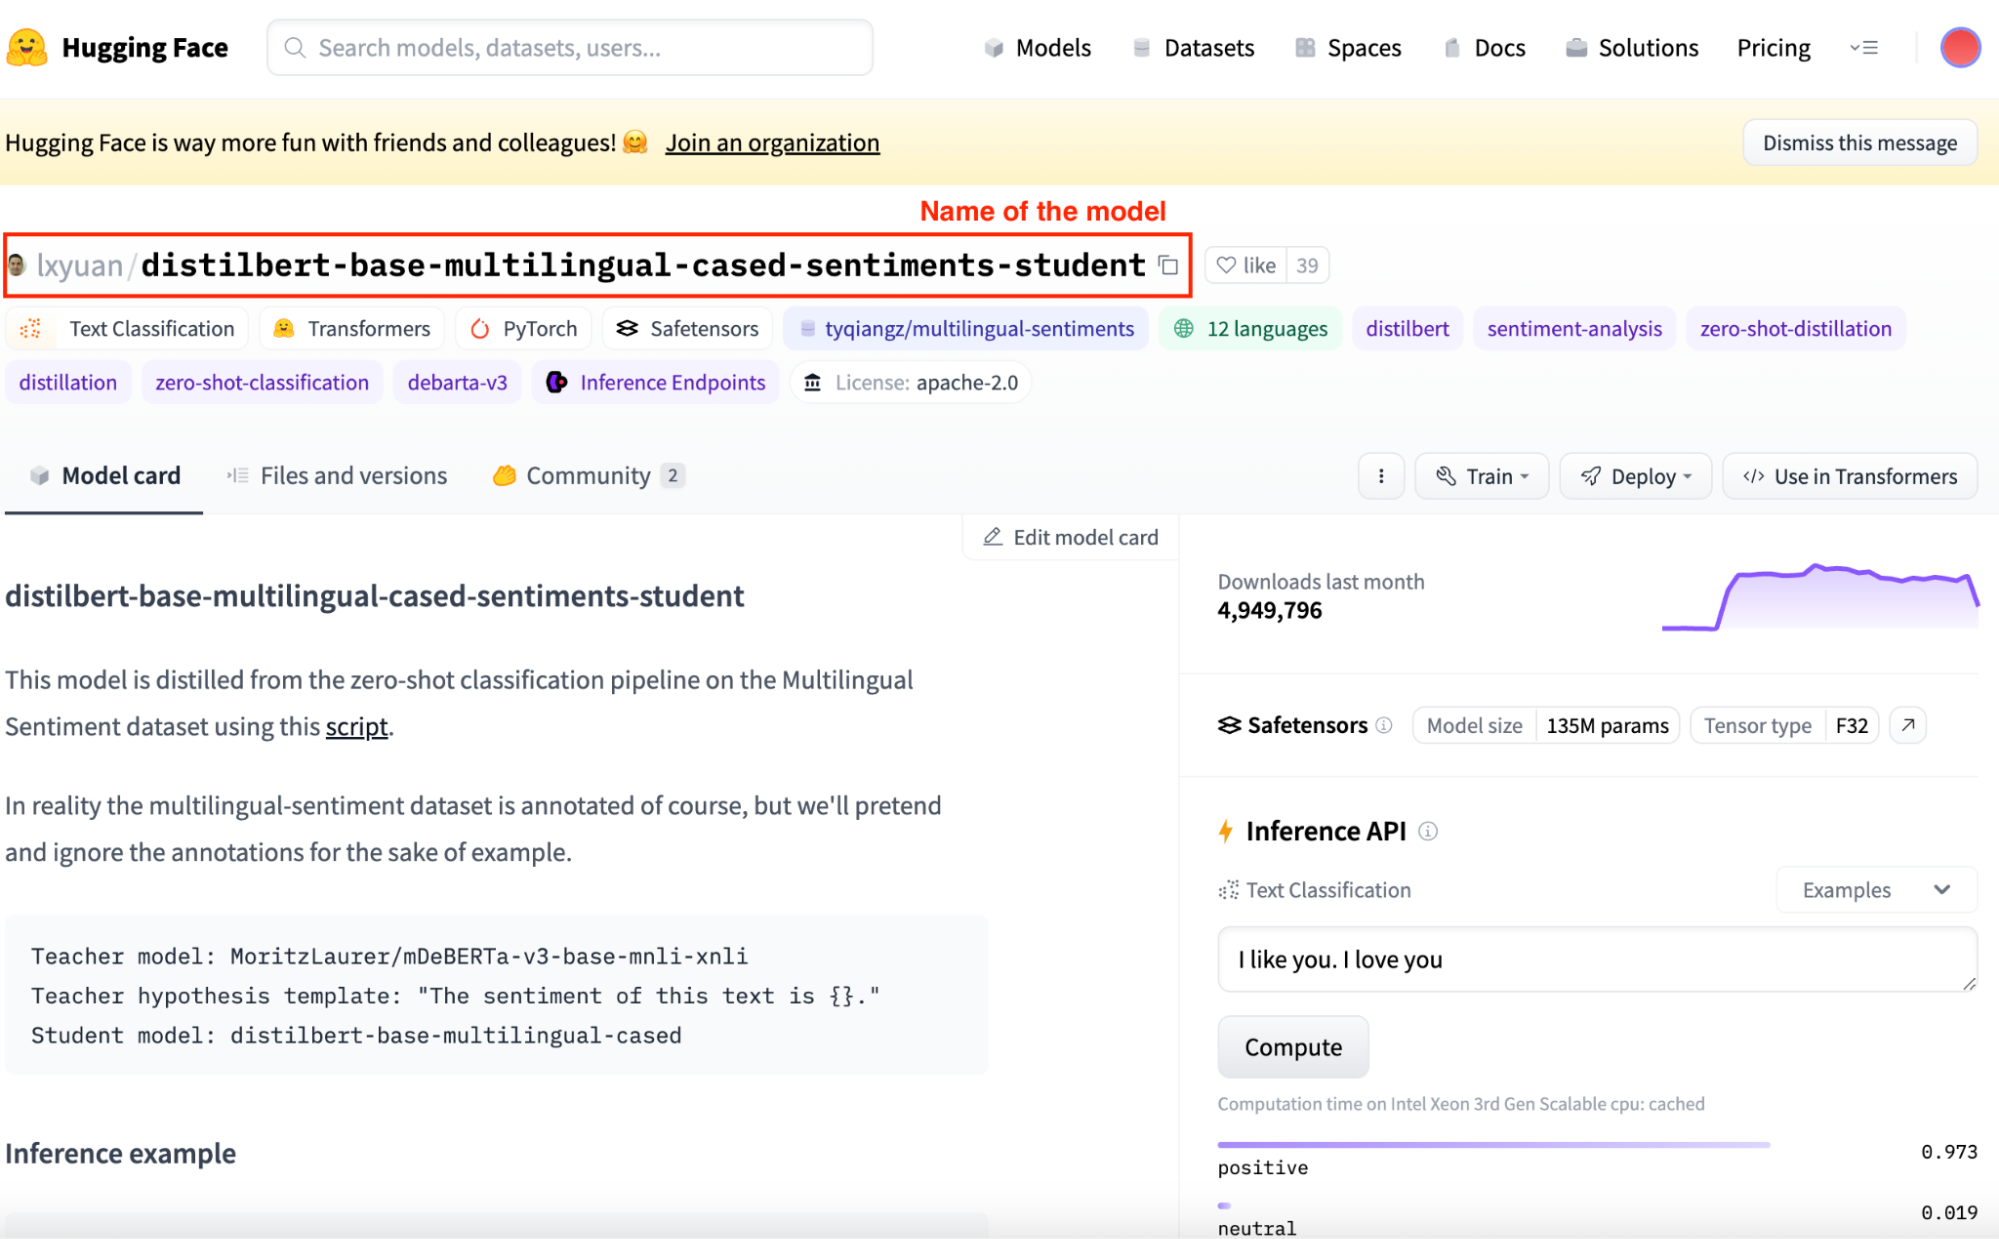
Screenshot della vista del modello specifico su Hugging Face Model Hub.
1. Carica un modello pre-addestrato: Ora che sappiamo quale modello usare, usiamolo in Python. Per prima cosa importiamo le classi AutoTokenizer e AutoModelForSequenceClassification da transformers.
Usando queste classi AutoModel l'architettura del modello verrà inferita automaticamente dal nome del modello.
from transformers import AutoTokenizer, AutoModelForSequenceClassification

model_name = "lxyuan/distilbert-base-multilingual-cased-sentiments-student"

# We call define a model object
model = AutoModelForSequenceClassification.from_pretrained(model_name)
2. Prepara l'input: Carica un tokenizer per il nostro modello; in questo caso la libreria transformers facilita il processo, perché deduce il tokenizer da usare a partire dal nome del modello che abbiamo scelto.
#We call the tokenizer class
tokenizer = AutoTokenizer.from_pretrained(model_name)
3. Esegui il modello: Genera un oggetto pipeline con il modello scelto, il tokenizer e il task da eseguire. Nel nostro caso, una sentiment analysis. Se inizializzi l'oggetto classifier con il task, la classe pipeline lo popolerà con i valori di default, anche se non è consigliato in produzione.
# Initializing a classifier with a model and a tokenizer
classifier = pipeline("sentiment-analysis", model = model, tokenizer = tokenizer)
# When passing only the task, the pipeline command inferes both the model and tokenizer.
classifier = pipeline("sentiment-analysis")
Possiamo eseguire questo modello fornendo un input.
output = classifier("I've been waiting for this tutorial all my life!")
4. Interpreta gli output: Il modello restituirà un oggetto contenente vari elementi a seconda della classe del modello. Per esempio, in questo caso di sentiment analysis, otterremo:
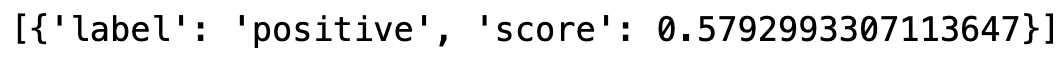
Output ottenuto.
Il fine-tuning è il processo di prendere un modello pre-addestrato e aggiornarne i parametri addestrandolo su un dataset specifico per il tuo task. Ciò consente di sfruttare le rappresentazioni già apprese dal modello e adattarle al tuo caso d'uso.
Immagina di dover usare un modello di classificazione del testo per inferire il sentiment da una lista di tweet. Una domanda naturale è: questo modello pre-addestrato funzionerà a dovere?
Per assicurarci che lo faccia, possiamo sfruttare il fine-tuning addestrando un modello di Hugging Face su un dataset contenente tweet e relativi sentiment, in modo da migliorarne le prestazioni.
Ecco un esempio di base di fine-tuning per la classificazione di sequenze:
1. Scegli un modello pre-addestrato e un dataset: Seleziona un'architettura adatta al tuo task. In questo caso, vogliamo continuare a usare lo stesso modello di sentiment analysis. Ora, però, ci servono dei dati per addestrarlo.
Ed è proprio qui che entra in gioco la libreria datasets. Possiamo andare a cercare i dataset nell'Hub e trovare quello che ci si adatta meglio.
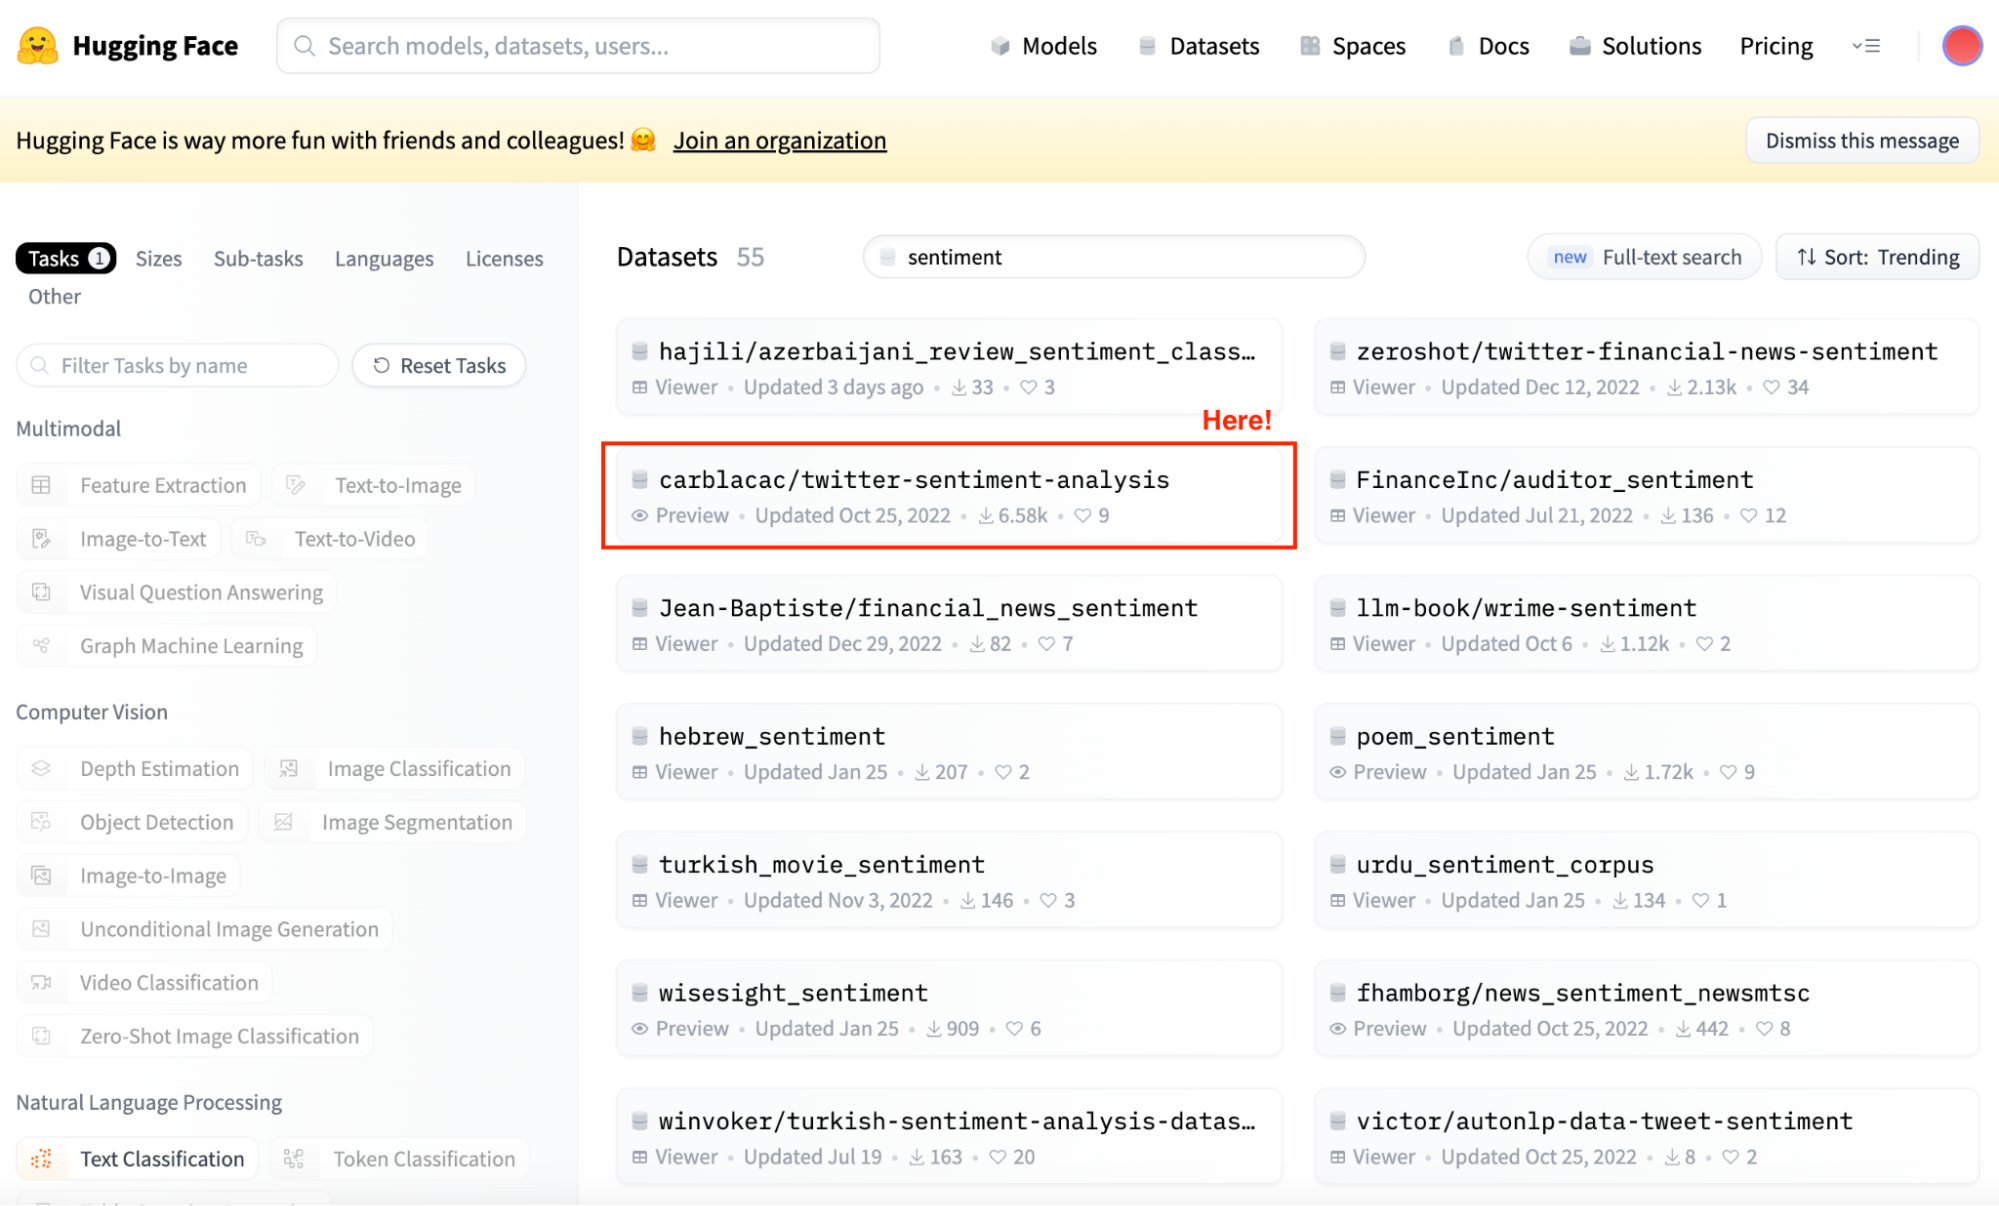
Screenshot della vista principale di Hugging Face Datasets Hub. Selezione dei dataset di Sentiment analysis.
Ora che sappiamo già quale dataset scegliere, possiamo semplicemente inizializzare sia il modello sia il dataset.
model = AutoModelForSequenceClassification.from_pretrained(model_name)

# Loading the dataset to train our model
dataset = load_dataset("mteb/tweet_sentiment_extraction")
Se diamo un'occhiata al dataset appena scaricato, è un dizionario che contiene un sottoinsieme per l'addestramento e uno per il test. Se convertiamo il sottoinsieme di training in un dataframe, appare così:
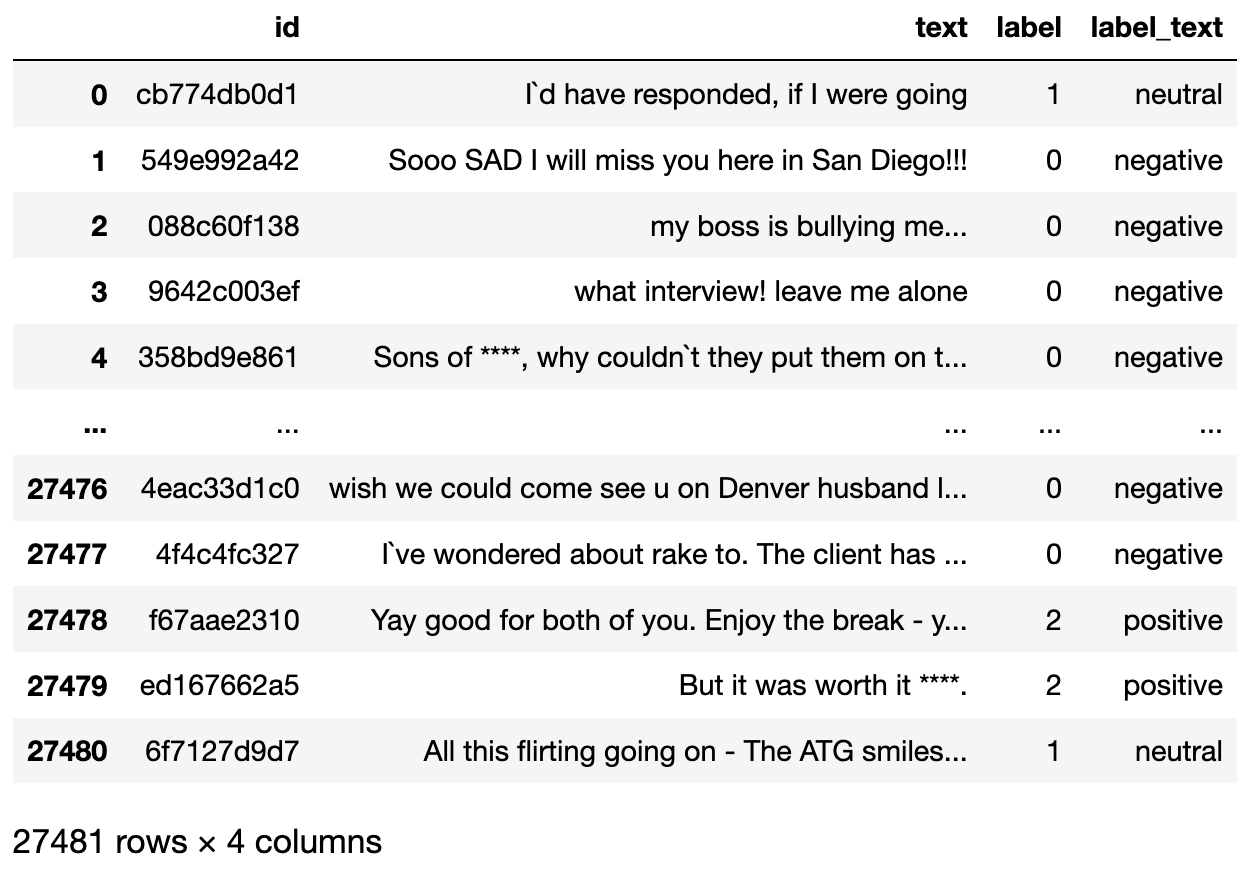
Il dataset da utilizzare.
2. Prepara il dataset: Ora che abbiamo il dataset, ci serve un tokenizer per prepararlo all'analisi da parte del modello. La variabile di testo del dataset va tokenizzata per poterla usare nel fine-tuning.
Per questo, il secondo passo è caricare un Tokenizer pre-addestrato e tokenizzare il nostro dataset, così da poterlo usare per il fine-tuning.
tokenizer = AutoTokenizer.from_pretrained(model_name)

def tokenize_function(examples):
    return tokenizer(examples["text"], padding="max_length", truncation=True)

tokenized_datasets = dataset.map(tokenize_function, batched=True)
3. Crea un dataset PyTorch con le codifiche: Il terzo passo è generare un dataset di training e uno di test. Il set di training verrà usato per il fine-tuning, mentre il set di test servirà per la valutazione.
Di solito, il processo di fine-tuning richiede molto tempo. Per facilitare il tutorial, campioniamo casualmente entrambi i dataset per ridurre i tempi di calcolo.
from datasets import load_dataset

model = AutoModelForSequenceClassification.from_pretrained(model_name)

# Loading the dataset to train our model
dataset = load_dataset("mteb/tweet_sentiment_extraction")

small_train_dataset = tokenized_datasets["train"].shuffle(seed=42).select(range(1000))
small_eval_dataset = tokenized_datasets["test"].shuffle(seed=42).select(range(1000))
4. Esegui il fine-tuning del modello: Il passo finale è impostare gli argomenti di training e avviare il processo. La libreria transformers contiene la classe trainer(), che si occupa di tutto.
Definiamo prima gli argomenti di training insieme alla strategia di valutazione. Una volta definito tutto, possiamo addestrare il modello con il comando train().
from transformers import Trainer, TrainingArguments
import numpy as np

training_args = TrainingArguments(output_dir="trainer_output", evaluation_strategy="epoch")

metric = evaluate.load("accuracy")

def compute_metrics(eval_pred):
    logits, labels = eval_pred
    predictions = np.argmax(logits, axis=-1)
    return metric.compute(predictions=predictions, references=labels)


trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=small_train_dataset,
    eval_dataset=small_eval_dataset,
    compute_metrics=compute_metrics,
)
trainer.train()
5. Valuta il modello: Dopo l'addestramento, valuta le prestazioni del modello su un set di validazione o di test. Anche in questo caso, la classe trainer include già un metodo evaluate che se ne occupa.
import evaluate

trainer.evaluate()
Il nostro modello fine-tuned presenta un'accuratezza del 70%.
Ora che abbiamo migliorato il modello, come possiamo condividerlo con la community? Questo ci porta all'ultimo passo.
Una volta che hai eseguito il fine-tuning del modello, potresti volerlo condividere con la community.
Hugging Face rende il processo semplice. Per prima cosa, devi installare la libreria huggingface_hub.
Un requisito per questo passaggio finale è avere un token attivo per poter connettere il tuo account Hugging Face. Puoi ottenerne uno facilmente seguendo questa guida. Lavorando in un Jupyter Notebook, possiamo importare comodamente la libreria notebook_login.
from huggingface_hub import notebook_login

notebook_login()
Questo genererà un login all'interno del nostro Jupyter Notebook. Ci basta inserire il token e il notebook sarà connesso al nostro account Hugging Face.
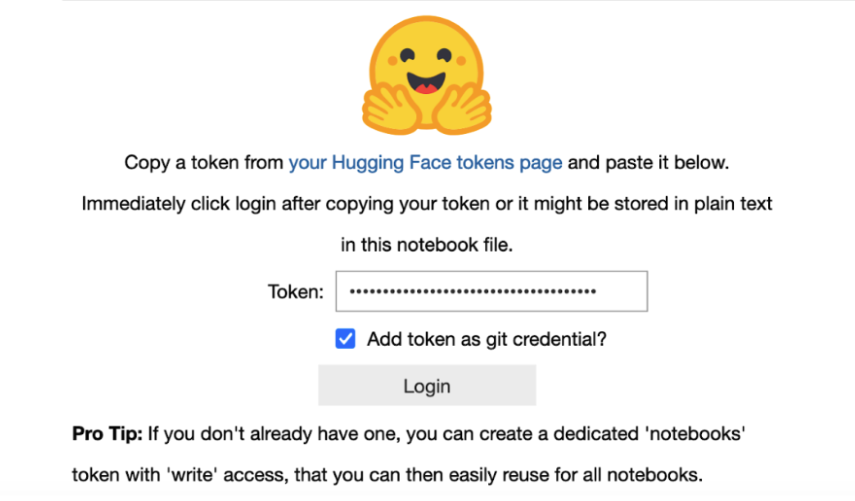
Ora non ci resta che caricare il modello usando il comando push_to_hub.
finetuned_model.push_to_hub("my-awesome-model")
Dopodiché, il modello sarà disponibile per tutti sul nostro profilo Hugging Face.
Se vogliamo standardizzare un qualsiasi processo NLP, con Hugging Face di solito bastano tre semplici passaggi che richiedono meno di cinque righe di codice:
1. Definisci un oggetto modello con la classe pipeline (e il relativo modello e tokenizer).
2. Definisci il testo o prompt di input.
3. Esegui il modello pre-addestrato con il nostro input e osserva l'output.
La classificazione del testo è un task fondamentale dell'NLP. Consiste nell'assegnare a ogni testo in input una o più categorie. Può essere usata per numerose applicazioni come rilevamento dello spam, sentiment analysis, etichettatura degli argomenti e altro.
Nell'esempio di codice qui sotto puoi vedere come, con i soli tre semplici passaggi della sezione precedente, possiamo implementare un modello di classificazione del testo.
# We import the pipeline module from the transformers library
from transformers import pipeline

# We load the pre-trained text classification model.
classifier = pipeline("text-classification",model='lxyuan/distilbert-base-multilingual-cased-sentiments-student')

# Input to be classified
input_ = "I absolutely love the transformers library!"

# Perform classification
output_ = classifier(input_)

# Observer the result
print(output_)
Semplice, no?
Passiamo quindi al secondo caso d'uso, uno dei più abusati di sempre.
Molti di voi conosceranno già ChatGPT o Google Bard, strumenti che generano testo a partire da un prompt di input. Questo processo si chiama “Text Generation” ed è un aspetto affascinante dell'NLP, in cui un modello produce testo simile a quello umano a partire da un input iniziale.
Ha un’ampia gamma di applicazioni, dalla creazione di risposte per chatbot alla scrittura creativa.
L'idea di base è addestrare un modello su un ampio corpus testuale, permettendogli di apprendere pattern, stili e strutture del linguaggio. Come puoi immaginare, la parte più costosa è proprio l'addestramento del modello.
Tuttavia, Hugging Face ci permette di implementare un modello del genere in appena cinque righe di codice, proprio come nel caso precedente.
Guarda l'esempio qui sotto:
from transformers import pipeline

generator = pipeline('text-generation', model='gpt2')

prompt = "In a world dominated by AI,"

generated_text = generator(prompt, max_length=50)[0]['generated_text']

print(generated_text)
Il question answering, spesso abbreviato in QA, è un ambito dell'NLP focalizzato sulla costruzione di sistemi che rispondono automaticamente alle domande poste dagli esseri umani in linguaggio naturale.
I sistemi QA sono ampiamente usati in svariate applicazioni, come assistenti virtuali, supporto clienti e sistemi di information retrieval.
I sistemi QA possono essere ampiamente suddivisi in due tipi:
Questi sistemi in genere combinano la comprensione del linguaggio naturale per interpretare la domanda e il recupero di informazioni per trovare le risposte pertinenti.
Anche in questo caso, implementare uno di questi modelli con Hugging Face è rapido e semplice.
from transformers import pipeline

qa_pipeline = pipeline('question-answering', model='distilbert-base-uncased-distilled-squad')

context = """Paris is the capital and most populous city of France. The city has an area of 105 square kilometers and a population of 2,140,526 residents."""
question = "What is the population of Paris?"

answer = qa_pipeline(question=question, context=context)
print(answer)
L'ultimo caso d'uso è la traduzione. La traduzione automatica è un sottoinsieme della linguistica computazionale che si concentra sulla traduzione di testi o parlato da una lingua all'altra mediante software. Con l'avvento del deep learning, la traduzione automatica ha fatto passi da gigante, in particolare con modelli come la Neural Machine Translation (NMT) che utilizzano grandi reti neurali.
I moderni sistemi NMT, a differenza dei modelli di traduzione tradizionali basati su regole o statistici, imparano a tradurre addestrandosi su grandi dataset di testi bilingui. Usano architetture sequence-to-sequence, in cui una parte della rete codifica il testo sorgente e un'altra lo decodifica nella lingua di destinazione, spesso con una notevole fluidità e accuratezza.
Un semplice esempio con Hugging Face potrebbe essere:
from transformers import pipeline

# Load the translation pipeline for English to Spanish
translator = pipeline('translation_en_to_de')

# Text to translate from English to Spanish
text_to_translate = "This is a great day for science!"

# Perform the translation
translation = translator(text_to_translate, max_length=40)

# Print the translated text
print(translation[0]['translation_text'])
Hugging Face è emersa come una forza trasformativa nel campo dell'intelligenza artificiale e del natural language processing. La sua suite di strumenti completa, che include la rivoluzionaria libreria Transformers, il collaborativo Model Hub e l'ampia libreria Datasets, ha democratizzato l'accesso a capacità NLP avanzate.
Promuovendo un ambiente in cui l'innovazione è condivisa e costruita collettivamente, Hugging Face non solo contribuisce all'avanzamento dell'AI, ma sta anche plasmando un futuro in cui la tecnologia è più accessibile, inclusiva e potente.
Mentre continuiamo ad assistere e partecipare alla rivoluzione dell'AI, Hugging Face ci ricorda che i progressi tecnologici più profondi sono quelli aperti, condivisi e costruiti insieme.
Non si tratta solo di creare macchine più intelligenti, ma di coltivare una community più intelligente e connessa di sviluppatori, ricercatori e appassionati desiderosi di spingere i limiti di ciò che è possibile.
Inizia oggi il tuo percorso in AI & NLP!
Programma
Programma
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



