
Cursus
Traitement du langage naturel en Python
20 h
Dans un monde technologique qui évolue à toute vitesse, l’intelligence artificielle s’impose comme un domaine clé, omniprésent, qui s’invite sans effort dans notre quotidien. Au cœur de cette vague IA, le traitement automatique du langage naturel (TALN) propulse des outils conversationnels populaires comme ChatGPT et Bard.
Et si la plupart des modèles qui rendent ces outils possibles étaient ouverts à tous, réunis au même endroit ?
Voici Hugging Face, un véritable game changer en apprentissage automatique et en TALN, acteur clé de la démocratisation de l’IA. Grâce à l’apprentissage par transfert, la plateforme joue un rôle essentiel pour rendre l’IA plus accessible.
Aujourd’hui, elle propose la bibliothèque NLP la plus populaire en Python, avec plus de 115 k étoiles sur GitHub, et s’impose comme l’une des plateformes de référence où passionnés et professionnels de l’IA expérimentent, déploient et font passer à l’échelle leurs propres modèles.
Que vous soyez un pro de la donnée ou simplement curieux, Hugging Face offre les outils et ressources pour donner vie à vos projets IA et repousser les limites de ce qui est possible en apprentissage automatique.
Découvrons ensemble tout ce que Hugging Face a à offrir !
Vous pouvez aussi en apprendre plus sur l’utilisation de modèles IA open source avec Hugging Face grâce à notre code-along.
Pour la plupart, Hugging Face n’est peut-être qu’un émoji sur le clavier du téléphone (🤗)
Mais dans l’écosystème tech, c’est un peu le GitHub du monde ML : une plateforme collaborative foisonnante d’outils qui permettent à chacun de créer, entraîner et déployer des modèles de TALN et de ML en open source.
La révolution ?
Ces modèles arrivent déjà préentraînés, ce qui simplifie grandement l’entrée dans le TALN. En clair, les développeurs ne partent plus de zéro : ils chargent un modèle préentraîné depuis le hub Hugging Face, l’affinent pour leur tâche spécifique et démarrent ainsi.
Cette simplicité d’usage fluidifie considérablement le développement.
Hugging Face est donc un hub où data scientists, chercheurs et ingénieurs ML se retrouvent pour échanger, demander de l’aide et contribuer à des initiatives open source.
Ils se définissent comme :
« The AI community for building the future. »
Cette vision, portée par l’approche communautaire, fait partie des ingrédients secrets du succès de Hugging Face.
Autre facteur de croissance : l’ergonomie de la plateforme. Une interface simple facilite la prise en main — pour les débutants comme pour les experts.
Avec l’ambition d’héberger la plus grande collection de ressources NLP et ML, Hugging Face s’engage à démocratiser l’IA et à la rendre accessible à une communauté mondiale.
Fondée en 2016, Hugging Face est à l’origine une entreprise franco-américaine qui visait à développer un chatbot IA interactif pour adolescents. Après avoir open sourcé le modèle derrière ce chatbot, l’entreprise a rapidement changé d’ambition : fournir à l’industrie IA des outils puissants et accessibles.
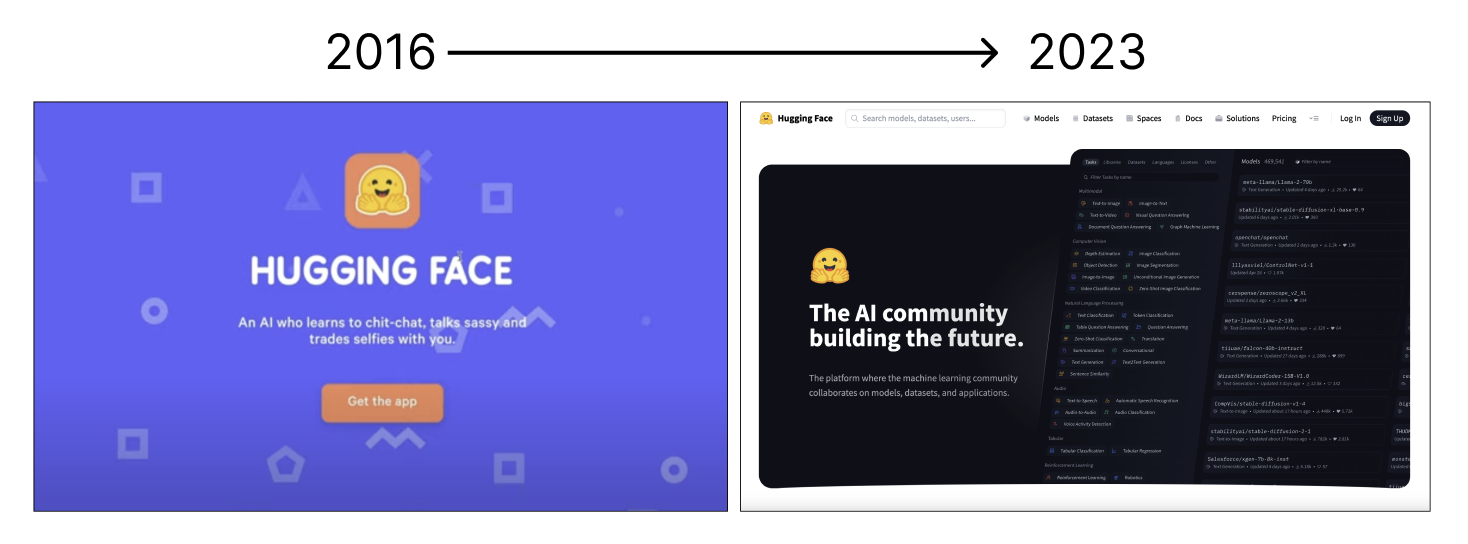
Image par l’auteur.
Le lancement en 2018 de la bibliothèque Transformers, véritablement transformatrice, a marqué l’une de ses contributions majeures et les plus connues à la communauté IA, offrant des modèles préentraînés comme BERT et GPT, devenus incontournables pour les tâches de TALN.
Aujourd’hui, Hugging Face a profondément remodelé l’écosystème ML. Son engagement en faveur de la collaboration open source a catalysé l’innovation en TALN, favorisant la progression collective et le développement de la technologie.
La plateforme est devenue un carrefour de partage de modèles et de jeux de données, propulsant la recherche et les usages concrets de l’IA.
Leur mantra ?
« Democratize good Machine Learning, one commit at a time. »
À travers des partenariats stratégiques et la volonté de rendre des outils NLP avancés largement disponibles, Hugging Face est devenu un pilier de la communauté, repoussant sans cesse les frontières de l’IA et démocratisant l’accès aux technologies de pointe.
Hugging Face est devenu une pierre angulaire du TALN moderne grâce à un ensemble de composants et de fonctionnalités qui répondent à un large éventail de besoins.
Passons-les en revue.
Transformers est une suite complète de modèles d’apprentissage automatique de pointe, spécialement conçus pour le TALN. Elle comprend une vaste collection de modèles préentraînés optimisés pour des tâches comme la classification de texte, la génération de langage, la traduction ou le résumé, entre autres.
Hugging Face a encapsulé les tâches NLP courantes dans une méthode simple, pipeline(), une API facile à utiliser pour exécuter une grande variété de tâches. Ces pipelines permettent d’appliquer aisément des modèles complexes à des cas réels. Pour en savoir plus sur les coulisses de cette bibliothèque, je vous recommande vivement l’article An Introduction to Using Transformers and Hugging Face.
Ces modèles sont facilement accessibles et personnalisables, ce qui a changé la donne pour les développeurs et chercheurs, et a largement contribué à rendre les modèles NLP sophistiqués plus accessibles.
L’intérêt majeur réside dans la capacité à masquer la complexité de l’entraînement et du déploiement des modèles NLP, ce qui permet d’implémenter des fonctionnalités avancées avec un minimum de code.
La bibliothèque permet d’exploiter des modèles préentraînés sans plonger dans les algorithmes sous-jacents.
Transformers simplifie l’implémentation des modèles NLP de plusieurs façons clés :
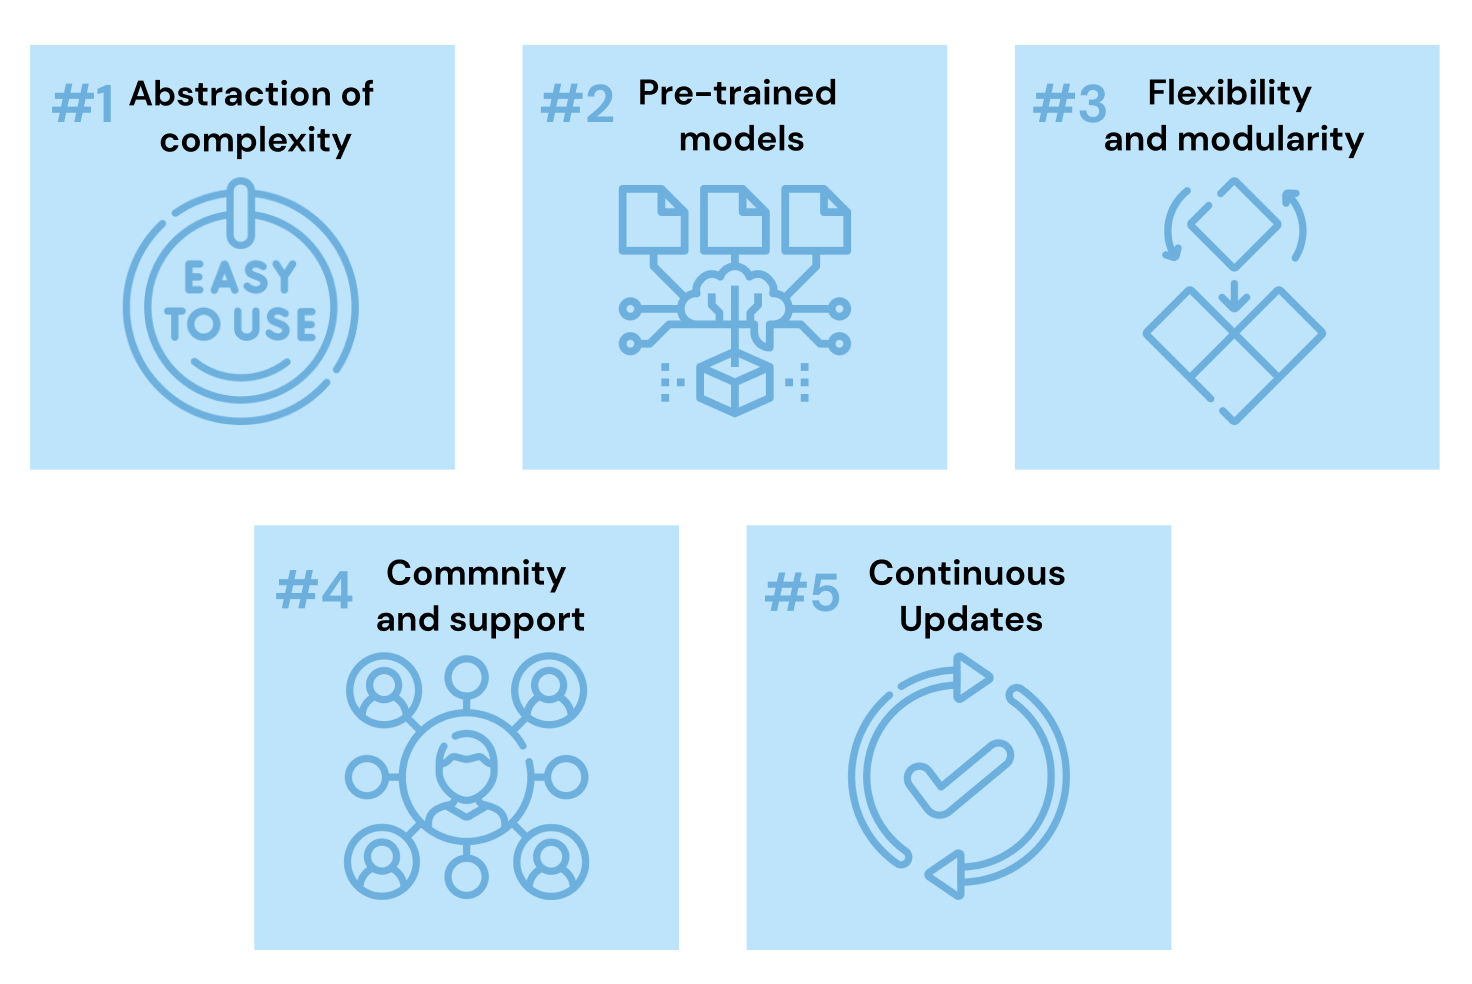
Pour mesurer concrètement tout ce que la bibliothèque Transformers nous évite, découvrez comment déployer un modèle NLP avec Building a Transformer with PyTorch.
Le Model Hub est la vitrine de la communauté : une plateforme où des milliers de modèles et de jeux de données sont à portée de clic. C’est une fonctionnalité clé qui permet de partager et de découvrir des modèles proposés par la communauté, favorisant une approche collaborative du développement NLP.
Vous pouvez l’explorer sur leur site officiel. Sélectionnez Models dans la navigation pour accéder au Model Hub, vous verrez alors une vue similaire à celle-ci :
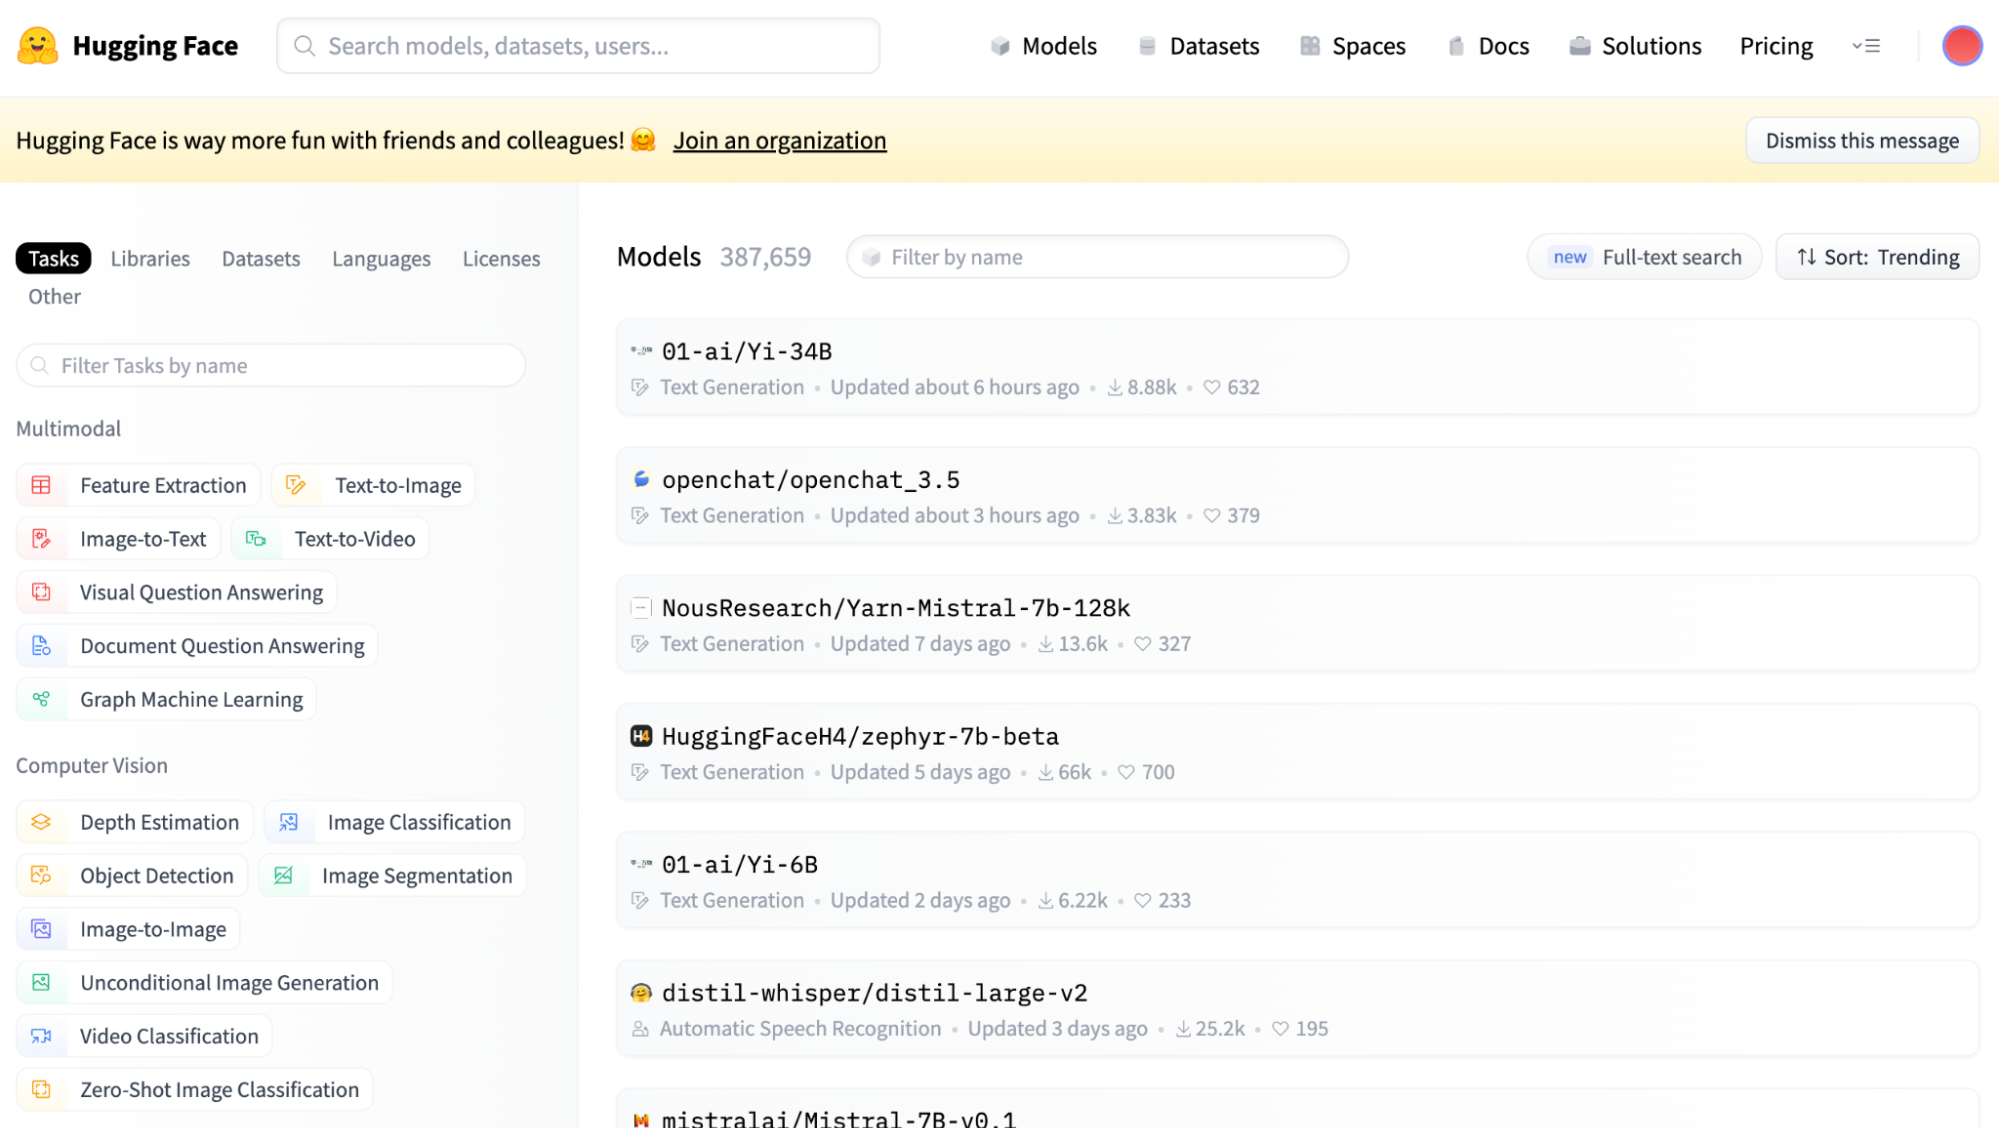
Capture d’écran de la vue principale du Model Hub de Hugging Face.
Comme vous le voyez, la colonne de gauche propose de nombreux filtres selon la tâche principale à réaliser.
Contribuer au Model Hub est simple grâce aux outils Hugging Face, qui guident l’utilisateur pour téléverser ses modèles. Une fois publiés, ces modèles sont disponibles pour toute la communauté, soit directement via le hub, soit via l’intégration avec la bibliothèque Transformers.
Cet accès et cette contribution facilités nourrissent un écosystème dynamique où les modèles de pointe sont constamment améliorés et enrichis, offrant une base collaborative solide pour faire avancer le TALN.
Les tokenizers sont essentiels en TALN : ils convertissent le texte dans un format compréhensible par les modèles d’apprentissage, ce qui est crucial pour traiter différentes langues et structures textuelles.
Ils découpent le texte en tokens — unités de base comme mots, sous-mots ou caractères — afin de préparer les données pour les modèles. Ces tokens sont les briques de base qui permettent aux modèles de comprendre et de générer du langage naturel.
Ils facilitent aussi la transformation des tokens en vecteurs pour l’entrée du modèle, et gèrent le padding et la troncature pour obtenir des séquences de longueur uniforme.
Hugging Face propose une gamme de tokenizers conviviaux, optimisés pour la bibliothèque Transformers, indispensables à un prétraitement fluide du texte. Vous pouvez en lire plus sur la tokenization dans un article dédié.
Autre composant clé : la bibliothèque Hugging Face Datasets, un vaste répertoire de jeux de données NLP pour entraîner et évaluer des modèles ML.
C’est un outil essentiel pour les développeurs, offrant une collection variée de datasets pour entraîner, tester et benchmarker des modèles NLP sur un large éventail de tâches.
L’un de ses principaux atouts est son interface simple et intuitive. Vous pouvez parcourir tous les jeux de données sur le Hub, puis, dans votre code, la bibliothèque Datasets vous permet de les télécharger en toute simplicité.
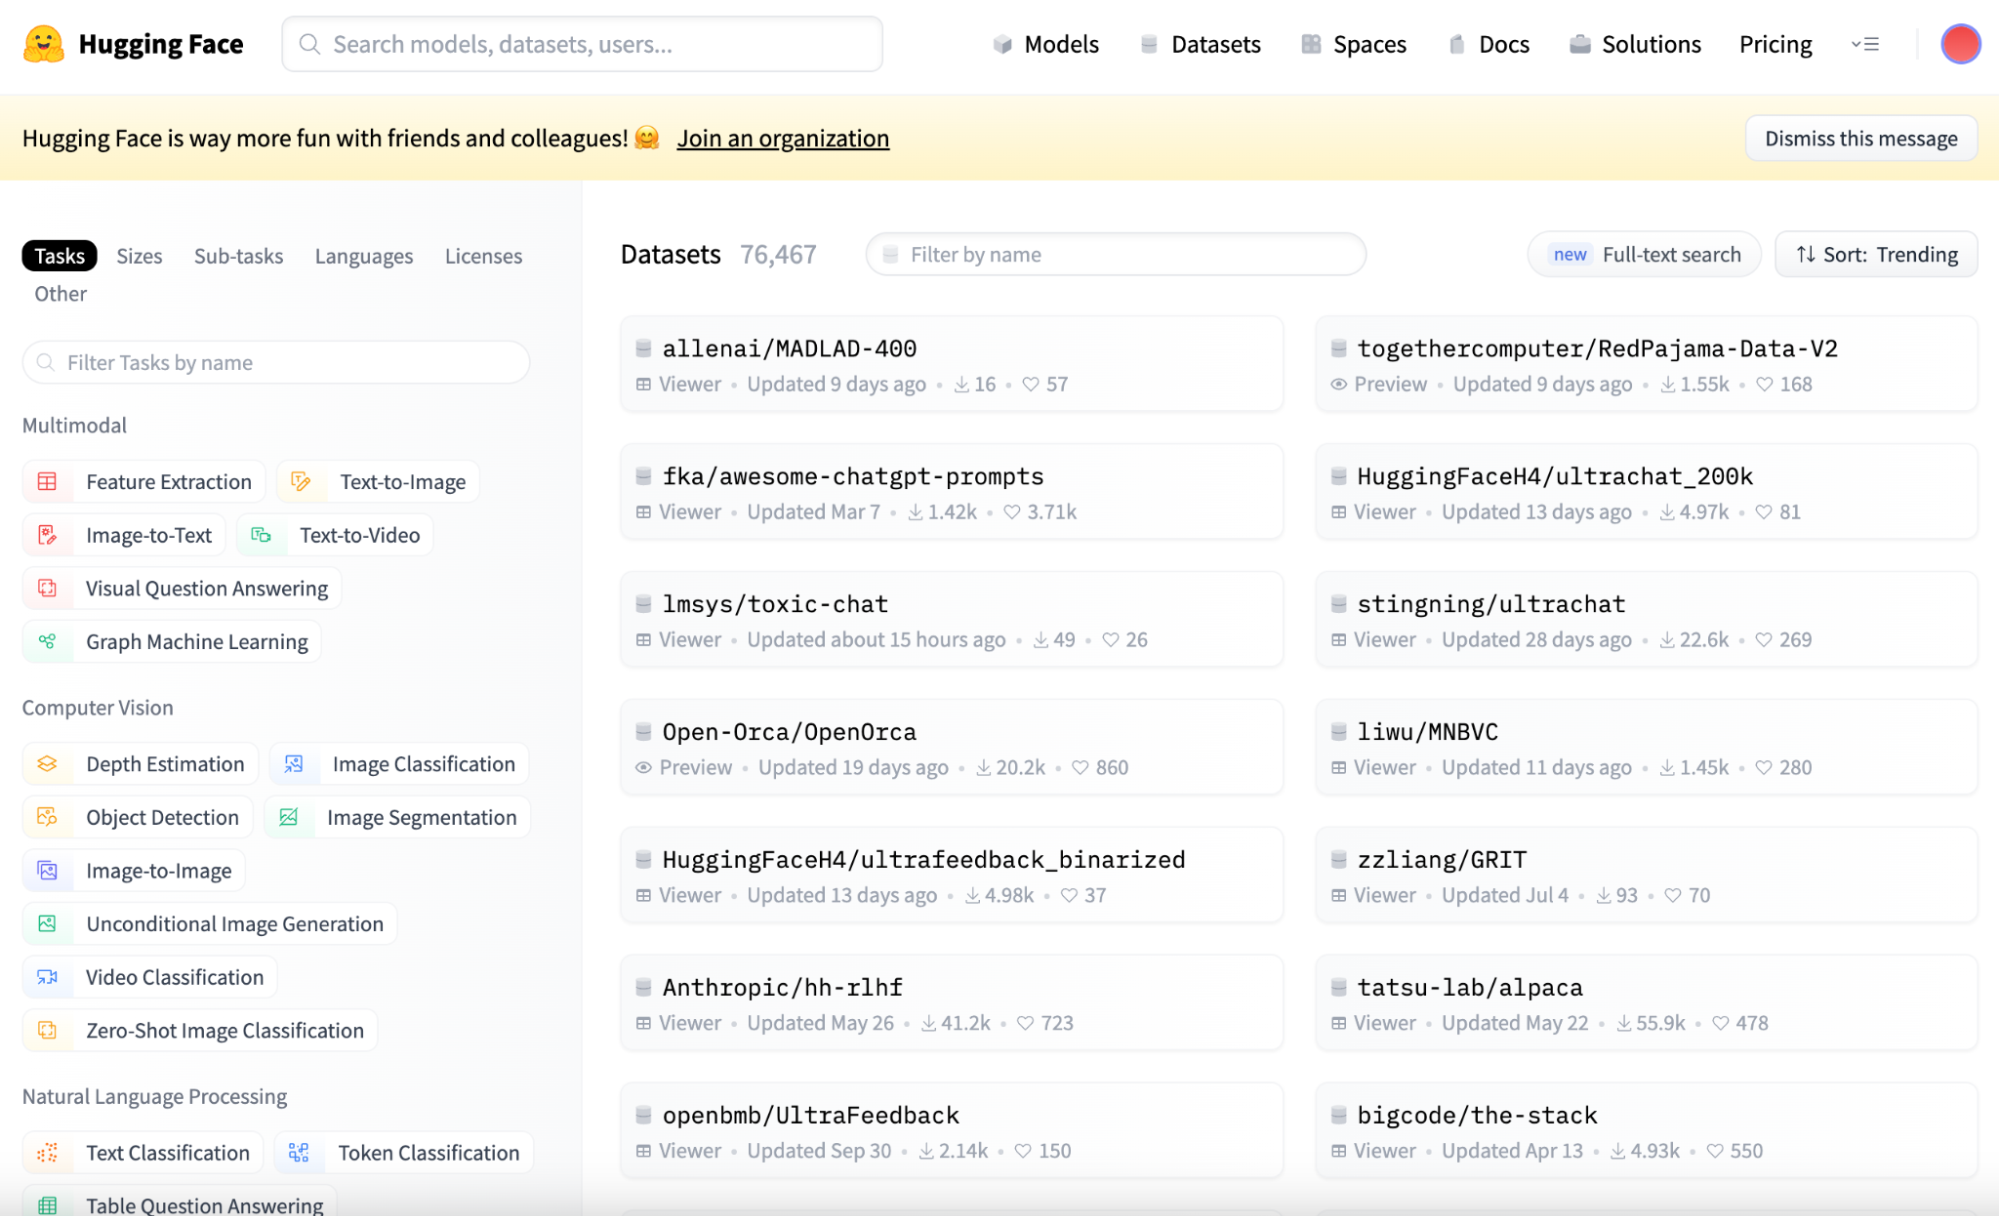
Capture d’écran de la vue principale de Hugging Face Datasets.
On y trouve des datasets pour les tâches courantes (classification de texte, traduction, question-réponse) ainsi que des jeux de données plus spécialisés pour des défis spécifiques.
Maintenant que nous partageons les mêmes bases et comprenons les concepts clés de Hugging Face, voyons comment exploiter ce petit bijou technologique.
Ce guide vous présente brièvement les fondamentaux pour débuter : installation, utilisation de modèles préentraînés, fine-tuning et partage de vos modèles avec la communauté.
Commencez par associer la bibliothèque transformers à votre framework de deep learning favori, TensorFlow ou PyTorch.
La bibliothèque transformers s’installe facilement avec pip, le gestionnaire de paquets Python.
pip install transformers
Pour profiter de toutes les capacités, installez aussi les bibliothèques datasets et tokenizers.
pip install tokenizers, datasets
Le Model Hub de Hugging Face propose une immense collection de modèles préentraînés pour une large gamme de tâches NLP. Découvrons comment utiliser un premier modèle.
1. Sélectionner un modèle préentraîné : rendez-vous sur le Model Hub.
Imaginons que nous souhaitions inférer le sentiment associé à une phrase. Nous pouvons filtrer les modèles dédiés à la « Text Classification » en sélectionnant ce bouton dans la barre latérale gauche.
Les modèles Hugging Face sont affichés par tendance. En général, ceux en haut sont les plus utilisés. Sélectionnons le deuxième résultat, le modèle de référence pour l’analyse de sentiments.
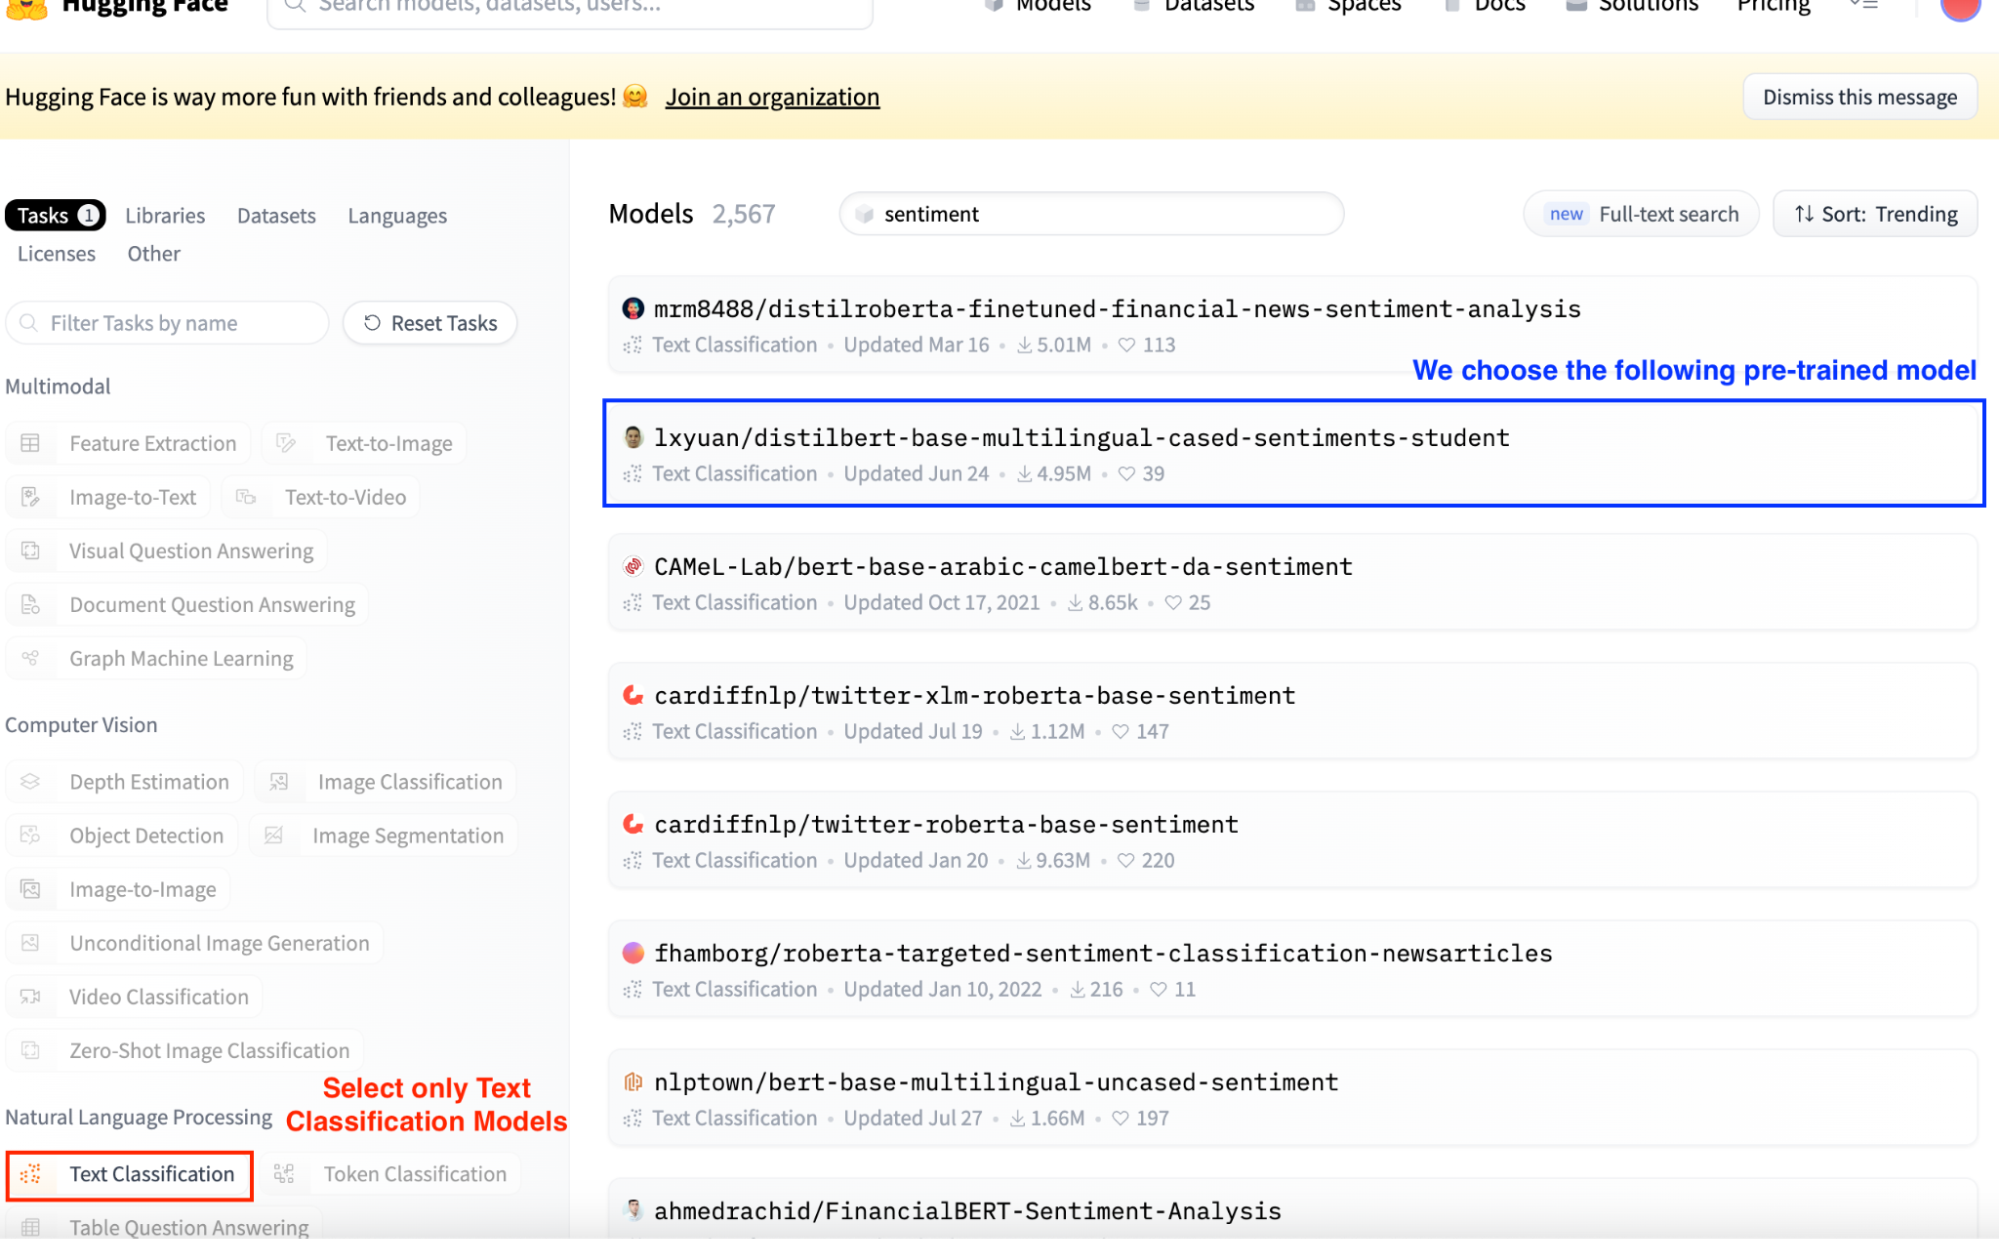
Capture d’écran du Model Hub de Hugging Face : sélection des modèles de classification de texte.
Pour l’utiliser, nous devons copier le nom du modèle, affiché en haut de sa page dédiée.
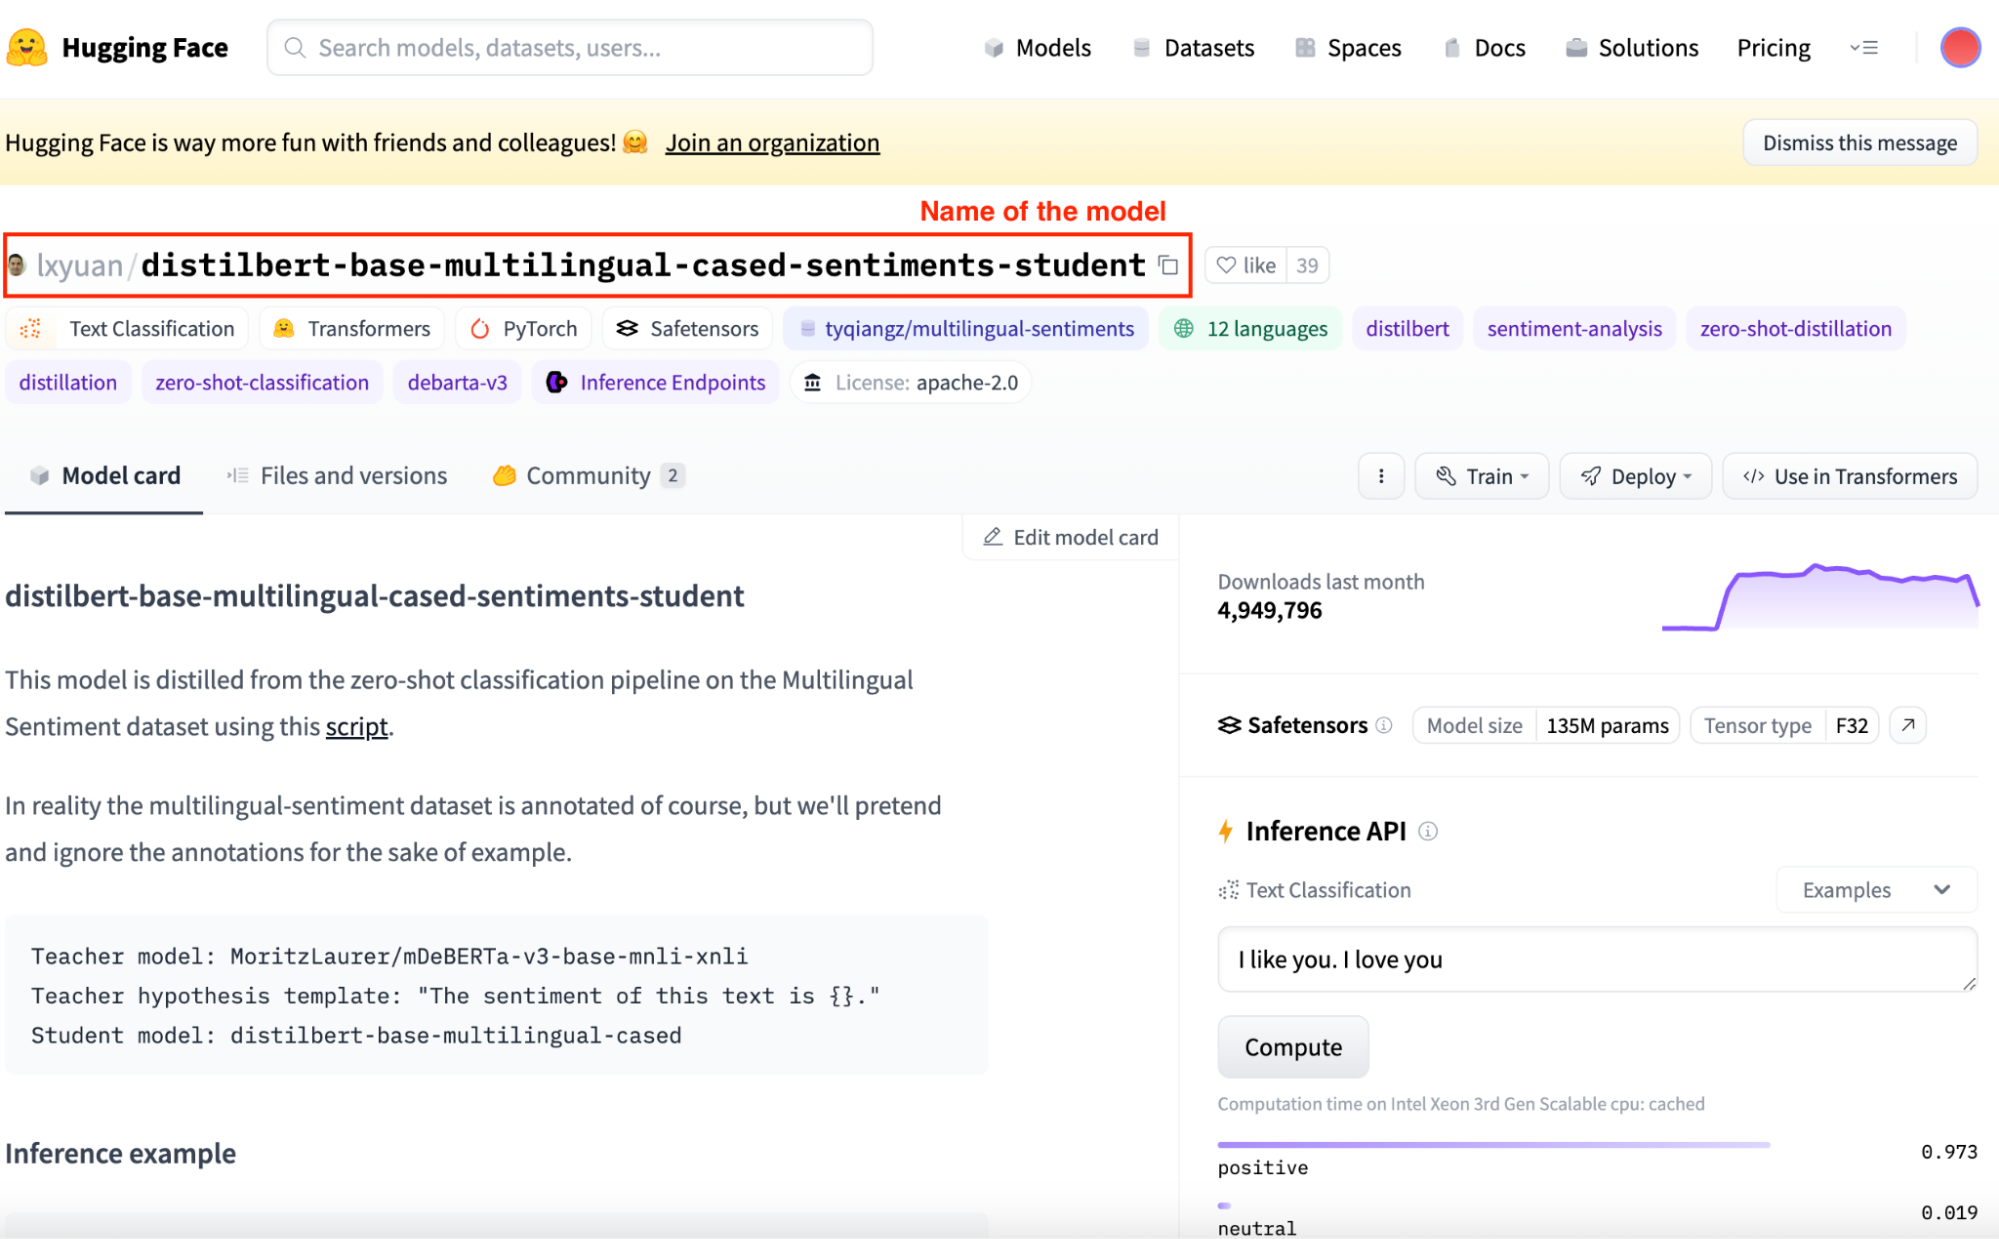
Capture d’écran de la page modèle sur le Model Hub de Hugging Face.
1. Charger un modèle préentraîné : maintenant que nous savons quel modèle utiliser, passons à Python. Importons d’abord les classes AutoTokenizer et AutoModelForSequenceClassification depuis transformers.
Ces classes AutoModel infèrent automatiquement l’architecture à partir du nom du modèle.
from transformers import AutoTokenizer, AutoModelForSequenceClassification

model_name = "lxyuan/distilbert-base-multilingual-cased-sentiments-student"

# We call define a model object
model = AutoModelForSequenceClassification.from_pretrained(model_name)
2. Préparer l’entrée : chargeons le tokenizer du modèle. La bibliothèque transformers facilite l’opération en inférant le tokenizer adapté à partir du nom du modèle choisi.
#We call the tokenizer class
tokenizer = AutoTokenizer.from_pretrained(model_name)
3. Exécuter le modèle : créons un objet pipeline avec le modèle, le tokenizer et la tâche à effectuer. Ici, une analyse de sentiments. Si vous initialisez le classificateur uniquement avec la tâche, la classe pipeline choisira des valeurs par défaut (à éviter en production).
# Initializing a classifier with a model and a tokenizer
classifier = pipeline("sentiment-analysis", model = model, tokenizer = tokenizer)
# When passing only the task, the pipeline command inferes both the model and tokenizer.
classifier = pipeline("sentiment-analysis")
Nous pouvons exécuter le modèle en lui fournissant une entrée.
output = classifier("I've been waiting for this tutorial all my life!")
4. Interpréter les sorties : le modèle renvoie un objet contenant divers éléments selon sa classe. Pour l’analyse de sentiments, par exemple, on obtient :
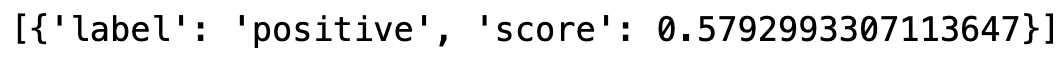
Sortie obtenue.
Le fine-tuning consiste à reprendre un modèle préentraîné et à mettre à jour ses paramètres en l’entraînant sur un jeu de données spécifique à votre tâche. Vous tirez ainsi parti des représentations déjà apprises en les adaptant à votre cas d’usage.
Imaginons que nous devions utiliser un classificateur de texte pour inférer le sentiment d’une liste de tweets. Une question naturelle : ce modèle préentraîné fonctionnera-t-il correctement ?
Pour s’en assurer, on peut affiner le modèle Hugging Face choisi avec un dataset de tweets et de sentiments associés, afin d’améliorer les performances.
Voici un exemple de base de fine-tuning pour une classification de séquences :
1. Choisir un modèle préentraîné et un dataset : sélectionnez une architecture adaptée. Ici, nous gardons le même modèle d’analyse de sentiments. Il nous faut maintenant des données pour l’entraîner.
C’est là que la bibliothèque datasets entre en scène. Parcourons les datasets sur le Hub et choisissons celui qui convient le mieux.
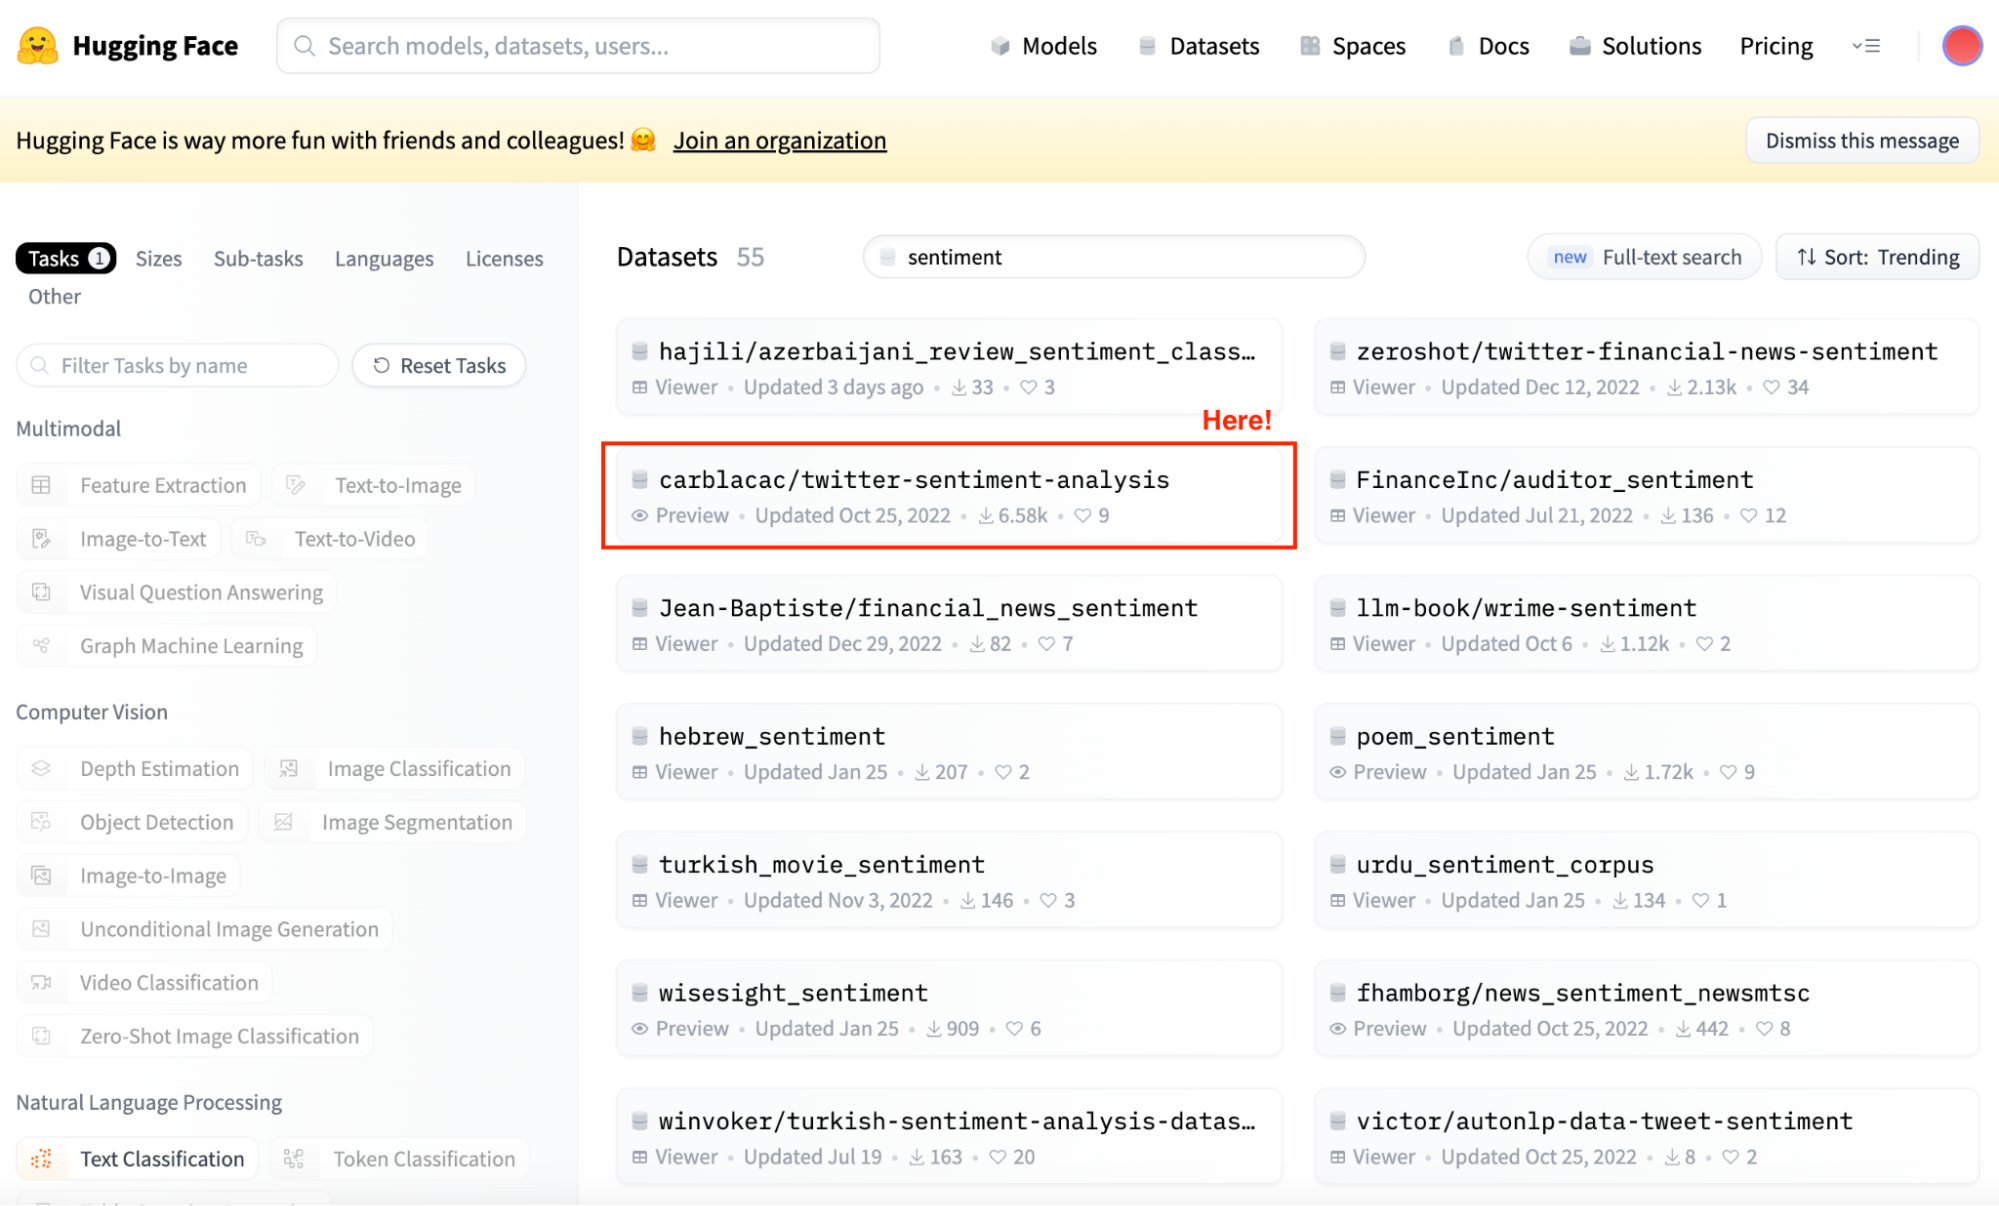
Capture d’écran du Datasets Hub de Hugging Face : sélection de jeux de données d’analyse de sentiments.
Maintenant que le dataset est choisi, nous pouvons initialiser le modèle et charger le dataset.
model = AutoModelForSequenceClassification.from_pretrained(model_name)

# Loading the dataset to train our model
dataset = load_dataset("mteb/tweet_sentiment_extraction")
Si l’on inspecte le dataset téléchargé, c’est un dictionnaire avec un sous-ensemble d’entraînement et un sous-ensemble de test. Converti en dataframe (pour l’entraînement), il ressemble à ceci :
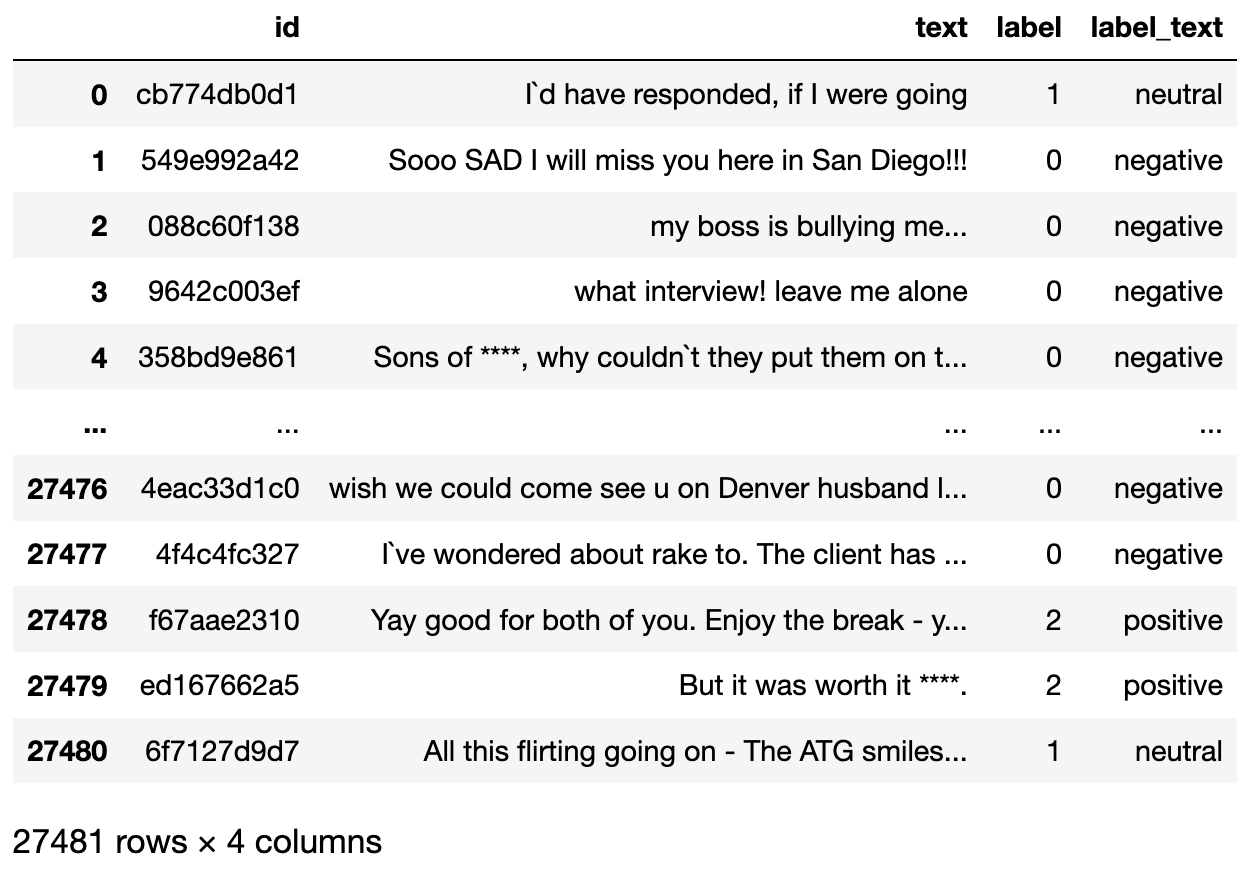
Jeu de données utilisé.
2. Préparer votre dataset : nous avons notre dataset, il nous faut un tokenizer pour le préparer au passage dans le modèle. La variable texte doit être tokenisée pour affiner le modèle.
Deuxième étape : charger un tokenizer préentraîné et tokeniser le dataset pour le fine-tuning.
tokenizer = AutoTokenizer.from_pretrained(model_name)

def tokenize_function(examples):
    return tokenizer(examples["text"], padding="max_length", truncation=True)

tokenized_datasets = dataset.map(tokenize_function, batched=True)
3. Construire un dataset PyTorch avec les encodages : générons les ensembles d’entraînement et de test. Le premier servira au fine-tuning, le second à l’évaluation.
Le fine-tuning prend souvent du temps. Pour ce tutoriel, nous échantillonnons aléatoirement des sous-ensembles afin de réduire le temps de calcul.
from datasets import load_dataset

model = AutoModelForSequenceClassification.from_pretrained(model_name)

# Loading the dataset to train our model
dataset = load_dataset("mteb/tweet_sentiment_extraction")

small_train_dataset = tokenized_datasets["train"].shuffle(seed=42).select(range(1000))
small_eval_dataset = tokenized_datasets["test"].shuffle(seed=42).select(range(1000))
4. Affiner le modèle : définissons les paramètres d’entraînement et lançons l’apprentissage. La bibliothèque transformers propose la classe trainer() qui gère l’ensemble du processus.
Nous définissons d’abord les arguments d’entraînement et la stratégie d’évaluation. Une fois prêt, nous entraînons le modèle avec train().
from transformers import Trainer, TrainingArguments
import numpy as np

training_args = TrainingArguments(output_dir="trainer_output", evaluation_strategy="epoch")

metric = evaluate.load("accuracy")

def compute_metrics(eval_pred):
    logits, labels = eval_pred
    predictions = np.argmax(logits, axis=-1)
    return metric.compute(predictions=predictions, references=labels)


trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=small_train_dataset,
    eval_dataset=small_eval_dataset,
    compute_metrics=compute_metrics,
)
trainer.train()
5. Évaluer le modèle : après l’entraînement, évaluez les performances sur un jeu de validation ou de test. La classe Trainer propose une méthode evaluate qui s’en charge.
import evaluate

trainer.evaluate()
Notre modèle affiné affiche une précision de 70 %.
Maintenant que nous l’avons amélioré, comment le partager avec la communauté ? Dernière étape.
Une fois votre modèle affiné, vous pouvez souhaiter le partager avec la communauté.
Hugging Face rend cela très simple. Commencez par installer la bibliothèque huggingface_hub.
Il vous faut un jeton actif pour vous connecter à votre compte Hugging Face. Vous pouvez en obtenir un facilement en suivant ce guide. Dans un Jupyter Notebook, importez notebook_login.
from huggingface_hub import notebook_login

notebook_login()
Cela ouvrira une fenêtre de connexion dans le Notebook. Saisissez votre jeton pour relier le Notebook à votre compte Hugging Face.
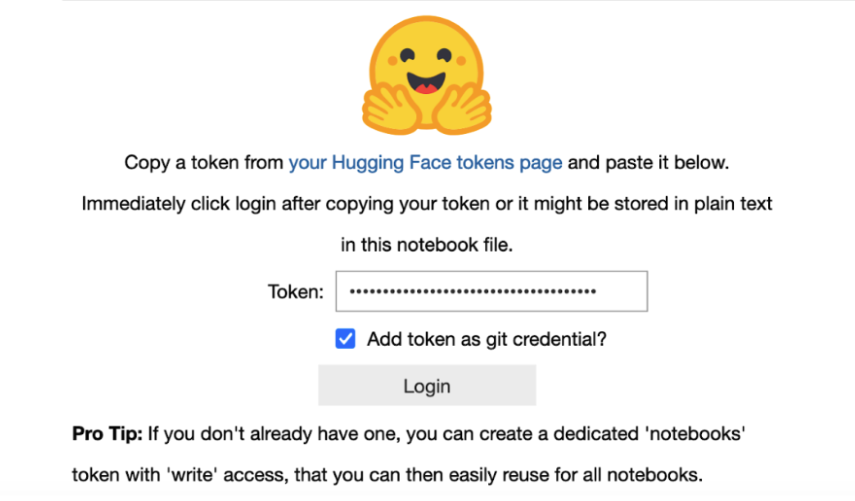
Il ne reste plus qu’à téléverser le modèle avec la commande push_to_hub.
finetuned_model.push_to_hub("my-awesome-model")
Après cela, le modèle sera disponible sur votre profil Hugging Face, accessible à tous.
Pour standardiser un processus NLP avec Hugging Face, on suit souvent trois étapes simples, en moins de cinq lignes de code :
1. Définir un objet modèle avec la classe pipeline (et le modèle et tokenizer correspondants).
2. Définir le texte d’entrée ou le prompt.
3. Exécuter le modèle préentraîné sur l’entrée et analyser la sortie.
La classification de texte est une tâche fondamentale du TALN. Elle consiste à attribuer une ou plusieurs catégories à chaque texte. Applications typiques : détection de spam, analyse de sentiments, étiquetage thématique, etc.
Comme dans l’exemple ci-dessous, trois étapes suffisent pour implémenter un modèle de classification de texte.
# We import the pipeline module from the transformers library
from transformers import pipeline

# We load the pre-trained text classification model.
classifier = pipeline("text-classification",model='lxyuan/distilbert-base-multilingual-cased-sentiments-student')

# Input to be classified
input_ = "I absolutely love the transformers library!"

# Perform classification
output_ = classifier(input_)

# Observer the result
print(output_)
Simple, non ?
Passons au deuxième cas d’usage, l’un des plus répandus.
Vous connaissez sans doute déjà ChatGPT ou Google Bard, des outils qui génèrent du texte à partir d’un prompt. Ce processus, la génération de texte, est un aspect fascinant du TALN où un modèle produit un texte proche du langage humain.
Les applications vont des chatbots à la rédaction créative.
L’idée centrale consiste à entraîner un modèle sur un large corpus, afin qu’il apprenne les schémas, styles et structures du langage. Sans surprise, la partie la plus coûteuse est justement l’entraînement.
Hugging Face permet toutefois de mettre cela en place en quelques lignes de code, comme précédemment.
Exemple :
from transformers import pipeline

generator = pipeline('text-generation', model='gpt2')

prompt = "In a world dominated by AI,"

generated_text = generator(prompt, max_length=50)[0]['generated_text']

print(generated_text)
La question-réponse (QA) vise à construire des systèmes capables de répondre automatiquement à des questions en langage naturel.
Ces systèmes sont largement utilisés, par exemple dans les assistants virtuels, le support client ou la recherche d’information.
On distingue généralement :
Ces systèmes combinent généralement compréhension du langage et recherche d’information pour trouver des réponses pertinentes.
L’implémentation avec Hugging Face est, là encore, rapide et simple.
from transformers import pipeline

qa_pipeline = pipeline('question-answering', model='distilbert-base-uncased-distilled-squad')

context = """Paris is the capital and most populous city of France. The city has an area of 105 square kilometers and a population of 2,140,526 residents."""
question = "What is the population of Paris?"

answer = qa_pipeline(question=question, context=context)
print(answer)
Dernier cas d’usage : la traduction. La traduction automatique est une sous-discipline de la linguistique informatique qui s’attache à traduire du texte ou de la parole d’une langue à une autre via des logiciels. Avec le deep learning, les progrès ont été spectaculaires, notamment grâce à la traduction neuronale (NMT).
Contrairement aux approches à base de règles ou statistiques, les systèmes NMT apprennent à traduire en s’entraînant sur de vastes corpus bilingues. Ils utilisent des architectures séquence-à-séquence, où un réseau encode le texte source et un autre le décode dans la langue cible, avec souvent une grande fluidité et précision.
Un exemple simple avec Hugging Face :
from transformers import pipeline

# Load the translation pipeline for English to Spanish
translator = pipeline('translation_en_to_de')

# Text to translate from English to Spanish
text_to_translate = "This is a great day for science!"

# Perform the translation
translation = translator(text_to_translate, max_length=40)

# Print the translated text
print(translation[0]['translation_text'])
Hugging Face s’impose comme une force transformatrice en IA et en traitement du langage. Sa suite d’outils complète — la bibliothèque Transformers, le Model Hub collaboratif et la bibliothèque Datasets — a démocratisé l’accès à des capacités NLP avancées.
En favorisant un environnement où l’innovation se partage et se construit collectivement, Hugging Face contribue à l’avancement de l’IA et façonne un futur où la technologie est plus accessible, inclusive et puissante.
Alors que nous vivons et participons à la révolution IA, Hugging Face nous rappelle que les avancées les plus profondes sont ouvertes, partagées et co-construites.
Il ne s’agit pas seulement de créer des machines plus intelligentes, mais aussi de fédérer une communauté plus avisée et connectée de développeurs, de chercheurs et de passionnés prêts à repousser les limites du possible.
Commencez votre parcours IA & TALN dès aujourd’hui !
Cursus
Cursus
Cours