
Lernpfad
Natürliche Sprachverarbeitung in Python
20 Std.
In der schnelllebigen Tech-Welt ist Künstliche Intelligenz heute allgegenwärtig und prägt immer mehr unseren Alltag. Ein zentrales Feld dabei ist das Natural Language Processing (NLP) – die Technologie hinter beliebten Conversational-Tools wie ChatGPT und Bard.
Und was, wenn die meisten Modelle, die diese Tools möglich machen, offen zugänglich sind – und an einem einzigen Ort?
Willkommen bei Hugging Face: ein Gamechanger für Machine Learning und Natural Language Processing – und ein Motor der Demokratisierung von KI. Dank Transfer Learning macht die Plattform leistungsfähige KI für alle einfacher nutzbar.
Heute bietet sie die populärste NLP-Bibliothek in Python mit über 115.000 GitHub-Sternen und ist zu einer der zentralen Plattformen geworden, auf der KI-Fans und -Profis eigene Modelle entwickeln, testen, bereitstellen und skalieren.
Ob Datenprofi oder neugieriger Einsteiger: Hugging Face liefert dir die Tools und Ressourcen, um KI-Projekte zum Leben zu erwecken – und verschiebt die Grenzen des Machbaren im Machine Learning.
Also, schauen wir uns an, was Hugging Face alles bietet!
Mehr über die Nutzung von Open-Source-KI-Modellen mit Hugging Face erfährst du auch in unserem Code-along.
Für die meisten ist Hugging Face vielleicht einfach nur ein weiteres Emoji auf der Smartphone-Tastatur (🤗).
In der Tech-Szene hingegen ist es so etwas wie GitHub für die ML-Welt – eine kollaborative Plattform voller Tools, mit denen jede und jeder per Open-Source-Code NLP- und ML-Modelle erstellen, trainieren und deployen kann.
Der Clou?
Viele Modelle sind bereits vortrainiert – das senkt die Einstiegshürde in NLP drastisch. Heißt: Entwicklerinnen und Entwickler starten nicht mehr bei null, sondern laden ein vortrainiertes Modell vom Hugging Face Hub, passen es an die eigene Aufgabe an (Fine-Tuning) – und legen los.
Diese Einfachheit nimmt enorm viel Komplexität aus der Entwicklung.
Hugging Face ist damit ein Treffpunkt für Data Scientists, Forschende und ML Engineers, um Ideen auszutauschen, Unterstützung zu finden und zu Open-Source-Projekten beizutragen.
Die Selbstbeschreibung lautet:
“The AI community for building the future.”
Genau dieser Community-Ansatz ist ein zentrales Erfolgsrezept von Hugging Face.
Ein weiterer Wachstumstreiber ist die intuitive Bedienung. Eine einfache Oberfläche erleichtert den Einstieg – für Neulinge ebenso wie für Profis.
Mit dem Ziel, die größte Sammlung an NLP- und ML-Ressourcen zu beherbergen, treibt Hugging Face die Demokratisierung von KI für eine weltweite Community voran.
Hugging Face wurde 2016 als amerikanisch-französisches Unternehmen gegründet – zunächst mit dem Ziel, einen interaktiven KI-Chatbot für Teenager zu entwickeln. Nachdem das zugrunde liegende Modell als Open Source veröffentlicht wurde, folgte schnell der größere Pivot: die KI-Branche mit starken, leicht zugänglichen Tools auszustatten.
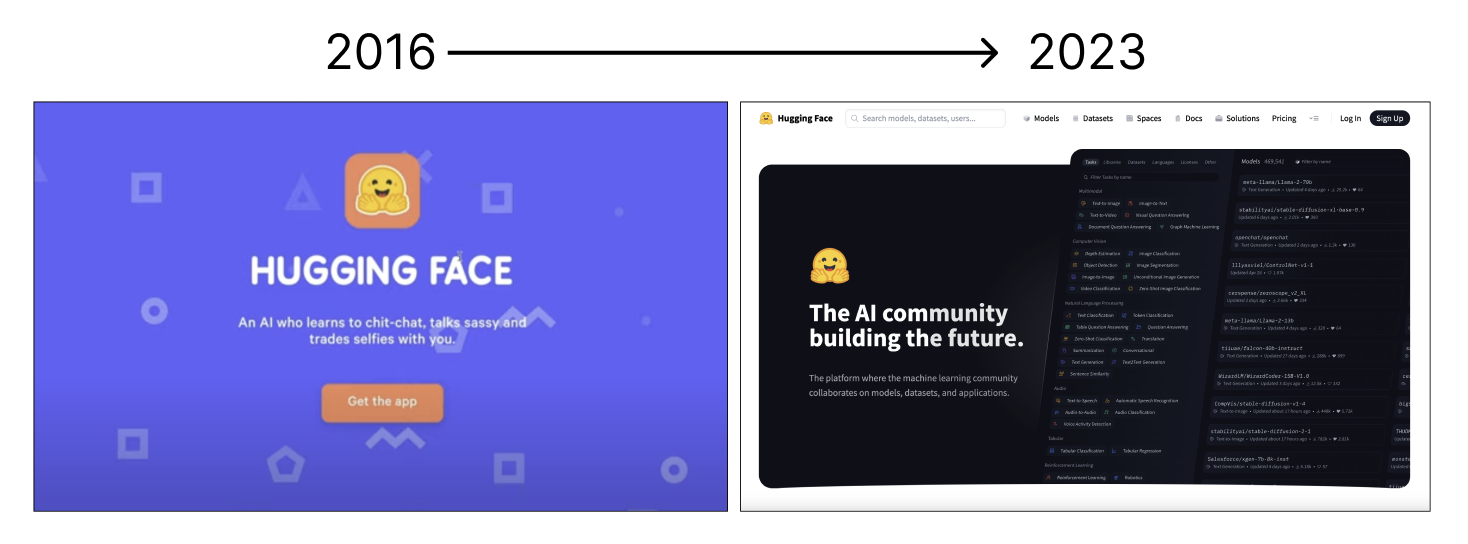
Bild: Autorin/Autor.
Mit dem Launch der Transformers-Bibliothek 2018 lieferte Hugging Face einen seiner größten Beiträge zur KI-Community: vortrainierte Modelle wie BERT und GPT, die heute Standard für viele NLP-Aufgaben sind.
Heute hat Hugging Face das ML-Ökosystem grundlegend geprägt. Der Open-Source-Fokus beschleunigt Innovationen in NLP und ermöglicht gemeinsames Wachstum.
Die Plattform ist zum Knotenpunkt für das Teilen von Modellen und Datensätzen geworden – und treibt Forschung wie Praxisanwendungen in der KI voran.
Das Motto?
“Democratize good Machine Learning, one commit at a time.”
Durch Partnerschaften und das Bestreben, fortgeschrittene NLP-Tools breit verfügbar zu machen, ist Hugging Face ein unverzichtbarer Teil der Community und treibt die KI-Entwicklung kontinuierlich voran.
Mit einer ganzen Reihe an Kernkomponenten und Features ist Hugging Face zu einem Eckpfeiler des modernen NLP geworden.
Schauen wir uns die wichtigsten Bausteine an.
Die Transformers-Bibliothek ist eine umfangreiche Suite moderner ML-Modelle speziell für NLP. Sie umfasst eine große Sammlung vortrainierter Modelle, optimiert für Aufgaben wie Textklassifikation, Textgenerierung, Übersetzung und Zusammenfassung – und mehr.
Hugging Face abstrahiert gängige NLP-Aufgaben über die einfach zu nutzende Methode `pipeline()` – eine API, mit der sich komplexe Modelle schnell auf reale Probleme anwenden lassen. Wenn du tiefer einsteigen willst, lies am besten den Artikel An Introduction to Using Transformers and Hugging Face.
Die Modelle sind leicht zugänglich und anpassbar – ein echter Fortschritt für Entwicklerinnen, Entwickler und Forschende, weil anspruchsvolle NLP-Modelle so viel näher rücken.
Der größte Mehrwert: Die Bibliothek kapselt die Komplexität von Training und Deployment, sodass sich fortgeschrittene NLP-Funktionen mit wenig Code einsetzen lassen.
So kannst du vortrainierte Modelle nutzen, ohne in die Algorithmen im Hintergrund eintauchen zu müssen.
Die Transformers-Bibliothek vereinfacht die Umsetzung von NLP-Modellen insbesondere durch:
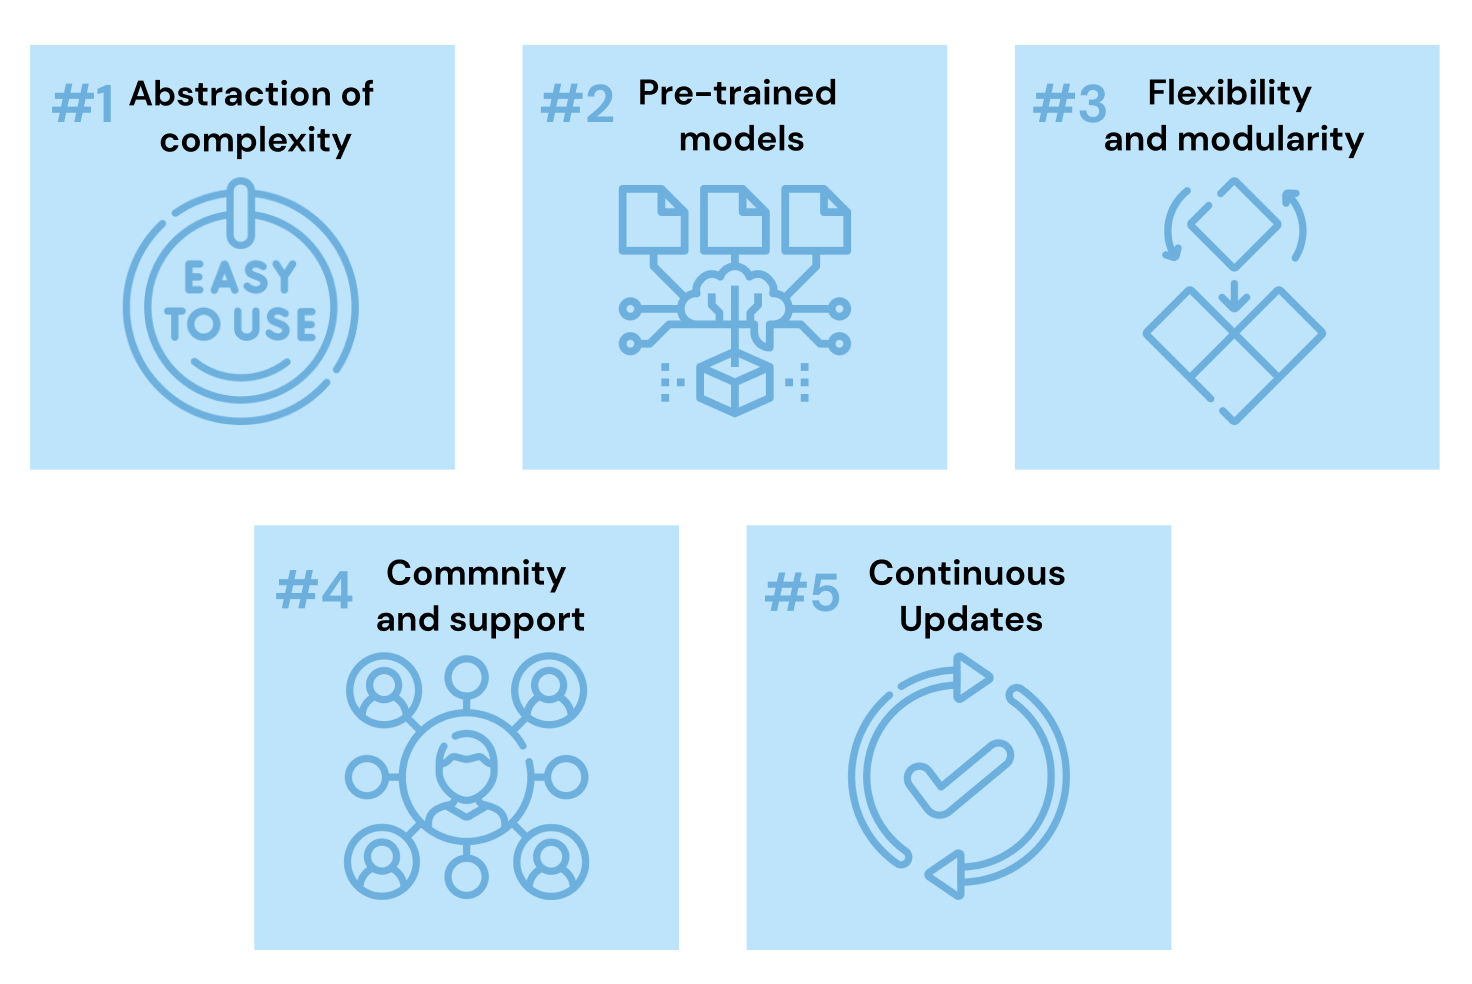
Wie viel Arbeit dir die Transformers-Bibliothek konkret abnimmt, siehst du im Tutorial Building a Transformer with PyTorch.
Der Model Hub ist das Gesicht der Community: eine Plattform, auf der dir Tausende Modelle und Datensätze zur Verfügung stehen. Hier teilt die Community ihre Modelle – und fördert so gemeinschaftliche Entwicklung im NLP.
Auf der Website kannst du den Model Hub über den Navigationspunkt Models aufrufen – dann siehst du eine Ansicht wie diese:
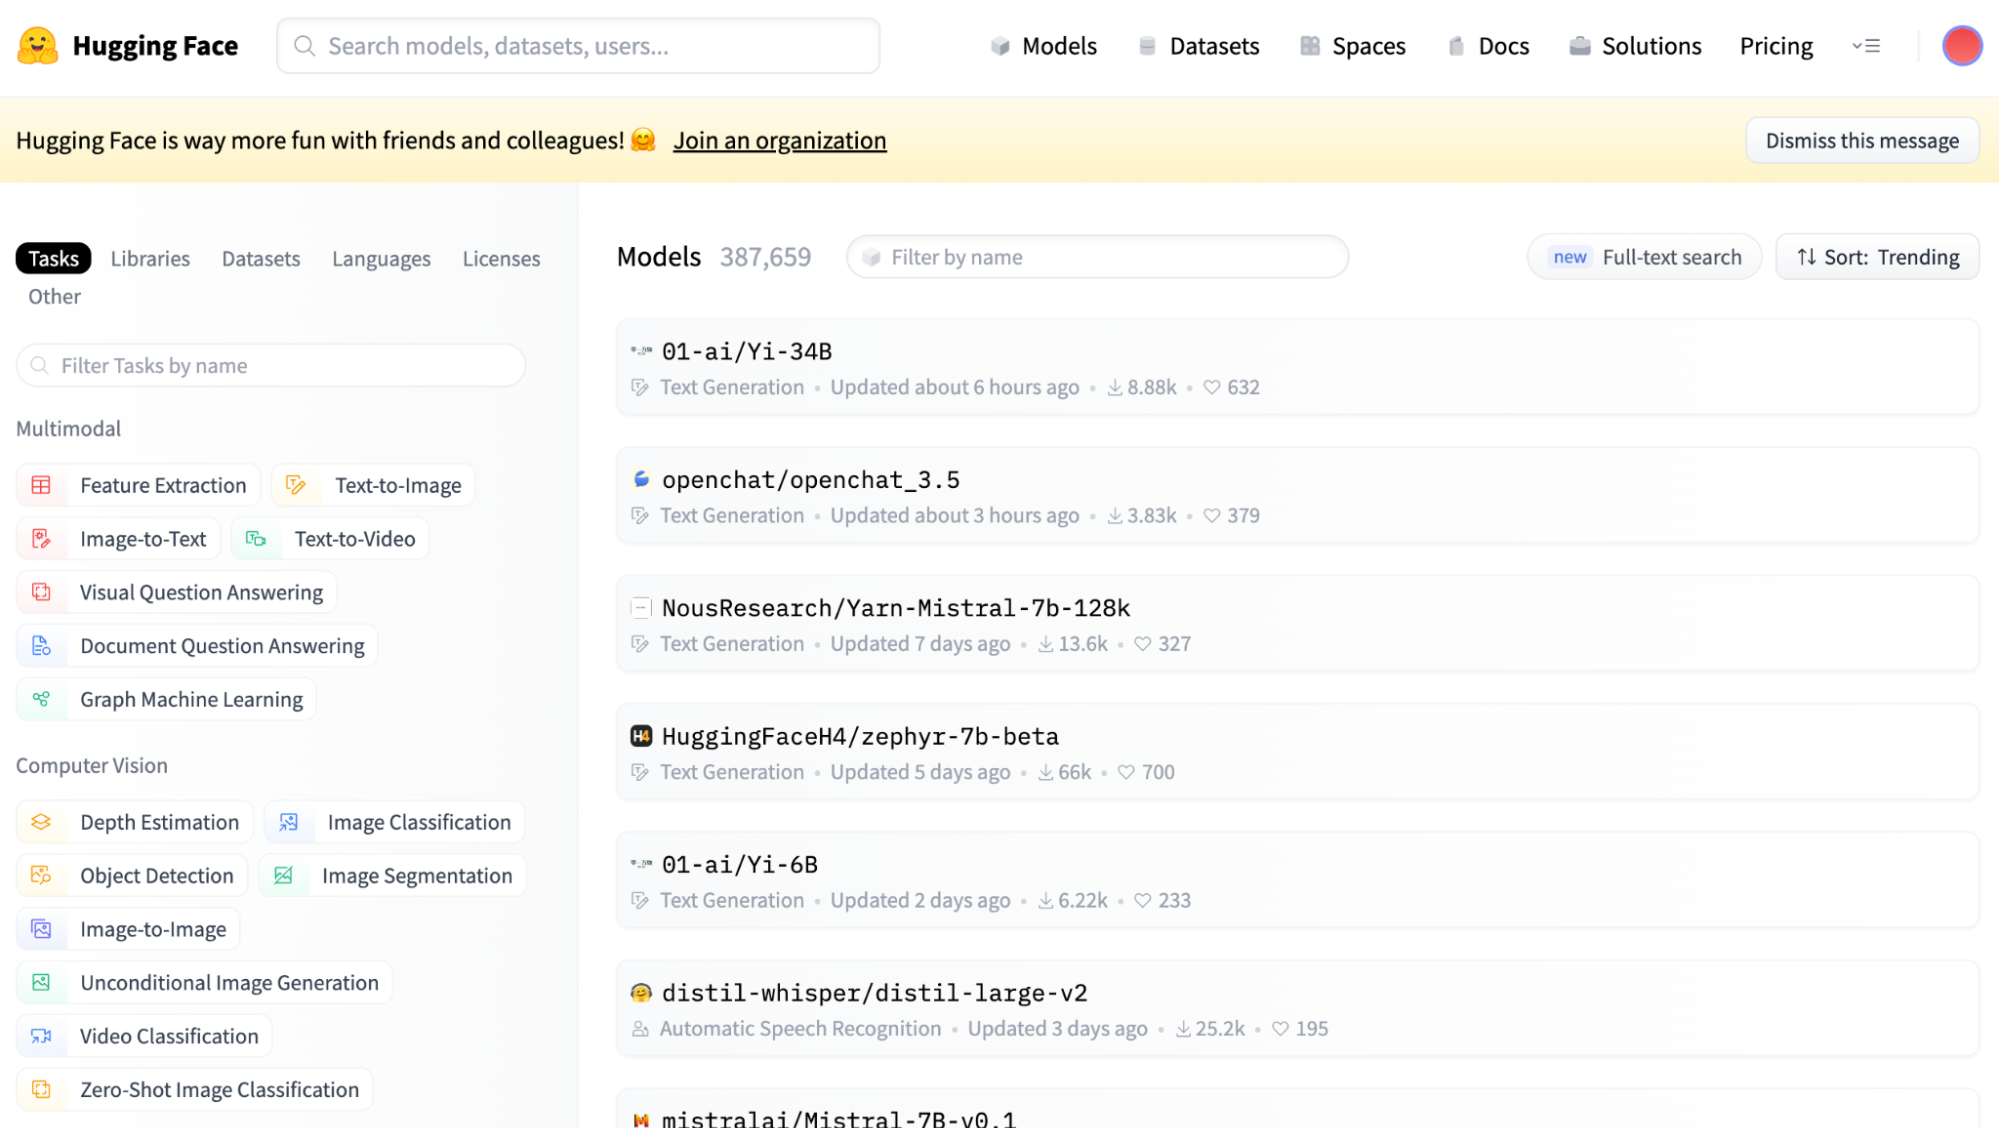
Screenshot der Hauptansicht des Hugging Face Model Hub.
Links findest du zahlreiche Filter passend zur gewünschten Aufgabe.
Das Beitragen eigener Modelle ist dank der bereitgestellten Tools einfach. Nach dem Upload kann die gesamte Community die Modelle direkt im Hub oder per Integration in die Transformers-Bibliothek nutzen.
Dieser leichte Zugang – sowohl zum Nutzen als auch zum Beitragen – schafft ein dynamisches Ökosystem, in dem State-of-the-Art-Modelle ständig verbessert und erweitert werden.
Tokenizer sind im NLP essenziell: Sie wandeln Text in ein Format um, das ML-Modelle verstehen – unerlässlich für unterschiedliche Sprachen und Textstrukturen.
Sie zerlegen Texte in Tokens – etwa Wörter, Subwörter oder Zeichen – und bereiten die Daten so für Modelle auf. Diese Tokens sind die Bausteine, mit denen Modelle menschliche Sprache verstehen und generieren.
Zudem wandeln sie Tokens in Vektoren für den Modelleingang um und kümmern sich um Padding und Kürzung für einheitliche Sequenzlängen.
Hugging Face stellt benutzerfreundliche, auf die Transformers-Bibliothek optimierte Tokenizer bereit – der Schlüssel für reibungsloses Text-Preprocessing. Mehr dazu im Artikel What is Tokenization.
Ein weiterer Kernbaustein ist die Datasets-Bibliothek von Hugging Face – ein großer Fundus an NLP-Datensätzen für Training und Benchmarking von ML-Modellen.
Diese Bibliothek ist für Entwicklerinnen und Entwickler extrem hilfreich: Sie bietet vielfältige Datensätze zum Trainieren, Testen und Benchmarken von NLP-Modellen über viele Aufgaben hinweg.
Besonders praktisch ist die einfache, nutzerfreundliche Schnittstelle. Im Hub kannst du Datensätze durchsuchen – und in deinem Code mit der Datasets-Bibliothek bequem herunterladen und einsetzen.
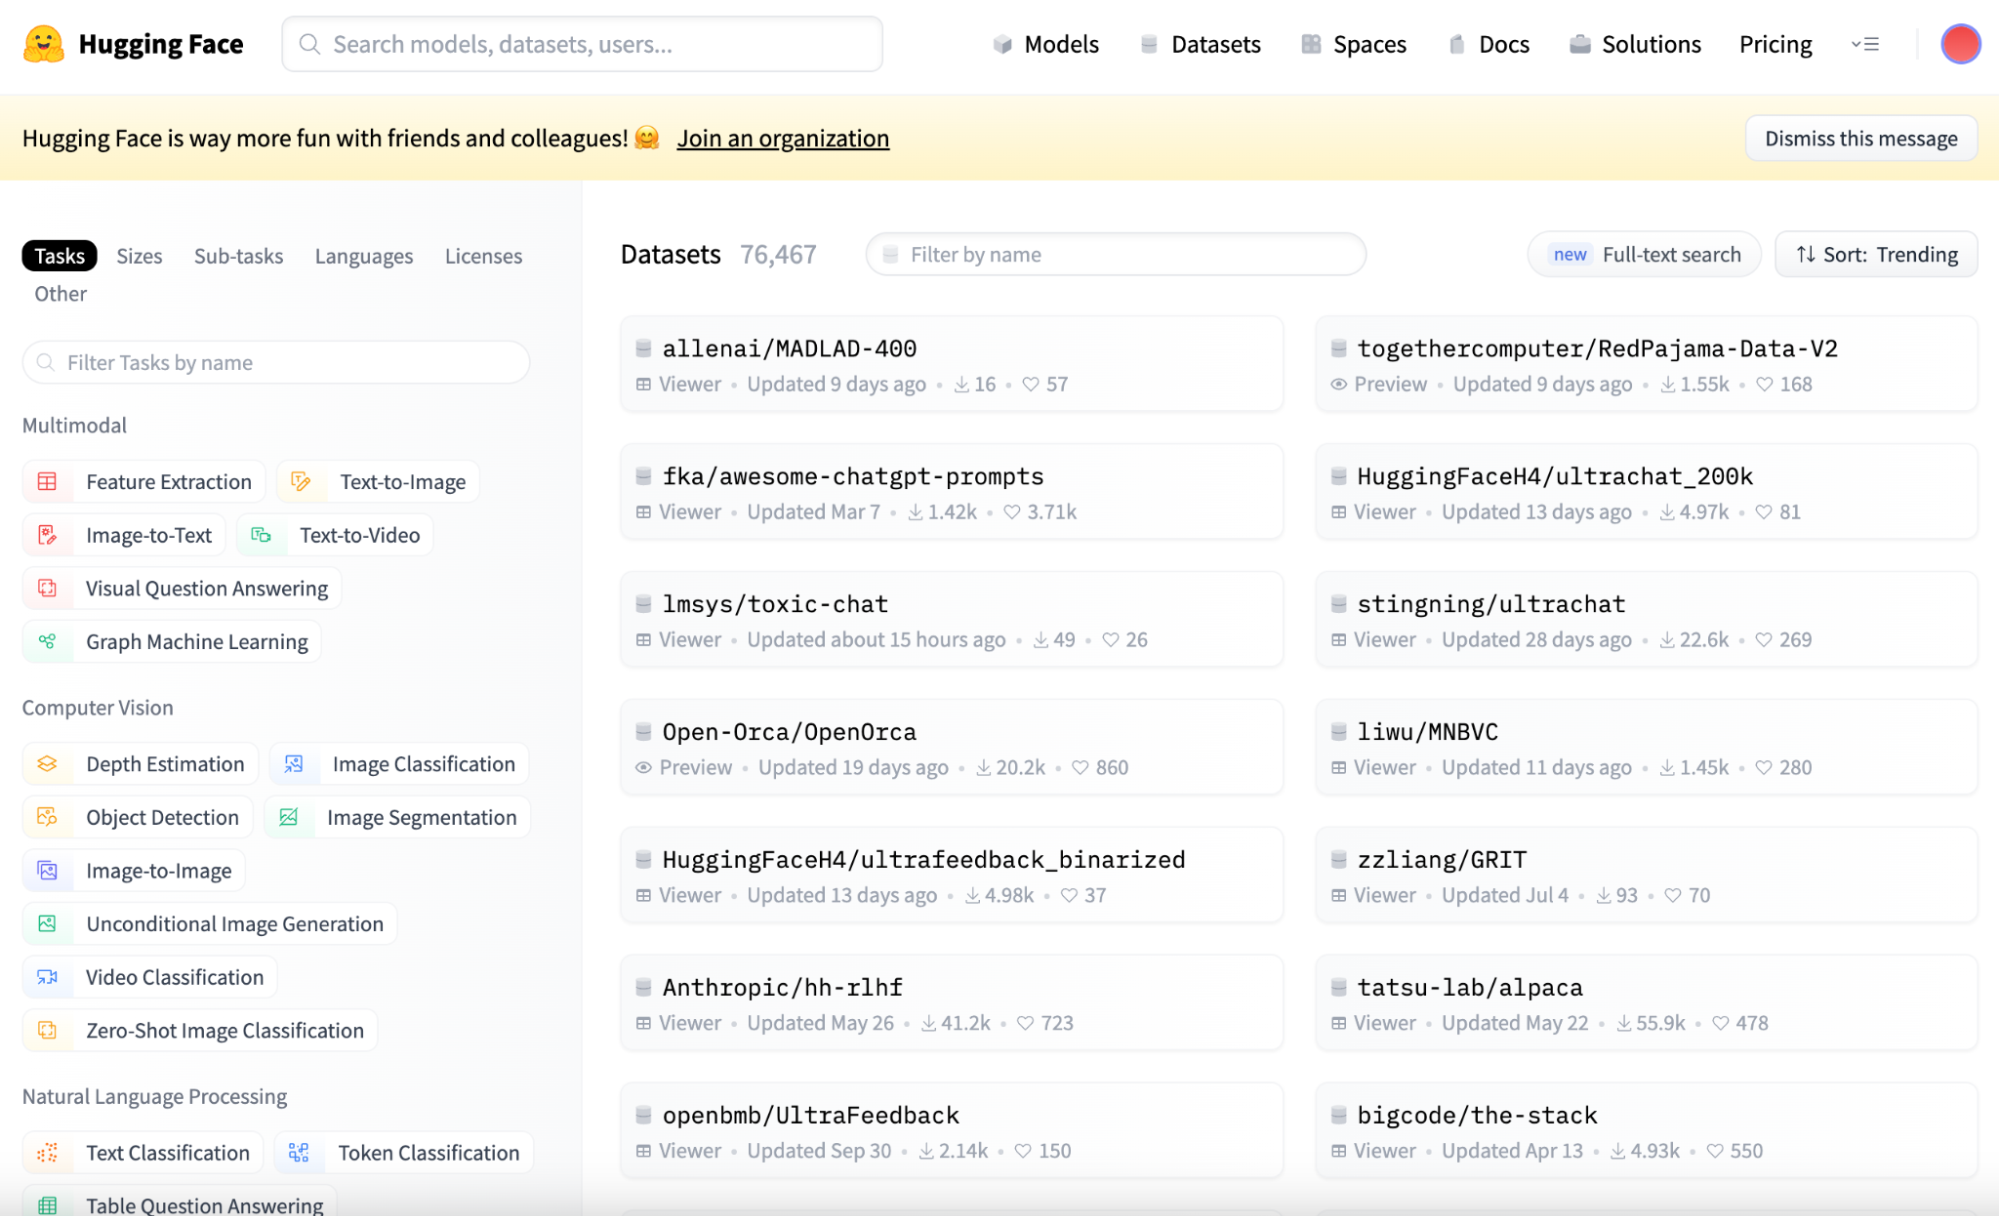
Screenshot der Hauptansicht von Hugging Face Datasets.
Es gibt Datensätze für gängige Aufgaben wie Textklassifikation, Übersetzung oder Question Answering – und spezialisierte Sets für besondere Herausforderungen.
Jetzt, da die Grundlagen klar sind, schauen wir uns an, wie du dieses technische Schmuckstück in der Praxis nutzt.
Diese Kurz-Anleitung führt dich durch Installation, Nutzung vortrainierter Modelle, Fine-Tuning und das Teilen deiner Modelle mit der Community.
Zuerst kombinierst du die transformers-Bibliothek mit deinem bevorzugten Deep-Learning-Framework – TensorFlow oder PyTorch.
Die Installation von transformers erfolgt bequem über pip, den Python-Paketmanager.
pip install transformers
Für den vollen Funktionsumfang installierst du zusätzlich datasets und tokenizers.
pip install tokenizers, datasets
Im Model Hub findest du eine große Sammlung vortrainierter Modelle für unterschiedlichste NLP-Aufgaben. So nutzt du dein erstes Modell:
1. Wähle ein vortrainiertes Modell: Gehe dazu in den Model Hub.
Angenommen, wir wollen die Stimmung in einem Text erkennen. Über den Filter „Text Classification“ in der linken Seitenleiste grenzen wir die Modelle ein.
Die Modelle sind standardmäßig nach Trending sortiert. Die obersten Ergebnisse sind meist am häufigsten genutzt. Wir wählen den zweiten Eintrag – ein sehr verbreitetes Sentiment-Analyse-Modell.
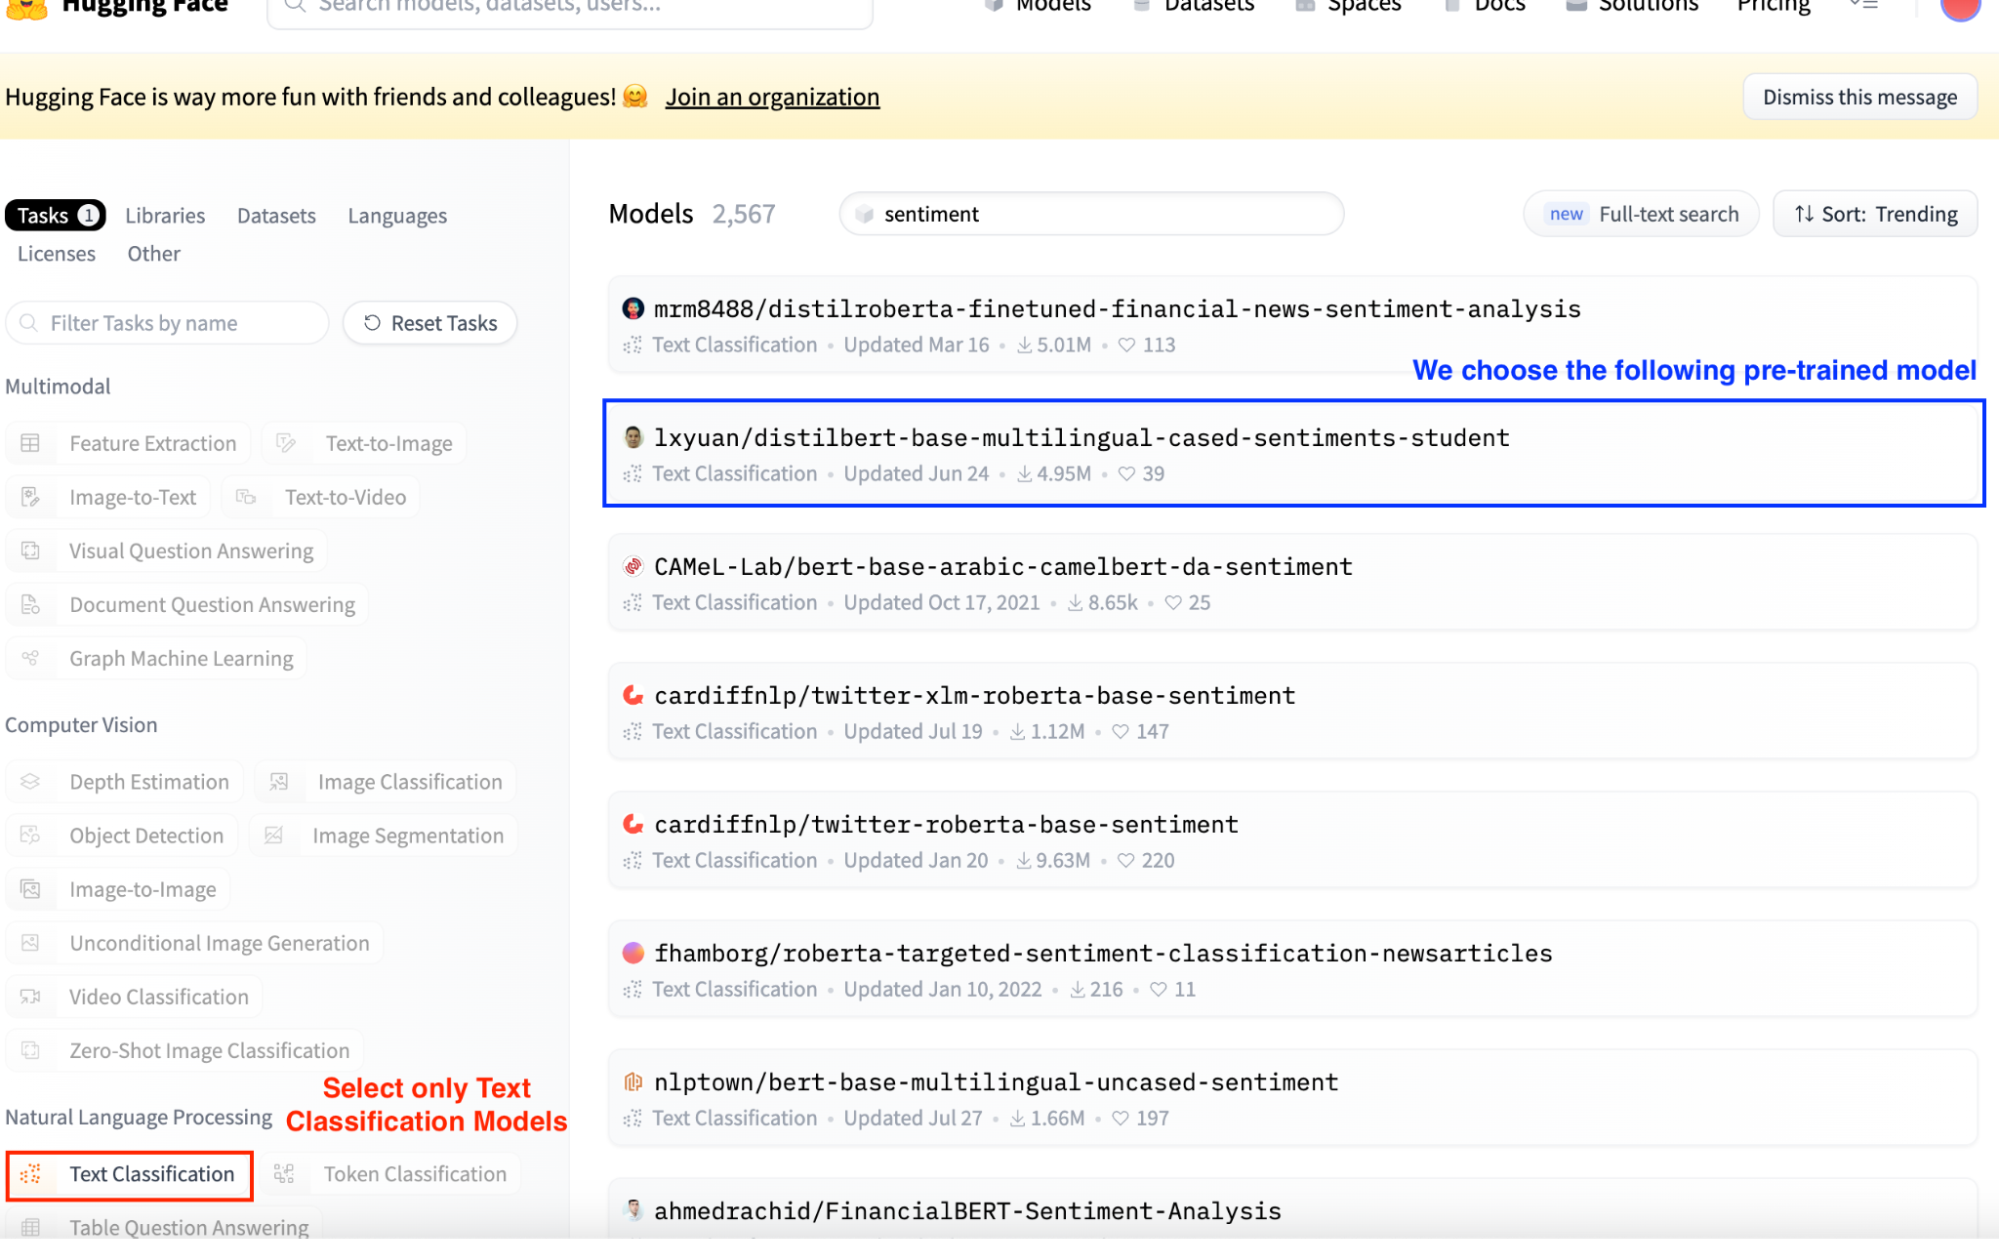
Screenshot der Model-Hub-Ansicht mit Auswahl von Textklassifikationsmodellen.
Um es zu verwenden, kopieren wir den Modellnamen – er steht im oberen Bereich der Modellseite.
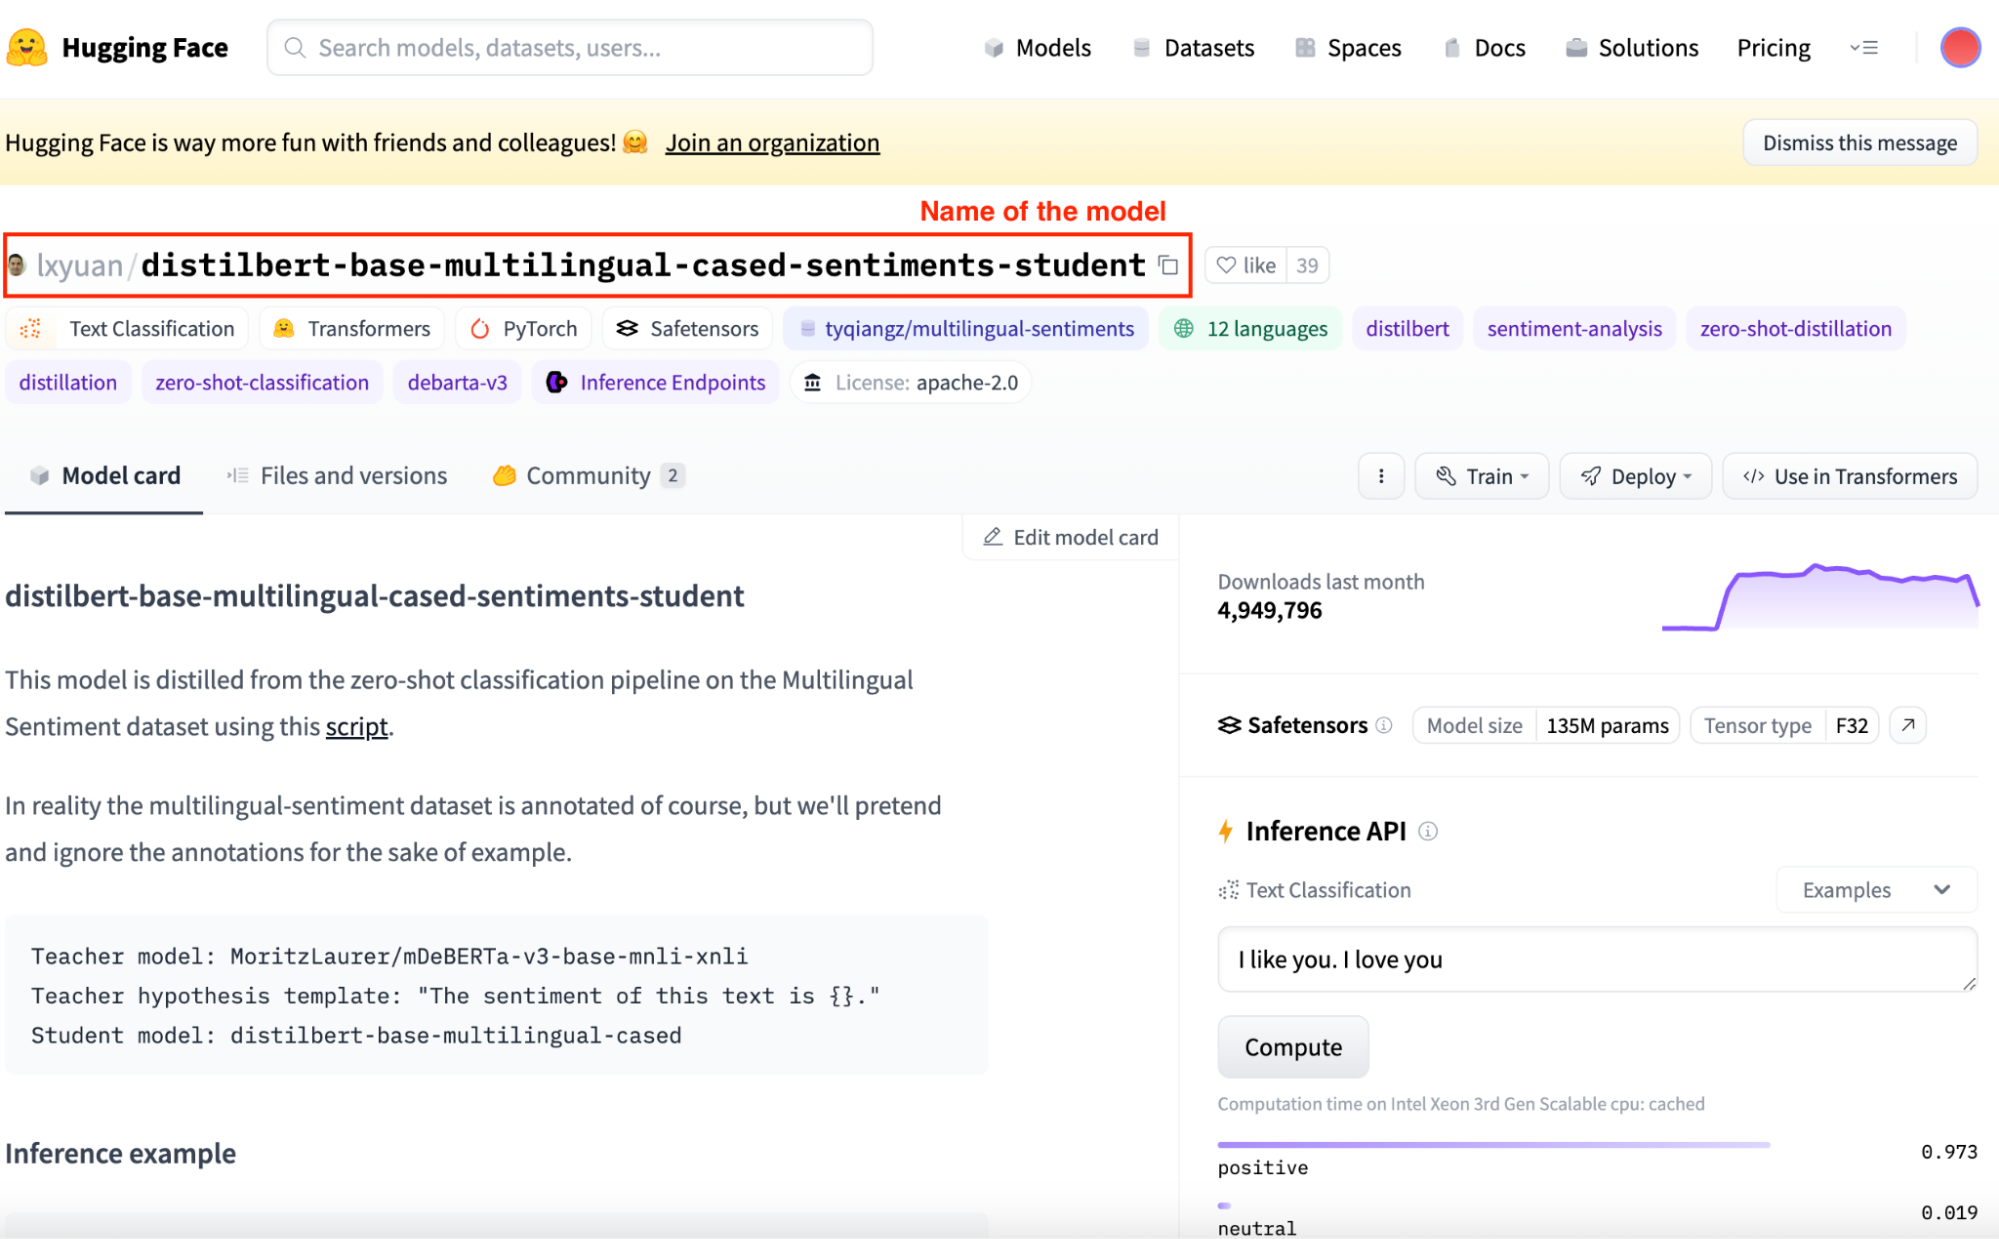
Screenshot der Detailansicht eines Modells im Hugging Face Model Hub.
1. Ein vortrainiertes Modell laden: Jetzt binden wir es in Python ein. Zuerst importieren wir AutoTokenizer und AutoModelForSequenceClassification aus transformers.
Diese AutoModel-Klassen leiten die Architektur anhand des Modellnamens automatisch ab.
from transformers import AutoTokenizer, AutoModelForSequenceClassification

model_name = "lxyuan/distilbert-base-multilingual-cased-sentiments-student"

# Wir definieren ein Modellobjekt
model = AutoModelForSequenceClassification.from_pretrained(model_name)
2. Eingaben vorbereiten: Lade den passenden Tokenizer. Die Bibliothek erkennt den richtigen Tokenizer aus dem Modellnamen.
# Wir laden die Tokenizer-Klasse
tokenizer = AutoTokenizer.from_pretrained(model_name)
3. Modell ausführen: Erzeuge ein Pipeline-Objekt mit Modell, Tokenizer und Aufgabe – hier Sentiment-Analyse. Übergibst du nur die Aufgabe, wählt die Pipeline Standardwerte; das ist bequem, aber für Produktion nicht empfohlen.
# Initialisierung eines Klassifikators mit Modell und Tokenizer
classifier = pipeline("sentiment-analysis", model = model, tokenizer = tokenizer)
# Übergibst du nur die Aufgabe, leitet pipeline Modell und Tokenizer ab.
classifier = pipeline("sentiment-analysis")
Jetzt führen wir das Modell mit einer Eingabe aus.
output = classifier("I've been waiting for this tutorial all my life!")
4. Ausgaben interpretieren: Das Modell gibt – je nach Klasse – verschiedene Elemente zurück. Bei Sentiment-Analyse z. B. sieht das so aus:
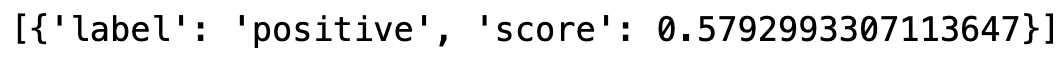
Ausgabeergebnis.
Beim Fine-Tuning passt du ein vortrainiertes Modell mit einem aufgabenspezifischen Datensatz weiter an. So nutzt du die gelernten Repräsentationen und optimierst sie für deinen Anwendungsfall.
Angenommen, wir wollen die Stimmung in Tweets erkennen. Funktioniert das vortrainierte Modell „out of the box“ gut genug?
Um die Performance zu verbessern, trainieren wir es per Fine-Tuning auf einem Datensatz mit Tweets und den passenden Sentiment-Labels.
Ein einfaches Beispiel für Fine-Tuning bei Sequenzklassifikation:
1. Modell und Datensatz wählen: Wir bleiben beim Sentiment-Modell, brauchen aber passende Trainingsdaten.
Hier kommt die datasets-Bibliothek ins Spiel. Im Hub suchen wir einen geeigneten Datensatz.
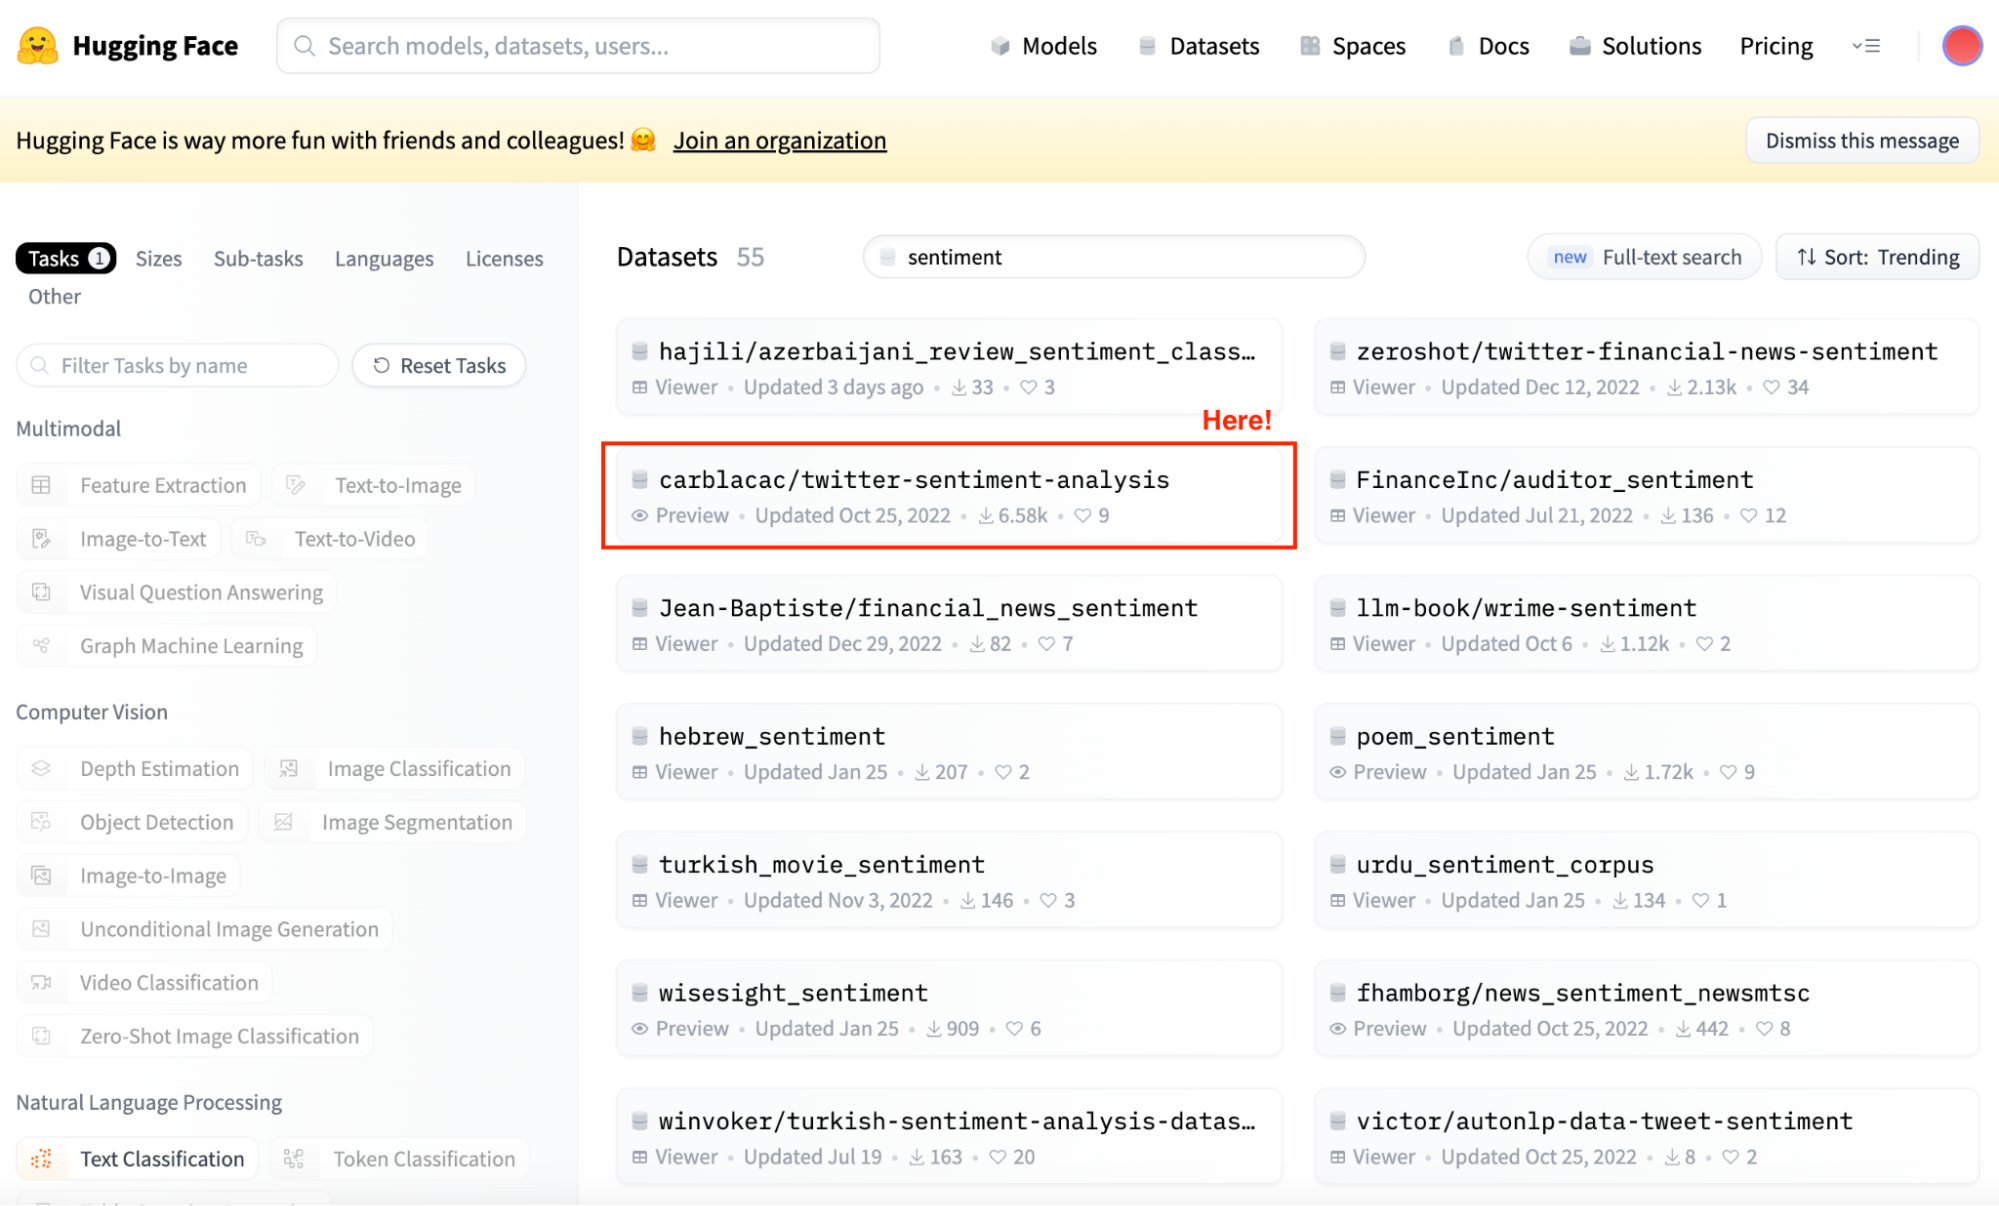
Screenshot des Datasets Hub mit Auswahl von Sentiment-Analyse-Datensätzen.
Nachdem der Datensatz feststeht, initialisieren wir Modell und Daten.
model = AutoModelForSequenceClassification.from_pretrained(model_name)

# Datensatz zum Training laden
dataset = load_dataset("mteb/tweet_sentiment_extraction")
Der geladene Datensatz ist ein Dictionary mit Trainings- und Testanteil. Konvertiert man das Training-Subset in ein DataFrame, sieht es so aus:
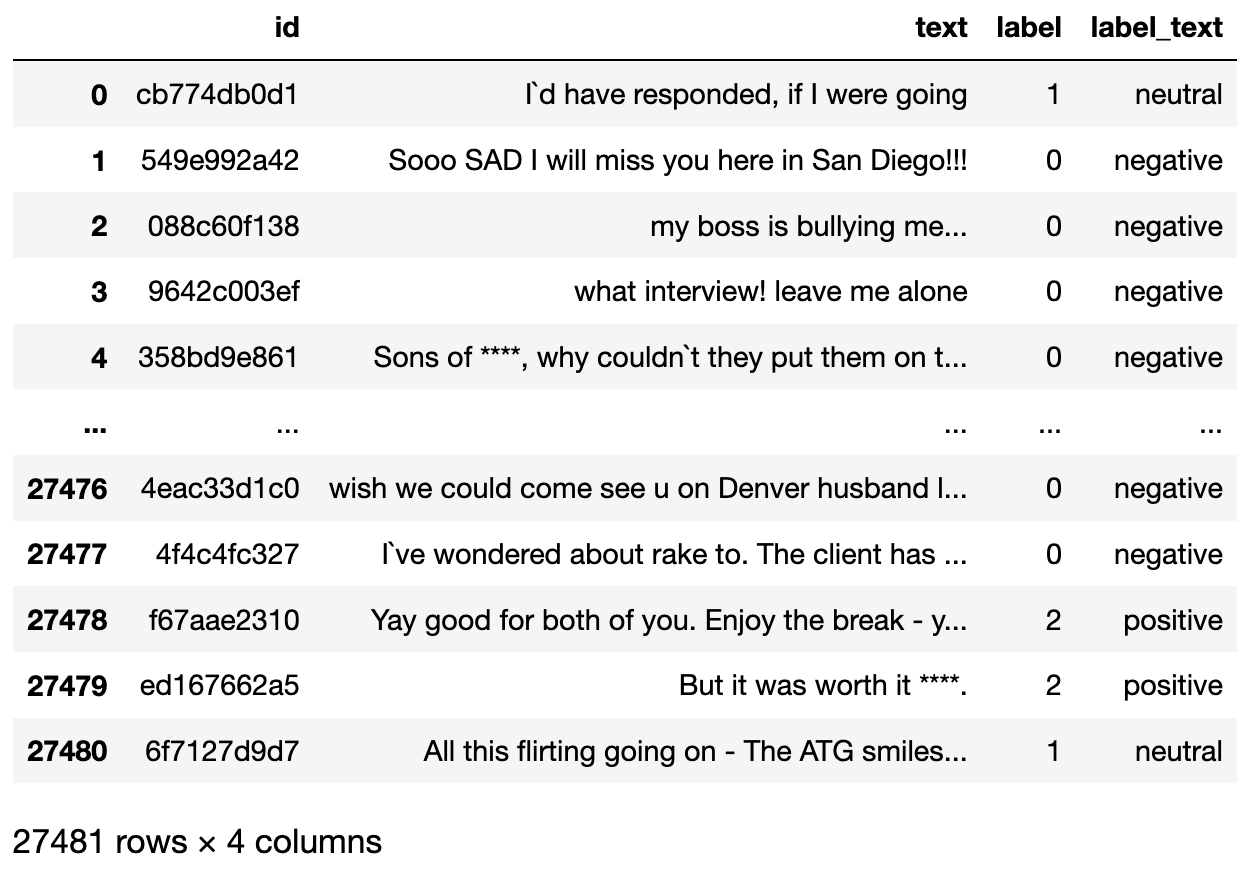
Der verwendete Datensatz.
2. Datensatz vorbereiten: Wir benötigen einen Tokenizer, um den Text für das Modell aufzubereiten. Die Textspalte wird tokenisiert, damit wir fine-tunen können.
Dafür laden wir einen vortrainierten Tokenizer und tokenisieren den Datensatz für das Fine-Tuning.
tokenizer = AutoTokenizer.from_pretrained(model_name)

def tokenize_function(examples):
    return tokenizer(examples["text"], padding="max_length", truncation=True)

tokenized_datasets = dataset.map(tokenize_function, batched=True)
3. PyTorch-Datensätze mit Encodings bauen: Erzeuge Trainings- und Testdaten. Train dient dem Fine-Tuning, Test der Evaluation.
Fine-Tuning kann lange dauern. Für das Tutorial ziehen wir zufällige Stichproben, um die Rechenzeit zu senken.
from datasets import load_dataset

model = AutoModelForSequenceClassification.from_pretrained(model_name)

# Datensatz zum Training laden
dataset = load_dataset("mteb/tweet_sentiment_extraction")

small_train_dataset = tokenized_datasets["train"].shuffle(seed=42).select(range(1000))
small_eval_dataset = tokenized_datasets["test"].shuffle(seed=42).select(range(1000))
4. Modell feinabstimmen: Definiere Trainingsargumente und starte das Training. Die trainer()-Klasse in transformers übernimmt den Rest.
Wir legen zunächst die Trainingsparameter und die Evaluationsstrategie fest. Danach trainieren wir das Modell mit train().
from transformers import Trainer, TrainingArguments
import numpy as np

training_args = TrainingArguments(output_dir="trainer_output", evaluation_strategy="epoch")

metric = evaluate.load("accuracy")

def compute_metrics(eval_pred):
    logits, labels = eval_pred
    predictions = np.argmax(logits, axis=-1)
    return metric.compute(predictions=predictions, references=labels)


trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=small_train_dataset,
    eval_dataset=small_eval_dataset,
    compute_metrics=compute_metrics,
)
trainer.train()
5. Modell evaluieren: Nach dem Training bewertest du die Performance auf einem Validierungs- oder Testset. Der Trainer bietet dafür eine evaluate-Methode.
import evaluate

trainer.evaluate()
Unser feinabgestimmtes Modell erreicht 70% Genauigkeit.
Wie teilen wir das verbesserte Modell jetzt mit der Community? Das ist der letzte Schritt.
Sobald du dein Modell feinabgestimmt hast, kannst du es mit der Community teilen.
Hugging Face macht das einfach. Zuerst installierst du die Bibliothek huggingface_hub.
Voraussetzung ist ein aktives Token für die Verbindung zu deinem Hugging Face Account. Hier erfährst du Schritt für Schritt, wie du es bekommst. In Jupyter Notebooks kannst du dafür notebook_login verwenden.
from huggingface_hub import notebook_login

notebook_login()
Daraufhin öffnet sich in deinem Notebook ein Login. Gib dort dein Token ein – und schon ist dein Notebook mit deinem Hugging Face Konto verbunden.
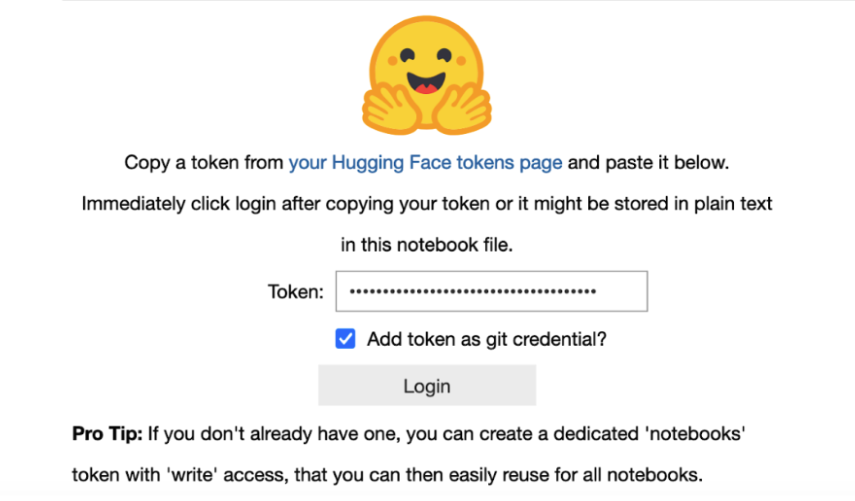
Jetzt lädst du dein Modell mit push_to_hub hoch.
finetuned_model.push_to_hub("my-awesome-model")
Anschließend ist das Modell in deinem Hugging Face Profil für alle verfügbar.
Viele NLP-Prozesse lassen sich mit Hugging Face auf drei einfache Schritte und weniger als fünf Zeilen Code herunterbrechen:
1. Modellobjekt mit der Pipeline-Klasse definieren (inklusive Modell und Tokenizer).
2. Eingabetext oder Prompt festlegen.
3. Vortrainiertes Modell mit der Eingabe ausführen und das Ergebnis betrachten.
Textklassifikation ist eine grundlegende NLP-Aufgabe. Sie ordnet jedem Text eine oder mehrere Kategorien zu – etwa für Spam-Erkennung, Sentiment-Analyse, Themen-Labeling und mehr.
Wie du siehst, reicht oft das 3-Schritte-Muster aus, um ein Textklassifikationsmodell zu nutzen:
# Wir importieren die pipeline-Funktion aus transformers
from transformers import pipeline

# Vortrainiertes Textklassifikationsmodell laden
classifier = pipeline("text-classification",model='lxyuan/distilbert-base-multilingual-cased-sentiments-student')

# Zu klassifizierender Input
input_ = "I absolutely love the transformers library!"

# Klassifikation durchführen
output_ = classifier(input_)

# Ergebnis ansehen
print(output_)
Einfach, oder?
Dann weiter zum zweiten – und wohl meistgenutzten – Anwendungsfall.
Die meisten kennen bereits ChatGPT oder Google Bard – Tools, die aus einem Prompt Text generieren. Dieses Verfahren heißt Textgenerierung und ermöglicht es Modellen, menschenähnlichen Text zu erstellen.
Anwendungen reichen von Chatbot-Antworten bis zu kreativen Texten.
Dafür werden Modelle auf großen Textkorpora trainiert und lernen Muster, Stile und Sprachstrukturen. Der teuerste Teil ist das Training.
Mit Hugging Face lässt sich das Ganze dennoch in wenigen Zeilen Code umsetzen – ähnlich wie zuvor.
Ein Beispiel:
from transformers import pipeline

generator = pipeline('text-generation', model='gpt2')

prompt = "In a world dominated by AI,"

generated_text = generator(prompt, max_length=50)[0]['generated_text']

print(generated_text)
Question Answering (QA) baut Systeme, die Fragen in natürlicher Sprache automatisch beantworten.
Einsatzgebiete sind virtuelle Assistenten, Support und Informationssuche.
Man unterscheidet grob zwei Typen:
Typischerweise kombinieren diese Systeme Sprachverständnis mit Informationssuche.
Auch hier ist die Umsetzung mit Hugging Face schnell erledigt:
from transformers import pipeline

qa_pipeline = pipeline('question-answering', model='distilbert-base-uncased-distilled-squad')

context = """Paris is the capital and most populous city of France. The city has an area of 105 square kilometers and a population of 2,140,526 residents."""
question = "What is the population of Paris?"

answer = qa_pipeline(question=question, context=context)
print(answer)
Zum Schluss: maschinelle Übersetzung. Machine Translation ist ein Teilgebiet der Computerlinguistik, das Text oder Sprache automatisch zwischen Sprachen überträgt. Mit Deep Learning haben NMT-Modelle (Neural Machine Translation) große Fortschritte gemacht.
Moderne NMT-Systeme lernen Übersetzungen auf Basis großer zweisprachiger Datensätze mit Sequence-to-Sequence-Architekturen: Ein Encoder verarbeitet die Ausgangssprache, ein Decoder erzeugt den Zieltext – oft sehr flüssig und präzise.
Ein einfaches Beispiel mit Hugging Face:
from transformers import pipeline

# Übersetzungspipeline für Englisch nach Deutsch laden
translator = pipeline('translation_en_to_de')

# Zu übersetzender Text
text_to_translate = "This is a great day for science!"

# Übersetzung durchführen
translation = translator(text_to_translate, max_length=40)

# Übersetzten Text ausgeben
print(translation[0]['translation_text'])
Hugging Face ist zu einer treibenden Kraft in KI und NLP geworden. Die umfassenden Tools – allen voran die Transformers-Bibliothek, der kollaborative Model Hub und die umfangreichen Datasets – machen fortgeschrittene NLP-Funktionen für viele zugänglich.
Indem Innovationen offen geteilt und gemeinsam weiterentwickelt werden, trägt Hugging Face nicht nur zum Fortschritt der KI bei – es formt eine Zukunft, in der Technologie zugänglicher, inklusiver und leistungsfähiger ist.
Während wir die KI-Revolution miterleben und mitgestalten, erinnert uns Hugging Face daran: Die größten Sprünge gelingen, wenn wir offen teilen und gemeinsam bauen.
Es geht nicht nur um smartere Maschinen, sondern um eine vernetzte, lernende Community aus Entwicklerinnen, Forschern und Enthusiastinnen, die die Grenzen des Möglichen verschiebt.
Starte jetzt deine Reise in KI & NLP!
Lernpfad
Lernpfad
Kurs