
Lộ trình
Xử lý ngôn ngữ tự nhiên trong Python
20 giờ
Trong thế giới công nghệ thay đổi nhanh chóng ngày nay, Trí tuệ Nhân tạo nổi bật như một lĩnh vực trọng yếu và hiện hữu ở khắp nơi, len lỏi vào những trải nghiệm thường nhật của chúng ta. Ở trung tâm làn sóng AI này là Xử lý Ngôn ngữ Tự nhiên, một lĩnh vực tinh vi vận hành các công cụ đối thoại phổ biến như ChatGPT và Bard.
Điều gì sẽ xảy ra nếu hầu hết các mô hình tạo nên những công cụ này đều mở cho mọi người và tập trung tại một nơi duy nhất?
Xin giới thiệu: Hugging Face, một nhân tố thay đổi cuộc chơi trong machine learning và xử lý ngôn ngữ tự nhiên, đồng thời là tác nhân chủ chốt trong việc dân chủ hóa AI. Nhờ học chuyển giao, nền tảng này đang đóng vai trò quan trọng trong việc giúp AI dễ tiếp cận hơn.
Tính đến hôm nay, họ sở hữu thư viện NLP phổ biến nhất trong Python, với hơn 115 nghìn sao trên GitHub, và đã nổi lên như một trong những nền tảng then chốt để những người đam mê và chuyên gia AI thử nghiệm, triển khai và mở rộng mô hình của riêng mình.
Dù bạn là chuyên gia dữ liệu hay chỉ là người mới tò mò, Hugging Face có sẵn công cụ và tài nguyên để hiện thực hóa dự án AI của bạn, đẩy xa ranh giới của những gì có thể với machine learning.
Vậy hãy cùng khám phá Hugging Face mang đến điều gì!
Bạn cũng có thể tìm hiểu thêm về Cách sử dụng các mô hình AI mã nguồn mở với Hugging Face qua phần code-along của chúng tôi.
Với đa số mọi người, Hugging Face có thể chỉ là một biểu tượng cảm xúc nữa trên bàn phím điện thoại (🤗)
Tuy nhiên, trong giới công nghệ, đây là GitHub của thế giới ML — một nền tảng cộng tác ngập tràn công cụ giúp bất kỳ ai tạo, huấn luyện và triển khai các mô hình NLP và ML bằng mã nguồn mở.
Bước ngoặt mang tính cách mạng?
Các mô hình này đã được huấn luyện sẵn, giúp việc nhập môn NLP trở nên đơn giản hơn nhiều. Nói cách khác, các lập trình viên không còn phải bắt đầu từ con số không; họ chỉ cần tải một mô hình đã huấn luyện sẵn từ hub của Hugging Face, tinh chỉnh cho tác vụ cụ thể và bắt đầu từ đó.
Tính dễ dùng này giúp đơn giản hóa đáng kể quy trình phát triển.
Vì thế, Hugging Face là nơi các nhà khoa học dữ liệu, nhà nghiên cứu và kỹ sư ML hội tụ để trao đổi ý tưởng, tìm kiếm hỗ trợ và đóng góp cho các dự án mã nguồn mở.
Họ tự mô tả mình là:
“Cộng đồng AI để kiến tạo tương lai.”
Tầm nhìn này chính là một trong những bí quyết thành công của Hugging Face: cách tiếp cận dựa vào cộng đồng.
Một lý do khác cho tốc độ tăng trưởng mạnh mẽ là tính trực quan của nền tảng. Giao diện đơn giản giúp cả người mới lẫn chuyên gia đều dễ dàng bắt đầu.
Với mục tiêu lưu trữ bộ sưu tập tài nguyên NLP và ML lớn nhất, Hugging Face cam kết dân chủ hóa AI và đưa công nghệ này đến với cộng đồng toàn cầu.
Thành lập năm 2016, Hugging Face là một công ty Mỹ–Pháp hướng đến phát triển chatbot AI tương tác dành cho thanh thiếu niên. Tuy nhiên, sau khi mã nguồn mở mô hình vận hành chatbot này, họ nhanh chóng chuyển hướng sang một tầm nhìn lớn hơn: trang bị cho ngành AI những công cụ mạnh mẽ và dễ tiếp cận.
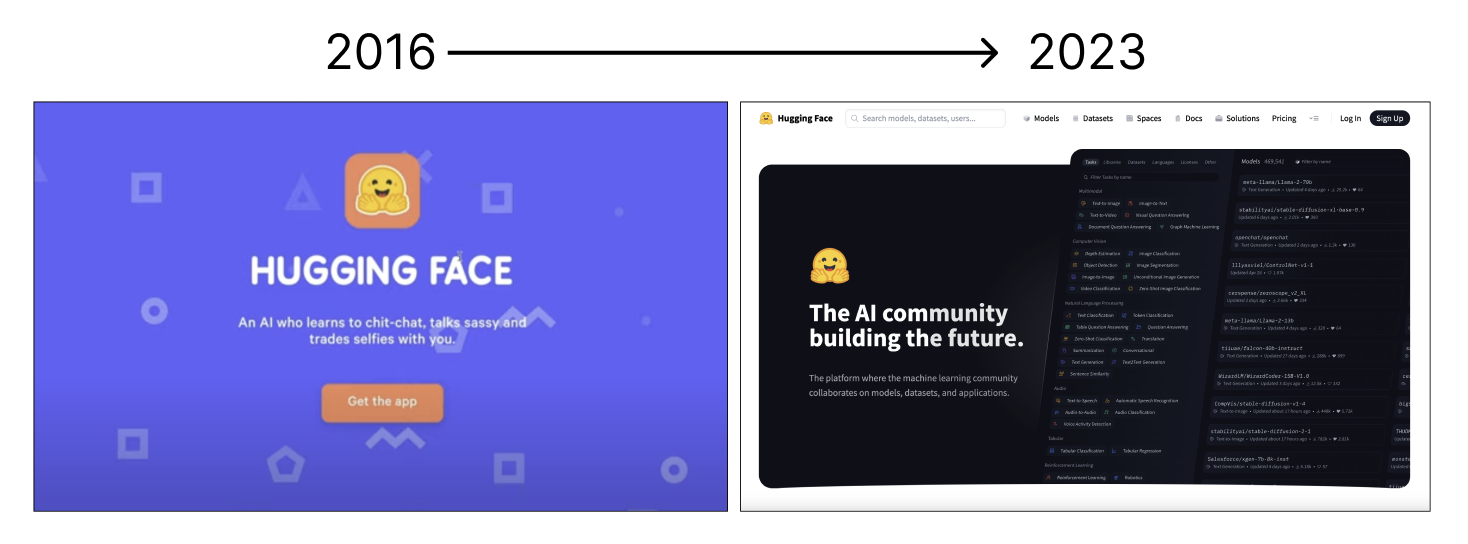
Hình ảnh của tác giả.
Sự ra mắt thư viện Transformers mang tính đột phá vào năm 2018 đánh dấu một trong những đóng góp lớn và nổi tiếng nhất của họ cho cộng đồng AI, cung cấp các mô hình tiền huấn luyện như BERT và GPT đã trở thành chuẩn mực trong các tác vụ NLP.
Ngày nay, HuggingFace đã hoàn toàn thay đổi hệ sinh thái ML. Cam kết hợp tác mã nguồn mở của họ đã xúc tác cho đổi mới trong NLP, cho phép công nghệ phát triển chung và cộng đồng cùng tiến bộ.
Nền tảng đã trở thành nút giao để chia sẻ mô hình và bộ dữ liệu, thúc đẩy nghiên cứu và ứng dụng thực tiễn trong AI.
Phương châm của họ?
“Dân chủ hóa Machine Learning tốt, từng lần commit một.”
Thông qua các hợp tác chiến lược và nỗ lực đưa công cụ NLP tiên tiến đến với đông đảo người dùng, Hugging Face đã trở thành phần không thể thiếu của cộng đồng, liên tục đẩy ranh giới AI và dân chủ hóa khả năng tiếp cận công nghệ tối tân.
Hugging Face đã trở thành nền tảng trụ cột của NLP hiện đại nhờ tập hợp các thành phần và tính năng cốt lõi đáp ứng nhiều nhu cầu xử lý ngôn ngữ.
Hãy cùng phân tích từng phần.
Thư viện Transformers là bộ sưu tập toàn diện các mô hình machine learning tối tân được thiết kế riêng cho NLP. Nó bao gồm một loạt mô hình tiền huấn luyện tối ưu cho các tác vụ như phân loại văn bản, sinh ngôn ngữ, dịch thuật và tóm tắt, v.v.
Hugging Face đã trừu tượng hóa các tác vụ NLP phổ biến thành phương thức `pipeline()` dễ dùng, một API thân thiện để thực hiện nhiều tác vụ. Các pipeline này cho phép người dùng dễ dàng áp dụng mô hình phức tạp vào bài toán thực tế. Nếu bạn muốn tìm hiểu thêm về thư viện này, tôi khuyến nghị đọc bài Giới thiệu về cách sử dụng Transformers và Hugging Face.
Các mô hình này dễ truy cập và tùy biến, mang tính cách mạng đối với nhà phát triển và nhà nghiên cứu, góp phần quan trọng giúp các mô hình NLP tinh vi trở nên phổ cập hơn.
Điểm quan trọng là khả năng trừu tượng hóa sự phức tạp khi huấn luyện và triển khai mô hình NLP, giúp người thực hành triển khai tính năng NLP nâng cao với rất ít mã.
Thư viện cho phép tận dụng các mô hình tiền huấn luyện mà không cần đi sâu vào thuật toán nền.
Transformers đơn giản hóa việc triển khai mô hình NLP theo vài cách chủ chốt:
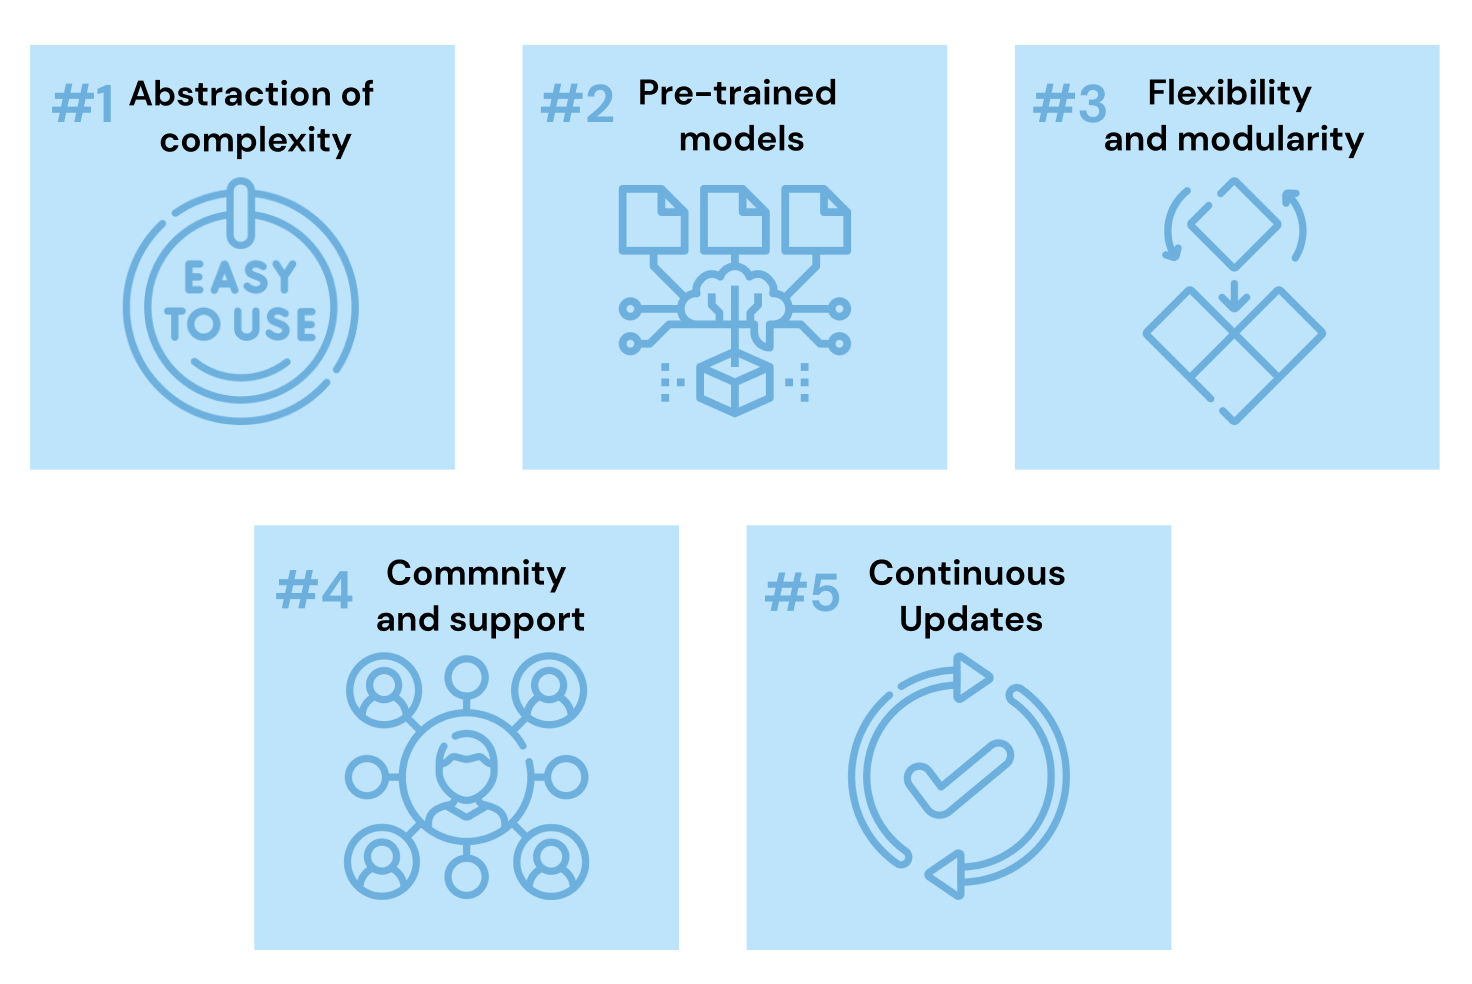
Nếu bạn muốn trực tiếp thấy thư viện transformers đã giúp chúng ta tiết kiệm bao nhiêu công sức, hãy học cách triển khai mô hình NLP với Xây dựng Transformer với PyTorch.
Model Hub là bộ mặt của cộng đồng, một nền tảng nơi hàng nghìn mô hình và bộ dữ liệu nằm trong tầm tay bạn. Đây là tính năng sáng tạo cho phép người dùng chia sẻ và khám phá các mô hình do cộng đồng đóng góp, thúc đẩy cách tiếp cận cộng tác trong phát triển NLP.
Bạn có thể vào xem trên trang chính thức của họ. Tại đó, bạn dễ dàng chọn Model Hub bằng cách nhấp vào nút Models trên thanh điều hướng, và một giao diện như sau sẽ xuất hiện:
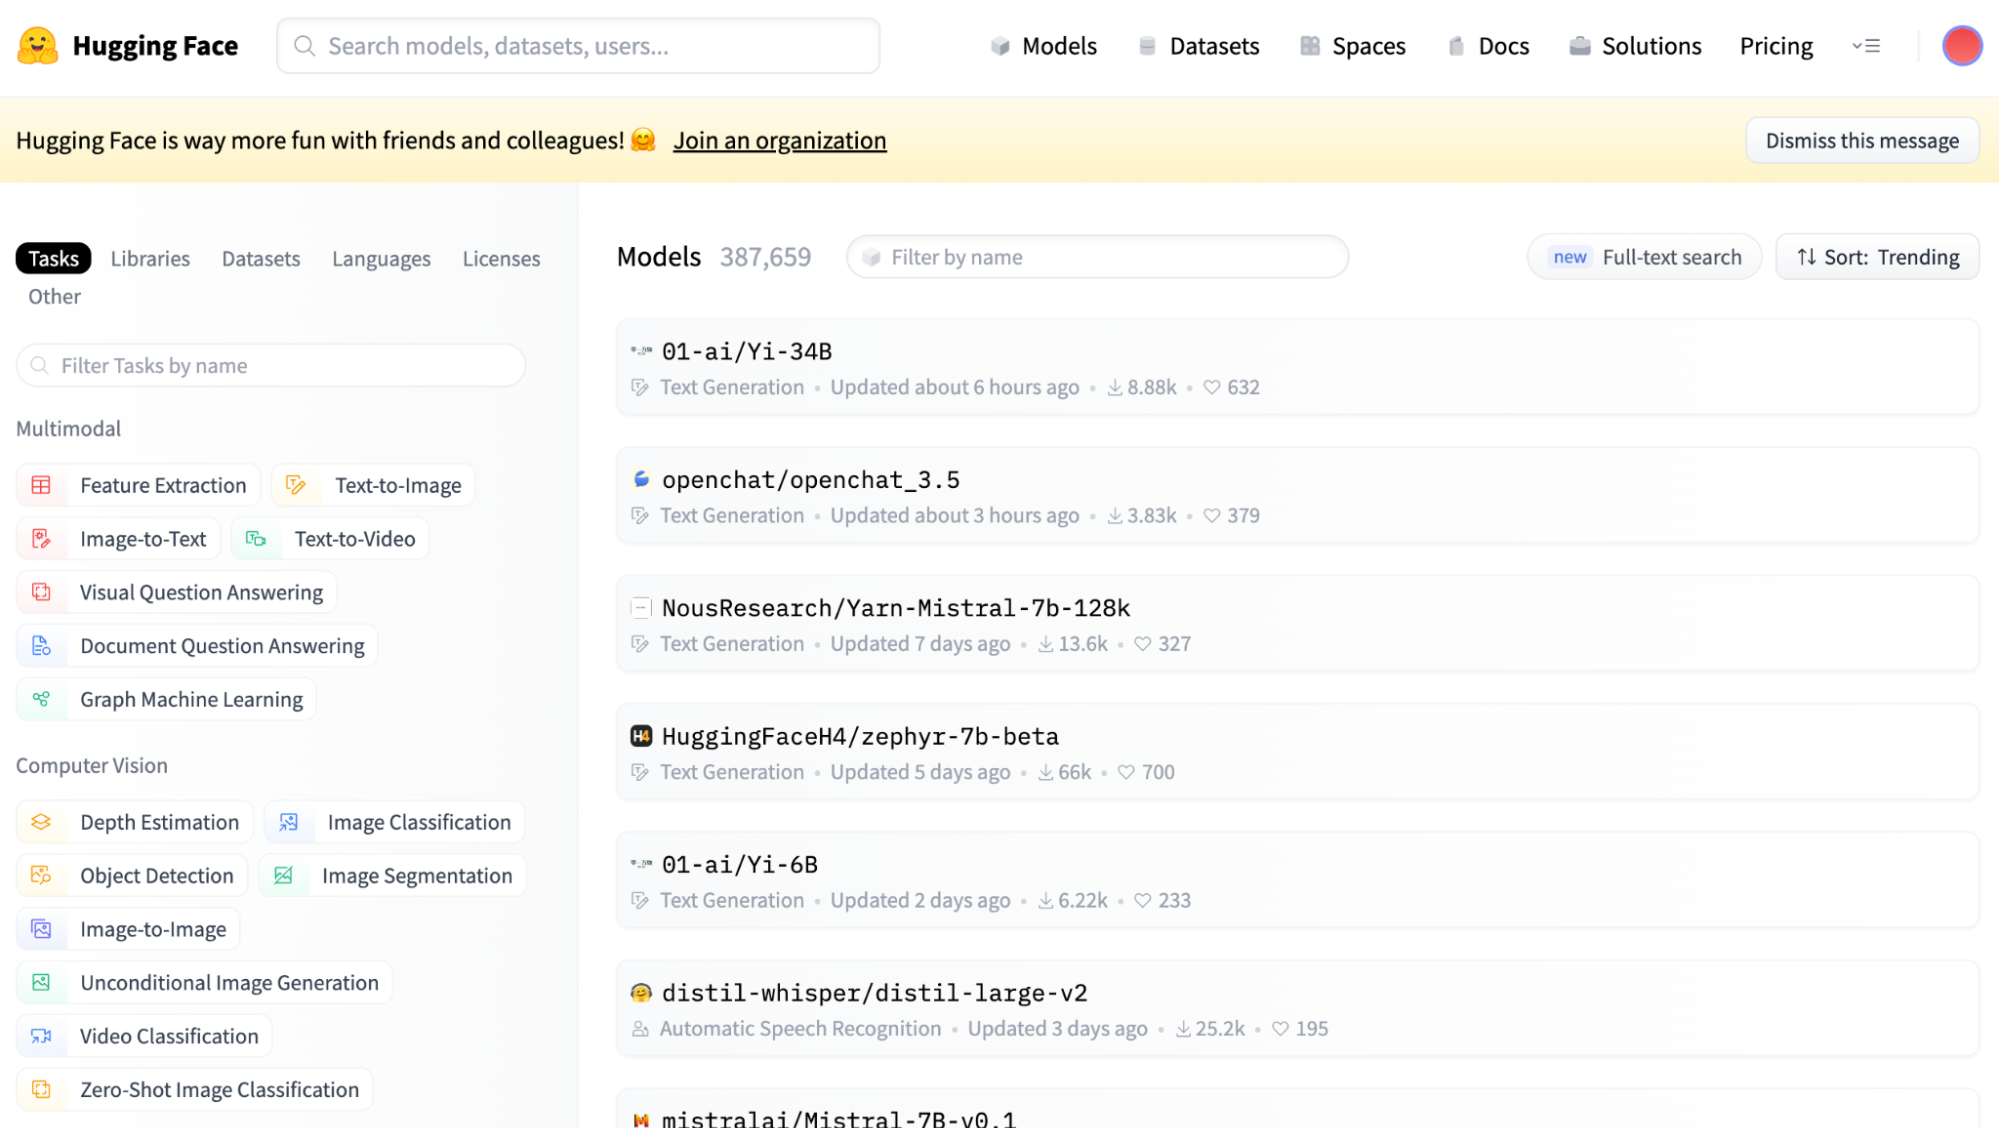
Ảnh chụp màn hình giao diện chính của Hugging Face Model Hub.
Như bạn thấy, ở thanh bên trái có nhiều bộ lọc theo tác vụ chính cần thực hiện.
Đóng góp cho Model Hub rất đơn giản nhờ các công cụ của Hugging Face, hướng dẫn người dùng qua quy trình tải mô hình lên. Khi đã đóng góp, các mô hình này sẵn sàng cho cả cộng đồng sử dụng, trực tiếp qua hub hoặc thông qua tích hợp với thư viện Transformers.
Tính dễ truy cập và đóng góp này nuôi dưỡng hệ sinh thái năng động, nơi các mô hình tối tân liên tục được tinh chỉnh và mở rộng, tạo nền tảng cộng tác phong phú cho tiến bộ NLP.
Tokenizer rất quan trọng trong NLP, vì chúng chuyển đổi văn bản sang định dạng mà mô hình machine learning có thể hiểu, điều cốt yếu để xử lý các ngôn ngữ và cấu trúc văn bản khác nhau.
Chúng có nhiệm vụ tách văn bản thành các token — đơn vị cơ bản như từ, từ con hoặc ký tự — chuẩn bị dữ liệu để mô hình machine learning xử lý. Các token này là viên gạch nền giúp mô hình hiểu và sinh ngôn ngữ tự nhiên của con người.
Chúng cũng hỗ trợ biến đổi token thành vector đầu vào cho mô hình và xử lý padding, cắt ngắn để độ dài chuỗi đồng nhất.
Hugging Face cung cấp nhiều tokenizer thân thiện, tối ưu cho thư viện Transformers, đóng vai trò then chốt trong tiền xử lý văn bản trơn tru. Bạn có thể đọc thêm về Tokenization trong một bài riêng.
Một thành phần chủ chốt khác là thư viện Hugging Face Datasets, một kho dữ liệu NLP khổng lồ hỗ trợ huấn luyện và đánh giá chuẩn các mô hình ML.
Thư viện này là công cụ thiết yếu cho nhà phát triển trong lĩnh vực, vì cung cấp bộ sưu tập dữ liệu đa dạng có thể dùng để huấn luyện, kiểm thử và đánh giá mọi mô hình NLP trên nhiều tác vụ.
Một lợi ích lớn là giao diện đơn giản, thân thiện. Bạn có thể duyệt và khám phá tất cả dataset trên Hugging Face Hub, còn khi dùng trong mã, thư viện datasets cho phép tải về bất kỳ dataset nào một cách dễ dàng.
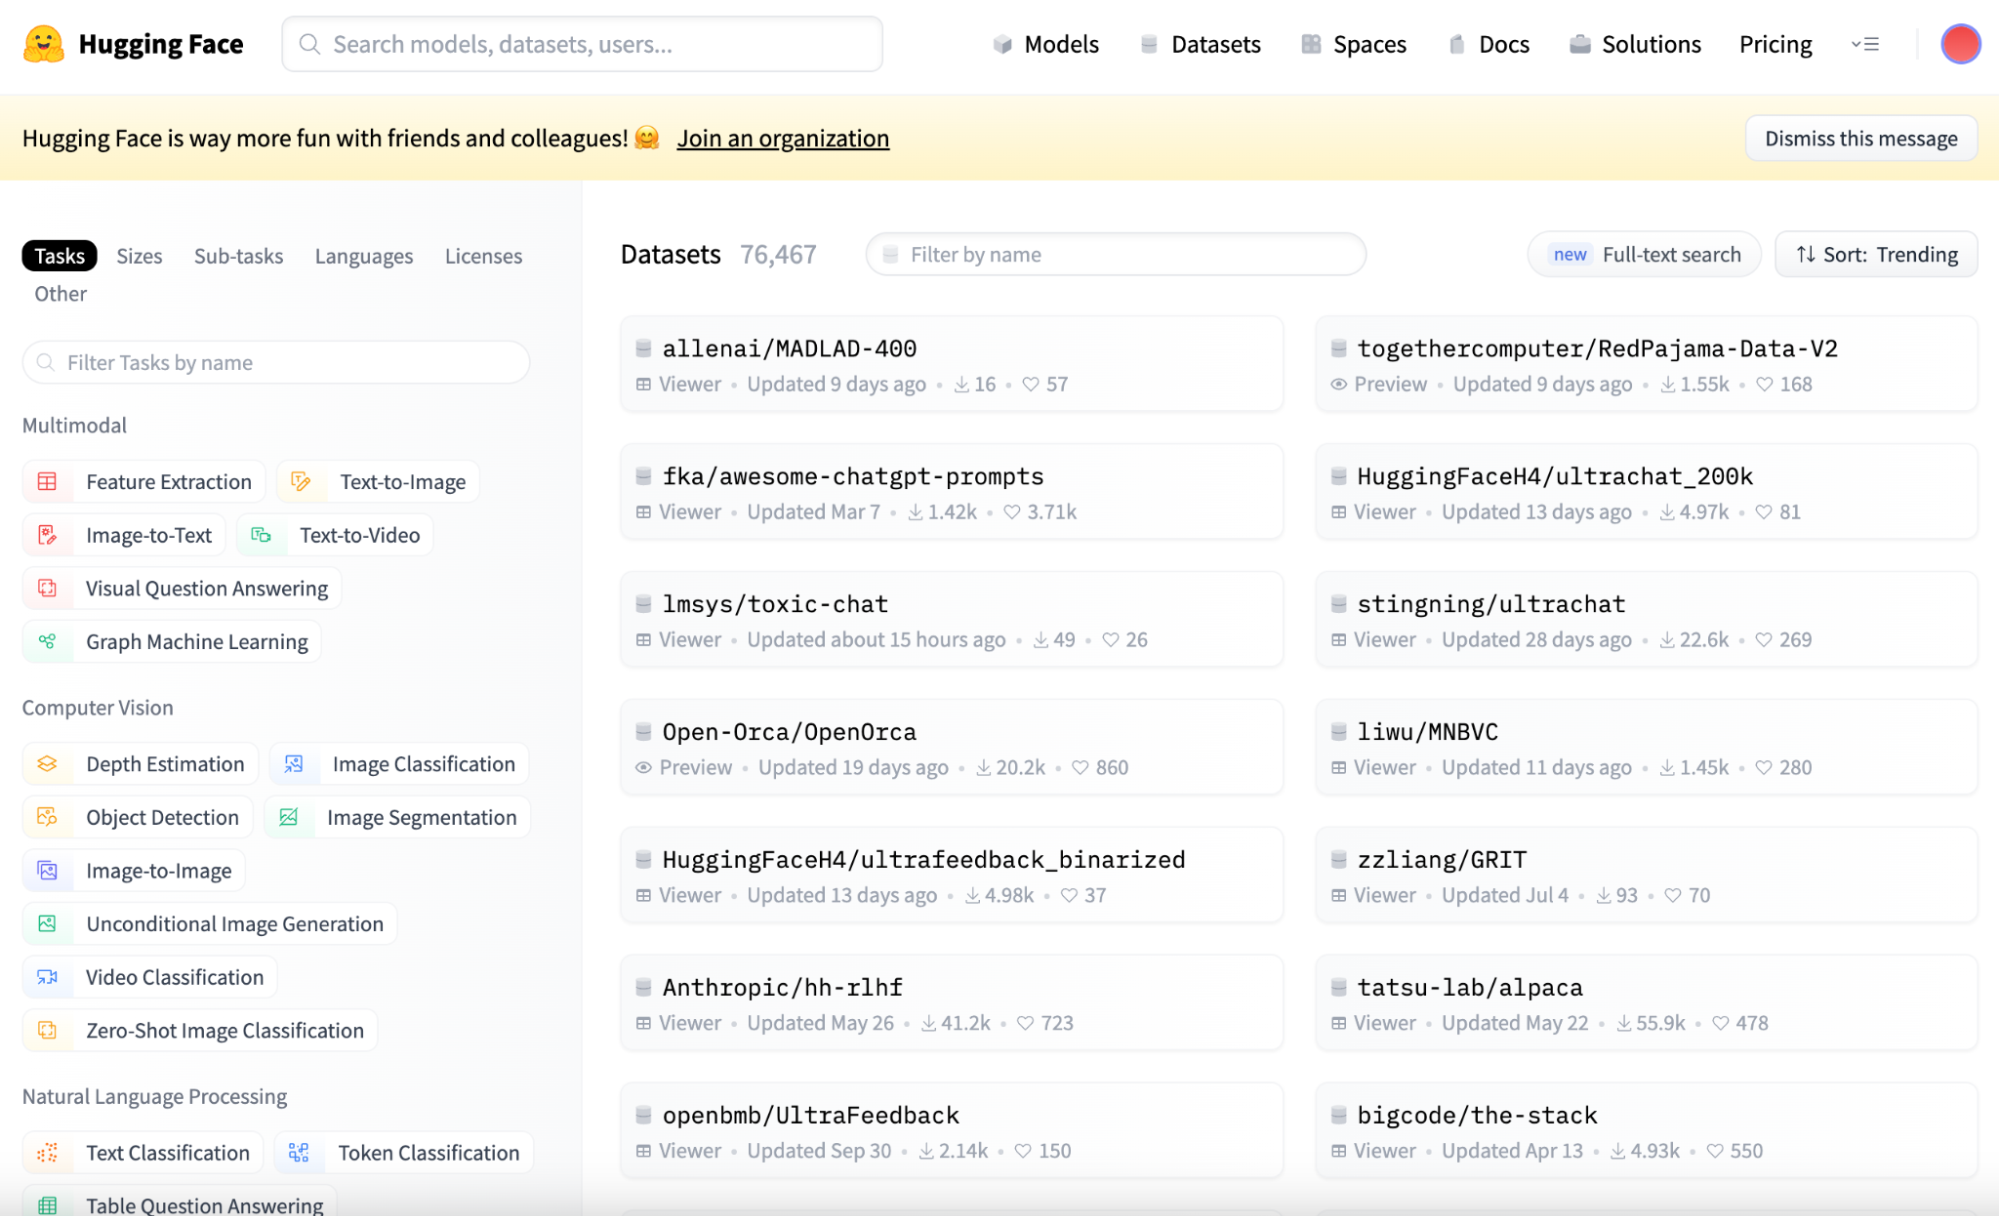
Ảnh chụp màn hình giao diện chính của Hugging Face Datasets.
Nó bao gồm các bộ dữ liệu cho những tác vụ phổ biến như phân loại văn bản, dịch thuật, hỏi đáp, cũng như các bộ dữ liệu chuyên biệt cho những thách thức độc đáo trong lĩnh vực.
Giờ khi chúng ta đã thống nhất và hiểu các khái niệm cốt lõi đằng sau Hugging Face, hãy tìm cách sử dụng “viên ngọc” công nghệ này.
Hướng dẫn này sẽ điểm qua ngắn gọn những điều cơ bản để bắt đầu với Hugging Face, gồm cài đặt, sử dụng mô hình tiền huấn luyện, tinh chỉnh và chia sẻ mô hình với cộng đồng.
Trước tiên, bạn nên kết hợp thư viện transformers với thư viện học sâu ưa thích của mình, TensorFlow hoặc PyTorch.
Thư viện transformers có thể cài đặt dễ dàng bằng pip, trình cài gói của Python.
pip install transformers
Để có đầy đủ khả năng, bạn cũng nên cài đặt thư viện datasets và tokenizers.
pip install tokenizers, datasets
Model hub của Hugging Face cung cấp bộ sưu tập khổng lồ các mô hình tiền huấn luyện cho nhiều tác vụ NLP. Hãy xem cách dùng mô hình tiền huấn luyện đầu tiên.
1. Chọn mô hình tiền huấn luyện: Trước hết, bạn cần chọn một mô hình tiền huấn luyện. Để làm vậy, chúng ta vào Model Hub.
Giả sử chúng ta muốn suy luận cảm xúc tương ứng với một chuỗi văn bản. Ta có thể dễ dàng chỉ duyệt các mô hình thực hiện tác vụ `Text Classification` bằng cách chọn nút Text Classification ở thanh bên trái.
Các mô hình trên Hugging Face luôn được sắp theo Trending. Thông thường, kết quả ở trên cùng là mô hình được dùng nhiều nhất. Vì vậy, ta chọn kết quả thứ hai, là mô hình phân tích cảm xúc được dùng nhiều nhất.
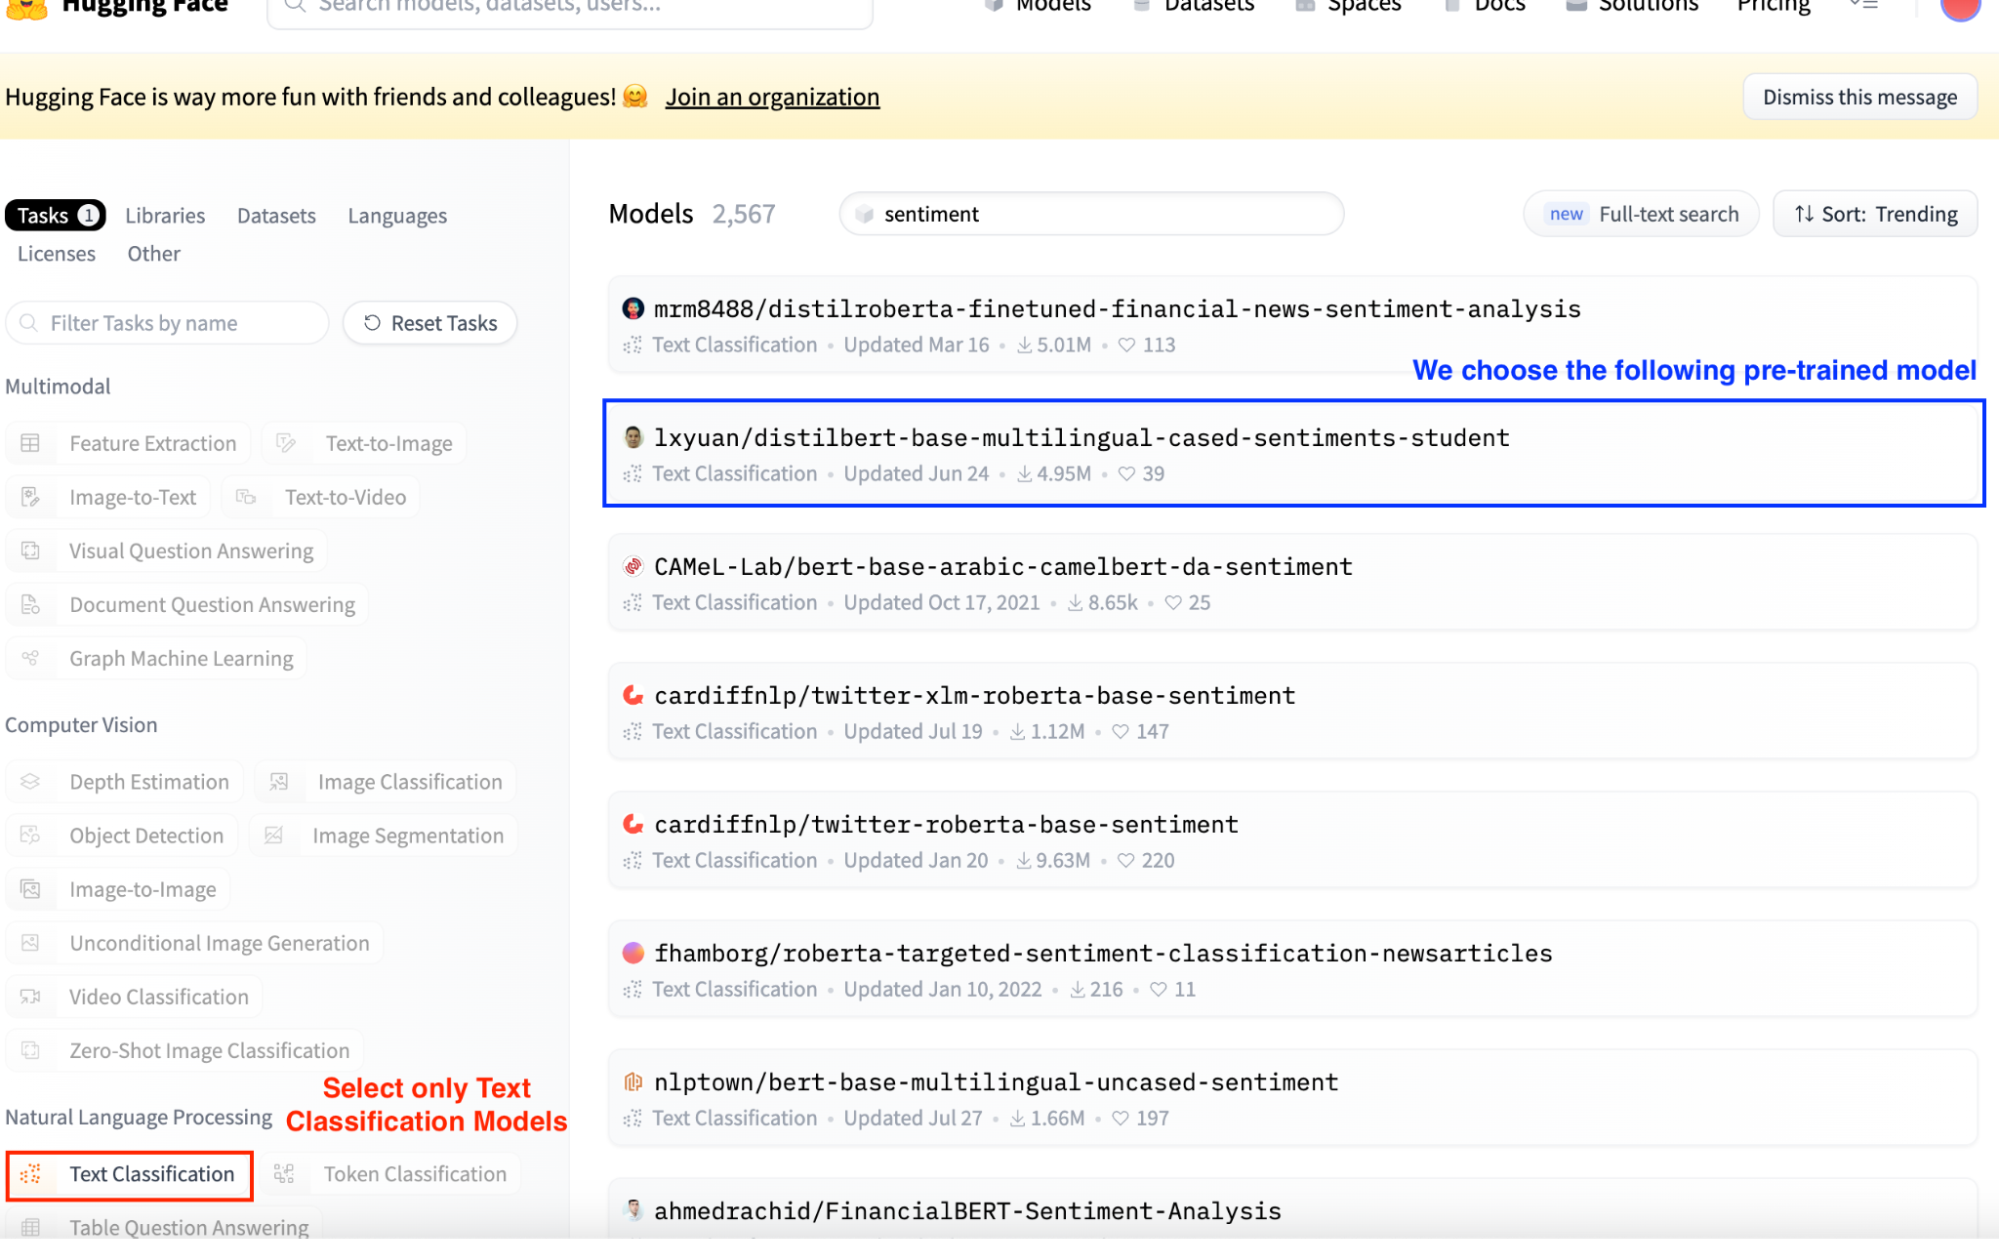
Ảnh chụp màn hình giao diện chính của Hugging Face Model Hub. Chọn các mô hình Text Classification.
Để sử dụng, chúng ta cần sao chép tên tương ứng của mô hình. Bạn có thể tìm thấy ở phần trên cùng của trang chi tiết mô hình.
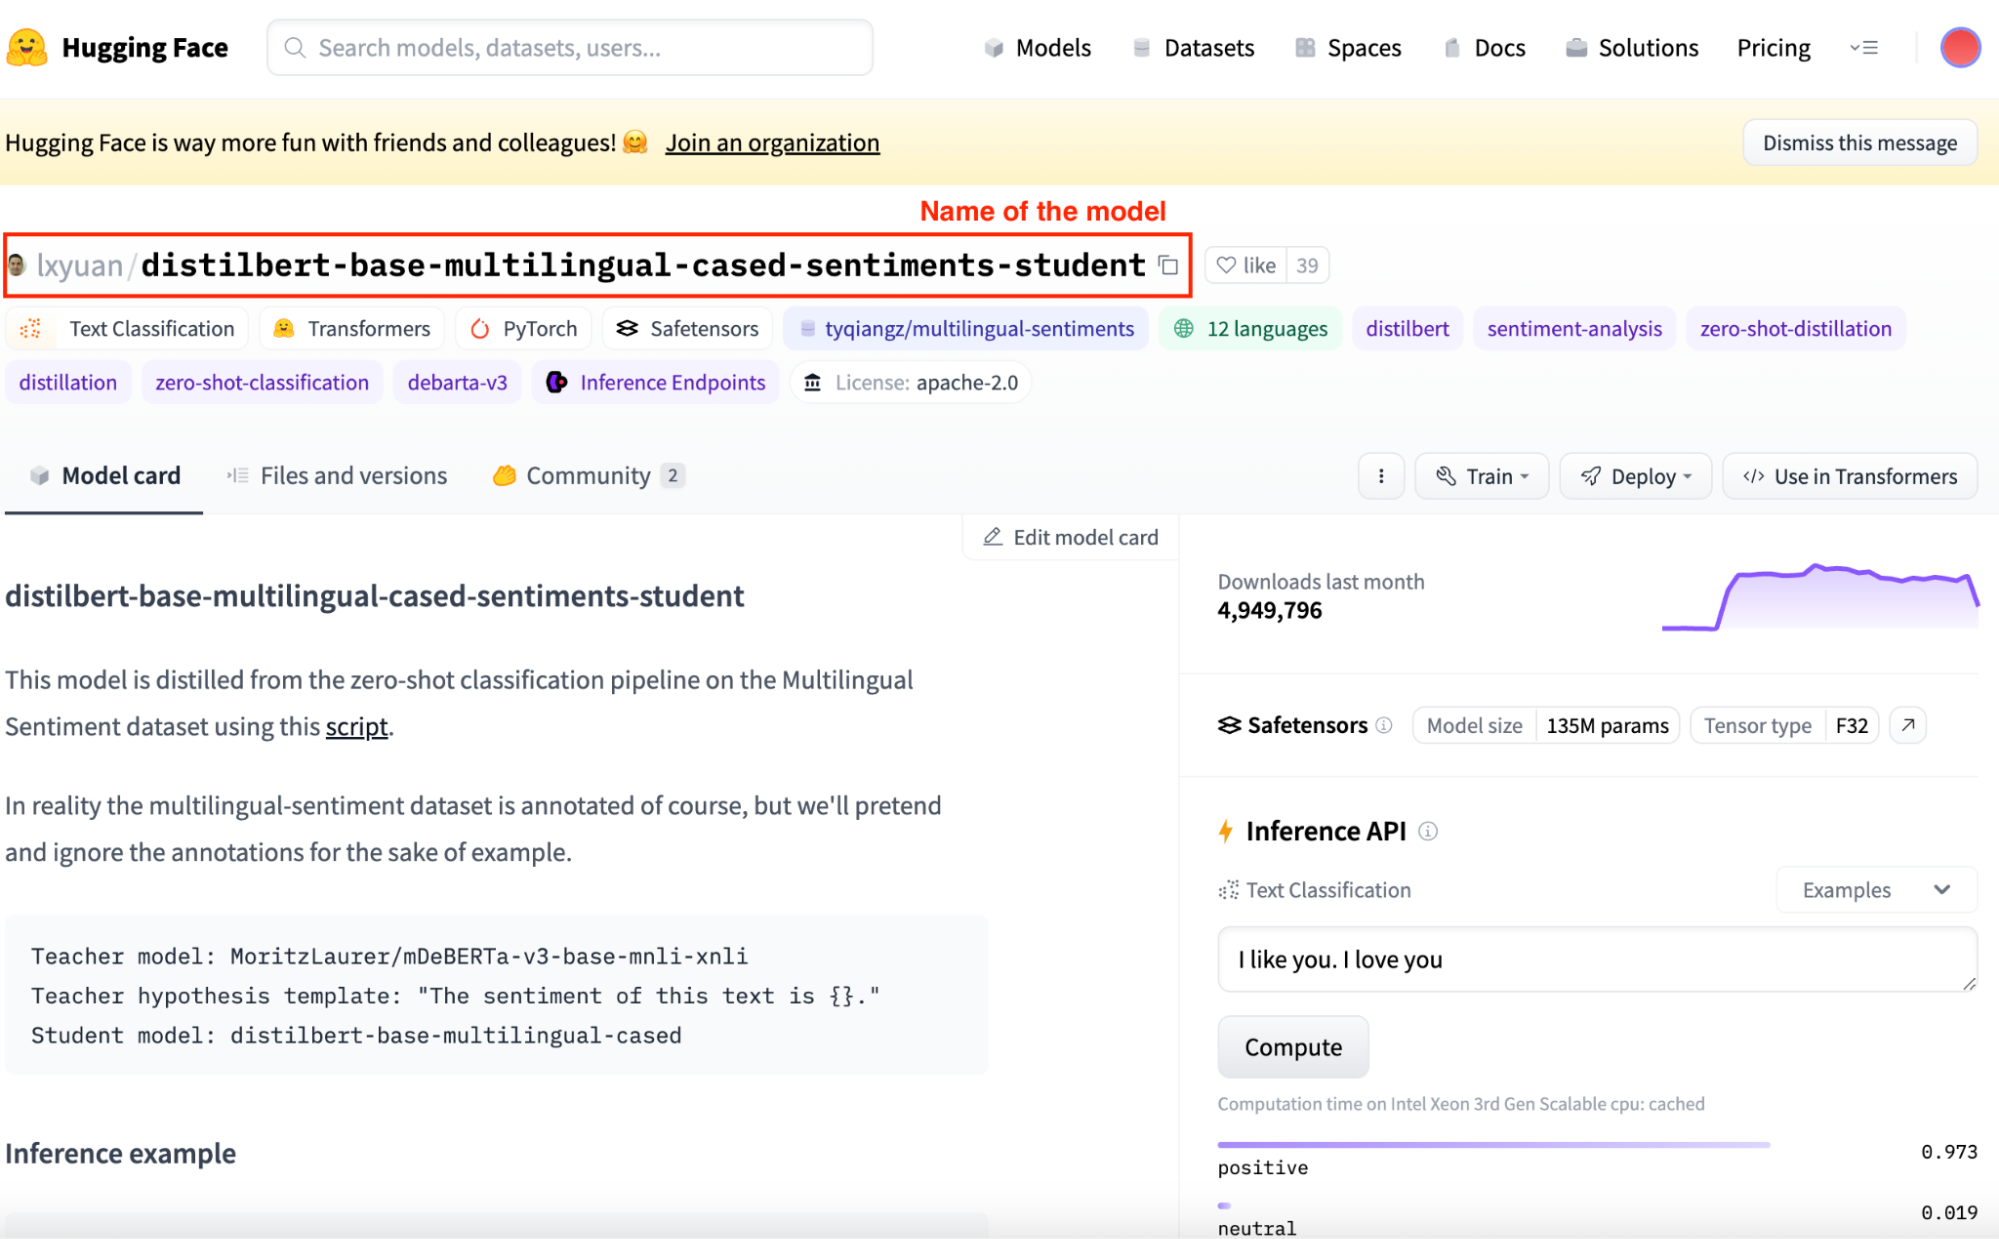
Ảnh chụp màn hình trang mô hình cụ thể trên Hugging Face Model Hub.
1. Tải mô hình tiền huấn luyện: Giờ khi đã biết dùng mô hình nào, hãy sử dụng nó trong Python. Trước hết ta cần import các lớp AutoTokenizer và AutoModelForSequenceClassification từ transformers.
Sử dụng các lớp AutoModel này sẽ tự động suy ra kiến trúc mô hình từ tên mô hình.
from transformers import AutoTokenizer, AutoModelForSequenceClassification

model_name = "lxyuan/distilbert-base-multilingual-cased-sentiments-student"

# We call define a model object
model = AutoModelForSequenceClassification.from_pretrained(model_name)
2. Chuẩn bị đầu vào: Tải tokenizer cho mô hình của chúng ta, trong trường hợp này, thư viện transformers giúp đơn giản hóa vì nó suy ra tokenizer cần dùng từ tên mô hình đã chọn.
#We call the tokenizer class
tokenizer = AutoTokenizer.from_pretrained(model_name)
3. Chạy mô hình: Tạo một đối tượng pipeline với mô hình đã chọn, tokenizer và tác vụ cần thực hiện. Trong trường hợp này là phân tích cảm xúc. Nếu bạn khởi tạo đối tượng classifier chỉ với tác vụ, lớp pipeline sẽ tự điền các giá trị mặc định, dù không khuyến nghị trong sản xuất.
# Initializing a classifier with a model and a tokenizer
classifier = pipeline("sentiment-analysis", model = model, tokenizer = tokenizer)
# When passing only the task, the pipeline command inferes both the model and tokenizer.
classifier = pipeline("sentiment-analysis")
Chúng ta có thể thực thi mô hình bằng cách đưa vào một số đầu vào.
output = classifier("I've been waiting for this tutorial all my life!")
4. Diễn giải đầu ra: Mô hình sẽ trả về một đối tượng chứa nhiều thành phần tùy theo lớp của mô hình. Ví dụ, với bài toán phân tích cảm xúc này, chúng ta sẽ nhận được:
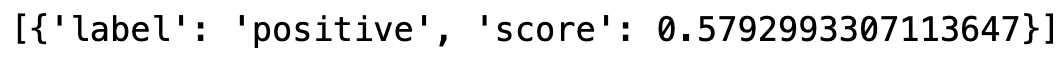
Đầu ra thu được.
Tinh chỉnh (fine-tuning) là quá trình lấy một mô hình tiền huấn luyện và cập nhật tham số của nó bằng cách huấn luyện trên một bộ dữ liệu đặc thù cho tác vụ của bạn. Điều này cho phép tận dụng biểu diễn đã học của mô hình và điều chỉnh cho phù hợp với trường hợp sử dụng.
Giả sử chúng ta cần dùng mô hình phân loại văn bản để suy luận cảm xúc từ danh sách tweet. Một câu hỏi tự nhiên là: Liệu mô hình tiền huấn luyện này có hoạt động tốt không?
Để đảm bảo, ta có thể tận dụng tinh chỉnh bằng cách huấn luyện một mô hình Hugging Face tiền huấn luyện với bộ dữ liệu chứa tweet và nhãn cảm xúc tương ứng để cải thiện hiệu năng.
Dưới đây là ví dụ cơ bản tinh chỉnh mô hình cho phân loại chuỗi:
1. Chọn mô hình tiền huấn luyện và bộ dữ liệu: Chọn kiến trúc mô hình phù hợp với tác vụ. Ở đây, ta muốn tiếp tục dùng cùng mô hình phân tích cảm xúc. Tuy nhiên, giờ ta cần dữ liệu để huấn luyện mô hình.
Và đây chính là lúc thư viện datasets phát huy tác dụng. Ta có thể vào xem tất cả dataset trên Model Hub và tìm bộ phù hợp nhất.
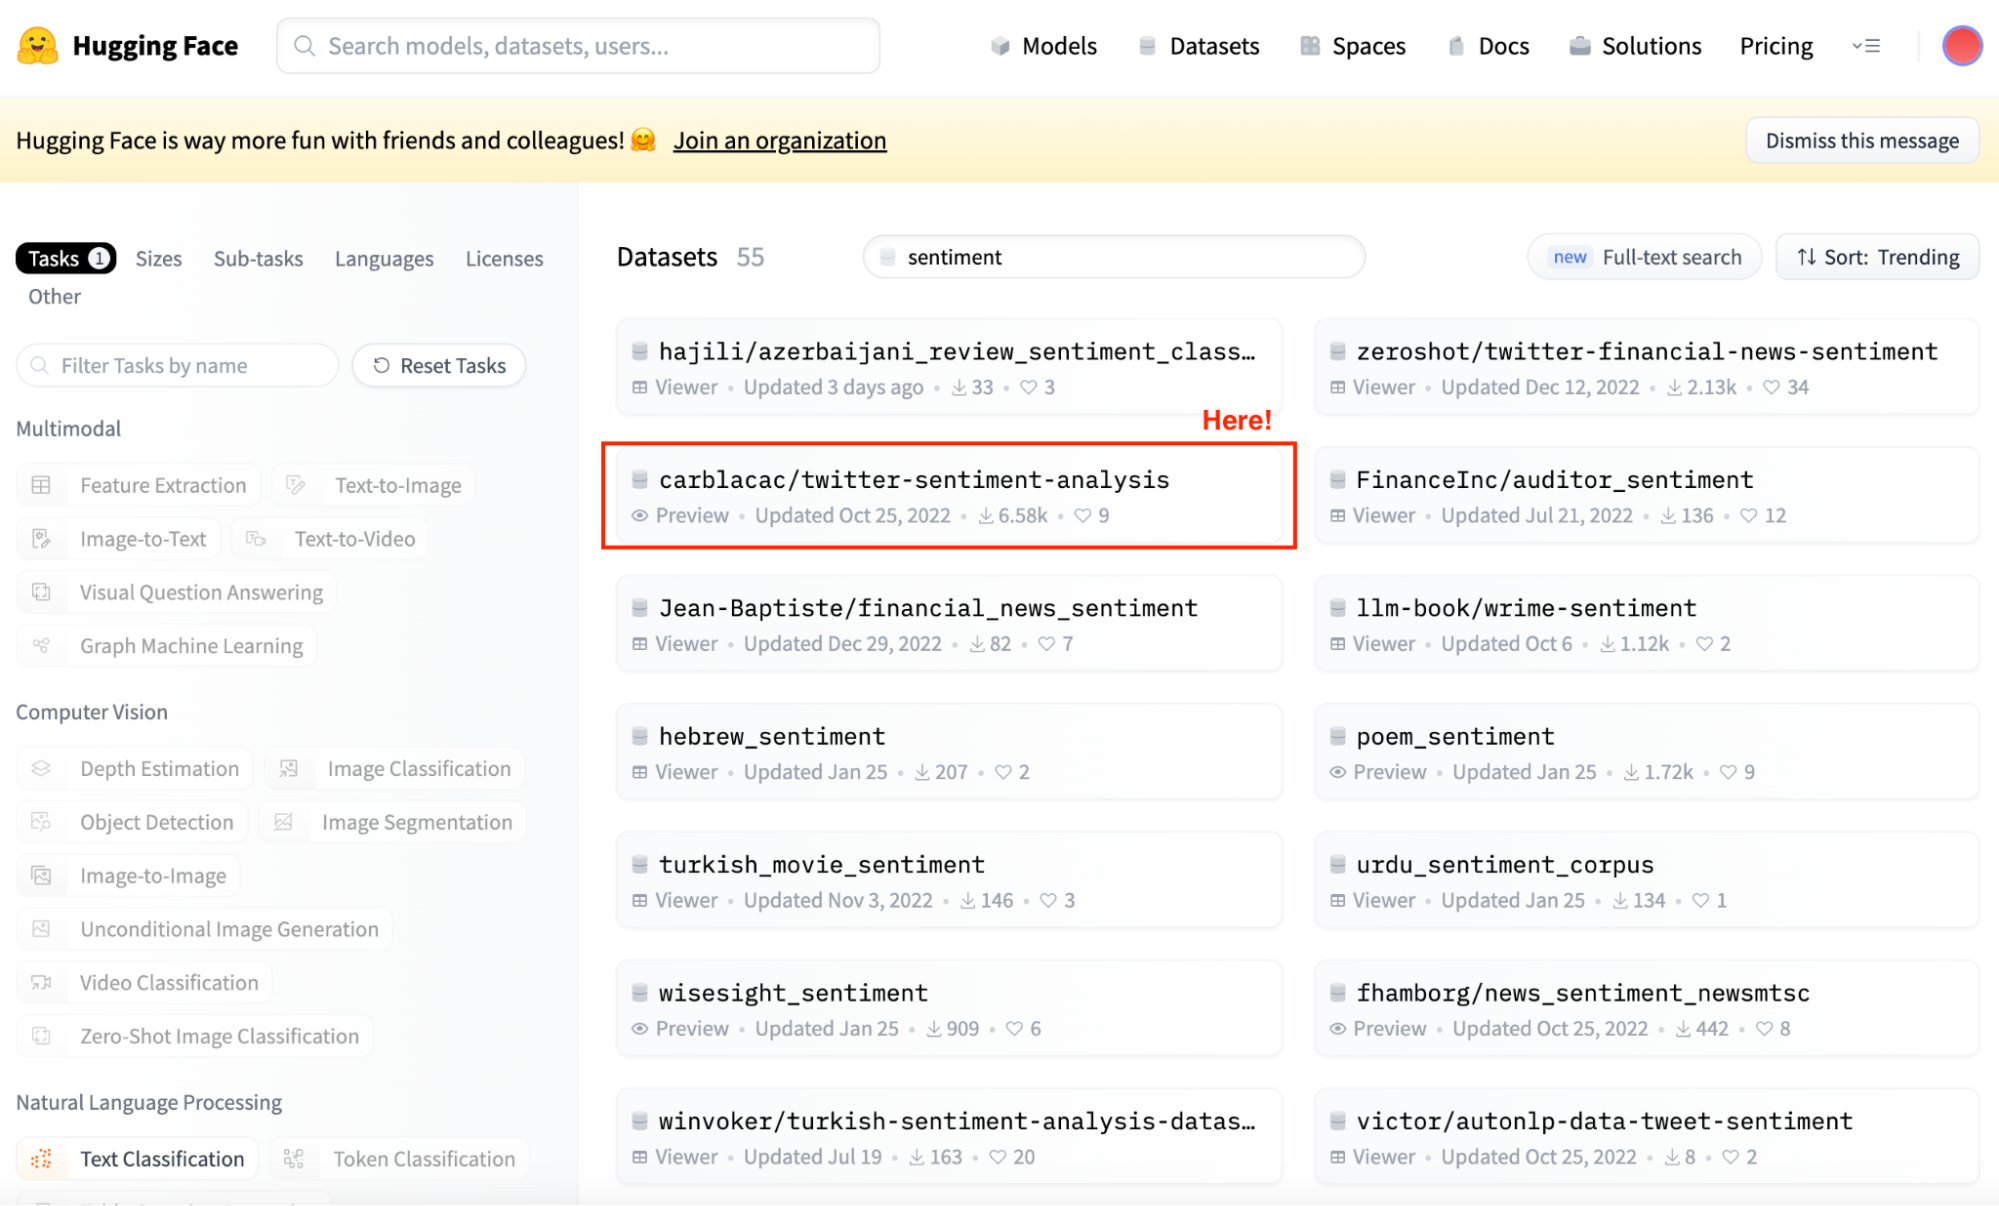
Ảnh chụp màn hình giao diện chính của Hugging Face Datasets Hub. Chọn các bộ dữ liệu phân tích cảm xúc.
Giờ khi đã biết chọn dataset nào, ta có thể đơn giản khởi tạo cả mô hình và dataset.
model = AutoModelForSequenceClassification.from_pretrained(model_name)

# Loading the dataset to train our model
dataset = load_dataset("mteb/tweet_sentiment_extraction")
Nếu kiểm tra dataset vừa tải, đó là một từ điển chứa tập con huấn luyện và tập con kiểm thử. Nếu chuyển tập huấn luyện sang dataframe, nó trông như sau:
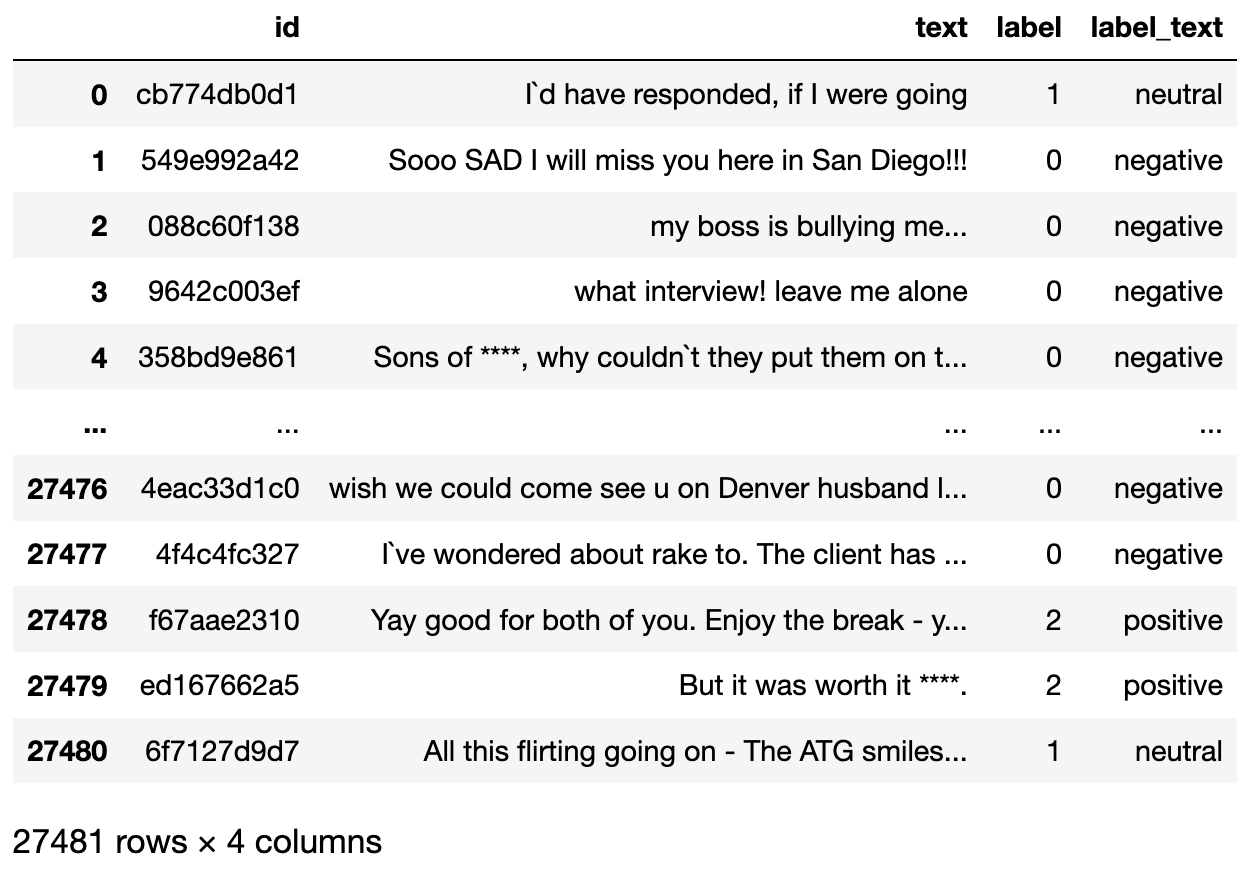
Bộ dữ liệu sẽ sử dụng.
2. Chuẩn bị bộ dữ liệu: Giờ khi đã có dataset, ta cần một tokenizer để chuẩn bị dữ liệu cho mô hình. Biến văn bản trong dataset cần được token hóa để có thể dùng tinh chỉnh mô hình.
Vì vậy, bước hai là tải một Tokenizer tiền huấn luyện và token hóa dataset để dùng cho tinh chỉnh.
tokenizer = AutoTokenizer.from_pretrained(model_name)

def tokenize_function(examples):
    return tokenizer(examples["text"], padding="max_length", truncation=True)

tokenized_datasets = dataset.map(tokenize_function, batched=True)
3. Xây dựng PyTorch dataset với encodings: Bước ba là tạo tập huấn luyện và kiểm thử. Tập huấn luyện dùng để tinh chỉnh mô hình, còn tập kiểm thử dùng để đánh giá.
Thông thường, quá trình tinh chỉnh tốn nhiều thời gian. Để thuận tiện cho hướng dẫn, chúng ta lấy mẫu ngẫu nhiên cả hai tập để giảm thời gian tính toán.
from datasets import load_dataset

model = AutoModelForSequenceClassification.from_pretrained(model_name)

# Loading the dataset to train our model
dataset = load_dataset("mteb/tweet_sentiment_extraction")

small_train_dataset = tokenized_datasets["train"].shuffle(seed=42).select(range(1000))
small_eval_dataset = tokenized_datasets["test"].shuffle(seed=42).select(range(1000))
4. Tinh chỉnh mô hình: Bước cuối là thiết lập tham số huấn luyện và bắt đầu huấn luyện. Thư viện transformers có lớp trainer() lo liệu mọi thứ.
Chúng ta trước tiên định nghĩa tham số huấn luyện cùng chiến lược đánh giá. Khi đã sẵn sàng, ta có thể dễ dàng huấn luyện mô hình với lệnh train().
from transformers import Trainer, TrainingArguments
import numpy as np

training_args = TrainingArguments(output_dir="trainer_output", evaluation_strategy="epoch")

metric = evaluate.load("accuracy")

def compute_metrics(eval_pred):
    logits, labels = eval_pred
    predictions = np.argmax(logits, axis=-1)
    return metric.compute(predictions=predictions, references=labels)


trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=small_train_dataset,
    eval_dataset=small_eval_dataset,
    compute_metrics=compute_metrics,
)
trainer.train()
5. Đánh giá mô hình: Sau huấn luyện, hãy đánh giá hiệu năng mô hình trên tập validation hoặc test. Một lần nữa, lớp trainer đã có sẵn phương thức evaluate xử lý việc này.
import evaluate

trainer.evaluate()
Mô hình đã tinh chỉnh của chúng ta đạt độ chính xác 70%.
Giờ khi đã cải thiện mô hình, làm sao chia sẻ với cộng đồng? Đây là bước cuối.
Khi bạn đã tinh chỉnh xong mô hình, có thể bạn muốn chia sẻ với cộng đồng.
Hugging Face giúp quy trình này rất đơn giản. Trước tiên, bạn cần cài thư viện huggingface_hub.
Một yêu cầu cho bước cuối là có token hợp lệ để kết nối với tài khoản Hugging Face của bạn. Bạn có thể dễ dàng lấy token theo hướng dẫn này. Khi làm việc trong Jupyter Notebook, chúng ta có thể import thư viện notebook_login.
from huggingface_hub import notebook_login

notebook_login()
Lệnh này sẽ mở giao diện đăng nhập ngay trong Jupyter Notebook. Chỉ cần nhập token, notebook của chúng ta sẽ kết nối với tài khoản Hugging Face.
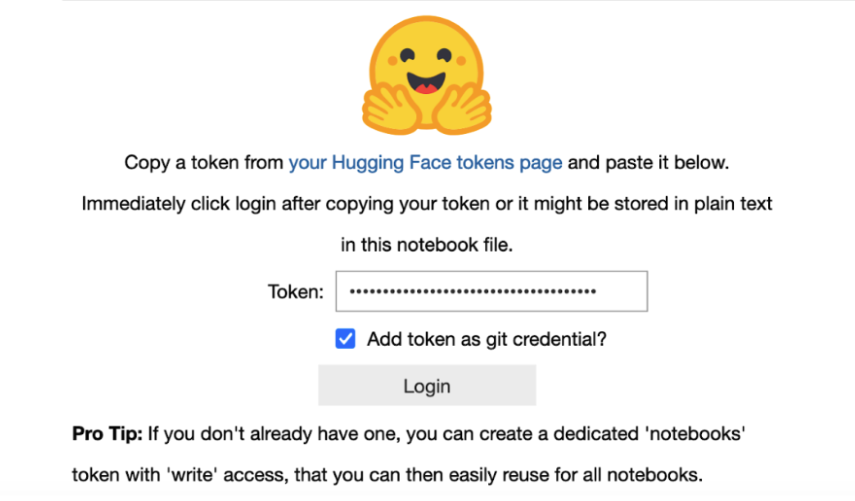
Giờ chúng ta chỉ cần tải mô hình lên bằng lệnh push_to_hub.
finetuned_model.push_to_hub("my-awesome-model")
Và sau đó, mô hình sẽ khả dụng cho mọi người trên hồ sơ Hugging Face của chúng ta.
Nếu muốn chuẩn hóa bất kỳ quy trình NLP nào, với Hugging Face, thường chỉ gồm ba bước đơn giản, mất chưa đến năm dòng mã:
1. Định nghĩa đối tượng mô hình với lớp pipeline (và mô hình, tokenizer tương ứng).
2. Xác định văn bản hoặc prompt đầu vào.
3. Chạy mô hình tiền huấn luyện với đầu vào và quan sát đầu ra.
Phân loại văn bản là tác vụ nền tảng của NLP. Nó gồm việc gán cho mỗi văn bản đầu vào một hoặc nhiều danh mục. Ứng dụng rất đa dạng như phát hiện spam, phân tích cảm xúc, gán nhãn chủ đề, và hơn thế nữa.
Bạn có thể quan sát ví dụ mã dưới đây, chỉ với ba bước đơn giản ở phần trước, chúng ta có thể triển khai mô hình phân loại văn bản.
# We import the pipeline module from the transformers library
from transformers import pipeline

# We load the pre-trained text classification model.
classifier = pipeline("text-classification",model='lxyuan/distilbert-base-multilingual-cased-sentiments-student')

# Input to be classified
input_ = "I absolutely love the transformers library!"

# Perform classification
output_ = classifier(input_)

# Observer the result
print(output_)
Dễ dàng, phải không?
Vậy hãy đến trường hợp thứ hai — cũng là một trong những trường hợp bị “dùng nhiều” nhất mọi thời đại.
Chắc nhiều bạn đã quen với ChatGPT hoặc Google Bard, những công cụ sinh văn bản từ một prompt đầu vào. Quy trình này gọi là “Sinh văn bản,” một khía cạnh hấp dẫn của NLP, nơi mô hình tạo ra văn bản giống người từ đầu vào ban đầu.
Nó có nhiều ứng dụng, từ tạo phản hồi chatbot đến viết sáng tạo.
Ý tưởng cốt lõi là huấn luyện mô hình trên một kho văn bản lớn, giúp nó học mẫu, phong cách, cấu trúc ngôn ngữ. Như bạn hình dung, phần tốn kém nhất chính là huấn luyện mô hình.
Tuy vậy, Hugging Face cho phép triển khai mô hình như vậy chỉ trong năm dòng mã, giống như ví dụ trước.
Xem ví dụ dưới đây:
from transformers import pipeline

generator = pipeline('text-generation', model='gpt2')

prompt = "In a world dominated by AI,"

generated_text = generator(prompt, max_length=50)[0]['generated_text']

print(generated_text)
Hỏi đáp (QA) là một lĩnh vực trong NLP tập trung xây dựng hệ thống tự động trả lời câu hỏi do con người đặt ra bằng ngôn ngữ tự nhiên.
Hệ thống QA được dùng rộng rãi trong các ứng dụng như trợ lý ảo, hỗ trợ khách hàng và truy xuất thông tin.
Hệ thống QA có thể được phân loại rộng thành hai loại:
Những hệ thống này thường kết hợp hiểu ngôn ngữ tự nhiên để diễn giải câu hỏi và truy xuất thông tin để tìm câu trả lời phù hợp.
Một lần nữa, triển khai một mô hình như vậy bằng Hugging Face rất nhanh và dễ.
from transformers import pipeline

qa_pipeline = pipeline('question-answering', model='distilbert-base-uncased-distilled-squad')

context = """Paris is the capital and most populous city of France. The city has an area of 105 square kilometers and a population of 2,140,526 residents."""
question = "What is the population of Paris?"

answer = qa_pipeline(question=question, context=context)
print(answer)
Trường hợp cuối cùng là dịch thuật. Dịch máy là một phân ngành của ngôn ngữ học tính toán tập trung vào việc dịch văn bản hoặc lời nói từ ngôn ngữ này sang ngôn ngữ khác bằng phần mềm. Với sự xuất hiện của học sâu, dịch máy đã tiến những bước dài, đặc biệt với các mô hình Dịch máy dùng mạng nơ-ron (NMT) sử dụng mạng nơ-ron lớn.
Các hệ thống NMT hiện đại, khác với mô hình dịch dựa trên luật hoặc thống kê truyền thống, học cách dịch bằng cách huấn luyện trên các bộ dữ liệu song ngữ lớn. Chúng sử dụng kiến trúc sequence-to-sequence, trong đó một phần mạng mã hóa văn bản nguồn và phần khác giải mã sang ngôn ngữ đích, thường đạt độ trôi chảy và chính xác ấn tượng.
Một ví dụ đơn giản dùng Hugging Face như sau:
from transformers import pipeline

# Load the translation pipeline for English to Spanish
translator = pipeline('translation_en_to_de')

# Text to translate from English to Spanish
text_to_translate = "This is a great day for science!"

# Perform the translation
translation = translator(text_to_translate, max_length=40)

# Print the translated text
print(translation[0]['translation_text'])
Hugging Face đã nổi lên như một lực lượng chuyển đổi trong lĩnh vực trí tuệ nhân tạo và xử lý ngôn ngữ tự nhiên. Bộ công cụ toàn diện của họ, gồm thư viện Transformers mang tính cách mạng, Model Hub giàu tính cộng tác và thư viện Datasets phong phú, đã dân chủ hóa khả năng tiếp cận các năng lực NLP tiên tiến.
Bằng cách nuôi dưỡng môi trường nơi đổi mới được chia sẻ và cùng nhau bồi đắp, Hugging Face không chỉ góp phần thúc đẩy AI mà còn định hình tương lai nơi công nghệ trở nên dễ tiếp cận hơn, bao trùm hơn và mạnh mẽ hơn.
Khi chúng ta tiếp tục chứng kiến và tham gia vào cuộc cách mạng AI, Hugging Face nhắc nhở rằng những tiến bộ công nghệ sâu sắc nhất là những tiến bộ mở, được chia sẻ và xây dựng cùng nhau.
Không chỉ là tạo ra máy móc thông minh hơn, mà còn là bồi dưỡng một cộng đồng nhà phát triển, nhà nghiên cứu và người đam mê thông minh hơn, kết nối hơn, sẵn sàng đẩy giới hạn của điều có thể.
Bắt đầu hành trình AI & NLP của bạn ngay hôm nay!
Lộ trình
Lộ trình
Khóa học
blog
Matt Crabtree
10 phút
