Programa
Processamento de Linguagem Natural em Python
20 h
No cenário tecnológico em rápida evolução, a inteligência artificial se destaca como uma área essencial e onipresente, se integrando com facilidade ao nosso dia a dia. No centro dessa onda de IA está o processamento de linguagem natural (NLP), um campo sofisticado que impulsiona ferramentas de conversação populares como o ChatGPT e o Bard.
E se a maioria dos modelos que tornam essas ferramentas possíveis estivesse aberta a todos e reunida em um só lugar?
Chega de mistério: a Hugging Face é um divisor de águas em machine learning e NLP e um agente-chave na democratização da IA. Graças ao aprendizado por transferência, ela vem desempenhando um papel crucial para tornar a IA mais acessível.
Hoje, ela ostenta a biblioteca de NLP mais popular em Python, com mais de 115 mil estrelas no GitHub, e se consolidou como uma das plataformas centrais para entusiastas e profissionais de IA experimentarem, implantarem e escalarem seus próprios modelos.
Seja você um profissional de dados ou um iniciante curioso, a Hugging Face tem as ferramentas e os recursos para tirar seus projetos de IA do papel, expandindo os limites do que é possível com machine learning.
Então, vamos descobrir o que a Hugging Face tem a oferecer!
Você também pode aprender mais sobre como usar modelos de IA open source com a Hugging Face no nosso code-along.
Para muita gente, Hugging Face pode ser só mais um emoji disponível no teclado do celular (🤗)
Mas, no mundo tech, ela é o GitHub do universo de ML — uma plataforma colaborativa repleta de ferramentas que permitem a qualquer pessoa criar, treinar e implantar modelos de NLP e ML usando código open source.
O grande diferencial?
Esses modelos já vêm pré-treinados, o que torna muito mais simples começar em NLP. Em outras palavras, os desenvolvedores não precisam mais partir do zero: basta carregar um modelo pré-treinado do hub da Hugging Face, fazer o fine-tuning para a sua tarefa específica e seguir daí.
Essa facilidade de uso simplifica bastante o desenvolvimento.
Assim, a Hugging Face é um hub onde cientistas de dados, pesquisadores e engenheiros de ML se encontram para trocar ideias, buscar suporte e contribuir com iniciativas open source.
Eles se descrevem como:
“A comunidade de IA para construir o futuro.”
Essa visão é justamente um dos segredos do sucesso da Hugging Face: a abordagem guiada pela comunidade.
Outro motivo para o seu crescimento acelerado é a intuitividade da plataforma. Uma interface simples torna o início rápido — tanto para novatos quanto para profissionais.
Com o objetivo de hospedar a maior coleção de recursos de NLP e ML, a Hugging Face está comprometida em democratizar a IA e torná-la acessível a uma comunidade global.
Fundada em 2016, a Hugging Face nasceu como uma empresa americano-francesa com a meta de desenvolver um chatbot de IA interativo para adolescentes. Porém, após abrir o código do modelo que alimentava esse chatbot, logo pivotou para uma ambição maior: equipar a indústria de IA com ferramentas poderosas e acessíveis.
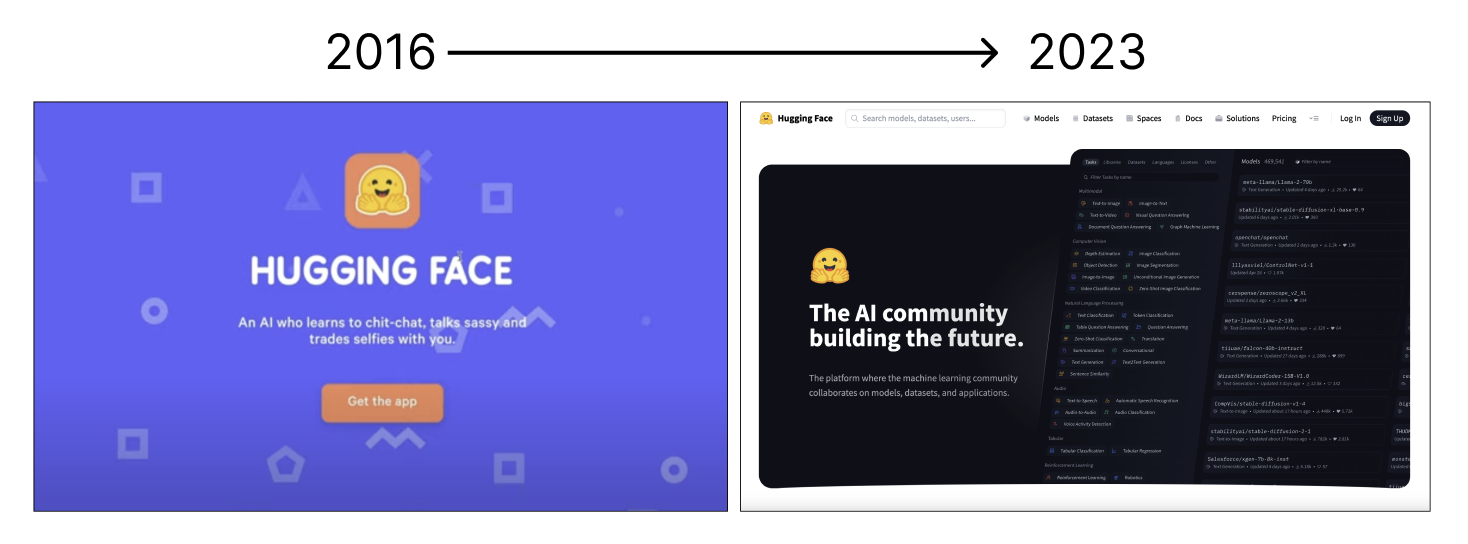
Imagem do autor.
O lançamento, em 2018, da biblioteca Transformers marcou uma de suas maiores e mais conhecidas contribuições para a comunidade de IA, oferecendo modelos pré-treinados como BERT e GPT, que se tornaram padrão em tarefas de NLP.
Hoje, a Hugging Face transformou por completo o ecossistema de ML. Seu compromisso com a colaboração open source catalisou a inovação em NLP, permitindo o crescimento coletivo e o desenvolvimento da tecnologia.
A plataforma virou um ponto de encontro para compartilhamento de modelos e datasets, impulsionando a pesquisa e as aplicações práticas em IA.
O mantra deles?
“Democratizar um bom machine learning, um commit de cada vez.”
Por meio de parcerias estratégicas e da dedicação em tornar ferramentas avançadas de NLP amplamente disponíveis, a Hugging Face se tornou parte essencial da comunidade, expandindo continuamente os limites da IA e democratizando o acesso a tecnologia de ponta.
A Hugging Face virou referência em NLP moderno graças a um conjunto de componentes e recursos que atendem a uma ampla variedade de necessidades de processamento de linguagem.
Vamos detalhar cada um deles.
A biblioteca Transformers é um conjunto abrangente de modelos de machine learning de última geração, projetados especialmente para NLP. Ela reúne uma ampla coleção de modelos pré-treinados, otimizados para tarefas como classificação de texto, geração de linguagem, tradução e sumarização, entre outras.
A Hugging Face abstraiu tarefas comuns de NLP em um método simples de usar, o `pipeline()`, uma API prática para executar uma grande variedade de tarefas. Esses pipelines permitem aplicar com facilidade modelos complexos a problemas do mundo real. Se você quiser entender mais do que está por trás dessa biblioteca, recomendo muito o artigo An Introduction to Using Transformers and Hugging Face.
Os modelos são fáceis de acessar e personalizar, o que foi revolucionário para desenvolvedores e pesquisadores, e teve papel central em tornar modelos sofisticados de NLP mais acessíveis.
A relevância está na capacidade de abstrair as complexidades do treinamento e da implantação de modelos de NLP, facilitando para quem pratica a implementação de recursos avançados com pouco código.
A biblioteca permite aproveitar modelos pré-treinados sem precisar mergulhar nos algoritmos por trás deles.
A Transformers simplifica a implementação de modelos de NLP de várias maneiras centrais:
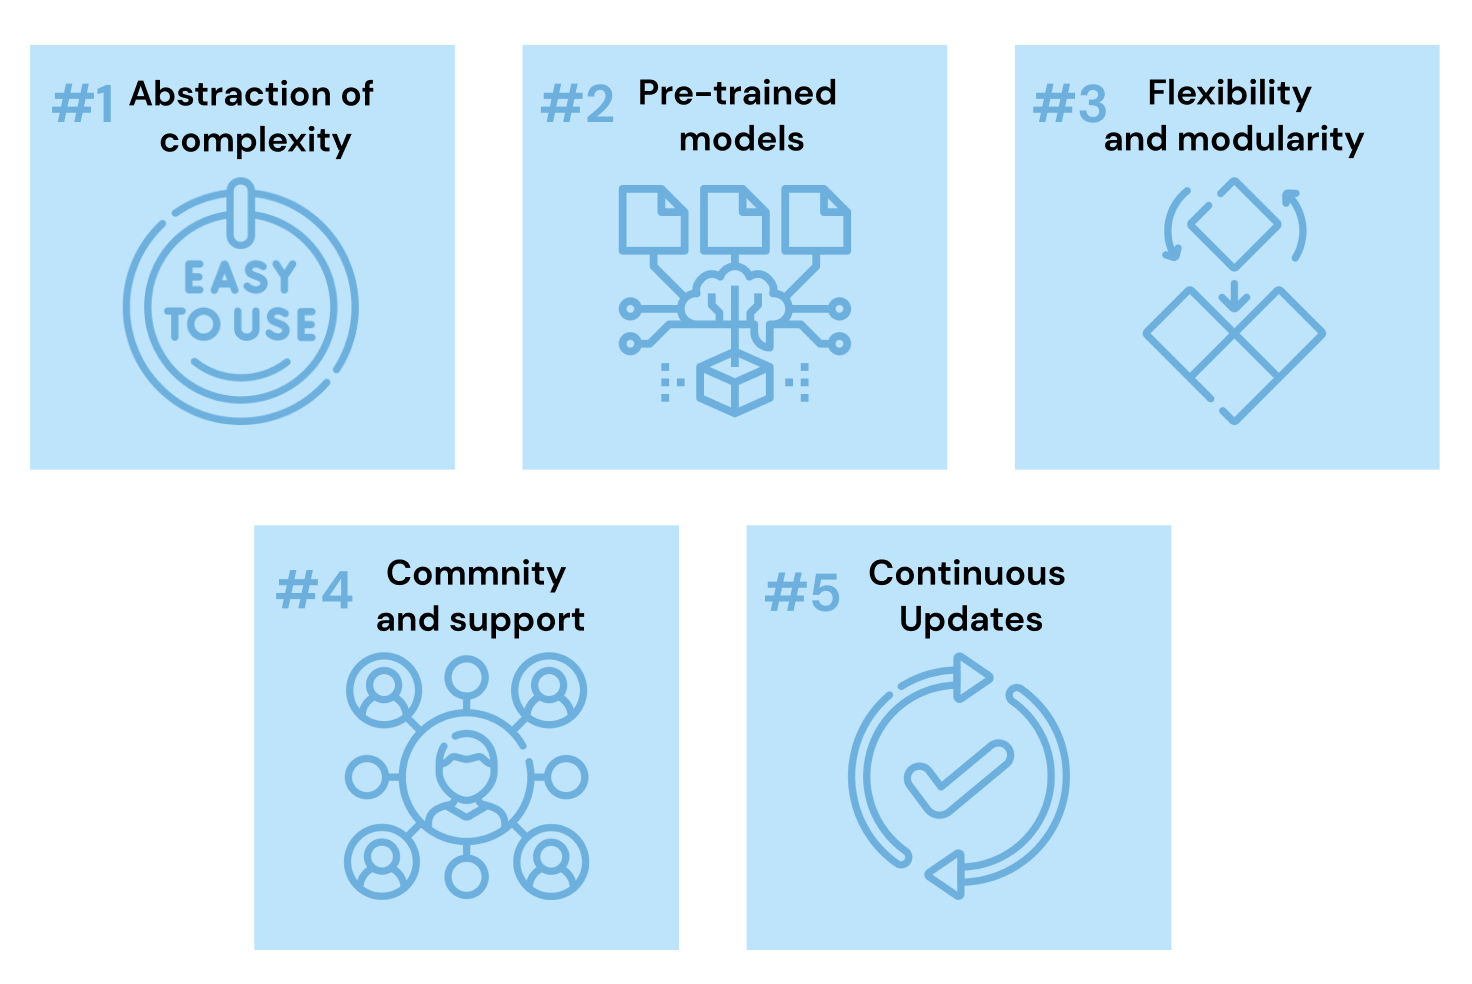
Se você quer ver na prática o quanto a Transformers poupa trabalho, aprenda a implantar um modelo de NLP com Building a Transformer with PyTorch.
O Model Hub é a vitrine da comunidade — uma plataforma onde milhares de modelos e datasets estão ao seu alcance. É um recurso inovador que permite compartilhar e descobrir modelos contribuídos pela comunidade, promovendo uma abordagem colaborativa ao desenvolvimento de NLP.
Você pode conferir no site oficial. Lá, é fácil acessar o Model Hub clicando em Models no menu, e uma visão como a abaixo deve aparecer:
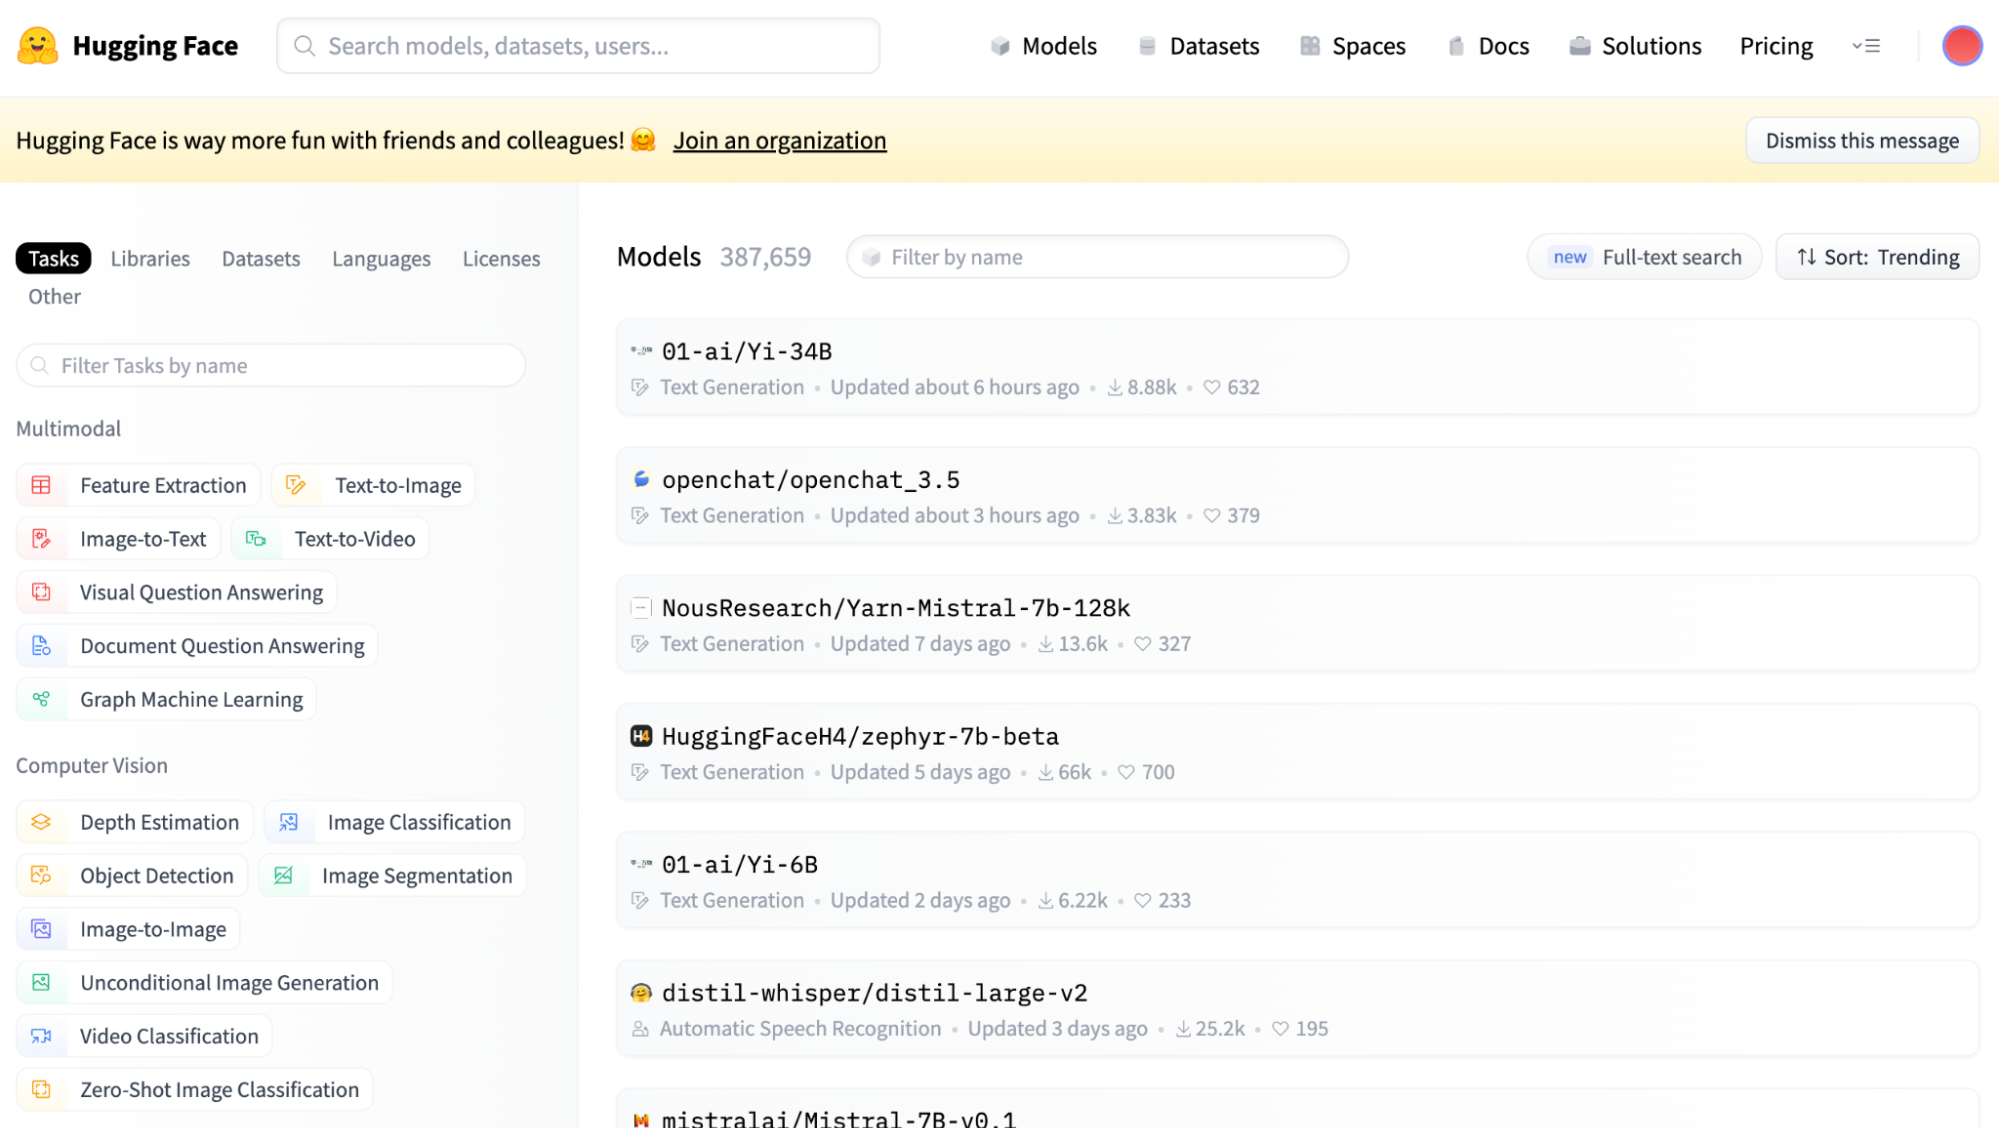
Captura da tela da visão principal do Hugging Face Model Hub.
Como dá para ver, na barra lateral esquerda há vários filtros relacionados à tarefa principal a ser executada.
Contribuir com o Model Hub é simples graças às ferramentas da Hugging Face, que orientam o usuário no processo de upload. Depois de enviado, o modelo fica disponível para toda a comunidade usar, diretamente no hub ou por meio da integração com a biblioteca Transformers.
Essa facilidade de acesso e contribuição cria um ecossistema dinâmico, no qual modelos de ponta são constantemente aprimorados e expandidos, oferecendo uma base rica e colaborativa para o avanço do NLP.
Tokenizers são cruciais em NLP, pois convertem texto em um formato que os modelos de machine learning conseguem entender — algo essencial para lidar com diferentes idiomas e estruturas textuais.
Eles quebram o texto em tokens — unidades básicas como palavras, subpalavras ou caracteres — preparando os dados para processamento pelos modelos. Esses tokens são os blocos de construção que permitem aos modelos compreender e gerar linguagem humana.
Eles também facilitam a transformação dos tokens em vetores de entrada para os modelos e lidam com padding e truncamento para manter comprimentos uniformes de sequência.
A Hugging Face oferece tokenizers fáceis de usar, otimizados para a biblioteca Transformers, que são peça-chave no pré-processamento fluido de texto. Você pode ler mais sobre tokenização em um artigo separado.
Outro componente essencial é a biblioteca Hugging Face Datasets, um vasto repositório de conjuntos de dados de NLP que apoiam o treinamento e o benchmarking de modelos de ML.
Essa biblioteca é uma ferramenta crucial para desenvolvedores da área, pois oferece uma coleção diversa de datasets para treinar, testar e avaliar modelos de NLP em uma grande variedade de tarefas.
Um dos principais benefícios é a interface simples e amigável. Embora você possa explorar todos os datasets no Hugging Face Hub, para usar no seu código existe a biblioteca datasets, que permite baixar qualquer conjunto de dados sem esforço.
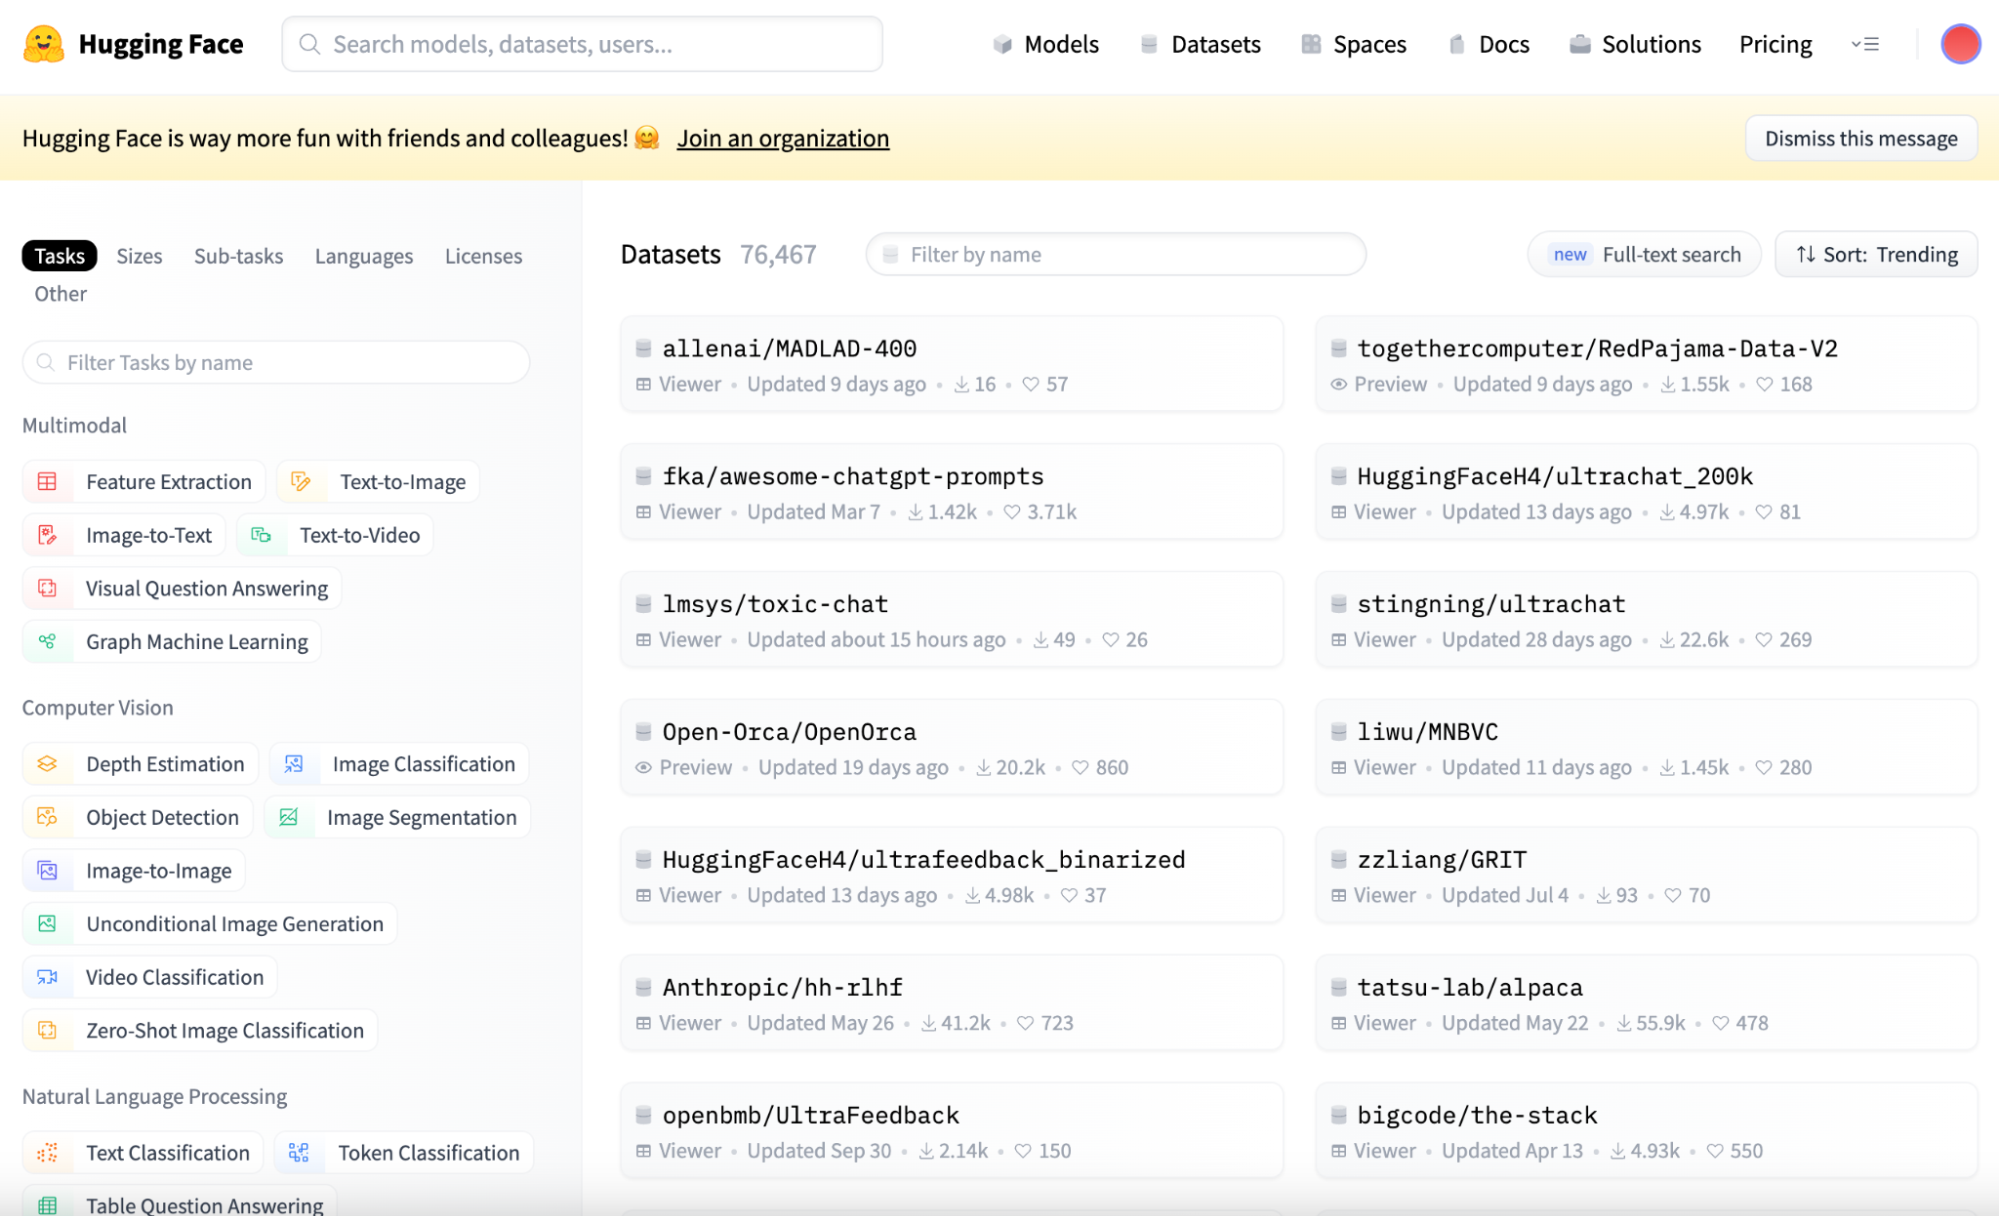
Captura da tela da visão principal do Hugging Face Datasets.
Ela inclui datasets para tarefas comuns como classificação de texto, tradução e perguntas e respostas, além de conjuntos mais especializados para desafios específicos da área.
Agora que já estamos alinhados e entendemos os conceitos-chave por trás da Hugging Face, vamos descobrir como usar essa joia tecnológica.
Este guia vai te conduzir rapidamente pelo básico para começar na Hugging Face, incluindo instalação, uso de modelos pré-treinados, fine-tuning e como compartilhar seus modelos com a comunidade.
Primeiro, combine a biblioteca transformers com sua biblioteca favorita de deep learning, seja TensorFlow ou PyTorch.
A biblioteca transformers pode ser instalada facilmente com o pip, o gerenciador de pacotes do Python.
pip install transformers
Para ter a capacidade completa, instale também as bibliotecas datasets e tokenizers.
pip install tokenizers, datasets
O Model Hub da Hugging Face oferece uma coleção enorme de modelos pré-treinados que você pode usar em uma ampla gama de tarefas de NLP. Vamos ver como usar nosso primeiro modelo pré-treinado.
1. Selecione um modelo pré-treinado: primeiro, escolha um modelo pré-treinado. Para isso, vamos ao Model Hub.
Imagine que queremos inferir o sentimento correspondente a um trecho de texto. Podemos filtrar facilmente apenas os modelos que executam tarefas de "Text Classification" selecionando esse filtro na barra lateral esquerda.
Os modelos da Hugging Face aparecem ordenados por Trending. Normalmente, os primeiros resultados são os mais usados. Vamos selecionar o segundo resultado, que é o modelo de análise de sentimentos mais utilizado.
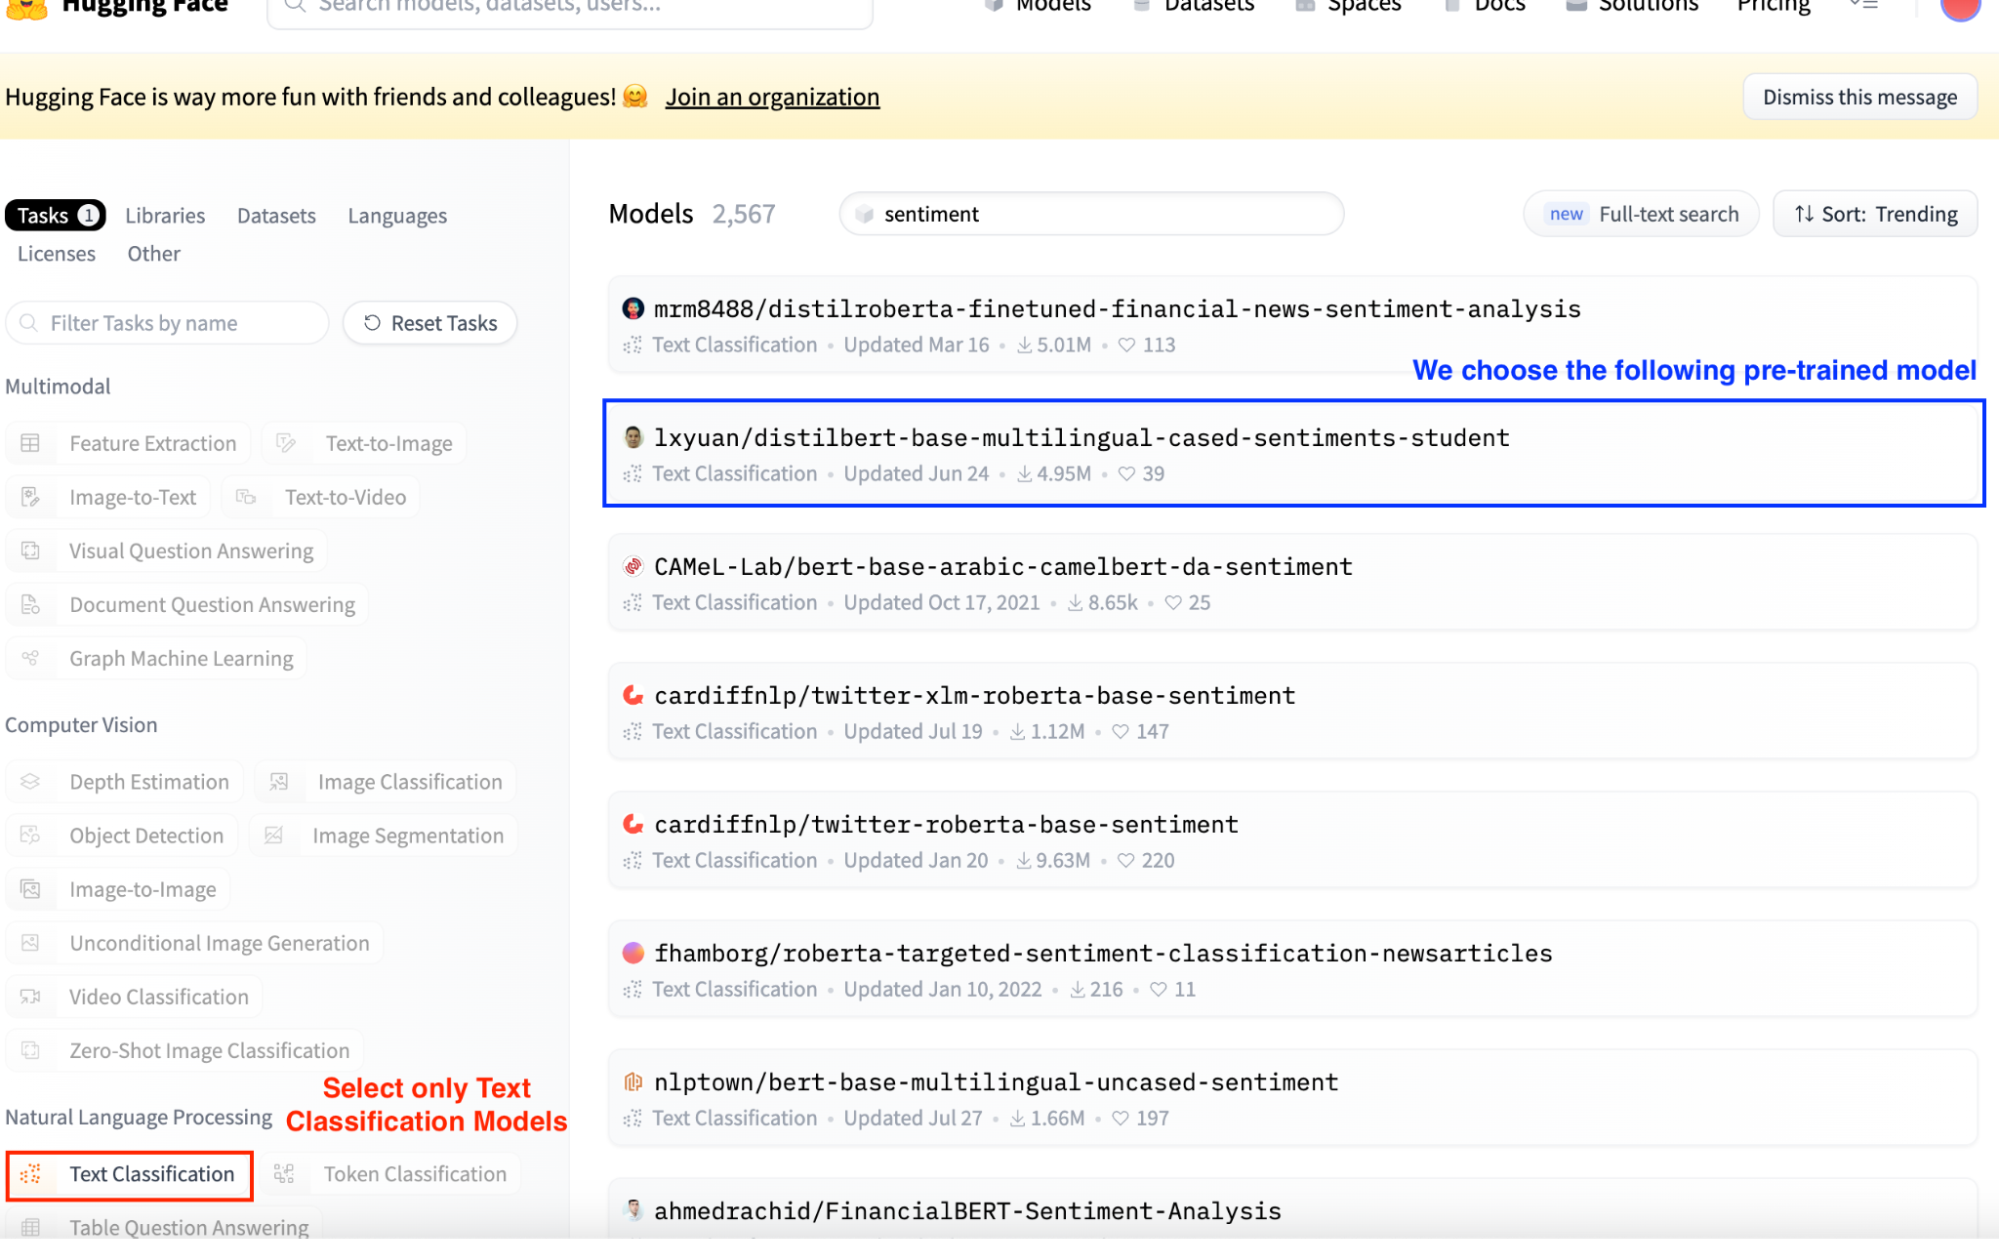
Captura da tela do Hugging Face Model Hub. Selecionando modelos de Text Classification.
Para usar, precisamos copiar o nome correspondente do modelo. Ele aparece no topo da página específica do modelo.
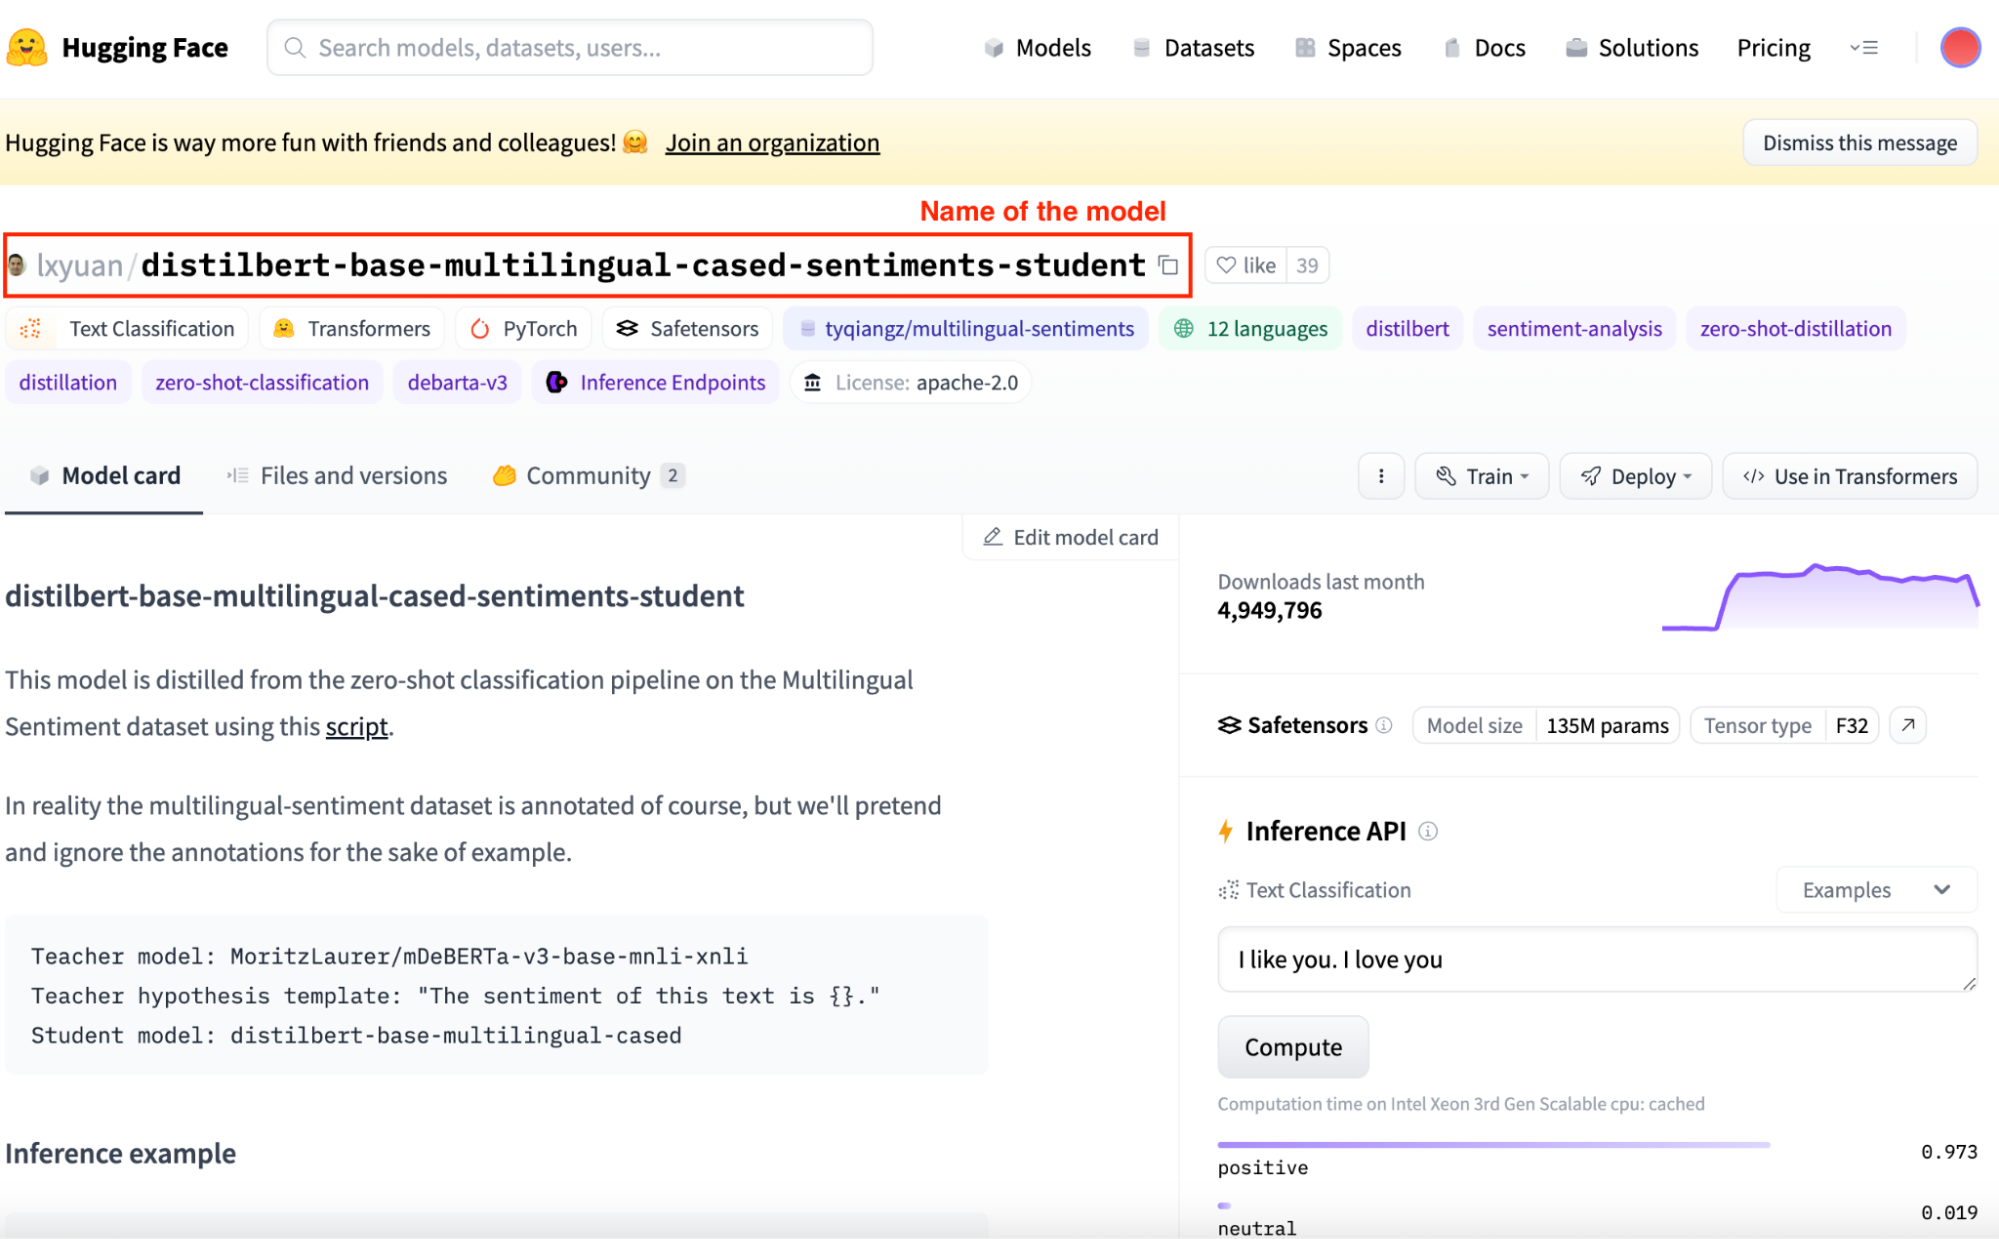
Captura da tela da página de um modelo específico no Model Hub.
1. Carregue um modelo pré-treinado: agora que já sabemos qual modelo usar, vamos rodá-lo em Python. Primeiro, importe as classes AutoTokenizer e AutoModelForSequenceClassification de transformers.
Usar essas classes AutoModel infere automaticamente a arquitetura a partir do nome do modelo.
from transformers import AutoTokenizer, AutoModelForSequenceClassification

model_name = "lxyuan/distilbert-base-multilingual-cased-sentiments-student"

# We call define a model object
model = AutoModelForSequenceClassification.from_pretrained(model_name)
2. Prepare sua entrada: carregue um tokenizer para o modelo; a biblioteca transformers facilita o processo ao inferir o tokenizer a ser usado a partir do nome do modelo escolhido.
#We call the tokenizer class
tokenizer = AutoTokenizer.from_pretrained(model_name)
3. Rode o modelo: gere um objeto de pipeline com o modelo escolhido, o tokenizer e a tarefa a ser executada. No nosso caso, análise de sentimentos. Se você inicializar o objeto do classificador apenas com a tarefa, a classe pipeline preencherá com valores padrão — não recomendado em produção.
# Initializing a classifier with a model and a tokenizer
classifier = pipeline("sentiment-analysis", model = model, tokenizer = tokenizer)
# When passing only the task, the pipeline command inferes both the model and tokenizer.
classifier = pipeline("sentiment-analysis")
Podemos executar o modelo passando uma entrada.
output = classifier("I've been waiting for this tutorial all my life!")
4. Interprete as saídas: o modelo retorna um objeto com vários elementos, dependendo da classe do modelo. Por exemplo, neste caso de análise de sentimentos, teremos algo assim:
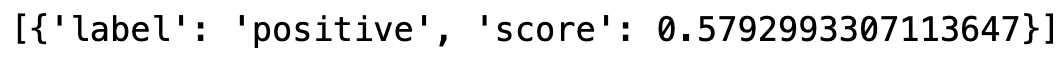
Saída obtida.
Fine-tuning é o processo de pegar um modelo pré-treinado e atualizar seus parâmetros treinando-o em um dataset específico da sua tarefa. Isso permite aproveitar as representações já aprendidas e adaptá-las ao seu caso de uso.
Imagine que precisamos usar um classificador de texto para inferir sentimentos em uma lista de tweets. Uma pergunta natural é: será que esse modelo pré-treinado vai funcionar bem?
Para garantir, podemos fazer o fine-tuning treinando um modelo da Hugging Face com um dataset contendo tweets e seus respectivos sentimentos, melhorando o desempenho.
Veja um exemplo básico de fine-tuning para classificação de sequências:
1. Escolha um modelo pré-treinado e um dataset: selecione uma arquitetura adequada à sua tarefa. Aqui, vamos continuar com o mesmo modelo de análise de sentimentos. Agora precisamos de dados para treinar.
É aqui que entra a biblioteca datasets. Podemos explorar os datasets no Hub e encontrar o que melhor se encaixa.
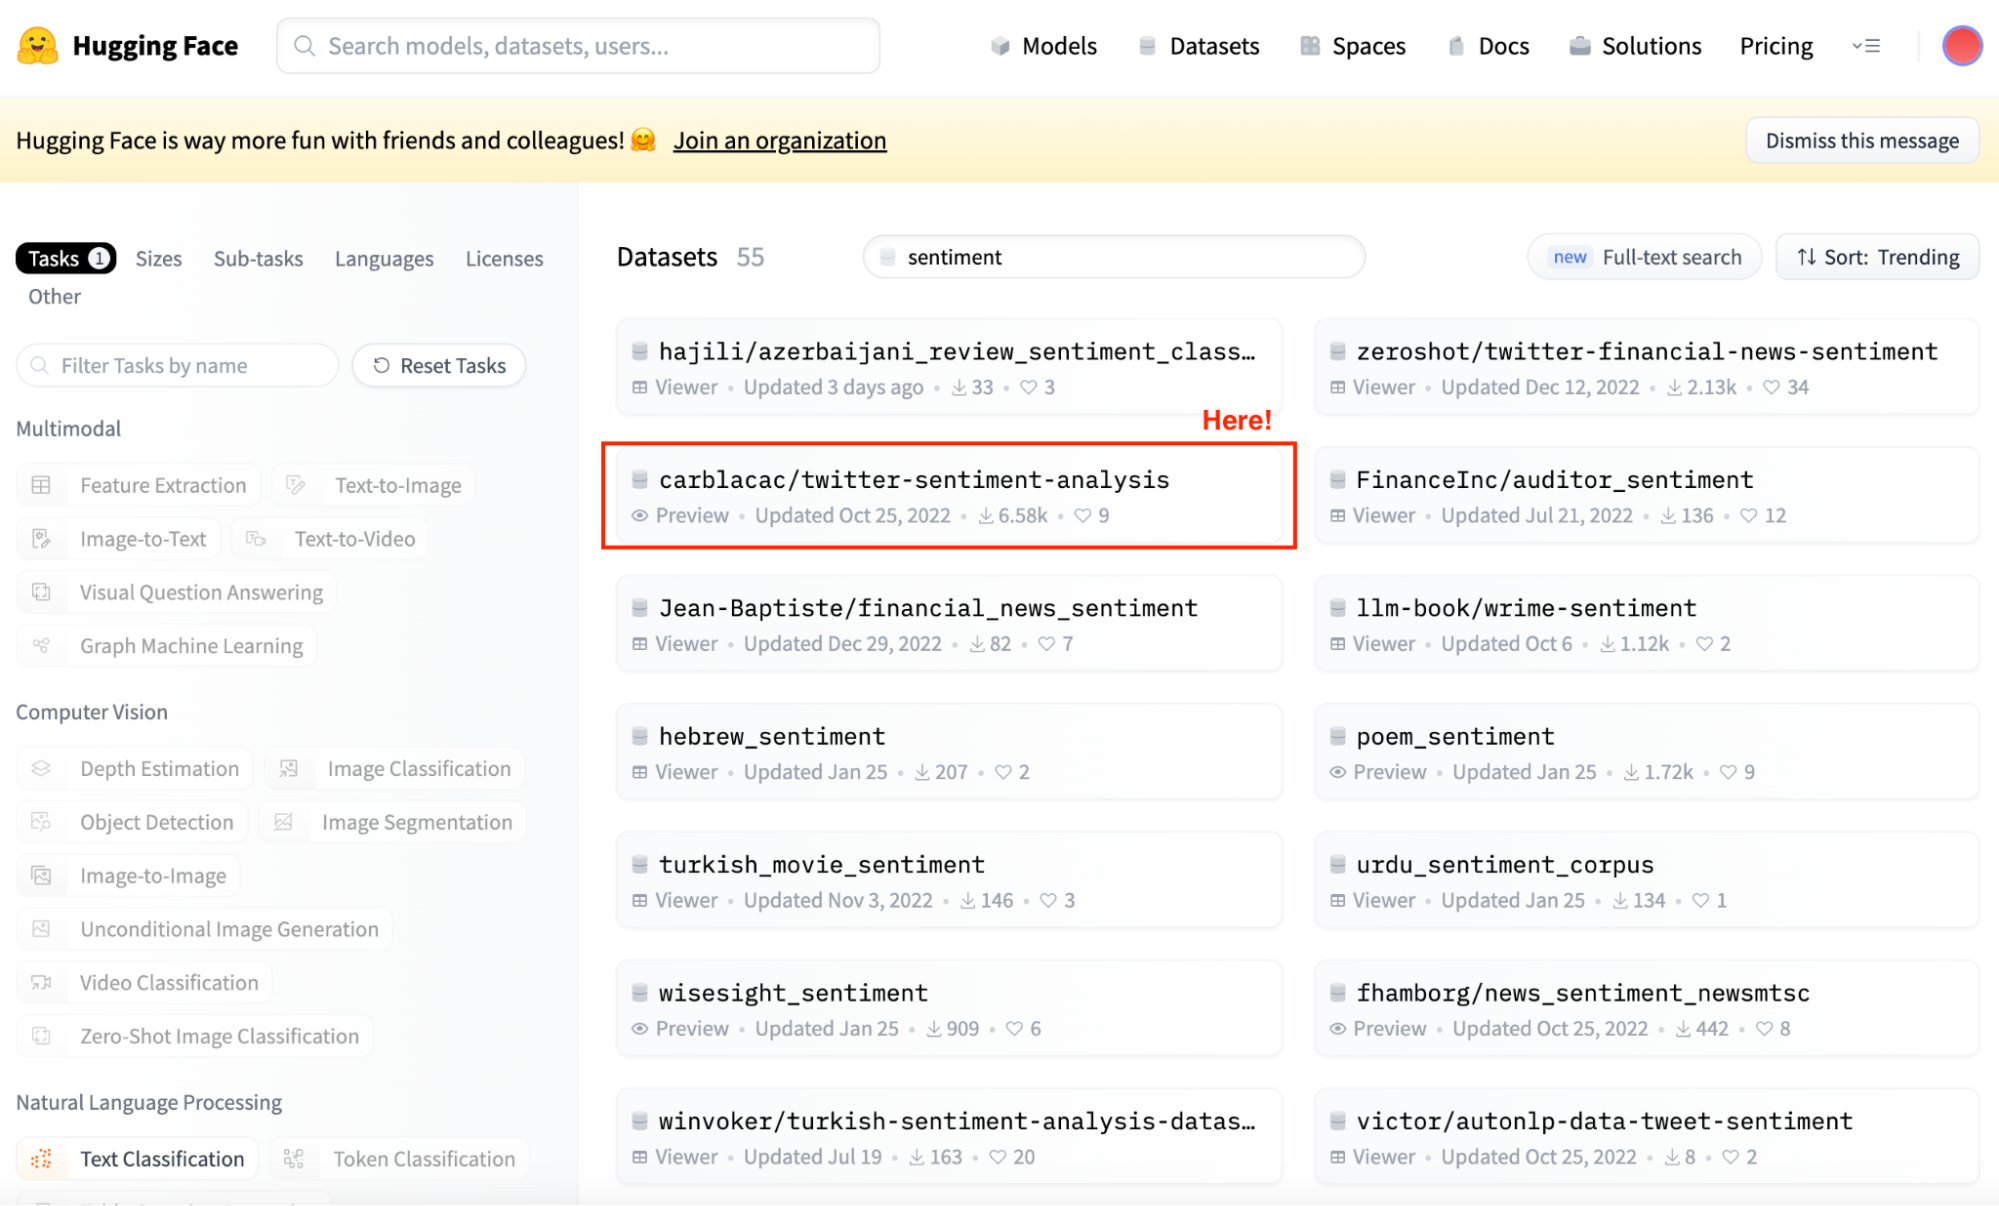
Captura da tela do Datasets Hub. Selecionando datasets de análise de sentimentos.
Agora que já sabemos qual dataset escolher, podemos inicializar o modelo e o dataset.
model = AutoModelForSequenceClassification.from_pretrained(model_name)

# Loading the dataset to train our model
dataset = load_dataset("mteb/tweet_sentiment_extraction")
Se olharmos o dataset baixado, veremos um dicionário contendo subconjuntos de treino e teste. Convertendo o conjunto de treino para um dataframe, ele fica assim:
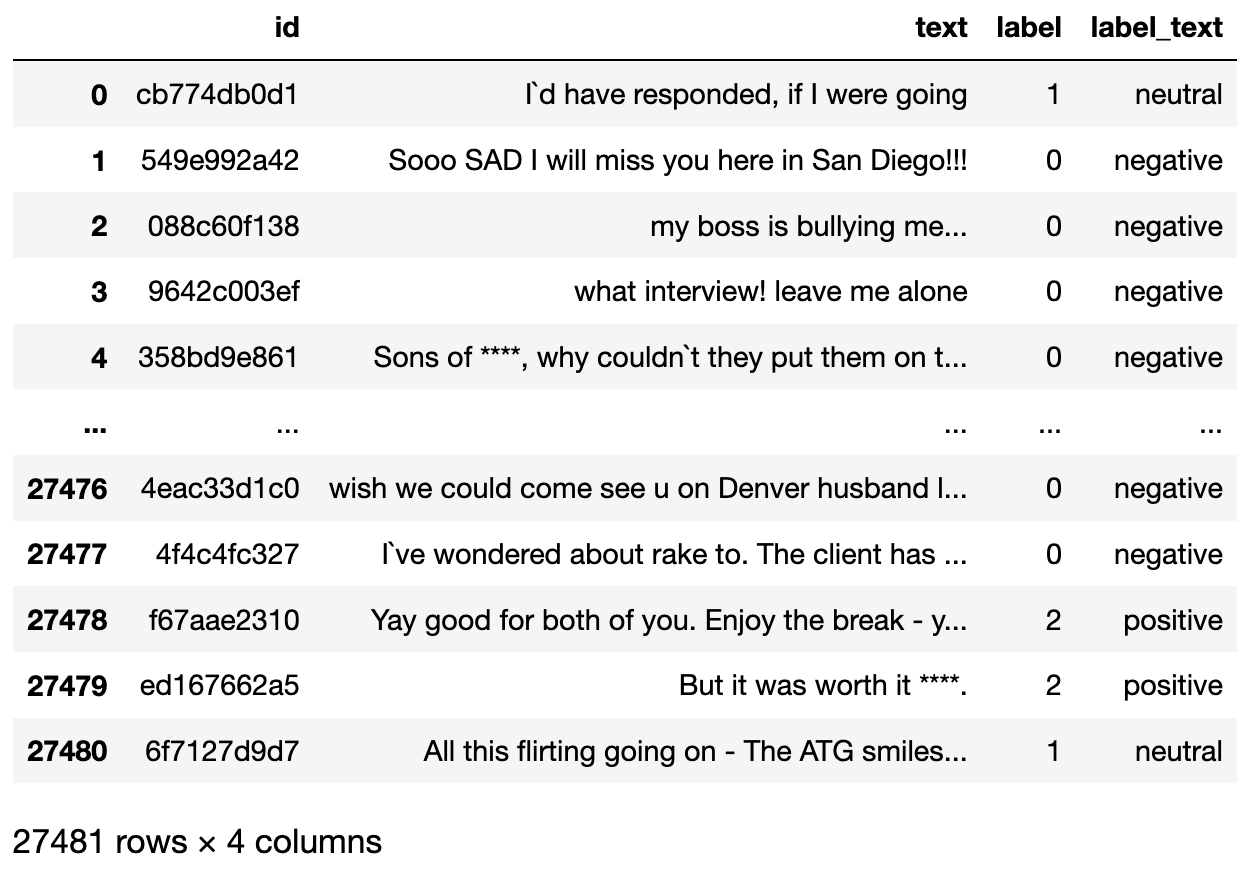
Dataset a ser usado.
2. Prepare seu dataset: agora que temos o dataset, precisamos de um tokenizer para prepará-lo para o modelo. A variável de texto deve ser tokenizada para que possamos fazer o fine-tuning.
Por isso, o segundo passo é carregar um tokenizer pré-treinado e tokenizar o dataset para uso no fine-tuning.
tokenizer = AutoTokenizer.from_pretrained(model_name)

def tokenize_function(examples):
    return tokenizer(examples["text"], padding="max_length", truncation=True)

tokenized_datasets = dataset.map(tokenize_function, batched=True)
3. Construa um dataset do PyTorch com os encodings: o terceiro passo é gerar conjuntos de treino e teste. O de treino será usado no fine-tuning; o de teste, na avaliação.
Normalmente, o fine-tuning leva bastante tempo. Para facilitar o tutorial, vamos amostrar aleatoriamente ambos os conjuntos para reduzir o custo computacional.
from datasets import load_dataset

model = AutoModelForSequenceClassification.from_pretrained(model_name)

# Loading the dataset to train our model
dataset = load_dataset("mteb/tweet_sentiment_extraction")

small_train_dataset = tokenized_datasets["train"].shuffle(seed=42).select(range(1000))
small_eval_dataset = tokenized_datasets["test"].shuffle(seed=42).select(range(1000))
4. Faça o fine-tuning do modelo: o passo final é definir os argumentos de treino e iniciar o processo. A biblioteca transformers traz a classe trainer(), que cuida de tudo.
Primeiro definimos os argumentos de treino e a estratégia de avaliação. Depois, é só treinar com o comando train().
from transformers import Trainer, TrainingArguments
import numpy as np

training_args = TrainingArguments(output_dir="trainer_output", evaluation_strategy="epoch")

metric = evaluate.load("accuracy")

def compute_metrics(eval_pred):
    logits, labels = eval_pred
    predictions = np.argmax(logits, axis=-1)
    return metric.compute(predictions=predictions, references=labels)


trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=small_train_dataset,
    eval_dataset=small_eval_dataset,
    compute_metrics=compute_metrics,
)
trainer.train()
5. Avalie o modelo: após o treino, avalie o desempenho no conjunto de validação ou teste. A classe trainer já inclui um método de avaliação que cuida disso.
import evaluate

trainer.evaluate()
Nosso modelo com fine-tuning apresentou acurácia de 70%.
Agora que já melhoramos o modelo, como compartilhá-lo com a comunidade? Esse é o passo final.
Depois de fazer o fine-tuning, você pode querer compartilhar seu modelo com a comunidade.
A Hugging Face torna isso bem simples. Primeiro, instale a biblioteca huggingface_hub.
Para este passo final, é necessário ter um token ativo para conectar à sua conta da Hugging Face. Você pode obter um facilmente seguindo este guia. Ao trabalhar em um Jupyter Notebook, podemos importar a função notebook_login.
from huggingface_hub import notebook_login

notebook_login()
Isso abrirá um prompt de login no Jupyter Notebook. Basta enviar seu token, e o notebook estará conectado à sua conta na Hugging Face.
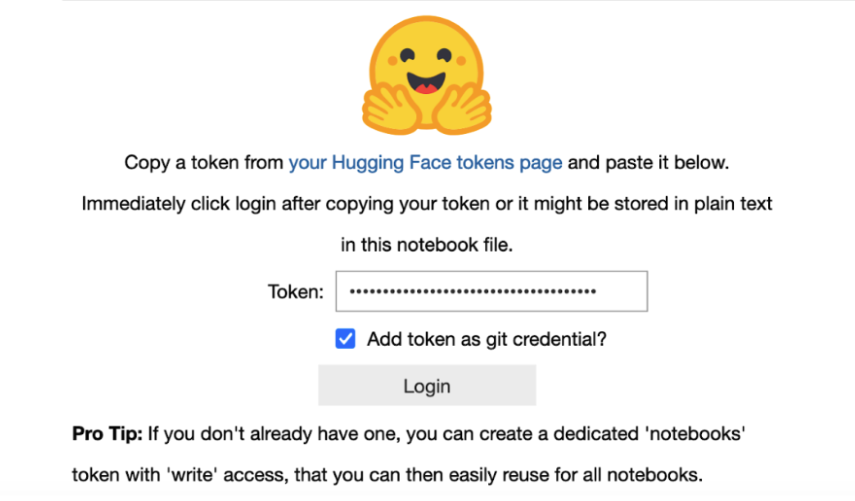
Agora é só enviar o modelo com o comando push_to_hub.
finetuned_model.push_to_hub("my-awesome-model")
Depois disso, o modelo ficará disponível para todos no seu perfil da Hugging Face.
Se quisermos padronizar qualquer processo de NLP, com a Hugging Face geralmente são três passos simples que cabem em menos de cinco linhas de código:
1. Definir um objeto de modelo com a classe pipeline (e o modelo e tokenizer correspondentes).
2. Definir o texto de entrada ou prompt.
3. Executar o modelo pré-treinado com a entrada e observar a saída.
Classificação de texto é uma tarefa fundamental em NLP. Consiste em atribuir a cada texto de entrada uma ou mais categorias. Isso pode ser usado em várias aplicações, como detecção de spam, análise de sentimentos, rotulagem de tópicos e muito mais.
No exemplo abaixo, você vê como, com apenas aqueles três passos, já implementamos um modelo de classificação de texto.
# We import the pipeline module from the transformers library
from transformers import pipeline

# We load the pre-trained text classification model.
classifier = pipeline("text-classification",model='lxyuan/distilbert-base-multilingual-cased-sentiments-student')

# Input to be classified
input_ = "I absolutely love the transformers library!"

# Perform classification
output_ = classifier(input_)

# Observer the result
print(output_)
Fácil, né?
Vamos então ao segundo caso de uso — um dos mais populares de todos os tempos.
Você provavelmente já conhece o ChatGPT ou o Google Bard, que geram texto a partir de um prompt. Esse processo é chamado de “geração de texto” e é um aspecto fascinante do NLP, no qual um modelo produz texto parecido com o humano a partir de uma entrada inicial.
As aplicações vão de respostas para chatbots à geração de textos criativos.
A ideia central é treinar um modelo em um grande corpus de textos, permitindo que ele aprenda padrões, estilos e estruturas da linguagem. Como você pode imaginar, a parte mais cara é justamente o treinamento.
Mas a Hugging Face permite implementar um modelo assim em cinco linhas de código, como no caso anterior.
Veja o exemplo:
from transformers import pipeline

generator = pipeline('text-generation', model='gpt2')

prompt = "In a world dominated by AI,"

generated_text = generator(prompt, max_length=50)[0]['generated_text']

print(generated_text)
Perguntas e respostas (QA) é um campo do NLP focado em criar sistemas que respondem automaticamente a perguntas feitas em linguagem natural.
Sistemas de QA são amplamente usados em assistentes virtuais, suporte ao cliente e sistemas de busca de informações.
Eles podem ser divididos em dois tipos:
Esses sistemas normalmente combinam compreensão de linguagem natural para interpretar a pergunta e técnicas de recuperação de informação para encontrar respostas relevantes.
Mais uma vez, implementar um desses modelos com a Hugging Face é rápido e fácil.
from transformers import pipeline

qa_pipeline = pipeline('question-answering', model='distilbert-base-uncased-distilled-squad')

context = """Paris is the capital and most populous city of France. The city has an area of 105 square kilometers and a population of 2,140,526 residents."""
question = "What is the population of Paris?"

answer = qa_pipeline(question=question, context=context)
print(answer)
O último caso de uso é tradução. Tradução automática é um subcampo da linguística computacional que foca em traduzir texto ou fala de um idioma para outro usando software. Com o avanço do deep learning, a tradução automática deu saltos importantes, especialmente com modelos de tradução neural (NMT) que usam grandes redes neurais.
Sistemas modernos de NMT, ao contrário dos modelos tradicionais baseados em regras ou estatísticos, aprendem a traduzir treinando em grandes conjuntos de textos bilíngues. Eles usam arquiteturas sequence-to-sequence, em que uma parte da rede codifica o texto de origem e outra decodifica para o idioma de destino, muitas vezes com fluência e precisão impressionantes.
Um exemplo simples usando a Hugging Face seria:
from transformers import pipeline

# Load the translation pipeline for English to Spanish
translator = pipeline('translation_en_to_de')

# Text to translate from English to Spanish
text_to_translate = "This is a great day for science!"

# Perform the translation
translation = translator(text_to_translate, max_length=40)

# Print the translated text
print(translation[0]['translation_text'])
A Hugging Face surgiu como uma força transformadora em inteligência artificial e processamento de linguagem natural. Seu conjunto abrangente de ferramentas — incluindo a revolucionária biblioteca Transformers, o colaborativo Model Hub e a extensa biblioteca Datasets — democratizou o acesso a capacidades avançadas de NLP.
Ao fomentar um ambiente em que a inovação é compartilhada e construída coletivamente, a Hugging Face não só impulsiona o avanço da IA, como também ajuda a moldar um futuro em que a tecnologia é mais acessível, inclusiva e poderosa.
À medida que continuamos a testemunhar — e participar — da revolução da IA, a Hugging Face nos lembra que os avanços tecnológicos mais profundos são aqueles abertos, compartilhados e construídos em conjunto.
Não se trata apenas de criar máquinas mais inteligentes, mas de fortalecer uma comunidade mais inteligente e conectada de desenvolvedores, pesquisadores e entusiastas dispostos a expandir os limites do possível.
Comece sua jornada em IA & NLP hoje!
Programa
Programa
Curso
blog
Khalid Abdelaty
15 min
blog
Richie Cotton
8 min
blog
Abid Ali Awan
9 min
Tutorial
Zoumana Keita
14 min
Tutorial
Zoumana Keita
12 min
Tutorial
Zoumana Keita
7 min