
Program
Doğal Dil İşleme Python'da
20 sa
Günümüzün hızla değişen teknoloji dünyasında Yapay Zekâ, gündelik deneyimlerimizin içine zahmetsizce dokunan, kritik ve her an var olan bir alan olarak öne çıkıyor. Bu YZ dalgasının merkezinde, ChatGPT ve Bard gibi popüler sohbet araçlarını besleyen sofistike bir alan olan Doğal Dil İşleme yer alıyor.
Peki ya bu araçları mümkün kılan modellerin çoğunun herkesin erişimine açık ve tek bir yerde toplandığını söylesek?
Karşınızda: Hugging Face. Makine öğrenimi ve doğal dil işlemede oyunun kurallarını değiştiren, YZ’nin demokratikleşmesinde kilit bir aktör. Transfer öğrenme sayesinde YZ’yi daha erişilebilir kılmada kritik bir rol oynuyor.
Bugün itibarıyla GitHub’da 115 binden fazla yıldıza sahip, Python’daki en popüler NLP kütüphanesini barındırıyor ve YZ meraklıları ile profesyonellerinin kendi modellerini denemeleri, dağıtmaları ve ölçeklendirmeleri için başvurdukları kilit platformlardan biri hâline geldi.
İster veri profesyoneli olun ister meraklı bir başlangıç seviyesinde, Hugging Face makine öğrenimiyle mümkün olanların sınırlarını zorlayarak YZ projelerinizi hayata geçirmeniz için gerekli araç ve kaynakları sunuyor.
Öyleyse, Hugging Face’in neler sunduğunu keşfedelim!
Kod eşliğinde içeriğimizle, Hugging Face ile Açık Kaynak YZ Modellerini Kullanma hakkında daha fazlasını da öğrenebilirsiniz.
Çoğu kişi için Hugging Face, telefon klavyelerindeki bir başka emoji olabilir (🤗)
Ancak teknoloji dünyasında, ML âleminin GitHub’ı gibidir — herkesin açık kaynak kod kullanarak NLP ve ML modelleri oluşturmasını, eğitmesini ve dağıtmasını sağlayan araçlarla dolu işbirlikçi bir platform.
Devrim niteliğindeki fark ne?
Bu modeller önceden eğitilmiş olarak geliyor; bu da NLP’ye giriş sürecini daha da kolaylaştırıyor. Basitçe söylemek gerekirse, geliştiriciler artık sıfırdan başlamıyor; Hugging Face hub’ından önceden eğitilmiş bir modeli yüklüyor, kendi görevlerine göre ince ayar yapıyor ve oradan devam ediyorlar.
Bu kullanım kolaylığı geliştirme sürecini büyük ölçüde basitleştiriyor.
Dolayısıyla Hugging Face; veri bilimcilerin, araştırmacıların ve ML mühendislerinin fikir alışverişinde bulunduğu, destek aradığı ve açık kaynak girişimlere katkıda bulunduğu bir merkez.
Kendilerini şöyle tanımlıyorlar:
“Geleceği inşa eden YZ topluluğu.”
Bu vizyon, Hugging Face’in başarısının gizli bileşenlerinden biri: topluluk odaklı bir yaklaşım.
Hızlı büyümesinin bir diğer nedeni ise platformun sezgisel yapısı. Basit bir arayüz sunmak, hem yeni başlayanlar hem de profesyoneller için işe girişmeyi kolaylaştırıyor.
En büyük NLP ve ML kaynak koleksiyonunu barındırma hedefiyle, Hugging Face YZ’yi demokratikleştirmeye ve küresel topluluğa erişilebilir kılmaya kararlı.
2016’da kurulan Hugging Face, başlangıçta gençleri hedefleyen etkileşimli bir YZ sohbet botu geliştirmeyi amaçlayan ABD-Fransa ortaklı bir şirketti. Ancak bu sohbet botunu çalıştıran modeli açık kaynak yaptıktan sonra hızla daha büyük bir vizyona yöneldi: YZ endüstrisini güçlü ve erişilebilir araçlarla donatmak.
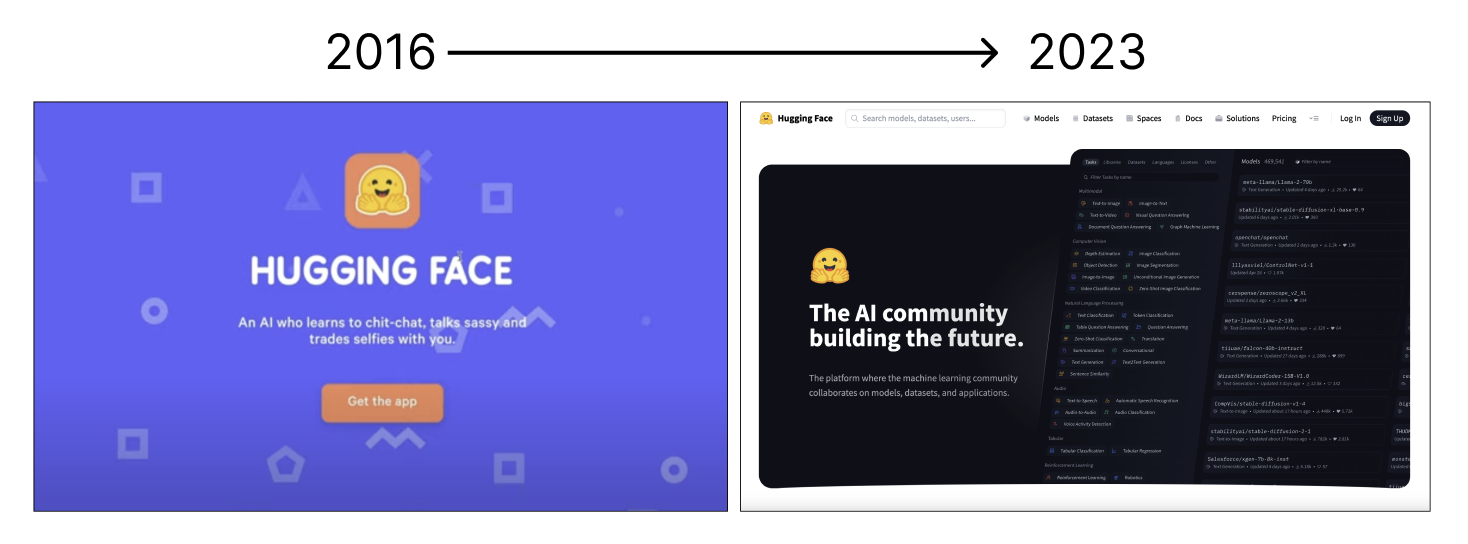
Yazarın görseli.
2018’de dönüştürücü Transformers kütüphanesinin piyasaya sürülmesi, BERT ve GPT gibi, NLP görevlerinde temel hâline gelen önceden eğitilmiş modelleri sunarak YZ topluluğuna yaptıkları en büyük ve en bilinen katkılardan birini işaret etti.
Bugün HuggingFace, ML ekosistemini tamamen dönüştürdü. Açık kaynak işbirliğine bağlılığı, NLP’de yeniliği hızlandırarak teknolojinin topluca gelişmesine olanak tanıdı.
Platform, model ve veri kümesi paylaşımı için bir kavşak hâline gelerek YZ araştırmalarını ve pratik uygulamaları ileri taşıdı.
Mottoları ne?
“İyi Makine Öğrenimini, her commit’te bir demokratikleştirin.”
Stratejik ortaklıklar ve gelişmiş NLP araçlarını geniş kitlelere sunma kararlılığı sayesinde Hugging Face, topluluğun ayrılmaz bir parçası hâline geldi; YZ’nin sınırlarını sürekli zorlayıp en yeni teknolojilere erişimi demokratikleştiriyor.
Hugging Face, geniş yelpazeye yayılan dil işleme ihtiyaçlarına hitap eden temel bileşen ve özellikleriyle modern NLP’nin yapı taşlarından biri oldu.
Şimdi her birini tek tek inceleyelim.
Transformers kütüphanesi, özellikle NLP için tasarlanmış, son teknoloji makine öğrenimi modellerinden oluşan kapsamlı bir araç takımıdır. Metin sınıflandırma, dil üretimi, çeviri ve özetleme gibi görevler için optimize edilmiş geniş bir önceden eğitilmiş model koleksiyonunu içerir.
Hugging Face, yaygın NLP görevlerini, çok çeşitli görevleri gerçekleştirmek için kullanımı kolay bir API olan `pipeline()` yöntemine soyutladı. Bu pipelines, kullanıcıların karmaşık modelleri gerçek dünya problemlerine kolayca uygulamasını sağlar. Bu kütüphanenin ardındaki yapıyı daha iyi anlamak isterseniz, Transformers ve Hugging Face Kullanımına Giriş makalesini şiddetle öneririm.
Bu modellere erişmek ve onları özelleştirmek kolaydır; bu durum geliştiriciler ve araştırmacılar için devrim niteliğindedir ve sofistike NLP modellerini daha erişilebilir kılmada kilit rol oynamıştır.
Önemi, NLP modellerini eğitme ve dağıtma süreçlerindeki karmaşıklıkları soyutlayabilmesinde yatıyor; böylece uygulayıcılar, minimum kodla gelişmiş NLP özelliklerini hayata geçirebiliyor.
Kütüphane, altta yatan algoritmalara dalmadan önceden eğitilmiş modellerden yararlanmayı sağlar.
Transformers kütüphanesi, NLP modellerinin uygulanmasını çeşitli temel yollarla basitleştirir:
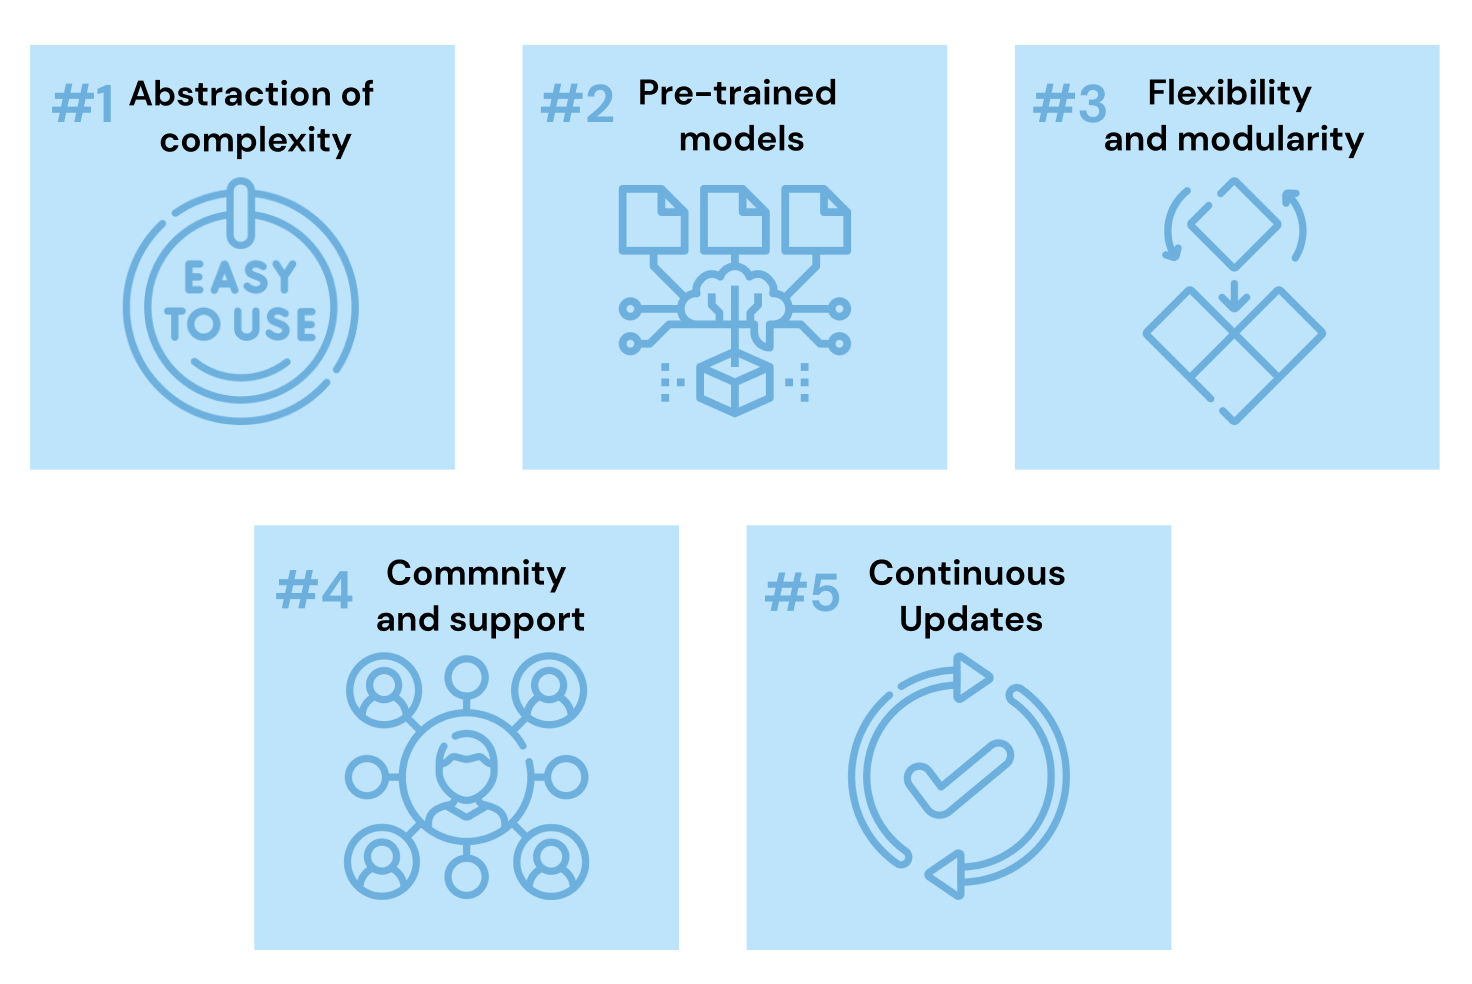
Transformers kütüphanesinin bize sağladığı tüm kolaylıkları bizzat görmek isterseniz, PyTorch ile Bir Transformer İnşa Etme yazısıyla bir NLP modelini nasıl dağıtacağınızı öğrenin.
Model Hub, topluluğun vitrini olarak öne çıkar; binlerce model ve veri kümesine parmaklarınızın ucundan ulaşabileceğiniz bir platformdur. Topluluk tarafından katkı sunulan modellerin paylaşılmasını ve keşfedilmesini sağlayan yenilikçi bir özelliktir; NLP geliştirmeye işbirlikçi bir yaklaşım kazandırır.
Resmî web sitelerinde bunu inceleyebilirsiniz. Gezginde Models düğmesine tıklayarak Model Hub’ı seçebilir ve aşağıdakine benzer bir görünümle karşılaşabilirsiniz:
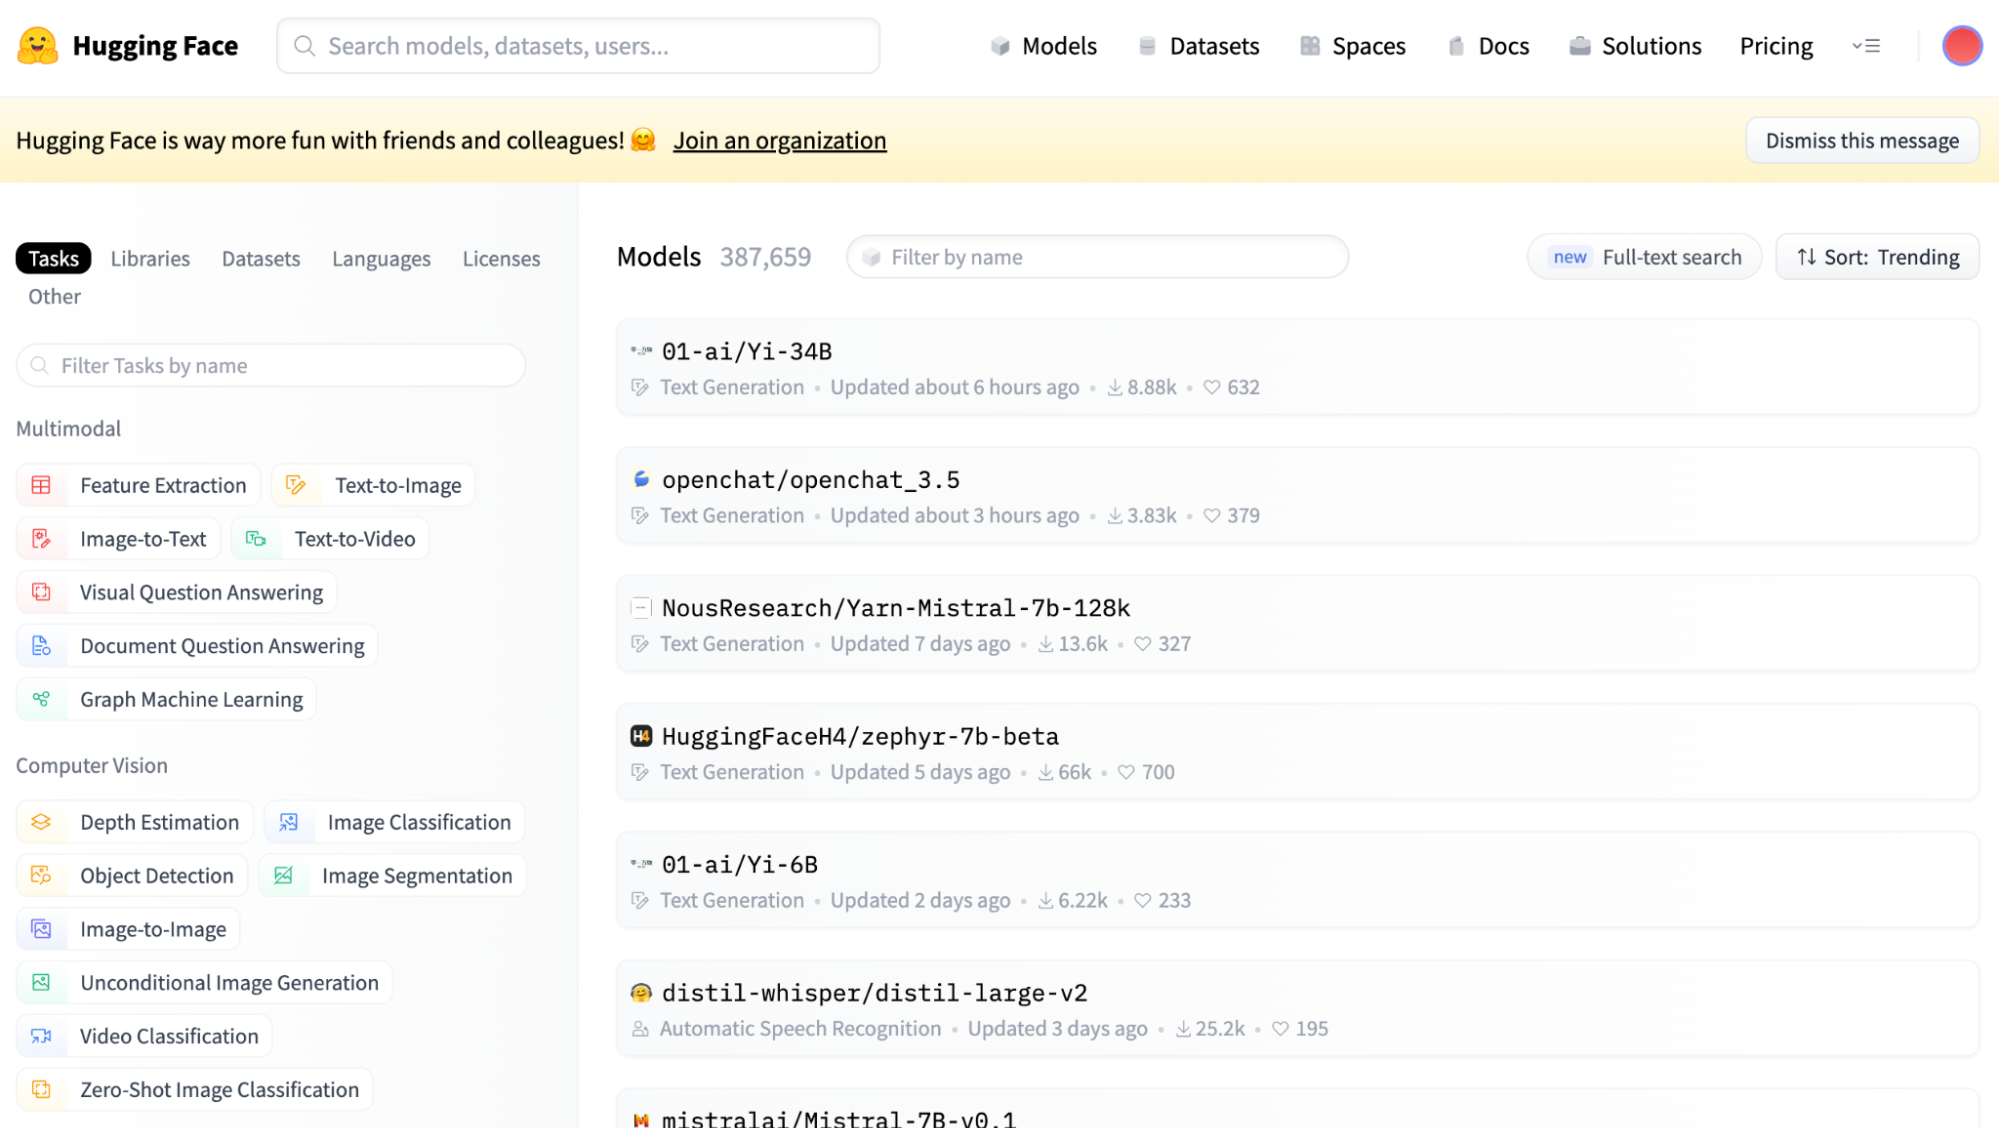
Hugging Face Model Hub ana görünümünün ekran görüntüsü.
Gördüğünüz gibi sol kenar çubuğunda, gerçekleştirilecek ana göreve ilişkin birden çok filtre vardır.
Model Hub’a katkıda bulunmak, Hugging Face’in araçları sayesinde kolaydır; kullanıcıları model yükleme sürecinde yönlendirir. Katkıda bulunulan modeller, hub üzerinden doğrudan ya da Hugging Face Transformers kütüphanesiyle entegrasyon yoluyla tüm topluluğun kullanımına açılır.
Bu erişim ve katkı kolaylığı, son teknoloji modellerin sürekli iyileştirildiği ve genişletildiği dinamik bir ekosistemi besler; NLP’nin ilerlemesi için zengin ve işbirlikçi bir temel sunar.
Tokenizer’lar NLP’de kritik öneme sahiptir; metni, makine öğrenimi modellerinin anlayabileceği bir biçime dönüştürmekten sorumludurlar; bu da farklı dilleri ve metin yapılarını işlemek için elzemdir.
Metni, kelime, alt kelime veya karakter gibi temel birimler olan token’lara ayırmaktan sorumludurlar; böylece veriyi, makine öğrenimi modellerinin işlemesi için hazırlarlar. Bu token’lar, modellerin insan dilini anlamasını ve üretmesini sağlayan yapı taşlarıdır.
Ayrıca token’ların modele girdi olarak vektör temsillere dönüştürülmesini kolaylaştırır; sabit dizi uzunlukları için padding ve truncation işlemlerini yönetirler.
Hugging Face, Transformers kütüphanesine optimize edilmiş, kullanıcı dostu bir tokenizer yelpazesi sunar; bu araçlar metnin sorunsuz ön işlenmesinde kilit rol oynar. Tokenleştirme hakkında ayrı bir yazıda daha fazlasını okuyabilirsiniz.
Bir diğer temel bileşen ise Hugging Face Datasets kütüphanesidir; ML modellerinin eğitimi ve kıyaslamasını destekleyen geniş bir NLP veri kümesi deposudur.
Bu kütüphane, alandaki geliştiriciler için kritik bir araçtır; çok çeşitli görevlerde herhangi bir NLP modelini eğitmek, test etmek ve kıyaslamak için kullanılabilecek zengin bir veri kümesi koleksiyonu sunar.
Sunduğu başlıca faydalardan biri, basit ve kullanıcı dostu arayüzüdür. Hugging Face Hub’da tüm veri kümelerini tarayıp keşfedebilirsiniz; kodda kullanmak için ise, herhangi bir veri kümesini zahmetsizce indirmenizi sağlayan veri kümesi kütüphanesi mevcuttur.
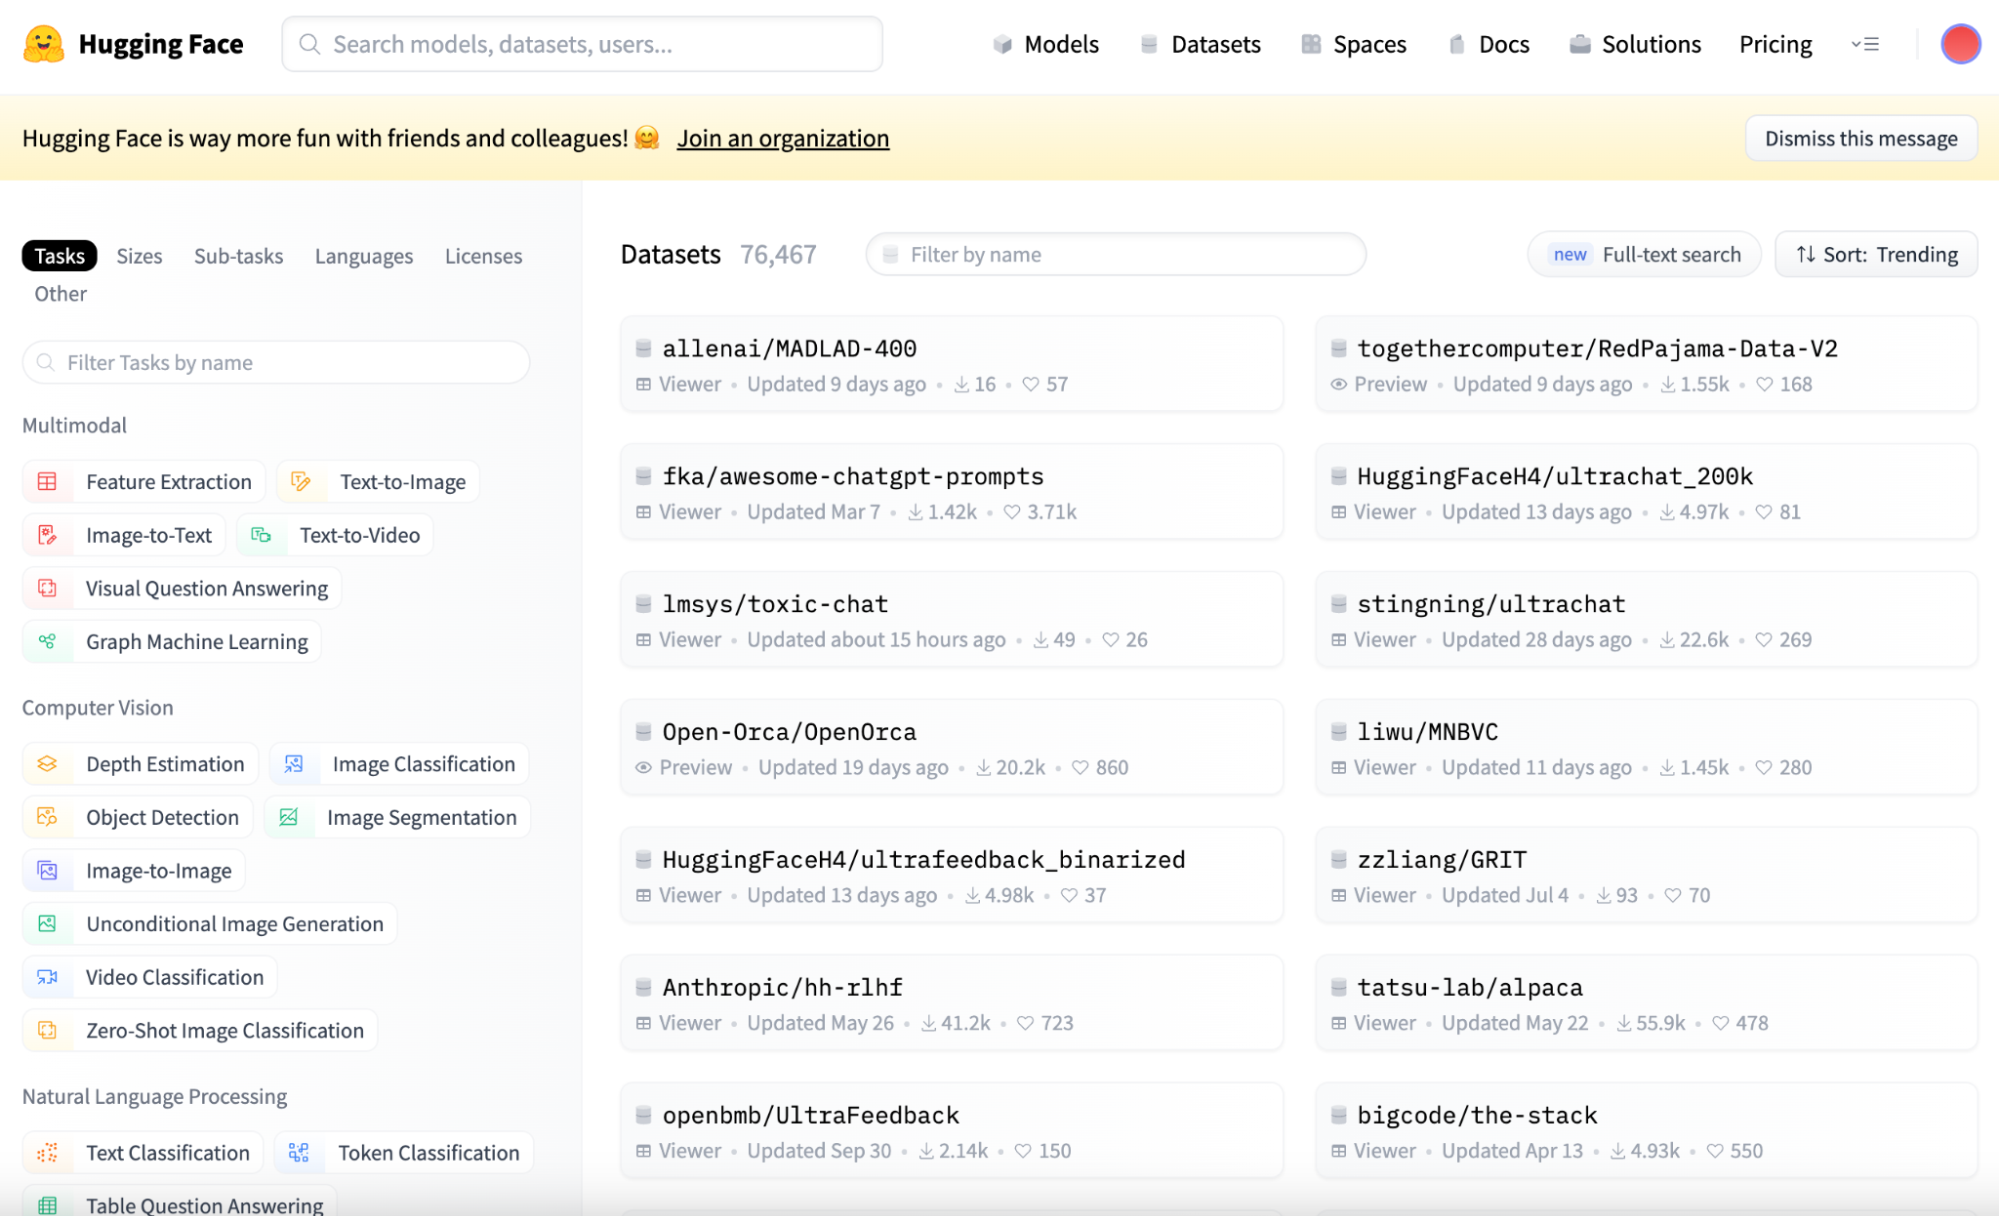
Hugging Face Datasets ana görünümünün ekran görüntüsü.
Metin sınıflandırma, çeviri ve soru-cevap gibi yaygın görevler için veri kümelerini; ayrıca alandaki özgün zorluklara yönelik daha özel veri kümelerini içerir.
Artık aynı noktadayız ve Hugging Face’in temel kavramlarını anladığımıza göre, bu teknolojik mücevheri nasıl kullanacağımızı keşfedelim.
Bu rehber, kurulum, önceden eğitilmiş modellerin kullanımı, ince ayar (fine-tuning) ve modellerinizi toplulukla paylaşma dâhil olmak üzere Hugging Face’e başlamanın temellerini kısaca anlatacak.
Önce, transformers kütüphanesini favori derin öğrenme kütüphanenizle, yani TensorFlow veya PyTorch ile birlikte kullanmalısınız.
Transformers kütüphanesi, Python’un paket yükleyicisi pip ile kolayca kurulabilir.
pip install transformers
Tam yetenek seti için datasets ve tokenizers kütüphanelerini de kurmalısınız.
pip install tokenizers, datasets
Hugging Face’in model hub’ı, çok geniş bir NLP görev yelpazesi için kullanabileceğiniz devasa bir önceden eğitilmiş model koleksiyonu sunar. İlk önceden eğitilmiş modelimizi nasıl kullanacağımızı keşfedelim.
1. Önceden eğitilmiş bir model seçin: Önce bir önceden eğitilmiş model seçmeniz gerekir. Bunun için Model Hub’a gidiyoruz.
Diyelim ki bir metin dizesine karşılık gelen duyguyu çıkarmak istiyoruz. Sol kenar çubuğundan Text Classification düğmesini seçerek yalnızca `Text Classification` görevini yapan modellere kolayca göz atabiliriz.
Hugging Face modelleri her zaman Trend olanlara göre sıralanır. Genellikle üst sıralardakiler en çok kullanılanlardır. Bu yüzden, en çok kullanılan duygu analizi modeli olan ikinci sonucu seçiyoruz.
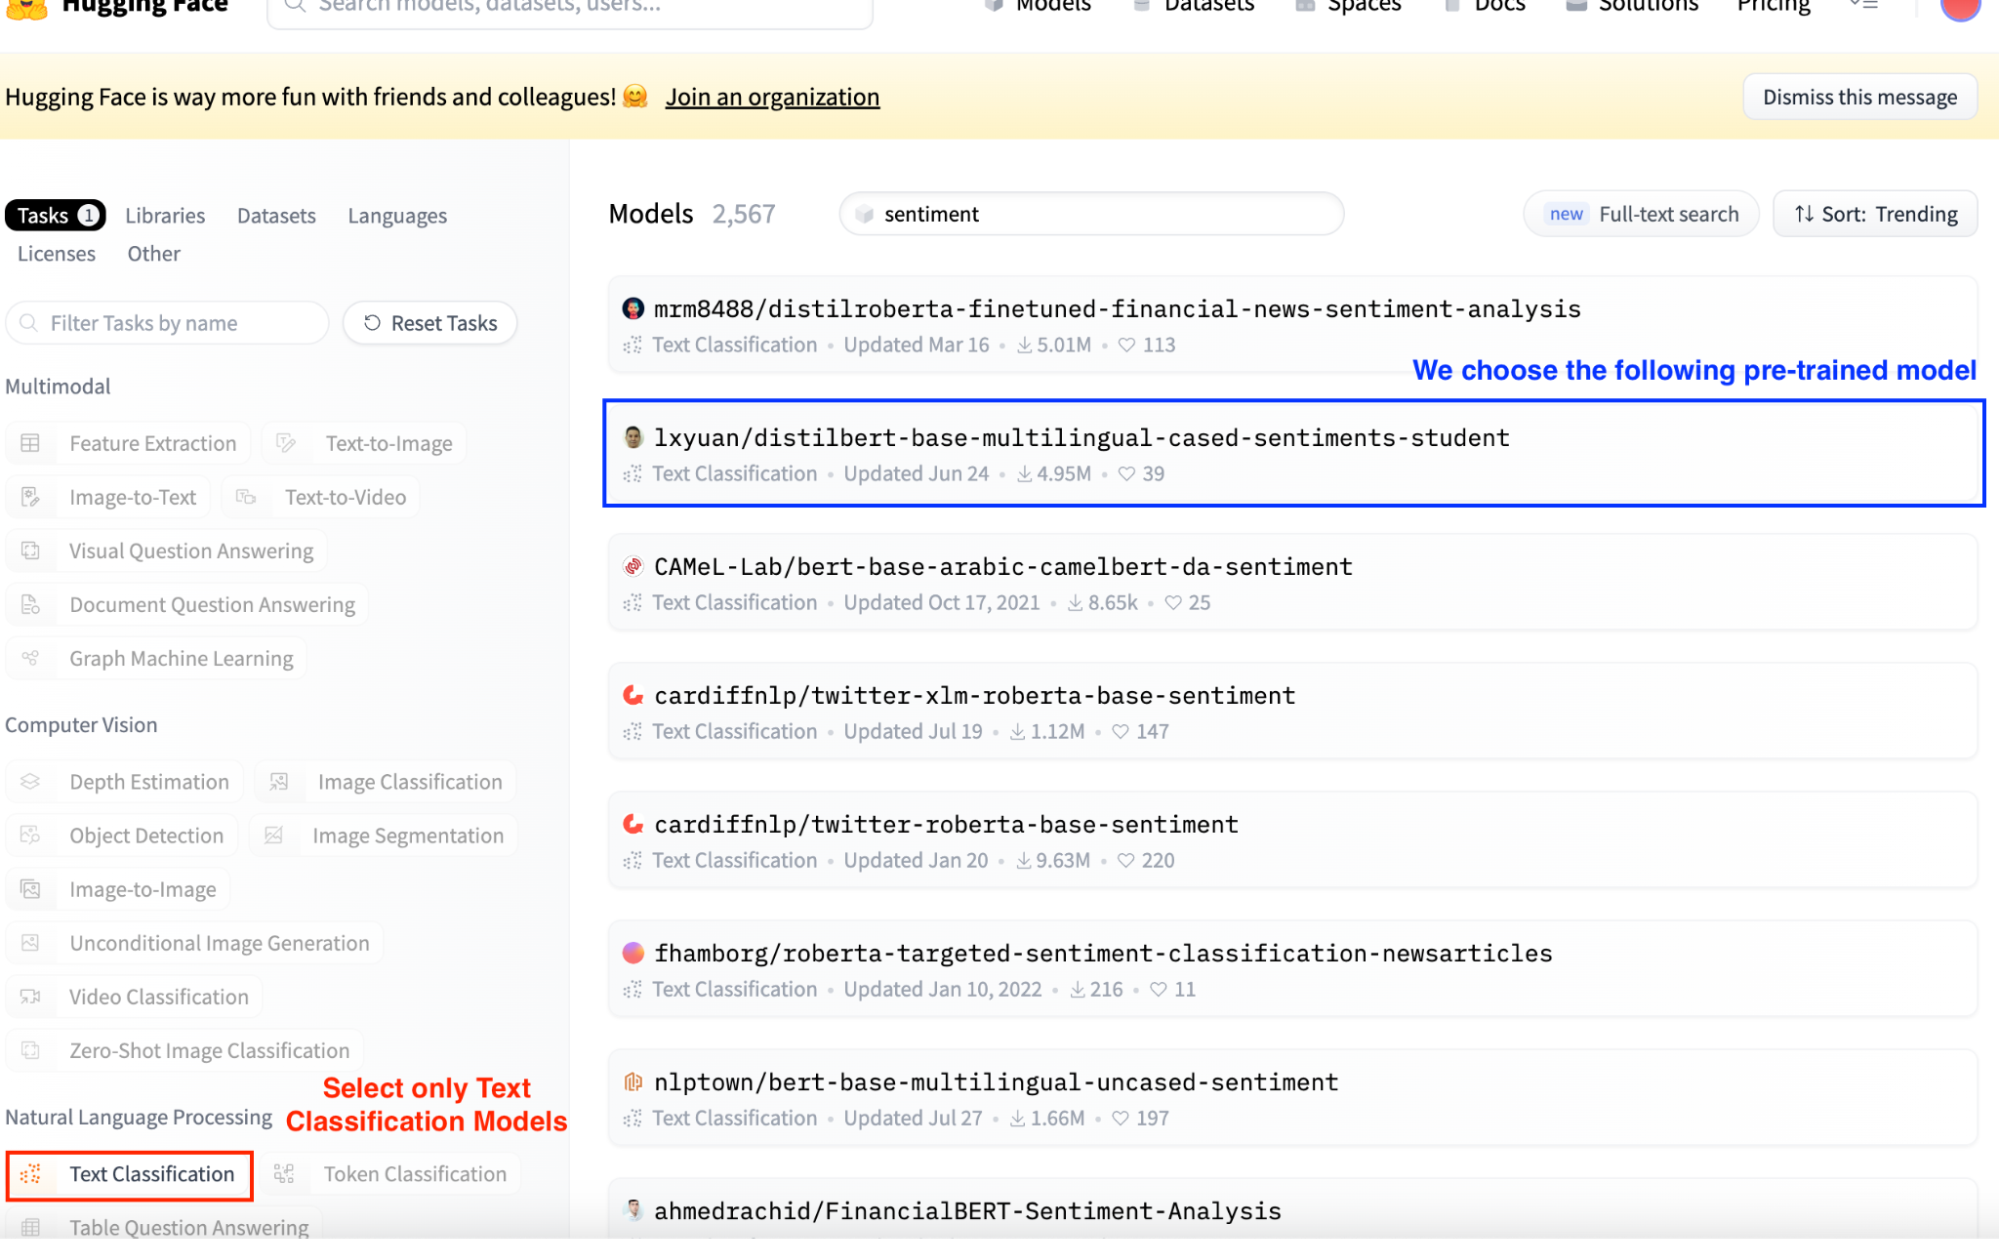
Hugging Face Model Hub ana görünümünün ekran görüntüsü. Metin Sınıflandırma modelleri seçiliyor.
Kullanmak için modelin adını kopyalamamız gerekir. Bu ad, modelin özel sayfasının üst kısmında bulunur.
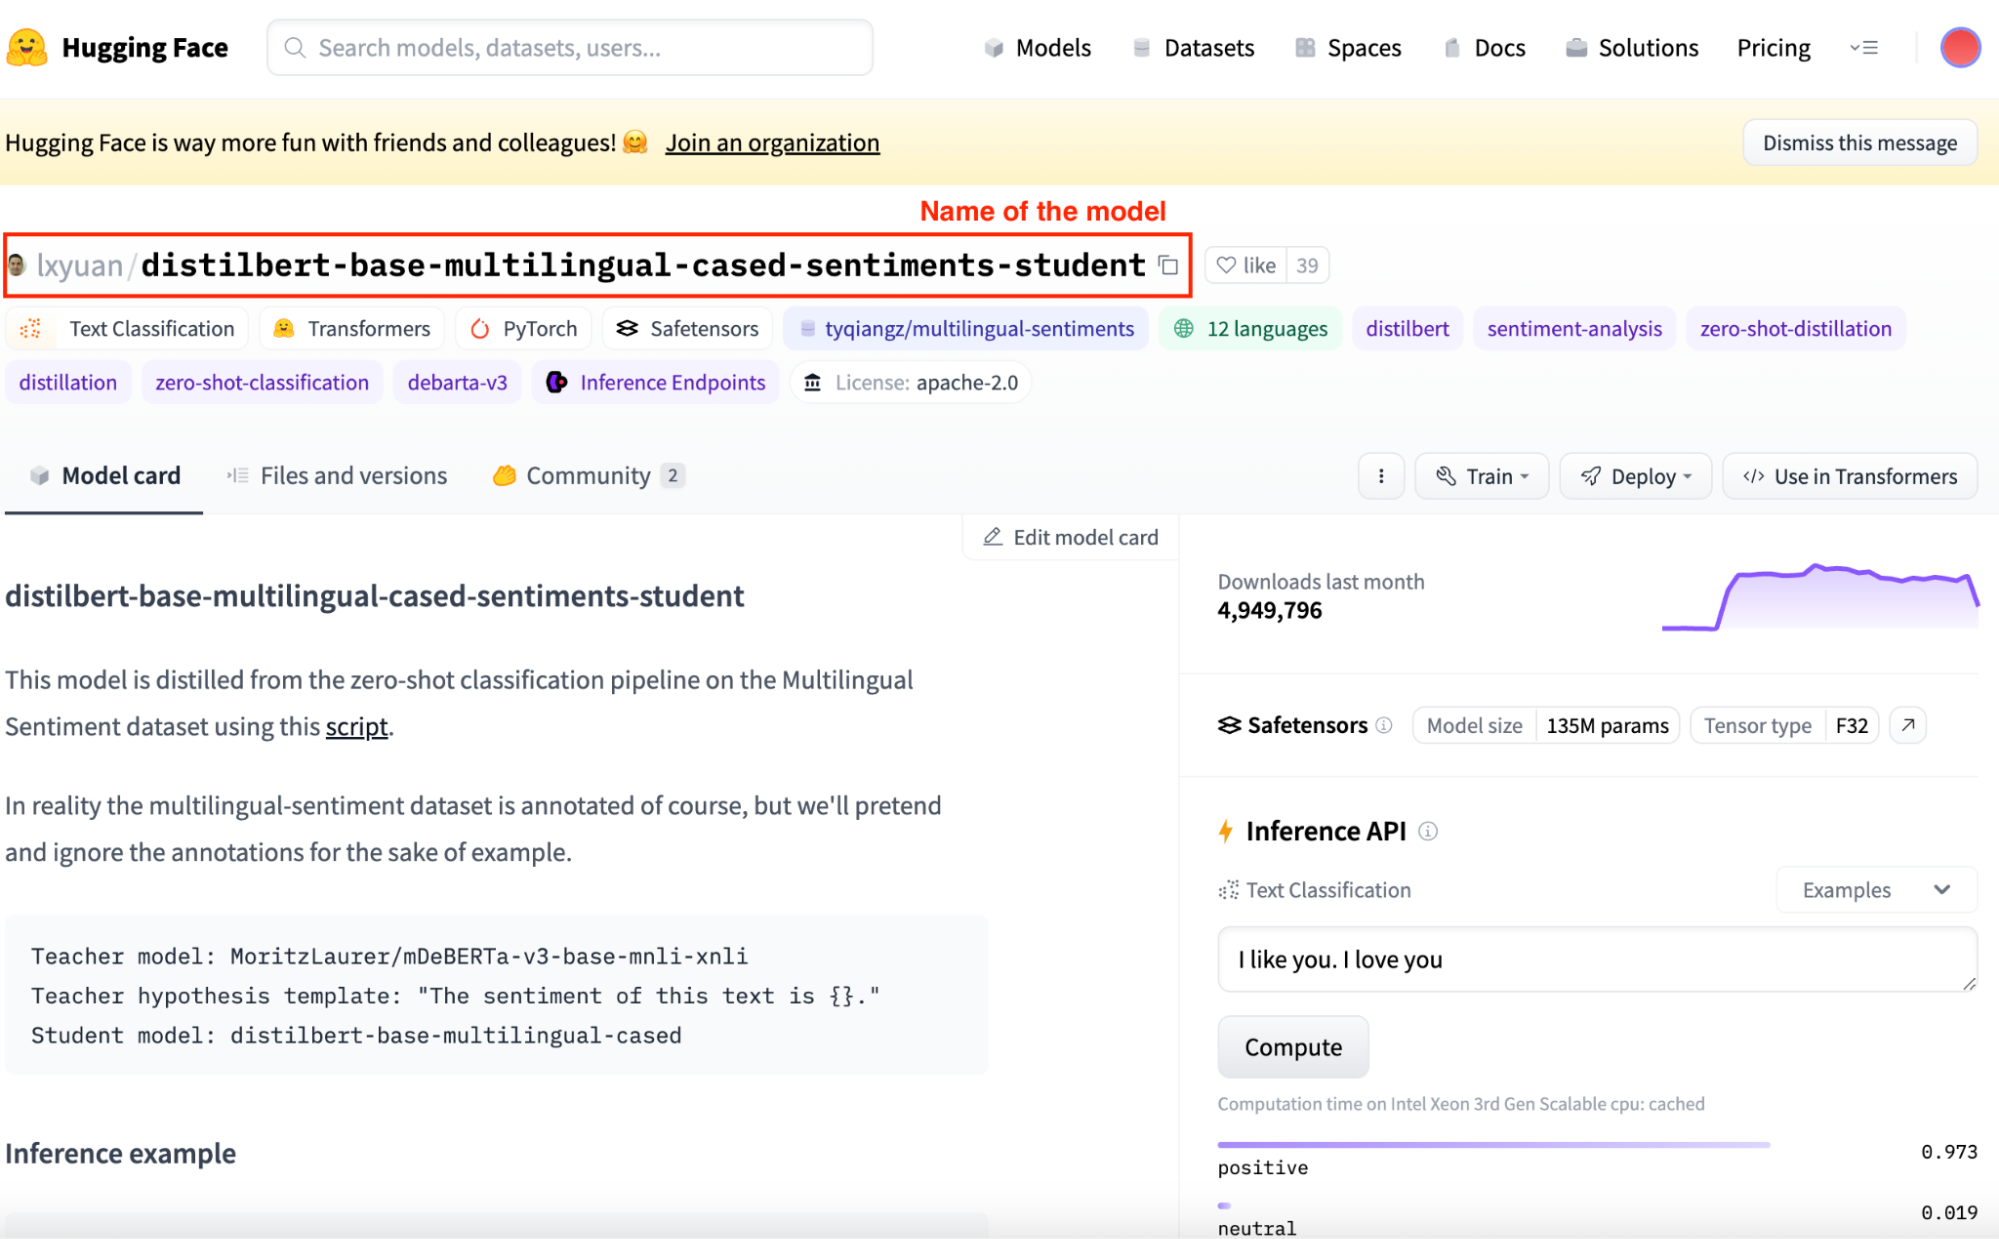
Hugging Face Model Hub’da belirli bir model görünümünün ekran görüntüsü.
1. Önceden eğitilmiş bir modeli yükleyin: Artık hangi modeli kullanacağımızı bildiğimize göre, bunu Python’da kullanalım. Önce transformers içinden AutoTokenizer ve AutoModelForSequenceClassification sınıflarını içe aktarmamız gerekiyor.
Bu AutoModel sınıflarını kullanmak, model mimarisini model adından otomatik olarak çıkarır.
from transformers import AutoTokenizer, AutoModelForSequenceClassification

model_name = "lxyuan/distilbert-base-multilingual-cased-sentiments-student"

# We call define a model object
model = AutoModelForSequenceClassification.from_pretrained(model_name)
2. Girdinizi hazırlayın: Modelimiz için bir tokenizer yükleyin; bu durumda, seçtiğimiz modelin adından hangi tokenizer’ın kullanılacağını transformers kütüphanesi çıkarır ve süreci kolaylaştırır.
#We call the tokenizer class
tokenizer = AutoTokenizer.from_pretrained(model_name)
3. Modeli çalıştırın: Seçilen model, tokenizer ve gerçekleştirilecek görevi içeren bir pipeline nesnesi oluşturun. Bizim durumumuzda bu, bir duygu analizi. Sınıflandırıcı nesnesini görevle başlatırsanız, pipeline sınıfı varsayılan değerlerle doldurur; ancak üretimde bu önerilmez.
# Initializing a classifier with a model and a tokenizer
classifier = pipeline("sentiment-analysis", model = model, tokenizer = tokenizer)
# When passing only the task, the pipeline command inferes both the model and tokenizer.
classifier = pipeline("sentiment-analysis")
Bu modeli bir girdi vererek çalıştırabiliriz.
output = classifier("I've been waiting for this tutorial all my life!")
4. Çıktıları yorumlayın: Model, sınıfına bağlı olarak çeşitli öğeler içeren bir nesne döndürür. Örneğin bu duygu analizi örneğinde şunu elde ederiz:
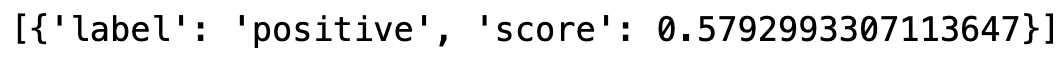
Elde edilen çıktı.
İnce ayar, önceden eğitilmiş bir modeli alıp görevine özgü bir veri kümesi üzerinde eğiterek parametrelerini güncelleme sürecidir. Bu sayede modelin öğrendiği temsillerden yararlanır ve kullanım durumunuza uyarlarsınız.
Duyguları bir dizi tweet’ten çıkarmak için bir metin sınıflandırıcı modele ihtiyacımız olduğunu düşünelim. Aklınıza doğal olarak şu soru gelebilir: Bu önceden eğitilmiş model düzgün çalışacak mı?
Bundan emin olmak için, tweet’ler ve karşılık gelen duygular içeren bir veri kümesiyle önceden eğitilmiş bir Hugging Face modelini eğitip performansı artırarak ince ayardan yararlanabiliriz.
İşte dizi sınıflandırma için bir modeli ince ayar ile uyarlamanın temel bir örneği:
1. Önceden eğitilmiş bir model ve veri kümesi seçin: Görevinize uygun bir model mimarisi seçin. Bu durumda aynı duygu analizi modelini kullanmaya devam etmek istiyoruz. Ancak şimdi modelimizi eğitmek için biraz veriye ihtiyacımız var.
İşte tam burada datasets kütüphanesi devreye giriyor. Model Hub’da tüm veri kümelerine bakabilir ve bize en uygun olanı bulabiliriz.
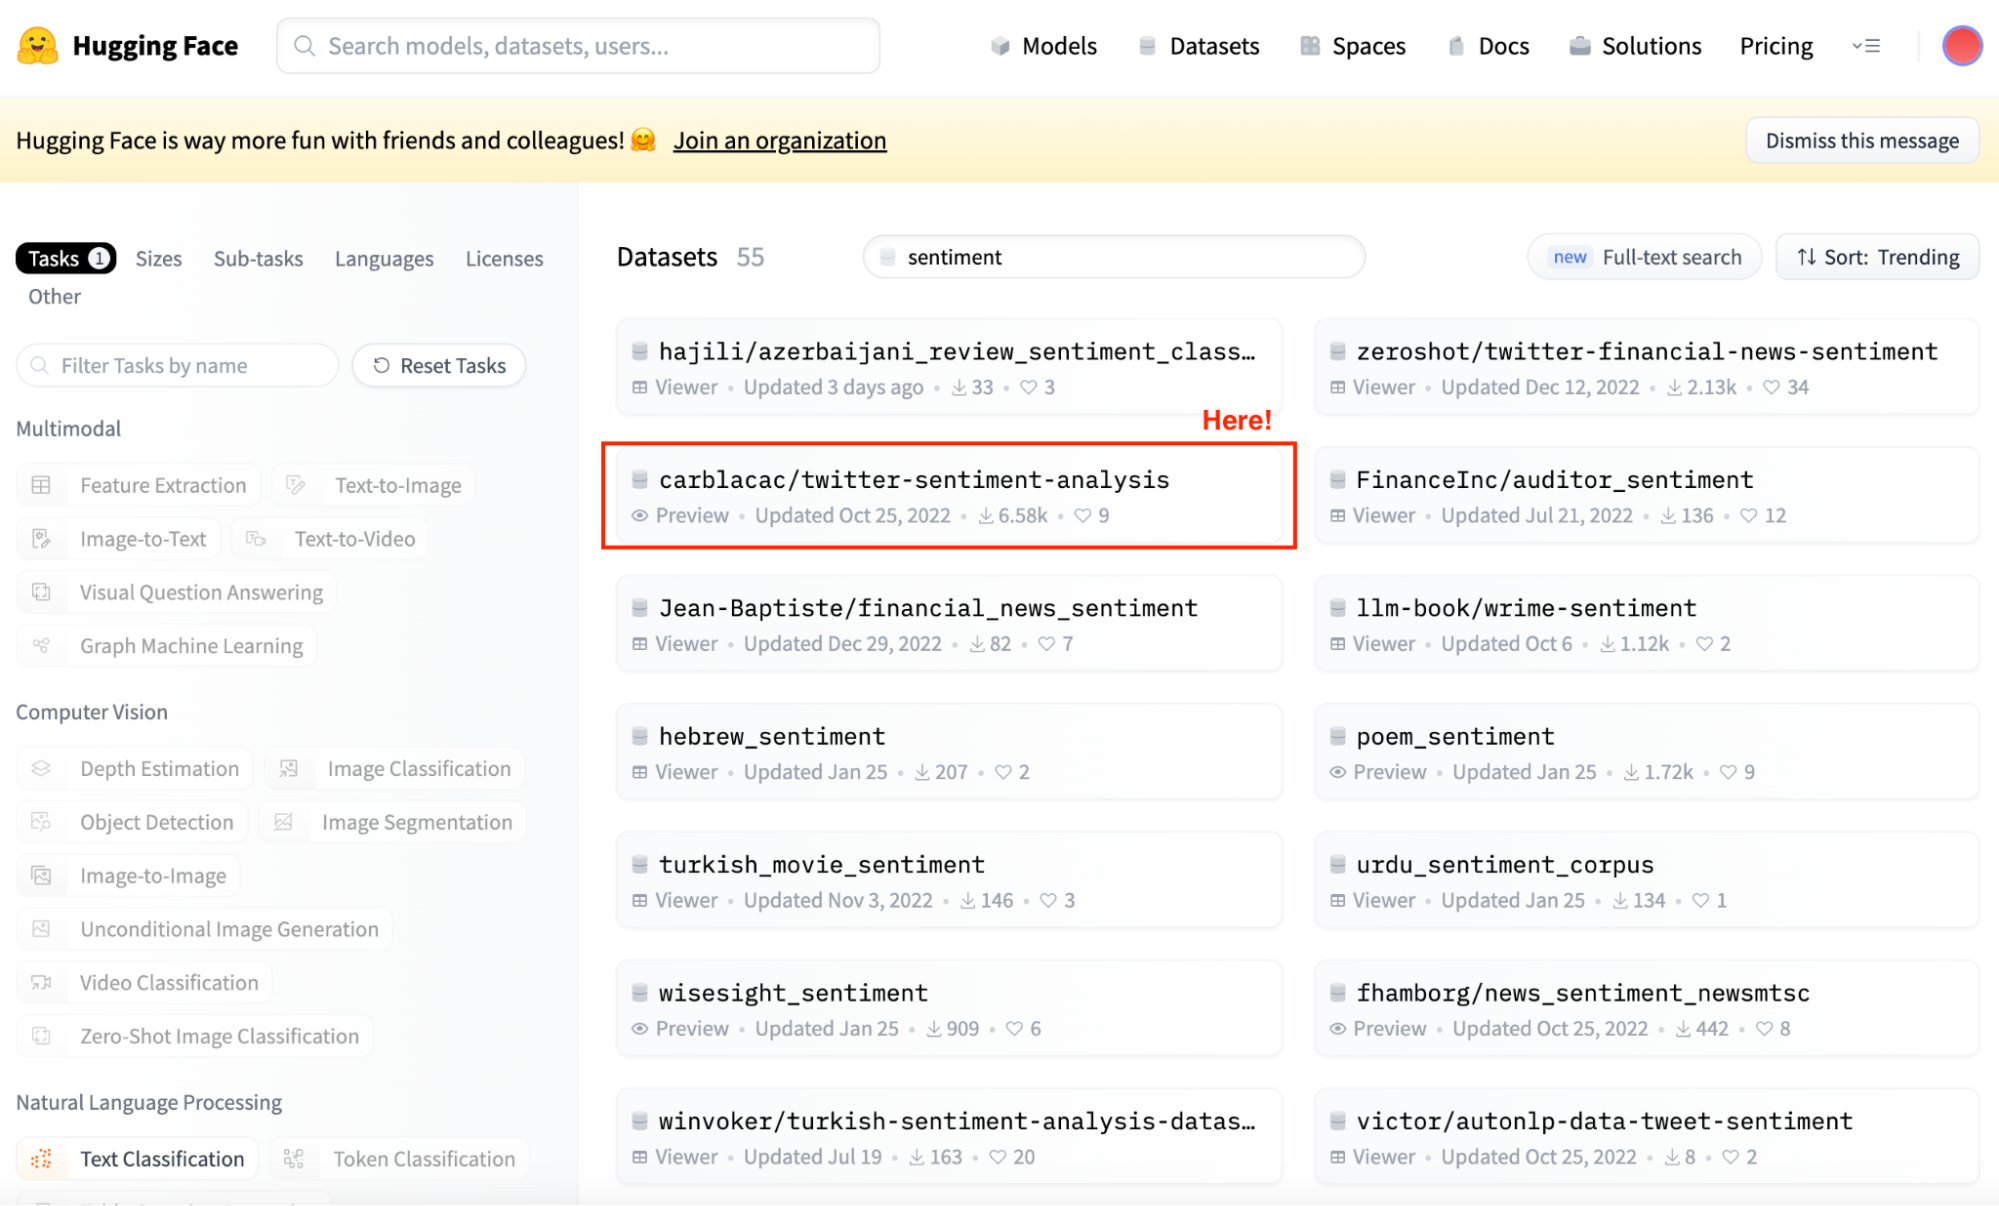
Hugging Face Datasets Hub ana görünümünün ekran görüntüsü. Duygu analizi veri kümeleri seçiliyor.
Artık hangi veri kümesini seçeceğimi bildiğime göre, hem modeli hem veri kümesini kolayca başlatabiliriz.
model = AutoModelForSequenceClassification.from_pretrained(model_name)

# Loading the dataset to train our model
dataset = load_dataset("mteb/tweet_sentiment_extraction")
Yeni indirdiğimiz veri kümesini incelersek, eğitim ve test alt kümelerinden oluşan bir sözlüktür. Eğitim alt kümesini bir veri çerçevesine dönüştürürsek aşağıdaki gibi görünür:
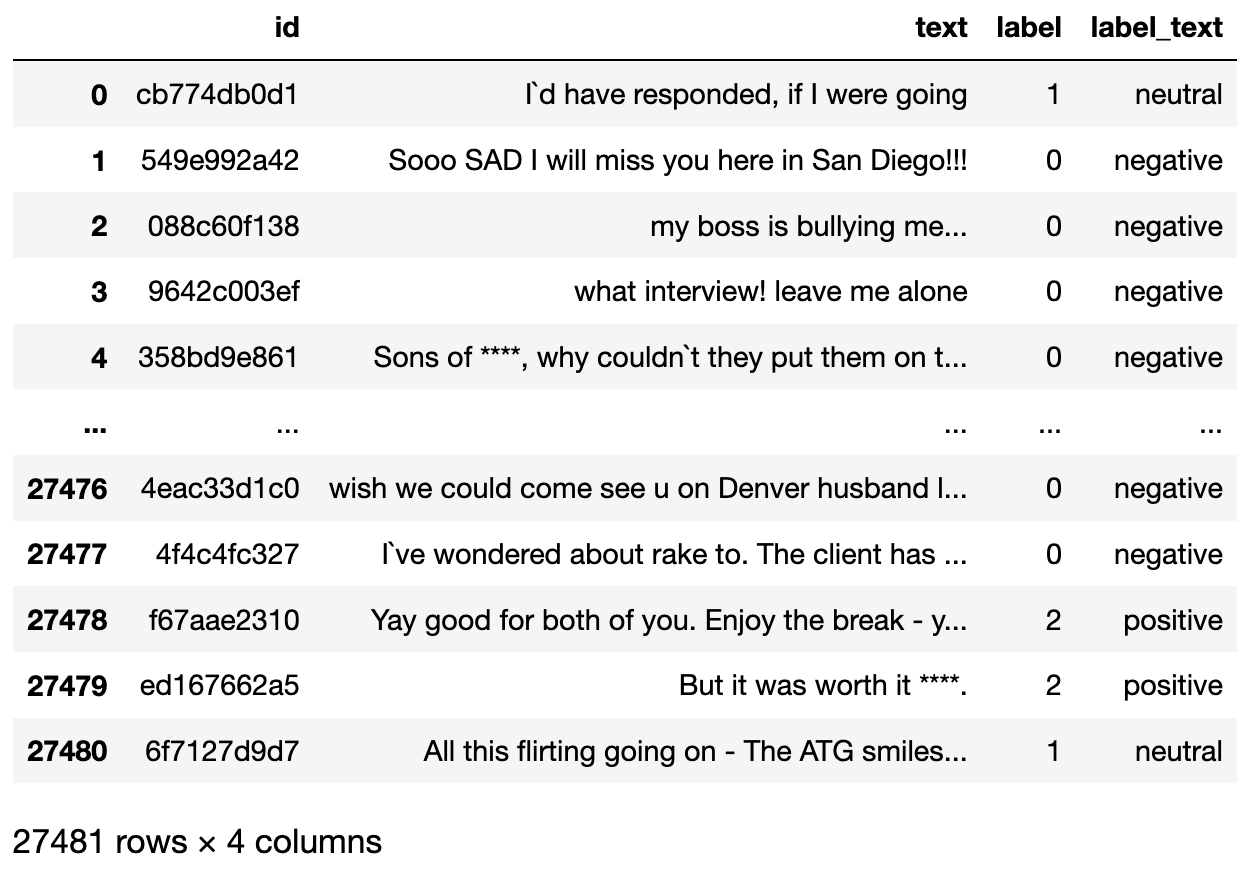
Kullanılacak veri kümesi.
2. Veri kümenizi hazırlayın: Artık veri kümemiz olduğuna göre, modelimizin ayrıştırabileceği hâle getirmek için bir tokenizer’a ihtiyacımız var. Veri kümemizdeki metin değişkeninin, modelimizi ince ayar için kullanabilmemiz amacıyla tokenleştirilmesi gerekir.
Bu nedenle ikinci adım, önceden eğitilmiş bir Tokenizer yüklemek ve veri kümemizi ince ayar için kullanılabilecek şekilde tokenleştirmektir.
tokenizer = AutoTokenizer.from_pretrained(model_name)

def tokenize_function(examples):
    return tokenizer(examples["text"], padding="max_length", truncation=True)

tokenized_datasets = dataset.map(tokenize_function, batched=True)
3. Kodlamalarla bir PyTorch veri kümesi oluşturun: Üçüncü adım, bir eğitim ve bir test veri kümesi üretmektir. Eğitim seti modelimizin ince ayarı için, test seti ise değerlendirme için kullanılacaktır.
Genellikle ince ayar süreci çok zaman alır. Eğitimi kolaylaştırmak için, hesaplama süresini azaltmak amacıyla her iki veri kümesinden de rastgele örneklem alıyoruz.
from datasets import load_dataset

model = AutoModelForSequenceClassification.from_pretrained(model_name)

# Loading the dataset to train our model
dataset = load_dataset("mteb/tweet_sentiment_extraction")

small_train_dataset = tokenized_datasets["train"].shuffle(seed=42).select(range(1000))
small_eval_dataset = tokenized_datasets["test"].shuffle(seed=42).select(range(1000))
4. Modeli ince ayar ile uyarlayın: Son adımımız, eğitim argümanlarını belirlemek ve eğitim sürecini başlatmaktır. Transformers kütüphanesi, her şeyi üstlenen trainer() sınıfını içerir.
Önce eğitim argümanlarını ve değerlendirme stratejisini tanımlarız. Her şey tanımlandıktan sonra train() komutuyla modeli kolayca eğitebiliriz.
from transformers import Trainer, TrainingArguments
import numpy as np

training_args = TrainingArguments(output_dir="trainer_output", evaluation_strategy="epoch")

metric = evaluate.load("accuracy")

def compute_metrics(eval_pred):
    logits, labels = eval_pred
    predictions = np.argmax(logits, axis=-1)
    return metric.compute(predictions=predictions, references=labels)


trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=small_train_dataset,
    eval_dataset=small_eval_dataset,
    compute_metrics=compute_metrics,
)
trainer.train()
5. Modeli değerlendirin: Eğitimden sonra, modelin performansını bir doğrulama veya test setinde değerlendirin. Yine, trainer sınıfı bunun için bir evaluate yöntemi içerir.
import evaluate

trainer.evaluate()
İnce ayar yapılmış modelimiz %70 doğruluk sunuyor.
Artık modelimizi geliştirdiğimize göre, onu toplulukla nasıl paylaşabiliriz? Bu da bizi son adıma getiriyor.
Modelinizi ince ayar ile uyarladıktan sonra, onu toplulukla paylaşmak isteyebilirsiniz.
Hugging Face bu süreci kolaylaştırır. Öncelikle huggingface_hub kütüphanesini kurmanız gerekir.
Bu son adım için, Hugging Face hesabınıza bağlanabilmek üzere etkin bir jetona sahip olmanız gerekir. Bu yönergeyi izleyerek birini kolayca alabilirsiniz. Bir Jupyter Notebook’ta çalışırken notebook_login kütüphanesini kolayca içe aktarabiliriz.
from huggingface_hub import notebook_login

notebook_login()
Bu işlem, Jupyter Notebook içinde bir oturum açma akışı başlatır. Yalnızca jetonumuzu girmemiz yeterlidir; not defterimiz Hugging Face hesabımıza bağlanır.
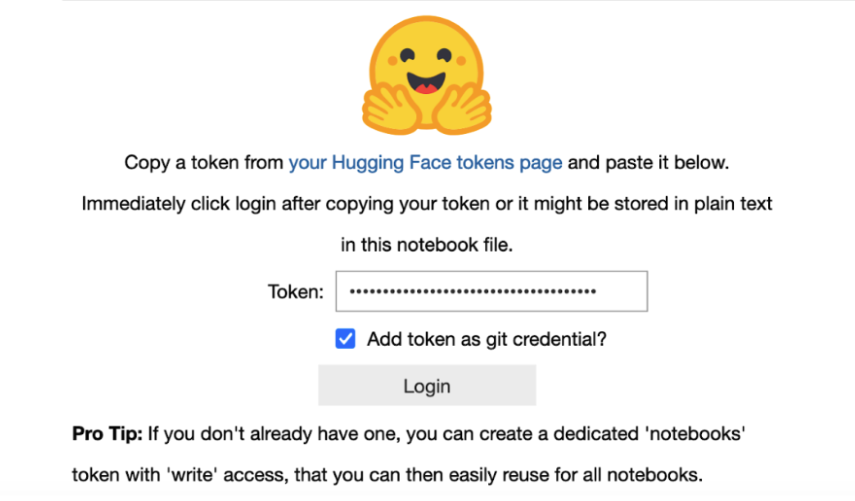
Şimdi push_to_hub komutunu kullanarak modelimizi yüklememiz yeterli.
finetuned_model.push_to_hub("my-awesome-model")
Bundan sonra, model profilimizde herkesin erişimine açık olacaktır.
Herhangi bir NLP sürecini standartlaştırmak istersek, Hugging Face ile bu genellikle beş satırdan az kodla üç basit adımı içerir:
1. Pipeline sınıfı ile bir model nesnesi tanımlayın (ve karşılık gelen model ile tokenizer’ı belirtin).
2. Girdi metnini veya istemi (prompt) tanımlayın.
3. Önceden eğitilmiş modeli girdimizle çalıştırın ve çıktıyı gözlemleyin.
Metin sınıflandırma, NLP’nin temel bir görevidir. Her bir girdi metnine bir veya daha fazla kategori atamaktan oluşur. Spam tespiti, duygu analizi, konu etiketleme ve daha fazlası gibi çeşitli uygulamalarda kullanılabilir.
Aşağıdaki örnek koda bakarak, önceki bölümde verilen üç basit adımla bir metin sınıflandırma modelini nasıl uygulayabildiğimizi görebilirsiniz.
# We import the pipeline module from the transformers library
from transformers import pipeline

# We load the pre-trained text classification model.
classifier = pipeline("text-classification",model='lxyuan/distilbert-base-multilingual-cased-sentiments-student')

# Input to be classified
input_ = "I absolutely love the transformers library!"

# Perform classification
output_ = classifier(input_)

# Observer the result
print(output_)
Kolay, değil mi?
Öyleyse, ikinci kullanım alanına ve gelmiş geçmiş en çok suistimal edilenlerden birine geçelim.
Çoğunuz, bir girdi isteminden metin üreten ChatGPT veya Google Bard gibi araçlara zaten aşinasınızdır. Bu sürece “Metin Üretimi” denir ve bir modelin ilk bir girdiden insan benzeri metin üretmesi, NLP’nin büyüleyici bir yönüdür.
Uygulama alanı geniştir; sohbet botu yanıtları oluşturmaktan yaratıcı yazılar üretmeye kadar uzanır.
Öz fikir, modeli büyük bir metin derlemi üzerinde eğiterek dilin kalıplarını, üsluplarını ve yapılarını öğrenmesini sağlamaktır. Tahmin edebileceğiniz gibi, en maliyetli kısım tam da modelin eğitilmesidir.
Ancak Hugging Face, tıpkı önceki durumda olduğu gibi, böyle bir modeli yalnızca beş satır kodla uygulamamıza olanak tanır.
Aşağıdaki örneğe bakın:
from transformers import pipeline

generator = pipeline('text-generation', model='gpt2')

prompt = "In a world dominated by AI,"

generated_text = generator(prompt, max_length=50)[0]['generated_text']

print(generated_text)
Sıkça QA olarak anılan soru-cevap, insanların doğal dilde sorduğu sorulara otomatik olarak yanıt veren sistemler kurmaya odaklanan bir NLP alanıdır.
QA sistemleri, sanal asistanlar, müşteri destek araçları ve bilgi erişim sistemleri gibi birçok uygulamada yaygın olarak kullanılır.
QA sistemleri genel olarak iki türe ayrılabilir:
Bu sistemler genellikle soruyu yorumlamak için doğal dil anlama ve ilgili yanıtları bulmak için bilgi erişimi bileşimini kullanır.
Yine, bu modellerden birini Hugging Face ile uygulamak hızlı ve kolaydır.
from transformers import pipeline

qa_pipeline = pipeline('question-answering', model='distilbert-base-uncased-distilled-squad')

context = """Paris is the capital and most populous city of France. The city has an area of 105 square kilometers and a population of 2,140,526 residents."""
question = "What is the population of Paris?"

answer = qa_pipeline(question=question, context=context)
print(answer)
Son kullanım alanı çeviridir. Makine çevirisi, metni veya konuşmayı bir dilden diğerine yazılım kullanarak çevirmeye odaklanan hesaplamalı dilbilimin bir alt alanıdır. Derin öğrenmenin gelişimiyle, özellikle büyük sinir ağları kullanan Sinirsel Makine Çevirisi (NMT) gibi modellerle önemli ilerlemeler kaydedilmiştir.
Modern NMT sistemleri, geleneksel kural tabanlı veya istatistiksel çeviri modellerinden farklı olarak, büyük iki dilli metin veri kümeleri üzerinde eğitilerek çeviri yapmayı öğrenir. Genellikle kaynak metni kodlayan ve hedef dile çözen, sıra-sıra (sequence-to-sequence) mimariler kullanırlar; çoğu zaman etkileyici akıcılık ve doğruluk sergilerler.
Hugging Face ile basit bir örnek şöyle olabilir:
from transformers import pipeline

# Load the translation pipeline for English to Spanish
translator = pipeline('translation_en_to_de')

# Text to translate from English to Spanish
text_to_translate = "This is a great day for science!"

# Perform the translation
translation = translator(text_to_translate, max_length=40)

# Print the translated text
print(translation[0]['translation_text'])
Hugging Face, yapay zekâ ve doğal dil işleme alanlarında dönüştürücü bir güç olarak öne çıktı. Devrim niteliğindeki Transformers kütüphanesi, işbirlikçi Model Hub ve kapsamlı Datasets kütüphanesi dâhil eksiksiz araç takımıyla, gelişmiş NLP yeteneklerine erişimi demokratikleştirdi.
Yeniliğin paylaşıldığı ve birlikte inşa edildiği bir ortamı teşvik ederek, Hugging Face yalnızca YZ’nin ilerlemesine katkıda bulunmuyor; aynı zamanda teknolojinin daha erişilebilir, kapsayıcı ve güçlü olduğu bir geleceği şekillendiriyor.
YZ devrimine tanıklık etmeye ve katılmaya devam ederken, Hugging Face bize en derin teknolojik atılımların açık, paylaşılan ve birlikte inşa edilenler olduğunu hatırlatıyor.
Mesele sadece daha akıllı makineler yaratmak değil; mümkün olanın sınırlarını zorlamaya istekli geliştiriciler, araştırmacılar ve meraklılardan oluşan daha akıllı, daha bağlantılı bir topluluğu büyütmektir.
YZ & NLP Yolculuğunuza Bugün Başlayın!
Program
Program
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



