
Leerpad
Natuurlijke taalverwerking in Python
20 uur
In de razendsnel veranderende techwereld springt Artificial Intelligence eruit als een cruciaal en alomtegenwoordig vakgebied dat moeiteloos in ons dagelijks leven is verweven. Centraal in deze AI-golf staat Natural Language Processing, een geavanceerd domein dat populaire conversational tools zoals ChatGPT en Bard aandrijft.
Wat als de meeste modellen die deze tools mogelijk maken, voor iedereen toegankelijk zijn en op één plek te vinden zijn?
Maak kennis met: Hugging Face, een gamechanger in machine learning en natural language processing en een sleutelfiguur in de democratisering van AI. Dankzij transfer learning speelt het een cruciale rol in het toegankelijker maken van AI.
Op dit moment heeft het de populairste NLP-bibliotheek in Python, met meer dan 115k sterren op GitHub, en is het uitgegroeid tot een van de belangrijkste platforms waar AI-enthousiastelingen en -professionals kunnen experimenteren, uitrollen en hun eigen modellen opschalen.
Of je nu een datapro bent of gewoon een nieuwsgierige beginner, Hugging Face heeft de tools en resources om je AI-projecten tot leven te brengen en de grenzen te verleggen van wat mogelijk is met machine learning.
Dus, laten we ontdekken wat Hugging Face te bieden heeft!
Je kunt ook meer leren over het gebruiken van open-source AI-modellen met Hugging Face in onze code-along.
Voor de meesten is Hugging Face misschien gewoon een andere emoji op hun telefoon-toetsenbord (🤗)
In de techscene is het echter de GitHub van de ML-wereld — een collaboratief platform boordevol tools die iedereen in staat stellen om NLP- en ML-modellen te bouwen, trainen en deployen met open-source code.
De revolutionaire twist?
Deze modellen zijn al voorgetraind, wat het instappen in NLP nog eenvoudiger maakt. Simpel gezegd: ontwikkelaars beginnen niet meer vanaf nul; ze laden nu een voorgetraind model vanaf de Hugging Face-hub, fine-tunen het voor hun specifieke taken en gaan vandaaruit verder.
Die gebruiksvriendelijkheid vereenvoudigt het ontwikkelproces aanzienlijk.
Zo is Hugging Face een hub waar data scientists, onderzoekers en ML-engineers samenkomen om ideeën uit te wisselen, hulp te zoeken en bij te dragen aan open-source-initiatieven.
Ze omschrijven zichzelf als:
“De AI-community die de toekomst bouwt.”
Precies die visie is een van de geheime ingrediënten van het succes van Hugging Face: een community-gedreven aanpak.
Een andere reden voor de sterke groei is de intuïtiviteit van het platform. Met een eenvoudige interface is het makkelijk om te starten — zowel voor newbies als voor pro’s.
Met als doel de grootste NLP- en ML-collectie aan resources te hosten, zet Hugging Face zich in om AI te democratiseren en toegankelijk te maken voor een wereldwijde community.
Hugging Face werd in 2016 opgericht als een Amerikaans-Frans bedrijf dat een interactieve AI-chatbot voor tieners wilde ontwikkelen. Maar nadat het het model achter deze chatbot open-source had gemaakt, schakelde het al snel over op een grootser plan: de AI-industrie voorzien van krachtige, toegankelijke tools.
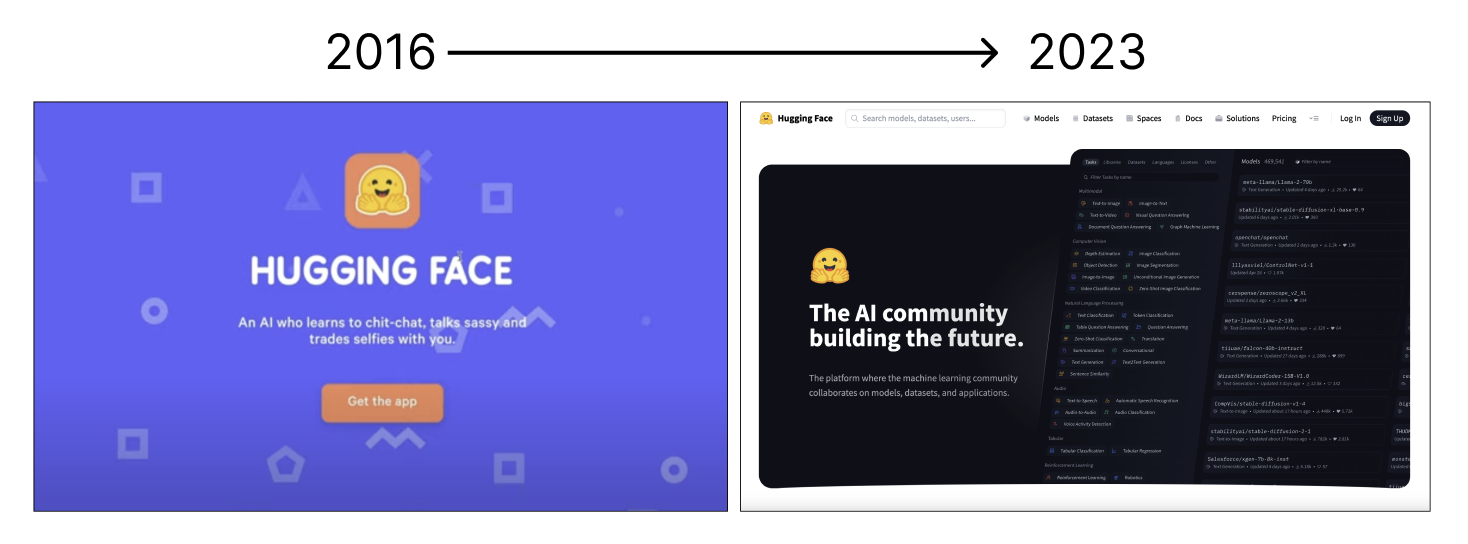
Afbeelding door de auteur.
De lancering van de transformerende Transformers-bibliotheek in 2018 was een van de grootste en bekendste bijdragen aan de AI-community, met voorgetrainde modellen zoals BERT en GPT die onmisbaar zijn geworden bij NLP-taken.
Vandaag heeft HuggingFace het ML-ecosysteem volledig veranderd. De inzet voor open-source samenwerking heeft innovatie in NLP aangejaagd, waardoor de technologie gezamenlijk kan groeien en zich ontwikkelen.
Het platform is een knooppunt geworden voor het delen van modellen en datasets, en stuwt onderzoek en praktische AI-toepassingen vooruit.
Hun mantra?
“Democratiseer goede Machine Learning, één commit per keer.”
Dankzij strategische partnerships en de toewijding om geavanceerde NLP-tools breed beschikbaar te maken, is Hugging Face onmisbaar geworden voor de community en blijft het de grenzen van AI verleggen en de toegang tot cutting-edge technologie democratiseren.
Hugging Face is uitgegroeid tot een hoeksteen van moderne NLP dankzij een reeks kerncomponenten en functies die tegemoetkomen aan uiteenlopende taalverwerkingsbehoeften.
Laten we ze stuk voor stuk doornemen.
De Transformers-bibliotheek is een uitgebreide suite van state-of-the-art machinelearningmodellen die speciaal zijn ontworpen voor NLP. Ze bestaat uit een brede collectie voorgetrainde modellen die geoptimaliseerd zijn voor taken zoals tekstclassificatie, taal generatie, vertaling en samenvatting, en meer
Hugging Face heeft veelvoorkomende NLP-taken geabstraheerd in een eenvoudig te gebruiken `pipeline()`-methode, een gebruiksvriendelijke API voor het uitvoeren van een groot aantal taken. Met deze pipelines kun je complexe modellen eenvoudig toepassen op real-world problemen. Wil je meer weten over wat er achter deze bibliotheek schuilgaat, dan raad ik het artikel An Introduction to Using Transformers and Hugging Face sterk aan.
Deze modellen zijn eenvoudig toegankelijk en aanpasbaar, wat revolutionair is geweest voor ontwikkelaars en onderzoekers en een sleutelrol heeft gespeeld in het toegankelijker maken van geavanceerde NLP-modellen.
Het belang zit in het abstraheren van de complexiteit rond het trainen en deployen van NLP-modellen, waardoor het voor practitioners makkelijker wordt om geavanceerde NLP-features te implementeren met minimale code.
De bibliotheek maakt het mogelijk om voorgetrainde modellen te benutten zonder in de onderliggende algoritmes te duiken.
De Transformers-bibliotheek vereenvoudigt de implementatie van NLP-modellen op verschillende manieren:
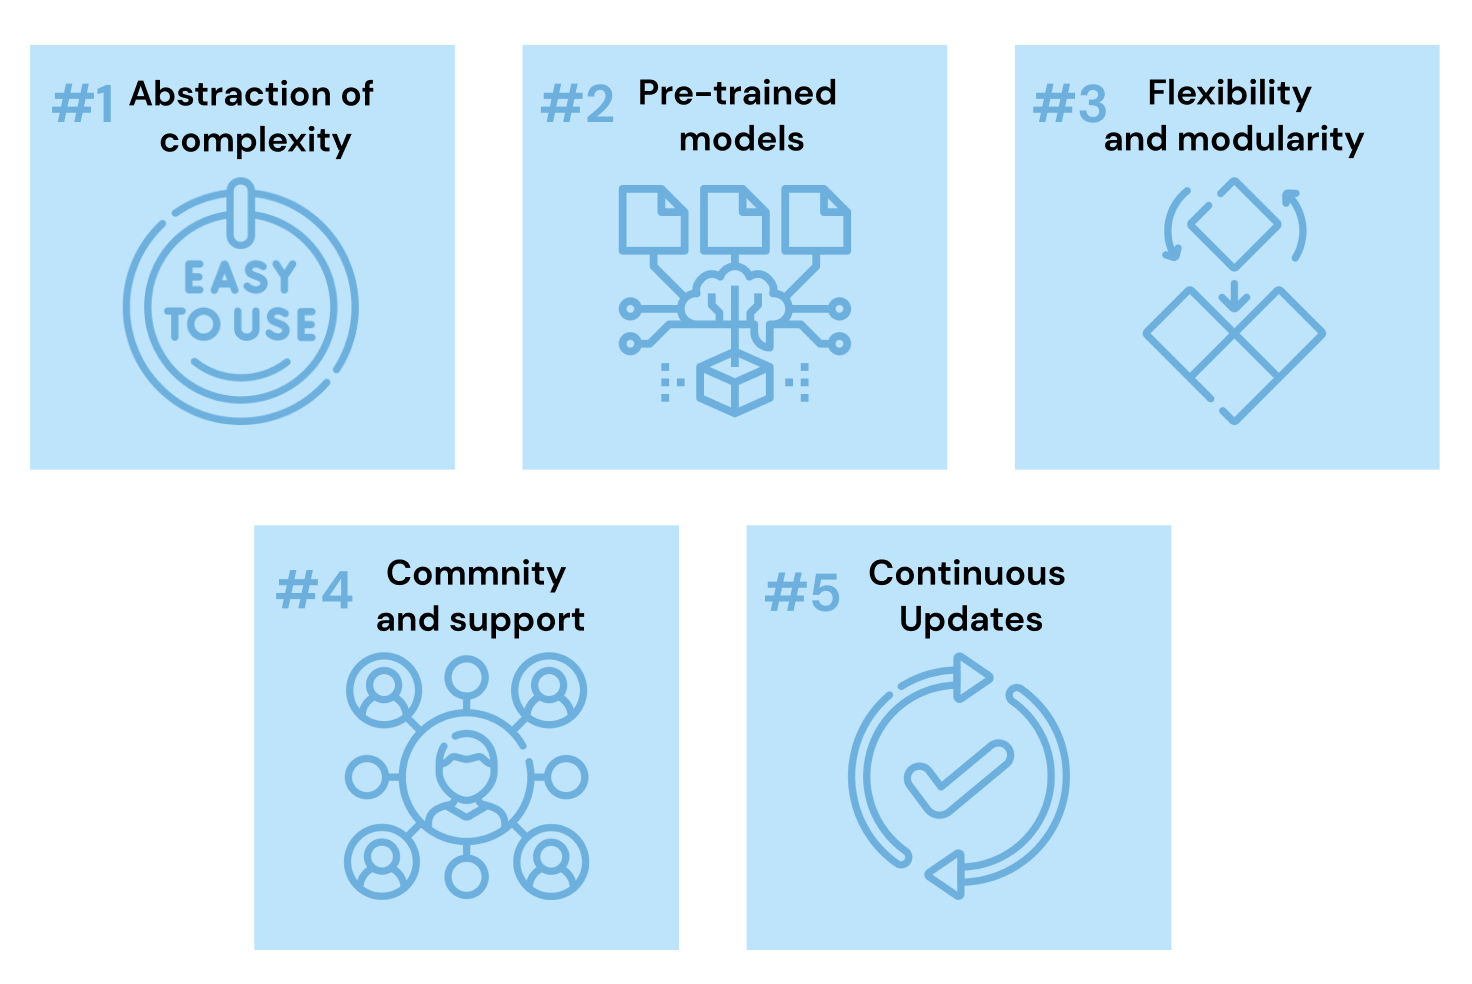
Wil je uit eerste hand zien hoeveel werk de Transformers-bibliotheek ons uit handen neemt, leer dan hoe je een NLP-model deployt met Building a Transformer with PyTorch.
De Model Hub is het gezicht van de community: een platform waar duizenden modellen en datasets binnen handbereik zijn. Het is een innovatieve functie waarmee gebruikers modellen kunnen delen en ontdekken die door de community zijn bijgedragen, en zo een collaboratieve aanpak van NLP-ontwikkeling stimuleren.
Je kunt het bekijken op hun officiële website. Daar kun je gemakkelijk de Model Hub selecteren door in de navigatie op de knop Models te klikken; vervolgens verschijnt een weergave zoals de onderstaande:
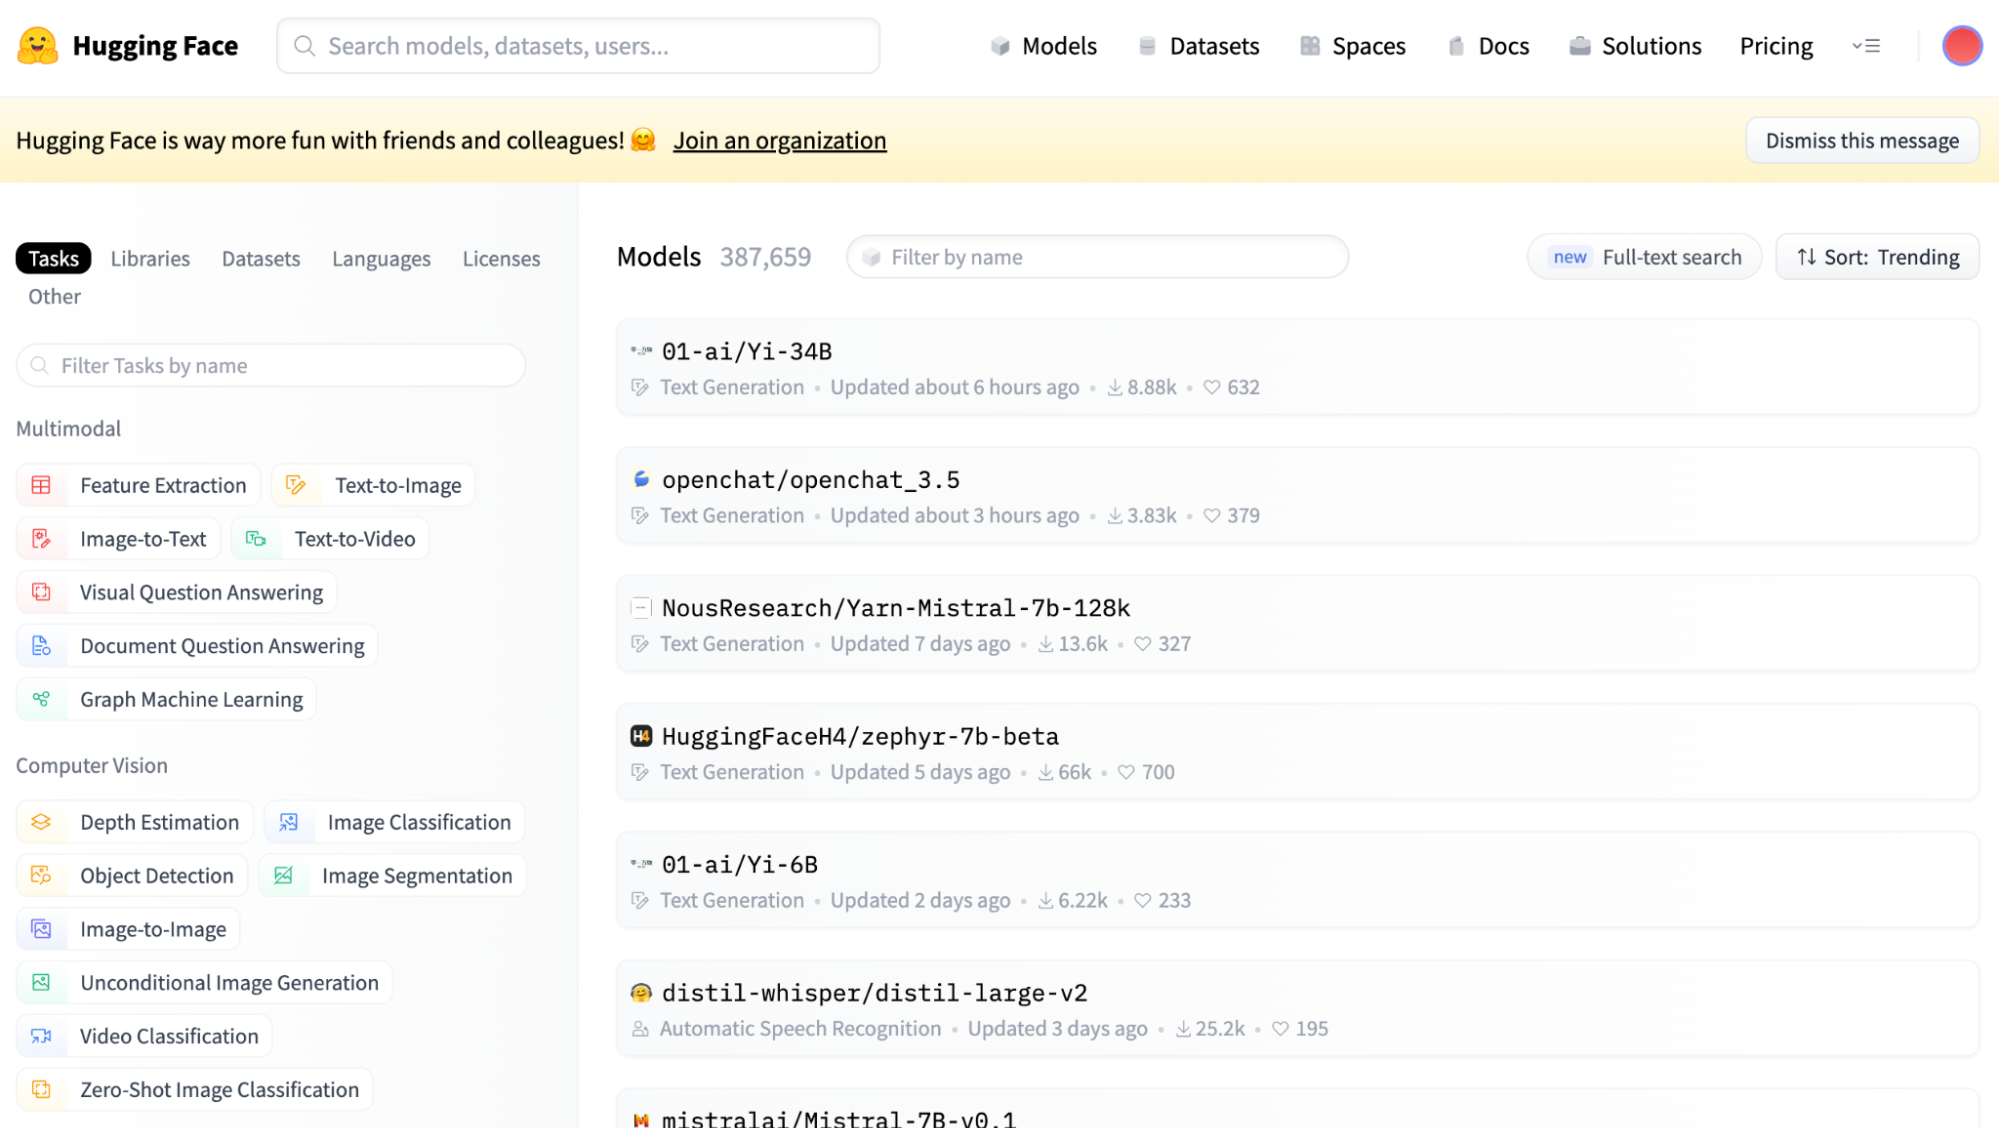
Screenshot van de hoofdweergave van Hugging Face Model Hub.
Zoals je ziet, staan in de linkerzijbalk meerdere filters met betrekking tot de uit te voeren hoofdtaak.
Bijdragen aan de Model Hub is eenvoudig dankzij de tools van Hugging Face, die gebruikers door het uploadproces van hun modellen leiden. Eenmaal bijgedragen zijn deze modellen beschikbaar voor de hele community, rechtstreeks via de hub of via integratie met de Hugging Face Transformers-bibliotheek.
Deze gemakkelijke toegang en bijdrage bevordert een dynamisch ecosysteem waarin state-of-the-art modellen voortdurend worden verfijnd en uitgebreid, en zo een rijke, collaboratieve basis bieden voor de verdere ontwikkeling van NLP.
Tokenizers zijn cruciaal in NLP: zij zetten tekst om in een formaat dat machinelearningmodellen begrijpen, wat essentieel is voor het verwerken van verschillende talen en tekststructuren.
Ze zijn verantwoordelijk voor het opdelen van tekst in tokens — basiseenheden zoals woorden, subwoorden of karakters — en bereiden zo data voor op verwerking door machinelearningmodellen. Deze tokens zijn de bouwstenen die modellen in staat stellen menselijke taal te begrijpen en te genereren.
Ze faciliteren ook de transformatie van tokens naar vectorrepresentaties voor modelinput en verzorgen padding en truncation voor uniforme sequentielengtes.
Hugging Face biedt een reeks gebruiksvriendelijke tokenizers, geoptimaliseerd voor de Transformers-bibliotheek, die essentieel zijn voor naadloze preprocessen van tekst. Je kunt meer lezen over Tokenization in een apart artikel.
Een andere belangrijke component is de Hugging Face Datasets-bibliotheek, een enorme repository van NLP-datasets die het trainen en benchmarken van ML-modellen ondersteunen.
Deze bibliotheek is een cruciale tool voor ontwikkelaars in het veld, met een diverse collectie datasets die gebruikt kunnen worden om NLP-modellen te trainen, testen en benchmarken voor een breed scala aan taken.
Een van de grootste voordelen is de eenvoudige, gebruiksvriendelijke interface. Je kunt alle datasets in de Hugging Face Hub verkennen, en voor gebruik in je code is er de speciaal ontwikkelde datasets-bibliotheek waarmee je elke dataset moeiteloos kunt downloaden.
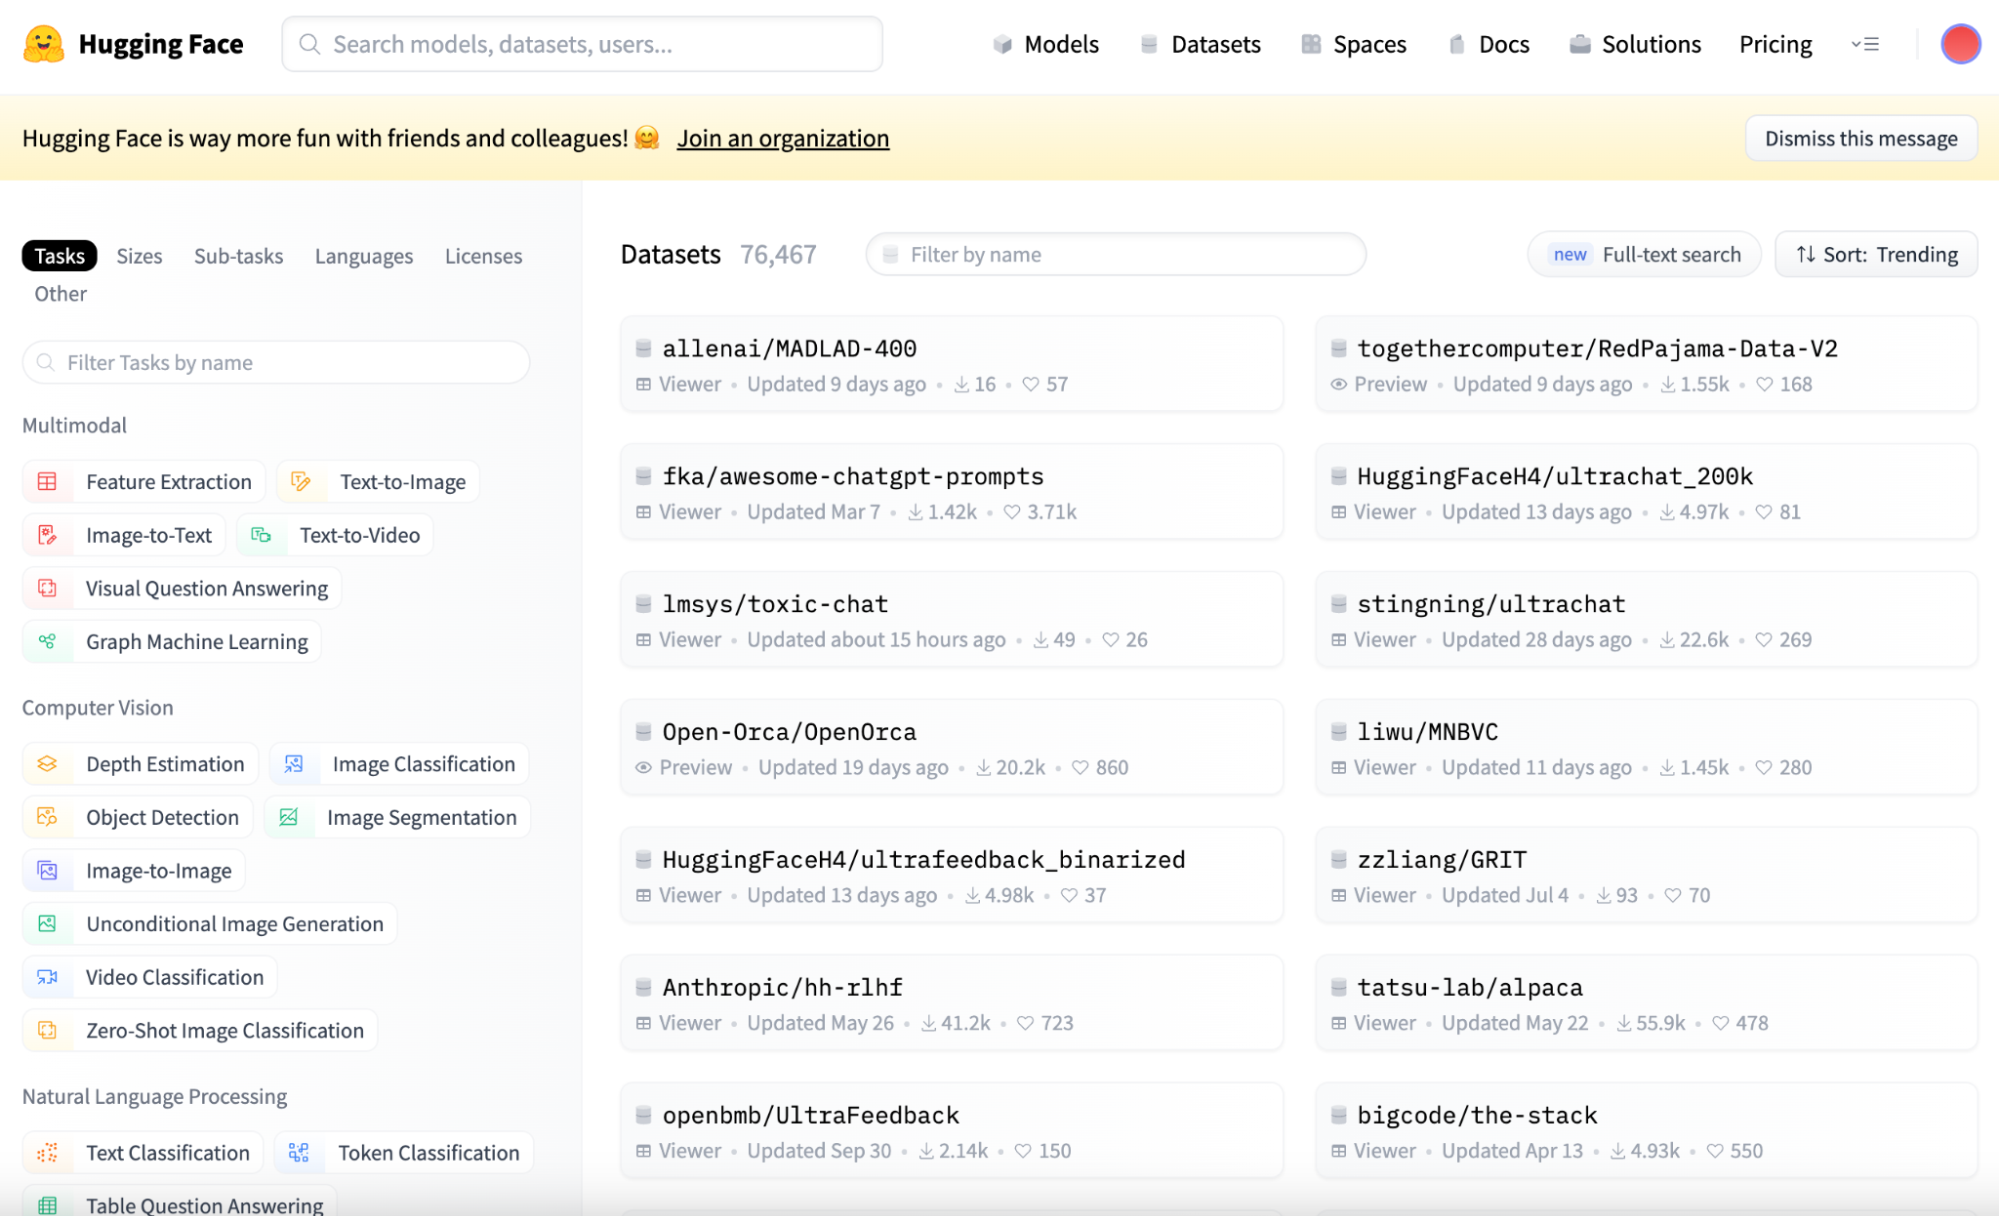
Screenshot van de hoofdweergave van Hugging Face Datasets.
Ze omvatten datasets voor veelvoorkomende taken zoals tekstclassificatie, vertaling en question answering, maar ook meer gespecialiseerde datasets voor unieke uitdagingen in het veld.
Nu we op één lijn zitten en de kernconcepten achter Hugging Face begrijpen, gaan we kijken hoe je met dit technologische pareltje aan de slag gaat.
Deze gids neemt je kort mee langs de basis: installatie, het gebruik van voorgetrainde modellen, fine-tuning en het delen van je modellen met de community.
Eerst combineer je de transformers-bibliotheek met je favoriete deep learning-bibliotheek, TensorFlow of PyTorch.
De transformers-bibliotheek installeer je eenvoudig via pip, de package installer van Python.
pip install transformers
Voor de volledige functionaliteit installeer je ook de bibliotheken datasets en tokenizers.
pip install tokenizers, datasets
De modelhub van Hugging Face biedt een enorme collectie voorgetrainde modellen voor uiteenlopende NLP-taken. Laten we ontdekken hoe je je eerste voorgetrainde model gebruikt.
1. Kies een voorgetraind model: Als eerste kies je een voorgetraind model. Dat doe je in de Model Hub.
Stel dat we het sentiment bij een tekststring willen afleiden. We kunnen eenvoudig filteren op modellen die `Text Classification` uitvoeren door in de linkerzijbalk op de knop Text Classification te klikken.
Hugging Face-modellen worden standaard gesorteerd op Trending. Meestal zijn de bovenste resultaten de meest gebruikte. We kiezen dus het tweede resultaat, het meest gebruikte sentimentanalysemodel.
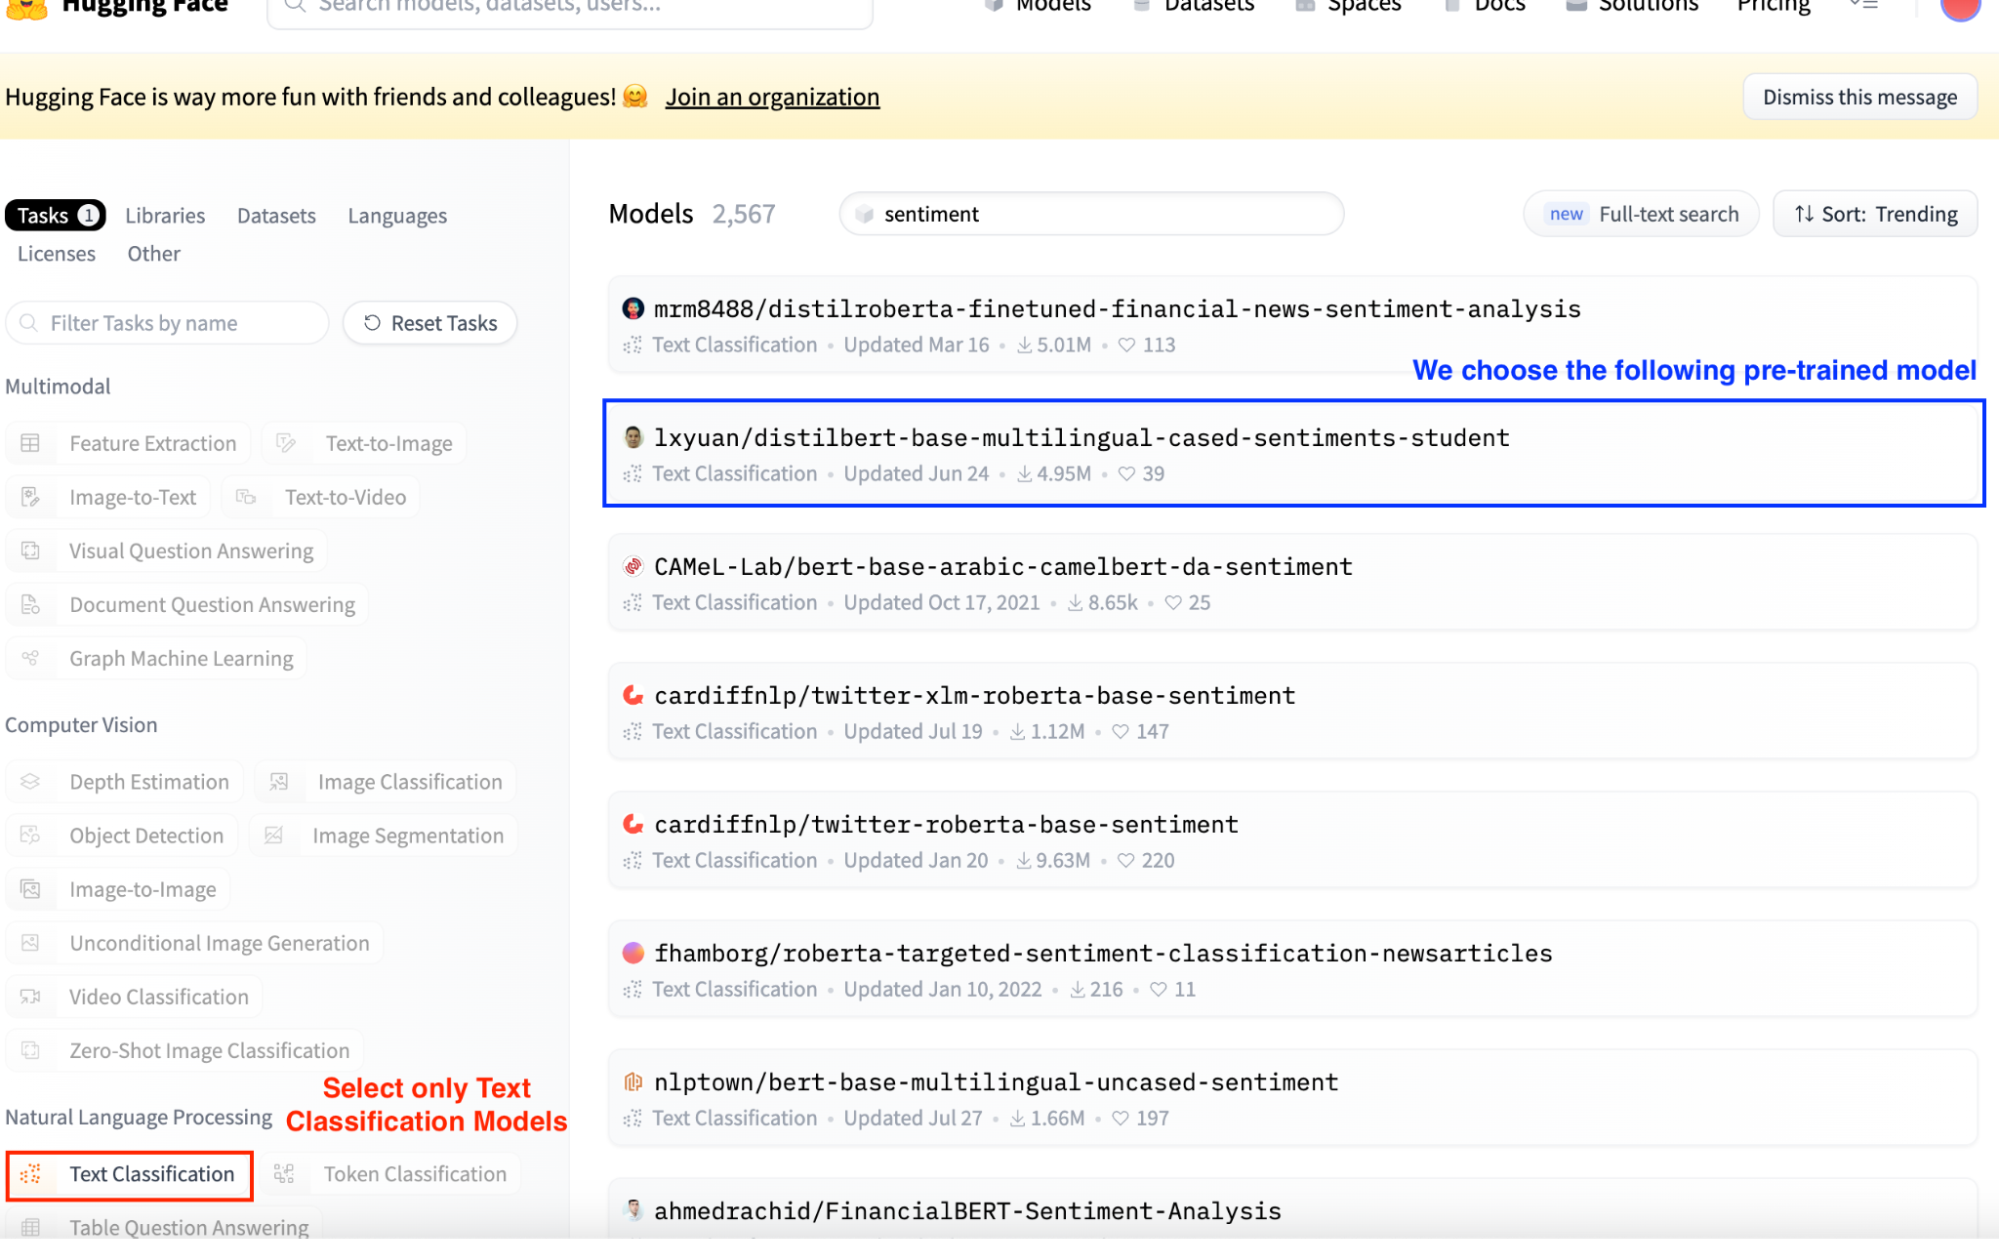
Screenshot van de hoofdweergave van Hugging Face Model Hub. Selectie van Text Classification-modellen.
Om het te gebruiken, kopiëren we de naam van het model. Die staat bovenaan in de specifieke modelweergave.
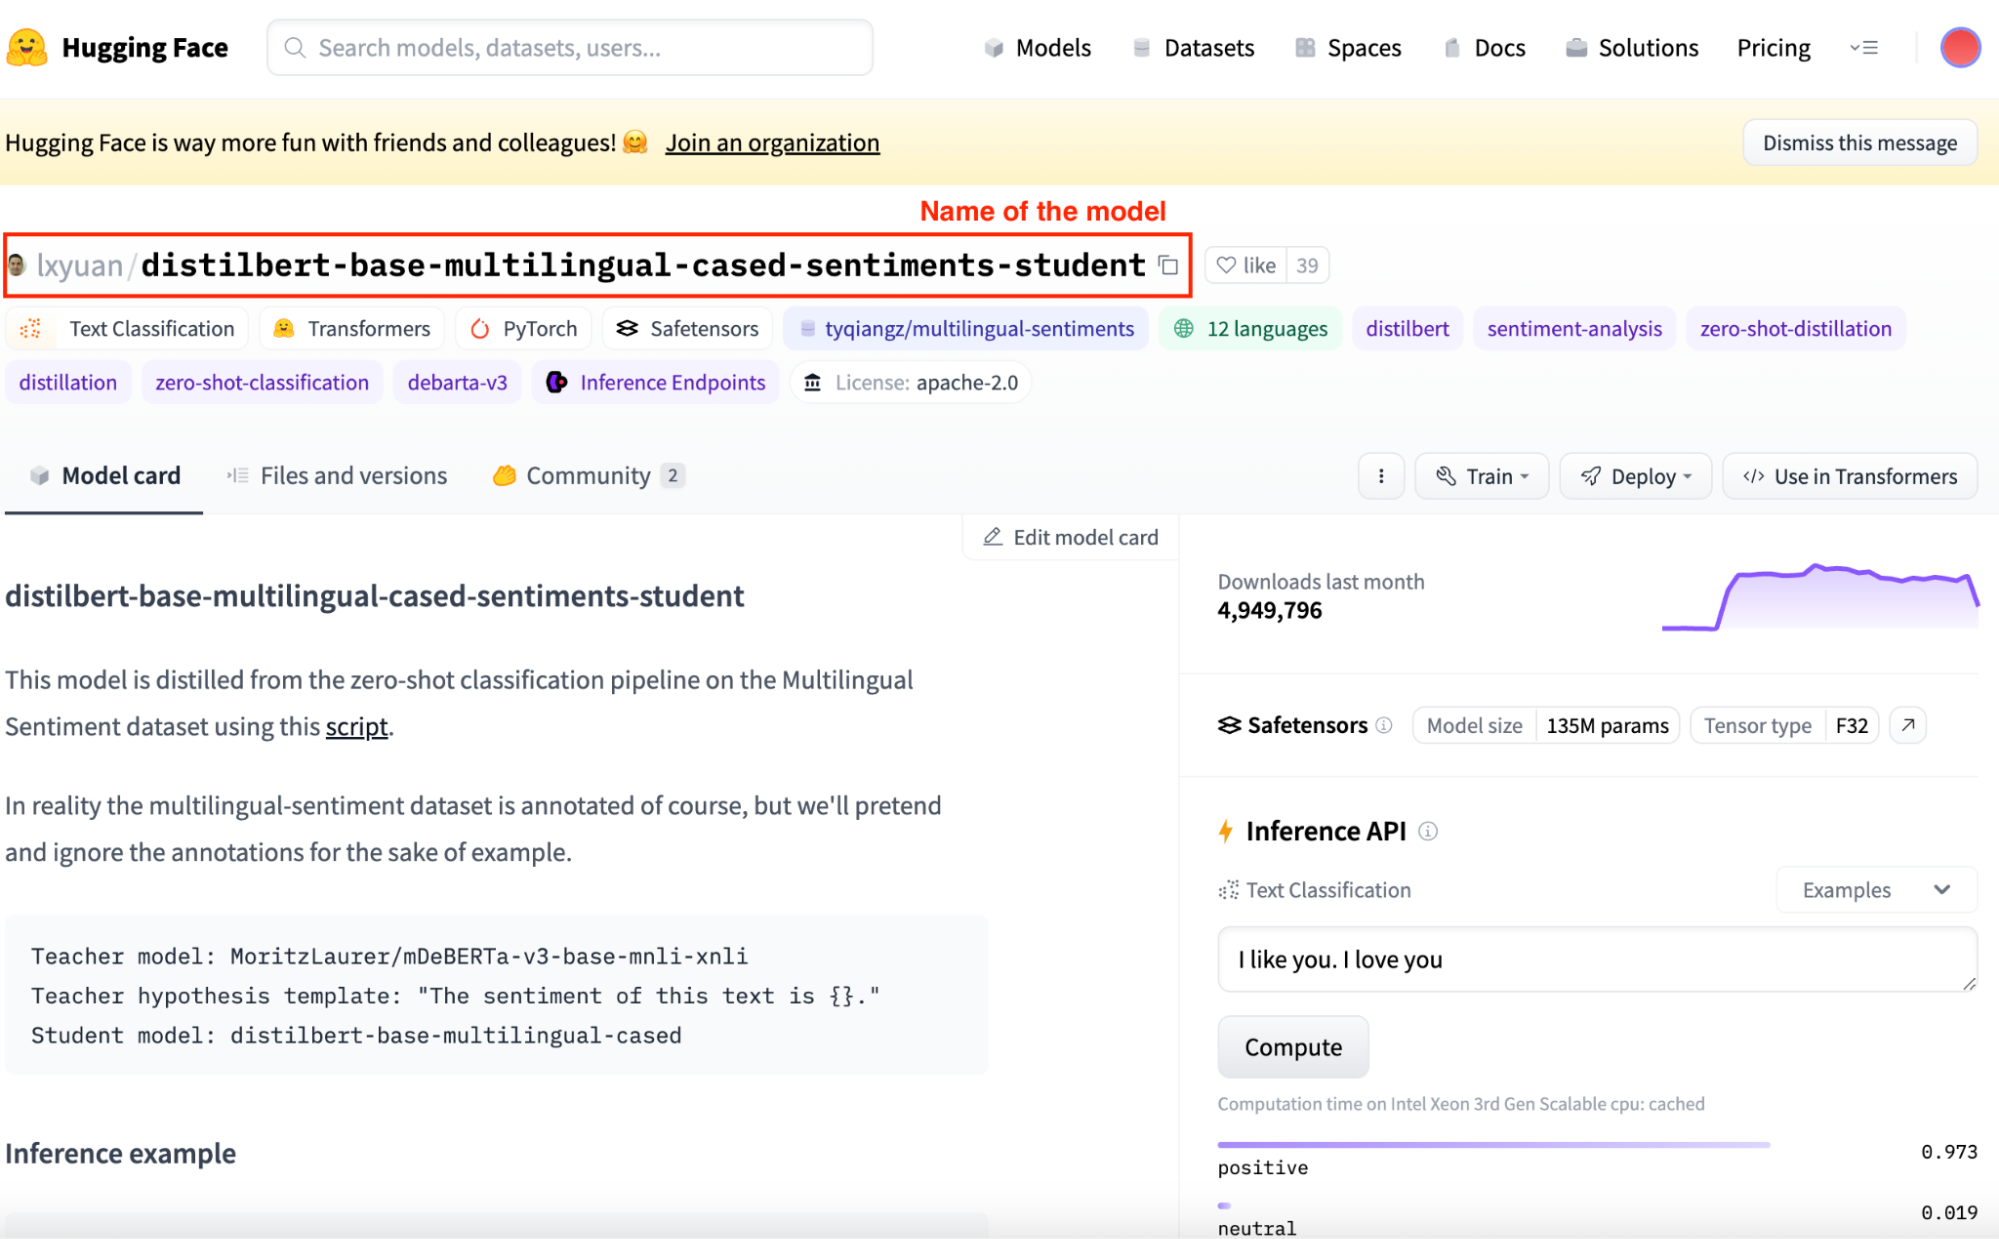
Screenshot van de model-specifieke weergave in Hugging Face Model Hub.
1. Laad een voorgetraind model: Nu we weten welk model we gebruiken, zetten we het in Python in. Eerst importeren we de klassen AutoTokenizer en AutoModelForSequenceClassification uit transformers.
Met deze AutoModel-klassen wordt de modelarchitectuur automatisch afgeleid op basis van de modelnaam.
from transformers import AutoTokenizer, AutoModelForSequenceClassification

model_name = "lxyuan/distilbert-base-multilingual-cased-sentiments-student"

# We call define a model object
model = AutoModelForSequenceClassification.from_pretrained(model_name)
2. Bereid je input voor: Laad een tokenizer voor ons model; in dit geval maakt de Transformers-bibliotheek het makkelijk doordat hij de juiste tokenizer afleidt aan de hand van de modelnaam die we hebben gekozen.
#We call the tokenizer class
tokenizer = AutoTokenizer.from_pretrained(model_name)
3. Voer het model uit: Genereer een pipeline-object met het gekozen model, de tokenizer en de uit te voeren taak. In ons geval: sentimentanalyse. Als je de classifier initieert met alleen de taak, vult de pipeline-klasse deze met standaardwaarden. Handig, maar niet aanbevolen in productie.
# Initializing a classifier with a model and a tokenizer
classifier = pipeline("sentiment-analysis", model = model, tokenizer = tokenizer)
# When passing only the task, the pipeline command inferes both the model and tokenizer.
classifier = pipeline("sentiment-analysis")
We kunnen dit model uitvoeren door wat input te geven.
output = classifier("I've been waiting for this tutorial all my life!")
4. Interpreteer de outputs: Het model retourneert een object met verschillende elementen, afhankelijk van de modelklasse. Voor dit sentimentanalysevoorbeeld krijgen we bijvoorbeeld:
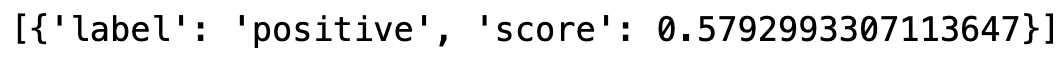
Verkregen output.
Fine-tuning is het proces waarbij je een voorgetraind model verder traint op een dataset die specifiek is voor jouw taak, zodat de parameters worden bijgewerkt. Zo kun je de geleerde representaties van het model benutten en aanpassen aan jouw use case.
Stel dat we een tekstclassificatiemodel nodig hebben om sentimenten uit een lijst tweets af te leiden. Een logische vraag is: Werkt dit voorgetrainde model wel goed genoeg?
Om dat zeker te weten, kunnen we fine-tuning toepassen: we trainen een voorgetraind Hugging Face-model met een dataset met tweets en bijbehorende sentimenten, zodat de performance verbetert.
Hier is een basic voorbeeld van het fine-tunen van een model voor sequence classification:
1. Kies een voorgetraind model en een dataset: Selecteer een modelarchitectuur die past bij je taak. In dit geval blijven we hetzelfde sentimentanalysemodel gebruiken. We hebben nu echter data nodig om het model te trainen.
En precies hier komt de datasets-bibliotheek van pas. We kunnen in de Model Hub alle datasets bekijken en degene kiezen die het best bij ons past.
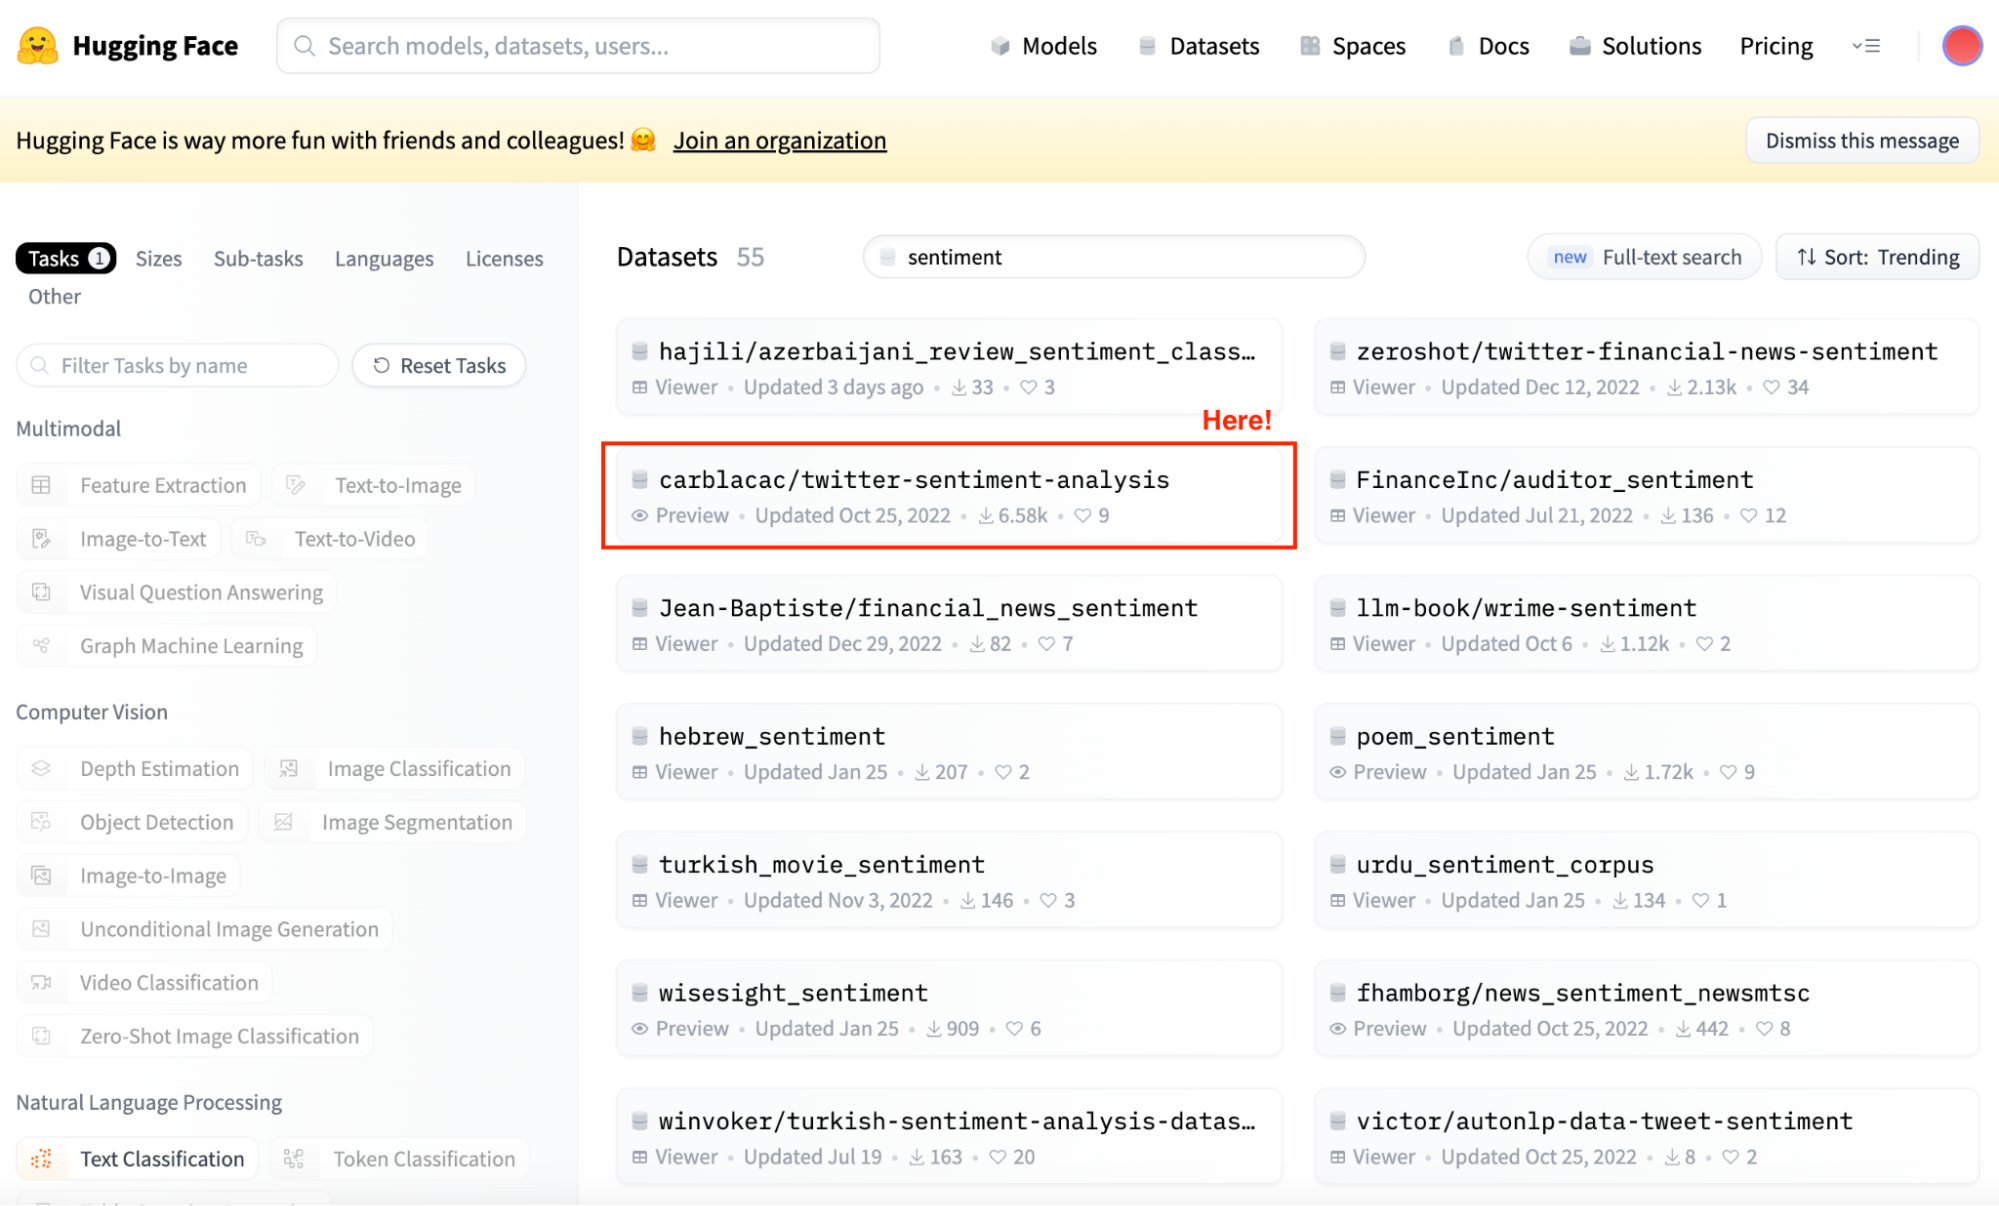
Screenshot van de hoofdweergave van Hugging Face Datasets Hub. Selectie van sentimentanalyse-datasets.
Nu we weten welke dataset we kiezen, kunnen we zowel het model als de dataset initialiseren.
model = AutoModelForSequenceClassification.from_pretrained(model_name)

# Loading the dataset to train our model
dataset = load_dataset("mteb/tweet_sentiment_extraction")
Als we de zojuist gedownloade dataset bekijken, zien we een dictionary met een subset voor training en een subset voor testen. Als we de trainingssubset naar een dataframe omzetten, ziet die er als volgt uit:
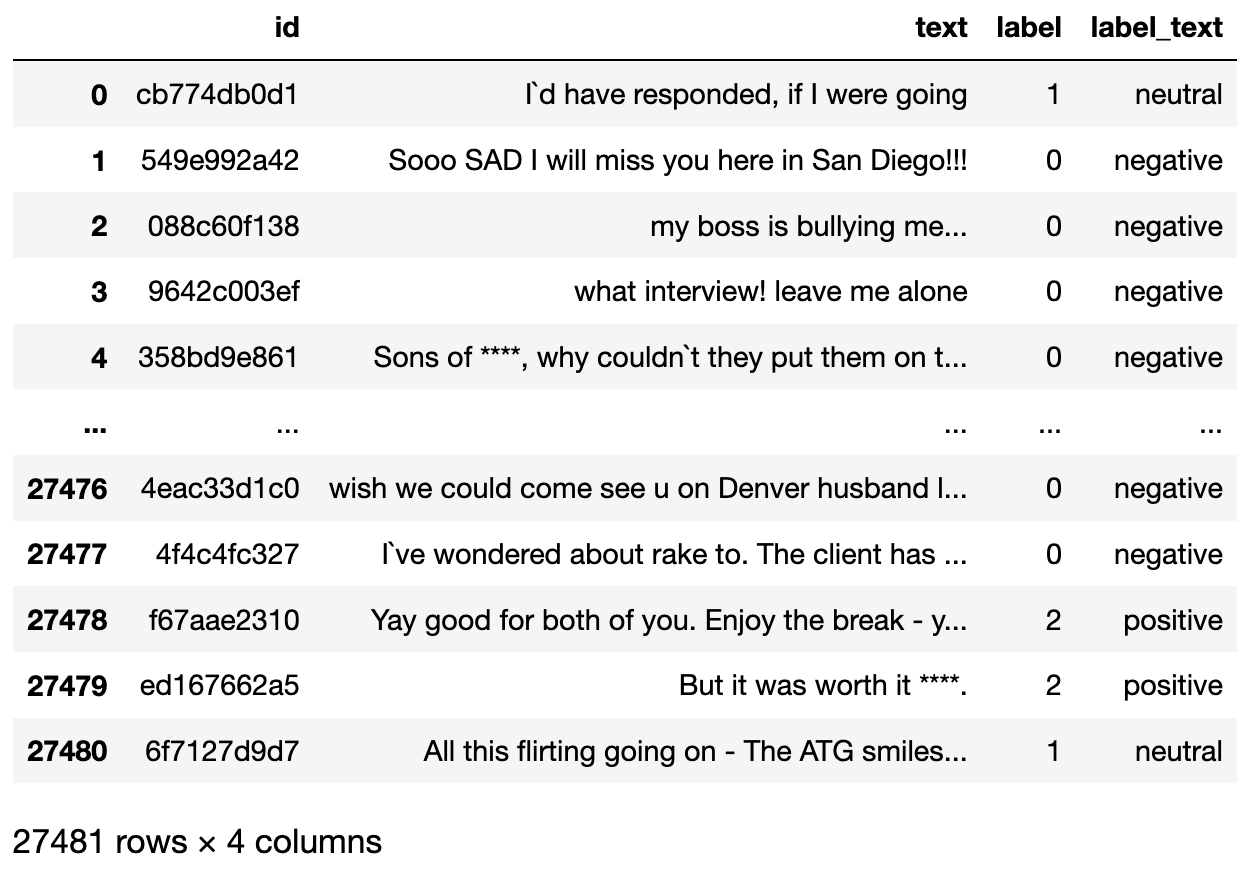
De dataset die wordt gebruikt.
2. Bereid je dataset voor: Nu we de dataset hebben, hebben we een tokenizer nodig om hem voor te bereiden voor ons model. De tekstvariabele in onze dataset moet getokenized worden zodat we die kunnen gebruiken om ons model te fine-tunen.
Daarom is de tweede stap het laden van een voorgetrainde Tokenizer en het tokenizen van onze dataset zodat die geschikt is voor fine-tuning.
tokenizer = AutoTokenizer.from_pretrained(model_name)

def tokenize_function(examples):
    return tokenizer(examples["text"], padding="max_length", truncation=True)

tokenized_datasets = dataset.map(tokenize_function, batched=True)
3. Bouw een PyTorch-dataset met encodings: De derde stap is het genereren van een train- en testdataset. De trainingsset gebruiken we om ons model te fine-tunen, de testset om het te evalueren.
Gewoonlijk kost fine-tuning veel tijd. Om de tutorial werkbaar te houden, nemen we willekeurige steekproeven uit beide datasets om de rekentijd te beperken.
from datasets import load_dataset

model = AutoModelForSequenceClassification.from_pretrained(model_name)

# Loading the dataset to train our model
dataset = load_dataset("mteb/tweet_sentiment_extraction")

small_train_dataset = tokenized_datasets["train"].shuffle(seed=42).select(range(1000))
small_eval_dataset = tokenized_datasets["test"].shuffle(seed=42).select(range(1000))
4. Fine-tune het model: Onze laatste stap is het instellen van de trainingsargumenten en het starten van het trainingsproces. De Transformers-bibliotheek bevat de trainer()-klasse, die alles regelt.
We definiëren eerst de trainingsargumenten en de evaluatiestrategie. Is alles gedefinieerd, dan kunnen we het model eenvoudig trainen met het commando train().
from transformers import Trainer, TrainingArguments
import numpy as np

training_args = TrainingArguments(output_dir="trainer_output", evaluation_strategy="epoch")

metric = evaluate.load("accuracy")

def compute_metrics(eval_pred):
    logits, labels = eval_pred
    predictions = np.argmax(logits, axis=-1)
    return metric.compute(predictions=predictions, references=labels)


trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=small_train_dataset,
    eval_dataset=small_eval_dataset,
    compute_metrics=compute_metrics,
)
trainer.train()
5. Evalueer het model: Evalueer na het trainen de prestaties van het model op een validatie- of testset. Ook hiervoor heeft de trainer-klasse al een evaluate-methode aan boord.
import evaluate

trainer.evaluate()
Ons gefinetunede model behaalt een nauwkeurigheid van 70%.
Nu we ons model hebben verbeterd, hoe delen we het met de community? Dat brengt ons bij de laatste stap.
Als je je model hebt gefinetuned, wil je het misschien met de community delen.
Hugging Face maakt dit proces eenvoudig. Installeer eerst de huggingface_hub-bibliotheek.
Voor deze laatste stap heb je een actieve token nodig om verbinding te maken met je Hugging Face-account. Je kunt er eenvoudig een krijgen via deze handleiding. Werk je in een Jupyter Notebook, dan kun je de notebook_login-bibliotheek gebruiken.
from huggingface_hub import notebook_login

notebook_login()
Dit opent een login in ons Jupyter Notebook. Je hoeft alleen je token in te voeren en het notebook is verbonden met je Hugging Face-account.
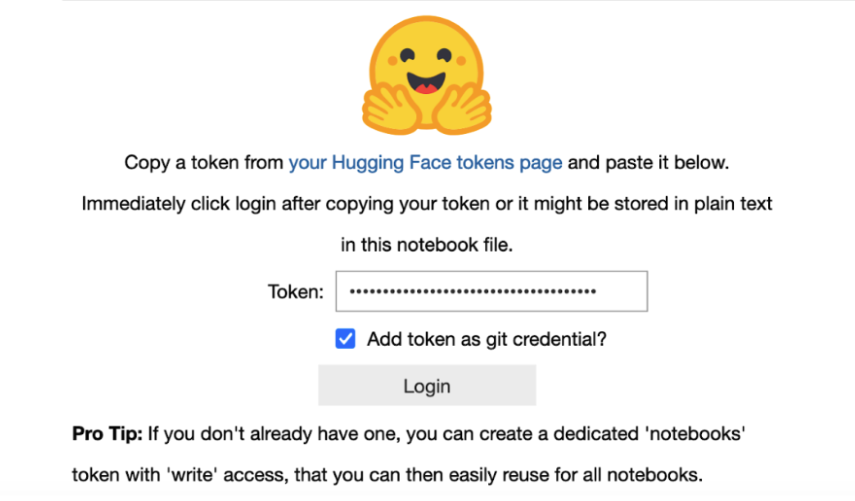
Nu hoeven we ons model alleen nog te uploaden met het commando push_to_hub.
finetuned_model.push_to_hub("my-awesome-model")
Daarna is het model voor iedereen zichtbaar op ons Hugging Face-profiel.
Als we een NLP-proces willen standaardiseren, komt dat met Hugging Face meestal neer op drie simpele stappen die minder dan vijf regels code kosten:
1. Definieer een modelobject met de pipeline-klasse (en het bijbehorende model en de tokenizer).
2. Definieer de inputtekst of prompt.
3. Voer het voorgetrainde model uit met onze input en bekijk de output.
Tekstclassificatie is een fundamentele taak in NLP. Hierbij ken je aan elke inputtekst één of meer categorieën toe. Dit is toepasbaar voor onder andere spamdetectie, sentimentanalyse, topiclabeling en meer.
In het onderstaande voorbeeld zie je hoe we met slechts de drie simpele stappen uit de vorige sectie een tekstclassificatiemodel implementeren.
# We import the pipeline module from the transformers library
from transformers import pipeline

# We load the pre-trained text classification model.
classifier = pipeline("text-classification",model='lxyuan/distilbert-base-multilingual-cased-sentiments-student')

# Input to be classified
input_ = "I absolutely love the transformers library!"

# Perform classification
output_ = classifier(input_)

# Observer the result
print(output_)
Makkelijk, toch?
Dan door naar de tweede use-case, een van de meest gebruikte aller tijden.
De meesten van jullie kennen ChatGPT of Google Bard al: tools die tekst genereren op basis van een inputprompt. Dit proces heet “Text Generation” en is een fascinerend onderdeel van NLP, waarbij een model mensachtige tekst produceert vanuit een initiële input.
De toepassingen zijn legio, van chatbotantwoorden genereren tot creatieve schrijfsels maken.
De kern is dat een model wordt getraind op een grote tekstcorpus, zodat het patronen, stijlen en structuren van taal leert. Zoals je kunt raden, is het trainen van het model het duurste onderdeel.
Hugging Face stelt ons echter in staat om zo’n model te implementeren in slechts vijf regels code, net als in het vorige geval.
Zie het voorbeeld hieronder:
from transformers import pipeline

generator = pipeline('text-generation', model='gpt2')

prompt = "In a world dominated by AI,"

generated_text = generator(prompt, max_length=50)[0]['generated_text']

print(generated_text)
Question answering, vaak afgekort tot QA, is een veld binnen NLP dat zich richt op systemen die automatisch vragen beantwoorden die in natuurlijke taal worden gesteld.
QA-systemen worden veel gebruikt in toepassingen zoals virtuele assistenten, klantenondersteuning en informatiesystemen.
QA-systemen zijn grofweg in twee typen in te delen:
Deze systemen combineren meestal natural language understanding om de vraag te interpreteren en information retrieval om relevante antwoorden te vinden.
Ook hier is implementatie met Hugging Face snel en eenvoudig.
from transformers import pipeline

qa_pipeline = pipeline('question-answering', model='distilbert-base-uncased-distilled-squad')

context = """Paris is the capital and most populous city of France. The city has an area of 105 square kilometers and a population of 2,140,526 residents."""
question = "What is the population of Paris?"

answer = qa_pipeline(question=question, context=context)
print(answer)
De laatste use-case is vertaling. Machinevertaling is een subveld van computationele taalkunde dat zich richt op het vertalen van tekst of spraak van de ene taal naar de andere met software. Met de komst van deep learning heeft machinevertaling enorme sprongen gemaakt, met name dankzij modellen zoals Neural Machine Translation (NMT) die grote neurale netwerken gebruiken.
Moderne NMT-systemen, in tegenstelling tot traditionele regelgebaseerde of statistische vertaalmodellen, leren vertalen door te trainen op grote datasets met tweetalige tekst. Ze gebruiken sequence-to-sequence-architecturen, waarbij een deel van het netwerk de brontekst encodeert en een ander deel die decodeert naar de doeltaal, vaak met indrukwekkende vloeiendheid en nauwkeurigheid.
Een eenvoudig voorbeeld met Hugging Face is:
from transformers import pipeline

# Load the translation pipeline for English to Spanish
translator = pipeline('translation_en_to_de')

# Text to translate from English to Spanish
text_to_translate = "This is a great day for science!"

# Perform the translation
translation = translator(text_to_translate, max_length=40)

# Print the translated text
print(translation[0]['translation_text'])
Hugging Face is uitgegroeid tot een transformerende kracht in kunstmatige intelligentie en natural language processing. De uitgebreide suite aan tools — waaronder de revolutionaire Transformers-bibliotheek, de collaboratieve Model Hub en de omvangrijke Datasets-bibliotheek — heeft de toegang tot geavanceerde NLP-mogelijkheden gedemocratiseerd.
Door een omgeving te creëren waarin innovatie gedeeld en gezamenlijk opgebouwd wordt, draagt Hugging Face niet alleen bij aan de vooruitgang van AI, maar helpt het ook een toekomst vorm te geven waarin technologie toegankelijker, inclusiever en krachtiger is.
Terwijl we de AI-revolutie blijven meemaken en eraan deelnemen, herinnert Hugging Face ons eraan dat de meest diepgaande technologische vooruitgang open, gedeeld en samen gebouwd is.
Het gaat niet alleen om slimmere machines, maar om het stimuleren van een slimmere, beter verbonden community van ontwikkelaars, onderzoekers en enthousiastelingen die graag de grenzen van het mogelijke verleggen.
Begin vandaag nog aan je AI- & NLP-reis!
Leerpad
Leerpad
Cursus
blog
Adel Nehme
15 min

