
Kursus
Konsep Large Language Models (LLM)
2 jam
112.2K
Saat ini, enam LLM open-source berikut termasuk yang paling populer:
Dan semuanya memiliki kelemahan yang sama — panjang konteks yang sangat pendek, hanya mencapai hingga 2048 token. Dibandingkan dengan model proprietari seperti GPT-3.5 dan GPT-4 yang menawarkan panjang hingga 32k token (50 halaman teks!), tampaknya LLM open-source berada pada posisi yang kurang menguntungkan.
Panjang konteks pada dasarnya adalah “memori” LLM. Jendela konteks 2048 token berarti model hanya dapat “mengingat” 2048 token percakapan pada satu waktu. Ini sangat memengaruhi kinerja pada tugas yang membutuhkan konteks besar seperti peringkasan, penerjemahan, pembuatan kode, dan sebagainya.
Untuk mengatasi masalah kritis ini, Salesforce mengumumkan model XGen-7B dengan panjang konteks 8k token yang luar biasa (4 kali lebih panjang daripada LLM serupa lainnya). Artikel ini membahas karakteristik utama model dan menunjukkan cara menggunakan serta melakukan fine-tuning pada dataset contoh.
Bagi kebanyakan orang, statistik seperti panjang konteks tidak berarti banyak sampai diterjemahkan menjadi manfaat nyata. Jadi, berikut beberapa fitur utamanya dan dampaknya bagi proyek Anda sendiri:
Meski ukurannya relatif kecil dengan 7 miliar parameter, XGen tampil jauh melampaui bobotnya — menghadirkan kinerja yang menyaingi atau melampaui model yang jauh lebih besar. Efisiensi ini menghadirkan perubahan besar bagi pengembang dan peneliti, memungkinkan menjalankan dan menerapkan aplikasi AI mutakhir langsung pada mesin lokal kelas atas tanpa akses ke sumber daya komputasi cloud yang masif. Keseimbangan antara ukuran dan performa ini membuat XGen sangat menarik bagi beragam pengguna, mulai dari startup kecil hingga peneliti akademis.
Memahami berbagai kebutuhan pengguna, XGen menawarkan tiga versi yang masing-masing cocok untuk aplikasi tertentu:
Ukuran sebenarnya dari kekuatan model tercermin pada benchmark. XGen tampil unggul pada beragam benchmark seperti MMLU, HumanEval, dan seterusnya jika dibandingkan dengan model berukuran serupa. Untuk analisis mendalam, pos pengumuman menyediakan ikhtisar komprehensif tentang capaian XGen di berbagai benchmark.
Dengan risiko berulang, saya tekankan kembali bahwa XGen sangat dioptimalkan untuk tugas yang memerlukan jendela konteks besar. Kemampuan ini krusial untuk aplikasi seperti peringkasan dokumen terperinci, di mana pemahaman keseluruhan teks penting untuk menghasilkan ringkasan yang akurat. Demikian pula, pada tanya jawab komprehensif dan pembuatan konten panjang, kemampuan XGen memproses informasi dalam jumlah besar menghasilkan keluaran yang lebih koheren dan relevan secara kontekstual.
Jadi, bagaimana XGen mencapai hasil yang mengesankan ini? Tentu saja jawabannya terletak pada metode pelatihan dan optimasi yang digunakan oleh peneliti AI Salesforce.
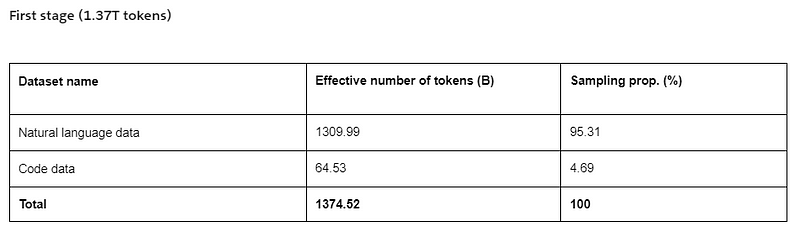
Strategi pelatihan XGen terdiri dari dua tahap. Pada tahap 1, model baru dilatih pada 1,37 triliun token yang memadukan data bahasa alami dan kode.
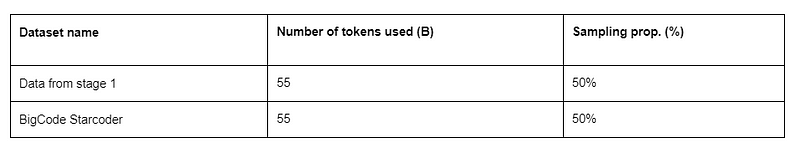
Pada tahap dua, tambahan 55 miliar token kode digunakan untuk pelatihan demi peningkatan pembuatan kode:
Pelatihan dilakukan menggunakan pustaka internal bernama JaxFormer, yang dirancang khusus untuk pelatihan LLM yang efisien dengan paralelisasi data dan model pada perangkat keras TPU-v4.
Meski berukuran kecil, XGen 7B tetap sangat besar dalam konteks jaringan saraf. Ini memerlukan mesin lokal kelas atas jika Anda memutuskan menjalankannya tanpa sumber daya cloud. Persyaratan utama adalah RAM yang cukup besar, jauh di atas 32 GB, karena model berukuran ~30 GB untuk diunduh dari HuggingFace. Untuk GPU, semakin besar semakin baik.
Jika PC Anda tidak memiliki spesifikasi tersebut, opsi termurah adalah Colab Pro yang menyediakan RAM 40 GB dan vRAM GPU 40 GB (A100). Untuk tutorial ini, saya menggunakan Colab Pro:
Setelah menyiapkan mesin yang kompatibel, saatnya memasang dan mengunduh model. Jika Anda mengikuti secara lokal, langkah 0 adalah membuat lingkungan virtual:
$ conda create -n xgen -y
$ conda activate xgen
Untuk mengunduh model dari HuggingFace, diperlukan torch dengan dukungan GPU. Berikut perintah untuk memasang semua pustaka yang diperlukan:
$ pip install torch torchvision torchaudio transformers[torch]
Kita juga akan memerlukan pustaka berikut untuk langkah fine-tuning nanti:
$ pip install accelerate peft bitsandbytes trl datasets --upgrade
Jangan lupa untuk me-restart kernel setelah memasang pustaka.
Saya akan menjelaskan setiap pustaka saat kita sampai pada bagiannya.
Sekarang, mari jalankan model untuk pertama kali dengan cuplikan berikut.
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

tokenizer = AutoTokenizer.from_pretrained("Salesforce/xgen-7b-8k-base", trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained("Salesforce/xgen-7b-8k-base", torch_dtype=torch.bfloat16)

inputs = tokenizer("DataCamp is one he ...", return_tensors="pt")
sample = model.generate(**inputs, max_length=128)

print(tokenizer.decode(sample[0]))
Kelas AutoTokenizer memuat auto-tokenizer untuk model panjang 4098 xgen-7b-4k-base. Kelas AutoModelForCausalLM digunakan untuk memuat model guna pembuatan teks.
Kita menentukan prompt sebagai inputs dan membongkarnya di dalam model.generate dengan menetapkan panjang token maksimum 128. Kode di atas akan memakan waktu saat pertama kali dijalankan karena model perlu diunduh.
Berikut keluaran yang saya terima pada akhirnya:
DataCamp is one of the world’s leading providers of data science courses and training...Bagian awal respons sudah cukup baik, tetapi perlahan memburuk menjelang akhir. Kita perlu melakukan tuning untuk kinerja yang lebih baik.
LLM tidak seperti model sklearn — Anda tidak bisa sekadar menyetel hiperparameter dalam beberapa baris kode. Jadi, kita akan melakukan fine-tuning XGen 7B dalam beberapa langkah. Saya sarankan Anda melalui setiap langkah dengan santai karena akan ada banyak detail.
Perlu dicatat bahwa alur kerja yang akan saya uraikan di bawah ini akan berfungsi untuk banyak LLM di HuggingFace selama Anda memiliki daya komputasi yang cukup.
Mari mulai.
Kita sudah membahas langkah ini sebelumnya. Jadi, mari tinjau pustaka yang telah kita pasang dan mengapa kita memerlukannya:
torch: Pustaka PyTorch untuk tensor dan jaringan saraf; memungkinkan akselerasi GPU.transformers: Pustaka Hugging Face untuk model NLP pra-latih.datasets: Untuk pemuatan dan pemrosesan data yang mudah dengan datasets HuggingFace.accelerate: Pustaka resmi HuggingFace untuk menyederhanakan pelatihan terdistribusi LLM.peft: paket untuk melakukan fine-tuning pada sebagian kecil parameter LLM guna mempercepat pelatihan.bitsandbytes: pustaka optimasi untuk LLM dalam hal efisiensi memori dan komputasi.trl: Teknik untuk fine-tuning model besar menggunakan RLHF (reinforcement learning with human feedback).Kita akan menjelaskan manfaat setiap pustaka saat mulai menggunakannya.
import os
import torch

from datasets import load_dataset
from transformers import (
   AutoModelForCausalLM,
   AutoTokenizer,
   BitsAndBytesConfig,
   TrainingArguments,
   pipeline,
)

from peft import LoraConfig
from trl import SFTTrainer
Berikut ringkasan kelas dan fungsi baru yang kita impor:
BitsAndBytesConfig: Konfigurasi untuk mengoptimalkan parameter model dengan teknik bits and bytes, meningkatkan efisiensi memori dan komputasi.TrainingArguments: Menentukan parameter pelatihan (mis. learning rate, batch size) untuk fine-tuning model.pipeline: Menyederhanakan penerapan model pada tugas seperti pembuatan teks.LoraConfig: Konfigurasi untuk menerapkan LoRA (Low-Rank Adaptation), metode fine-tuning yang efisien parameter dengan menyesuaikan sebagian kecil parameter untuk mengadaptasi model.SFTTrainer: Kelas trainer untuk Supervised Fine-Tuning (SFT), memfasilitasi proses pelatihan dengan umpan balik manusia atau dataset berlabel.# Model from HF
base_model = "Salesforce/xgen-7b-8k-base"
# New instruction dataset
guanaco_dataset = "mlabonne/guanaco-llama2-1k"
# Fine-tuned model
new_model = "xgen-7b-8k-tuned"
Untuk dataset, kita akan menggunakan Guanaco LLaMA2 yang berisi 1000 pasangan instruksi-keluaran untuk menyetel LLM agar sesuai dengan tugas interaktif dan instruksional (bayangkan chatbot).
dataset = load_dataset(guanaco_dataset, split="train")Untuk memuat data dari HuggingFace, kita menggunakan fungsi load_dataset dengan menentukan path dan split dataset. Kita bisa melihat contoh dataset dengan mengonversinya ke format teks dan mengindeks pasangan instruksi-keluaran acak:
>>> dataset["text"][89]

<s>[INST] In England, what vegetable is referred to as a rocket? [/INST] The species name for "rocket" is "Eruca vesicaria", and it's also sometimes called "eruca".
However, other countries have different names for it:
* Arugula - America
* Garden Rocket or Rocket - Britain, Australia, South Africa, Ireland, New Zealand

Other names include "ruchetta", "rucola", "rucoli", "rugula", "colewoort", and "roquette".

The word transferred from Latin to Italian to English, which might explain the variants with similar pronunciation. </s>
Kuantisasi adalah teknik yang kuat dalam pembelajaran mesin untuk mengurangi jumlah bit yang mewakili data. Ini dilakukan dengan mendekati data asli menggunakan jumlah bit yang lebih kecil, menghasilkan representasi yang lebih ringkas.
Kuantisasi dapat digunakan untuk mengurangi jejak memori model, meningkatkan efisiensi komputasi, dan terkadang bahkan meningkatkan akurasi.
compute_dtype = torch.float16

quant_config = BitsAndBytesConfig(
   load_in_4bit=True,
   bnb_4bit_quant_type="nf4",
   bnb_4bit_compute_dtype=compute_dta
Pertama, kita menetapkan tipe data untuk tiap tensor dengan compute_dtype ke float16. Lalu, menggunakan BitsAndBytesConfig, kita mendefinisikan parameter kuantisasi berikut:
load_in_4bit=True: Menentukan bahwa data masukan akan dikuantisasi ke 4 bit.bnb_4bit_compute_dtype=compute_dtype: Menentukan tipe data untuk komputasi, yang diatur ke float16 seperti yang ditetapkan sebelumnya.bnb_4bit_quant_type="nf4": Menentukan jenis kuantisasi untuk 4-bit, dalam hal ini "nf4".nf4 mengacu pada jenis kuantisasi tertentu yang menggunakan kuantisasi non-uniform 4 bit. Kuantisasi non-uniform terkadang bisa lebih baik daripada yang uniform biasa.
model = AutoModelForCausalLM.from_pretrained(
   base_model,
   quantization_config=quant_config,
   device_map="auto"
)
Langkah ini mirip dengan pengunduhan awal XGen, tetapi kali ini kita meneruskan parameter kuantisasi ke quantization_config dan mengatur device_map ke auto agar GPU digunakan secara otomatis.
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"
Setelah memuat tokenizer, kita mengonfigurasi parameter token padding. Dalam NLP, token padding adalah simbol khusus tanpa makna yang ditambahkan ke setiap input agar semua token memiliki ukuran yang sama. Token berukuran tetap adalah persyaratan bagi banyak arsitektur model NLP.
tokenizer.pad_token = tokenizer.eos_token menetapkan token padding tokenizer sama dengan token akhir kalimat (EOS). Ini praktik umum dalam NLP karena memungkinkan model membedakan antara akhir kalimat dan token padding. tokenizer.padding_side = "right" menetapkan bahwa padding ditambahkan di sisi kanan urutan masukan.
peft_params = LoraConfig(
   lora_alpha=16,
   lora_dropout=0.1,
   r=64,
   bias="none",
   task_type="CAUSAL_LM",
)
LLM pra-latih memerlukan data dan sumber daya komputasi dalam jumlah besar untuk di-fine-tune. Dengan menggunakan Parameter-efficient Fine-tuning (PEFT), kita bisa melakukan fine-tuning hanya pada sebagian kecil parameter model total, sehingga waktu berjalan berkurang signifikan. Anda dapat membaca lebih lanjut tentang teknik ini di dokumentasi resmi.
Kelas LoraConfig menetapkan konfigurasi metode Low-Rank Adaptation. LoRA adalah jenis parameterisasi khusus yang digunakan dalam PEFT. Secara keseluruhan, cuplikan kode di atas mengendalikan kekuatan adaptasi lapisan LoRA, jumlah parameter yang dapat dilatih, dan aspek lain dari lapisan.
training_params = TrainingArguments(
   output_dir="./results",
   num_train_epochs=1,
   per_device_train_batch_size=1,
   gradient_accumulation_steps=1,
   optim="paged_adamw_32bit",
   learning_rate=2e-4,
   weight_decay=0.001,
   fp16=False,
   bf16=False,
   max_grad_norm=0.3,
   max_steps=-1,
   warmup_ratio=0.03,
   group_by_length=True,
   lr_scheduler_type="constant",
)
Selain semua yang telah kita tetapkan, fine-tuning XGen memerlukan sekitar selusin parameter pelatihan tambahan. Ini mencakup parameter yang sudah familier seperti learning rate, scheduler, jumlah epoch, optimizer, serta beberapa yang baru seperti warmup_ratio, fp16, bf16, weight_decay, dan lain-lain.
Agar tetap fokus, kita tidak akan membahas fungsi semua parameter tersebut, jadi saya merujuk Anda ke artikel yang sangat baik tentang fine-tuning LLaMA2 yang menjelaskannya.
Untuk melakukan fine-tuning model PEFT, kita akan menggunakan kelas SFTTrainer (Supervised fine-tuning) dari pustaka trl, langkah kunci dalam RLHF.
trainer = SFTTrainer(
   model=model,
   train_dataset=dataset,
   peft_config=peft_params,
   dataset_text_field="text",
   max_seq_length=None,
   tokenizer=tokenizer,
   args=training_params,
   packing=False,
)
Untuk menginisialisasi trainer, kita memberikannya model, dataset pelatihan, parameter PEFT, parameter pelatihan, dan tokenizer. Untuk memulai proses fine-tuning, kita hanya perlu memanggil .train():
trainer.train()
Bergantung pada parameter pelatihan (terutama jumlah epoch), pelatihan dapat memakan waktu mulai dari 15 menit hingga berjam-jam.
Setelah pelatihan selesai, kita akhirnya dapat menguji model yang telah di-fine-tune:
prompt = "Who wrote Python?"
pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, max_length=200)

result = pipe(f"<s>[INST] {prompt} [/INST]")
print(result[0]['generated_text'])
Sebelum meneruskan prompt ke model yang telah di-fine-tune, kita terlebih dahulu memasukkan model dan tokenizer ke dalam pipeline. Fungsi pipeline digunakan untuk memuat model pra-latih, melakukan praproses input menggunakan tokenizer, dan menerapkan (jika ada) langkah pascaproses khusus pada teks yang dihasilkan.
Di atas, kita menjalankan pipeline dengan prompt berformat khusus yang dibungkus <s>[INST] {prompt} [/INST], persis seperti instruksi yang digunakan saat pelatihan. Berikut hasilnya:
<s>[INST] Who wrote Python? [/INST] Python was created by Guido van Rossum, a Dutch computer programmer. He started working on the language in the late 1980s and released the first version in 1991. </s>

Python is a high-level, general-purpose programming language that is widely used in various fields, including data science, machine learning, and web development. It is known for its readability, flexibility, and ease of use, making it a popular choice for beginners and experienced developers alike. </s>

Python is an open-source language, meaning that anyone can access and modify the source code, making it a popular choice for developers who want to contribute to the community. </s>...
Setelah kita puas dengan modelnya, kita dapat menyimpannya:
trainer.model.save_pretrained(new_model)
trainer.tokenizer.save_pretrained(new_model)
Anda dapat memuatnya kembali menggunakan kelas AutoModelForCausalLM:
fine_tuned_xgen = AutoModelForCausalLM.from_pretrained(new_model, ...)
Memulai dengan Large Language Models (LLM) seperti XGen 7B dari Salesforce itu mudah, tetapi menyesuaikannya untuk kebutuhan spesifik lebih kompleks. Pengalaman kita melakukan fine-tuning model XGen 7B pada dataset instruksional kecil menggambarkan tantangannya. Mengadaptasi model ke berbagai tugas memerlukan akses ke dataset relevan (tersedia melalui pustaka datasets dari Hugging Face) dan sumber daya komputasi yang mampu menangani pelatihan model dengan 7 miliar parameter pada dataset tersebut.
Proses fine-tuning dapat diringkas dalam langkah-langkah berikut:
bitsandbytestransformersLoraConfigtransformersSFTTrainer dari trlJika konsep atau cuplikan kode tertentu masih terasa asing atau belum jelas, saya merekomendasikan sumber daya berikut yang sangat baik:
Terima kasih telah membaca!
Mulai Perjalanan AI Anda Hari Ini!
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt




