Kurs
Konzepte großer Sprachmodelle (LLMs)
2 Std.
113K
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleAktuell zählen diese sechs zu den heißesten Open-Source-LLMs:
Und sie alle haben denselben Nachteil — eine sehr kurze Kontextlänge von maximal 2048 Tokens. Verglichen mit proprietären Modellen wie GPT-3.5 und GPT-4, die bis zu 32k Tokens (50 Seiten Text!) erlauben, stehen Open-Source-LLMs klar im Nachteil.
Die Kontextlänge ist im Kern das „Gedächtnis“ von LLMs. Ein Kontextfenster von 2048 Tokens bedeutet, dass sich das Modell jeweils nur 2048 Tokens der Unterhaltung „merken“ kann. Das wirkt sich deutlich auf Aufgaben aus, bei denen viel Kontext entscheidend ist, etwa Zusammenfassung, Übersetzung, Codegenerierung usw.
Um dieses zentrale Problem anzugehen, hat Salesforce sein XGen-7B-Modell vorgestellt – mit einer beachtlichen Kontextlänge von 8k Tokens (viermal so lang wie vergleichbare LLMs). Dieser Artikel stellt die wichtigsten Merkmale des Modells vor und zeigt, wie du es an einem Beispieldatensatz nutzt und feinabstimmst.
Für die meisten sagen Kennzahlen wie Kontextlänge wenig aus, bis sie sich in greifbaren Vorteilen zeigen. Hier sind daher die wichtigsten Features – und was sie für deine Projekte bedeuten:
Trotz seiner relativ kleinen Größe von 7 Milliarden Parametern liefert XGen Leistung auf Augenhöhe mit deutlich größeren Modellen – teils sogar darüber. Diese Effizienz ist ein Gamechanger für Entwicklerinnen, Entwickler und Forschende: Moderne KI-Anwendungen lassen sich direkt auf leistungsstarken lokalen Maschinen ausführen und bereitstellen, ohne riesige Cloud-Ressourcen. Diese Balance aus Größe und Performance macht XGen für viele Zielgruppen attraktiv – von kleinen Startups bis hin zu Forschungsteams.
Weil Anforderungen variieren, bietet XGen drei Varianten, die sich für unterschiedliche Einsatzzwecke eignen:
Die wahre Stärke zeigt sich in Benchmarks. XGen liegt bei einer Reihe verschiedener Benchmarks wie MMLU, HumanEval usw. im Vergleich zu ähnlich großen Modellen vorn. Eine detaillierte Analyse findest du im Ankündigungsbeitrag mit einem umfassenden Überblick über XGens Ergebnisse.
Ich betone es gern noch einmal: XGen ist stark auf Aufgaben mit großen Kontextfenstern optimiert. Das ist entscheidend für Anwendungen wie ausführliche Dokumentenzusammenfassungen, bei denen das Verständnis des gesamten Texts nötig ist, um präzise Zusammenfassungen zu erzeugen. Ebenso profitieren umfassende Question-Answering-Systeme und Longform-Generierung: XGen verarbeitet große Informationsmengen und liefert dadurch kohärentere, kontextrelevantere Ausgaben.
Wie erreicht XGen diese beeindruckenden Resultate? Die Antwort liegt natürlich in den Trainings- und Optimierungsmethoden der Salesforce-AI-Forschenden.
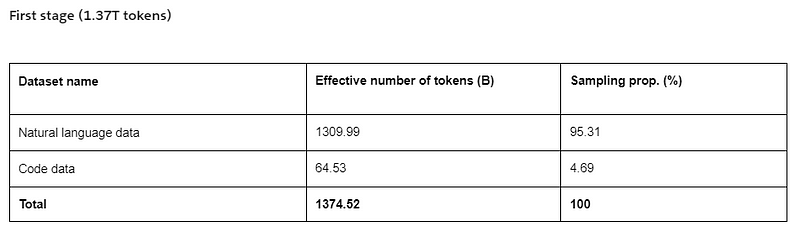
Die Trainingsstrategie von XGen umfasst zwei Phasen. In Phase 1 wird ein frisches Modell auf 1,37 Billionen Tokens trainiert – eine Mischung aus natürlicher Sprache und Code.
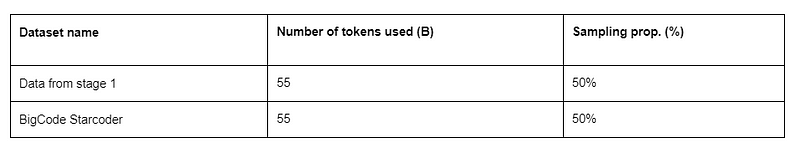
In Phase 2 folgen zusätzliche 55 Milliarden Tokens aus Code, um die Codegenerierung weiter zu verbessern:
Das Training erfolgte mit der Inhouse-Bibliothek JaxFormer, speziell entwickelt für effizientes LLM-Training mit Daten- und Modellparallelisierung auf TPU-v4-Hardware.
Trotz der geringen Parameterzahl ist XGen 7B als neuronales Netz immer noch groß. Wenn du es ohne Cloud-Ressourcen lokal ausführen willst, brauchst du eine High-End-Maschine. Wichtigste Anforderung ist ausreichend RAM – deutlich über 32 GB, da das Modell ~30 GB beim Download von HuggingFace umfasst. Bei GPUs gilt: je größer, desto besser.
Falls dein PC diese Spezifikationen nicht erfüllt, ist Colab Pro die günstigste Option – mit 40 GB RAM und 40 GB GPU-vRAM (A100). Für dieses Tutorial nutze ich Colab Pro:
Nach dem Einrichten einer kompatiblen Maschine ist es Zeit, das Modell zu installieren und herunterzuladen. Wenn du lokal mitgehst, ist Schritt 0 das Erstellen einer virtuellen Umgebung:
$ conda create -n xgen -y
$ conda activate xgen
Um das Modell von HuggingFace zu laden, muss torch mit GPU-Unterstützung installiert sein. Hier ist der Befehl zum Installieren aller benötigten Libraries:
$ pip install torch torchvision torchaudio transformers[torch]
Für die spätere Feinabstimmung benötigen wir außerdem diese Libraries:
$ pip install accelerate peft bitsandbytes trl datasets --upgrade
Vergiss nicht, den Kernel nach der Installation neu zu starten.
Ich erkläre die einzelnen Libraries, sobald wir sie verwenden.
Jetzt starten wir das Modell zum ersten Mal mit folgendem Snippet.
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

tokenizer = AutoTokenizer.from_pretrained("Salesforce/xgen-7b-8k-base", trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained("Salesforce/xgen-7b-8k-base", torch_dtype=torch.bfloat16)

inputs = tokenizer("DataCamp is one he ...", return_tensors="pt")
sample = model.generate(**inputs, max_length=128)

print(tokenizer.decode(sample[0]))
Die Klasse AutoTokenizer lädt den Auto-Tokenizer für das 4098-Längen-Modell xgen-7b-4k-base. AutoModelForCausalLM lädt Modelle für Textgenerierung.
Wir übergeben den Prompt als inputs und entpacken ihn in model.generate mit einer maximalen Tokenlänge von 128. Beim ersten Lauf dauert es etwas, da das Modell heruntergeladen wird.
So sah meine Ausgabe am Ende aus:
DataCamp is one of the world’s leading providers of data science courses and training...Der Anfang ist solide, gegen Ende wird die Antwort jedoch schwächer. Wir müssen feinabstimmen, um bessere Ergebnisse zu erzielen.
LLMs sind nicht wie sklearn-Modelle – du kannst ihre Hyperparameter nicht in ein paar Zeilen Code „tunen“. Deshalb stimmen wir XGen 7B in mehreren Schritten fein. Geh sie am besten der Reihe nach durch – es gibt viele Details.
Der unten skizzierte Workflow funktioniert für viele LLMs auf HuggingFace, solange genügend Rechenleistung vorhanden ist.
Los geht’s.
Das haben wir bereits erledigt. Hier ein kurzer Überblick über die installierten Libraries und warum wir sie brauchen:
torch: PyTorch für Tensoren und neuronale Netze; ermöglicht GPU-Beschleunigung.transformers: Hugging Face Library für vortrainierte NLP-Modelle.datasets: Einfaches Laden und Verarbeiten von HuggingFace-Datensätzen.accelerate: Offizielle HuggingFace-Library für vereinfachtes verteiltes Training von LLMs.peft: Paket zur effizienten Feinabstimmung eines kleinen Bruchteils der LLM-Parameter.bitsandbytes: Optimierung von LLMs hinsichtlich Speicher- und Recheneffizienz.trl: Techniken zur Feinabstimmung großer Modelle mit RLHF (Reinforcement Learning mit menschlichem Feedback).Die Vorteile jeder Library erläutern wir, sobald wir sie einsetzen.
import os
import torch

from datasets import load_dataset
from transformers import (
   AutoModelForCausalLM,
   AutoTokenizer,
   BitsAndBytesConfig,
   TrainingArguments,
   pipeline,
)

from peft import LoraConfig
from trl import SFTTrainer
Hier ein Überblick zu den neuen Klassen und Funktionen:
BitsAndBytesConfig: Konfiguration zur Optimierung von Modellparametern mit Bits-and-Bytes-Techniken für bessere Speicher- und Recheneffizienz.TrainingArguments: Trainingsparameter (z. B. Learning Rate, Batchgröße) für die Feinabstimmung.pipeline: Vereinfacht die Anwendung von Modellen auf Aufgaben wie Textgenerierung.LoraConfig: Konfiguration für LoRA (Low-Rank Adaptation), eine effiziente Feinabstimmungsmethode, die nur wenige Parameter anpasst.SFTTrainer: Trainer für Supervised Fine-Tuning (SFT) – unterstützt Training mit menschlichem Feedback oder gelabelten Datensätzen.# Model from HF
base_model = "Salesforce/xgen-7b-8k-base"
# New instruction dataset
guanaco_dataset = "mlabonne/guanaco-llama2-1k"
# Fine-tuned model
new_model = "xgen-7b-8k-tuned"
Für den Datensatz nutzen wir das Guanaco-LLaMA2-Set mit 1000 Instruction-Output-Paaren, um LLMs für interaktive und instruktive Aufgaben (z. B. Chatbots) zu tunen.
dataset = load_dataset(guanaco_dataset, split="train")Zum Laden der Daten von HuggingFace verwenden wir load_dataset und geben Pfad sowie Split an. Beispiele lassen sich anzeigen, indem wir den Datensatz in Text konvertieren und ein zufälliges Instruction-Output-Paar indexieren:
>>> dataset["text"][89]

<s>[INST] In England, what vegetable is referred to as a rocket? [/INST] The species name for "rocket" is "Eruca vesicaria", and it's also sometimes called "eruca".
However, other countries have different names for it:
* Arugula - America
* Garden Rocket or Rocket - Britain, Australia, South Africa, Ireland, New Zealand

Other names include "ruchetta", "rucola", "rucoli", "rugula", "colewoort", and "roquette".

The word transferred from Latin to Italian to English, which might explain the variants with similar pronunciation. </s>
Quantisierung ist eine wirksame Technik, um die Anzahl der Bits zur Darstellung von Daten zu reduzieren. Dabei wird die Originaldarstellung näherungsweise mit weniger Bits kodiert – das spart Speicherplatz.
Quantisierung kann den Speicherbedarf eines Modells senken, die Recheneffizienz verbessern und mitunter sogar die Genauigkeit erhöhen.
compute_dtype = torch.float16

quant_config = BitsAndBytesConfig(
   load_in_4bit=True,
   bnb_4bit_quant_type="nf4",
   bnb_4bit_compute_dtype=compute_dta
Zuerst setzen wir den Datentyp für Tensoren mit compute_dtype auf float16. Anschließend definieren wir mit BitsAndBytesConfig folgende Quantisierungsparameter:
load_in_4bit=True: Die Eingabedaten werden auf 4 Bit quantisiert.bnb_4bit_compute_dtype=compute_dtype: Datentyp für Berechnungen – hier float16 wie oben festgelegt.bnb_4bit_quant_type="nf4": Typ der 4-Bit-Quantisierung – in diesem Fall "nf4".nf4 bezeichnet eine nicht-uniforme 4-Bit-Quantisierung. Nicht-uniforme Verfahren können gegenüber uniformen teils Vorteile bringen.
model = AutoModelForCausalLM.from_pretrained(
   base_model,
   quantization_config=quant_config,
   device_map="auto"
)
Dieser Schritt ähnelt dem ersten Download von XGen, diesmal übergeben wir jedoch die Quantisierungsparameter an quantization_config und setzen device_map auf auto, damit die GPU automatisch genutzt wird.
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"
Nach dem Laden konfigurieren wir die Padding-Parameter. Padding-Tokens sind spezielle Platzhalter ohne Bedeutung; sie sorgen dafür, dass alle Sequenzen die gleiche Länge haben – häufig eine Voraussetzung für NLP-Architekturen.
tokenizer.pad_token = tokenizer.eos_token setzt das Padding-Token gleich dem End-of-Sentence-(EOS)-Token. So kann das Modell das Satzende und Padding unterscheiden. tokenizer.padding_side = "right" legt fest, dass rechts aufgefüllt wird.
peft_params = LoraConfig(
   lora_alpha=16,
   lora_dropout=0.1,
   r=64,
   bias="none",
   task_type="CAUSAL_LM",
)
Vortrainierte LLMs brauchen enorme Daten- und Rechenressourcen zur Feinabstimmung. Mit Parameter-Efficient Fine-Tuning (PEFT) stimmen wir nur einen Bruchteil der Gesamtparameter ab – das reduziert die Laufzeit deutlich. Mehr dazu in der offiziellen Doku.
Die Klasse LoraConfig setzt die Konfiguration für Low-Rank Adaptation. LoRA ist eine spezielle Parametrisierung innerhalb von PEFT. Insgesamt steuert das Snippet u. a. die Stärke der Anpassung der LoRA-Schichten und die Anzahl trainierbarer Parameter.
training_params = TrainingArguments(
   output_dir="./results",
   num_train_epochs=1,
   per_device_train_batch_size=1,
   gradient_accumulation_steps=1,
   optim="paged_adamw_32bit",
   learning_rate=2e-4,
   weight_decay=0.001,
   fp16=False,
   bf16=False,
   max_grad_norm=0.3,
   max_steps=-1,
   warmup_ratio=0.03,
   group_by_length=True,
   lr_scheduler_type="constant",
)
Zusätzlich benötigen wir eine Reihe weiterer Trainingsparameter. Dazu zählen bekannte Größen wie Learning Rate, Scheduler, Epochen, Optimizer – und neue wie warmup_ratio, fp16, bf16, weight_decay usw.
Um fokussiert zu bleiben, gehen wir nicht auf jedes Detail ein. Eine gute Einführung findest du im Artikel zum Fein-Tuning von LLaMA2.
Für die Feinabstimmung mit PEFT nutzen wir die Klasse SFTTrainer (Supervised Fine-Tuning) aus der trl-Library – ein Kernelement von RLHF.
trainer = SFTTrainer(
   model=model,
   train_dataset=dataset,
   peft_config=peft_params,
   dataset_text_field="text",
   max_seq_length=None,
   tokenizer=tokenizer,
   args=training_params,
   packing=False,
)
Zur Initialisierung übergeben wir Modell, Trainingsdatensatz, PEFT- und Trainingsparameter sowie den Tokenizer. Den Feinabstimmungsprozess startest du mit .train():
trainer.train()
Abhängig von den Trainingsparametern (insbesondere der Epochenzahl) dauert das Training von 15 Minuten bis zu mehreren Stunden.
Nach dem Training testen wir das feinabgestimmte Modell:
prompt = "Who wrote Python?"
pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, max_length=200)

result = pipe(f"<s>[INST] {prompt} [/INST]")
print(result[0]['generated_text'])
Bevor wir den Prompt an das feinabgestimmte model geben, erstellen wir eine pipeline mit model und tokenizer. Die Pipeline lädt das Modell, verarbeitet den Input mit dem Tokenizer und kann optional Post-Processing anwenden.
Oben nutzen wir einen speziell formatierten Prompt, um das Trainingsschema nachzubilden: <s>[INST] {prompt} [/INST]. Das Ergebnis sieht so aus:
<s>[INST] Who wrote Python? [/INST] Python was created by Guido van Rossum, a Dutch computer programmer. He started working on the language in the late 1980s and released the first version in 1991. </s>

Python is a high-level, general-purpose programming language that is widely used in various fields, including data science, machine learning, and web development. It is known for its readability, flexibility, and ease of use, making it a popular choice for beginners and experienced developers alike. </s>

Python is an open-source language, meaning that anyone can access and modify the source code, making it a popular choice for developers who want to contribute to the community. </s>...
Wenn du zufrieden bist, speicherst du das Ergebnis so:
trainer.model.save_pretrained(new_model)
trainer.tokenizer.save_pretrained(new_model)
Laden kannst du es später wieder mit AutoModelForCausalLM:
fine_tuned_xgen = AutoModelForCausalLM.from_pretrained(new_model, ...)
Mit Large Language Models (LLMs) wie XGen 7B von Salesforce zu starten, ist einfach – sie für spezifische Anforderungen anzupassen, deutlich anspruchsvoller. Unsere Feinabstimmung von XGen 7B auf einem kleinen Instruktionsdatensatz zeigt die Herausforderung: Für unterschiedliche Aufgaben brauchst du passende Datensätze (z. B. aus der Datasets-Library von Hugging Face) und Rechenressourcen, die das Training eines 7-Milliarden-Parameter-Modells überhaupt stemmen.
Der Feinabstimmungsprozess lässt sich auf diese Schritte verdichten:
bitsandbytes festlegentransformers definierenLoraConfig festlegentransformers setzenSFTTrainer aus trl feinabstimmenWenn dir einige Konzepte oder Codeschnipsel noch fremd vorkommen, helfen diese Ressourcen weiter:
Danke fürs Lesen!
Starte heute deine KI-Reise!
Kurs
Kurs
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleBlog
Hesam Sheikh Hassani
15 Min.
Blog
Nisha Arya Ahmed
15 Min.
Blog
Blog
Nathaniel Taylor-Leach
4 Min.
Blog
Nathaniel Taylor-Leach
8 Min.
Tutorial
Josef Waples
8 Min.