
course
Large Language Models (LLMs) कॉन्सेप्ट्स
2 घंटा
110.3K
इस समय, ये छह कुछ सबसे लोकप्रिय ओपन‑सोर्स LLMs हैं:
और सभी में एक ही कमी है — बहुत छोटी कॉन्टेक्स्ट लंबाई, जो अधिकतम 2048 टोकन तक ही पहुँचती है। स्वामित्व वाले मॉडलों जैसे GPT-3.5 और GPT-4 की तुलना में, जो 32k टोकन (लगभग 50 पेज के पाठ) तक की लंबाई देते हैं, ओपन‑सोर्स LLMs भारी पिछड़ते दिखते हैं।
कॉन्टेक्स्ट लंबाई मूल रूप से LLMs की “मेमोरी” है। 2048‑टोकन विंडो का मतलब है कि मॉडल एक समय में बातचीत के केवल 2048 टोकन ही “याद” रख सकता है। यह उन कार्यों में प्रदर्शन को काफी प्रभावित करता है, जहाँ बड़ा संदर्भ निर्णायक होता है — जैसे सारांशण, अनुवाद, कोड जनरेशन आदि।
इस अहम समस्या का समाधान करने के लिए, Salesforce ने XGen-7B मॉडल की घोषणा की, जिसमें 8k टोकन की शानदार कॉन्टेक्स्ट लंबाई है (अन्य समान LLMs से 4 गुना अधिक)। यह लेख मॉडल की प्रमुख विशेषताओं को कवर करता है और दिखाता है कि इसे एक सैंपल डेटासेट पर कैसे उपयोग और फाइन‑ट्यून किया जाए।
ज्यादातर लोगों के लिए, कॉन्टेक्स्ट लंबाई जैसी संख्याएँ तब तक मायने नहीं रखतीं, जब तक वे ठोस लाभों में अनुवाद न हो जाएँ। तो, यहाँ इसकी कुछ मुख्य विशेषताएँ और वे आपके प्रोजेक्ट्स पर क्या प्रभाव डाल सकती हैं:
सिर्फ 7 बिलियन पैरामीटर्स के अपेक्षाकृत छोटे आकार के बावजूद, XGen अपनी क्षमता से कहीं अधिक प्रदर्शन देता है — जो अक्सर कहीं बड़े मॉडलों के बराबर या बेहतर होता है। यह दक्षता डेवलपर्स और शोधकर्ताओं के लिए गेम‑चेंजर है, क्योंकि इससे हाई‑एंड लोकल मशीनों पर ही अत्याधुनिक AI एप्लिकेशन चलाना और तैनात करना संभव होता है, बिना बड़े क्लाउड संसाधनों पर निर्भर रहे। आकार और प्रदर्शन के इस संतुलन के कारण XGen स्टार्टअप्स से लेकर शैक्षणिक शोधकर्ताओं तक, व्यापक उपयोगकर्ता समूह के लिए खासा आकर्षक है।
विभिन्न उपयोगकर्ता आवश्यकताओं को समझते हुए, XGen तीन संस्करण प्रदान करता है, जो विशिष्ट अनुप्रयोगों के लिए उपयुक्त हैं:
मॉडल की वास्तविक ताकत बेंचमार्क में झलकती है। XGen समान आकार के मॉडलों की तुलना में MMLU, HumanEval आदि जैसे विविध बेंचमार्क पर शीर्ष पर रहता है। विस्तृत विश्लेषण के लिए, घोषणा पोस्ट XGen की बेंचमार्क उपलब्धियों का समग्र अवलोकन प्रदान करता है।
दोहराव का जोखिम लेते हुए, फिर भी कहना होगा कि XGen बड़े कॉन्टेक्स्ट विंडो की आवश्यकता वाले कार्यों के लिए अत्यधिक अनुकूलित है। यह क्षमता विस्तृत दस्तावेज़ सारांशण जैसे अनुप्रयोगों के लिए महत्वपूर्ण है, जहाँ पूरे पाठ को समझना सटीक सारांश बनाने के लिए ज़रूरी है। इसी तरह, व्यापक प्रश्न‑उत्तर और लम्बे‑फ़ॉर्म कंटेंट जनरेशन में, XGen की बड़ी मात्रा में जानकारी संसाधित करने की क्षमता अधिक सुसंगत, संदर्भानुकूल आउटपुट देती है।
तो, XGen ये प्रभावशाली नतीजे कैसे हासिल करता है? स्वाभाविक है, इसका उत्तर Salesforce के AI शोधकर्ताओं द्वारा अपनाए गए प्रशिक्षण और अनुकूलन तरीकों में निहित है।
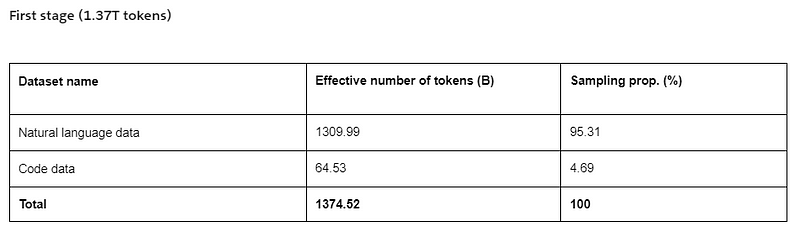
XGen की प्रशिक्षण रणनीति दो चरणों में बंटी है। स्टेज 1 में, एक नया मॉडल 1.37 ट्रिलियन टोकन पर प्रशिक्षित किया गया, जिसमें प्राकृतिक भाषा डेटा और कोड का मिश्रण शामिल था।
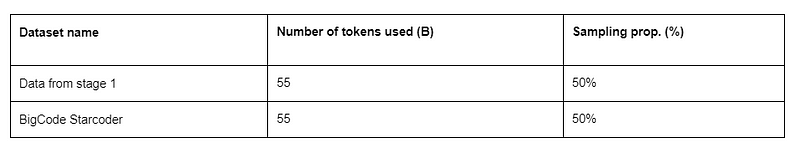
दूसरे चरण में, बेहतर कोड जनरेशन के लिए अतिरिक्त 55 बिलियन टोकन के कोड पर प्रशिक्षण किया गया:
प्रशिक्षण इन‑हाउस लाइब्रेरी JaxFormer का उपयोग करके किया गया, जिसे विशेष रूप से TPU‑v4 हार्डवेयर पर डेटा और मॉडल पैरेललाइज़ेशन के साथ कुशल LLM प्रशिक्षण के लिए डिज़ाइन किया गया है।
अपने छोटे आकार के बावजूद, न्यूरल नेटवर्क के लिहाज से XGen 7B अब भी काफ़ी बड़ा है। यदि आप इसे क्लाउड संसाधनों के बिना चलाना चाहते हैं, तो हाई‑एंड लोकल मशीनों की ज़रूरत होगी। प्राथमिक आवश्यकता पर्याप्त बड़ी RAM है — 32 GB से काफी अधिक — क्योंकि मॉडल को HuggingFace से डाउनलोड करने में ~30 GB लगता है। GPU के लिए, जितना बड़ा उतना बेहतर।
यदि आपके PC में ये स्पेक्स नहीं हैं, तो सबसे किफ़ायती विकल्प Colab Pro है, जो 40 GB RAM और 40GB GPU vRAM (A100s) के साथ आता है। इस ट्यूटोरियल के लिए, मैं Colab Pro का उपयोग कर रहा/रही हूँ:
संगत मशीन सेटअप करने के बाद, अब इंस्टॉल कर मॉडल डाउनलोड करने का समय है। यदि आप लोकली फॉलो कर रहे हैं, तो स्टेप 0 एक वर्चुअल एनवायरनमेंट बनाना है:
$ conda create -n xgen -y
$ conda activate xgen
HuggingFace से मॉडल डाउनलोड करने के लिए, यह आवश्यक है कि GPU‑सपोर्ट के साथ torch इंस्टॉल हो। सभी आवश्यक लाइब्रेरी इंस्टॉल करने के लिए कमांड यह है:
$ pip install torch torchvision torchaudio transformers[torch]
हमें बाद में फाइन‑ट्यूनिंग स्टेप के लिए ये लाइब्रेरी भी चाहिए होंगी:
$ pip install accelerate peft bitsandbytes trl datasets --upgrade
लाइब्रेरी इंस्टॉल करने के बाद कर्नेल रीस्टार्ट करना न भूलें।
उनके उपयोग पर पहुँचते ही मैं हर लाइब्रेरी को समझाऊँगा/समझाऊँगी।
अब, निम्नलिखित स्निपेट के साथ पहली बार मॉडल चलाते हैं।
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

tokenizer = AutoTokenizer.from_pretrained("Salesforce/xgen-7b-8k-base", trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained("Salesforce/xgen-7b-8k-base", torch_dtype=torch.bfloat16)

inputs = tokenizer("DataCamp is one he ...", return_tensors="pt")
sample = model.generate(**inputs, max_length=128)

print(tokenizer.decode(sample[0]))
AutoTokenizer क्लास 4098 लंबाई वाले मॉडल xgen-7b-4k-base के लिए ऑटो‑टोकनाइज़र लोड करता है। AutoModelForCausalLM क्लास टेक्स्ट जनरेशन के लिए मॉडल लोड करने हेतु है।
हम inputs के रूप में प्रॉम्प्ट दे रहे हैं और model.generate के अंदर उसे अनपैक कर 128 की अधिकतम टोकन लंबाई निर्दिष्ट कर रहे हैं। ऊपर का कोड पहली बार चलाते समय कुछ समय लेगा, क्योंकि मॉडल डाउनलोड होना है।
अंत में मुझे यह आउटपुट मिला:
DataCamp is one of the world’s leading providers of data science courses and training...प्रतिक्रिया की शुरुआत ठीक है, लेकिन अंत की ओर धीरे‑धीरे गिरावट आती है। बेहतर प्रदर्शन के लिए हमें इसे ट्यून करना होगा।
LLMs sklearn मॉडलों जैसे नहीं होते — जिन्हें कुछ पंक्तियों के कोड में हाइपरपैरामीटर ट्यून कर लें। इसलिए, हम XGen 7B को कई चरणों में फाइन‑ट्यून करेंगे। मैं सुझाव दूँगा/दूँगी कि आप हर स्टेप ध्यान से लें, क्योंकि काफ़ी विवरण होंगे।
ध्यान दें कि नीचे बताया गया वर्कफ़्लो HuggingFace पर मौजूद कई LLMs के साथ काम करेगा, बशर्ते आपके पास पर्याप्त कंप्यूट पावर हो।
चलिए शुरू करते हैं।
हम यह चरण पहले कवर कर चुके हैं। तो, आइए इंस्टॉल की गई लाइब्रेरी और उनकी ज़रूरत का संक्षिप्त पुनरावलोकन करें:
torch: टेंसर और न्यूरल नेटवर्क के लिए PyTorch लाइब्रेरी; GPU एक्सेलरेशन सक्षम करती है।transformers: Hugging Face की प्री‑ट्रेन NLP मॉडलों की लाइब्रेरी।datasets: HuggingFace डेटासेट्स के साथ आसान डेटा लोडिंग और प्रोसेसिंग।accelerate: HuggingFace की आधिकारिक लाइब्रेरी, LLMs के डिस्ट्रिब्यूटेड ट्रेनिंग को सरल बनाती है।peft: LLM पैरामीटर्स के छोटे हिस्से को फाइन‑ट्यून करने का पैकेज, जिससे प्रशिक्षण तेज़ होता है।bitsandbytes: मेमोरी और कम्प्यूटेशनल दक्षता के लिहाज़ से LLMs के लिए ऑप्टिमाइज़ेशन लाइब्रेरी।trl: RLHF (मानव फ़ीडबैक के साथ रिइनफोर्समेंट लर्निंग) से बड़े मॉडलों को फाइन‑ट्यून करने की तकनीकें।हम उनके उपयोग पर पहुँचते ही हर लाइब्रेरी के फ़ायदे समझाएँगे।
import os
import torch

from datasets import load_dataset
from transformers import (
   AutoModelForCausalLM,
   AutoTokenizer,
   BitsAndBytesConfig,
   TrainingArguments,
   pipeline,
)

from peft import LoraConfig
from trl import SFTTrainer
यहाँ हम जिन नई क्लासों और फ़ंक्शनों को आयात कर रहे हैं, उनका एक अवलोकन है:
BitsAndBytesConfig: बिट्स‑एंड‑बाइट्स तकनीकों से मॉडल पैरामीटर्स को ऑप्टिमाइज़ करने की कॉन्फ़िगरेशन, जिससे मेमोरी और गणना दक्षता बढ़ती है।TrainingArguments: फाइन‑ट्यूनिंग के लिए प्रशिक्षण पैरामीटर्स (जैसे लर्निंग रेट, बैच साइज) निर्दिष्ट करता है।pipeline: टेक्स्ट जनरेशन जैसी टास्क पर मॉडल लागू करना सरल बनाता है।LoraConfig: LoRA (Low‑Rank Adaptation) के लिए कॉन्फ़िगरेशन — एक पैरामीटर‑इफीशिएंट फाइन‑ट्यूनिंग विधि जो मॉडल को अपनाने हेतु पैरामीटर्स के छोटे सेट को समायोजित करती है।SFTTrainer: सुपरवाइज़्ड फाइन‑ट्यूनिंग (SFT) के लिए ट्रेनर क्लास, जो मानव फ़ीडबैक या लेबल्ड डेटासेट के साथ प्रशिक्षण को सुगम बनाती है।# Model from HF
base_model = "Salesforce/xgen-7b-8k-base"
# New instruction dataset
guanaco_dataset = "mlabonne/guanaco-llama2-1k"
# Fine-tuned model
new_model = "xgen-7b-8k-tuned"
डेटासेट के लिए, हम Guanaco LLaMA2 डेटासेट का उपयोग करेंगे, जिसमें 1000 इंस्ट्रक्शन‑आउटपुट पेयर्स हैं, ताकि LLMs को इंटरएक्टिव और इंस्ट्रक्शनल टास्क (जैसे चैटबॉट्स) के लिए ट्यून किया जा सके।
dataset = load_dataset(guanaco_dataset, split="train")HuggingFace से डेटा लोड करने के लिए, हम load_dataset फ़ंक्शन का उपयोग करते हैं, जिसमें डेटासेट का पाथ और स्प्लिट निर्दिष्ट करते हैं। हम डेटासेट के नमूने टेक्स्ट फ़ॉर्मेट में बदलकर और कोई रैंडम इंस्ट्रक्शन‑आउटपुट पेयर इंडेक्स करके देख सकते हैं:
>>> dataset["text"][89]

<s>[INST] In England, what vegetable is referred to as a rocket? [/INST] The species name for "rocket" is "Eruca vesicaria", and it's also sometimes called "eruca".
However, other countries have different names for it:
* Arugula - America
* Garden Rocket or Rocket - Britain, Australia, South Africa, Ireland, New Zealand

Other names include "ruchetta", "rucola", "rucoli", "rugula", "colewoort", and "roquette".

The word transferred from Latin to Italian to English, which might explain the variants with similar pronunciation. </s>
क्वांटाइज़ेशन मशीन लर्निंग में डेटा को दर्शाने के लिए प्रयुक्त बिट्स की संख्या घटाने की एक शक्तिशाली तकनीक है। यह मूल डेटा को कम बिट्स में अनुमानित करके किया जाता है, जिससे अधिक कॉम्पैक्ट प्रतिनिधित्व मिलता है।
क्वांटाइज़ेशन से मॉडल का मेमोरी फ़ुटप्रिंट घटाया जा सकता है, कम्प्यूटेशनल दक्षता सुधरती है और कभी‑कभी शुद्धता भी बेहतर होती है।
compute_dtype = torch.float16

quant_config = BitsAndBytesConfig(
   load_in_4bit=True,
   bnb_4bit_quant_type="nf4",
   bnb_4bit_compute_dtype=compute_dta
पहले हम compute_dtype को float16 पर सेट कर हर टेंसर के लिए डेटा टाइप तय करते हैं। फिर BitsAndBytesConfig के जरिए निम्न क्वांटाइज़ेशन पैरामीटर्स परिभाषित करते हैं:
load_in_4bit=True: यह बताता है कि इनपुट डेटा 4 बिट्स में क्वांटाइज़ होगा।bnb_4bit_compute_dtype=compute_dtype: गणनाओं के लिए प्रयुक्त डेटा टाइप निर्दिष्ट करता है, जो ऊपर सेट float16 है।bnb_4bit_quant_type="nf4": 4‑बिट क्वांटाइज़ेशन का प्रकार बताता है, यहाँ "nf4"।nf4 एक विशिष्ट प्रकार का क्वांटाइज़ेशन है जो 4 बिट्स के साथ नॉन‑यूनिफ़ॉर्म क्वांटाइज़ेशन का उपयोग करता है। कुछ स्थितियों में नॉन‑यूनिफ़ॉर्म, साधारण यूनिफ़ॉर्म से बेहतर हो सकता है।
model = AutoModelForCausalLM.from_pretrained(
   base_model,
   quantization_config=quant_config,
   device_map="auto"
)
यह चरण XGen को प्रारंभिक बार डाउनलोड करने जैसा ही है, पर इस बार हम quantization_config में क्वांटाइज़ेशन पैरामीटर्स पास कर रहे हैं और device_map को auto पर सेट कर रहे हैं, ताकि GPU स्वतः उपयोग हो।
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"
टोकनाइज़र लोड करने के बाद, हम पैडेड टोकन पैरामीटर्स कॉन्फ़िगर करते हैं। NLP में, पैडेड टोकन ऐसे विशेष प्रतीक होते हैं जिनका अर्थ नहीं होता, और उन्हें प्रत्येक इनपुट में जोड़ा जाता है ताकि सभी टोकन समान आकार के हों। स्थिर आकार के टोकन कई NLP आर्किटेक्चर्स की आवश्यकता होते हैं।
tokenizer.pad_token = tokenizer.eos_token टोकनाइज़र के पैडिंग टोकन को वाक्य‑समाप्ति (EOS) टोकन के समान सेट करता है। यह NLP में आम प्रचलन है, क्योंकि इससे मॉडल वाक्य के अंत और पैडेड टोकन के बीच भेद कर सकता है। tokenizer.padding_side = "right" बताता है कि पैडिंग इनपुट सीक्वेंस के दाएँ ओर जोड़ी जाए।
peft_params = LoraConfig(
   lora_alpha=16,
   lora_dropout=0.1,
   r=64,
   bias="none",
   task_type="CAUSAL_LM",
)
प्री‑ट्रेन LLMs को फाइन‑ट्यून करने के लिए बहुत अधिक डेटा और कम्प्यूट संसाधनों की ज़रूरत होती है। Parameter‑efficient Fine‑tuning (PEFT) का उपयोग करके, हम कुल मॉडल पैरामीटर्स के केवल एक हिस्से को फाइन‑ट्यून करते हैं, जिससे रनटाइम में उल्लेखनीय कमी आती है। इस तकनीक के बारे में अधिक जानकारी आधिकारिक दस्तावेज़ से पढ़ सकते हैं।
LoraConfig क्लास LoRA (Low‑Rank Adaptation) विधि की कॉन्फ़िगरेशन सेट करती है। LoRA, PEFT में उपयोग होने वाला एक विशिष्ट पैरामीटराइज़ेशन है। समग्र रूप से, ऊपर दिया गया स्निपेट LoRA लेयर्स की अनुकूलन‑ताकत, प्रशिक्षित किए जाने वाले पैरामीटर्स की संख्या और लेयर्स के अन्य पहलुओं को नियंत्रित करता है।
training_params = TrainingArguments(
   output_dir="./results",
   num_train_epochs=1,
   per_device_train_batch_size=1,
   gradient_accumulation_steps=1,
   optim="paged_adamw_32bit",
   learning_rate=2e-4,
   weight_decay=0.001,
   fp16=False,
   bf16=False,
   max_grad_norm=0.3,
   max_steps=-1,
   warmup_ratio=0.03,
   group_by_length=True,
   lr_scheduler_type="constant",
)
अब तक परिभाषित सभी चीज़ों के अलावा, XGen को फाइन‑ट्यून करने के लिए लगभग दर्जनभर और प्रशिक्षण पैरामीटर्स चाहिए। इनमें परिचित पैरामीटर्स जैसे लर्निंग रेट, लर्निंग रेट शेड्यूलर्स, epochs की संख्या, ऑप्टिमाइज़र शामिल हैं, और कुछ नए जैसे warmup_ratio, fp16, bf16, weight_decay आदि।
फ़ोकस बनाए रखने के लिए, हम इन सभी पैरामीटर्स का विवरण यहाँ नहीं कवर करेंगे — इनके लिए मैं आपको LLaMA2 फाइन‑ट्यूनिंग पर इस उत्कृष्ट लेख की ओर संदर्भित करता/करती हूँ।
PEFT मॉडल को फाइन‑ट्यून करने के लिए, हम trl लाइब्रेरी की SFTTrainer (Supervised fine‑tuning) क्लास का उपयोग करेंगे, जो RLHF का एक प्रमुख चरण है।
trainer = SFTTrainer(
   model=model,
   train_dataset=dataset,
   peft_config=peft_params,
   dataset_text_field="text",
   max_seq_length=None,
   tokenizer=tokenizer,
   args=training_params,
   packing=False,
)
ट्रेनर को प्रारंभ करने के लिए, हम उसे मॉडल, प्रशिक्षण डेटासेट, PEFT पैरामीटर्स, प्रशिक्षण पैरामीटर्स और टोकनाइज़र देते हैं। फाइन‑ट्यूनिंग प्रक्रिया शुरू करने के लिए, बस .train() कॉल करना है:
trainer.train()
प्रशिक्षण पैरामीटर्स (विशेषकर epochs की संख्या) पर निर्भर करते हुए, प्रशिक्षण 15 मिनट से लेकर कई घंटों तक ले सकता है।
प्रशिक्षण पूरा होने पर, हम अपने फाइन‑ट्यून किए गए मॉडल का परीक्षण कर सकते हैं:
prompt = "Who wrote Python?"
pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, max_length=200)

result = pipe(f"<s>[INST] {prompt} [/INST]")
print(result[0]['generated_text'])
प्रॉम्प्ट को फाइन‑ट्यून किए गए model को देने से पहले, हम पहले model और tokenizer को pipeline में पास करते हैं। pipeline फ़ंक्शन प्री‑ट्रेन मॉडल लोड करने, टोकनाइज़र के साथ इनपुट को प्री‑प्रोसेस करने और यदि कोई हों तो जेनरेट किए गए टेक्स्ट पर कस्टम पोस्ट‑प्रोसेसिंग स्टेप लागू करने के काम आता है।
ऊपर, हम पाइपलाइन को विशेष रूप से फ़ॉर्मैट किए गए प्रॉम्प्ट के साथ चला रहे हैं, जिसे <s>[INST] {prompt} [/INST] में रैप किया गया है — ठीक वैसे ही जैसे प्रशिक्षण के दौरान निर्देश थे। परिणाम यह है:
<s>[INST] Who wrote Python? [/INST] Python was created by Guido van Rossum, a Dutch computer programmer. He started working on the language in the late 1980s and released the first version in 1991. </s>

Python is a high-level, general-purpose programming language that is widely used in various fields, including data science, machine learning, and web development. It is known for its readability, flexibility, and ease of use, making it a popular choice for beginners and experienced developers alike. </s>

Python is an open-source language, meaning that anyone can access and modify the source code, making it a popular choice for developers who want to contribute to the community. </s>...
जब हम अपने मॉडल से संतुष्ट हों, तो अंततः इसे सहेजा जा सकता है:
trainer.model.save_pretrained(new_model)
trainer.tokenizer.save_pretrained(new_model)
आप इसे फिर से AutoModelForCausalLM क्लास के जरिए लोड कर सकते हैं:
fine_tuned_xgen = AutoModelForCausalLM.from_pretrained(new_model, ...)
Salesforce के XGen 7B जैसे बड़े भाषा मॉडल (LLMs) के साथ शुरुआत करना आसान है, लेकिन उन्हें विशिष्ट आवश्यकताओं के अनुरूप बनाना अधिक जटिल है। छोटे इंस्ट्रक्शनल डेटासेट पर XGen 7B को फाइन‑ट्यून करने का हमारा अनुभव इसी चुनौती को दर्शाता है। विभिन्न कार्यों के लिए मॉडल को अनुकूलित करने हेतु प्रासंगिक डेटासेट्स (Hugging Face की datasets लाइब्रेरी के माध्यम से उपलब्ध) और ऐसे कम्प्यूट संसाधनों की आवश्यकता होती है जो 7 बिलियन पैरामीटर्स वाले मॉडल को उन डेटासेट्स पर प्रशिक्षित कर सकें।
फाइन‑ट्यूनिंग प्रक्रिया को निम्न चरणों में संक्षेपित किया जा सकता है:
bitsandbytes के साथ क्वांटाइज़ेशन पैरामीटर्स परिभाषित करनाtransformers के जरिए मॉडल और उसके इनिट पैरामीटर्स परिभाषित करनाLoraConfig के साथ LoRA लेयर्स के रूप में PEFT पैरामीटर्स परिभाषित करनाtransformers के जरिए प्रशिक्षण पैरामीटर्स सेट करनाtrl के SFTTrainer से मॉडल ट्यून करनायदि कुछ अवधारणाएँ या कोड स्निपेट अब भी अपरिचित या धुँधले लगते हैं, तो मैं इन उत्कृष्ट संसाधनों की अनुशंसा करता/करती हूँ:
पढ़ने के लिए धन्यवाद!
आज ही अपनी AI यात्रा शुरू करें!
course
course
course