
Last chance! 50% off DataCamp Premium
Sale ends in
Op dit moment zijn dit zes van de heetste open-source LLM’s:
En ze hebben allemaal hetzelfde nadeel: een erg korte contextlengte, tot slechts 2048 tokens. In vergelijking met propriëtaire modellen zoals GPT-3.5 en GPT-4, die lengtes tot 32k tokens bieden (50 pagina’s tekst!), lijkt het alsof open-source LLM’s op een flinke achterstand staan.
Contextlengte is in feite het “geheugen” van LLM’s. Een contextvenster van 2048 tokens betekent dat het model slechts 2048 tokens van het gesprek tegelijk kan onthouden. Dit beïnvloedt de prestaties aanzienlijk bij taken waarbij een grote context cruciaal is, zoals samenvatten, vertalen, codegeneratie, enzovoort.
Om dit cruciale probleem aan te pakken, kondigde Salesforce zijn XGen-7B-model aan met een verbazingwekkende contextlengte van 8k tokens (vier keer langer dan andere vergelijkbare LLM’s). Dit artikel behandelt de belangrijkste kenmerken van het model en laat zien hoe je het kunt gebruiken en fine-tunen op een voorbeelddataset.
Voor de meeste mensen zeggen statistieken zoals contextlengte weinig totdat ze worden vertaald naar tastbare voordelen. Hier zijn daarom enkele van de belangrijkste features en de impact die ze kunnen hebben op je eigen projecten:
Ondanks zijn relatief kleine omvang van 7 miljard parameters slaat XGen boven zijn gewichtsklasse: het levert prestaties die vergelijkbaar zijn met of beter zijn dan die van veel grotere modellen. Deze efficiëntie is een gamechanger voor developers en onderzoekers: je kunt geavanceerde AI-toepassingen rechtstreeks op high-end lokale machines draaien en uitrollen, zonder toegang tot enorme cloudresources. Deze balans tussen grootte en performance maakt XGen bijzonder aantrekkelijk voor een breed publiek, van kleine startups tot academische onderzoekers.
Omdat gebruikers verschillende behoeften hebben, biedt XGen drie versies, elk geschikt voor specifieke toepassingen:
De echte kracht van het model blijkt uit de benchmarks. XGen komt als beste uit de bus op uiteenlopende benchmarks zoals MMLU, HumanEval, enzovoort, vergeleken met modellen van vergelijkbare grootte. Voor een diepgaande analyse biedt de aankondigingspost een uitgebreid overzicht van XGen’s prestaties over benchmarks heen.
Met het risico in herhaling te vallen: XGen is sterk geoptimaliseerd voor taken die grote contextvensters vereisen. Deze capaciteit is cruciaal voor toepassingen zoals gedetailleerde documentsamenvattingen, waar begrip van de hele tekst belangrijk is om accurate samenvattingen te genereren. Evenzo leidt XGen’s vermogen om grote hoeveelheden informatie te verwerken bij uitgebreide vraag–antwoordtaken en long-form contentgeneratie tot samenhangendere, contextueel relevantere output.
Hoe behaalt XGen deze indrukwekkende resultaten? Het antwoord ligt uiteraard in de trainings- en optimalisatiemethoden die de AI-onderzoekers van Salesforce hebben gebruikt.
De trainingsstrategie van XGen bestaat uit twee fasen. In fase 1 wordt een vers model getraind op 1,37 biljoen tokens, met een mix van natuurlijke taaldata en code.
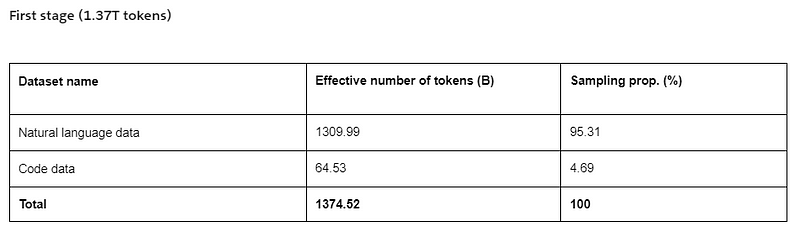
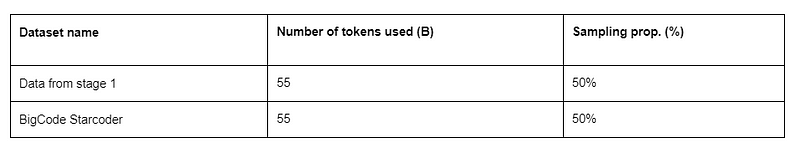
In fase twee werden nog eens 55 miljard tokens aan code gebruikt om betere codegeneratie te trainen:
De training is uitgevoerd met een interne bibliotheek genaamd JaxFormer, speciaal ontworpen voor efficiënte LLM-training met zowel data- als modelparallelisatie op TPU-v4-hardware.
Ondanks zijn kleine formaat is XGen 7B nog steeds behoorlijk groot als neuraal netwerk. Als je het zonder cloudresources wilt draaien, heb je high-end lokale machines nodig. De belangrijkste vereiste is voldoende grote RAM, ruim boven de 32 GB, aangezien het model ~30 GB is om te downloaden van HuggingFace. Voor GPU’s geldt: hoe groter, hoe beter.
Als je pc deze specs niet heeft, is de goedkoopste optie Colab Pro, met 40 GB RAM en 40 GB GPU vRAM (A100’s). Voor deze tutorial gebruik ik Colab Pro:
Na het opzetten van een compatibele machine is het tijd om het model te installeren en te downloaden. Volg je lokaal mee, dan is stap 0 het aanmaken van een virtual environment:
$ conda create -n xgen -y
$ conda activate xgen
Om het model van HuggingFace te downloaden, is het vereist dat torch met GPU-ondersteuning is geïnstalleerd. Dit is het commando om alle vereiste libraries te installeren:
$ pip install torch torchvision torchaudio transformers[torch]
Voor de fine-tuningstap later hebben we ook de volgende libraries nodig:
$ pip install accelerate peft bitsandbytes trl datasets --upgrade
Vergeet niet de kernel te herstarten na het installeren van de libraries.
Ik leg elke library uit zodra we bij dat onderdeel komen.
Laten we het model nu voor het eerst draaien met het volgende snippet.
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

tokenizer = AutoTokenizer.from_pretrained("Salesforce/xgen-7b-8k-base", trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained("Salesforce/xgen-7b-8k-base", torch_dtype=torch.bfloat16)

inputs = tokenizer("DataCamp is one he ...", return_tensors="pt")
sample = model.generate(**inputs, max_length=128)

print(tokenizer.decode(sample[0]))
De klasse AutoTokenizer laadt de auto-tokenizer voor het 4098-lengte model xgen-7b-4k-base. De klasse AutoModelForCausalLM wordt gebruikt om modellen voor tekstgeneratie te laden.
We specificeren de prompt als inputs en pakken die uit in model.generate met een maximale tokenlengte van 128. De bovenstaande code duurt even bij de eerste run omdat het model gedownload moet worden.
Dit was uiteindelijk mijn output:
DataCamp is one of the world’s leading providers of data science courses and training...Het begin van het antwoord is prima, maar richting het einde gaat het langzaam achteruit. We moeten fine-tunen voor betere prestaties.
LLM’s zijn niet zoals sklearn-modellen – je kunt hun hyperparameters niet even in een paar regels code afstellen. We gaan XGen 7B dus in meerdere stappen fine-tunen. Ik raad je aan om elke stap rustig te doorlopen; er komt veel detail voorbij.
Let op: de workflow hieronder werkt voor veel LLM’s op HuggingFace, zolang je genoeg rekenkracht hebt.
Laten we beginnen.
Deze stap hebben we eerder al doorlopen. Laten we de geïnstalleerde libraries en hun nut kort herzien:
torch: PyTorch-bibliotheek voor tensors en neurale netwerken; maakt GPU-versnelling mogelijk.transformers: Hugging Face-bibliotheek voor voorgetrainde NLP-modellen.datasets: Voor eenvoudig laden en verwerken van data met HuggingFace-datasets.accelerate: Officiële HuggingFace-library om gedistribueerde training van LLM’s te vereenvoudigen.peft: een pakket om slechts een fractie van de LLM-parameters te fine-tunen en zo training te versnellen.bitsandbytes: optimalisatiebibliotheek voor LLM’s qua geheugen- en rekenefficiëntie.trl: Technieken om grote modellen te fine-tunen met RLHF (reinforcement learning met menselijke feedback).We leggen de voordelen van elke library uit zodra we ze gebruiken.
import os
import torch

from datasets import load_dataset
from transformers import (
   AutoModelForCausalLM,
   AutoTokenizer,
   BitsAndBytesConfig,
   TrainingArguments,
   pipeline,
)

from peft import LoraConfig
from trl import SFTTrainer
Hier is een overzicht van de nieuwe klassen en functies die we importeren:
BitsAndBytesConfig: Configuratie om modelparameters te optimaliseren met bits-and-bytes-technieken voor betere geheugen- en rekenefficiëntie.TrainingArguments: Specificeert trainingsparameters (bijv. learning rate, batchgrootte) voor fine-tunen.pipeline: Vereenvoudigt het toepassen van modellen op taken zoals tekstgeneratie.LoraConfig: Configuratie voor het toepassen van LoRA (Low-Rank Adaptation), een parameter-efficiënte fine-tuningmethode die een kleine set parameters aanpast om het model te laten aansluiten.SFTTrainer: Trainerklasse voor Supervised Fine-Tuning (SFT), die het trainingsproces met menselijke feedback of gelabelde datasets faciliteert.# Model from HF
base_model = "Salesforce/xgen-7b-8k-base"
# New instruction dataset
guanaco_dataset = "mlabonne/guanaco-llama2-1k"
# Fine-tuned model
new_model = "xgen-7b-8k-tuned"
Voor de dataset gebruiken we de Guanaco LLaMA2-dataset, die 1000 instructie–antwoordparen bevat om LLM’s te tunen voor interactieve en instructietaken (denk aan chatbots).
dataset = load_dataset(guanaco_dataset, split="train")Om de data van HuggingFace te laden, gebruiken we de functie load_dataset met het pad en de split van de dataset. We kunnen voorbeelden bekijken door deze naar tekst te converteren en een willekeurig instructie–antwoordpaar te indexeren:
>>> dataset["text"][89]

<s>[INST] In England, what vegetable is referred to as a rocket? [/INST] The species name for "rocket" is "Eruca vesicaria", and it's also sometimes called "eruca".
However, other countries have different names for it:
* Arugula - America
* Garden Rocket or Rocket - Britain, Australia, South Africa, Ireland, New Zealand

Other names include "ruchetta", "rucola", "rucoli", "rugula", "colewoort", and "roquette".

The word transferred from Latin to Italian to English, which might explain the variants with similar pronunciation. </s>
Kwantisatie is een krachtige techniek in machine learning om het aantal bits dat nodig is om data te representeren te verminderen. Dit gebeurt door de originele data te benaderen met een kleiner aantal bits, wat resulteert in een compactere representatie.
Kwantisatie kan worden gebruikt om de geheugendruk van een model te verlagen, de rekenefficiëntie te verbeteren en soms zelfs de nauwkeurigheid te verhogen.
compute_dtype = torch.float16

quant_config = BitsAndBytesConfig(
   load_in_4bit=True,
   bnb_4bit_quant_type="nf4",
   bnb_4bit_compute_dtype=compute_dta
Eerst stellen we met compute_dtype het datatype voor elke tensor in op float16. Vervolgens definiëren we met BitsAndBytesConfig de volgende kwantisatieparameters:
load_in_4bit=True: Hiermee wordt aangegeven dat de invoerdata naar 4 bits wordt gekwantiseerd.bnb_4bit_compute_dtype=compute_dtype: Hiermee geef je het datatype voor berekeningen op; dit staat ingesteld op het eerder opgehaalde float16.bnb_4bit_quant_type="nf4": Dit specificeert het kwantisatietype voor 4-bit-kwantisatie, in dit geval "nf4".nf4 verwijst naar een specifiek type niet-uniforme 4-bit-kwantisatie. Niet-uniforme kwantisatie kan soms beter presteren dan eenvoudige uniforme kwantisatie.
model = AutoModelForCausalLM.from_pretrained(
   base_model,
   quantization_config=quant_config,
   device_map="auto"
)
Deze stap lijkt op onze initiële download van XGen, maar dit keer geven we de kwantisatieparameters mee aan quantization_config en zetten we device_map op auto zodat de GPU automatisch wordt gebruikt.
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"
Nadat we de tokenizer hebben geladen, configureren we de parameters voor paddingtokens. In NLP zijn paddingtokens speciale symbolen zonder betekenis die aan elke invoersequentie worden toegevoegd, zodat alle tokens dezelfde lengte hebben. Tokens met vaste lengte zijn een vereiste voor veel modelarchitecturen in NLP.
tokenizer.pad_token = tokenizer.eos_token stelt het paddingtoken van de tokenizer gelijk aan het end-of-sentence (EOS)-token. Dit is gangbaar in NLP, omdat het het model helpt onderscheid te maken tussen het einde van een zin en padding. tokenizer.padding_side = "right" geeft aan dat padding aan de rechterkant van de inputsequenties moet worden toegevoegd.
peft_params = LoraConfig(
   lora_alpha=16,
   lora_dropout=0.1,
   r=64,
   bias="none",
   task_type="CAUSAL_LM",
)
Voorgetrainde LLM’s vereisen enorme hoeveelheden data en rekenkracht om te fine-tunen. Met Parameter-Efficient Fine-Tuning (PEFT) kunnen we slechts een fractie van de totale modelparameters fine-tunen, wat de doorlooptijd aanzienlijk verkort. Meer over deze techniek lees je in de officiële documentatie.
De klasse LoraConfig stelt de configuratie in van de Low-Rank Adaptation-methode. LoRA is een specifiek type parameterisatie binnen PEFT. Al met al stuurt de bovenstaande code de sterkte van de aanpassing van LoRA-lagen, het aantal trainbare parameters en andere aspecten van de lagen aan.
training_params = TrainingArguments(
   output_dir="./results",
   num_train_epochs=1,
   per_device_train_batch_size=1,
   gradient_accumulation_steps=1,
   optim="paged_adamw_32bit",
   learning_rate=2e-4,
   weight_decay=0.001,
   fp16=False,
   bf16=False,
   max_grad_norm=0.3,
   max_steps=-1,
   warmup_ratio=0.03,
   group_by_length=True,
   lr_scheduler_type="constant",
)
Naast alles wat we al hebben gedefinieerd, vereist het fine-tunen van XGen nog een dozijn extra trainingsparameters. Daaronder bekende parameters zoals learning rate, learning-rateplanners, aantal epochs, optimizers, en enkele nieuwe zoals warmup_ratio, fp16, bf16, weight_decay, enzovoort.
Om gefocust te blijven, behandelen we niet alles in detail. Zie hiervoor dit uitstekende artikel over het fine-tunen van LLaMA2, waarin ze worden uitgelegd.
Om een PEFT-model te fine-tunen, gebruiken we de klasse SFTTrainer (Supervised fine-tuning) uit de library trl, een kernstap binnen RLHF.
trainer = SFTTrainer(
   model=model,
   train_dataset=dataset,
   peft_config=peft_params,
   dataset_text_field="text",
   max_seq_length=None,
   tokenizer=tokenizer,
   args=training_params,
   packing=False,
)
Om de trainer te initialiseren, geven we het model, de trainingsdataset, de PEFT-parameters, de trainingsparameters en de tokenizer door. Om het fine-tuningproces te starten, hoeven we alleen .train() aan te roepen:
trainer.train()
Afhankelijk van de trainingsparameters (vooral het aantal epochs) kan de training 15 minuten tot enkele uren duren.
Zodra de training klaar is, kunnen we ons gefinetunede model testen:
prompt = "Who wrote Python?"
pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, max_length=200)

result = pipe(f"<s>[INST] {prompt} [/INST]")
print(result[0]['generated_text'])
Voordat we de prompt aan het gefinetunede model doorgeven, geven we eerst het model en de tokenizer door aan een pipeline. De pipelinefunctie wordt gebruikt om voorgetrainde modellen te laden, de input met de tokenizer voor te verwerken en (indien van toepassing) aangepaste post-processingstappen op de gegenereerde tekst toe te passen.
Hierboven draaien we de pipeline met een speciaal geformatteerde prompt, omwikkeld met <s>[INST] {prompt} [/INST], precies zoals de instructies tijdens training. Dit is het resultaat:
<s>[INST] Who wrote Python? [/INST] Python was created by Guido van Rossum, a Dutch computer programmer. He started working on the language in the late 1980s and released the first version in 1991. </s>

Python is a high-level, general-purpose programming language that is widely used in various fields, including data science, machine learning, and web development. It is known for its readability, flexibility, and ease of use, making it a popular choice for beginners and experienced developers alike. </s>

Python is an open-source language, meaning that anyone can access and modify the source code, making it a popular choice for developers who want to contribute to the community. </s>...
Als we tevreden zijn met ons model, kunnen we het opslaan:
trainer.model.save_pretrained(new_model)
trainer.tokenizer.save_pretrained(new_model)
Je kunt het later opnieuw laden met de klasse AutoModelForCausalLM:
fine_tuned_xgen = AutoModelForCausalLM.from_pretrained(new_model, ...)
Aan de slag gaan met Large Language Models (LLM’s) zoals Salesforce’s XGen 7B is eenvoudig, maar ze aanpassen aan specifieke behoeften is complexer. Onze ervaring met het fine-tunen van XGen 7B op een kleine instructiedataset illustreert die uitdaging. Het model voor uiteenlopende taken aanpassen vereist toegang tot relevante datasets (beschikbaar via de datasets-bibliotheek van Hugging Face) en rekenresources die de training van een model met 7 miljard parameters over die datasets aankunnen.
Het fine-tuningproces is samen te vatten in de volgende stappen:
bitsandbytestransformersLoraConfigtransformersSFTTrainer uit trlAls bepaalde concepten of codefragmenten nog onwennig of vaag aanvoelen, raad ik deze uitstekende bronnen aan:
Bedankt voor het lezen!
Begin vandaag aan je AI-reis!
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min


