Lewati ke konten utama

Menjelajahi BLOOM: Panduan Komprehensif untuk Model Bahasa Besar Multibahasa

Telusuri BLOOM, model bahasa besar multibahasa, mencakup proses pembuatannya, spesifikasi teknis, penggunaan, dan aspek etika untuk mendemokratisasi AI.
Diperbarui 31 Agu 2026  · 13 mnt baca

Jelajahi dengan AI

ChatGPTClaudePerplexity

Kebangkitan model bahasa besar (LLM) telah menjadi tren penentu dalam ranah Pemrosesan Bahasa Alami (NLP), mendorong adopsi luas di berbagai aplikasi. Namun, kemajuan ini kerap bersifat eksklusif, karena sebagian besar LLM yang dikembangkan oleh organisasi dengan sumber daya besar tetap tidak dapat diakses publik.

Eksklusivitas ini menimbulkan pertanyaan penting: Bagaimana jika ada cara untuk mendemokratisasi akses ke model bahasa yang kuat ini? Di sinilah BLOOM hadir.

Artikel ini memberikan gambaran lengkap tentang apa itu BLOOM dengan terlebih dahulu membahas asal-usulnya. Lalu, mengulas spesifikasi teknis BLOOM dan cara menggunakannya, sebelum menyoroti keterbatasan serta pertimbangan etikanya.

Apa itu BLOOM?

BigScience Large Open-science Open-access Multilingual Language Model (disingkat BLOOM), mewakili kemajuan besar dalam upaya mendemokratisasi teknologi model bahasa.

Dikembangkan secara kolaboratif oleh lebih dari 1.200 peserta dari 39 negara, termasuk sejumlah besar dari Amerika Serikat, BLOOM adalah hasil upaya global. Dikoordinasikan oleh BigScience bekerja sama dengan Hugging Face dan komunitas NLP Prancis, proyek ini melampaui batas geografis dan institusional.

Ini adalah model open-source dan transformer hanya-decoder dengan 176 miliar parameter yang dilatih pada korpus ROOTS, yaitu himpunan data dari ratusan sumber dalam 59 bahasa: 46 bahasa tutur dan 13 bahasa pemrograman.

Di bawah ini adalah bagan pai distribusi bahasa pelatihan.
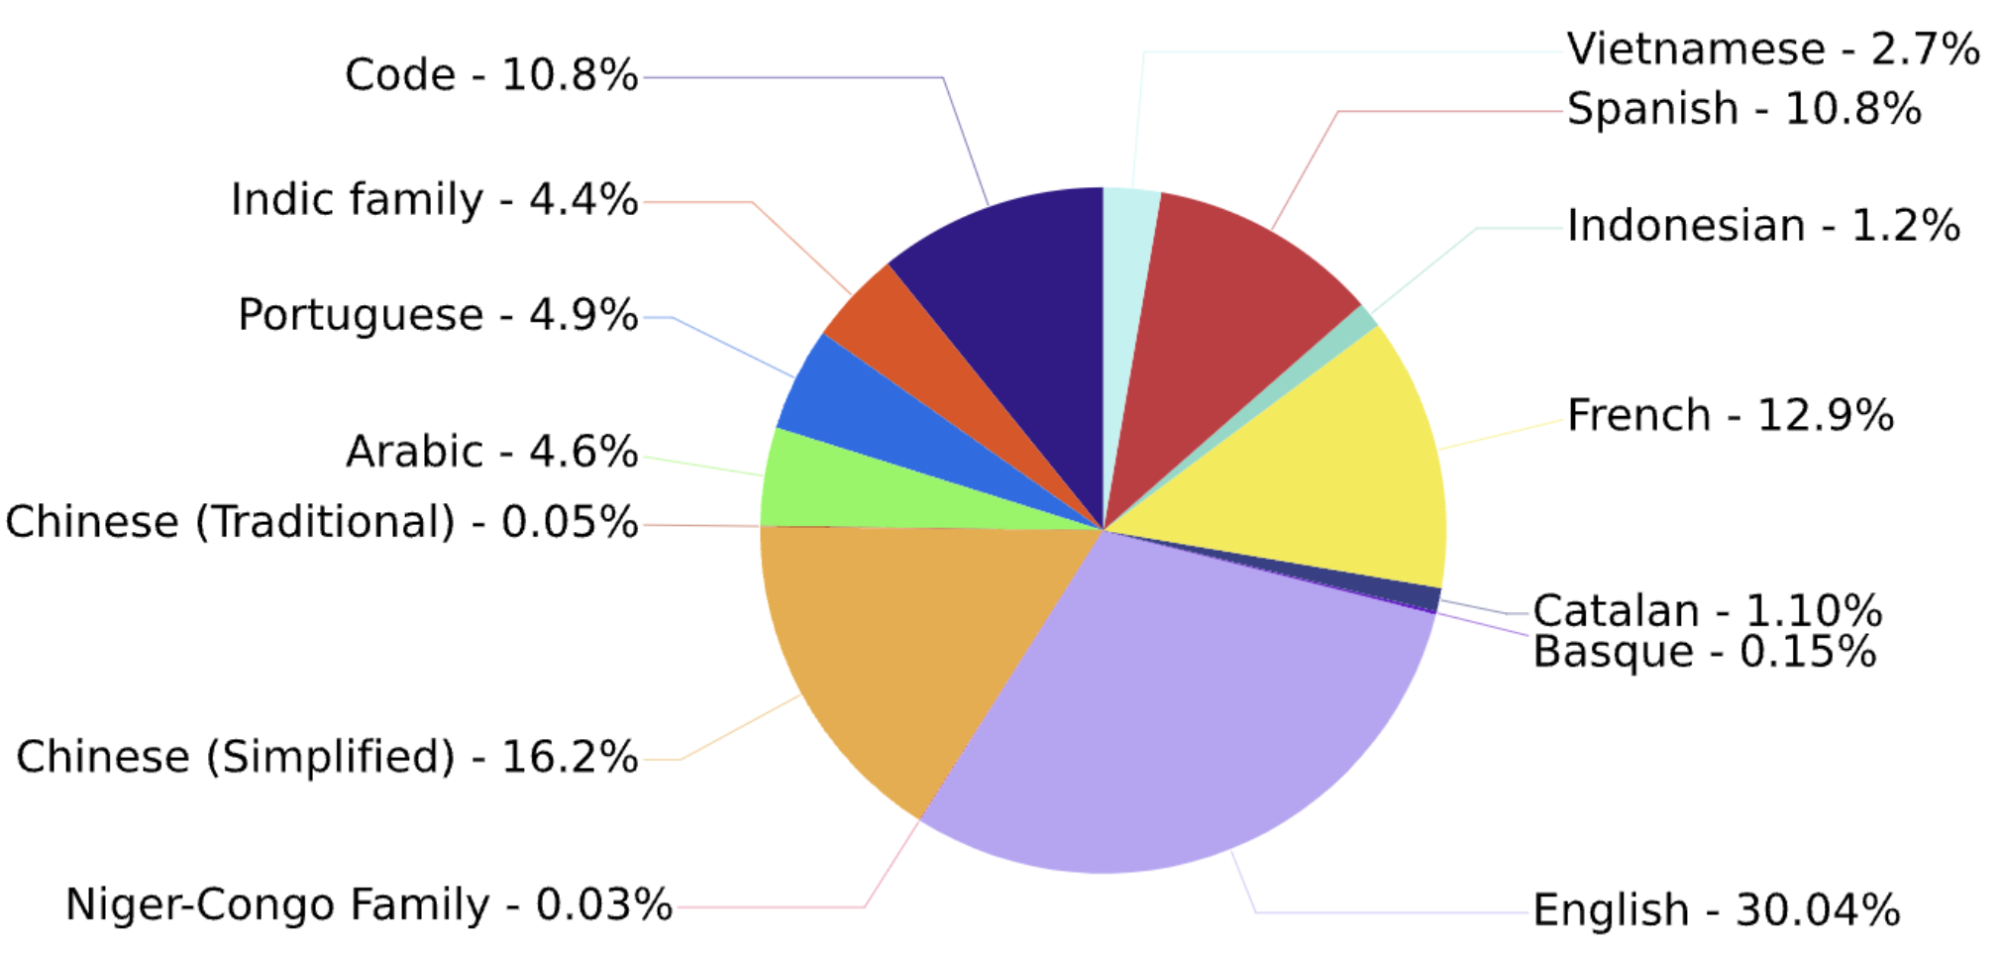
Distribusi bahasa pelatihan

Distribusi bahasa pelatihan (sumber)

Model ini menunjukkan kinerja luar biasa pada beragam tolok ukur, dan mencapai hasil lebih baik setelah multitask prompted finetuning.

Proyek ini berpuncak pada sesi pelatihan selama 117 hari (11 Maret - 6 Juli) di superkomputer Jean Zay di Paris, didukung oleh hibah komputasi besar dari lembaga riset Prancis CNRS dan GENCI.

BLOOM bukan hanya sebuah keajaiban teknologi, tetapi juga simbol kerja sama internasional dan kekuatan pengejaran ilmu pengetahuan kolektif.

Arsitektur model BLOOM

Sekarang, mari jelaskan arsitektur BLOOM secara lebih terperinci, yang melibatkan banyak komponen.
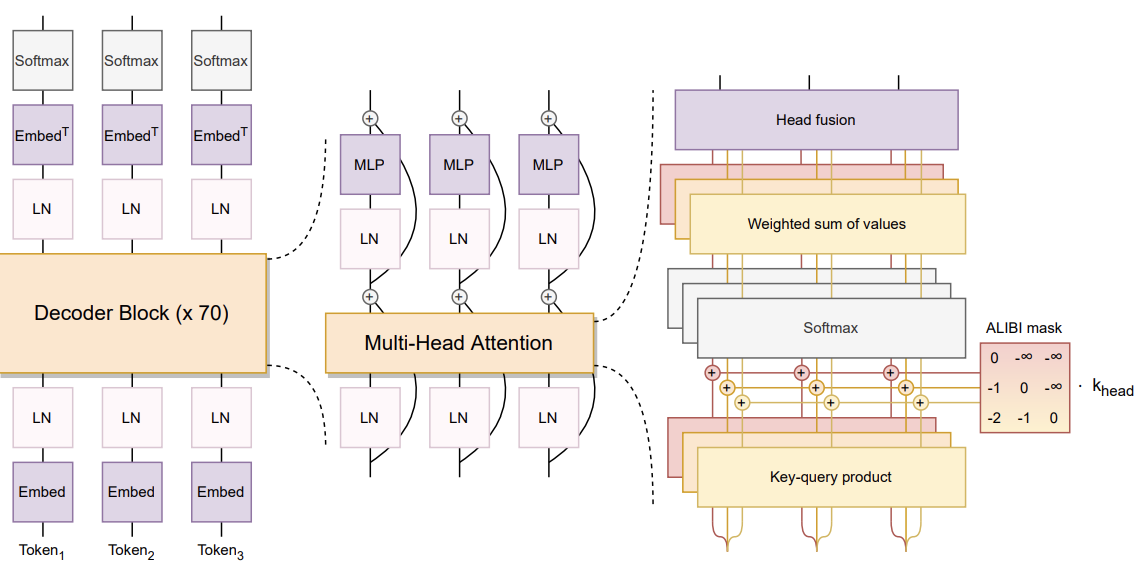
Arsitektur Bloom

Arsitektur Bloom (sumber)

Arsitektur model BLOOM, sebagaimana dirinci dalam makalahnya, mencakup beberapa hal penting:

  • Metodologi Desain: Tim berfokus pada keluarga model yang dapat diskalakan dengan dukungan pada alat dan basis kode yang tersedia publik, serta melakukan eksperimen ablation pada model yang lebih kecil untuk mengoptimalkan komponen dan hiperparameter. Generalisasi zero-shot menjadi metrik utama untuk mengevaluasi keputusan arsitektur.
  • Arsitektur dan Tujuan Pra-pelatihan: BLOOM berbasis arsitektur Transformer, khususnya model kausal hanya-decoder. Pendekatan ini divalidasi sebagai yang paling efektif untuk kemampuan generalisasi zero-shot dibandingkan arsitektur encoder-decoder dan arsitektur hanya-decoder lainnya.
  • Detail Pemodelan:
    • ALiBi Positional Embeddings: ALiBi dipilih alih-alih positional embeddings tradisional, karena secara langsung melemahkan skor atensi berdasarkan jarak antara key dan query. Ini menghasilkan pelatihan yang lebih mulus dan kinerja yang lebih baik.
    • Embedding LayerNorm: Normalisasi layer tambahan disertakan segera setelah layer embedding, yang meningkatkan stabilitas pelatihan. Keputusan ini sebagian dipengaruhi oleh penggunaan bfloat16 pada pelatihan akhir, yang lebih stabil daripada float16​​.

Komponen-komponen ini mencerminkan fokus tim pada keseimbangan antara inovasi dan teknik yang telah terbukti untuk mengoptimalkan kinerja dan stabilitas model.

Selain komponen arsitektural BLOOM, mari pahami dua komponen relevan tambahan: prapemrosesan data dan dataset dengan prompt.

  • Prapemrosesan data: Ini mencakup langkah-langkah penting seperti deduplikasi dan penyamaran privasi, terutama untuk sumber dengan risiko privasi lebih tinggi.
  • Dataset ber-prompt: BLOOM menggunakan multitask prompted finetuning, yang menunjukkan kemampuan generalisasi tugas zero-shot yang kuat.

Cara Menggunakan BLOOM

Dalam contoh ini, kita akan menggunakan BLOOM untuk menghasilkan cerita kreatif. Kode yang disediakan disusun untuk menyiapkan lingkungan, menyiapkan model, dan menghasilkan teks berdasarkan prompt yang diberikan. Kode sumber terkait tersedia di GitHub, dan sangat terinspirasi dari tutorial amrrs.

Konfigurasi workspace

Model BLOOM intensif sumber daya, sehingga konfigurasi workspace yang tepat sangat krusial, dan langkah-langkah utamanya dijelaskan di bawah.

Pertama, pustaka transformer digunakan untuk menyediakan antarmuka bekerja dengan model BLOOM, dan model berbasis transformer secara umum.

!pip install transformers -q

Dengan menggunakan nvidia-smi, kita memeriksa properti GPU yang tersedia untuk memastikan kita memiliki sumber daya komputasi yang diperlukan untuk menjalankan model.

!nvidia-smi
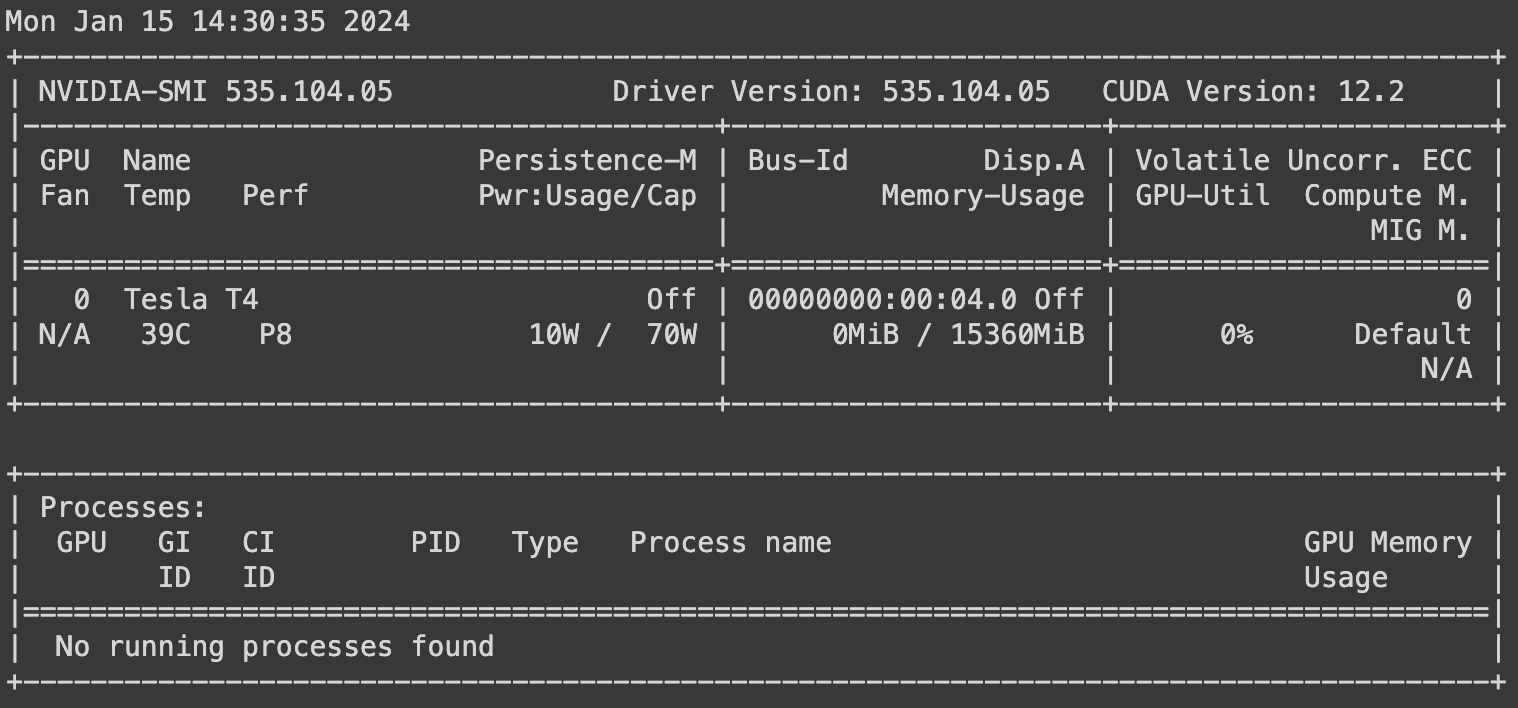
Properti GPU

Kita mengimpor modul yang diperlukan dari transformers dan torch. torch digunakan untuk mengatur tipe tensor default agar memanfaatkan akselerasi GPU.

Kemudian, karena kita menggunakan GPU, pustaka torch dikonfigurasi menggunakan fungsi set_default_tensor_type untuk memastikan penggunaan GPU.

from transformers import AutoModelForCausalLM, AutoTokenizer, set_seed
import torch
torch.set_default_tensor_type(torch.cuda.FloatTensor)

Menggunakan model BLOOM

Model sasaran yang digunakan adalah model BLOOM dengan 7 miliar parameter, dan dapat diakses dari repositori Hubbing Face milik BigScience di bawah bigscience/bloom-1b7, yang merupakan pengenal unik model.

model_ID = "bigscience/bloom-1b7"

Selanjutnya, kita memuat model BLOOM dan tokenizer pra-latih dari Hugging Face, dan menetapkan seed untuk reprodusibilitas menggunakan fungsi set_seed dengan angka apa pun. Nilai angkanya sendiri tidak masalah, namun penting untuk menggunakan nilai non-floating.

Untuk mempelajari lebih lanjut tentang potensi LLM yang belum tergarap dengan LangChain, yang merupakan kerangka kerja Python open-source untuk membangun aplikasi AI tingkat lanjut, tutorial kami How to Build LLM Applications with LangChain Tutorial adalah panduan yang tepat.

Selain itu, jika Anda seorang data engineer dan tertarik menggunakan LangChain untuk aplikasi data, artikel kami Introduction to LangChain for Data Engineering & Data Applications memberikan gambaran tentang apa yang dapat Anda lakukan dengan LangChain, termasuk masalah yang dipecahkan LangChain dan contoh use case data.

model = AutoModelForCausalLM.from_pretrained(model_ID, use_cache=True) 
tokenizer = AutoTokenizer.from_pretrained(model_ID)
set_seed(2024)

Sekarang, kita dapat menentukan judul cerita yang akan dihasilkan, beserta prompt-nya.

story_title = 'An Unexpected Journey Through Time' 
prompt = f'This is a creative story about {story_title}.\n'

Terakhir, kita tokenisasi prompt dan memetakannya ke perangkat model yang sesuai sebelum menghasilkan keluaran model setelah decoding.

input_ids = tokenizer(prompt, return_tensors="pt").to(0)

sample = model.generate(**input_ids, 
                        max_length=200, top_k=1, 
                        temperature=0, repetition_penalty=2.0)

generated_story = tokenizer.decode(sample[0], skip_special_tokens=True)

Hasil akhir diformat menggunakan modul textwrap, untuk memastikan jumlah maksimum karakter per baris adalah 80 demi keterbacaan yang lebih baik.

import textwrap  
wrapper = textwrap.TextWrapper(width=80)
formated_story = wrapper.fill(text=generated_story)
print(formated_story)

Hasil akhirnya ditampilkan di bawah ini:
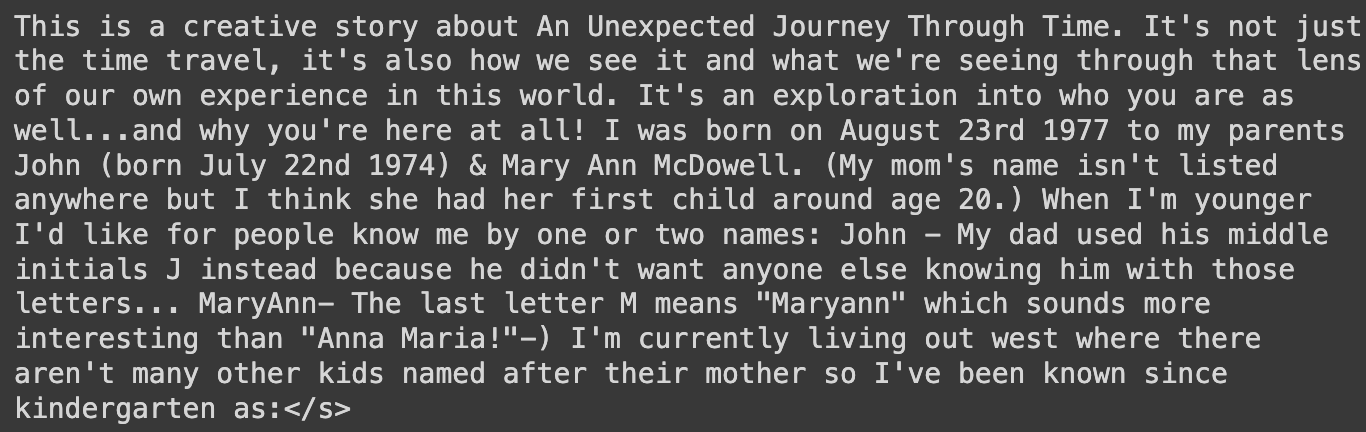
image2.png

Cerita yang dihasilkan menggunakan model BLOOM

Dengan beberapa baris kode, kita dapat menghasilkan konten yang bermakna menggunakan model BLOOM.

Jika Anda ingin menguasai proses pelatihan model bahasa besar menggunakan PyTorch, dari penyiapan awal hingga implementasi akhir, tutorial kami How to Train an LLM with PyTorch menyediakan panduan lengkap untuk mencapai tujuan tersebut.

Penggunaan yang Dimaksud dan Di Luar Cakupan

Seperti semua kemajuan teknologi, BLOOM hadir dengan serangkaian aplikasi yang sesuai dan tidak sesuai. Bagian ini mengulas use case yang tepat dan yang tidak tepat, menyoroti di mana kemampuannya paling baik dimanfaatkan dan di mana kehati-hatian diperlukan. Memahami batasan ini penting untuk memanfaatkan potensi BLOOM secara bertanggung jawab dan efektif.

Penggunaan yang Dimaksud untuk BLOOM

BLOOM adalah alat serbaguna yang dirancang untuk mendorong batas pemrosesan dan generasi bahasa. Penggunaan yang dimaksud mencakup berbagai domain, masing-masing memanfaatkan kemampuan bahasanya yang luas.

  • Generasi Konten Multibahasa: Dengan kemahiran dalam 59 bahasa, BLOOM unggul dalam menciptakan konten yang beragam dan inklusif. Kemampuan ini sangat berharga dalam komunikasi global, pendidikan, dan media, di mana keberinklusifan bahasa krusial.

  • Pemrograman dan Pengembangan Perangkat Lunak: Pelatihan BLOOM dalam bahasa pemrograman menempatkannya sebagai aset dalam pengembangan perangkat lunak. Ia dapat membantu tugas seperti pembuatan kode, debugging, dan menjadi alat edukatif bagi pemrogram baru.

  • Riset dan Akademik: Di lingkungan akademik, BLOOM berfungsi sebagai sumber daya kuat untuk analisis linguistik dan riset AI, menyediakan wawasan tentang pola bahasa, perilaku AI, dan lainnya.


Penggunaan BLOOM yang di luar cakupan

Memahami keterbatasan BLOOM penting untuk memastikan penerapan yang etis dan praktis. Beberapa use case berada di luar cakupan yang dimaksud untuk BLOOM LLM, terutama karena pertimbangan etis atau kendala teknis.

  • Penanganan Data Sensitif: BLOOM tidak dirancang untuk memproses data pribadi sensitif atau informasi rahasia. Potensi pelanggaran privasi atau penyalahgunaan data tersebut membuatnya tidak cocok untuk tujuan ini.

  • Pembuatan Keputusan Bernilai Tinggi: menggunakan BLOOM dalam skenario yang memerlukan akurasi kritis, seperti diagnosis medis atau keputusan hukum, tidak disarankan. Keterbatasan model, seperti halnya sebagian besar LLM, dapat menyebabkan hasil yang tidak akurat atau menyesatkan di area sensitif ini.

  • Pengganti Interaksi Manusia: BLOOM tidak boleh dipandang sebagai pengganti interaksi manusia, terutama di bidang yang memerlukan kecerdasan emosional, seperti konseling, diplomasi, atau pengajaran personal. Model ini tidak memiliki pemahaman bernuansa dan empati yang diberikan oleh interaksi manusia.

Pengguna Langsung dan Tidak Langsung

BLOOM, sebagai Large Language Model (LLM) tingkat lanjut, menawarkan beragam manfaat yang menjangkau berbagai kelompok pengguna. Kemampuannya tidak hanya berdampak langsung pada profesi dan sektor tertentu, tetapi juga memiliki efek lebih luas yang secara tidak langsung memengaruhi lebih banyak pemangku kepentingan.

Eksplorasi tentang pengguna BLOOM ini bertujuan menyoroti bagaimana berbagai kelompok memanfaatkan dan terdampak oleh alat inovatif ini.

Dengan memahami pengguna langsung dan tidak langsung BLOOM, kita dapat mengapresiasi pengaruh luas model ini dan beragam cara kontribusinya dalam memajukan teknologi dan masyarakat.

Pengguna Langsung BLOOM

  • Developer dan Data Scientist: Profesional di pengembangan perangkat lunak dan data science adalah pengguna utama. Mereka memanfaatkan BLOOM untuk tugas seperti bantuan penulisan kode, debugging, dan analisis data.
  • Peneliti dan Akademisi: Kelompok ini mencakup ahli linguistik, peneliti AI, dan akademisi yang menggunakan BLOOM untuk studi bahasa, analisis perilaku AI, dan memajukan riset NLP.
  • Pembuat Konten dan Penerjemah: Penulis, jurnalis, dan penerjemah menggunakan BLOOM untuk menghasilkan dan menerjemahkan konten lintas bahasa, meningkatkan produktivitas dan jangkauan mereka.

Pengguna Tidak Langsung BLOOM

  • Bisnis dan Organisasi: Perusahaan di berbagai sektor diuntungkan secara tidak langsung dari BLOOM melalui layanan berbasis AI yang ditingkatkan, interaksi pelanggan yang lebih baik, dan penanganan data yang efisien.
  • Institusi Pendidikan: Siswa dan pendidik merasakan manfaat BLOOM secara tidak langsung lewat alat dan sumber belajar yang mengintegrasikan kemampuan pemrosesan bahasanya untuk kegiatan belajar-mengajar.
  • Masyarakat Umum: Komunitas yang lebih luas menjadi penerima manfaat tidak langsung BLOOM melalui pengalaman teknologi yang lebih baik, akses ke konten multibahasa, dan aplikasi perangkat lunak yang ditingkatkan.

Pertimbangan Etis dan Keterbatasan

Penerapan BLOOM, seperti LLM lainnya, membawa berbagai pertimbangan etis dan keterbatasan. Aspek-aspek ini krusial untuk dipahami demi penggunaan yang bertanggung jawab serta mengantisipasi dampak teknologi yang lebih luas. Bagian ini membahas implikasi etika, risiko, dan keterbatasan melekat yang terkait penggunaan BLOOM.

Pertimbangan etis

  • Bias Data dan Keadilan: Salah satu kekhawatiran etis utama adalah potensi BLOOM untuk mempertahankan atau memperkuat bias yang ada dalam data pelatihannya. Hal ini dapat memengaruhi keadilan dan netralitas keluarannya, menimbulkan tantangan etis pada skenario yang membutuhkan pemrosesan tanpa bias.
  • Kekhawatiran Privasi: Meskipun BLOOM tidak secara eksplisit dirancang untuk menangani informasi pribadi sensitif, keluasan data latihnya mungkin secara tidak sengaja mencakup informasi seperti itu. Ada risiko pelanggaran privasi jika BLOOM menghasilkan keluaran berdasarkan atau mengungkap data sensitif.

Risiko terkait penggunaan

  • Mis-informasi dan Manipulasi: Kemampuan BLOOM yang canggih dapat disalahgunakan untuk menghasilkan informasi menyesatkan atau konten manipulatif, sehingga menimbulkan risiko signifikan di bidang seperti media, politik, dan opini publik.
  • Ketergantungan dan Degradasi Keterampilan: Ketergantungan berlebihan pada BLOOM untuk tugas seperti pembuatan konten atau penerjemahan dapat menyebabkan degradasi keterampilan tersebut pada manusia, memengaruhi kreativitas dan kemampuan bahasa.

Keterbatasan BLOOM

  • Pemahaman Kontekstual: Meski canggih, BLOOM mungkin kurang dalam pemahaman kontekstual dan kultural yang mendalam yang diperlukan untuk tugas tertentu, sehingga menimbulkan ketidakakuratan atau keluaran yang tidak tepat pada skenario bernuansa.
  • Sifat Bahasa yang Terus Berkembang: Pelatihan BLOOM pada himpunan data statis berarti ia mungkin tidak mengikuti perkembangan bahasa, termasuk kosakata gaul baru, terminologi, atau referensi budaya.

Dampak dunia nyata dan kontroversi

Pengembangan dan rilis BLOOM memiliki implikasi signifikan di dunia nyata, baik dari sisi dampaknya maupun kontroversi yang ditimbulkannya. Bagian ini membahas aspek-aspek tersebut, berdasarkan wawasan dari makalah riset BLOOM.

Dampak dunia nyata dari BLOOM

  • Demokratisasi Teknologi AI: BLOOM merepresentasikan langkah menuju demokratisasi teknologi AI. Dikembangkan oleh BigScience, upaya kolaboratif yang melibatkan lebih dari 1.200 orang dari 38 negara, BLOOM adalah model akses terbuka yang dilatih pada korpus beragam mencakup 59 bahasa​​. Partisipasi luas dan aksesibilitas ini menandai pergeseran dari eksklusivitas yang lazim terlihat dalam pengembangan model bahasa besar.
  • Keberagaman dan Inklusivitas: Komitmen proyek terhadap keberagaman linguistik, geografis, dan ilmiah patut dicatat. Korpus ROOTS yang digunakan untuk melatih BLOOM mencakup rentang bahasa alami dan bahasa pemrograman yang sangat luas, mencerminkan penekanan pada inklusivitas dan representasi dalam pengembangan AI

Kontroversi dan tantangan

  • Kekhawatiran Sosial dan Etis: Pengembangan BLOOM mengakui keterbatasan sosial dan tantangan etis dalam pengembangan model bahasa besar. Workshop BigScience menerapkan Piagam Etika untuk memandu proyek, menekankan inklusivitas, keberagaman, keterbukaan, reprodusibilitas, dan tanggung jawab. Prinsip-prinsip ini diintegrasikan dalam berbagai aspek proyek, dari kurasi dataset hingga evaluasi model​​.
  • Kekhawatiran Lingkungan dan Sumber Daya: Pengembangan model bahasa besar seperti BLOOM menimbulkan kekhawatiran lingkungan karena sumber daya komputasi yang signifikan diperlukan. Pelatihan model-model ini, yang umumnya hanya terjangkau organisasi dengan sumber daya besar, berdampak pada konsumsi energi dan jejak karbon​

Apakah BLOOM Masih Relevan Saat Ini?

Di dunia Kecerdasan Buatan (AI) yang bergerak cepat, relevansi LLM seperti BLOOM menjadi topik diskusi berkelanjutan.

Dikembangkan oleh tim peneliti internasional yang luas, BLOOM merupakan lompatan besar dalam pemrosesan bahasa. Namun, lanskap AI terus berkembang, dengan model-model baru bermunculan dan menggeser fokus.

Mari kita tinjau apakah BLOOM masih mampu bertahan di domain yang kompetitif ini.

  • Pergeseran Fokus: Awalnya menjadi terobosan besar, kini BLOOM berada di bayang-bayang model yang lebih baru. Berbeda dengan AI percakapan seperti ChatGPT, BLOOM dirancang untuk pelengkapan konten alih-alih komunikasi interaktif.
  • Kendala Perangkat Keras: Tuntutan perangkat keras BLOOM yang tinggi membatasi aksesibilitasnya dibandingkan LLM yang lebih ramah pengguna seperti GPT-3.5 dan GPT-4, yang lebih mudah diintegrasikan ke berbagai aplikasi.
  • Meningkatnya Persaingan: Munculnya model seperti LLaMA dan alat seperti Alpaca telah mendemokratisasi akses ke LLM, menawarkan kemampuan dengan kebutuhan sumber daya yang lebih rendah, sehingga memperluas daya tarik dan penggunaannya.
  • Kemampuan Multibahasa: Nilai jual unik BLOOM adalah pelatihan ekstensifnya dalam banyak bahasa, menjadikannya sumber yang berharga untuk penerjemahan dan pembuatan konten multibahasa.

Kesimpulan

Artikel ini menyajikan ikhtisar proyek BLOOM, sebuah kontribusi penting bagi bidang Model Bahasa Besar yang terus berkembang.

Kita menelusuri pengembangan BLOOM, menyoroti spesifikasi teknis dan kolaborasi di balik pembuatannya. Artikel ini juga menjadi panduan untuk mengakses dan memanfaatkan BLOOM secara efektif, dengan menekankan penggunaan yang tepat dan keterbatasannya.

Lebih lanjut, artikel ini membahas implikasi etika dan dampak dunia nyata dari proyek BLOOM AI, merefleksikan penerimaan serta relevansinya dalam lanskap AI saat ini. Baik Anda terlibat langsung dalam AI maupun sebagai penggemar, eksplorasi tentang BLOOM ini menawarkan perspektif penting untuk menavigasi dunia LLM yang kompleks.

Bagi Anda yang ingin memperdalam keterlibatan dengan model bahasa tingkat lanjut, kursus tambahan kami, Large Language Models (LLMs) Concepts, menyediakan jalur untuk menemukan potensi penuh LLM melalui kursus konseptual yang mencakup aplikasi LLM, metodologi pelatihan, pertimbangan etika, dan riset terbaru.


Zoumana Keita 's photo
Author
Zoumana Keita
LinkedIn
Twitter

Seorang data scientist serbabisa yang senang berbagi pengetahuan dan memberi dampak bagi orang lain, Zoumana adalah pembuat konten di YouTube dan penulis teknologi teratas di Medium. Ia menikmati berbicara di depan umum, ngoding, dan mengajar. Zoumana meraih dua gelar magister: yang pertama di bidang ilmu komputer dengan fokus Machine Learning di Paris, Prancis, dan yang kedua di bidang Data Science dari Texas Tech University di AS. Kariernya dimulai sebagai Pengembang Perangkat Lunak di Groupe OPEN, Prancis, lalu bergabung dengan IBM sebagai Konsultan Machine Learning, di mana ia mengembangkan solusi AI end-to-end untuk perusahaan asuransi. Zoumana kemudian bergabung dengan Axionable, startup AI Berkelanjutan pertama yang berbasis di Paris dan Montreal. Di sana, ia berperan sebagai Data Scientist dan mengimplementasikan produk AI, terutama use case NLP, untuk klien dari Prancis, Montreal, Singapura, dan Swiss. Selain itu, 5% dari waktunya didedikasikan untuk Riset dan Pengembangan. Saat ini, ia bekerja sebagai Senior Data Scientist di IFC - World Bank Group.

Topik
Kecerdasan Buatan

Mulai Perjalanan AI Anda Hari Ini!

Kursus

Konsep Generative AI

2 Hr
116.7K
Pelajari cara mulai memanfaatkan AI generatif secara bertanggung jawab. Pelajari cara model AI generatif dikembangkan dan dampaknya bagi masyarakat ke depan.
Lihat DetailRight Arrow
Mulai Kursus
Lihat Lebih BanyakRight Arrow
Terkait

blogs

40 Pertanyaan Wawancara DBMS Teratas di 2026

Kuasai pertanyaan wawancara basis data, dari konsep SQL dasar hingga skenario desain sistem tingkat lanjut. Panduan mendalam ini mencakup semua yang Anda perlukan untuk sukses di wawancara DBMS dan meraih peran berikutnya.
Dario Radečić's photo

Dario Radečić

15 mnt

blogs

12 Alternatif ChatGPT Terbaik yang Bisa Anda Coba pada 2026

Artikel ini menyajikan daftar alternatif ChatGPT yang akan meningkatkan produktivitas Anda.
Javier Canales Luna's photo

Javier Canales Luna

14 mnt

blogs

Tutorial Korelasi di R

Dapatkan pengenalan dasar-dasar korelasi di R: pelajari lebih lanjut tentang koefisien korelasi, matriks korelasi, plotting korelasi, dan sebagainya.
David Woods's photo

David Woods

13 mnt

blogs

Spaghetti Plot dan Jalur Badai

Temukan alasan mengapa Anda sebaiknya (tidak) menggunakan spaghetti plot untuk menyampaikan ketidakpastian jalur prediksi badai serta dampaknya terhadap interpretasi.
Hugo Bowne-Anderson's photo

Hugo Bowne-Anderson

13 mnt

Lihat Lebih BanyakLihat Lebih Banyak