Curso
Conceptos de grandes modelos lingüísticos (LLM)
2 h
112.1K
Ahora mismo, estos seis son algunos de los LLM de código abierto más populares:
Y todos comparten la misma desventaja: una ventana de contexto muy corta, que llega como mucho a 2048 tokens. Si los comparamos con modelos propietarios como GPT-3.5 y GPT-4, que ofrecen hasta 32k tokens (¡50 páginas de texto!), parece que los LLM de código abierto salen perdiendo.
La longitud de contexto es, en esencia, la “memoria” de los LLM. Una ventana de 2048 tokens significa que el modelo solo puede recordar 2048 tokens de la conversación a la vez. Esto afecta de forma notable a tareas donde el contexto amplio es clave, como el resumen de documentos, la traducción, la generación de código, etc.
Para abordar este problema crítico, Salesforce anunció su modelo XGen-7B con una longitud de contexto de 8k tokens (4 veces más que otros LLM similares). Este artículo repasa las características clave del modelo y muestra cómo usarlo y afinarlo con un conjunto de datos de ejemplo.
Para la mayoría, cifras como la longitud de contexto no significan mucho hasta que se traducen en beneficios tangibles. Aquí tienes algunas de sus funciones principales y el impacto que pueden tener en tus propios proyectos:
A pesar de su tamaño relativamente pequeño, con 7.000 millones de parámetros, XGen rinde muy por encima de lo que cabría esperar, logrando un desempeño a la altura —o mejor— que el de modelos mucho más grandes. Esta eficiencia cambia las reglas del juego para desarrolladores e investigadores, ya que permite ejecutar y desplegar aplicaciones de IA punteras directamente en máquinas locales de gama alta, sin depender de grandes recursos en la nube. Este equilibrio entre tamaño y rendimiento hace que XGen resulte especialmente atractivo para un abanico amplio de usuarios, desde startups hasta el mundo académico.
Conscientes de las distintas necesidades, XGen ofrece tres versiones, cada una pensada para aplicaciones concretas:
La verdadera medida de la potencia del modelo se ve en los benchmarks. XGen sale en cabeza en un conjunto diverso de pruebas como MMLU, HumanEval, etc., cuando se compara con modelos de tamaño similar. Para un análisis en profundidad, la entrada de anuncio ofrece una visión completa de los resultados de XGen.
A riesgo de repetirme, XGen está muy optimizado para tareas que requieren ventanas de contexto amplias. Esta capacidad es crucial en aplicaciones como el resumen detallado de documentos, donde comprender el texto completo es fundamental para generar buenos resúmenes. De forma similar, en preguntas y respuestas complejas y en la generación de textos largos, la habilidad de XGen para procesar grandes cantidades de información se traduce en salidas más coherentes y relevantes.
¿Cómo logra XGen estos resultados tan buenos? La respuesta, claro, está en los métodos de entrenamiento y optimización utilizados por el equipo de Salesforce AI.
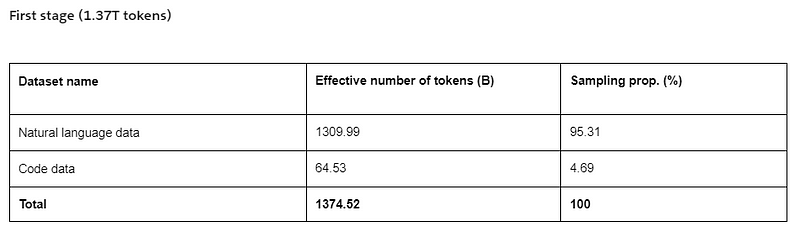
La estrategia de entrenamiento de XGen tiene dos etapas. En la primera, se entrena un modelo desde cero con 1,37 billones de tokens, con una mezcla de lenguaje natural y código.
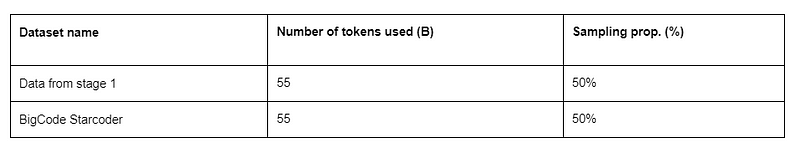
En la segunda etapa, se utilizan 55.000 millones de tokens adicionales de código para mejorar la generación de código:
El entrenamiento se realizó con una librería interna llamada JaxFormer, diseñada específicamente para entrenar LLM de forma eficiente con paralelización de datos y de modelo en hardware TPU-v4.
Aunque es compacto, XGen 7B sigue siendo grande en términos de redes neuronales. Si quieres ejecutarlo sin recursos en la nube, necesitarás una máquina local potente. El requisito principal es contar con suficiente RAM, bastante por encima de 32 GB, ya que el modelo ocupa ~30 GB al descargarlo desde HuggingFace. En cuanto a GPUs, cuanto más grande, mejor.
Si tu PC no cumple estas especificaciones, la opción más económica es Colab Pro, que ofrece 40 GB de RAM y 40 GB de vRAM de GPU (A100). Para este tutorial, uso Colab Pro:
Una vez tengas la máquina preparada, toca instalar y descargar el modelo. Si estás siguiendo el tutorial en local, el paso 0 es crear un entorno virtual:
$ conda create -n xgen -y
$ conda activate xgen
Para descargar el modelo desde HuggingFace, es necesario tener instalado torch con soporte para GPU. Este es el comando para instalar todas las librerías necesarias:
$ pip install torch torchvision torchaudio transformers[torch]
También necesitaremos las siguientes librerías para el paso de afinado:
$ pip install accelerate peft bitsandbytes trl datasets --upgrade
No olvides reiniciar el kernel después de instalar las librerías.
Explicaré cada librería cuando lleguemos a su sección.
Ahora, ejecutemos el modelo por primera vez con este fragmento.
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

tokenizer = AutoTokenizer.from_pretrained("Salesforce/xgen-7b-8k-base", trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained("Salesforce/xgen-7b-8k-base", torch_dtype=torch.bfloat16)

inputs = tokenizer("DataCamp is one he ...", return_tensors="pt")
sample = model.generate(**inputs, max_length=128)

print(tokenizer.decode(sample[0]))
La clase AutoTokenizer carga el autotokenizador para el modelo de longitud 4098 xgen-7b-4k-base. La clase AutoModelForCausalLM sirve para cargar modelos de generación de texto.
Indicamos el prompt como inputs y lo desempaquetamos en model.generate estableciendo una longitud máxima de 128 tokens. La primera vez tardará un rato, ya que hay que descargar el modelo.
Este fue el resultado que obtuve:
DataCamp is one of the world’s leading providers of data science courses and training...El inicio de la respuesta está bien, pero empeora hacia el final. Necesitamos afinarlo para mejorar el rendimiento.
Los LLM no son como los modelos de sklearn: no basta con ajustar hiperparámetros en unas pocas líneas. Así que vamos a afinar XGen 7B en varios pasos. Te recomiendo ir paso a paso, respirando hondo: habrá bastantes detalles.
Ten en cuenta que el flujo de trabajo que detallo a continuación funcionará con muchos LLM en HuggingFace siempre que tengas suficiente capacidad de cómputo.
Vamos allá.
Ya hemos cubierto este paso antes. Repasemos las librerías instaladas y por qué las necesitamos:
torch: librería PyTorch para tensores y redes neuronales; permite aceleración por GPU.transformers: librería de Hugging Face para modelos NLP preentrenados.datasets: para cargar y procesar datos fácilmente con datasets de HuggingFace.accelerate: librería oficial de HuggingFace que simplifica el entrenamiento distribuido de LLM.peft: paquete para afinar solo una fracción de los parámetros del LLM y acelerar el entrenamiento.bitsandbytes: librería de optimización para LLM en memoria y cómputo.trl: técnicas para afinar modelos grandes usando RLHF (aprendizaje por refuerzo con feedback humano).Explicaremos las ventajas de cada librería cuando las usemos.
import os
import torch

from datasets import load_dataset
from transformers import (
   AutoModelForCausalLM,
   AutoTokenizer,
   BitsAndBytesConfig,
   TrainingArguments,
   pipeline,
)

from peft import LoraConfig
from trl import SFTTrainer
Resumen de las clases y funciones nuevas que importamos:
BitsAndBytesConfig: configuración para optimizar parámetros del modelo con técnicas de bits and bytes, mejorando memoria y eficiencia computacional.TrainingArguments: define parámetros de entrenamiento (p. ej., learning rate, batch size) para afinar modelos.pipeline: simplifica aplicar modelos a tareas como generación de texto.LoraConfig: configuración para aplicar LoRA (Low-Rank Adaptation), un método de afinado eficiente que ajusta un pequeño conjunto de parámetros.SFTTrainer: clase de entrenamiento para Supervised Fine-Tuning (SFT), que facilita el entrenamiento con feedback humano o datasets etiquetados.# Model from HF
base_model = "Salesforce/xgen-7b-8k-base"
# New instruction dataset
guanaco_dataset = "mlabonne/guanaco-llama2-1k"
# Fine-tuned model
new_model = "xgen-7b-8k-tuned"
Para el dataset, usaremos Guanaco LLaMA2, que contiene 1000 pares instrucción-respuesta para afinar LLM en tareas interactivas e instructivas (piensa en chatbots).
dataset = load_dataset(guanaco_dataset, split="train")Para cargar los datos de HuggingFace, usamos load_dataset indicando la ruta y el split del dataset. Podemos ver muestras convirtiéndolo a texto e indexando un par instrucción-respuesta aleatorio:
>>> dataset["text"][89]

<s>[INST] In England, what vegetable is referred to as a rocket? [/INST] The species name for "rocket" is "Eruca vesicaria", and it's also sometimes called "eruca".
However, other countries have different names for it:
* Arugula - America
* Garden Rocket or Rocket - Britain, Australia, South Africa, Ireland, New Zealand

Other names include "ruchetta", "rucola", "rucoli", "rugula", "colewoort", and "roquette".

The word transferred from Latin to Italian to English, which might explain the variants with similar pronunciation. </s>
La cuantización es una técnica potente para reducir el número de bits necesarios para representar los datos. Se logra aproximando los datos originales con un número menor de bits, obteniendo una representación más compacta.
La cuantización puede reducir la huella de memoria de un modelo, mejorar la eficiencia computacional e incluso, a veces, mejorar la precisión.
compute_dtype = torch.float16

quant_config = BitsAndBytesConfig(
   load_in_4bit=True,
   bnb_4bit_quant_type="nf4",
   bnb_4bit_compute_dtype=compute_dta
Primero, establecemos el tipo de dato de cada tensor con compute_dtype a float16. Luego, con BitsAndBytesConfig, definimos estos parámetros de cuantización:
load_in_4bit=True: indica que los datos de entrada se cuantizarán a 4 bits.bnb_4bit_compute_dtype=compute_dtype: especifica el tipo de dato para los cálculos, en este caso float16, definido antes.bnb_4bit_quant_type="nf4": especifica el tipo de cuantización para 4 bits; aquí, "nf4".nf4 se refiere a una cuantización no uniforme con 4 bits. La cuantización no uniforme a veces supera a la uniforme.
model = AutoModelForCausalLM.from_pretrained(
   base_model,
   quantization_config=quant_config,
   device_map="auto"
)
Este paso es similar a la descarga inicial de XGen, pero ahora pasamos los parámetros de cuantización a quantization_config y ajustamos device_map a auto para usar la GPU automáticamente.
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"
Tras cargar el tokenizador, configuramos los parámetros de padding. En PLN, los tokens de relleno son símbolos especiales sin significado que se añaden para que todas las secuencias tengan el mismo tamaño. Muchos modelos requieren entradas de tamaño fijo.
tokenizer.pad_token = tokenizer.eos_token establece el token de relleno igual que el token de fin de secuencia (EOS). Es una práctica común, ya que permite distinguir entre fin de frase y padding. tokenizer.padding_side = "right" indica que el relleno se añade a la derecha.
peft_params = LoraConfig(
   lora_alpha=16,
   lora_dropout=0.1,
   r=64,
   bias="none",
   task_type="CAUSAL_LM",
)
Los LLM preentrenados requieren enormes cantidades de datos y cómputo para afinarse. Con Parameter-Efficient Fine-Tuning (PEFT), podemos ajustar solo una fracción de los parámetros totales, reduciendo de forma significativa el tiempo de ejecución. Puedes leer más en la documentación oficial.
La clase LoraConfig define la configuración del método Low-Rank Adaptation. LoRA es un tipo de parametrización dentro de PEFT. En conjunto, el fragmento anterior controla la intensidad de la adaptación de las capas LoRA, el número de parámetros entrenables y otros aspectos.
training_params = TrainingArguments(
   output_dir="./results",
   num_train_epochs=1,
   per_device_train_batch_size=1,
   gradient_accumulation_steps=1,
   optim="paged_adamw_32bit",
   learning_rate=2e-4,
   weight_decay=0.001,
   fp16=False,
   bf16=False,
   max_grad_norm=0.3,
   max_steps=-1,
   warmup_ratio=0.03,
   group_by_length=True,
   lr_scheduler_type="constant",
)
Además de todo lo anterior, afinar XGen requiere alrededor de una docena de parámetros más. Incluyen parámetros conocidos como la tasa de aprendizaje, el programador de aprendizaje, número de épocas y optimizadores, y otros como warmup_ratio, fp16, bf16, weight_decay, etc.
Para no perdernos en los detalles, no entraremos a explicar cada uno; te remito a este excelente artículo sobre afinación de LLaMA2 que los cubre.
Para afinar un modelo PEFT, usaremos la clase SFTTrainer (Supervised Fine-Tuning) de la librería trl, un paso clave en RLHF.
trainer = SFTTrainer(
   model=model,
   train_dataset=dataset,
   peft_config=peft_params,
   dataset_text_field="text",
   max_seq_length=None,
   tokenizer=tokenizer,
   args=training_params,
   packing=False,
)
Para inicializar el entrenador, le pasamos el modelo, el dataset de entrenamiento, los parámetros PEFT, los parámetros de entrenamiento y el tokenizador. Para iniciar el proceso, basta con llamar a .train():
trainer.train()
Según los parámetros (especialmente el número de épocas), el entrenamiento puede tardar desde 15 minutos hasta varias horas.
Una vez finaliza el entrenamiento, ya podemos probar el modelo afinado:
prompt = "Who wrote Python?"
pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, max_length=200)

result = pipe(f"<s>[INST] {prompt} [/INST]")
print(result[0]['generated_text'])
Antes de pasar el prompt al model afinado, creamos un pipeline con el model y el tokenizer. La función pipeline carga el modelo preentrenado, preprocesa la entrada con el tokenizador y aplica (si procede) pasos de postprocesado al texto generado.
Arriba ejecutamos el pipeline con un prompt con formato especial envuelto en <s>[INST] {prompt} [/INST], igual que las instrucciones usadas durante el entrenamiento. Este es el resultado:
<s>[INST] Who wrote Python? [/INST] Python was created by Guido van Rossum, a Dutch computer programmer. He started working on the language in the late 1980s and released the first version in 1991. </s>

Python is a high-level, general-purpose programming language that is widely used in various fields, including data science, machine learning, and web development. It is known for its readability, flexibility, and ease of use, making it a popular choice for beginners and experienced developers alike. </s>

Python is an open-source language, meaning that anyone can access and modify the source code, making it a popular choice for developers who want to contribute to the community. </s>...
Cuando estemos satisfechos con el resultado, podemos guardarlo:
trainer.model.save_pretrained(new_model)
trainer.tokenizer.save_pretrained(new_model)
Puedes volver a cargarlo con la clase AutoModelForCausalLM:
fine_tuned_xgen = AutoModelForCausalLM.from_pretrained(new_model, ...)
Empezar con Large Language Models (LLM) como XGen 7B de Salesforce es sencillo, pero adaptarlos a necesidades específicas es más complejo. Nuestra experiencia afinando XGen 7B con un pequeño dataset instructivo lo ilustra bien. Adaptar el modelo a distintas tareas exige acceso a datasets relevantes (disponibles en la librería datasets de Hugging Face) y recursos computacionales capaces de entrenar un modelo con 7.000 millones de parámetros sobre esos datos.
El proceso de afinado puede resumirse en estos pasos:
bitsandbytestransformersLoraConfigtransformersSFTTrainer de trlSi algunos conceptos o fragmentos de código aún te resultan poco familiares, te recomiendo estos recursos:
¡Gracias por leer!
¡Empieza hoy tu camino en IA!
Curso
Curso
Curso
blog
Abid Ali Awan
13 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Josep Ferrer
11 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Arunn Thevapalan
12 min