
Cours
Concepts des grands modèles de langage (LLM)
2 h
109.8K
En ce moment, ces six LLM open source figurent parmi les plus en vue :
Ils partagent toutefois le même inconvénient : une fenêtre de contexte très courte, limitée à 2 48 jetons. Face à des modèles propriétaires comme GPT-3.5 et GPT-4 qui montent jusqu'à 32 000 jetons (environ 50 pages de texte !), les LLM open source semblent lourdement défavorisés.
La longueur de contexte constitue en quelque sorte la « mémoire » des LLM. Une fenêtre de 2 48 jetons signifie que le modèle ne peut retenir qu’autant de jetons à la fois dans une conversation. Cela dégrade nettement les performances sur des tâches où un grand contexte est crucial, comme le résumé de documents, la traduction, la génération de code, etc.
Pour répondre à cet enjeu majeur, Salesforce a annoncé XGen-7B, un modèle avec une longueur de contexte de 8 000 jetons (4 fois plus que des LLM similaires). Cet article présente ses caractéristiques clés et montre comment l’utiliser et le peaufiner sur un jeu de données d’exemple.
Pour beaucoup, des statistiques comme la longueur de contexte restent abstraites tant qu’elles ne sont pas traduites en bénéfices concrets. Voici donc ses principaux atouts et l’impact potentiel sur vos projets :
Malgré sa taille relativement modeste de 7 milliards de paramètres, XGen livre des performances qui rivalisent avec des modèles bien plus gros, voire les dépassent. Cette efficacité change la donne pour les développeurs et les chercheurs : elle permet d’exécuter et de déployer des applications d’IA de pointe directement sur des machines locales haut de gamme, sans recourir à d’importantes ressources cloud. Cet équilibre entre taille et performance rend XGen particulièrement attractif, des startups aux laboratoires académiques.
Conçu pour répondre à des besoins divers, XGen propose trois versions adaptées à des applications précises :
La véritable mesure de la force du modèle se voit dans les benchmarks. XGen se hisse en tête sur un ensemble varié (MMLU, HumanEval, etc.) face à des modèles de taille comparable. Pour une analyse détaillée, le billet d’annonce propose une synthèse complète de ses performances.
Au risque de me répéter, XGen est particulièrement optimisé pour les tâches exigeant de larges fenêtres de contexte. C’est crucial pour des cas comme le résumé de documents volumineux, où la compréhension globale du texte améliore sensiblement la précision. De même, pour le question-réponse approfondi et la génération de contenus longs, la capacité d’XGen à traiter beaucoup d’informations produit des résultats plus cohérents et contextuels.
Comment XGen obtient-il de tels résultats ? Sans surprise, tout repose sur les stratégies d’entraînement et d’optimisation mises en œuvre par les chercheurs de Salesforce AI.
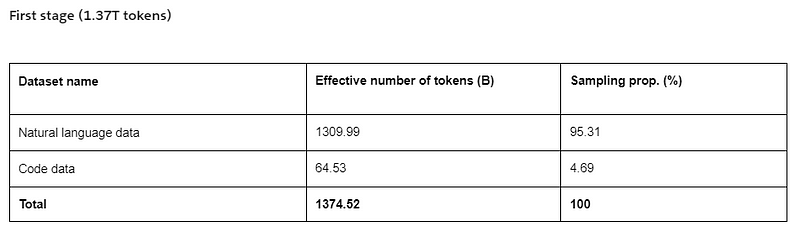
La stratégie d’entraînement se déroule en deux étapes. En phase 1, un modèle neuf est entraîné sur 1,37 billion de jetons, mêlant langage naturel et code.
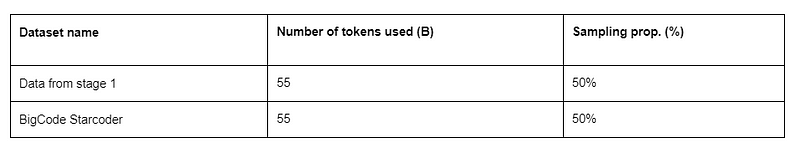
En phase 2, 55 milliards de jetons supplémentaires de code sont utilisés pour améliorer la génération de code :
L’entraînement a été réalisé avec une bibliothèque interne appelée JaxFormer, spécialement conçue pour entraîner efficacement des LLM avec parallélisation des données et du modèle sur matériel TPU-v4.
Malgré son format « compact », XGen 7B reste très volumineux à l’échelle des réseaux de neurones. Si vous souhaitez l’exécuter sans ressources cloud, prévoyez une machine locale haut de gamme. L’exigence principale est une RAM suffisante, bien au-delà de 32 Go, car le modèle pèse environ 30 Go à télécharger depuis HuggingFace. Côté GPU, plus il est puissant, mieux c’est.
Si votre PC n’atteint pas ces spécifications, l’option la plus économique est Colab Pro, qui fournit 40 Go de RAM et 40 Go de vRAM GPU (A100). Pour ce tutoriel, j’utilise Colab Pro :
Une fois la machine prête, passons à l’installation et au téléchargement du modèle. Si vous suivez en local, l’étape 0 consiste à créer un environnement virtuel :
$ conda create -n xgen -y
$ conda activate xgen
Pour télécharger le modèle depuis HuggingFace, il est nécessaire d’installer torch avec prise en charge du GPU. Voici la commande pour installer toutes les bibliothèques requises :
$ pip install torch torchvision torchaudio transformers[torch]
Nous aurons aussi besoin des bibliothèques suivantes pour l’étape de fine-tuning :
$ pip install accelerate peft bitsandbytes trl datasets --upgrade
N’oubliez pas de redémarrer le noyau après l’installation.
Je détaillerai chaque bibliothèque au moment de son utilisation.
Passons maintenant à une première exécution du modèle avec l’extrait ci-dessous.
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

tokenizer = AutoTokenizer.from_pretrained("Salesforce/xgen-7b-8k-base", trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained("Salesforce/xgen-7b-8k-base", torch_dtype=torch.bfloat16)

inputs = tokenizer("DataCamp is one he ...", return_tensors="pt")
sample = model.generate(**inputs, max_length=128)

print(tokenizer.decode(sample[0]))
La classe AutoTokenizer charge l’auto-tokenizer pour le modèle xgen-7b-4k-base (longueur 4098). La classe AutoModelForCausalLM sert à charger des modèles de génération de texte.
Nous définissons l’invite comme inputs et la passons à model.generate avec une longueur maximale de 128 jetons. Lors de la première exécution, le code prendra du temps car le modèle doit être téléchargé.
Voici la sortie obtenue :
DataCamp is one of the world’s leading providers of data science courses and training...Le début de la réponse est correct, mais la qualité se dégrade ensuite. Il faut l’affiner pour de meilleures performances.
Les LLM ne sont pas des modèles sklearn : on ne règle pas simplement quelques hyperparamètres en quelques lignes. Nous allons donc affiner XGen 7B en plusieurs étapes. Je vous conseille d’avancer sereinement : il y aura beaucoup de détails.
Notez que le flux de travail ci-dessous s’applique à de nombreux LLM sur HuggingFace, sous réserve de disposer des ressources de calcul adéquates.
C’est parti.
Nous avons déjà traité cette étape. Récapitulons les bibliothèques installées et leur utilité :
torch : bibliothèque PyTorch pour les tenseurs et réseaux de neurones ; accélération GPU.transformers : bibliothèque Hugging Face pour les modèles NLP pré-entraînés.datasets : chargement et préparation des données avec les jeux de données HuggingFace.accelerate : bibliothèque officielle HuggingFace pour simplifier l’entraînement distribué de LLM.peft : affiner une petite fraction des paramètres d’un LLM pour accélérer l’entraînement.bitsandbytes : optimisation mémoire et calcul pour LLM.trl : techniques d’affinage de grands modèles via RLHF (apprentissage par renforcement avec retour humain).Nous reviendrons sur les bénéfices de chaque bibliothèque lors de leur utilisation.
import os
import torch

from datasets import load_dataset
from transformers import (
   AutoModelForCausalLM,
   AutoTokenizer,
   BitsAndBytesConfig,
   TrainingArguments,
   pipeline,
)

from peft import LoraConfig
from trl import SFTTrainer
Aperçu des nouvelles classes et fonctions importées :
BitsAndBytesConfig : configuration d’optimisation des paramètres via des techniques « bits and bytes », pour gagner en mémoire et en efficacité de calcul.TrainingArguments : paramètres d’entraînement (taux d’apprentissage, batch size, etc.) pour l’affinage.pipeline : facilite l’application des modèles à des tâches comme la génération de texte.LoraConfig : configuration de LoRA (Low-Rank Adaptation), une méthode d’affinage efficace en paramètres.SFTTrainer : classe d’entraînement pour le fine-tuning supervisé (SFT), utile avec des données étiquetées ou du feedback humain.# Model from HF
base_model = "Salesforce/xgen-7b-8k-base"
# New instruction dataset
guanaco_dataset = "mlabonne/guanaco-llama2-1k"
# Fine-tuned model
new_model = "xgen-7b-8k-tuned"
Pour le jeu de données, nous utiliserons Guanaco LLaMA2, qui contient 1 000 paires instruction‑réponse pour adapter les LLM à des tâches interactives et d’instruction (type chatbots).
dataset = load_dataset(guanaco_dataset, split="train")Pour charger les données depuis HuggingFace, on utilise load_dataset en spécifiant le chemin et le split. On peut visualiser des exemples en accédant au champ texte et en indexant une paire au hasard :
>>> dataset["text"][89]

<s>[INST] In England, what vegetable is referred to as a rocket? [/INST] The species name for "rocket" is "Eruca vesicaria", and it's also sometimes called "eruca".
However, other countries have different names for it:
* Arugula - America
* Garden Rocket or Rocket - Britain, Australia, South Africa, Ireland, New Zealand

Other names include "ruchetta", "rucola", "rucoli", "rugula", "colewoort", and "roquette".

The word transferred from Latin to Italian to English, which might explain the variants with similar pronunciation. </s>
La quantification est une technique puissante en apprentissage automatique qui réduit le nombre de bits nécessaires pour représenter les données, en les approchant avec moins de bits pour une représentation plus compacte.
Elle peut réduire l’empreinte mémoire d’un modèle, améliorer l’efficacité de calcul et, parfois, même la précision.
compute_dtype = torch.float16

quant_config = BitsAndBytesConfig(
   load_in_4bit=True,
   bnb_4bit_quant_type="nf4",
   bnb_4bit_compute_dtype=compute_dta
D’abord, nous fixons le type de données pour chaque tenseur à float16 via compute_dtype. Puis, avec BitsAndBytesConfig, nous définissons :
load_in_4bit=True : quantification d’entrée en 4 bits.bnb_4bit_compute_dtype=compute_dtype : type numérique utilisé pour les calculs (float16).bnb_4bit_quant_type="nf4" : type de quantification 4 bits, ici "nf4".nf4 désigne une quantification non uniforme en 4 bits, parfois plus performante que la quantification uniforme.
model = AutoModelForCausalLM.from_pretrained(
   base_model,
   quantization_config=quant_config,
   device_map="auto"
)
Cette étape ressemble au téléchargement initial d’XGen, mais nous passons ici les paramètres de quantification via quantization_config et nous fixons device_map à auto afin d’utiliser automatiquement le GPU.
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"
Après le chargement, nous configurons le jeton de padding. En NLP, les jetons de bourrage sont des symboles sans signification ajoutés pour aligner les séquences à une taille fixe, souvent requise par l’architecture.
tokenizer.pad_token = tokenizer.eos_token fait du jeton de fin de phrase (EOS) le jeton de padding, pratique pour distinguer fin de phrase et bourrage. tokenizer.padding_side = "right" indique que le padding se fait à droite.
peft_params = LoraConfig(
   lora_alpha=16,
   lora_dropout=0.1,
   r=64,
   bias="none",
   task_type="CAUSAL_LM",
)
Les LLM pré-entraînés exigent énormément de données et de calcul pour être affutés. Avec la méthode PEFT (Parameter-Efficient Fine-Tuning), on n’entraîne qu’une petite fraction des paramètres, ce qui réduit fortement les coûts. Plus de détails dans la documentation officielle.
La classe LoraConfig fixe les paramètres de LoRA, la méthode de factorisation à rang faible utilisée en PEFT. L’extrait ci-dessus contrôle notamment l’intensité d’adaptation, le nombre de paramètres entraînables et d’autres aspects des couches.
training_params = TrainingArguments(
   output_dir="./results",
   num_train_epochs=1,
   per_device_train_batch_size=1,
   gradient_accumulation_steps=1,
   optim="paged_adamw_32bit",
   learning_rate=2e-4,
   weight_decay=0.001,
   fp16=False,
   bf16=False,
   max_grad_norm=0.3,
   max_steps=-1,
   warmup_ratio=0.03,
   group_by_length=True,
   lr_scheduler_type="constant",
)
Au-delà de tout ce que nous avons défini, l’affinage d’XGen requiert encore une douzaine de paramètres : taux d’apprentissage, scheduler, nombre d’époques, optimiseur, ainsi que warmup_ratio, fp16, bf16, weight_decay, etc.
Pour rester concis, nous ne les détaillons pas ici ; référez-vous à cet excellent article sur l’affinage de LLaMA2 qui les explique.
Pour affiner un modèle PEFT, nous allons utiliser la classe SFTTrainer (Supervised Fine-Tuning) de la bibliothèque trl, élément clé du RLHF.
trainer = SFTTrainer(
   model=model,
   train_dataset=dataset,
   peft_config=peft_params,
   dataset_text_field="text",
   max_seq_length=None,
   tokenizer=tokenizer,
   args=training_params,
   packing=False,
)
Pour initialiser l’entraîneur, on lui transmet le modèle, le jeu d’entraînement, les paramètres PEFT, les paramètres d’entraînement et le tokenizer. Il suffit ensuite d’appeler .train() :
trainer.train()
Selon les paramètres (notamment le nombre d’époques), l’entraînement peut durer de 15 minutes à plusieurs heures.
Une fois l’entraînement terminé, testons le modèle affuté :
prompt = "Who wrote Python?"
pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, max_length=200)

result = pipe(f"<s>[INST] {prompt} [/INST]")
print(result[0]['generated_text'])
Avant de transmettre l’invite au model affuté, nous injectons le model et le tokenizer dans un pipeline. Cette fonction charge le modèle pré-entraîné, prétraite l’entrée via le tokenizer et applique éventuellement un post-traitement.
Ici, nous utilisons un prompt formaté et encadré par <s>[INST] {prompt} [/INST], exactement comme durant l’entraînement. Résultat :
<s>[INST] Who wrote Python? [/INST] Python was created by Guido van Rossum, a Dutch computer programmer. He started working on the language in the late 1980s and released the first version in 1991. </s>

Python is a high-level, general-purpose programming language that is widely used in various fields, including data science, machine learning, and web development. It is known for its readability, flexibility, and ease of use, making it a popular choice for beginners and experienced developers alike. </s>

Python is an open-source language, meaning that anyone can access and modify the source code, making it a popular choice for developers who want to contribute to the community. </s>...
Une fois satisfait des résultats, on peut sauvegarder :
trainer.model.save_pretrained(new_model)
trainer.tokenizer.save_pretrained(new_model)
Vous pourrez le recharger via AutoModelForCausalLM :
fine_tuned_xgen = AutoModelForCausalLM.from_pretrained(new_model, ...)
Démarrer avec des Large Language Models (LLM) comme XGen 7B de Salesforce est relativement simple, mais les adapter à des besoins spécifiques est plus exigeant. Notre expérience d’affinage d’XGen 7B sur un petit jeu de données d’instruction l’illustre bien. Adapter le modèle à différentes tâches suppose d’accéder à des jeux de données adéquats (disponibles via la bibliothèque datasets de Hugging Face) et à des ressources de calcul capables de gérer l’entraînement d’un modèle à 7 milliards de paramètres.
Le processus d’affinage se résume en ces étapes :
bitsandbytestransformersLoraConfigtransformersSFTTrainer de trlSi certains concepts ou extraits de code restent flous, je vous recommande ces ressources :
Merci de votre lecture !
Démarrez votre parcours IA aujourd’hui !
Cours
Cours
Cours