Curso
Conceitos de Grandes Modelos de Linguagem (LLMs)
2 h
109.8K
Neste momento, estes seis estão entre os LLMs open source mais em alta:
E todos compartilham a mesma desvantagem — janelas de contexto muito curtas, chegando a no máximo 2048 tokens. Comparados a modelos proprietários como GPT-3.5 e GPT-4, que oferecem até 32k tokens (o equivalente a 50 páginas de texto!), os LLMs open source parecem em clara desvantagem.
Comprimento de contexto é basicamente a “memória” dos LLMs. Uma janela de 2048 tokens significa que o modelo só consegue “lembrar” 2048 tokens da conversa por vez. Isso impacta bastante o desempenho em tarefas que exigem muito contexto, como sumarização, tradução, geração de código etc.
Para enfrentar esse problema crítico, a Salesforce anunciou o XGen-7B, com uma janela de contexto de 8k tokens (4 vezes maior que a de LLMs similares). Este artigo apresenta as principais características do modelo e mostra como usá-lo e afiná-lo em um conjunto de dados de exemplo.
Para muita gente, estatísticas como comprimento de contexto só fazem sentido quando viram benefícios concretos. Então, aqui vão alguns dos principais recursos e o impacto que podem ter nos seus projetos:
Apesar do tamanho relativamente pequeno de 7 bilhões de parâmetros, o XGen entrega bem mais do que se espera — com desempenho que rivaliza ou supera modelos muito maiores. Essa eficiência muda o jogo para desenvolvedores e pesquisadores, permitindo rodar e implantar aplicações de IA de ponta diretamente em máquinas locais robustas, sem depender de grandes recursos de nuvem. Esse equilíbrio entre tamanho e performance torna o XGen especialmente atrativo para um público amplo, de startups a pesquisadores acadêmicos.
Considerando diferentes necessidades, o XGen oferece três versões, cada uma indicada para aplicações específicas:
A força do modelo aparece nos benchmarks. O XGen lidera em conjuntos diversos como MMLU, HumanEval e outros, quando comparado a modelos de tamanho similar. Para uma análise detalhada, o post de anúncio traz um panorama completo dos resultados do XGen.
Correndo o risco de soar repetitivo, vale reforçar: o XGen é altamente otimizado para tarefas que exigem janelas de contexto grandes. Isso é crucial para aplicações como sumarização detalhada de documentos, em que entender o texto como um todo é vital para gerar resumos precisos. Da mesma forma, em perguntas e respostas abrangentes e geração de conteúdo longo, a capacidade do XGen de processar grandes quantidades de informação resulta em saídas mais coerentes e relevantes.
Como o XGen alcança esses resultados impressionantes? Claro, a resposta está nas técnicas de treinamento e otimização usadas pelos pesquisadores de IA da Salesforce.
A estratégia de treinamento do XGen tem duas etapas. Na etapa 1, um modelo do zero é treinado com 1,37 trilhão de tokens, combinando linguagem natural e código.
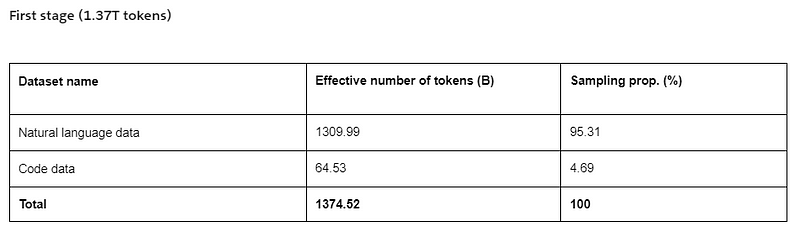
Na etapa 2, mais 55 bilhões de tokens de código foram usados para aprimorar a geração de código:
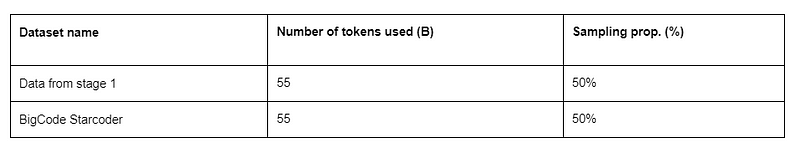
O treinamento foi feito com uma biblioteca interna chamada JaxFormer, projetada para treinamento eficiente de LLMs com paralelização de dados e de modelo em hardware TPU-v4.
Apesar de ser “pequeno”, o XGen 7B ainda é bem grande em termos de redes neurais. Para rodá-lo sem nuvem, você vai precisar de uma máquina local robusta. O principal requisito é ter RAM suficiente, bem acima de 32 GB, já que o modelo tem ~30 GB para baixar do HuggingFace. Sobre GPUs, quanto mais potente, melhor.
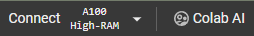
Se o seu PC não tem essas especificações, a opção mais em conta é o Colab Pro, que oferece 40 GB de RAM e 40 GB de vRAM de GPU (A100). Para este tutorial, estou usando o Colab Pro:
Depois de configurar uma máquina compatível, é hora de instalar e baixar o modelo. Se você estiver acompanhando localmente, o passo zero é criar um ambiente virtual:
$ conda create -n xgen -y
$ conda activate xgen
Para baixar o modelo do HuggingFace, é obrigatório ter o torch com suporte a GPU instalado. Aqui está o comando para instalar todas as bibliotecas necessárias:
$ pip install torch torchvision torchaudio transformers[torch]
Também vamos precisar das seguintes bibliotecas para a etapa de fine-tuning:
$ pip install accelerate peft bitsandbytes trl datasets --upgrade
Não esqueça de reiniciar o kernel após instalar as bibliotecas.
Vou explicar cada biblioteca quando chegarmos a essa parte.
Agora, vamos rodar o modelo pela primeira vez com o snippet a seguir.
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

tokenizer = AutoTokenizer.from_pretrained("Salesforce/xgen-7b-8k-base", trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained("Salesforce/xgen-7b-8k-base", torch_dtype=torch.bfloat16)

inputs = tokenizer("DataCamp is one he ...", return_tensors="pt")
sample = model.generate(**inputs, max_length=128)

print(tokenizer.decode(sample[0]))
A classe AutoTokenizer carrega o autotokenizer para o modelo de comprimento 4098 xgen-7b-4k-base. A classe AutoModelForCausalLM carrega modelos para geração de texto.
Especificamos o prompt como inputs e o desempacotamos dentro do model.generate, definindo um comprimento máximo de 128 tokens. Na primeira execução, o código acima vai demorar um pouco, pois o modelo precisa ser baixado.
Aqui está a saída que recebi no final:
DataCamp is one of the world’s leading providers of data science courses and training...O começo da resposta está ok, mas vai piorando aos poucos. Precisamos ajustar para melhorar o desempenho.
LLMs não são como modelos do sklearn — não dá para ajustar hiperparâmetros em poucas linhas. Então vamos fazer o fine-tuning do XGen 7B em várias etapas. Minha sugestão é ir com calma, porque teremos muitos detalhes.
Vale notar que o fluxo abaixo funciona para muitos LLMs no HuggingFace, desde que você tenha poder computacional suficiente.
Vamos lá.
Já cobrimos esta etapa antes. Então, vamos revisar as bibliotecas instaladas e por que precisamos delas:
torch: biblioteca PyTorch para tensores e redes neurais; habilita aceleração por GPU.transformers: biblioteca da Hugging Face para modelos de NLP pré-treinados.datasets: para carregamento e processamento fácil de dados com datasets do HuggingFace.accelerate: biblioteca oficial da HuggingFace que simplifica treinamento distribuído de LLMs.peft: pacote para ajustar uma fração dos parâmetros do LLM e acelerar o treinamento.bitsandbytes: biblioteca de otimização de LLMs em memória e computação.trl: técnicas para ajustar modelos grandes usando RLHF (aprendizado por reforço com feedback humano).Vamos explicar os benefícios de cada biblioteca quando começarmos a usá-las.
import os
import torch

from datasets import load_dataset
from transformers import (
   AutoModelForCausalLM,
   AutoTokenizer,
   BitsAndBytesConfig,
   TrainingArguments,
   pipeline,
)

from peft import LoraConfig
from trl import SFTTrainer
Aqui está um panorama das novas classes e funções importadas:
BitsAndBytesConfig: configuração para otimizar parâmetros do modelo com técnicas de bits and bytes, melhorando eficiência de memória e computação.TrainingArguments: define parâmetros de treinamento (por exemplo, taxa de aprendizado, batch size) para fine-tuning.pipeline: simplifica a aplicação de modelos em tarefas como geração de texto.LoraConfig: configuração do LoRA (Low-Rank Adaptation), método de fine-tuning eficiente em parâmetros que ajusta um conjunto reduzido de parâmetros.SFTTrainer: classe de treinamento para Supervised Fine-Tuning (SFT), facilitando o treinamento com feedback humano ou datasets rotulados.# Model from HF
base_model = "Salesforce/xgen-7b-8k-base"
# New instruction dataset
guanaco_dataset = "mlabonne/guanaco-llama2-1k"
# Fine-tuned model
new_model = "xgen-7b-8k-tuned"
Para o dataset, usaremos o Guanaco LLaMA2, que contém 1000 pares instrução-resposta para ajustar LLMs a tarefas interativas e instrucionais (pense em chatbots).
dataset = load_dataset(guanaco_dataset, split="train")Para carregar os dados do HuggingFace, usamos a função load_dataset informando o caminho e o split do dataset. Dá para visualizar amostras convertendo para texto e indexando um par instrução-resposta aleatório:
>>> dataset["text"][89]

<s>[INST] In England, what vegetable is referred to as a rocket? [/INST] The species name for "rocket" is "Eruca vesicaria", and it's also sometimes called "eruca".
However, other countries have different names for it:
* Arugula - America
* Garden Rocket or Rocket - Britain, Australia, South Africa, Ireland, New Zealand

Other names include "ruchetta", "rucola", "rucoli", "rugula", "colewoort", and "roquette".

The word transferred from Latin to Italian to English, which might explain the variants with similar pronunciation. </s>
Quantização é uma técnica poderosa em machine learning para reduzir a quantidade de bits necessários para representar dados. Isso é feito ao aproximar os dados originais com menos bits, gerando uma representação mais compacta.
A quantização pode reduzir o consumo de memória de um modelo, melhorar a eficiência computacional e, às vezes, até melhorar a acurácia.
compute_dtype = torch.float16

quant_config = BitsAndBytesConfig(
   load_in_4bit=True,
   bnb_4bit_quant_type="nf4",
   bnb_4bit_compute_dtype=compute_dta
Primeiro, definimos o tipo de dado de cada tensor com compute_dtype para float16. Em seguida, com o BitsAndBytesConfig, definimos os parâmetros de quantização:
load_in_4bit=True: especifica que a entrada será quantizada em 4 bits.bnb_4bit_compute_dtype=compute_dtype: especifica o tipo de dado para os cálculos, definido como float16 acima.bnb_4bit_quant_type="nf4": especifica o tipo de quantização de 4 bits, neste caso "nf4".nf4 se refere a um tipo específico de quantização não uniforme com 4 bits. Em alguns casos, a quantização não uniforme supera a uniforme.
model = AutoModelForCausalLM.from_pretrained(
   base_model,
   quantization_config=quant_config,
   device_map="auto"
)
Este passo é semelhante ao download inicial do XGen, mas agora passamos os parâmetros de quantização em quantization_config e definimos device_map como auto para usar a GPU automaticamente.
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"
Depois de carregar o tokenizer, configuramos os parâmetros de padding. Em PLN, tokens de padding são símbolos especiais sem significado adicionados às entradas para que todas tenham o mesmo tamanho. Tamanhos fixos de sequência são requisito para muitas arquiteturas.
tokenizer.pad_token = tokenizer.eos_token define o token de padding igual ao token de fim de sentença (EOS). É uma prática comum porque ajuda o modelo a distinguir fim de sentença de padding. tokenizer.padding_side = "right" indica que o padding deve ser adicionado à direita.
peft_params = LoraConfig(
   lora_alpha=16,
   lora_dropout=0.1,
   r=64,
   bias="none",
   task_type="CAUSAL_LM",
)
LLMs pré-treinados exigem muitos dados e computação para ajuste fino. Com o Parameter-efficient Fine-Tuning (PEFT), ajustamos só uma fração dos parâmetros totais, reduzindo bastante o tempo de execução. Você pode ler mais na documentação oficial.
A classe LoraConfig define as configurações do método LoRA (uma forma de parametrização usada em PEFT). No geral, o snippet acima controla a força de adaptação das camadas LoRA, o número de parâmetros treináveis e outros aspectos.
training_params = TrainingArguments(
   output_dir="./results",
   num_train_epochs=1,
   per_device_train_batch_size=1,
   gradient_accumulation_steps=1,
   optim="paged_adamw_32bit",
   learning_rate=2e-4,
   weight_decay=0.001,
   fp16=False,
   bf16=False,
   max_grad_norm=0.3,
   max_steps=-1,
   warmup_ratio=0.03,
   group_by_length=True,
   lr_scheduler_type="constant",
)
Além do que já definimos, fazer fine-tuning do XGen exige mais uma dúzia de parâmetros de treinamento. Incluem parâmetros conhecidos como taxa de aprendizado, scheduler, número de épocas, otimizadores, e alguns novos, como warmup_ratio, fp16, bf16, weight_decay etc.
Para manter o foco, não vamos detalhar todos. Recomendo este ótimo artigo sobre fine-tuning do LLaMA2 que explica cada um.
Para fazer o fine-tuning com PEFT, usaremos a classe SFTTrainer (Supervised Fine-Tuning) da biblioteca trl, etapa-chave no RLHF.
trainer = SFTTrainer(
   model=model,
   train_dataset=dataset,
   peft_config=peft_params,
   dataset_text_field="text",
   max_seq_length=None,
   tokenizer=tokenizer,
   args=training_params,
   packing=False,
)
Para iniciar o trainer, passamos o modelo, o dataset de treino, os parâmetros de PEFT, os parâmetros de treinamento e o tokenizer. Para lançar o processo de fine-tuning, basta chamar .train():
trainer.train()
Dependendo dos parâmetros (especialmente número de épocas), o treinamento pode levar de 15 minutos a algumas horas.
Assim que o treinamento terminar, podemos testar o modelo ajustado:
prompt = "Who wrote Python?"
pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, max_length=200)

result = pipe(f"<s>[INST] {prompt} [/INST]")
print(result[0]['generated_text'])
Antes de passar o prompt ao model ajustado, primeiro criamos um pipeline com o model e o tokenizer. A função pipeline carrega modelos pré-treinados, pré-processa a entrada com o tokenizer e aplica (se houver) pós-processamentos no texto gerado.
Acima, executamos o pipeline com um prompt formatado e envolto em <s>[INST] {prompt} [/INST], exatamente como nas instruções usadas durante o treino. Veja o resultado:
<s>[INST] Who wrote Python? [/INST] Python was created by Guido van Rossum, a Dutch computer programmer. He started working on the language in the late 1980s and released the first version in 1991. </s>

Python is a high-level, general-purpose programming language that is widely used in various fields, including data science, machine learning, and web development. It is known for its readability, flexibility, and ease of use, making it a popular choice for beginners and experienced developers alike. </s>

Python is an open-source language, meaning that anyone can access and modify the source code, making it a popular choice for developers who want to contribute to the community. </s>...
Quando você estiver satisfeito com o modelo, é só salvá-lo:
trainer.model.save_pretrained(new_model)
trainer.tokenizer.save_pretrained(new_model)
Você pode carregá-lo de volta usando a classe AutoModelForCausalLM novamente:
fine_tuned_xgen = AutoModelForCausalLM.from_pretrained(new_model, ...)
Começar com LLMs como o XGen 7B da Salesforce é relativamente simples, mas personalizá-los para necessidades específicas é mais complexo. A experiência de fazer fine-tuning do XGen 7B em um pequeno dataset instrucional mostra esse desafio. Adaptar o modelo a várias tarefas exige acesso a datasets relevantes (disponíveis pela biblioteca datasets da Hugging Face) e recursos computacionais capazes de treinar um modelo com 7 bilhões de parâmetros nesses conjuntos.
O processo de fine-tuning pode ser resumido nestes passos:
bitsandbytestransformersLoraConfigtransformersSFTTrainer do trlSe algum conceito ou snippet ainda parece estranho, recomendo estes ótimos recursos:
Obrigado pela leitura!
Comece sua jornada em IA hoje!
Curso
Curso
Curso
blog
Richie Cotton
7 min
blog
Abid Ali Awan
13 min
Tutorial
Josep Ferrer
11 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Arunn Thevapalan
12 min