
Last chance! 50% off DataCamp Premium
Sale ends in
Anda membandingkan skor SAT tahun 2020 dengan skor ACT pada tahun yang sama. Seorang siswa meraih 1200 pada SAT sementara yang lain mendapat 24 pada ACT, tetapi kinerja mana yang lebih baik? Inilah tepatnya masalah yang dipecahkan oleh z-score dengan mengonversi berbagai pengukuran ke skala yang sama.
Z-score mengubah data mentah menjadi nilai yang terstandarisasi, sehingga memungkinkan perbandingan yang bermakna di antara distribusi yang sama sekali berbeda. Standardisasi ini membantu saat Anda menganalisis data dari berbagai sumber, mengidentifikasi outlier, atau menghitung probabilitas dalam analisis statistik. Kami akan membahas dasar matematis di balik z-score, menelusuri metode perhitungan praktis langkah demi langkah, dan menerapkan teknik-teknik ini pada berbagai skenario.
Z-score memberi Anda cara yang terstandarisasi untuk memahami di mana posisi suatu titik data relatif terhadap distribusinya.
Z-score merepresentasikan jumlah simpangan baku suatu titik data dari mean distribusinya. Rumusnya sederhana:
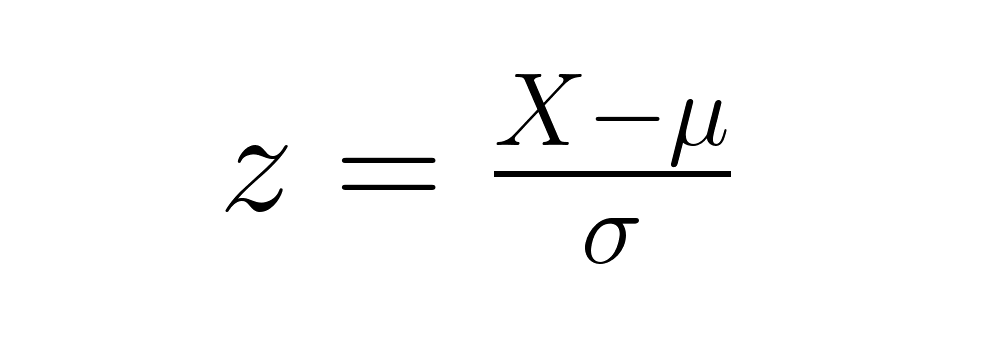
di mana X adalah skor mentah Anda, μ (mu) adalah mean populasi, dan σ (sigma) adalah simpangan baku populasi. Z-score memungkinkan Anda membandingkan titik data dari distribusi berbeda secara langsung, terlepas dari satuan atau skala aslinya.
Z-score mengubah data yang berdistribusi normal menjadi distribusi normal standar yang merupakan kurva lonceng khusus dengan mean = 0 dan simpangan baku = 1. Transformasi ini membuka kemampuan analitis yang berguna: sekitar 68% nilai berada dalam satu simpangan baku dari mean (z-score antara -1 dan +1), 95% dalam dua simpangan baku (-2 hingga +2), dan 99,7% dalam tiga simpangan baku (-3 hingga +3).
Rumus z-score dasar bekerja baik untuk data populasi, tetapi analisis dunia nyata sering memerlukan sedikit modifikasi bergantung pada jenis data dan ukuran sampel Anda.
Seperti diperkenalkan sebelumnya, rumus dasar z-score adalah:
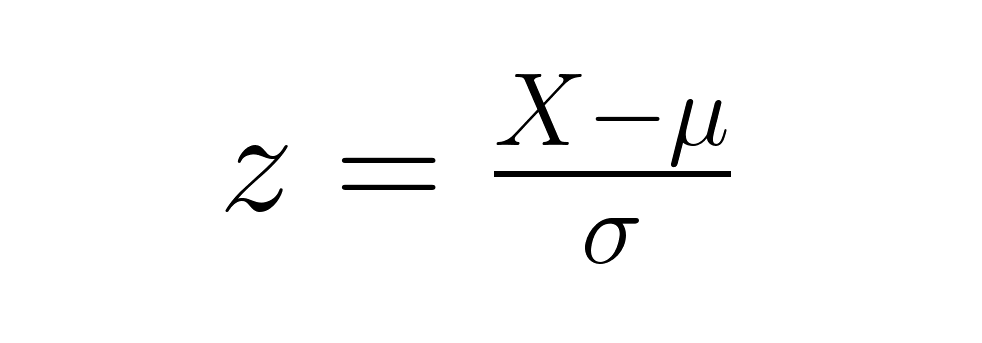
Dari titik awal ini, variasi muncul bergantung pada apakah Anda bekerja dengan data sampel atau menguji mean sampel terhadap mean populasi.
Untuk titik data individual dalam sebuah sampel:
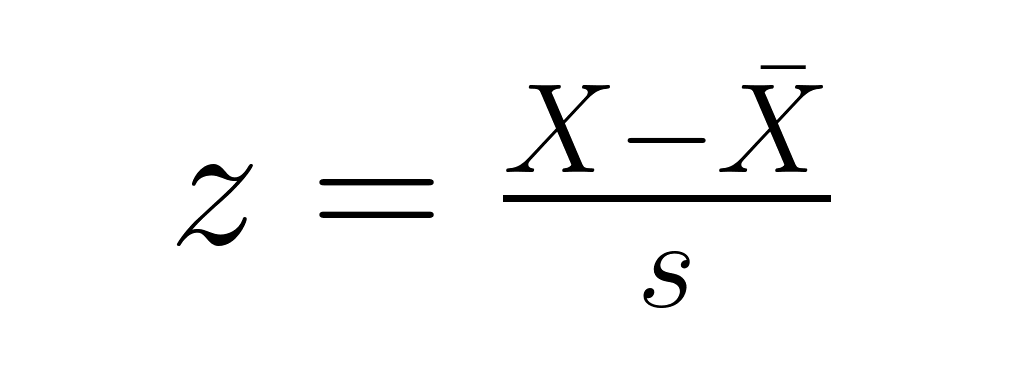
di mana X̄ adalah mean sampel dan s adalah simpangan baku sampel (dihitung dengan penyebut n−1). Versi ini menunjukkan berapa banyak simpangan baku sampel suatu titik dari mean sampel, yang berguna untuk mengidentifikasi posisi relatif dan potensi outlier dalam dataset Anda.
Saat menguji apakah mean sampel berbeda secara signifikan dari mean populasi, kita menggunakan galat baku mean dalam perhitungan:
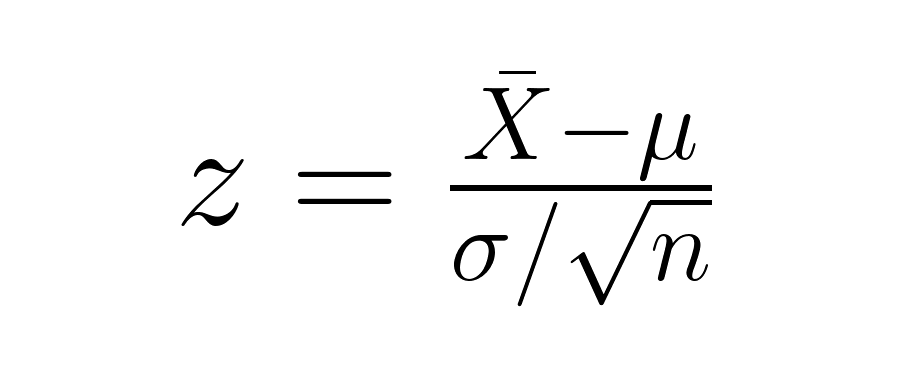
di mana X̄ adalah mean sampel Anda, μ adalah mean populasi, σ adalah simpangan baku populasi, dan n adalah ukuran sampel Anda. Penyebut (σ/√n) merepresentasikan galat baku mean, yang memperhitungkan ukuran sampel dalam pengujian hipotesis.
Terkadang Anda bekerja mundur dari z-score untuk menemukan nilai asli. Menata ulang rumus memberi Anda:
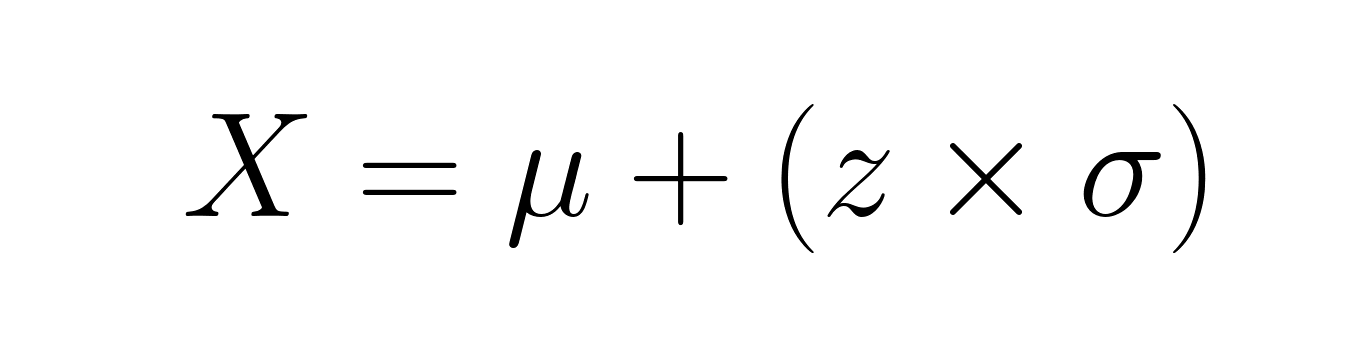
Jika skor ujian seorang siswa memiliki z-score 1,5 pada ujian dengan mean 75 dan simpangan baku 10, skor aktualnya adalah 75 + (1,5 × 10) = 90.
Mengonversi data mentah ke z-score melibatkan proses sistematis yang akan menjadi kebiasaan dengan latihan.
Berikut cara menghitung z-score secara manual: Pertama, temukan mean distribusi Anda dengan menjumlahkan semua nilai dan membaginya dengan jumlah data. Selanjutnya, hitung simpangan baku dengan mencari akar kuadrat dari rata-rata kuadrat selisih terhadap mean. Terakhir, terapkan rumus z-score dengan mengurangkan mean dari skor mentah Anda dan membaginya dengan simpangan baku.
Mari kita telusuri sebuah contoh: Jika skor ujian 85, 92, 78, 96, 88 mewakili dataset lengkap kita (mean = 87,8, simpangan baku = 6,14), skor 92 memiliki z-score sebesar (92 - 87,8) / 6,14 = 0,68.
Anda juga dapat menghitung z-score dengan cepat menggunakan fungsi STANDARDIZE() di Excel atau fungsi yang sama di Google Sheets, digabungkan dengan AVERAGE() dan STDEV.P() untuk data populasi atau STDEV.S() untuk data sampel.
Interpretasi z-score mengikuti aturan arah yang konsisten terlepas dari data asli Anda. Z-score positif menunjukkan nilai di atas mean, sementara z-score negatif menunjukkan nilai di bawah mean. Z-score 0 berarti titik data Anda sama persis dengan mean.
Untuk data yang berdistribusi normal, Anda dapat menerapkan pedoman interpretatif tambahan: nilai dengan z-score melampaui ±2 tergolong tidak biasa (terjadi sekitar 5% kasus), sementara z-score melampaui ±3 tergolong jarang (kurang dari 1% probabilitas). Anda dapat menemukan persentil yang tepat untuk distribusi normal menggunakan z-table, yang menunjukkan persentase observasi yang berada di bawah z-score tertentu.
Untuk data non-normal, z-score tetap menunjukkan posisi relatif dan membantu mengidentifikasi potensi outlier, tetapi persentase spesifiknya tidak berlaku.
Memahami hubungan antara z-score dan simpangan baku membantu Anda menangkap apa yang sebenarnya diwakili oleh nilai-nilai terstandarisasi ini.
Z-score secara langsung mengukur jarak dari mean dalam satuan simpangan baku. Z-score sebesar 2,5 berarti titik data Anda berada 2,5 simpangan baku di atas mean. Ini berbeda dari simpangan baku itu sendiri, yang mengukur sebaran tipikal data di sekitar mean.
Simpangan baku menggambarkan variabilitas dalam satu dataset, sementara z-score memungkinkan perbandingan lintas dataset yang berbeda dengan mean dan penyebaran yang berbeda. Anggap simpangan baku sebagai pengukur "lebar" distribusi Anda, sedangkan z-score memberi tahu Anda persis di mana titik-titik individual berada dalam lebar tersebut.
Untuk data yang berdistribusi normal, z-table mengonversi z-score menjadi peringkat persentil, menunjukkan persentase observasi yang berada di bawah nilai Anda. Dalam distribusi normal, z-score 1,0 berkaitan dengan persentil ke-84, yang berarti 84% observasi lebih kecil.
Kalkulator online modern dan perangkat lunak statistik membuat konversi ini seketika untuk distribusi normal. Namun, untuk data non-normal, Anda memerlukan metode spesifik distribusi untuk menentukan persentil, karena persentase standar pada z-table tidak berlaku.
Z-score muncul di seluruh statistik dan ilmu data, memecahkan masalah praktis di berbagai bidang.
Z-score membentuk dasar perhitungan probabilitas dalam distribusi normal. Saat Anda ingin mencari probabilitas memperoleh skor di atas 600 pada skor ujian yang berdistribusi normal dengan mean 500 dan simpangan baku 100, Anda terlebih dahulu mengonversi 600 menjadi z-score 1,0, lalu melihat probabilitas yang sesuai (sekitar 16%). Anda juga dapat menghitung probabilitas di antara dua z-score dengan mencari selisih antara probabilitas kumulatifnya.
Dalam pengujian hipotesis, z-score membantu menentukan signifikansi statistik dengan membandingkan statistik sampel dengan nilai populasi yang diharapkan di bawah asumsi kenormalan. Kursus Hypothesis Testing in R kami membahas aplikasi ini, menunjukkan bagaimana z-score terhubung dengan p-value dan interval kepercayaan.
Data scientist secara rutin menggunakan z-score untuk mengidentifikasi potensi outlier. Untuk data yang berdistribusi normal, nilai dengan z-score melampaui ±3 sangat tidak biasa (terjadi kurang dari 1% waktu) dan sering menunjukkan kesalahan entri data, masalah pengukuran, atau kasus yang benar-benar luar biasa yang layak diselidiki. Bahkan dengan data non-normal, z-score yang ekstrem dapat menandai observasi yang perlu diperiksa lebih dekat.
Menstandarkan seluruh dataset dengan z-score menghasilkan variabel dengan mean 0 dan simpangan baku 1, sehingga dapat dibandingkan secara langsung. Ini sangat berharga dalam algoritma pembelajaran mesin yang sensitif terhadap perbedaan skala, seperti k-means clustering atau neural network.
Z-score memungkinkan perbandingan adil di antara tes atau pengukuran berbeda dengan bentuk distribusi yang serupa. Perbandingan SAT versus ACT sebelumnya menjadi sederhana setelah Anda mengonversi kedua skor menjadi z-score menggunakan mean dan simpangan baku masing-masing. Seorang siswa dengan z-score SAT 1,2 berkinerja lebih baik daripada seseorang dengan z-score ACT 0,8, terlepas dari perbedaan skala.
Z-score muncul dalam teknik analitis canggih seperti analisis klaster (di mana standardisasi memastikan semua variabel berkontribusi secara setara), multidimensional scaling, dan principal components analysis.
Dalam analisis regresi, koefisien terstandarisasi (juga disebut koefisien beta) membantu Anda membandingkan pentingnya relatif prediktor kontinu dengan menempatkannya pada skala yang sama. Prosesnya melibatkan pengonversian semua variabel (baik prediktor maupun keluaran) ke z-score sebelum menjalankan regresi. Koefisien terstandarisasi yang dihasilkan memberi tahu Anda "berapa banyak simpangan baku keluaran diperkirakan berubah saat prediktor ini meningkat satu simpangan baku?" sehingga memungkinkan perbandingan langsung di antara prediktor dengan satuan asli yang berbeda.
Tenaga medis menggunakan z-score untuk menafsirkan hasil tes dengan membandingkannya terhadap data populasi referensi. Z-score kepadatan tulang membandingkan pengukuran individu dengan rekan sebaya yang seumur, membantu mendiagnosis kondisi seperti osteoporosis. Penilaian pendidikan mengandalkan z-score untuk menstandardisasi hasil tes lintas tahun dan populasi berbeda, sehingga memungkinkan perbandingan yang adil meski kondisi tes bervariasi.
Analisis modern mengandalkan alat perangkat lunak yang mengotomatiskan perhitungan z-score.
Z-table tradisional tetap berguna untuk memahami hubungan antara z-score dan probabilitas dalam distribusi normal. Tabel-tabel ini mencantumkan probabilitas kumulatif untuk nilai distribusi normal standar, biasanya berkisar dari z = -3,49 hingga z = 3,49. Untuk membaca z-table, temukan dua digit pertama z-score Anda di kolom kiri, lalu cari digit ketiga di baris atas.
Kami telah membahas fungsi STANDARDIZE() di Excel sebelumnya pada bagian perhitungan langkah demi langkah. Untuk Python dan R, mari kita telusuri contoh yang sama menggunakan skor ujian: 85, 92, 78, 96, 88.
Python dengan scipy.stats:
import numpy as np
from scipy import stats

# Our exam scores
scores = np.array([85, 92, 78, 96, 88])

# Calculate z-scores using scipy (uses population std by default)
# This means dividing by N, not N-1
z_scores = stats.zscore(scores)
print(f"Z-scores: {z_scores}")
# Output: [-0.46  0.68 -1.59  1.33  0.03]

# Manual calculation for verification
mean_score = np.mean(scores)
std_score = np.std(scores, ddof=0)  # Population standard deviation
z_manual = (scores - mean_score) / std_score
print(f"Manual z-scores: {z_manual}")
R menggunakan fungsi scale():
# Our exam scores
scores <- c(85, 92, 78, 96, 88)

# Calculate z-scores using scale() (uses sample std by default)
z_scores <- scale(scores)[,1]  # Extract vector from matrix
print(paste("Z-scores:", z_scores))
# Output: [-0.41  0.61 -1.43  1.19  0.03]

# Manual calculation for verification
z_manual <- (scores - mean(scores)) / sd(scores)
print(paste("Manual z-scores:", z_manual))
Perhatikan bahwa Python dan R memberikan hasil yang sedikit berbeda karena scipy.stats.zscore() menggunakan simpangan baku populasi (membagi dengan N) sedangkan scale() di R menggunakan simpangan baku sampel (membagi dengan N-1). Untuk skor kita 92, Python memberikan z-score 0,68 sedangkan R memberikan 0,61. Keduanya benar tergantung pada apakah Anda memperlakukan data Anda sebagai populasi lengkap atau sampel.
Z-score menyediakan jembatan antara data mentah dan interpretasi statistik yang bermakna. Z-score memungkinkan perbandingan yang adil lintas skala yang berbeda, mendukung perhitungan probabilitas ketika data mengikuti distribusi normal, dan membantu mengidentifikasi observasi tidak biasa yang layak diselidiki.
Nilai-nilai terstandarisasi ini mencakup dari analisis data dasar hingga aplikasi pembelajaran mesin tingkat lanjut, menjadikannya alat yang berguna bagi siapa pun yang bekerja dengan data kuantitatif. Jelajahi kursus Inference for Numerical Data in R kami untuk melihat teknik inferensi statistik dengan dataset nyata, dan kursus A/B Testing in R untuk metode pengujian hipotesis di mana konsep z-score sering diterapkan.
Belajar bersama DataCamp
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt




