
Corso
Introduzione alla statistica
4 ore
161.8K
Stai confrontando i punteggi SAT del 2020 con i punteggi ACT dello stesso anno. Uno studente ha ottenuto 1200 al SAT mentre un altro ha preso 24 all'ACT: quale performance è migliore? È proprio questo il problema che gli z-score risolvono, convertendo misure diverse su una scala comune.
Gli z-score trasformano i dati grezzi in valori standardizzati, rendendo possibili confronti significativi tra distribuzioni completamente diverse. Questa standardizzazione aiuta quando analizzi dati da fonti differenti, identifichi outlier o calcoli probabilità nell'analisi statistica. Vedremo le basi matematiche degli z-score, i metodi pratici di calcolo passo dopo passo e applicheremo queste tecniche a diversi scenari.
Gli z-score ti forniscono un modo standardizzato per capire dove si colloca un punto dati rispetto alla sua distribuzione.
Uno z-score rappresenta il numero di deviazioni standard di cui un punto dati si discosta dalla media della distribuzione. La formula è semplice:
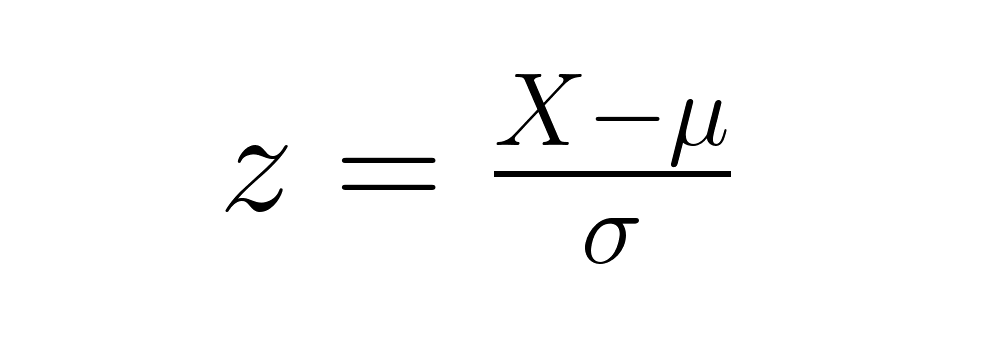
dove X è il punteggio grezzo, μ (mu) è la media della popolazione e σ (sigma) è la deviazione standard della popolazione. Gli z-score ti permettono di confrontare direttamente punti dati provenienti da distribuzioni diverse, indipendentemente dalle unità o scale originali.
Gli z-score trasformano dati normalmente distribuiti nella distribuzione normale standard, che è una particolare curva a campana con media = 0 e deviazione standard = 1. Questa trasformazione sblocca alcune capacità analitiche utili: circa il 68% dei valori cade entro una deviazione standard dalla media (z-score tra -1 e +1), il 95% entro due deviazioni standard (-2 a +2) e il 99,7% entro tre deviazioni standard (-3 a +3).
La formula base dello z-score funziona bene per dati di popolazione, ma nelle analisi reali spesso servono piccole modifiche a seconda del tipo di dato e della dimensione del campione.
Come visto in precedenza, la formula di base per uno z-score è:
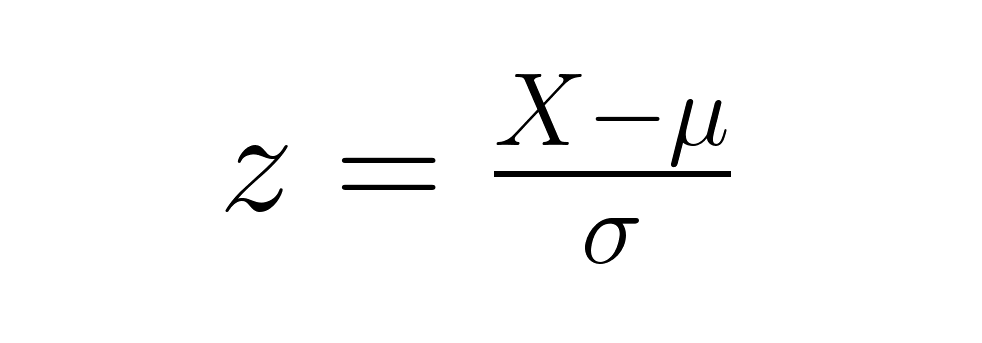
Da questo punto di partenza, sorgono variazioni a seconda che tu stia lavorando con dati campionari o testando una media campionaria rispetto a una media di popolazione.
Per punti dati individuali in un campione:
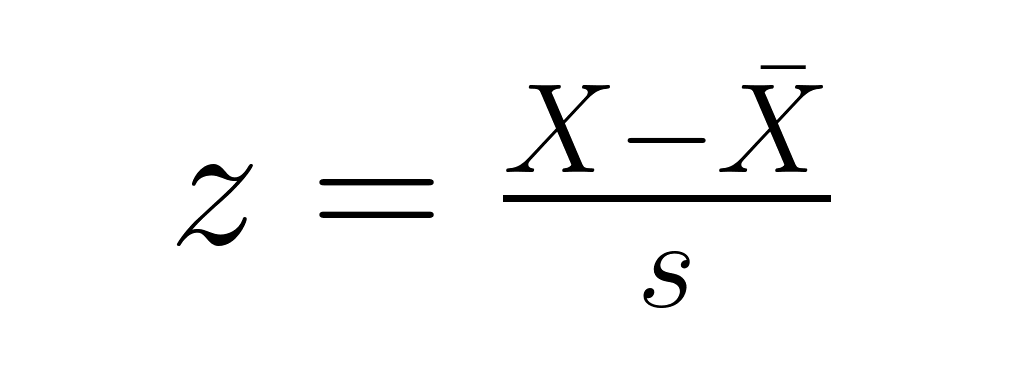
dove X̄ è la media campionaria e s è la deviazione standard campionaria (calcolata con denominatore n−1). Questa versione mostra di quante deviazioni standard campionarie un punto si discosta dalla media campionaria, utile per identificare posizioni relative e potenziali outlier all'interno del tuo dataset.
Quando si testa se una media campionaria differisce in modo significativo da una media di popolazione, si usa l'errore standard della media nel calcolo:
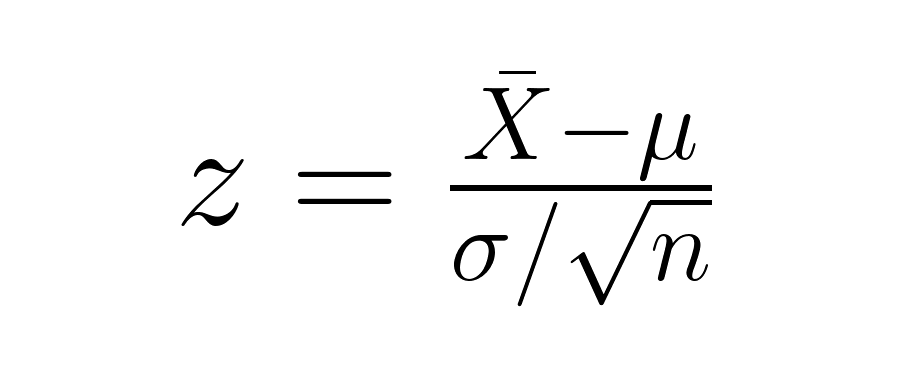
dove X̄ è la media del campione, μ è la media della popolazione, σ è la deviazione standard della popolazione e n è la dimensione del campione. Il denominatore (σ/√n) rappresenta l'errore standard della media, che tiene conto della dimensione del campione nei test d'ipotesi.
A volte si procede al contrario dagli z-score per trovare i valori originali. Riorganizzando la formula ottieni:
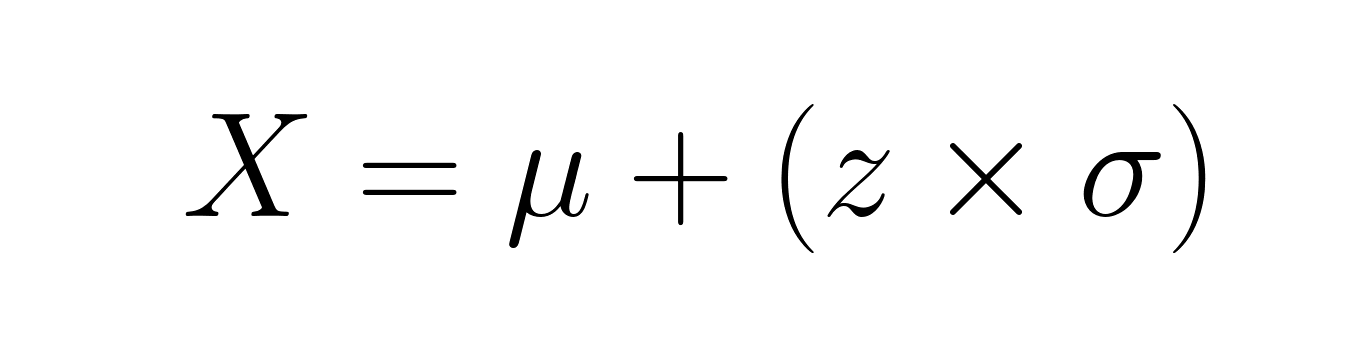
Se il punteggio di uno studente ha uno z-score di 1,5 in un esame con media 75 e deviazione standard 10, il suo punteggio reale sarebbe 75 + (1,5 × 10) = 90.
Convertire dati grezzi in z-score è un processo sistematico che, con la pratica, diventa naturale.
Ecco come calcolare manualmente gli z-score: per prima cosa, trova la media della distribuzione sommando tutti i valori e dividendo per il conteggio. Poi calcola la deviazione standard trovando la radice quadrata della media dei quadrati degli scarti dalla media. Infine, applica la formula dello z-score sottraendo la media dal tuo valore grezzo e dividendo per la deviazione standard.
Facciamo un esempio: se i punteggi d'esame 85, 92, 78, 96, 88 rappresentano il nostro dataset completo (media = 87,8, deviazione standard = 6,14), un punteggio di 92 ha uno z-score di (92 - 87,8) / 6,14 = 0,68.
Puoi anche calcolare rapidamente gli z-score usando la funzione STANDARDIZE() di Excel o la stessa funzione in Google Sheets, insieme a AVERAGE() e STDEV.P() per dati di popolazione o STDEV.S() per dati campionari.
L'interpretazione degli z-score segue regole direzionali coerenti indipendentemente dai tuoi dati originali. Z-score positivi indicano valori sopra la media, mentre z-score negativi indicano valori sotto la media. Uno z-score di 0 significa che il tuo punto dati coincide esattamente con la media.
Per dati normalmente distribuiti, puoi applicare ulteriori linee guida interpretative: i valori con z-score oltre ±2 sono insoliti (si verificano in circa il 5% dei casi), mentre z-score oltre ±3 sono rari (probabilità inferiore all'1%). Puoi trovare i percentili esatti per le distribuzioni normali usando le tabelle z, che mostrano quale percentuale di osservazioni è inferiore a un dato z-score.
Per dati non normali, gli z-score indicano comunque la posizione relativa e aiutano a identificare potenziali outlier, ma le percentuali specifiche non si applicano.
Capire il rapporto tra z-score e deviazione standard ti aiuta a cogliere cosa rappresentano effettivamente questi valori standardizzati.
Gli z-score misurano direttamente la distanza dalla media in unità di deviazione standard. Uno z-score di 2,5 significa che il tuo punto dati si trova 2,5 deviazioni standard sopra la media. Questo differisce dalla deviazione standard in sé, che misura la dispersione tipica dei dati attorno alla media.
La deviazione standard descrive la variabilità all'interno di un singolo dataset, mentre gli z-score permettono il confronto tra dataset diversi con medie e dispersioni differenti. Pensa alla deviazione standard come alla "larghezza" della tua distribuzione, mentre gli z-score ti dicono esattamente dove cadono i singoli punti all'interno di quella larghezza.
Per dati normalmente distribuiti, le tabelle z convertono gli z-score in ranghi percentili, mostrando quale percentuale di osservazioni è inferiore al tuo valore. In una distribuzione normale, uno z-score di 1,0 corrisponde all'84° percentile, cioè l'84% delle osservazioni è più piccolo.
I moderni calcolatori online e i software statistici rendono queste conversioni istantanee per le distribuzioni normali. Tuttavia, per dati non normali, avrai bisogno di metodi specifici per la distribuzione per determinare i percentili, poiché le percentuali standard della tabella z non si applicano.
Gli z-score compaiono in tutta la statistica e la data science, risolvendo problemi pratici in campi diversi.
Gli z-score costituiscono la base dei calcoli di probabilità nelle distribuzioni normali. Quando vuoi trovare la probabilità di superare 600 in una distribuzione di punteggi d'esame con media 500 e deviazione standard 100, prima converti 600 in uno z-score di 1,0, poi consulti la probabilità corrispondente (circa 16%). Puoi anche calcolare probabilità tra due z-score trovando la differenza tra le loro probabilità cumulative.
Nei test d'ipotesi, gli z-score aiutano a determinare la significatività statistica confrontando le statistiche campionarie con i valori attesi della popolazione sotto l'assunzione di normalità. Il nostro corso Hypothesis Testing in R copre queste applicazioni, mostrando come gli z-score si collegano a p-value e intervalli di confidenza.
I data scientist usano regolarmente gli z-score per identificare potenziali outlier. Per dati normalmente distribuiti, valori con z-score oltre ±3 sono altamente insoliti (si verificano in meno dell'1% dei casi) e spesso indicano errori di inserimento, problemi di misurazione o casi davvero eccezionali da approfondire. Anche con dati non normali, z-score estremi possono segnalare osservazioni che meritano un esame più attento.
Standardizzare interi dataset con gli z-score crea variabili con media 0 e deviazione standard 1, rendendole direttamente confrontabili. Questo è prezioso negli algoritmi di machine learning sensibili alle differenze di scala, come il clustering k-means o le reti neurali.
Gli z-score permettono confronti equi tra test o misure diverse con forme di distribuzione simili. Quel confronto SAT contro ACT citato prima diventa semplice una volta che converti entrambi i punteggi in z-score usando le rispettive medie e deviazioni standard. Uno studente con z-score SAT di 1,2 ha superato qualcuno con z-score ACT di 0,8, indipendentemente dalla diversa scala.
Gli z-score compaiono in tecniche analitiche sofisticate come l'analisi dei cluster (dove la standardizzazione garantisce che tutte le variabili contribuiscano in egual misura), il multidimensional scaling e l'analisi delle componenti principali.
Nell'analisi di regressione, i coefficienti standardizzati (detti anche coefficienti beta) aiutano a confrontare l'importanza relativa dei predittori continui mettendoli sulla stessa scala. Il processo prevede la conversione di tutte le variabili (sia predittori che outcome) in z-score prima di eseguire la regressione. I coefficienti standardizzati risultanti ti dicono "di quante deviazioni standard ci si aspetta che cambi l'outcome quando questo predittore aumenta di una deviazione standard?", rendendo possibili confronti diretti tra predittori con unità originali diverse.
I professionisti sanitari usano gli z-score per interpretare i risultati dei test confrontandoli con i dati della popolazione di riferimento. Gli z-score della densità ossea confrontano le misurazioni individuali con i coetanei, aiutando a diagnosticare condizioni come l'osteoporosi. Le valutazioni educative si basano sugli z-score per standardizzare i risultati dei test tra anni e popolazioni diverse, permettendo confronti equi nonostante condizioni di test variabili.
Le analisi moderne si affidano a strumenti software che automatizzano i calcoli degli z-score.
Le tradizionali tabelle z restano utili per comprendere il legame tra z-score e probabilità nelle distribuzioni normali. Queste tabelle elencano le probabilità cumulative per i valori della distribuzione normale standard, tipicamente da z = -3,49 a z = 3,49. Per consultare una tabella z, trova le prime due cifre del tuo z-score nella colonna di sinistra, poi individua la terza cifra nella riga superiore.
Abbiamo già visto la funzione STANDARDIZE() di Excel nella sezione sul calcolo passo dopo passo. Per Python e R, lavoriamo sullo stesso esempio con i punteggi d'esame: 85, 92, 78, 96, 88.
Python con scipy.stats:
import numpy as np
from scipy import stats

# Our exam scores
scores = np.array([85, 92, 78, 96, 88])

# Calculate z-scores using scipy (uses population std by default)
# This means dividing by N, not N-1
z_scores = stats.zscore(scores)
print(f"Z-scores: {z_scores}")
# Output: [-0.46  0.68 -1.59  1.33  0.03]

# Manual calculation for verification
mean_score = np.mean(scores)
std_score = np.std(scores, ddof=0)  # Population standard deviation
z_manual = (scores - mean_score) / std_score
print(f"Manual z-scores: {z_manual}")
R usando la funzione scale():
# Our exam scores
scores <- c(85, 92, 78, 96, 88)

# Calculate z-scores using scale() (uses sample std by default)
z_scores <- scale(scores)[,1]  # Extract vector from matrix
print(paste("Z-scores:", z_scores))
# Output: [-0.41  0.61 -1.43  1.19  0.03]

# Manual calculation for verification
z_manual <- (scores - mean(scores)) / sd(scores)
print(paste("Manual z-scores:", z_manual))
Nota che Python e R forniscono risultati leggermente diversi perché scipy.stats.zscore() usa la deviazione standard di popolazione (dividendo per N) mentre scale() di R usa la deviazione standard campionaria (dividendo per N-1). Per il nostro punteggio di 92, Python dà uno z-score di 0,68 mentre R dà 0,61. Entrambi sono corretti a seconda che tu tratti i dati come popolazione completa o come campione.
Gli z-score fanno da ponte tra dati grezzi e interpretazione statistica significativa. Permettono confronti equi tra scale diverse, supportano i calcoli di probabilità quando i dati seguono distribuzioni normali e aiutano a individuare osservazioni insolite che meritano approfondimenti.
Questi valori standardizzati spaziano dall'analisi dati di base alle applicazioni avanzate di machine learning, rendendoli strumenti utili per chiunque lavori con dati quantitativi. Esplora il nostro corso Inference for Numerical Data in R per vedere tecniche di inferenza statistica con dataset reali, e il nostro A/B Testing in R course per i metodi di test d'ipotesi in cui i concetti di z-score si applicano spesso.
Impara con DataCamp
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



