
कोर्स
Statistics परिचय
4 घंटा
162.3K
आप 2020 के SAT अंकों की उसी वर्ष के ACT अंकों से तुलना कर रहे हैं। एक छात्र ने SAT में 1200 स्कोर किया जबकि दूसरे ने ACT में 24—लेकिन बेहतर प्रदर्शन किसका है? यही समस्या z-स्कोर सुलझाते हैं, जो अलग-अलग मापों को एक समान पैमाने पर बदल देते हैं।
Z-स्कोर कच्चे डाटा को मानकीकृत मानों में बदलते हैं, जिससे बिल्कुल भिन्न वितरणों के बीच भी सार्थक तुलना संभव हो जाती है। यह मानकीकरण तब मददगार होता है जब आप अलग-अलग स्रोतों के डेटा का विश्लेषण करते हैं, अपवाद मान (outliers) पहचानते हैं, या सांख्यिकीय विश्लेषण में प्रायिकता की गणना करते हैं। हम z-स्कोर के पीछे के गणितीय आधारों को कवर करेंगे, चरण-दर-चरण व्यावहारिक गणना विधियाँ समझेंगे, और इन तकनीकों को अलग-अलग परिदृश्यों में लागू करेंगे।
Z-स्कोर आपको यह मानकीकृत तरीका देते हैं कि कोई भी डेटा बिंदु अपने वितरण के सापेक्ष कहाँ स्थित है।
Z-स्कोर दर्शाता है कि कोई डेटा बिंदु अपने वितरण के औसत से कितने मानक विचलन दूर है। इसका सूत्र सरल है:
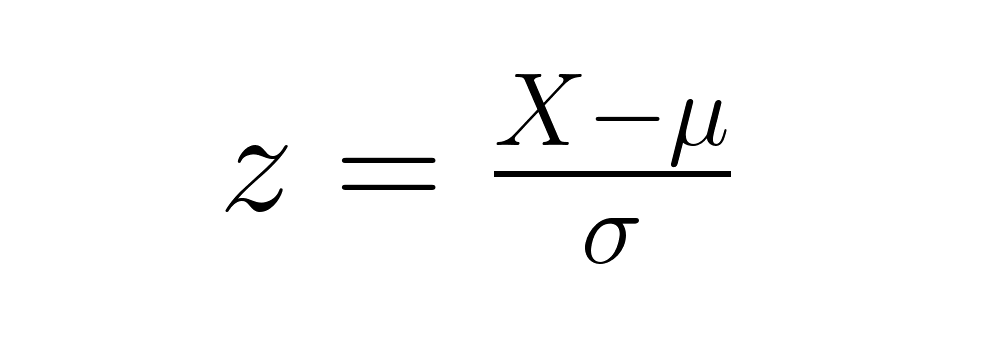
जहाँ X आपका कच्चा स्कोर है, μ (म्यू) आबादी का औसत है, और σ (सिग्मा) आबादी का मानक विचलन है। Z-स्कोर आपको अलग-अलग वितरणों से आए डेटा बिंदुओं की सीधी तुलना करने देते हैं, उनके मूल इकाइयों या पैमानों की परवाह किए बिना।
Z-स्कोर सामान्य रूप से वितरित डेटा को मानक सामान्य वितरण में बदल देते हैं, जो एक विशेष घंटी के आकार का वक्र है जिसका औसत = 0 और मानक विचलन = 1 होता है। यह रूपांतरण कुछ उपयोगी विश्लेषणात्मक क्षमताएँ खोलता है: लगभग 68% मान औसत से एक मानक विचलन के भीतर आते हैं (Z-स्कोर -1 से +1), 95% दो मानक विचलनों के भीतर (-2 से +2), और 99.7% तीन मानक विचलनों के भीतर (-3 से +3)।
मूल z-स्कोर सूत्र आबादी के डेटा के लिए अच्छा काम करता है, लेकिन वास्तविक दुनिया के विश्लेषण में डेटा के प्रकार और नमूने के आकार के अनुसार कुछ संशोधनों की आवश्यकता पड़ सकती है।
जैसा कि पहले बताया गया, z-स्कोर का मूल सूत्र है:
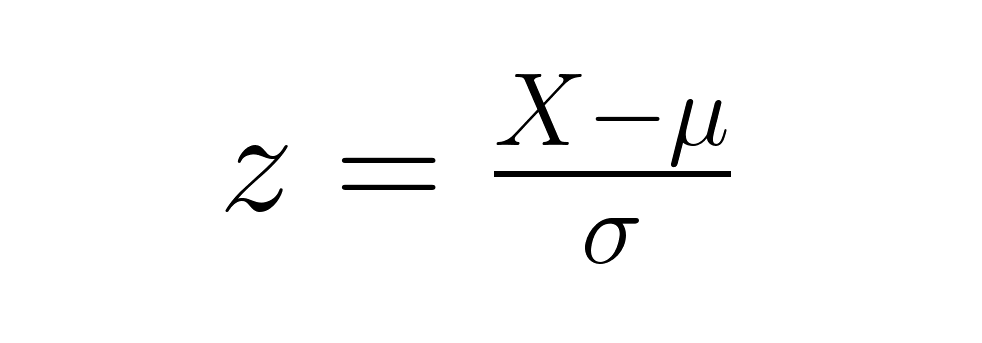
यहीं से विभिन्नताएँ इस बात पर निर्भर करती हैं कि आप नमूना डेटा पर काम कर रहे हैं या किसी नमूना औसत की तुलना आबादी के औसत से कर रहे हैं।
नमूने के व्यक्तिगत डेटा बिंदुओं के लिए:
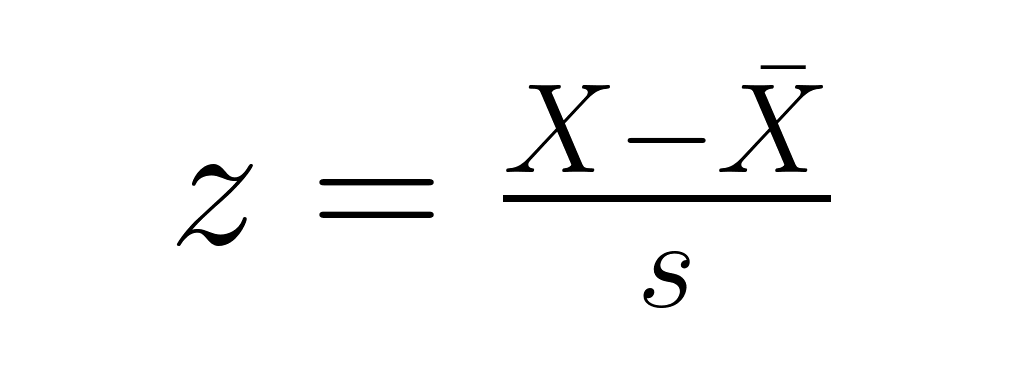
जहाँ X̄ नमूना औसत है और s नमूना मानक विचलन है (हर में n−1 के साथ गणना किया जाता है)। यह रूप बताता है कि कोई बिंदु नमूना औसत से कितने नमूना मानक विचलन दूर है, जो आपके डेटासेट के भीतर सापेक्ष स्थिति और संभावित अपवाद मानों की पहचान करने में उपयोगी है।
जब यह परखना हो कि कोई नमूना औसत आबादी के औसत से महत्वपूर्ण रूप से भिन्न है या नहीं, तो हम अपनी गणना में औसत की मानक त्रुटि का उपयोग करते हैं:
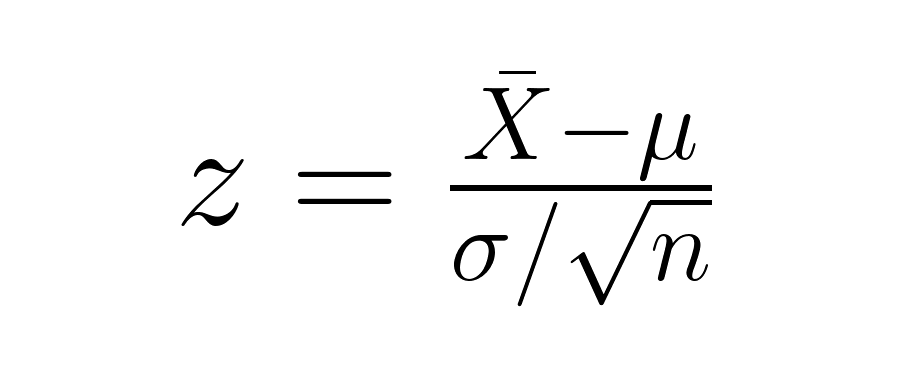
जहाँ X̄ आपका नमूना औसत है, μ आबादी का औसत है, σ आबादी का मानक विचलन है, और n आपका नमूना आकार है। हर में (σ/√n) औसत की मानक त्रुटि को दर्शाता है, जो परिकल्पना परीक्षण में नमूना आकार का हिसाब रखता है।
कभी-कभी आप मूल मान पाने के लिए z-स्कोर से उल्टा काम करते हैं। सूत्र को पुनर्व्यवस्थित करने पर मिलता है:
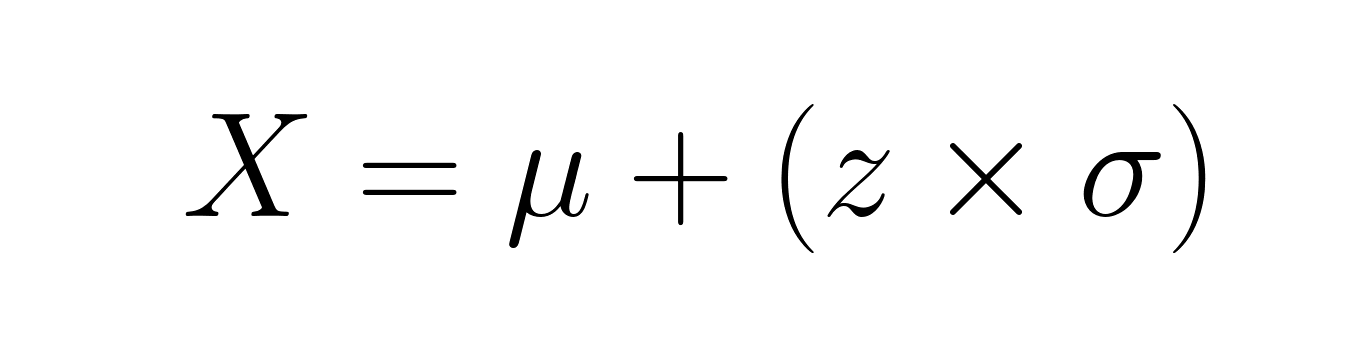
यदि किसी छात्र के टेस्ट स्कोर का z-स्कोर 1.5 है और परीक्षा का औसत 75 तथा मानक विचलन 10 है, तो उसका वास्तविक स्कोर होगा 75 + (1.5 × 10) = 90।
कच्चे डेटा को z-स्कोर में बदलना एक व्यवस्थित प्रक्रिया है, जो अभ्यास से सहज हो जाती है।
z-स्कोर को मैन्युअली ऐसे निकालें: पहले, अपने वितरण का औसत निकालें—सभी मानों को जोड़ें और संख्या से भाग दें। फिर, औसत से वर्ग विचलनों के औसत का वर्गमूल लेकर मानक विचलन निकालें। अंत में, अपने कच्चे स्कोर से औसत घटाएँ और मानक विचलन से भाग दें—यही z-स्कोर का सूत्र है।
आइए एक उदाहरण देखें: यदि परीक्षा अंक 85, 92, 78, 96, 88 हमारे पूर्ण डेटासेट का प्रतिनिधित्व करते हैं (औसत = 87.8, मानक विचलन = 6.14), तो 92 का z-स्कोर होगा (92 - 87.8) / 6.14 = 0.68।
आप Excel के STANDARDIZE() फ़ंक्शन या Google Sheets में उसी फ़ंक्शन का उपयोग करके भी z-स्कोर तुरंत निकाल सकते हैं, और जरूरत के अनुसार AVERAGE() तथा आबादी के लिए STDEV.P() या नमूने के लिए STDEV.S() के साथ संयोजन कर सकते हैं।
मूल डेटा कुछ भी हो, z-स्कोर की दिशा संबंधी व्याख्या स्थिर रहती है। धनात्मक z-स्कोर औसत से ऊपर के मान दर्शाते हैं, जबकि ऋणात्मक z-स्कोर औसत से नीचे के। z-स्कोर 0 का मतलब है कि आपका डेटा बिंदु ठीक औसत के बराबर है।
सामान्य रूप से वितरित डेटा के लिए, आप अतिरिक्त दिशानिर्देश लागू कर सकते हैं: ±2 से परे z-स्कोर असामान्य होते हैं (लगभग 5% मामलों में), जबकि ±3 से परे z-स्कोर दुर्लभ होते हैं (1% से कम प्रायिकता)। सामान्य वितरणों के लिए आप z-तालिकाओं से सटीक पर्सेंटाइल देख सकते हैं, जो दिखाती हैं कि किसी दिए गए z-स्कोर से नीचे कितने प्रतिशत अवलोकन आते हैं।
गैर-सामान्य डेटा के लिए, z-स्कोर फिर भी सापेक्ष स्थिति दर्शाते हैं और संभावित अपवाद मानों की पहचान में मदद करते हैं, लेकिन विशिष्ट प्रतिशत लागू नहीं होते।
Z-स्कोर और मानक विचलन के संबंध को समझना यह पकड़ने में मदद करता है कि ये मानकीकृत मान वास्तव में क्या दर्शाते हैं।
Z-स्कोर सीधे औसत से दूरी को मानक विचलन इकाइयों में मापते हैं। 2.5 का z-स्कोर बताता है कि आपका डेटा बिंदु औसत से 2.5 मानक विचलन ऊपर है। यह मानक विचलन से भिन्न है, जो औसत के आसपास डेटा के सामान्य फैलाव को मापता है।
मानक विचलन एक ही डेटासेट के भीतर परिवर्तनशीलता का वर्णन करता है, जबकि z-स्कोर अलग-अलग औसत और फैलाव वाले विभिन्न डेटासेटों के बीच तुलना संभव करते हैं। मानक विचलन को अपने वितरण की "चौड़ाई" की तरह समझें, जबकि z-स्कोर बताते हैं कि उस चौड़ाई के भीतर व्यक्तिगत बिंदु ठीक कहाँ पड़ते हैं।
सामान्य रूप से वितरित डेटा के लिए, z-तालिकाएँ z-स्कोर को पर्सेंटाइल रैंक में बदलती हैं, दिखाती हैं कि आपके मान से नीचे कितने प्रतिशत अवलोकन आते हैं। सामान्य वितरण में, 1.0 का z-स्कोर 84वें पर्सेंटाइल के अनुरूप होता है, यानी 84% अवलोकन इससे छोटे होते हैं।
आधुनिक ऑनलाइन कैलकुलेटर और सांख्यिकीय सॉफ्टवेयर सामान्य वितरणों के लिए ये रूपांतरण तुरंत कर देते हैं। हालाँकि, गैर-सामान्य डेटा के लिए आपको वितरण-विशिष्ट तरीकों की जरूरत होगी, क्योंकि मानक z-तालिका के प्रतिशत वहाँ लागू नहीं होते।
Z-स्कोर सांख्यिकी और डेटा साइंस में व्यापक रूप से दिखते हैं, और विविध क्षेत्रों की व्यावहारिक समस्याएँ सुलझाते हैं।
सामान्य वितरणों में प्रायिकता गणनाओं की नींव z-स्कोर हैं। जब आप सामान्य रूप से वितरित परीक्षा अंकों (औसत 500, मानक विचलन 100) में 600 से ऊपर स्कोर की प्रायिकता ढूँढना चाहते हैं, तो पहले 600 को z-स्कोर 1.0 में बदलें, फिर उसके अनुरूप प्रायिकता देखें (लगभग 16%)। आप दो z-स्कोरों के बीच की प्रायिकता, उनके संचयी प्रायिकताओं का अंतर लेकर, निकाल सकते हैं।
परिकल्पना परीक्षण में, z-स्कोर सामान्यता की धारणा के तहत नमूना सांख्यिकीय मानों की तुलना अपेक्षित आबादी मूल्यों से करके सांख्यिकीय महत्व तय करने में मदद करते हैं। हमारा Hypothesis Testing in R कोर्स इन अनुप्रयोगों को कवर करता है, यह दिखाते हुए कि z-स्कोर p-मूल्यों और विश्वसनीयता अंतरालों से कैसे जुड़े हैं।
डेटा वैज्ञानिक संभावित अपवाद मानों की पहचान के लिए नियमित रूप से z-स्कोर का उपयोग करते हैं। सामान्य रूप से वितरित डेटा में, ±3 से परे z-स्कोर बहुत असामान्य होते हैं (1% से कम बार होते हैं) और अक्सर डेटा प्रविष्टि त्रुटि, मापन समस्या, या जाँच योग्य असाधारण मामलों का संकेत देते हैं। गैर-सामान्य डेटा में भी, अत्यधिक z-स्कोर उन अवलोकनों को चिन्हित कर सकते हैं जिनकी नज़दीकी जाँच बनती है।
पूरे डेटासेट को z-स्कोर से मानकीकृत करने पर चरों का औसत 0 और मानक विचलन 1 हो जाता है, जिससे वे सीधे तुलनीय बनते हैं। यह उन मशीन लर्निंग एल्गोरिद्म में मूल्यवान है जो पैमाने के अंतर के प्रति संवेदनशील होते हैं, जैसे k-means क्लस्टरिंग या न्यूरल नेटवर्क।
Z-स्कोर विभिन्न परीक्षाओं या मापों के बीच निष्पक्ष तुलना संभव करते हैं, बशर्ते उनके वितरण आकार समान हों। पहले वाला SAT बनाम ACT उदाहरण तब सीधा हो जाता है जब आप दोनों अंकों को उनके-अपने औसत और मानक विचलनों का उपयोग करके z-स्कोर में बदलते हैं। SAT z-स्कोर 1.2 वाला छात्र ACT z-स्कोर 0.8 वाले से बेहतर रहा, अलग-अलग स्केल होने के बावजूद।
Z-स्कोर उन्नत विश्लेषण तकनीकों में दिखते हैं, जैसे क्लस्टर विश्लेषण (जहाँ मानकीकरण सुनिश्चित करता है कि सभी चर समान रूप से योगदान दें), बहुआयामी स्केलिंग, और प्रिंसिपल कंपोनेंट्स एनालिसिस।
प्रतिगमन विश्लेषण में, मानकीकृत गुणांक (जिन्हें बीटा गुणांक भी कहते हैं) सभी निरंतर पूर्वानुमानकों को एक ही पैमाने पर रखकर उनके सापेक्ष महत्व की तुलना करने में मदद करते हैं। प्रक्रिया में प्रतिगमन चलाने से पहले सभी चरों (पूर्वानुमानक और परिणाम) को z-स्कोर में बदलना शामिल है। प्राप्त मानकीकृत गुणांक बताते हैं: "जब यह पूर्वानुमानक एक मानक विचलन बढ़ता है, तो परिणाम में कितने मानक विचलन का परिवर्तन अपेक्षित है?"—जिससे अलग-अलग मूल इकाइयों वाले पूर्वानुमानकों की सीधी तुलना संभव होती है।
चिकित्सा विशेषज्ञ परीक्षण परिणामों की व्याख्या संदर्भ आबादी डेटा से तुलना करके करते हैं, जिसमें z-स्कोर काम आते हैं। बोन डेंसिटी z-स्कोर व्यक्तिगत मापों की उम्र-मेल खाते साथियों से तुलना करते हैं, जिससे ऑस्टियोपोरोसिस जैसी स्थितियों का निदान करने में मदद मिलती है। शैक्षिक मूल्यांकन अलग-अलग वर्षों और आबादियों में परिणामों को मानकीकृत करने के लिए z-स्कोर पर निर्भर करता है, जिससे अलग-अलग परीक्षा शर्तों के बावजूद निष्पक्ष तुलना संभव होती है।
आधुनिक विश्लेषण z-स्कोर गणनाओं को स्वचालित करने वाले सॉफ्टवेयर टूल्स पर निर्भर करता है।
पारंपरिक z-तालिकाएँ सामान्य वितरणों में z-स्कोर और प्रायिकताओं के बीच संबंध समझने में अब भी उपयोगी हैं। ये तालिकाएँ मानक सामान्य वितरण के लिए संचयी प्रायिकताएँ सूचीबद्ध करती हैं, आम तौर पर z = -3.49 से z = 3.49 तक। z-तालिका पढ़ने के लिए, बाएँ कॉलम में अपने z-स्कोर के पहले दो अंक ढूँढें, फिर ऊपर की पंक्ति में तीसरा अंक देखें।
हमने चरण-दर-चरण गणना अनुभाग में Excel के STANDARDIZE() फ़ंक्शन को कवर किया। Python और R के लिए, चलिए इन्हीं परीक्षा अंकों: 85, 92, 78, 96, 88 के साथ वही उदाहरण देखते हैं।
scipy.stats के साथ Python:
import numpy as np
from scipy import stats

# Our exam scores
scores = np.array([85, 92, 78, 96, 88])

# Calculate z-scores using scipy (uses population std by default)
# This means dividing by N, not N-1
z_scores = stats.zscore(scores)
print(f"Z-scores: {z_scores}")
# Output: [-0.46  0.68 -1.59  1.33  0.03]

# Manual calculation for verification
mean_score = np.mean(scores)
std_score = np.std(scores, ddof=0)  # Population standard deviation
z_manual = (scores - mean_score) / std_score
print(f"Manual z-scores: {z_manual}")
R में scale() फ़ंक्शन का उपयोग:
# Our exam scores
scores <- c(85, 92, 78, 96, 88)

# Calculate z-scores using scale() (uses sample std by default)
z_scores <- scale(scores)[,1]  # Extract vector from matrix
print(paste("Z-scores:", z_scores))
# Output: [-0.41  0.61 -1.43  1.19  0.03]

# Manual calculation for verification
z_manual <- (scores - mean(scores)) / sd(scores)
print(paste("Manual z-scores:", z_manual))
ध्यान दें कि Python और R थोड़े अलग परिणाम देते हैं क्योंकि scipy.stats.zscore() आबादी का मानक विचलन उपयोग करता है (N से भाग), जबकि R का scale() नमूना मानक विचलन उपयोग करता है (N-1 से भाग)। हमारे 92 के स्कोर के लिए, Python 0.68 का z-स्कोर देता है जबकि R 0.61 देता है। आप अपने डेटा को पूर्ण आबादी मानते हैं या एक नमूना—इसके आधार पर दोनों सही हैं।
Z-स्कोर कच्चे डेटा और सार्थक सांख्यिकीय व्याख्या के बीच पुल का काम करते हैं। ये अलग-अलग पैमानों पर निष्पक्ष तुलना संभव बनाते हैं, सामान्य वितरण होने पर प्रायिकता गणनाओं का समर्थन करते हैं, और असामान्य अवलोकनों की पहचान में मदद करते हैं जिनकी जाँच बनती है।
ये मानकीकृत मान बुनियादी डेटा विश्लेषण से लेकर उन्नत मशीन लर्निंग अनुप्रयोगों तक फैले हैं, जिससे वे किसी भी मात्रात्मक डेटा पर काम करने वाले के लिए उपयोगी उपकरण बनते हैं। हमारे Inference for Numerical Data in R कोर्स में वास्तविक डेटासेट के साथ सांख्यिकीय अनुमान तकनीकें देखें, और A/B Testing in R course में उन परिकल्पना परीक्षण विधियों को सीखें जहाँ z-स्कोर अवधारणाएँ अक्सर लागू होती हैं।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स