
Che cos'è il Context Engineering?
Il context engineering è la pratica di progettare sistemi che decidono quali informazioni vede un modello di IA prima di generare una risposta.
Anche se il termine è nuovo, i principi alla base del context engineering esistono da parecchio. Questa nuova astrazione ci permette di ragionare sul problema più importante e sempre presente: progettare il flusso di informazioni in entrata e in uscita dai sistemi di IA.
Invece di scrivere prompt perfetti per richieste singole, crei sistemi che raccolgono dettagli rilevanti da più fonti e li organizzano all'interno della context window del modello. Significa che il tuo sistema mette insieme cronologia della conversazione, dati utente, documenti esterni e strumenti disponibili, quindi li formatta in modo che il modello possa usarli.
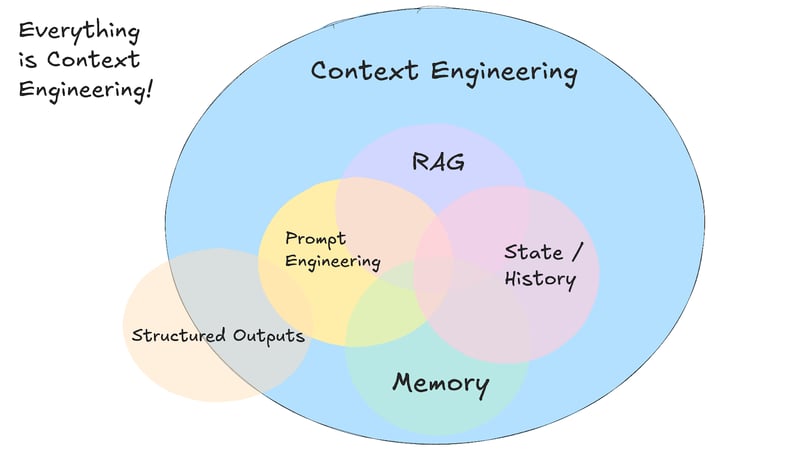
Fonte: 12-factor-agents
Questo approccio richiede la gestione di diversi tipi di informazioni che costituiscono il contesto completo:
- Istruzioni di sistema che definiscono comportamento e regole
- Cronologia della conversazione e preferenze dell'utente
- Informazioni recuperate da documenti o database
- Strumenti disponibili e loro definizioni
- Formati di output strutturati e schemi
- Dati in tempo reale e risposte di API esterne
La sfida principale è lavorare entro i limiti della context window mantenendo conversazioni coerenti nel tempo. Il tuo sistema deve decidere cosa è più rilevante per ogni richiesta, il che di solito significa costruire sistemi di retrieval che trovino i dettagli giusti quando servono.
Questo implica creare sistemi di memoria che traccino sia il flusso di conversazione a breve termine sia le preferenze dell'utente a lungo termine, oltre a rimuovere informazioni obsolete per fare spazio alle esigenze attuali.
Il vero vantaggio arriva quando diversi tipi di contesto lavorano insieme per creare sistemi di IA che sembrano più intelligenti e consapevoli. Quando il tuo assistente AI può fare riferimento a conversazioni precedenti, accedere al tuo calendario e capire il tuo stile di comunicazione contemporaneamente, le interazioni smettono di essere ripetitive e iniziano a sembrare di lavorare con qualcosa che ti ricorda davvero.
Context Engineering vs. Prompt Engineering
Se chiedi a ChatGPT di "scrivere un'email professionale", quello è prompt engineering: stai scrivendo istruzioni per un singolo compito. Ma se stai costruendo un bot per l'assistenza clienti che deve ricordare ticket precedenti, accedere ai dettagli dell'account utente e mantenere la cronologia della conversazione su più interazioni, quello è context engineering.
Andrej Karpathy lo spiega bene:
Le persone associano i prompt a brevi descrizioni di compiti che daresti a un LLM nell'uso quotidiano. Mentre in ogni app LLM di livello industriale, il context engineering è la delicata arte e scienza di riempire la context window con le informazioni giuste per il passo successivo.
La maggior parte delle applicazioni di IA usa sia il prompt engineering sia il context engineering. Servono comunque prompt ben scritti all'interno del tuo sistema di context engineering. La differenza è che quei prompt ora lavorano con informazioni di background gestite con cura invece di ripartire da zero ogni volta.
|
Approach |
Best Used For |
|
Prompt Engineering |
Attività una tantum, generazione di contenuti, output con formato specifico |
|
Context Engineering |
AI conversazionale, strumenti di analisi di documenti, assistenti di coding |
|
Entrambi insieme |
Applicazioni di IA in produzione che necessitano di prestazioni costanti e affidabili |
Context Engineering nella pratica
Il context engineering passa dalla teoria alla realtà quando inizi a costruire applicazioni di IA che devono lavorare con informazioni complesse e interconnesse. Pensa a un bot per l'assistenza clienti che deve accedere a ticket precedenti, controllare lo stato dell'account e fare riferimento alla documentazione di prodotto, il tutto mantenendo un tono di conversazione utile. Qui è dove il prompting tradizionale crolla e il context engineering diventa necessario.
Sistemi RAG
Si può dire che il context engineering sia iniziato con i sistemi di retrieval augmented generation (RAG). RAG è stata una delle prime tecniche che ti ha permesso di introdurre ai LLM informazioni non presenti nei loro dati di addestramento originali.
I sistemi RAG usano tecniche avanzate di context engineering per organizzare e presentare le informazioni in modo più efficace. Suddividono i documenti in parti significative, classificano le informazioni per rilevanza e fanno rientrare i dettagli più utili entro i limiti di token.
Prima di RAG, se volevi che un'IA rispondesse a domande sui documenti interni della tua azienda, dovevi riaddestrare o fine-tunare l'intero modello. RAG ha cambiato le cose costruendo sistemi in grado di cercare tra i tuoi documenti, trovare i frammenti rilevanti e includerli nella context window insieme alla tua domanda.
Questo ha permesso ai LLM di analizzare all'improvviso più documenti e fonti per rispondere a domande complesse che normalmente richiederebbero a un umano di leggere centinaia di pagine.
Agenti AI
I sistemi RAG hanno aperto la porta alle informazioni esterne, ma gli agenti AI sono andati oltre rendendo il contesto dinamico e reattivo. Invece di recuperare solo documenti statici, gli agenti usano strumenti esterni durante le conversazioni.
L'IA decide quale strumento risolve meglio il problema attuale. Un agente può iniziare una conversazione, rendersi conto che gli servono dati azionari aggiornati, chiamare un'API finanziaria e poi usare quelle informazioni fresche per proseguire la conversazione.
Il calo del costo dei token dei LLM ha reso possibili anche i sistemi multi-agente. Invece di stipare tutto nella context window di un singolo modello, puoi avere agenti specializzati che gestiscono aspetti diversi di un problema e condividono informazioni tra loro tramite protocolli come A2A o MCP.
Per saperne di più sugli agenti AI, dai un'occhiata a questo cheat sheet sugli agenti AI.
Assistenti di coding AI
Gli assistenti di coding AI—come Cursor o Windsurf—rappresentano una delle applicazioni più avanzate del context engineering perché combinano principi RAG e agent mantenendo informazioni altamente strutturate e interconnesse.
Questi sistemi devono comprendere non solo i singoli file, ma intere architetture di progetto, dipendenze tra moduli e pattern di codice in tutto il tuo codebase.
Quando chiedi a un assistente di refattorizzare una funzione, ha bisogno del contesto su dove viene usata, quali tipi di dati si aspetta e come le modifiche potrebbero influire su altre parti del progetto.
Qui il context engineering diventa fondamentale perché il codice ha relazioni che si estendono su più file e persino più repository. Un buon assistente di coding mantiene il contesto sulla struttura del tuo progetto, sulle modifiche recenti, sul tuo stile di programmazione e sui framework che usi.
Ecco perché strumenti come Cursor migliorano più a lungo li usi in un progetto. Accumulano contesto sul tuo codebase specifico e possono fare suggerimenti più pertinenti in base ai tuoi pattern e alle tue preferenze.
Errori di contesto e tecniche per mitigarli
Leggendo l'articolo, potresti pensare che il context engineering sia inutile o lo sarà a breve, man mano che le context window dei modelli più avanzati continuano a crescere. Sarebbe un'ipotesi naturale, perché se il contesto è abbastanza grande, potresti buttare tutto in un prompt (strumenti, documenti, istruzioni e altro) e lasciare che il modello faccia il resto.
Tuttavia, questo eccellente articolo scritto da Drew Breunig mostra quattro modi sorprendenti in cui il contesto può andare fuori controllo, anche quando il modello in questione supporta context window da 1 milione di token. In questa sezione descriverò rapidamente i problemi evidenziati da Drew Breunig e i pattern di context engineering che li risolvono—ti consiglio vivamente di leggere l'articolo di Breunig per maggiori dettagli.
Context poisoning
Il context poisoning si verifica quando una allucinazione o un errore finisce nel contesto del tuo sistema di IA e poi viene richiamato più e più volte nelle risposte future. Il team di DeepMind ha identificato questo problema nel loro rapporto tecnico su Gemini 2.5 mentre costruivano un agente che giocava a Pokémon. Quando l'agente a volte allucinava lo stato di gioco, questa falsa informazione avvelenava la sezione "obiettivi" del suo contesto, portando l'agente a sviluppare strategie insensate e a perseguire obiettivi impossibili per molto tempo.
Questo problema peggiora molto nei workflow degli agenti in cui le informazioni si accumulano. Una volta che un contesto avvelenato si stabilisce, può volerci un'eternità per sistemarlo perché il modello continua a fare riferimento alle informazioni false come se fossero vere.
La soluzione migliore è la validazione e quarantena del contesto. Puoi isolare diversi tipi di contesto in thread separati e validare le informazioni prima che vengano aggiunte alla memoria a lungo termine. La quarantena del contesto significa avviare nuovi thread quando rilevi un potenziale avvelenamento, impedendo che le informazioni errate si diffondano nelle interazioni future.
Context distraction
La context distraction si verifica quando il tuo contesto cresce così tanto che il modello inizia a concentrarsi troppo sulla cronologia accumulata invece di usare ciò che ha imparato in addestramento. L'agente Gemini che giocava a Pokémon lo ha mostrato: una volta che il contesto ha superato i 100.000 token, l'agente ha iniziato a ripetere azioni della sua vasta cronologia invece di sviluppare nuove strategie.
Uno studio di Databricks (molto interessante; vale davvero la pena leggerlo) ha rilevato che la correttezza del modello inizia a calare intorno ai 32.000 token per Llama 3.1 405b, con i modelli più piccoli che raggiungono il limite molto prima. Significa che i modelli iniziano a commettere errori molto prima che le loro context window siano effettivamente piene, il che fa riflettere sul reale valore di context window molto grandi per compiti di ragionamento complessi.
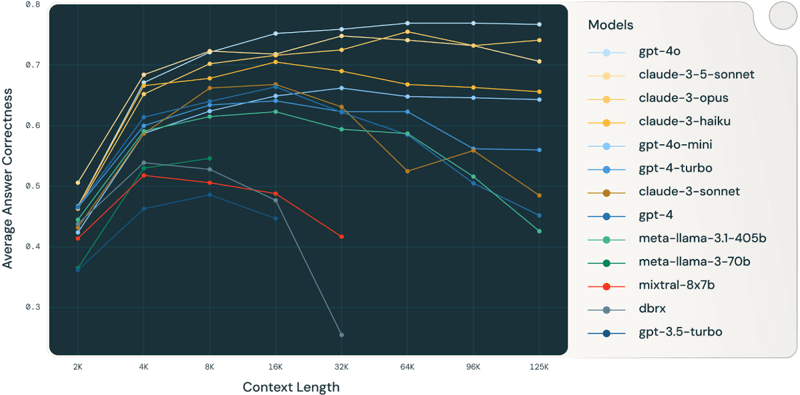
Fonte: Databricks
L'approccio migliore è la riassunzione del contesto. Invece di lasciare che il contesto cresca all'infinito, puoi comprimere le informazioni accumulate in riassunti più brevi che mantengono i dettagli importanti eliminando la cronologia ridondante. Questo aiuta quando raggiungi la soglia di distrazione: puoi riassumere la conversazione finora e ripartire da capo mantenendo la coerenza.
Context confusion
La context confusion si verifica quando includi informazioni extra nel tuo contesto che il modello usa per generare risposte errate, anche quando quelle informazioni non sono rilevanti per il compito attuale. La Berkeley Function-Calling Leaderboard lo mostra: ogni modello performa peggio quando gli si forniscono più di uno strumento, e a volte i modelli chiamano strumenti che non hanno niente a che fare con il compito.
Il problema peggiora con modelli più piccoli e più strumenti. Uno studio recente ha rilevato che un Llama 3.1 8b quantizzato falliva il benchmark GeoEngine quando gli venivano forniti tutti i 46 strumenti disponibili, anche se il contesto rientrava benissimo nel limite di 16k. Ma quando i ricercatori hanno dato allo stesso modello solo 19 strumenti, ha funzionato correttamente.
La soluzione è la gestione del loadout degli strumenti usando tecniche RAG. La ricerca di Tiantian Gan e Qiyao Sun ha mostrato che applicare RAG alle descrizioni degli strumenti può migliorare davvero le prestazioni. Archiviando le descrizioni degli strumenti in un database vettoriale, puoi selezionare solo gli strumenti più pertinenti per ogni compito. Il loro studio ha riscontrato che mantenere la selezione sotto i 30 strumenti ha triplicato l'accuratezza di selezione degli strumenti e accorciato molto i prompt.
Context clash
Il context clash si verifica quando raccogli nel tuo contesto informazioni e strumenti che vanno direttamente in conflitto con altre informazioni già presenti. Uno studio di Microsoft e Salesforce lo ha mostrato prendendo prompt di benchmark e "shardandone" le informazioni in più turni di conversazione invece di fornirle tutte insieme. I risultati sono stati enormi: un calo medio di prestazioni del 39%, con il modello o3 di OpenAI che è sceso da 98,1 a 64,1.
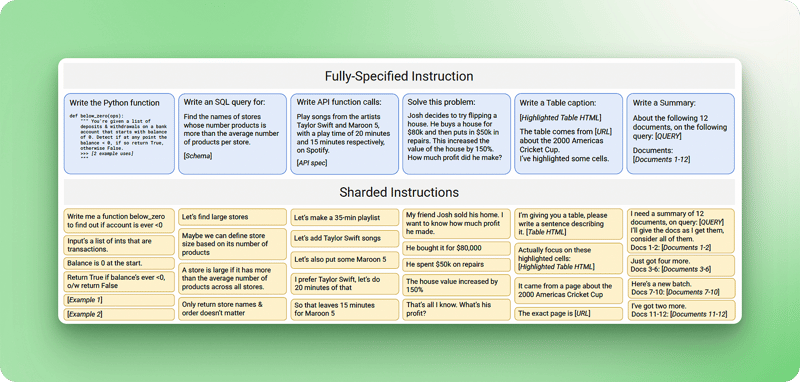
Fonte: Laban et. al, 2025
Il problema nasce perché, quando le informazioni arrivano a fasi, il contesto assemblato contiene i primi tentativi del modello di rispondere alle domande prima di avere tutte le informazioni. Queste risposte iniziali errate restano nel contesto e influenzano il modello quando genera le risposte finali.
Le migliori soluzioni sono la potatura e l'offloading del contesto. La potatura del contesto significa rimuovere informazioni obsolete o in conflitto man mano che arrivano nuovi dettagli. L'offloading del contesto, come lo strumento "think" di Anthropic, dà ai modelli uno spazio di lavoro separato per elaborare le informazioni senza ingombrare il contesto principale. Questo approccio da blocco appunti può offrire fino al 54% di miglioramento in benchmark specifici per agenti, impedendo che contraddizioni interne rovinino il ragionamento.
Conclusione
Il context engineering rappresenta la prossima fase dello sviluppo dell'IA, in cui l'attenzione si sposta dal creare prompt perfetti al costruire sistemi che gestiscono il flusso di informazioni nel tempo. La capacità di mantenere un contesto rilevante su più interazioni determina se la tua IA sembra intelligente o se dà solo buone risposte una tantum.
Le tecniche trattate in questo tutorial—dai sistemi RAG alla validazione del contesto e alla gestione degli strumenti—sono già utilizzate in sistemi di produzione che gestiscono milioni di utenti.
Se stai costruendo qualcosa di più complesso di un semplice generatore di contenuti, è probabile che ti serviranno tecniche di context engineering. La buona notizia è che puoi iniziare in piccolo con implementazioni RAG di base e aggiungere gradualmente memoria e gestione degli strumenti più sofisticate man mano che le esigenze crescono.
Per approfondire, ti consiglio queste risorse:
- Tutorial su Cursor AI Code Editor—Scopri come funziona il context engineering nella pratica con gli assistenti di coding AI
- Confronto Cursor vs Windsurf—Scopri le differenze tra Cursor e Windsurf
- I migliori assistenti di coding AI—Confronta diversi strumenti e i loro approcci alla gestione del contesto
- Corso Retrieval Augmented Generation (RAG) con LangChain—Corso pratico per costruire sistemi RAG
- Che cos'è la Retrieval Augmented Generation (RAG)?—Concetti di base per il context engineering
- Tutorial Agentic RAG—Tecniche avanzate per una gestione dinamica del contesto
- Che cos'è il Prompt Engineering?—Capire la differenza tra prompt e context engineering
- Corso sistemi multi-agente con LangGraph—Impara a costruire sistemi multi-agente con LangGraph
- Corso Introduzione agli agenti AI—Costruire sistemi che usano strumenti e mantengono il contesto nel tempo
FAQs
Quando dovrei iniziare a usare il context engineering invece dei soli prompt?
Inizia a usare il context engineering quando la tua IA deve ricordare cose tra una conversazione e l'altra, lavorare con più fonti di informazione o mantenere attività di lunga durata. Se stai costruendo qualcosa di più complesso di un semplice generatore di contenuti, è probabile che ti serviranno queste tecniche.
Qual è la differenza principale tra context engineering e prompt engineering?
Il prompt engineering si concentra sullo scrivere istruzioni per compiti singoli, mentre il context engineering progetta sistemi che gestiscono il flusso di informazioni su più interazioni. Il context engineering costruisce sistemi di memoria e retrieval, mentre il prompt engineering cura le richieste individuali.
Posso usare context window più grandi invece del context engineering?
Context window più grandi non risolvono i problemi di fondo. Le ricerche mostrano che le prestazioni dei modelli calano intorno ai 32.000 token, anche con window da un milione di token, a causa di distrazione e confusione del contesto. Servono comunque tecniche come riassunzione, potatura e selezione intelligente delle informazioni a prescindere dalla dimensione del contesto.
Perché i modelli di IA performano peggio quando fornisco loro più strumenti o informazioni?
Questo si chiama context confusion: i modelli si fanno distrarre da informazioni irrilevanti e possono usare strumenti che non corrispondono al compito. La soluzione è la gestione del loadout degli strumenti: usa tecniche RAG per selezionare solo gli strumenti più pertinenti per ogni compito specifico, mantenendo la selezione sotto i 30 strumenti.

Sono un creator di contenuti sulla data science con oltre 2 anni di esperienza e uno dei più seguiti su Medium. Mi piace scrivere articoli dettagliati su AI e ML con un pizzico di sarcasmo, perché bisogna pur fare qualcosa per renderli un po’ meno noiosi. Ho pubblicato oltre 130 articoli e un corso su DataCamp, con un altro in arrivo. I miei contenuti sono stati visti da oltre 5 milioni di persone, 20.000 delle quali sono diventate follower sia su Medium che su LinkedIn.





Puoi essere un maestro del prompt engineering, ma man mano che la conversazione procede, il tuo chatbot spesso dimentica i primi e più importanti pezzi delle tue istruzioni, il tuo assistente di codice perde di vista l'architettura del progetto e il tuo strumento RAG non riesce a collegare informazioni tra documenti e domini complessi.
Con l'aumentare della complessità dei casi d'uso dell'IA, scrivere un prompt ingegnoso è solo una piccola parte di una sfida molto più grande: context engineering.
In questo tutorial ti spiegherò cos'è il context engineering, come funziona, quando usarlo al posto del semplice prompt engineering e le tecniche pratiche che rendono i sistemi di IA più intelligenti e consapevoli del contesto.
Se preferisci seguire con un video, dai un'occhiata a questa lezione: