Corso
Comprendere l'intelligenza artificiale
2 ore
426.1K
La maggior parte dei benchmark di AI segue la stessa formula: poni una domanda al modello, ottieni una risposta, verifica se è corretta. Per anni, questo approccio ha funzionato abbastanza bene. Ma quando i modelli all'avanguardia hanno iniziato a superare il 90% in quasi tutte le valutazioni principali, è emerso un problema noto. I benchmark hanno iniziato a perdere la capacità di distinguere un modello dall'altro.
ARC-AGI-3 adotta un approccio diverso. Invece di presentare enigmi statici con chiari input-output, immerge gli agenti AI in ambienti interattivi senza istruzioni, obiettivi dichiarati o regole esplicite. L'agente deve capire tutto da solo tramite prove e osservazione, proprio come farebbe una persona a cui viene dato un gioco che non ha mai visto prima.
Lanciato il 25 marzo 2026 dalla ARC Prize Foundation, ARC-AGI-3 ha prodotto un risultato notevole al rilascio: ogni modello AI all'avanguardia ha ottenuto meno dell'1%, mentre gli esseri umani hanno risolto tutti gli ambienti del benchmark.
ARC-AGI-3 è un benchmark di ragionamento interattivo creato dalla ARC Prize Foundation, co-fondata dal ricercatore di AI François Chollet (creatore di Keras) e Mike Knoop (co-fondatore di Zapier). Il benchmark si basa su quello che il team ARC Prize considera un principio fondamentale: la vera intelligenza non riguarda quanto un sistema sa, ma quanto efficacemente può imparare qualcosa di completamente nuovo.
Mentre le precedenti valutazioni di AI testavano la conoscenza cristallizzata (recuperare fatti memorizzati, applicare euristiche apprese), ARC-AGI-3 punta all'intelligenza fluida, la capacità di ragionare su problemi nuovi e adattarsi a situazioni inedite invece di fare affidamento su ciò che è stato appreso in addestramento. Misura se un agente AI sa esplorare un ambiente sconosciuto, capirne le regole, identificare cosa significa “vincere” e poi agire in modo efficiente sulla base di quella comprensione.
Il benchmark include 135 ambienti tra set pubblici, semi-privati e completamente privati. Ogni ambiente è uno scenario a turni, simile a un gioco, creato da un team di design interno. L'agente non riceve alcun indizio. Osserva semplicemente lo stato del mondo, compie un'azione, vede cosa succede e ripete.
Il paper tecnico descrive il benchmark come un test di quattro capacità fondamentali: esplorazione, modellizzazione, definizione degli obiettivi e pianificazione.
Per assicurarsi che il benchmark misuri il ragionamento e non il richiamo di dati di addestramento, gli ambienti di ARC-AGI-3 evitano linguaggio, numeri, lettere, simboli culturali o oggetti del mondo reale riconoscibili. Si basano invece solo su quelli che il team ARC Prize chiama "Core Knowledge priors", abilità cognitive di base condivise da tutti gli esseri umani.
Questi priors includono l'“oggettualità” (capire che le cose sono entità persistenti che possono muoversi o collidere), geometria e topologia di base (simmetria, rotazione, "dentro" contro "fuori"), fisica di base (momento, gravità, rimbalzo) e “agentività” (riconoscere quando qualcosa nell'ambiente agisce con intenzione). Se un ambiente richiedesse sapere che una chiave apre una serratura, testerebbe i dati di addestramento, non il ragionamento.
Il passaggio da una valutazione statica ad ambienti interattivi cambia ciò che il benchmark può effettivamente misurare.
Ogni ambiente ARC-AGI-3 presenta una griglia 64×64 in cui ogni cella mostra uno dei 16 colori possibili. L'agente riceve uno stato visivo (chiamato “frame”) come oggetto JSON, quindi invia una singola azione per turno. Lo spazio delle azioni è ridotto: in genere cinque comandi direzionali o basati su tasti, più un'opzionale azione di “click” basata su coordinate per selezionare celle specifiche della griglia.
Gli ambienti sono rigorosamente a turni. Nulla cambia finché l'agente non agisce, il che significa che il benchmark premia il ragionamento accurato rispetto ai riflessi rapidi. È importante notare che operazioni interne come passaggi di ragionamento, tentativi o chiamate a strumenti non contano come azioni. Solo i comandi che modificano effettivamente lo stato dell'ambiente sono conteggiati ai fini del punteggio dell'agente.
Ogni ambiente contiene più livelli disposti in ordine di difficoltà crescente. Il primo livello funge da tutorial, introducendo le meccaniche di base con complessità minima. I livelli successivi aggiungono nuove regole e interazioni, così l'agente deve portare avanti ciò che ha imparato e applicarlo in situazioni più complesse.
La difficoltà in ARC-AGI-3 non deriva dall'oscurità o dalla scala. Deriva dalla composizione di più meccaniche apprese lungo i livelli. Un ambiente con una sola meccanica sarebbe troppo facile da forzare a tentativi. La vera prova è combinare diverse dinamiche apprese per risolvere un problema che l'agente non ha mai visto prima.
Il benchmark gira su un motore personalizzato basato su Python progettato per raggiungere una soglia di prestazioni di 1.000 FPS in modalità headless. Gli sviluppatori possono iniziare con pip install arc-agi e interagire con gli ambienti tramite l'SDK o una REST API. Puoi anche giocare agli ambienti pubblici nel tuo browser per farti un'idea di come sono questi giochi.
Una nota iniziale: questi punteggi riflettono lo stato della classifica a fine marzo 2026 e quasi certamente cambieranno man mano che i ricercatori svilupperanno nuovi approcci.
Al lancio, la ARC Prize Foundation ha testato diversi modelli all'avanguardia sul set di valutazione semi-privato.
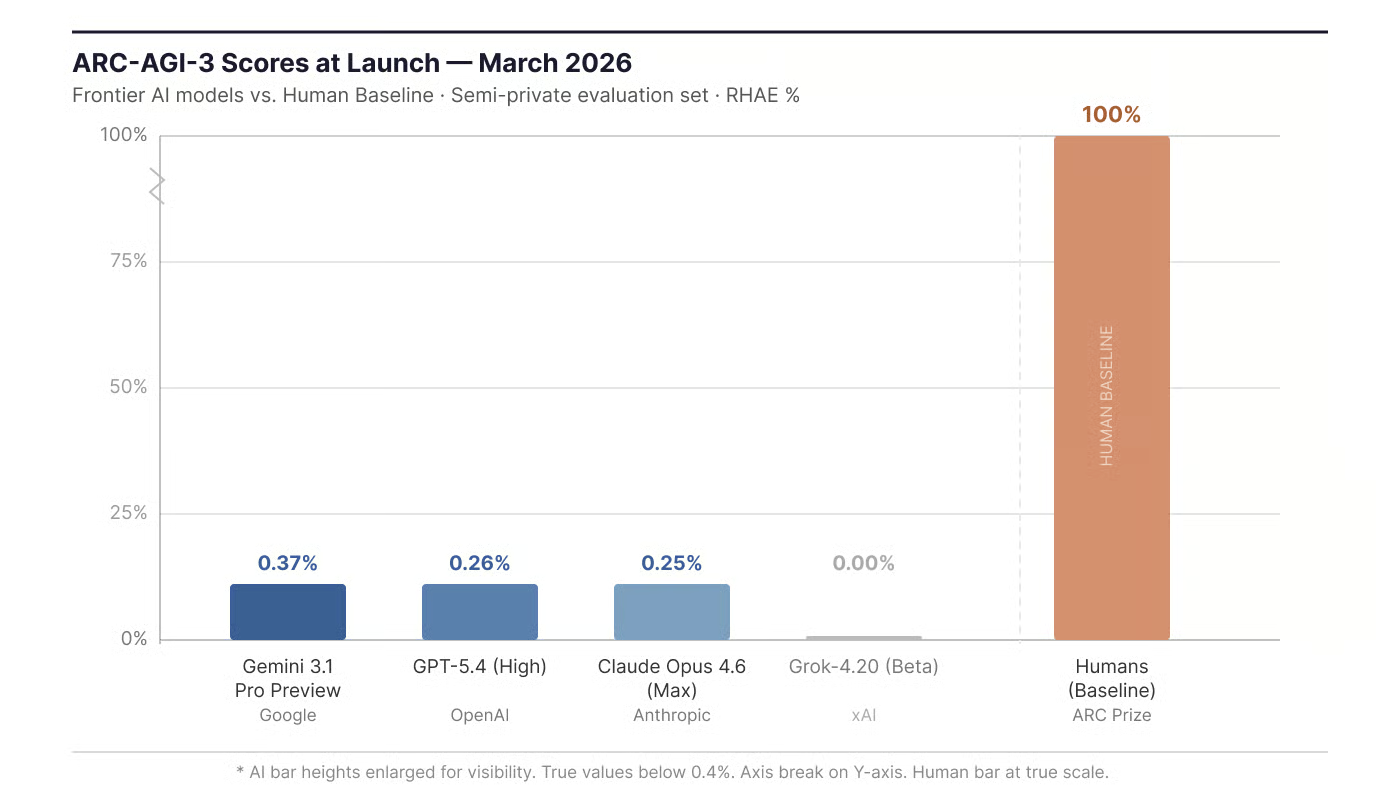
Punteggi al lancio (marzo 2026): AI all'avanguardia contro baseline umana. Immagine dell'autore.
Per contesto, questi stessi modelli all'avanguardia dominano la maggior parte degli altri benchmark di AI. ARC-AGI-1 si avvicina alla saturazione, con i modelli di punta ben oltre il 90%. Il calo a meno dell'1% su ARC-AGI-3 suggerisce che le capacità testate qui sono diverse da quelle in cui gli attuali modelli eccellono.
Lo 0% di Grok-4.20 non significa che il modello non abbia compiuto alcuna azione. Significa che ha superato il limite di azioni del benchmark in ogni livello. Spiegherò come funziona quel limite nella sezione sul punteggio.
Gli agenti con i punteggi più alti durante il periodo di anteprima non erano modelli linguistici. Durante la competizione di anteprima (che utilizzava 3 ambienti pubblici e 3 privati come set di valutazione nascosto), un sistema chiamato StochasticGoose di Tufa Labs ha raggiunto il 12,58% utilizzando un approccio di reinforcement learning con reti neurali convoluzionali.
Quando però StochasticGoose è stato valutato sull'intero benchmark ufficiale al lancio, il suo punteggio è sceso allo 0,25%, più o meno lo stesso livello degli LLM all'avanguardia. Questo risultato è significativo: un approccio che funzionava bene su una manciata di ambienti noti ha fatto molto peggio di fronte all'intera gamma di ambienti inediti, confermando quanto ARC-AGI-3 dipenda dall'adattabilità generale piuttosto che dall'ottimizzazione specifica del compito.
Ciò suggerisce che il formato interattivo potrebbe funzionare meglio con architetture diverse, dato che un modello linguistico non può ragionare su un problema quando le informazioni necessarie emergono solo dopo ogni azione.
Puoi consultare i punteggi più recenti sulla classifica di ARC-AGI-3.
Questi numeri assumono un altro significato sapendo cosa testavano i precedenti benchmark ARC. ARC-AGI-1, rilasciato da Chollet nel 2019, ha introdotto il concetto di misurare l'intelligenza fluida tramite enigmi visivi astratti. Il formato era statico: il modello vedeva alcuni esempi di input-output a griglia, deduceva la regola di trasformazione e produceva un singolo output. ARC-AGI-2, rilasciato nel marzo 2025, utilizzava lo stesso formato statico ma con compiti più difficili e composizionali.
ARC-AGI-1 ha aiutato a identificare l'emergere dei grandi modelli di ragionamento come nuova categoria, con o3 di OpenAI come primo segnale chiaro. ARC-AGI-2 ha seguito la rapidità con cui quella capacità di ragionamento è cresciuta. Ma il formato statico aveva una vulnerabilità: lo scaling del calcolo al momento del test. Generando migliaia di soluzioni candidate in parallelo durante l'inferenza, i laboratori hanno spinto i punteggi di ARC-AGI-2 da valori a una cifra a ben oltre il 50% in un anno.
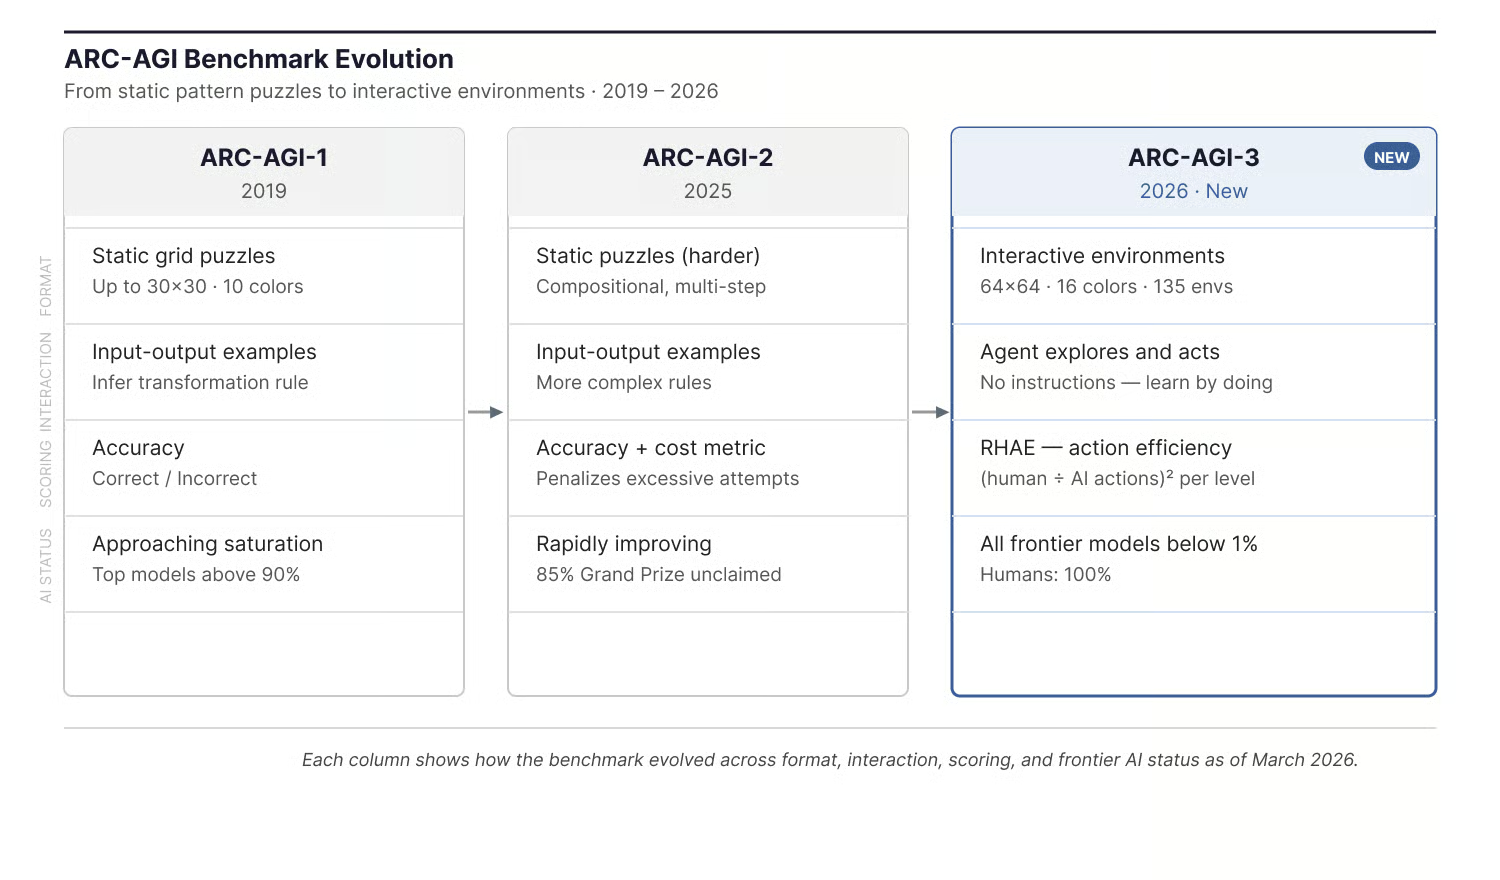
Evoluzione nel tempo dei benchmark ARC-AGI. Immagine dell'autore.
ARC-AGI-3 rende molto più difficile adottare strategie di campionamento brute-force perché, come accennato, l'ambiente rivela le sue regole solo dopo che l'agente agisce. Non puoi generare 10.000 soluzioni candidate in una finestra di contesto quando il problema cambia a ogni azione.
Oltre al formato interattivo, ARC-AGI-3 include scelte di design specifiche per contrastare le scorciatoie di contaminazione dei dati e generazione sintetica che hanno influenzato le versioni precedenti. Il cambiamento più significativo è il rapporto invertito del dataset. ARC-AGI-1 e ARC-AGI-2 avevano circa un rapporto 10:1 di compiti pubblici rispetto a quelli privati, offrendo ai ricercatori ampio materiale di addestramento. ARC-AGI-3 inverte questo: solo 25 ambienti sono pubblici, mentre la grande maggioranza è trattenuta in set semi-privati e completamente privati usati per la valutazione.
Il team ARC Prize ha anche segnalato evidenze che suggeriscono che alcuni modelli all'avanguardia possano avere dati ARC nei set di addestramento. Durante la valutazione di ARC-AGI-2, il chain-of-thought di Gemini 3 ha fatto riferimento a mappature di colori specifiche di ARC senza che gli fossero state suggerite, il che suggerisce saturazione dei dati di addestramento. Riducendo la superficie pubblica e passando ad ambienti interattivi che non possono essere memorizzati come schemi statici, ARC-AGI-3 mira a rendere molto più difficile questo tipo di scorciatoia.
Queste scelte di design hanno più senso una volta compreso cosa il benchmark stia effettivamente cercando di testare. Il benchmark mira a ciò che il team ARC Prize descrive come "efficienza di acquisizione delle abilità": quanto rapidamente ed efficacemente un agente AI può imparare qualcosa che non ha mai incontrato prima.
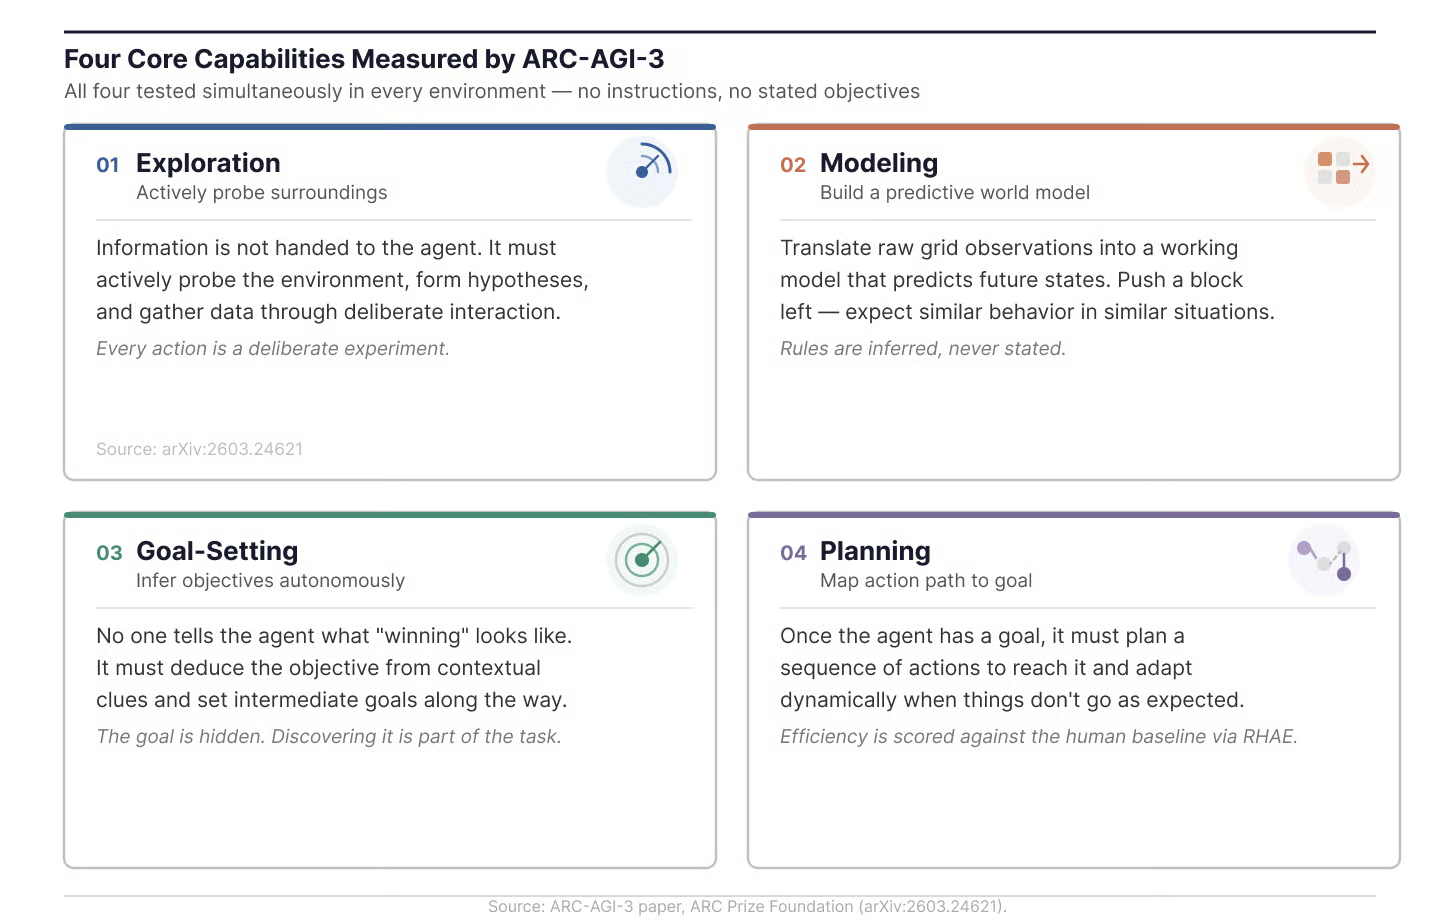
Quattro capacità fondamentali misurate da ARC-AGI-3. Immagine dell'autore.
Queste quattro aree sono testate simultaneamente in ogni ambiente, senza istruzioni e senza obiettivi dichiarati in alcun momento.
Un punteggio del 100% su ARC-AGI-3 significherebbe che un agente AI può risolvere ogni ambiente con l'efficienza del secondo miglior tester umano. Il team ARC Prize è chiaro che questo non equivale all'AGI. Significherebbe che un particolare divario tra apprendimento AI e umano è stato colmato.
Il punteggio è l'aspetto in cui ARC-AGI-3 differisce maggiormente dai benchmark precedenti. Non verifica solo se l'agente alla fine inciampa in una soluzione. Misura quanto efficientemente ci arriva.
La metrica si chiama RHAE, acronimo di Relative Human Action Efficiency. La formula per livello è:
Punteggio livello = min(1.0, (azioni_baseline_umane / azioni_AI))²
Il dettaglio chiave è il termine al quadrato. Non è una relazione lineare. Raddoppiare il numero di azioni non dimezza il punteggio; lo riduce a un quarto. Dieci volte le azioni fanno precipitare il punteggio quasi a zero. Questo disegno a legge di potenza penalizza fortemente gli approcci brute-force e premia gli agenti che imparano davvero come funziona l'ambiente.
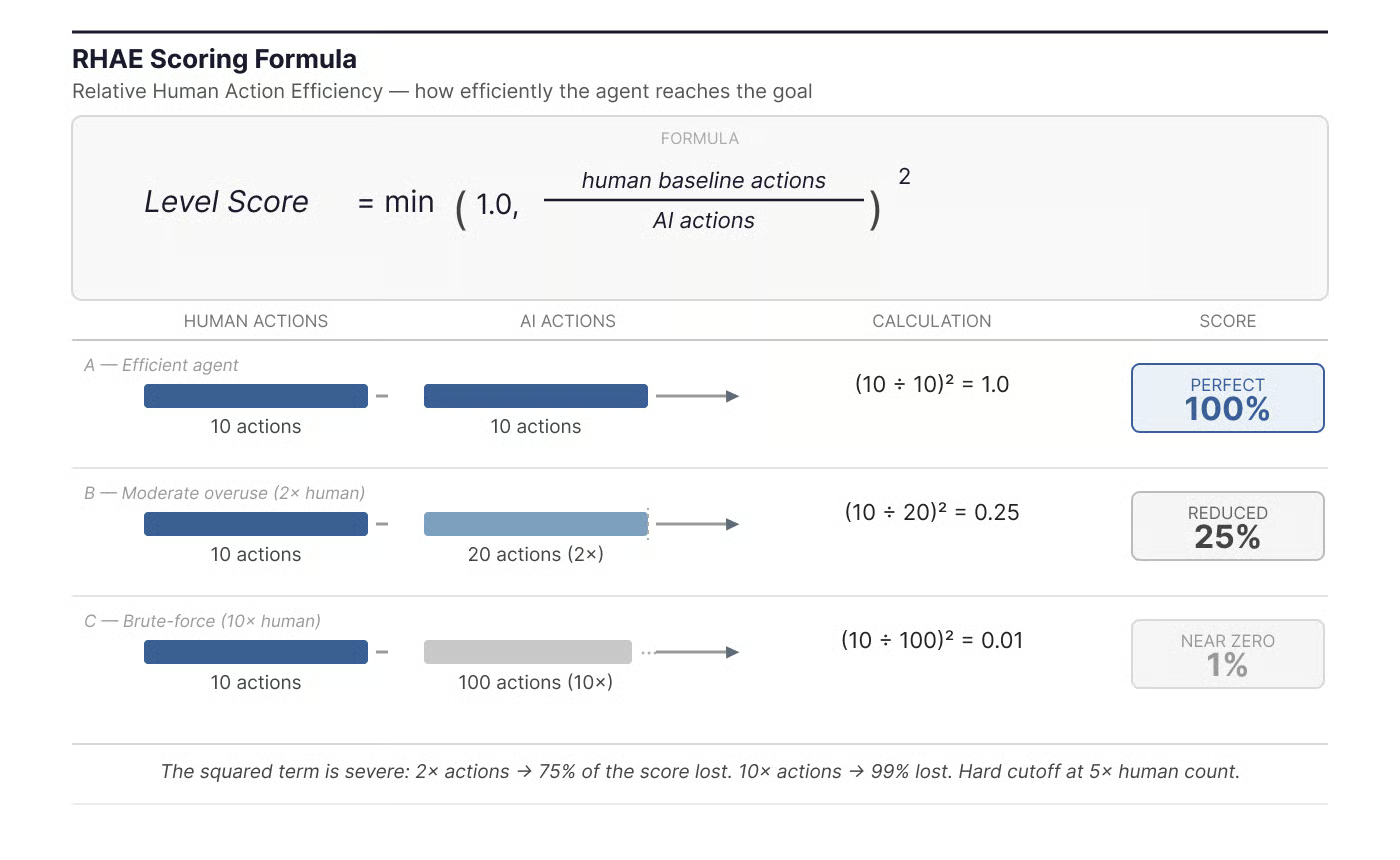
Formula di punteggio RHAE con esempi pratici. Immagine dell'autore.
La baseline umana è stabilita dal secondo miglior performer su 10 tester che hanno affrontato ogni ambiente alla prima esposizione. Usare il secondo miglior invece del migliore assoluto filtra gli outlier fortunati pur restando ancorati al gioco reale.
C'è anche un limite rigido: se un agente impiega più di 5 volte il numero di azioni umane in un livello, viene interrotto e ottiene zero per quel livello. E i punteggi sono limitati a 1,0, quindi scoprire una scorciatoia non prevista che batte la baseline umana non dà crediti extra.
All'interno di ogni ambiente, i livelli successivi contano di più. Il punteggio utilizza una media ponderata in cui il Livello 1 ha peso 1, il Livello 2 ha peso 2 e così via. Questo significa che i livelli tutorial incidono poco, mentre i livelli più difficili che richiedono di combinare più meccaniche apprese hanno il peso maggiore.
ARC-AGI-3 mantiene due classifiche separate con regole diverse. La classifica Official valuta i modelli all'avanguardia usando sistemi API generalisti che non sono stati preparati appositamente per ARC-AGI-3. La classifica Community consente risultati auto-dichiarati e ammette harness. Questa distinzione è importante perché, come accennato, harness costruiti a mano possono gonfiare drasticamente i punteggi su ambienti noti fallendo completamente su quelli inediti. La classifica Official è progettata per misurare la reale adattabilità dell'AI, non l'impalcatura del developer.
ARC-AGI-3 è il fulcro della competizione di quest'anno, ma non è l'unica track.
ARC Prize 2026 ha un montepremi totale di oltre 2 milioni di dollari distribuito su tre track. La track ARC-AGI-3 offre 850.000 dollari in premi totali, con in testa un Grand Prize da 700.000 dollari per il primo agente idoneo che raggiunge il 100% sul set di valutazione completamente privato. Se nessuno lo reclama quest'anno, i fondi verranno riportati al 2027. Oltre al Grand Prize, c'è un premio per il punteggio più alto da 75.000 dollari suddiviso tra i primi cinque classificati, e due checkpoint intermedi (30 giugno e 30 settembre 2026) che distribuiscono ciascuno 37.500 dollari tra le prime tre squadre a quella data.
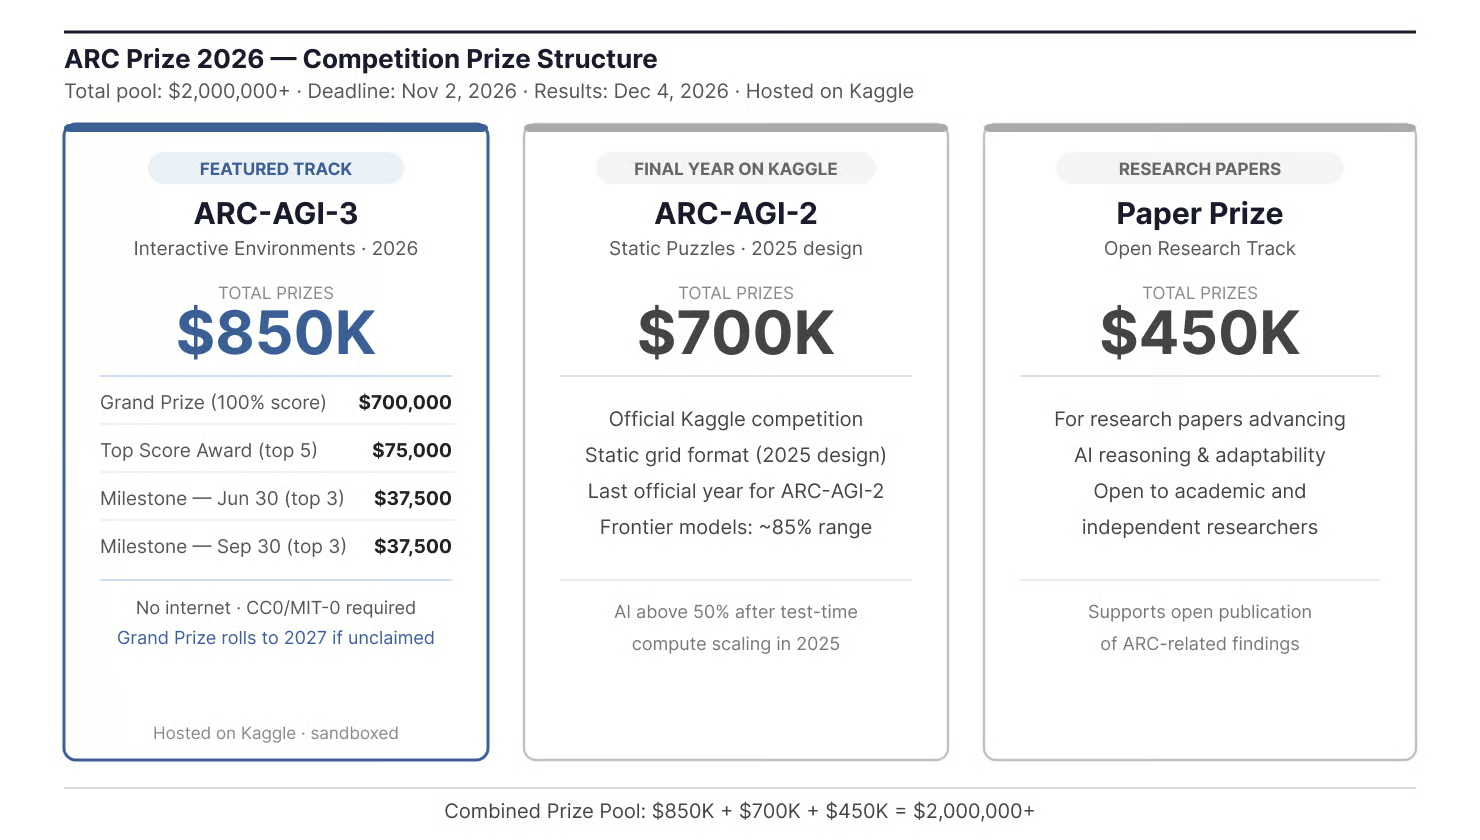
Struttura dei premi della competizione ARC Prize 2026. Immagine dell'autore.
Le altre due track sono una track ARC-AGI-2 (700.000 dollari, e in particolare l'ultimo anno in cui ARC-AGI-2 sarà utilizzato in una competizione ufficiale su Kaggle) e una track Paper Prize (450.000 dollari per articoli di ricerca).
La competizione si svolge su Kaggle, ma con regole che la distinguono da una tipica competizione Kaggle. Le submission vengono valutate in un ambiente sandbox senza accesso a Internet, il che esclude chiamate API a modelli ospitati come GPT, Claude o Gemini. Tutte le soluzioni idonee ai premi devono essere rilasciate con una licenza permissiva o di pubblico dominio (CC0 o MIT-0) prima di ricevere i punteggi di valutazione privata. La competizione si è aperta il 25 marzo 2026, con scadenza finale per l'invio il 2 novembre 2026 e risultati annunciati il 4 dicembre 2026.
I benchmark contano soprattutto quando rivelano un divario che prima non sembrava tale. Da questo punto di vista, i primi due benchmark ARC si sono guadagnati il posto: ARC-AGI-1 ha messo in luce l'emergere dei grandi modelli di ragionamento e ARC-AGI-2 ha seguito fino a che punto potesse arrivare lo scaling del calcolo al test-time. ARC-AGI-3 indica un problema diverso.
Ciò che rende questo benchmark rilevante ora è il contesto. All'inizio del 2026, molti benchmark di AI ampiamente utilizzati si avvicinano alla saturazione. I modelli all'avanguardia superano il 90% su MMLU, HumanEval e GSM8K, tra gli altri, il che limita quanto queste valutazioni possano dirci sulle differenze tra sistemi. ARC-AGI-3 testa una capacità che gli attuali modelli sembrano non avere: imparare al volo dentro ambienti sconosciuti. Il divario tra punteggi AI sotto l'1% e risolvibilità umana al 100% è abbastanza grande da suggerire che non si tratti solo di una versione più difficile dello stesso test, ma di una sfida di tipo diverso.
ARC Prize presenta ARC-AGI-3 come il test più importante di ragionamento interattivo, anche se vale la pena ricordare che questa impostazione viene dall'organizzazione che gestisce il benchmark. Se reggerà dipenderà da come il benchmark si comporterà man mano che i ricercatori si adatteranno ad esso.
Nessun benchmark è perfetto e ARC-AGI-3 ha ricevuto alcune critiche degne di nota.
Una preoccupazione comune riguarda la formula di punteggio stessa. La metrica di efficienza al quadrato penalizza pesantemente l'esplorazione, che è a buon diritto un segno di intelligenza piuttosto che un fallimento. Se un agente impiega 50 azioni per mappare accuratamente le condizioni limite prima di raggiungere una soluzione, ottiene un punteggio molto peggiore di un umano che indovina la regola in 5 azioni. Alcuni membri della community hanno sostenuto che ciò faccia apparire il divario di prestazioni artificialmente ampio.
C'è anche la questione della selezione della baseline. Come trattato nella sezione sul punteggio, il benchmark usa il secondo miglior tester umano invece della media, fissando l'asticella in alto. Anche gli umani “tipici” con questo approccio otterrebbero meno del 100%.
Il team ARC Prize presenta il benchmark come un tentativo scientifico di misurare una specifica capacità mancante, non come un test definitivo di intelligenza generale. È una lettura corretta alla luce di ciò che sappiamo oggi.
ARC-AGI-3 adotta un approccio diverso per valutare i sistemi di AI. Passando dai puzzle statici agli ambienti interattivi, testa se i modelli sanno esplorare, definire i propri obiettivi e capire le cose tramite l'esperienza anziché tramite istruzioni.
I numeri iniziali sono impressionanti. Modelli che dominano benchmark di coding, gare di matematica e test di conoscenza faticano a superare l'1% qui. Se quel divario si chiuderà rapidamente, come accaduto con i precedenti benchmark ARC, o se il formato interattivo si dimostrerà più difficile da scalfire è qualcosa che vale la pena osservare da vicino.
Per approfondire i concetti alla base dei sistemi di AI adattivi, dai un'occhiata al nostro percorso AI Fundamentals o al nostro corso su Building Scalable Agentic Systems.
Impara con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min