
Khóa học
Hiểu về Trí tuệ Nhân tạo
2 giờ
426.1K
Hầu hết các thước đo AI đều theo một công thức: đưa câu hỏi cho mô hình, nhận câu trả lời, kiểm tra đúng sai. Nhiều năm qua, cách làm này khá hiệu quả. Nhưng khi các mô hình tiên phong bắt đầu đạt trên 90% ở hầu hết các bài đánh giá lớn, một vấn đề quen thuộc xuất hiện: các thước đo dần mất khả năng phân biệt mô hình này với mô hình khác.
ARC-AGI-3 chọn một hướng khác. Thay vì đưa ra các câu đố tĩnh với cặp vào–ra rõ ràng, nó thả các tác tử AI vào những môi trường tương tác không có hướng dẫn, không có mục tiêu nêu sẵn, và không có quy tắc tường minh. Tác tử phải tự tìm ra mọi thứ qua thử nghiệm và quan sát, giống như cách một người học chơi một trò mới toanh.
Ra mắt ngày 25 tháng 3, 2026 bởi ARC Prize Foundation, ARC-AGI-3 tạo ra một kết quả đáng chú ý ngay khi công bố: mọi mô hình AI tiên phong đều đạt dưới 1%, trong khi con người giải được toàn bộ các môi trường của thước đo.
ARC-AGI-3 là một thước đo lập luận tương tác do ARC Prize Foundation tạo ra, đồng sáng lập bởi nhà nghiên cứu AI François Chollet (tác giả Keras) và Mike Knoop (đồng sáng lập Zapier). Thước đo này dựa trên một nguyên lý cốt lõi theo đội ngũ ARC Prize: trí tuệ thực sự không nằm ở lượng kiến thức hệ thống sở hữu, mà ở hiệu quả khi học điều hoàn toàn mới.
Nếu các bài đánh giá trước đây kiểm tra kiến thức “kết tinh” (truy xuất sự kiện đã ghi nhớ, áp dụng heuristic đã học), thì ARC-AGI-3 nhắm đến trí thông minh “linh hoạt”: khả năng lý luận qua các vấn đề mới và thích ứng với tình huống mới thay vì dựa vào những gì đã học trong huấn luyện. Nó đo xem một tác tử AI có thể khám phá một môi trường xa lạ, tự tìm ra quy tắc, xác định “chiến thắng” là gì, rồi hành động hiệu quả dựa trên hiểu biết đó hay không.
Bộ thước đo gồm 135 môi trường thuộc các bộ công khai, bán riêng tư và hoàn toàn riêng tư. Mỗi môi trường là một kịch bản dạng trò chơi theo lượt do đội ngũ thiết kế nội bộ xây dựng. Tác tử không nhận được gì để bám víu. Nó chỉ quan sát trạng thái thế giới, thực hiện một hành động, xem điều gì xảy ra, rồi lặp lại.
Bài báo cáo kỹ thuật mô tả thước đo này là phép thử bốn năng lực cốt lõi: khám phá, mô hình hóa, đặt mục tiêu và lập kế hoạch.
Để đảm bảo thước đo đo năng lực lập luận chứ không phải khả năng nhớ dữ liệu huấn luyện, các môi trường ARC-AGI-3 tránh sử dụng ngôn ngữ, số, chữ cái, biểu tượng văn hóa, hay vật thể đời thực dễ nhận diện. Thay vào đó, chúng chỉ dựa vào cái gọi là “tiên nghiệm Tri thức Cốt lõi” của đội ngũ ARC Prize: những năng lực nhận thức cơ bản mà mọi con người đều có.
Các tiên nghiệm này gồm tính vật thể (hiểu rằng sự vật là thực thể bền vững có thể di chuyển hoặc va chạm), hình học và tôpô cơ bản (đối xứng, xoay, “bên trong” so với “bên ngoài”), vật lý cơ bản (đà, trọng lực, nảy), và tính tác tử (nhận biết khi một thứ trong môi trường hành xử có chủ ý). Nếu một môi trường đòi hỏi biết chìa khóa mở ổ khóa, thì đó là kiểm tra dữ liệu huấn luyện, không phải lập luận.
Việc chuyển từ đánh giá tĩnh sang môi trường tương tác làm thay đổi những gì thước đo có thể đo lường thực sự.
Mỗi môi trường ARC-AGI-3 hiển thị một lưới 64×64, mỗi ô có một trong 16 màu. Tác tử nhận trạng thái trực quan (gọi là “khung hình”) dưới dạng đối tượng JSON, rồi gửi một hành động cho mỗi lượt. Không gian hành động nhỏ: thường là năm lệnh hướng hoặc phím, cộng thêm một hành động “nhấp” theo tọa độ để chọn các ô cụ thể.
Các môi trường hoàn toàn theo lượt. Không có gì thay đổi cho đến khi tác tử hành động, nghĩa là thước đo ưu tiên lập luận cẩn trọng hơn là phản xạ nhanh. Quan trọng là, các thao tác nội bộ như bước lập luận, thử lại, hay gọi công cụ không bị tính là hành động. Chỉ những lệnh thực sự làm thay đổi trạng thái môi trường mới được tính vào điểm số của tác tử.
Mỗi môi trường gồm nhiều cấp độ sắp theo thứ tự tăng dần độ khó. Cấp đầu đóng vai trò hướng dẫn, giới thiệu cơ chế cơ bản với độ phức tạp tối thiểu. Các cấp sau bổ sung quy tắc và tương tác mới, buộc tác tử mang những gì đã học áp dụng vào tình huống phức tạp hơn.
Độ khó trong ARC-AGI-3 không đến từ tính đánh đố hay quy mô, mà từ sự kết hợp nhiều cơ chế đã học qua các cấp. Một môi trường chỉ có một cơ chế quá dễ để thử mò. Bài test thực sự là phối hợp nhiều động lực đã học để giải một vấn đề mà tác tử chưa từng thấy.
Bộ thước đo chạy trên một engine tùy biến dựa trên Python, thiết kế để đạt ngưỡng hiệu năng 1.000 FPS ở chế độ headless. Nhà phát triển có thể bắt đầu với pip install arc-agi và tương tác với môi trường qua SDK hoặc REST API. Bạn cũng có thể chơi các môi trường công khai trên trình duyệt để cảm nhận các trò chơi này.
Cần lưu ý trước: các điểm số này phản ánh bảng xếp hạng vào cuối tháng 3/2026 và gần như chắc chắn sẽ thay đổi khi các nhà nghiên cứu phát triển phương pháp mới.
Khi ra mắt, ARC Prize Foundation đã thử nghiệm một số mô hình tiên phong trên bộ đánh giá bán riêng tư.
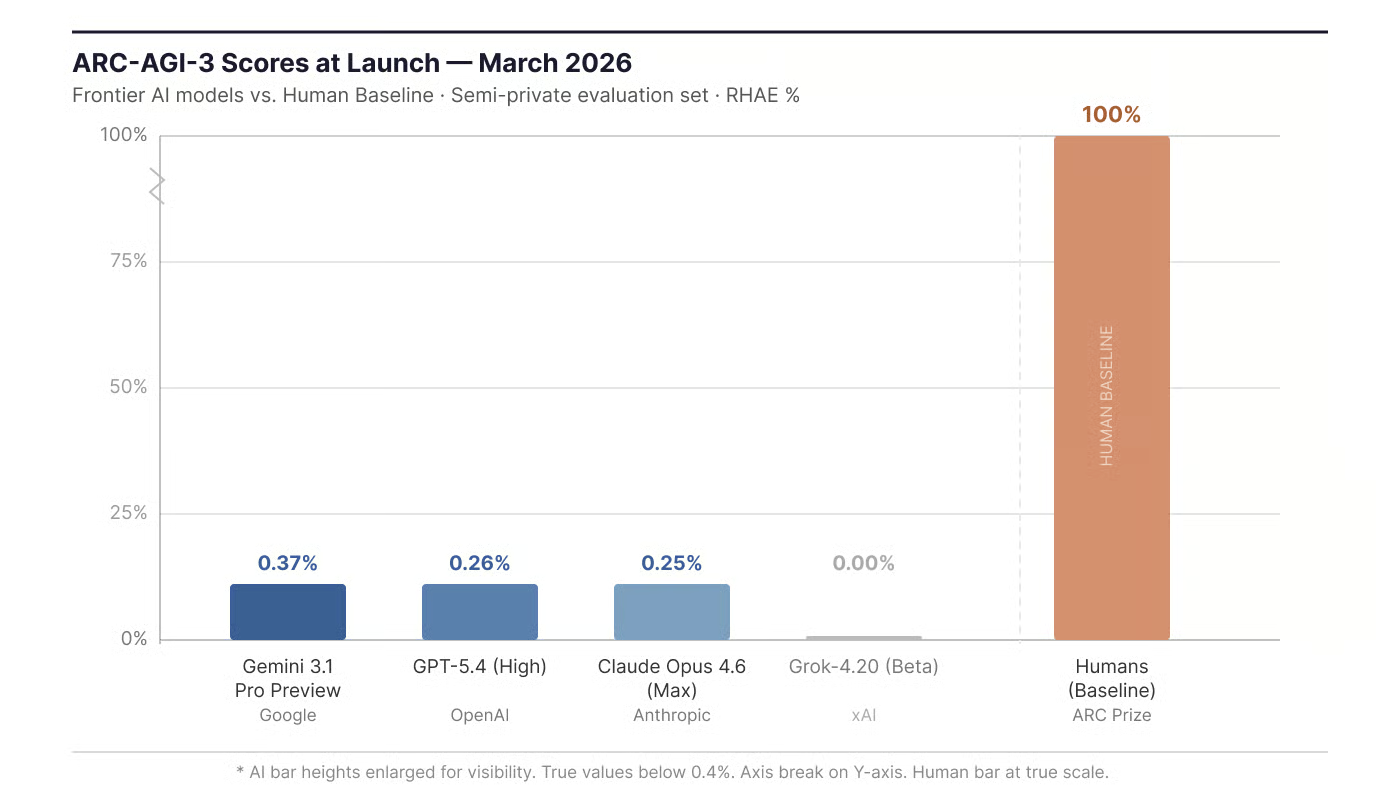
Điểm số lúc ra mắt (tháng 3/2026): AI tiên phong so với mốc con người. Hình do Tác giả thực hiện.
Để so sánh, chính các mô hình tiên phong này dẫn đầu ở đa số thước đo AI khác. ARC-AGI-1 đang tiến tới bão hòa, các mô hình hàng đầu hiện đạt trên 90%. Việc rơi xuống dưới 1% ở ARC-AGI-3 gợi ý năng lực được kiểm tra ở đây khác với những gì các mô hình hiện tại làm tốt.
Điểm 0% của Grok-4.20 không có nghĩa là mô hình không thực hiện hành động nào. Nó có nghĩa mô hình đã vượt quá ngưỡng cắt hành động ở mọi cấp độ. Tôi sẽ giải thích cách ngưỡng này hoạt động trong phần chấm điểm.
Các tác tử đứng đầu giai đoạn xem trước không phải là mô hình ngôn ngữ. Trong cuộc thi xem trước (dùng 3 môi trường công khai và 3 môi trường riêng tư làm bộ đánh giá ẩn), một hệ thống tên StochasticGoose của Tufa Labs đạt 12,58% nhờ phương pháp học tăng cường với mạng nơ-ron tích chập.
Tuy nhiên, khi StochasticGoose được đánh giá trên toàn bộ thước đo chính thức lúc ra mắt, điểm số giảm còn 0,25%, xấp xỉ mức của các LLM tiên phong. Kết quả đó nói lên nhiều điều: một cách tiếp cận hiệu quả trên vài môi trường đã biết lại kém hẳn khi đối mặt dải môi trường chưa từng thấy, nhấn mạnh ARC-AGI-3 phụ thuộc nhiều vào khả năng thích ứng nói chung hơn là tối ưu hóa theo tác vụ cụ thể.
Điều này gợi ý định dạng tương tác có thể phù hợp hơn với các kiến trúc khác, vì mô hình ngôn ngữ không thể lý luận trọn vẹn khi thông tin cần thiết chỉ xuất hiện sau mỗi hành động.
Bạn có thể xem điểm số mới nhất trên bảng xếp hạng ARC-AGI-3.
Những con số này trông khác đi khi bạn hiểu các thước đo ARC trước đó kiểm tra điều gì. ARC-AGI-1, Chollet công bố năm 2019, giới thiệu khái niệm đo trí thông minh linh hoạt qua các câu đố thị giác trừu tượng. Định dạng là tĩnh: mô hình nhìn vài ví dụ lưới vào–ra, suy ra quy tắc biến đổi, rồi tạo ra một đầu ra. ARC-AGI-2, phát hành tháng 3/2025, dùng cùng định dạng tĩnh nhưng với nhiệm vụ khó hơn, tính hợp thành cao hơn.
ARC-AGI-1 giúp nhận diện sự xuất hiện của các mô hình lập luận lớn như một phân khúc mới, với o3 của OpenAI là dấu hiệu rõ ràng đầu tiên. ARC-AGI-2 theo dõi tốc độ mở rộng của năng lực lập luận đó. Nhưng định dạng tĩnh có một điểm yếu: mở rộng tính toán ở thời điểm suy luận. Bằng cách tạo song song hàng nghìn lời giải ứng viên trong lúc suy luận, các phòng lab đã đẩy điểm ARC-AGI-2 từ một chữ số lên trên 50% chỉ trong vòng một năm.
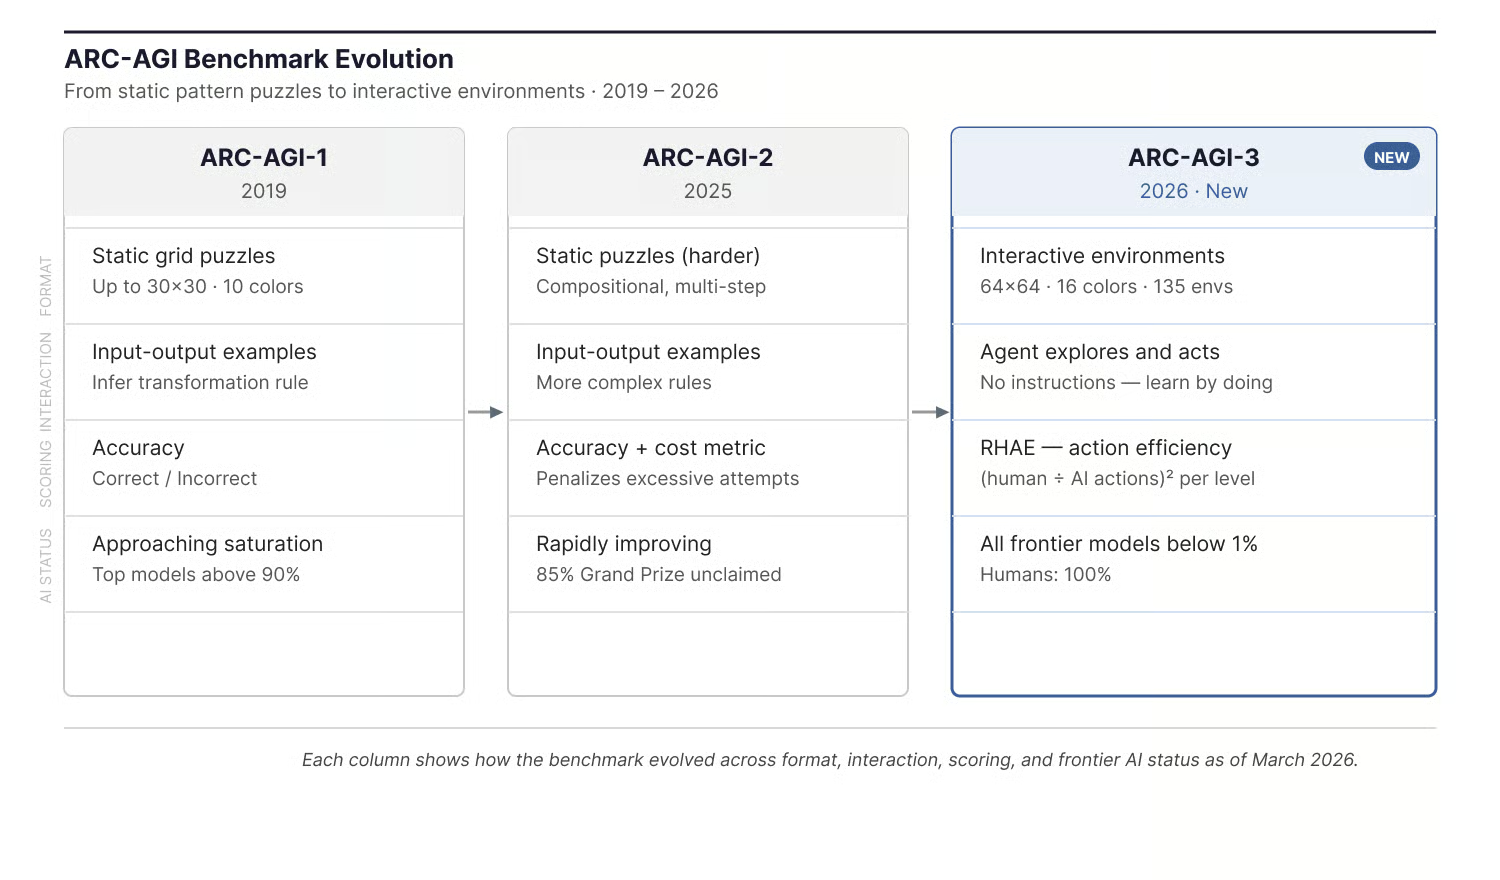
Tiến hóa của các thước đo ARC-AGI theo thời gian. Hình do Tác giả thực hiện.
ARC-AGI-3 khiến chiến lược lấy mẫu brute-force khó áp dụng hơn nhiều vì như đã nói, môi trường chỉ hé lộ quy tắc sau khi tác tử hành động. Bạn không thể tạo 10.000 lời giải ứng viên trong một cửa sổ ngữ cảnh khi vấn đề thay đổi qua từng hành động.
Ngoài định dạng tương tác, ARC-AGI-3 còn có những lựa chọn thiết kế nhằm chống lại vấn đề nhiễm dữ liệu và sinh tổng hợp từng ảnh hưởng các phiên bản trước. Thay đổi đáng chú ý nhất là tỷ lệ bộ dữ liệu đảo ngược. ARC-AGI-1 và ARC-AGI-2 có tỷ lệ nhiệm vụ công khai so với riêng tư khoảng 10:1, cho các nhà nghiên cứu rất nhiều tư liệu huấn luyện. ARC-AGI-3 đảo ngược: chỉ 25 môi trường công khai, còn đa số được giữ ở bộ bán riêng tư và hoàn toàn riêng tư để đánh giá.
Đội ngũ ARC Prize cũng nêu bằng chứng cho thấy một số mô hình tiên phong có thể chứa dữ liệu ARC trong tập huấn luyện. Trong đánh giá ARC-AGI-2, lập luận chuỗi suy nghĩ của Gemini 3 đã tự động tham chiếu ánh xạ màu đặc thù của ARC dù không được nhắc, gợi ý tình trạng bão hòa dữ liệu huấn luyện. Bằng cách giảm bề mặt công khai và chuyển sang môi trường tương tác không thể ghi nhớ như các mẫu tĩnh, ARC-AGI-3 hướng tới việc làm cho dạng “đi tắt” này khó hơn nhiều.
Những lựa chọn thiết kế đó sẽ dễ hiểu hơn khi bạn biết thước đo thực sự muốn kiểm tra điều gì. Thước đo nhắm tới cái mà đội ngũ ARC Prize mô tả là “hiệu quả tiếp thu kỹ năng”: mức độ hiệu quả mà một tác tử AI có thể học thứ nó chưa từng gặp.
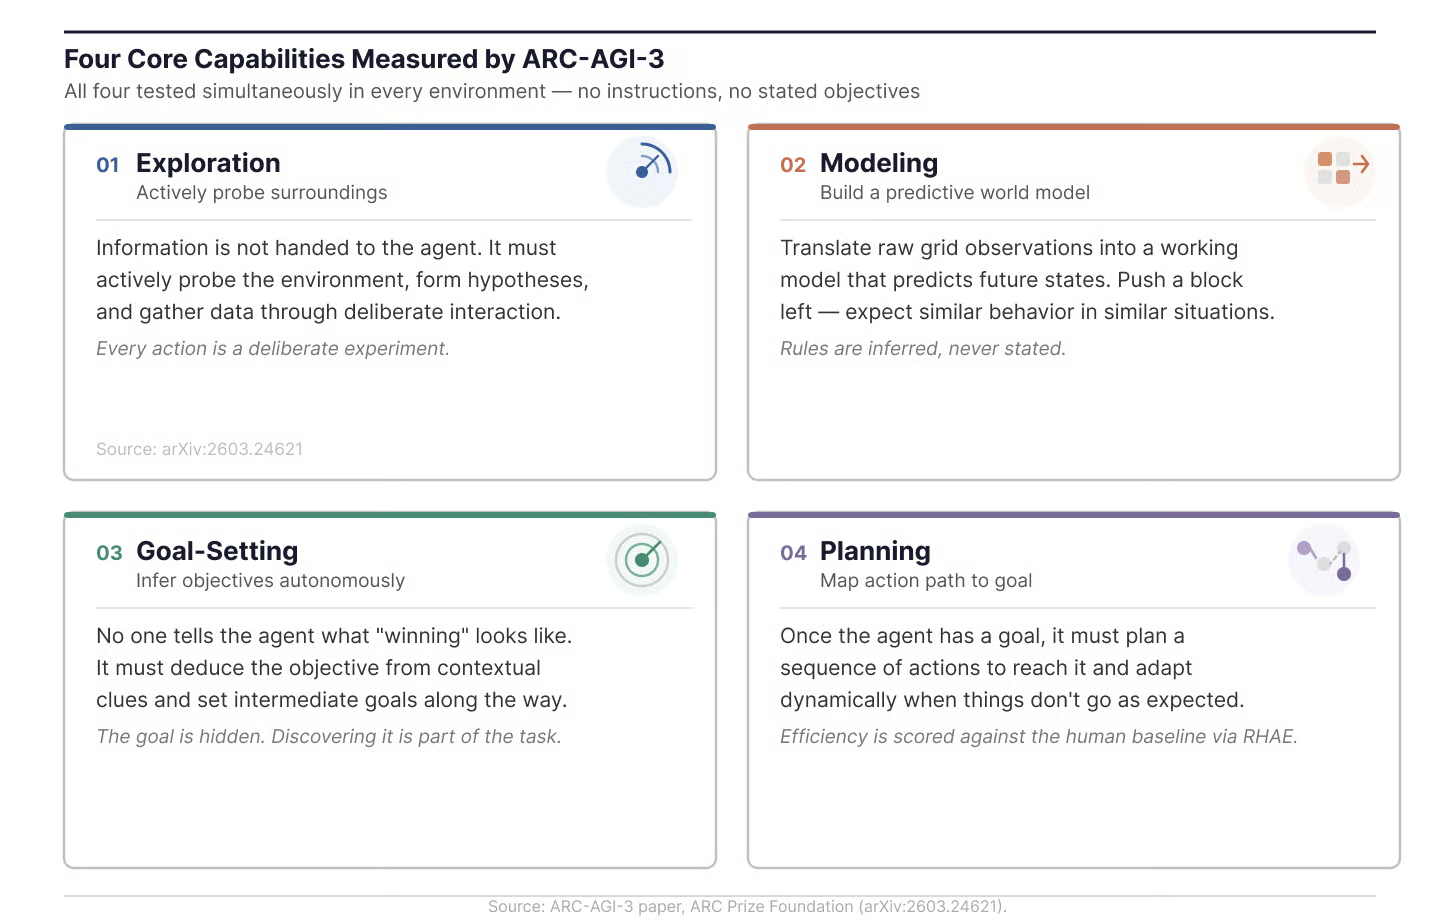
Bốn năng lực cốt lõi được ARC-AGI-3 đo lường. Hình do Tác giả thực hiện.
Bốn khía cạnh này được kiểm tra đồng thời trong mọi môi trường, không có hướng dẫn hay mục tiêu nêu sẵn ở bất kỳ thời điểm nào.
Điểm 100% trên ARC-AGI-3 có nghĩa một tác tử AI có thể giải mọi môi trường hiệu quả ngang người thử nghiệm tốt thứ hai. Đội ngũ ARC Prize nói rõ đây không đồng nghĩa AGI. Nó chỉ cho thấy một khoảng cách cụ thể giữa học của AI và con người đã được thu hẹp.
Chấm điểm là nơi ARC-AGI-3 khác biệt nhất so với các thước đo trước. Nó không chỉ kiểm tra liệu tác tử rốt cuộc có tình cờ ra lời giải hay không. Nó đo mức độ hiệu quả để tác tử đi đến đó.
Chỉ số gọi là RHAE, viết tắt của Hiệu quả Hành động Tương đối so với Con người (Relative Human Action Efficiency). Công thức cho mỗi cấp độ là:
Điểm cấp độ = min(1.0, (human_baseline_actions / AI_actions))²
Chi tiết then chốt là số mũ bình phương. Đây không phải quan hệ tuyến tính. Gấp đôi số hành động không làm điểm giảm còn một nửa; nó giảm còn một phần tư. Gấp mười lần hành động khiến điểm gần như về 0. Thiết kế theo luật lũy thừa này trừng phạt mạnh các cách brute-force và thưởng cho tác tử thực sự học cách môi trường vận hành.
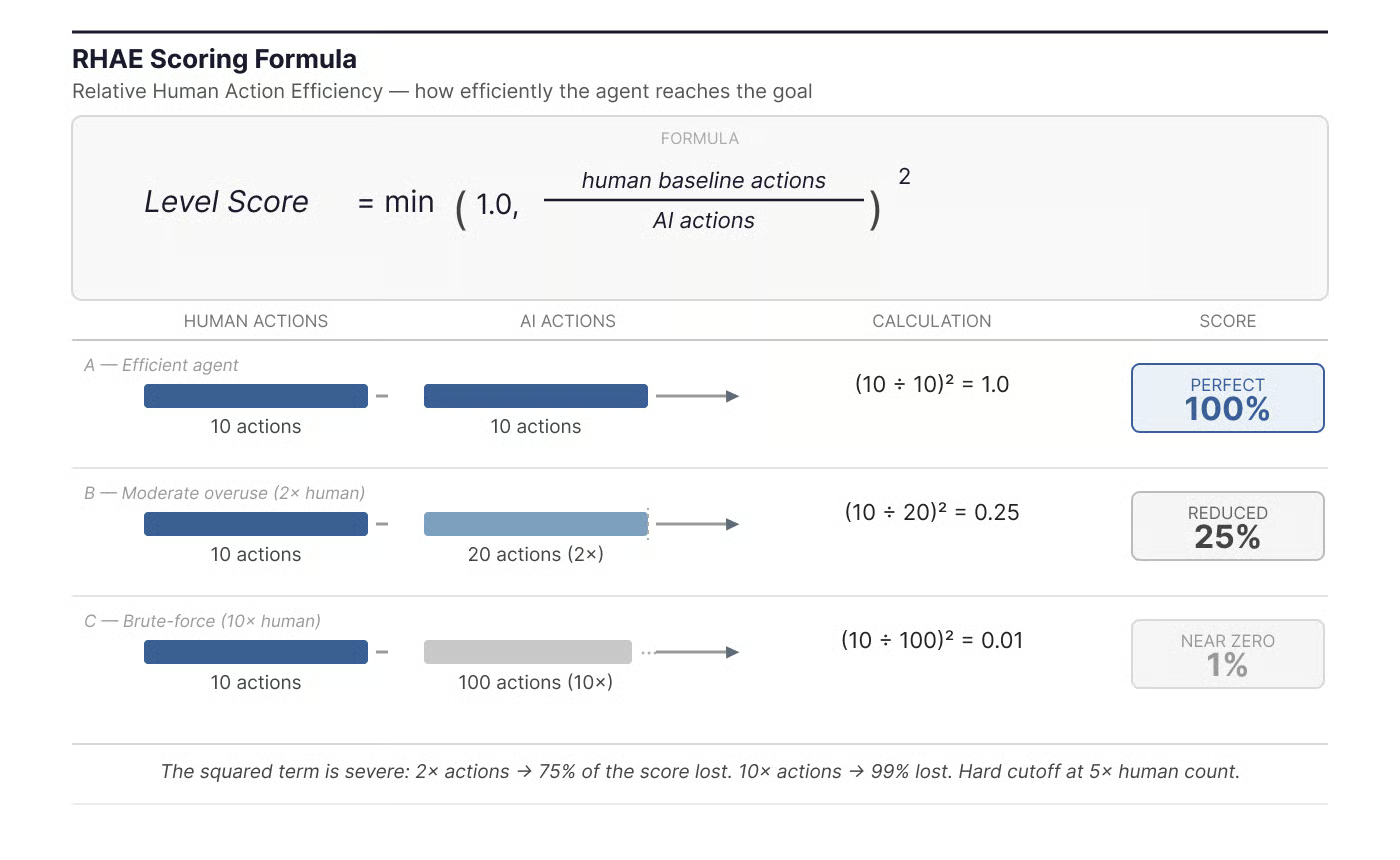
Công thức RHAE với ví dụ minh họa. Hình do Tác giả thực hiện.
Mốc con người được đặt theo người đạt thành tích tốt thứ hai trong số 10 người thử nghiệm mỗi môi trường lần đầu. Dùng người tốt thứ hai thay vì người tốt nhất loại bỏ ngoại lệ may mắn mà vẫn bám sát thực tế chơi.
Cũng có ngưỡng cứng: nếu tác tử thực hiện quá 5 lần số hành động của con người ở bất kỳ cấp độ nào, nó bị cắt và nhận 0 điểm cho cấp đó. Điểm cũng bị chặn ở 1.0, nên nếu phát hiện “đường tắt” ngoài ý muốn tốt hơn mốc con người thì cũng không được cộng thêm điểm.
Trong mỗi môi trường, các cấp sau nặng điểm hơn. Việc chấm dùng trung bình trọng số, với Cấp 1 trọng số 1, Cấp 2 trọng số 2, v.v. Điều này có nghĩa các cấp hướng dẫn hầu như không ảnh hưởng điểm, còn các cấp khó đòi hỏi phối hợp nhiều cơ chế đã học sẽ có sức nặng lớn nhất.
ARC-AGI-3 duy trì hai bảng xếp hạng riêng với quy tắc khác nhau. Bảng Official đánh giá các mô hình tiên phong dùng hệ thống API mục đích chung, không được chuẩn bị đặc thù cho ARC-AGI-3. Bảng Community cho phép tự báo cáo kết quả và chấp nhận các harness. Sự khác biệt này quan trọng vì như đã nêu, các harness thủ công có thể thổi phồng điểm trên môi trường đã biết trong khi thất bại hoàn toàn ở môi trường chưa thấy. Bảng Official được thiết kế để đo khả năng thích ứng thực sự của AI, không phải “giàn giáo” của nhà phát triển.
ARC-AGI-3 là trọng tâm của cuộc thi năm nay, nhưng không phải đường đua duy nhất.
ARC Prize 2026 có tổng giải thưởng hơn 2 triệu đô la chia cho ba đường đua. Đường đua ARC-AGI-3 có tổng giải 850.000 đô, với Giải Lớn 700.000 đô cho tác tử đủ điều kiện đầu tiên đạt 100% trên bộ đánh giá hoàn toàn riêng tư. Nếu không ai giành được năm nay, quỹ sẽ chuyển sang 2027. Ngoài Giải Lớn, có giải điểm số cao nhất 75.000 đô chia cho năm đội dẫn đầu, và hai mốc checkpoint (30/6 và 30/9/2026) mỗi mốc phân bổ 37.500 đô cho ba đội đứng đầu tại thời điểm đó.
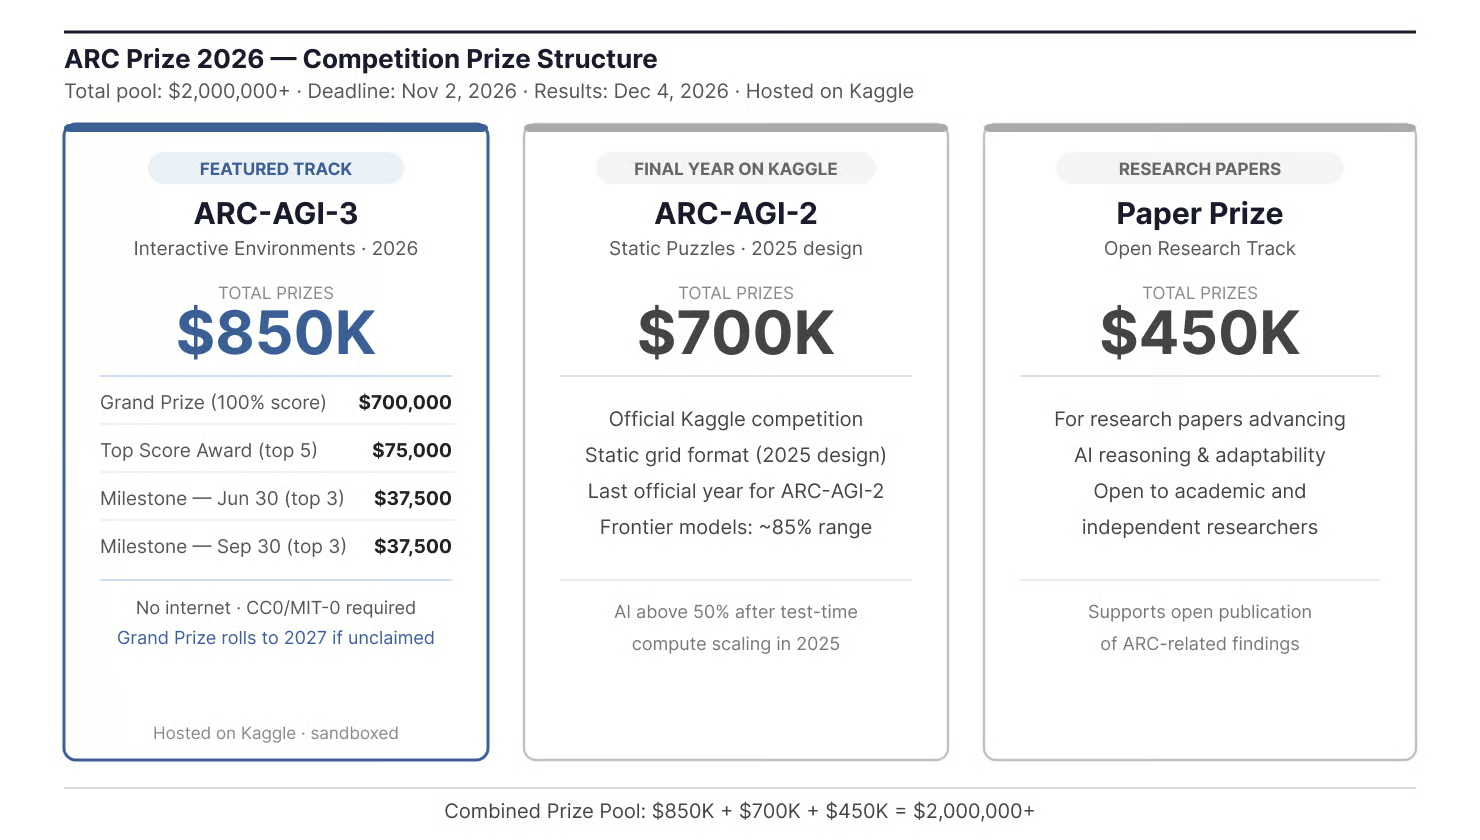
Cơ cấu giải thưởng cuộc thi ARC Prize 2026. Hình do Tác giả thực hiện.
Hai đường đua còn lại là đường đua ARC-AGI-2 (700.000 đô, và đáng chú ý là năm cuối ARC-AGI-2 được dùng trong một cuộc thi Kaggle chính thức) và đường đua Paper Prize (450.000 đô cho các bài nghiên cứu).
Cuộc thi diễn ra trên Kaggle, nhưng với quy định khác thường lệ. Bài nộp được đánh giá trong môi trường sandbox không có internet, loại trừ việc gọi API tới các mô hình như GPT, Claude hay Gemini. Mọi lời giải đủ điều kiện nhận giải phải phát hành dưới giấy phép thoáng hoặc phạm vi công cộng (CC0 hoặc MIT-0) trước khi nhận điểm đánh giá riêng tư. Cuộc thi mở ngày 25/3/2026, hạn chót nộp là 2/11/2026, và công bố kết quả ngày 4/12/2026.
Các thước đo có ý nghĩa nhất khi chúng phơi bày một khoảng trống vốn không rõ ràng trước đó. Theo tiêu chí đó, hai thước đo ARC đầu tiên đã khẳng định vị thế: ARC-AGI-1 phơi bày sự xuất hiện của các mô hình lập luận lớn, và ARC-AGI-2 theo dõi mức độ đẩy mạnh tính toán ở thời điểm suy luận. ARC-AGI-3 đang chỉ vào một vấn đề khác.
Điều khiến thước đo này đặc biệt liên quan lúc này là bối cảnh. Từ đầu năm 2026, nhiều thước đo AI được dùng rộng rãi tiến gần bão hòa. Các mô hình tiên phong đạt trên 90% ở MMLU, HumanEval, và GSM8K, trong số khác, khiến các bài đánh giá này khó cho ta biết khác biệt giữa các hệ thống. ARC-AGI-3 kiểm tra một năng lực mà các mô hình hiện nay có vẻ thiếu: học “tại chỗ” trong các môi trường xa lạ. Khoảng cách giữa điểm AI dưới 1% và khả năng giải 100% của con người đủ lớn để gợi ý đây không chỉ là bản khó hơn của cùng bài test, mà là một dạng thử thách khác.
ARC Prize coi ARC-AGI-3 là bài kiểm tra quan trọng nhất về lập luận tương tác, dù cũng nên nhớ rằng cách đóng khung này đến từ chính tổ chức vận hành thước đo. Tính bền vững của nhận định đó phụ thuộc vào cách thước đo thể hiện khi cộng đồng nghiên cứu thích nghi với nó.
Không thước đo nào hoàn hảo, và ARC-AGI-3 nhận một số phê bình đáng lưu ý.
Một lo ngại phổ biến là chính công thức chấm điểm. Chỉ số hiệu quả bình phương trừng phạt mạnh việc khám phá, vốn có thể được coi là dấu hiệu của trí tuệ chứ không phải thất bại. Nếu một tác tử dành 50 hành động để cẩn thận lập bản đồ ranh giới trước khi ra lời giải, điểm số sẽ thấp hơn nhiều so với một người đoán trúng quy tắc trong 5 hành động. Một số thành viên cộng đồng cho rằng điều này làm khoảng cách hiệu suất trông như bị phóng đại.
Cũng có câu hỏi về cách chọn mốc so sánh. Như đã nêu trong phần chấm điểm, thước đo dùng người thử nghiệm tốt thứ hai thay vì trung bình, đặt ra một mức rất cao. Ngay cả người dùng phổ thông cũng sẽ dưới 100% với cách tiếp cận này.
Đội ngũ ARC Prize giới thiệu thước đo như một nỗ lực khoa học nhằm đo một năng lực còn thiếu cụ thể, không phải bài kiểm tra quyết định về trí tuệ tổng quát. Đó là một cách hiểu hợp lý dựa trên những gì ta biết ngày nay.
ARC-AGI-3 chọn cách khác để đánh giá hệ thống AI. Bằng cách chuyển từ câu đố tĩnh sang môi trường tương tác, nó kiểm tra liệu các mô hình có thể khám phá, tự đặt mục tiêu, và tìm ra lời giải qua trải nghiệm thay vì chỉ qua hướng dẫn.
Những con số ban đầu rất đáng chú ý. Các mô hình thống trị thước đo lập trình, thi toán và kiểm tra kiến thức lại chật vật vượt 1% ở đây. Khoảng cách đó sẽ khép nhanh như với các thước đo ARC trước, hay định dạng tương tác thực sự khó “bẻ khóa” hơn, là điều tôi cho rằng rất đáng theo dõi sát sao.
Để tìm hiểu thêm về các khái niệm đằng sau hệ thống AI thích ứng, hãy xem AI Fundamentals của chúng tôi hoặc khóa học Xây dựng Hệ thống Tác tử có Khả năng Mở rộng.
Học cùng DataCamp
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
